Модель gpt-6-astra была выпущена 3 сентября 2026 года, а уже на следующий день стала доступна всем пользователям. Однако спустя всего неделю в социальных сетях поднялась волна недовольства: пользователи жалуются, что gpt-6-astra «поглупела». Мол, на тех же самых промптах качество ответов стало хуже, чем в первые дни, а режим повышенной интенсивности рассуждений (Extra high) стал работать быстрее, но выдавать более поверхностные результаты. В то же время лимиты на использование Astra в ChatGPT и Codex оказались заметно жестче, чем у предыдущей модели GPT-5.6 Sol, из-за чего многие разработчики упираются в ограничения прямо посреди работы. В этой статье мы разберем 5-шаговый метод проверки, действительно ли gpt-6-astra стала хуже, и как временно переключиться на официальный API-ключ, если лимиты исчерпаны, чтобы ваш рабочий процесс оставался стабильным.
Ключевая ценность: после прочтения вы научитесь отличать «реальную деградацию» от «ошибок восприятия», поймете реальные границы лимитов подписки и узнаете, как использовать контролируемую интенсивность рассуждений и стратегии кэширования для вызова полноценной версии gpt-6-astra с оптимальными затратами.
Основные моменты споров вокруг «деградации» gpt-6-astra
Прежде чем приступать к проверке, давайте разложим по полочкам известные факты. Согласно данным зарубежных СМИ, таких как Decrypt, через неделю после запуска Astra посыпались жалобы. Часть разработчиков (включая команду opencode) вернулись на GPT-5.6 Sol из-за того, что затраты выросли вдвое, а качество не оправдало ожиданий. Однако на момент публикации OpenAI не делала официальных заявлений по Astra. Многие опытные пользователи считают, что сама модель не изменилась, просто после «медового месяца» люди стали внимательнее замечать её ошибки.
| Пункт | Известные факты | Что это значит для вас |
|---|---|---|
| Дата выпуска | 03.09.2026 для одобренных пользователей, 04.09 — общий доступ | Модель всё еще на ранней стадии, серверные настройки могут часто меняться |
| Жалобы на «поглупение» | Пользователи отмечают ухудшение ответов на те же промпты и ускорение работы при высоких настройках | Нужно проверять воспроизводимым способом, а не только по ощущениям |
| Официальный ответ | Официальных заявлений по Astra пока нет | Невозможно подтвердить, менялись ли настройки интенсивности рассуждений по умолчанию |
| Исторический прецедент | В июле 2026 года Sol сталкивалась с подобными претензиями; OpenAI отрицала намеренное ослабление, но признала эксперименты с настройками «интенсивности рассуждений» | Бюджет рассуждений в ChatGPT не находится под вашим полным контролем |
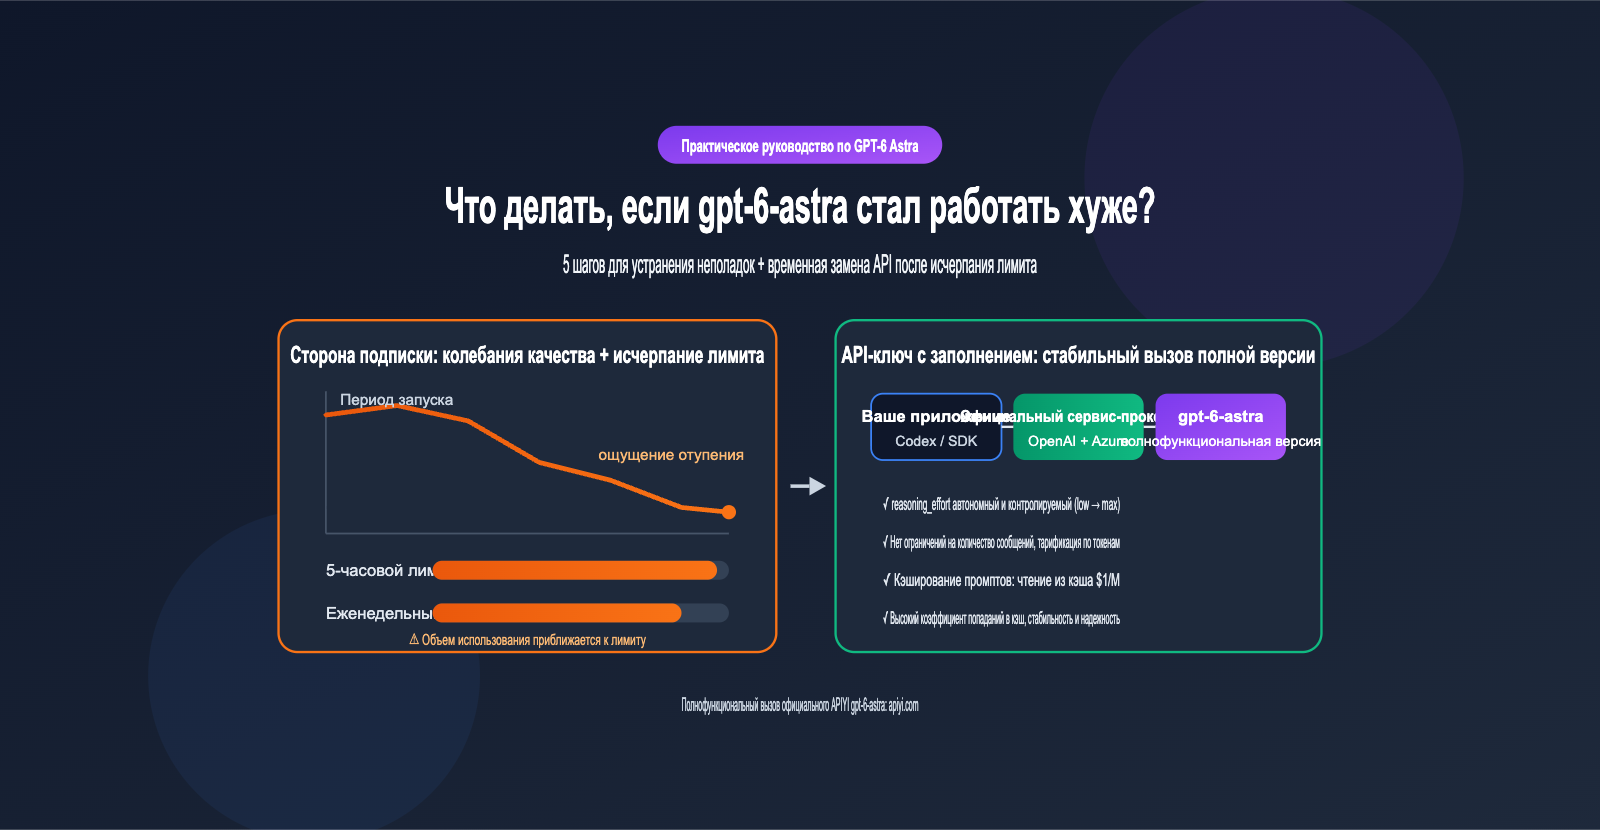
| Урезание лимитов | В подписке Work/Codex доступно около 5-45 сообщений за 5 часов, что вдвое меньше, чем было у Sol | Активные пользователи легко упираются в потолок в часы пик |
Почему кажется, что gpt-6-astra «стала глупее»
Вероятность того, что веса модели были тайно заменены, крайне мала. Чаще всего причина кроется в «бюджете рассуждений». В API gpt-6-astra поддерживает пять уровней интенсивности рассуждений: low, medium, high, xhigh и max. Чем выше уровень, тем больше шагов размышления делает модель перед ответом, что повышает качество, но увеличивает время генерации. В таких продуктах, как ChatGPT и Codex, бюджет рассуждений распределяется платформой централизованно. Как только платформа снижает фактический бюджет, чтобы справиться с нагрузкой на вычислительные мощности, пользователи видят результат, который «работает быстрее, но выдает более грубые ответы», что полностью совпадает с жалобами.
С другой стороны, разработчики, такие как Theo, отмечают, что у Astra высокая дисперсия ответов: на одну и ту же задачу она может выдать как блестящий результат, так и допустить глупую ошибку. В начале все запоминали только удачные кейсы, а при длительном использовании неудачи стали бросаться в глаза — этот психологический разрыв часто интерпретируют как «деградацию». Поэтому ключ к проверке — разделить три переменные: «планирование платформы», «дисперсия модели» и «ваши собственные методы работы».
5-шаговый алгоритм диагностики при «деградации» gpt-6-astra
Этот алгоритм поможет вам разобраться, действительно ли модель gpt-6-astra стала работать хуже, или проблема кроется в чем-то другом. Выполняйте шаги по порядку, чтобы не тратить время на бесполезную смену моделей.
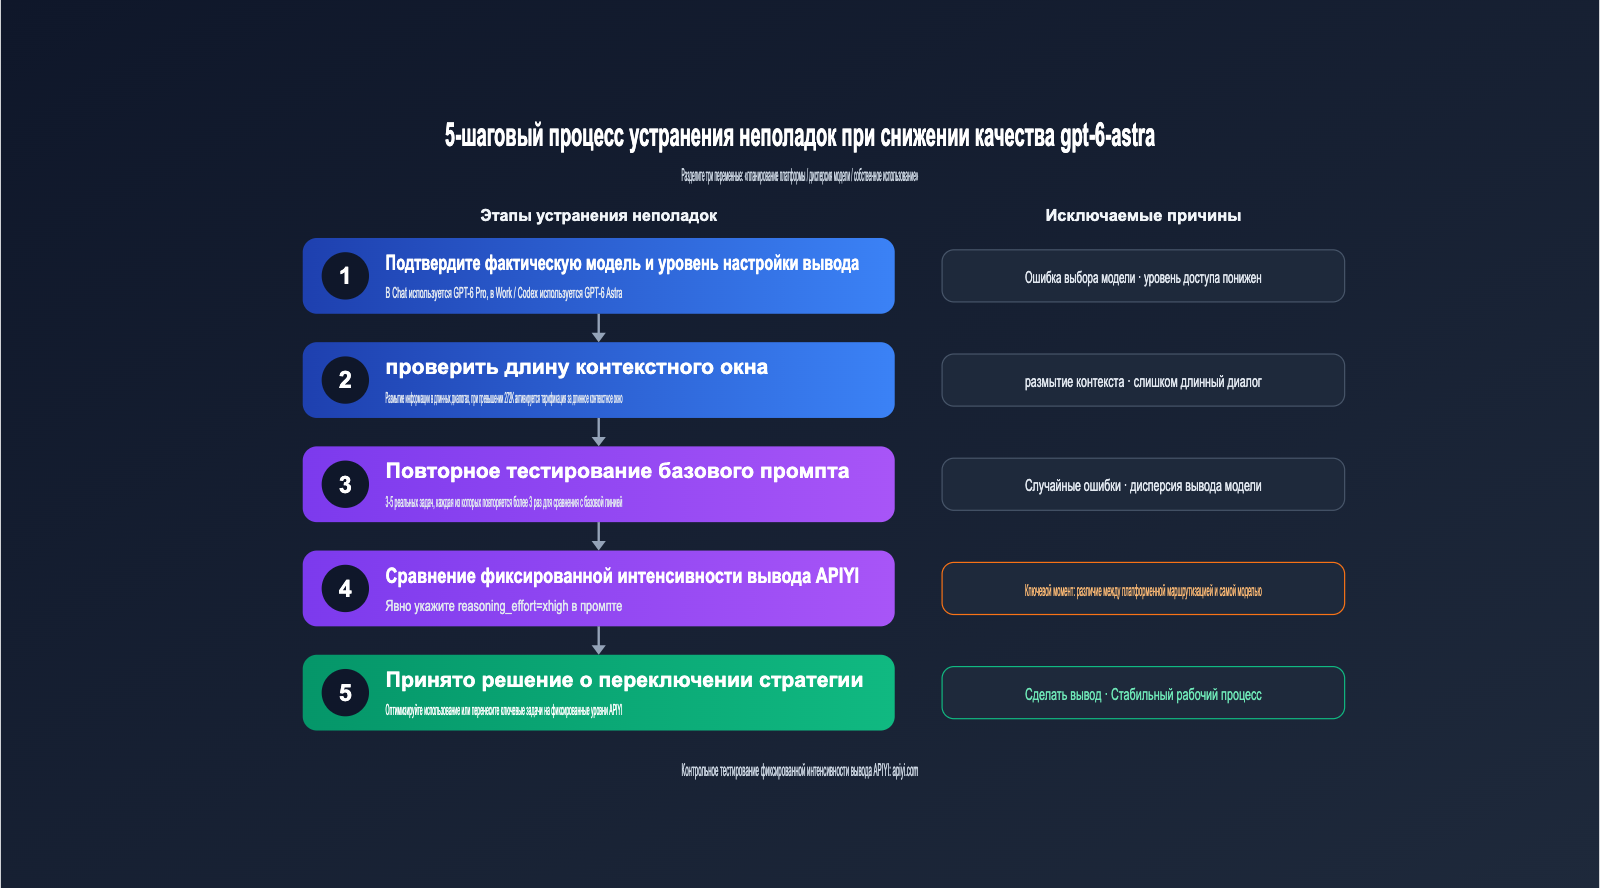
- Проверьте модель и уровень сложности: В ChatGPT модель Astra в чатах отображается как GPT-6 Pro, а в Work и Codex — как GPT-6 Astra. У них разные лимиты. Убедитесь, что используете нужную модель и уровень «рассуждений» (reasoning effort). Проверьте, не выдает ли интерфейс предупреждение о снижении качества из-за нехватки квот.
- Проверьте длину контекста: Контекстное окно Astra составляет 1 050 000 токенов, но «размытие» ранней информации в длинных диалогах — общая проблема всех больших языковых моделей. Если сессия в Codex длится уже несколько часов, начните новую и сократите вводные данные.
- Тестирование на фиксированных промптах: Возьмите 3–5 привычных задач, для которых у вас есть эталонные ответы, полученные ранее. Запустите один и тот же промпт минимум 3 раза. Единичный случай не дает статистической значимости.
- Сравнение через API с фиксированной интенсивностью: Используйте API, чтобы явно задать параметр
reasoning_effort. Сравните результат с тем, что выдает веб-интерфейс. Если через API с параметромxhighрезультат заметно лучше, значит, проблема в лимитах платформы, а не в самой модели. - Принятие решения: Если дело в промптах — оптимизируйте их. Если в платформе или квотах — перенесите критически важные задачи на API.
| Явление | Вероятная причина | Метод проверки | Рекомендация |
|---|---|---|---|
| Ответы стали быстрыми, но поверхностными | Снижен бюджет на рассуждения | Сравнение с xhigh через API |
Перенести задачи на API с фиксацией уровня |
| Ошибки в конце длинных сессий | Размытие контекста | Запуск в новом чате | Дробить задачи, чистить контекст |
| Нестабильное качество | Высокая дисперсия модели | Повтор промпта 3–5 раз | Добавить проверку или сэмплирование |
| Уведомление о нехватке квот | Исчерпан лимит (5ч или недельный) | Проверка панели лимитов | Ждать обновления или использовать API |
| Регресс в качестве кода | Смена уровня или «дрейф» промпта | Сравнение с эталоном | Зафиксировать системный промпт и уровень |
🎯 Совет по диагностике: Шаг 4 — ключевой для понимания того, где именно проблема. Мы рекомендуем использовать сервис-прокси API APIYI (apiyi.com) для запуска одного и того же промпта с параметрами
highиxhigh. Этот сервис предоставляет доступ к gpt-6-astra напрямую через официальные шлюзы, что делает результаты сравнения максимально объективными.
Что делать, если закончились лимиты gpt-6-astra
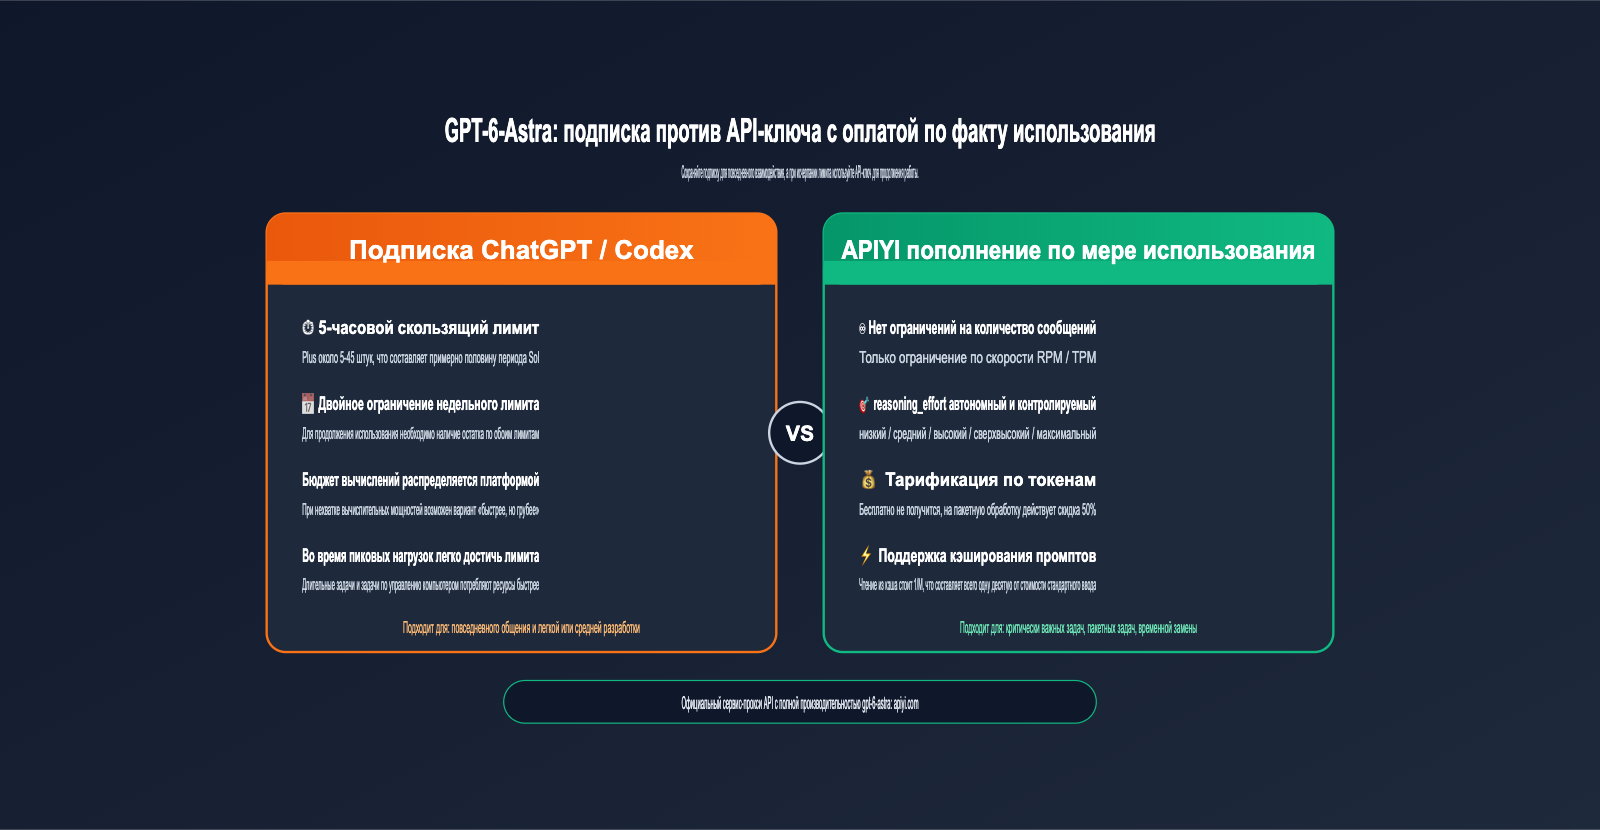
Даже если модель не «глупеет», нехватка лимитов — это всегда неприятно и выбивает из рабочего ритма. Согласно данным из зарубежных сообществ, Astra в ChatGPT Work и Codex использует двойное ограничение: «5-часовой скользящий лимит + недельный лимит». Чтобы продолжать работу, оба показателя должны быть в норме. Кроме того, после сброса лимитов 5 сентября появились сообщения, что для активных пользователей потолок стал еще ниже. В таблице ниже приведены оценочные значения, но ориентироваться стоит на официальную панель использования OpenAI.
| Тарифный план | Оценочный лимит Astra в Work/Codex | GPT-6 Pro в Chat | Для кого подходит |
|---|---|---|---|
| Plus | ~5-45 сообщений / 5 ч | Недоступно | Легкие задачи, редкое использование |
| Pro $100 | ~25-225 сообщений / 5 ч | ~50 сообщений / нед | Основной инструмент разработчика |
| Pro $200 | ~100-900 сообщений / 5 ч | ~200 сообщений / нед | Интенсивная работа 24/7 |
| API (оплата по факту) | Нет лимита сообщений, только RPM/TPM | Не применимо | Пакетные задачи, критические процессы |
Такой разброс в цифрах объясняется тем, что расход лимитов зависит от сложности задачи, уровня рассуждений (reasoning effort) и длины контекста. Одно дело — короткий вопрос, и совсем другое — 40-минутная задача по автоматизации действий на компьютере. Для большинства разработчиков переходить на тариф $200 ради редких пиковых нагрузок невыгодно. Куда экономнее оставить текущую подписку и использовать API для «добора» лимитов, когда они заканчиваются.
Три преимущества использования API gpt-6-astra
Использование API для временной подстраховки — это не просто «дополнительные лимиты», это возвращение контроля. Во-первых, вы сами задаете интенсивность рассуждений, и платформа не может изменить её втихую — это отличный способ борьбы с непредсказуемым «поглупением» модели. Во-вторых, API тарифицируется по токенам: не пользуетесь — не платите, что идеально для пиковых нагрузок. В-третьих, API поддерживает пакетную обработку (Batch) и кэширование промптов, что позволяет держать расходы под контролем.
При выборе провайдера важно убедиться, что это прямой шлюз. Некоторые посредники используют реверс-инжиниринг или перенаправляют запросы на другие модели, что только усугубляет проблему качества. APIYI apiyi.com предоставляет «полноценную» версию gpt-6-astra с прямым доступом к OpenAI и Azure. Параметры интерфейса полностью идентичны официальным, что делает его надежным дополнением к вашей подписке.
Быстрый старт с API gpt-6-astra
gpt-6-astra поддерживает эндпоинты Chat Completions, Responses и Batch, принимает текст и изображения, а на выходе выдает текст. Ниже приведен минимальный пример на официальном SDK OpenAI — просто замените base_url и API-ключ.
Минимальный пример вызова gpt-6-astra
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

response = client.chat.completions.create(
    model="gpt-6-astra",
    reasoning_effort="xhigh",  # low / medium / high / xhigh / max
    messages=[
        {"role": "system", "content": "Ты опытный бэкенд-разработчик, отвечай рабочим кодом."},
        {"role": "user", "content": "Реализуй LRU-кэш с временем жизни на Python"}
    ]
)
print(response.choices[0].message.content)
print(response.usage)  # Обратите внимание на prompt_tokens_details.cached_tokens
Полный код: обертка с ключами кэширования, повторами и статистикой
import time
from openai import OpenAI, APIError, RateLimitError

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Фиксированный системный промпт в начале для лучшего кэширования
SYSTEM_PROMPT = open("system_prompt.md", encoding="utf-8").read()


def ask_astra(user_input: str,
              effort: str = "high",
              cache_key: str = "project-alpha-v1",
              max_retries: int = 3) -> str:
    """Вызов gpt-6-astra с фиксированной интенсивностью и ключом кэша"""
    for attempt in range(max_retries):
        try:
            resp = client.chat.completions.create(
                model="gpt-6-astra",
                reasoning_effort=effort,
                prompt_cache_key=cache_key,
                messages=[
                    {"role": "system", "content": SYSTEM_PROMPT},
                    {"role": "user", "content": user_input},
                ],
            )
            usage = resp.usage
            cached = 0
            if usage.prompt_tokens_details:
                cached = usage.prompt_tokens_details.cached_tokens or 0
            hit_rate = cached / usage.prompt_tokens if usage.prompt_tokens else 0
            print(f"Вход {usage.prompt_tokens} | Кэш {cached} "
                  f"| Hit rate {hit_rate:.1%} | Выход {usage.completion_tokens}")
            return resp.choices[0].message.content
        except RateLimitError:
            wait = 2 ** attempt
            print(f"Лимит превышен, повтор через {wait} сек")
            time.sleep(wait)
        except APIError as e:
            print(f"Ошибка API: {e}")
            time.sleep(1)
    raise RuntimeError("Не удалось получить ответ после нескольких попыток")


if __name__ == "__main__":
    tasks = [
        "Проверь использование индексов в этом SQL: SELECT ...",
        "Разработай схему идемпотентных повторов для сервиса заказов",
    ]
    for t in tasks:
        print(ask_astra(t, effort="xhigh")[:200])
💡 Совет: Для первого запуска используйте уровень
medium, чтобы проверить цепочку, а затем повышайте интенсивность в зависимости от сложности задачи. Зарегистрируйтесь на APIYI apiyi.com, чтобы получить тестовый баланс и убедиться в качестве ответов перед запуском в продакшн.
Переключение на API gpt-6-astra в Codex
Если вы работаете в основном через Codex CLI, не нужно прерывать работу при исчерпании лимитов. В файле ~/.codex/config.toml можно настроить кастомного провайдера:
model = "gpt-6-astra"
model_provider = "apiyi"
model_reasoning_effort = "high"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
После настройки выполните export APIYI_API_KEY=ваш_ключ и перезапустите Codex. Когда лимиты подписки восстановятся, просто закомментируйте model_provider, чтобы вернуться к обычному режиму.
Как выбрать интенсивность рассуждений (reasoning effort)
Интенсивность напрямую влияет на качество, время ответа и стоимость. Рекомендуем выбирать её исходя из типа задачи, а не всегда выставлять максимум.
| Интенсивность | Типичные задачи | Качество | Время и стоимость |
|---|---|---|---|
| low | Форматирование, простые вопросы, извлечение данных | Базовое | Минимальные |
| medium | Автодополнение кода, написание документации | Сбалансированное | Низкие |
| high | Рефакторинг, архитектура, анализ данных | Стабильное | Средние |
| xhigh | Поиск сложных багов, длинные цепочки агентов | Почти как «из коробки» | Высокие |
| max | Математические доказательства, аудит безопасности | Максимальное | Очень высокие |
🎯 Рекомендация: Если вам кажется, что модель «глупеет» в обычном чате, перенесите критические задачи на уровень
xhighчерез API. При использовании APIYI apiyi.com интенсивность определяется параметрами запроса, что позволяет держать качество ответов под полным контролем.
Оптимизация затрат и коэффициента попадания в кэш для gpt-6-astra
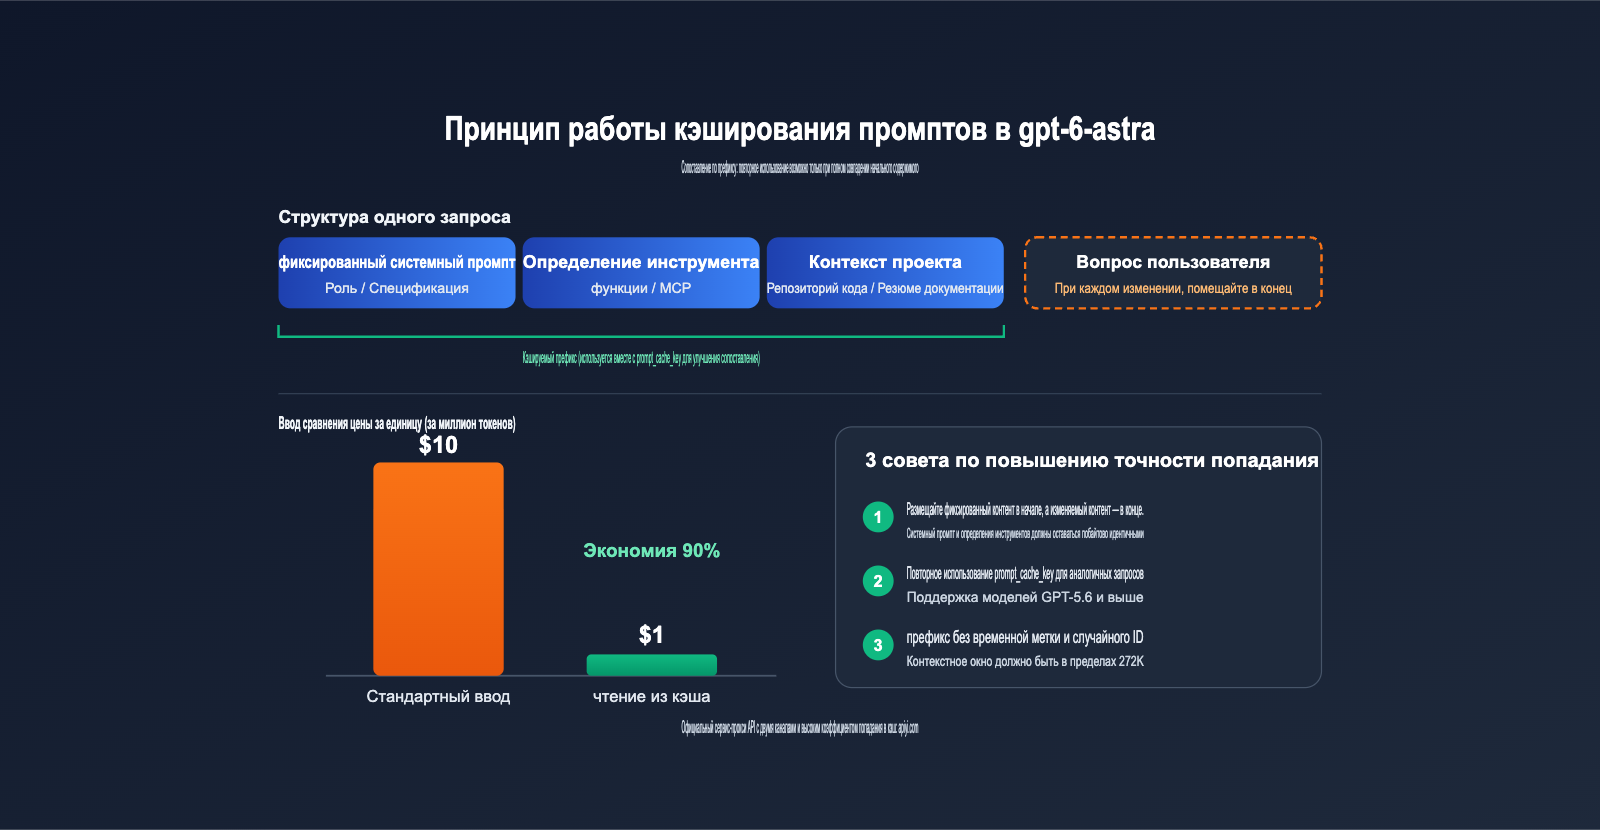
Официальная стоимость gpt-6-astra составляет $10 за входные данные и $50 за выходные (на миллион токенов), что в несколько раз выше, чем цена на старте GPT-5.6 Sol. Поэтому при использовании API для замены моделей важно заранее продумать контроль расходов. Хорошая новость в том, что стоимость кэшированного ввода для Astra составляет всего $1, что равно 10% от стандартной цены. Высокий коэффициент попадания в кэш напрямую влияет на итоговый счет.
| Статья расходов | Официальная цена (за млн токенов) | Примечание |
|---|---|---|
| Стандартный ввод | $10 | Применяется, если ввод не превышает 272K токенов |
| Чтение из кэша | $1 | Часть промпта, попавшая в кэш, экономит 90% |
| Запись в кэш | $12.5 | Новый префикс, записываемый в кэш, чуть дороже стандартного ввода |
| Стандартный вывод | $50 | Включая токены рассуждений |
| Длинный контекст | 2x для ввода/кэша, 1.5x для вывода | Активируется при превышении 272K токенов |
| Batch / Flex | 50% от стандартной цены | Подходит для задач, не требующих мгновенного ответа |
4 совета по повышению коэффициента попадания в кэш для gpt-6-astra
Кэширование промптов работает на основе совпадения «префикса»: если начало запроса идентично, модель использует ранее вычисленные результаты. Чтобы максимально эффективно использовать этот механизм, следуйте этим рекомендациям:
- Фиксированный контент — в начало: Системные промпты, определения инструментов, проектные спецификации и прочие неизменяемые данные размещайте в самом начале сообщения. Вопросы пользователя, временные метки и прочие динамические данные — в конце.
- Используйте
prompt_cache_key: Модели GPT-5.6 и выше поддерживают этот параметр. Использование одного и того же ключа кэша для запросов с общим длинным префиксом значительно повышает вероятность попадания. - Избегайте динамических значений в префиксе: Если в системный промпт вставлены текущее время или случайный ID, префикс будет меняться при каждом запросе, и кэш будет бесполезен.
- Держите контекст в пределах 272K: Превышение этого порога активирует тарификацию длинного контекста, а цена чтения из кэша удваивается. Для длинных документов лучше сначала выполнить поиск (RAG), а затем передавать данные в модель.
Коэффициент попадания в кэш также зависит от стабильности нижележащих каналов связи. Если запросы постоянно переключаются между разными бэкендами, кэш не будет работать эффективно. APIYI (apiyi.com) использует прямые каналы OpenAI и Azure и оптимизировал маршрутизацию для gpt-6-astra, чтобы обеспечить кэш-дружелюбную среду. В сценариях с фиксированными префиксами вы получите высокий коэффициент попадания, который можно отследить через поле cached_tokens в ответе API.
Часто задаваемые вопросы о «деградации» и замещении gpt-6-astra
В1: Действительно ли OpenAI «понизила интеллект» (деградировала) gpt-6-astra?
На данный момент нет официальных доказательств того, что веса модели были изменены, и OpenAI не делала никаких заявлений по этому поводу. Более вероятное объяснение кроется в изменениях планирования вычислительных ресурсов для подписчиков, наложенных на естественную вариативность ответов самой модели. Рекомендуем воспользоваться нашим методом проверки из 5 шагов, описанным в статье, и сделать выводы после сравнения с фиксированными настройками через API.
В2: Является ли gpt-6-astra, вызываемая через API, той же самой моделью, что и в ChatGPT?
Да, это одна и та же модель. Разница лишь в том, что API позволяет вам явно задавать интенсивность вычислений, тогда как бюджет на логические рассуждения в подписочном продукте распределяется платформой. APIYI apiyi.com предоставляет «полносильную» версию gpt-6-astra, которая является прямым прокси-сервисом официальной модели: интенсивность вычислений выполняется строго в соответствии с переданными вами параметрами.
В3: Можно ли одновременно использовать лимиты подписки и API?
Да, они независимы друг от друга. Рекомендуемый подход: использовать подписку для повседневных задач, а при исчерпании лимитов или необходимости пакетной обработки переключаться на API. В Codex это можно быстро настроить через конфигурационный файл.
В4: Будет ли дорого использовать API для замещения?
Зависит от того, как вы это используете. Контроль интенсивности вычислений, повышение частоты попаданий в кэш и перенос некритичных задач в пакетный режим (Batch) позволяют снизить расходы более чем в два раза. Рекомендуем сначала протестировать стоимость выполнения реальных задач на APIYI apiyi.com, а затем решать вопрос о масштабах замещения.
В5: Как лучше сочетать gpt-6-astra и GPT-5.6 Sol?
Sol стоит значительно дешевле и отлично подходит для обычного кодинга и пакетных задач. Astra же имеет явное преимущество в управлении компьютером, сложных логических рассуждениях и длинных цепочках задач для агентов. Используйте Sol как модель по умолчанию, переключаясь на Astra только для решения сложных проблем — так вы сохраните качество, контролируя бюджет.
Итог: превращаем неопределенность gpt-6-astra в управляемую переменную
gpt-6-astra — это самая мощная флагманская модель OpenAI на текущий момент, однако споры о «деградации» и ужесточении лимитов после запуска обнажили суть подписочных продуктов: бюджет на вычисления и лимиты использования определяются платформой, и пользователю приходится с этим мириться. Вместо того чтобы гадать, стала ли модель «глупее», лучше создать собственный эталон качества с помощью фиксированных промптов и настроек интенсивности вычислений.
На практике можно выделить три шага: сначала используйте метод проверки из 5 шагов, чтобы отделить планирование платформы от вариативности модели и ваших собственных методов использования. Затем, при исчерпании лимитов, используйте API для замещения, фиксируя ключевые задачи на уровне high или xhigh. Наконец, оптимизируйте расходы с помощью фиксированных префиксов, prompt_cache_key и пакетной обработки. Таким образом, независимо от изменений на стороне подписки, ваш основной рабочий процесс останется стабильным.
Если вам нужен надежный канал для замещения, рекомендуем вызывать «полносильную» версию gpt-6-astra через APIYI apiyi.com. Платформа обеспечивает прямое подключение к OpenAI и Azure, полностью совместима с официальными интерфейсами и обладает высокой частотой попаданий в кэш, что делает её отличным дополнением к подпискам ChatGPT и Codex.
Справочные материалы:
- Документация по моделям OpenAI (gpt-6-astra): developers.openai.com/api/docs/models/gpt-6-astra
- Справка OpenAI по использованию Astra: help.openai.com
- Отчет Decrypt о спорах вокруг деградации Astra: decrypt.co
- Документация Microsoft Foundry по кэшированию промптов: learn.microsoft.com
- Документация APIYI: docs.apiyi.com
Об авторе: Техническая команда APIYI, специализирующаяся на интеграции API больших языковых моделей и инженерных практиках. Приглашаем обсудить оптимизацию вызовов и контроль затрат на gpt-6-astra через APIYI apiyi.com.