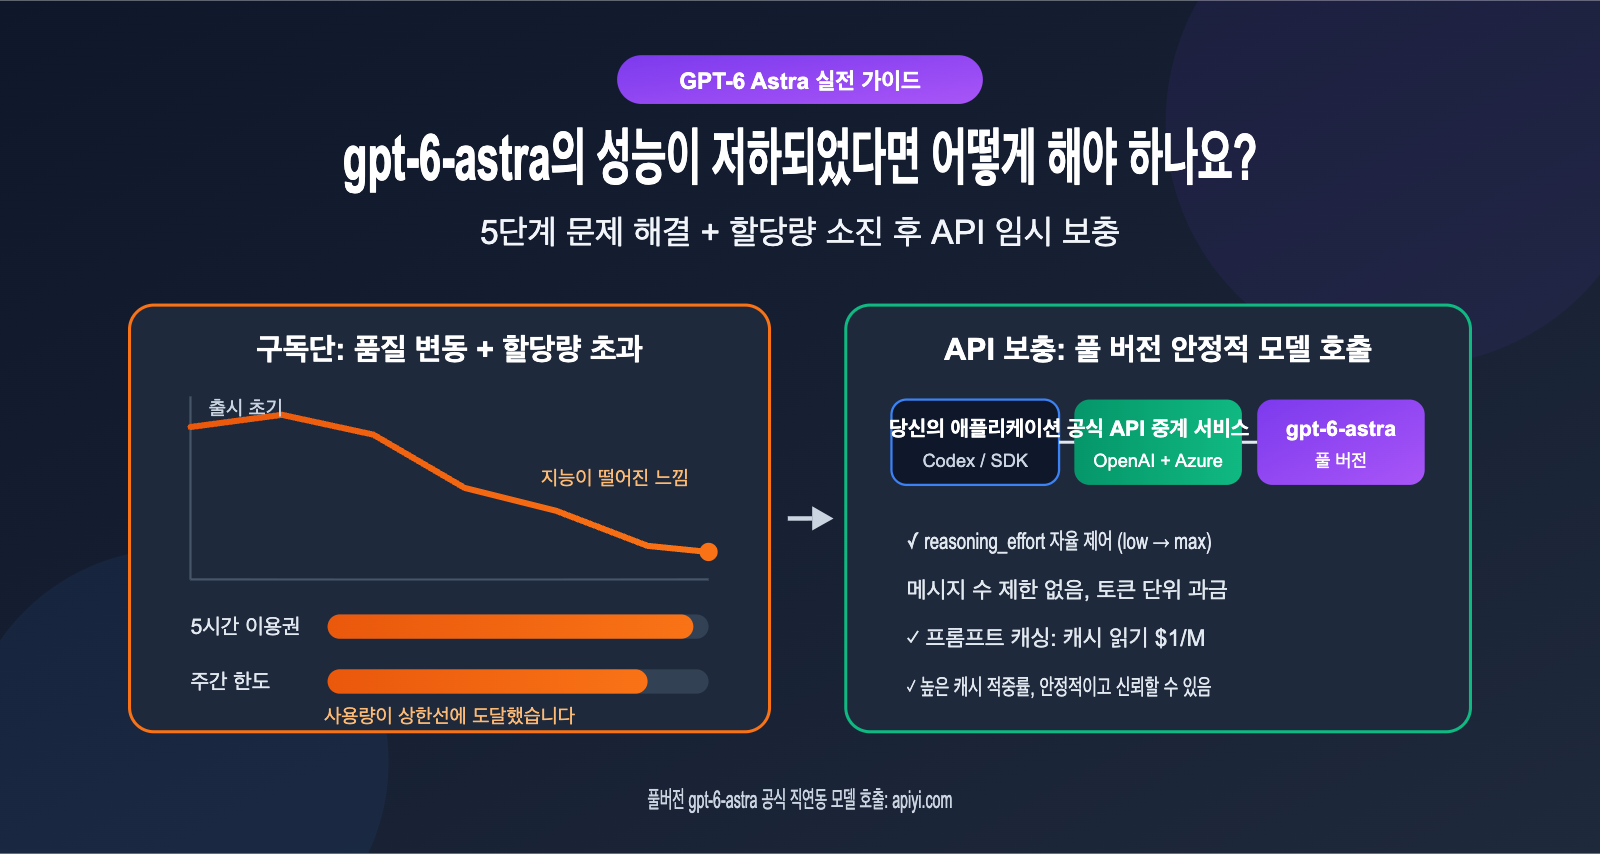
gpt-6-astra가 2026년 9월 3일 출시되고 다음 날 전체 공개된 이후, 불과 일주일 만에 소셜 미디어에는 "gpt-6-astra가 멍청해졌다(降智)"는 불만이 쏟아졌습니다. 같은 프롬프트를 입력해도 출시 초기보다 결과물의 질이 떨어졌고, Extra high 추론 단계는 더 빠르게 작동하지만 결과는 더 거칠어졌다는 의견이 지배적입니다. 동시에 ChatGPT와 Codex의 Astra 할당량이 이전 세대인 GPT-5.6 Sol보다 눈에 띄게 줄어들어, 많은 개발자가 작업 도중 제한에 걸려 멈추는 상황이 발생하고 있습니다. 이번 글에서는 gpt-6-astra가 실제로 성능이 저하되었는지 확인하는 5단계 점검법과, 할당량을 모두 소진했을 때 공식 API 중계 서비스를 통해 임시로 보완하는 방법을 소개해 여러분의 워크플로우를 안정적으로 유지할 수 있도록 도와드리겠습니다.
핵심 가치: 이 글을 읽고 나면 '실제 성능 저하'와 '체감상의 차이'를 구분할 수 있게 되며, 구독 할당량의 실제 한계를 파악하고, 제어 가능한 추론 강도와 캐시 전략을 활용해 합리적인 비용으로 최상의 gpt-6-astra를 사용하는 방법을 배우게 됩니다.
gpt-6-astra 성능 저하 논란의 핵심 포인트
점검을 시작하기 전에 현재 알려진 사실들을 명확히 정리해 보겠습니다. Decrypt 등 해외 매체의 정리에 따르면, Astra 출시 일주일 후부터 불만이 집중적으로 제기되었습니다. 일부 개발자(opencode 팀 포함)는 비용이 두 배로 들고 기대치에 미치지 못하는 품질 때문에 GPT-5.6 Sol로 되돌아갔습니다. 하지만 이 글을 작성하는 시점까지 OpenAI는 Astra에 대한 공식 입장을 밝히지 않았으며, 많은 숙련된 사용자들은 모델 자체는 변함이 없으나 '허니문 기간'이 지난 후 사용자들이 모델의 실수에 더 민감해진 것뿐이라고 분석하기도 합니다.
| 포인트 | 알려진 사실 | 의미 |
|---|---|---|
| 출시일 | 2026-09-03 승인된 사용자 대상 공개, 09-04 전체 이용 가능 | 모델이 아직 초기 단계라 서버 측 정책이 자주 변경될 수 있음 |
| 성능 저하 불만 | 같은 프롬프트 결과 품질 저하, 고추론 단계 소요 시간 단축 | 느낌이 아닌 재현 가능한 방식으로 검증 필요 |
| 공식 입장 | Astra 관련 공식 성명 없음 | 기본 추론 강도가 조정되었는지 확인 불가 |
| 과거 사례 | 2026년 7월 Sol도 유사한 의혹 제기, OpenAI는 고의적 성능 저하 부인했으나 '추론 강도' 실험 인정 | ChatGPT 측의 추론 예산은 사용자가 완전히 제어할 수 없음 |
| 할당량 축소 | Plus의 Work/Codex 내 약 5-45회/5시간, Sol 시절의 절반 수준 | 헤비 유저는 피크 타임에 제한에 걸리기 쉬움 |
gpt-6-astra가 "멍청해진 것 같다"고 느끼는 이유
모델 가중치가 몰래 교체되었을 가능성은 매우 낮습니다. 더 흔한 원인은 '추론 예산'에 있습니다. gpt-6-astra는 API에서 low, medium, high, xhigh, max의 5단계 추론 강도를 지원합니다. 단계가 높을수록 모델이 답변하기 전에 더 많은 사고 과정을 거치며, 품질과 소요 시간이 함께 증가합니다. ChatGPT와 Codex 같은 구독형 서비스에서는 추론 예산을 플랫폼이 통합 관리하는데, 플랫폼이 연산 자원 압박에 대응하기 위해 실제 예산을 하향 조정하면 사용자는 "더 빠르지만 더 거친" 결과를 보게 되며, 이는 불만 내용과 정확히 일치합니다.
한편, Theo와 같은 개발자들은 Astra 자체가 출력 편차가 크다는 점을 지적합니다. 같은 작업이라도 놀라운 결과를 낼 때가 있는 반면, 기초적인 실수를 할 때도 있다는 것이죠. 출시 초기에는 놀라운 사례만 기억하기 쉽지만, 시간이 흐르면서 실패 사례가 부각되면서 발생하는 심리적 격차가 '성능 저하'로 해석되기도 합니다. 따라서 점검의 핵심은 '플랫폼 스케줄링', '모델 편차', '사용자의 활용 방식'이라는 세 가지 변수를 분리해서 살펴보는 것입니다.
gpt-6-astra 성능 저하 5단계 점검법
gpt-6-astra의 성능이 떨어졌다고 느껴질 때, 무작정 모델을 바꾸기보다는 아래 절차를 따라 단계별로 원인을 파악해 보세요. 각 단계마다 특정 원인을 배제할 수 있습니다.
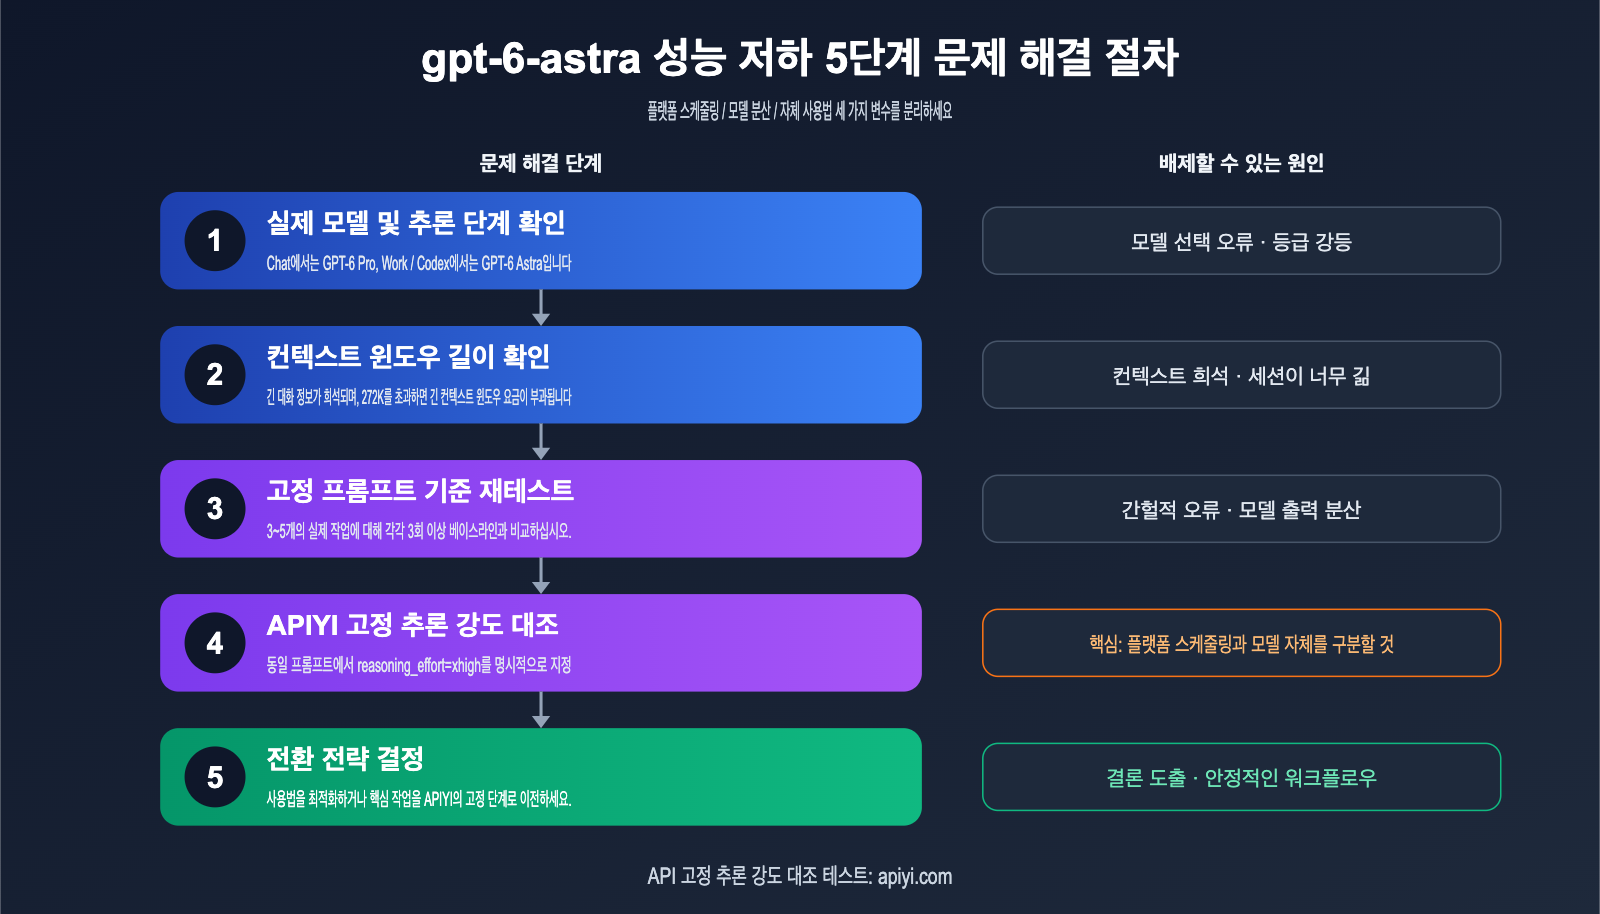
- 실제 사용 중인 모델과 등급 확인: ChatGPT에서 Astra는 채팅 시 'GPT-6 Pro'로 표시되지만, Work와 Codex에서는 'GPT-6 Astra'로 나타나며 할당량 체계도 다릅니다. 현재 어떤 모델을 사용 중인지, 사고 강도는 몇 단계인지, 할당량 부족으로 인한 등급 하향 메시지가 뜨지 않았는지 먼저 확인하세요.
- 컨텍스트 윈도우 확인: Astra의 컨텍스트 윈도우는 1,050,000 토큰이지만, 대화가 길어지면 초기 정보가 희석되는 것은 모든 대규모 언어 모델의 고질적인 문제입니다. Codex 대화가 몇 시간째 이어지고 있다면, 새 대화를 시작하고 배경 정보를 간결하게 정리한 뒤 다시 테스트해 보세요.
- 고정 프롬프트로 기준점 테스트: 익숙한 실제 작업 3~5개를 골라 초기 출력 결과를 기준(Baseline)으로 삼고, 동일한 프롬프트로 3회 이상 반복 실행해 보세요. 일시적인 오류인지, 성능이 지속적으로 저하된 것인지 통계적으로 확인해야 합니다.
- API 고정 추론 강도로 대조: API에서
reasoning_effort를 명시적으로 설정하여 동일한 프롬프트로 ChatGPT 결과와 비교해 보세요. 만약 API의xhigh결과가 구독형 서비스보다 훨씬 뛰어나다면, 모델 자체의 문제라기보다 플랫폼 측의 추론 예산 할당 문제일 가능성이 큽니다. - 결론에 따른 전략 수립: 사용법 문제라면 프롬프트와 대화 관리를 최적화하고, 플랫폼 스케줄링이나 할당량 문제라면 중요한 작업은 제어가 가능한 API 호출 방식으로 전환하세요.
| 현상 | 가장 유력한 원인 | 검증 방법 | 권장 조치 |
|---|---|---|---|
| 답변은 빠른데 추론이 얕음 | 실제 추론 예산 하향 조정 | API xhigh 설정 대조 |
중요 작업은 API로 전환 및 등급 고정 |
| 긴 대화 후반부 잦은 오류 | 컨텍스트 희석 또는 272K 초과 | 새 대화로 복구 테스트 | 작업 분할 및 컨텍스트 간소화 |
| 동일 작업 결과가 들쭉날쭉 | 모델 출력 편차 큼 | 동일 프롬프트 3~5회 실행 | 검증 단계 추가 또는 다중 샘플링 |
| 갑작스러운 용량 부족 알림 | 5시간 또는 주간 할당량 초과 | 사용량 대시보드 확인 | 재설정 대기 또는 API로 보완 |
| 코드 품질 저하 | 등급 변경 또는 프롬프트 드리프트 | 초기 기준점과 비교 | 시스템 프롬프트 및 등급 고정 |
🎯 점검 팁: 4단계는 '플랫폼 문제'와 '모델 문제'를 구분하는 핵심입니다. APIYI(apiyi.com)를 통해 동일한 프롬프트로
high와xhigh등급을 각각 실행해 보시길 권장합니다. 해당 플랫폼은 공식 모델을 그대로 중계하므로, OpenAI 원본 인터페이스와 동일한 파라미터를 사용하여 훨씬 설득력 있는 비교 결과를 얻을 수 있습니다.
gpt-6-astra 할당량을 다 썼을 때 대처법
모델의 성능이 저하되지 않았더라도, 할당량 문제는 작업 흐름을 끊기 충분합니다. 해외 미디어와 커뮤니티 정보에 따르면, Astra는 ChatGPT Work와 Codex에서 '5시간 롤링 할당량 + 주간 할당량'이라는 이중 제한을 적용하고 있으며, 두 조건 모두 충족되어야 계속 사용할 수 있습니다. 또한 9월 5일 전체 할당량 초기화 이후, 일부 헤비 유저의 상한선이 더욱 엄격해졌다는 보고도 있습니다. 아래 표는 커뮤니티에서 정리한 추정치이며, 실제 할당량은 OpenAI 공식 사용량 대시보드를 기준으로 합니다.
| 구독 플랜 | Work/Codex 내 Astra 추정 할당량 | Chat 내 GPT-6 Pro | 추천 대상 |
|---|---|---|---|
| Plus | 약 5-45회 / 5시간 | 제공 안 함 | 가벼운 체험, 가끔 복잡한 작업 수행 |
| Pro $100 | 약 25-225회 / 5시간 | 약 50회 / 주 | 일상적인 개발 주력 |
| Pro $200 | 약 100-900회 / 5시간 | 약 200회 / 주 | 상시 헤비 유저 |
| API 종량제 | 메시지 횟수 제한 없음, RPM/TPM 제한 적용 | 해당 없음 | 대량 작업, 핵심 업무, 임시 보충 |
구간 차이가 큰 이유는 메시지당 소모되는 할당량이 작업의 복잡도, 추론 강도, 컨텍스트 윈도우 길이에 따라 달라지기 때문입니다. 40분 동안 컴퓨터를 제어하는 작업과 간단한 질의응답은 소모량 차이가 매우 큽니다. 대부분의 개발자에게는 가끔 발생하는 할당량 부족을 위해 $200 플랜으로 업그레이드하는 것보다, 기존 구독을 유지하면서 할당량이 소진되었을 때 API 종량제로 보충하는 것이 훨씬 경제적입니다.
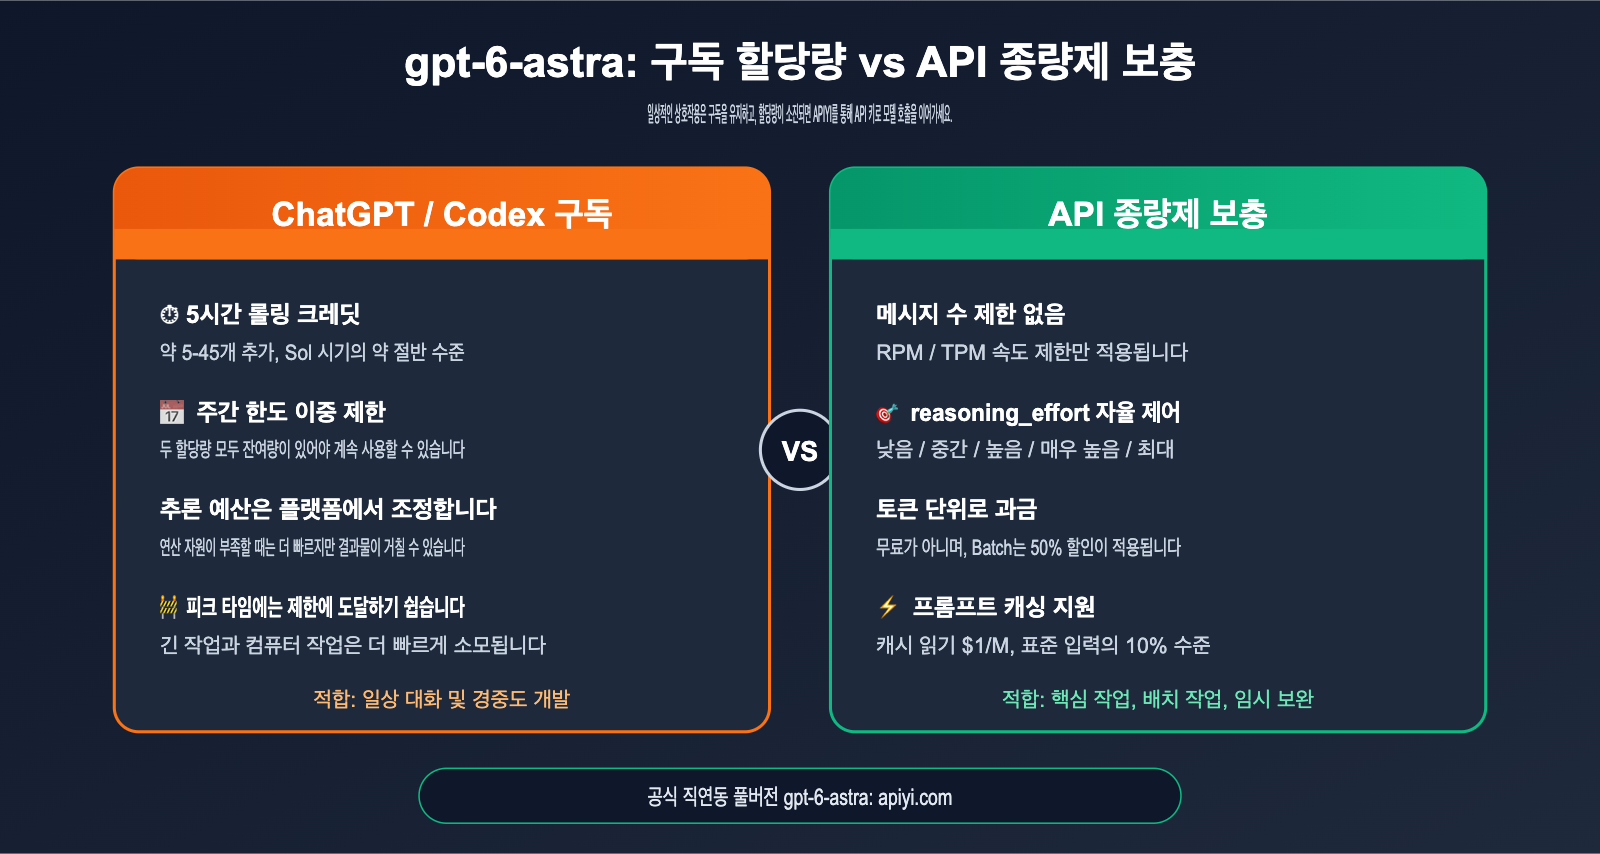
gpt-6-astra API 보충의 세 가지 장점
API를 통한 임시 보충은 단순히 '할당량을 늘리는 것' 이상의 의미, 즉 제어권을 되찾는다는 점이 중요합니다. 첫째, 추론 강도를 직접 지정할 수 있어 플랫폼이 임의로 조정하지 않으므로 '성능 저하'에 대한 불확실성을 상쇄할 수 있습니다. 둘째, API는 토큰 단위로 과금되므로 사용하지 않을 때는 비용이 발생하지 않아 간헐적인 수요에 적합합니다. 셋째, Batch 처리나 프롬프트 캐싱 등 비용 최적화 수단을 지원하여 장기적으로 비용을 관리하기 좋습니다.
채널을 선택할 때는 공식 직연동 여부를 확인해야 합니다. 일부 서드파티 채널은 역방향 인터페이스를 사용하거나 요청을 다른 모델로 라우팅하여 성능 저하 문제를 악화시킬 수 있습니다. APIYI(apiyi.com)에서 제공하는 gpt-6-astra는 풀 스펙 버전으로, OpenAI 및 Azure 공식 직연동 라인을 모두 지원하며 인터페이스 매개변수도 공식과 완전히 동일하여 안정적인 보조 수단으로 적합합니다.
gpt-6-astra API 빠르게 시작하기
gpt-6-astra는 Chat Completions, Responses, Batch 엔드포인트를 지원하며 텍스트와 이미지를 입력받아 텍스트를 출력합니다. 아래의 간단한 예제는 OpenAI 공식 SDK를 사용하며, base_url과 API 키만 교체하면 바로 실행할 수 있습니다.
gpt-6-astra 간단 호출 예제
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

response = client.chat.completions.create(
    model="gpt-6-astra",
    reasoning_effort="xhigh",  # low / medium / high / xhigh / max
    messages=[
        {"role": "system", "content": "당신은 숙련된 백엔드 엔지니어입니다. 실행 가능한 코드를 포함하여 답변하세요."},
        {"role": "user", "content": "Python으로 만료 시간이 있는 LRU 캐시를 구현해줘"}
    ]
)
print(response.choices[0].message.content)
print(response.usage)  # prompt_tokens_details.cached_tokens 확인
전체 코드 보기: 캐시 키, 재시도 및 사용량 통계가 포함된 래퍼
import time
from openai import OpenAI, APIError, RateLimitError

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 프롬프트 캐싱 효율을 위해 고정된 긴 시스템 프롬프트를 상단에 배치
SYSTEM_PROMPT = open("system_prompt.md", encoding="utf-8").read()


def ask_astra(user_input: str,
              effort: str = "high",
              cache_key: str = "project-alpha-v1",
              max_retries: int = 3) -> str:
    """gpt-6-astra 호출, 추론 강도 고정 및 캐시 키 재사용"""
    for attempt in range(max_retries):
        try:
            resp = client.chat.completions.create(
                model="gpt-6-astra",
                reasoning_effort=effort,
                prompt_cache_key=cache_key,
                messages=[
                    {"role": "system", "content": SYSTEM_PROMPT},
                    {"role": "user", "content": user_input},
                ],
            )
            usage = resp.usage
            cached = 0
            if usage.prompt_tokens_details:
                cached = usage.prompt_tokens_details.cached_tokens or 0
            hit_rate = cached / usage.prompt_tokens if usage.prompt_tokens else 0
            print(f"입력 {usage.prompt_tokens} | 캐시 {cached} "
                  f"| 적중률 {hit_rate:.1%} | 출력 {usage.completion_tokens}")
            return resp.choices[0].message.content
        except RateLimitError:
            wait = 2 ** attempt
            print(f"속도 제한 발생, {wait}초 후 재시도")
            time.sleep(wait)
        except APIError as e:
            print(f"인터페이스 오류: {e}")
            time.sleep(1)
    raise RuntimeError("여러 번 재시도했으나 실패했습니다.")


if __name__ == "__main__":
    tasks = [
        "이 SQL의 인덱스 사용 현황을 검토해줘: SELECT ...",
        "주문 서비스를 위한 멱등성 재시도 설계안",
    ]
    for t in tasks:
        print(ask_astra(t, effort="xhigh")[:200])
💡 사용 팁: 처음 호출할 때는
medium단계로 연결을 확인한 후, 작업 난이도에 따라 점진적으로 높이는 것을 권장합니다. APIYI(apiyi.com)에 가입하여 테스트 할당량을 받은 뒤, 출력 품질이 기대에 부합하는지 확인하고 실제 작업에 적용해 보세요.
Codex에서 gpt-6-astra API로 전환하기
주로 Codex CLI에서 Astra를 사용한다면, 할당량이 소진되어도 작업을 중단할 필요가 없습니다. ~/.codex/config.toml 파일에서 커스텀 모델 제공자를 설정하여 API 키로 작업을 계속할 수 있습니다.
model = "gpt-6-astra"
model_provider = "apiyi"
model_reasoning_effort = "high"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
설정 완료 후 export APIYI_API_KEY=본인의키를 실행하고 Codex를 시작하면 됩니다. 구독 할당량이 초기화되면 model_provider 부분을 주석 처리하여 원래 로그인 방식으로 돌아갈 수 있으며, 필요에 따라 두 모드를 자유롭게 전환할 수 있습니다.
gpt-6-astra 추론 강도 선택법
추론 강도는 품질, 소요 시간, 비용을 직접 결정하므로 무조건 높이기보다는 작업 유형에 따라 단계를 나누는 것이 좋습니다.
| 추론 강도 | 대표적인 작업 | 품질 수준 | 소요 시간 및 비용 |
|---|---|---|---|
| low | 형식 변환, 간단한 질의응답, 정보 추출 | 기본 요구사항 충족 | 최저 |
| medium | 일상적인 코드 완성, 문서 작성 | 균형 잡힘 | 낮음 |
| high | 복잡한 리팩토링, 아키텍처 설계, 데이터 분석 | 안정적이고 신뢰성 있음 | 중간 |
| xhigh | 어려운 버그 수정, 긴 체인의 에이전트 작업 | 초기 출시 경험과 유사 | 높음 |
| max | 수학적 증명, 보안 감사, 고가치 의사결정 | 최고 수준 | 최고, 호출 빈도 조절 필요 |
🎯 선택 가이드: 구독 모델의 '성능 저하'가 의심된다면, 원래 ChatGPT에서 수행하던 핵심 작업을
xhigh단계로 고정하여 호출해 보세요. APIYI(apiyi.com)를 통해 호출하면 추론 강도를 요청 매개변수로 완벽하게 제어할 수 있어 품질 변동을 예측 가능한 범위 내에서 관리할 수 있습니다.
gpt-6-astra 비용 관리 및 캐시 적중률 최적화
gpt-6-astra의 공식 가격은 입력 $10, 출력 $50(100만 토큰당)로, GPT-5.6 Sol 출시 가격의 몇 배에 달합니다. 따라서 API를 보조 수단으로 사용할 때는 비용 관리를 최우선으로 고려해야 합니다. 다행히 Astra의 캐시 입력 가격은 표준 입력가의 10% 수준인 $1에 불과하므로, 캐시 적중률을 높이는 것이 곧 비용 절감으로 직결됩니다.
| 과금 항목 | 공식 가격 (100만 토큰당) | 설명 |
|---|---|---|
| 표준 입력 | $10 | 입력이 272K 토큰 이하일 때 적용 |
| 캐시 읽기 | $1 | 프롬프트 캐시 적중 시 적용, 90% 비용 절감 |
| 캐시 쓰기 | $12.5 | 새로운 캐시 접두사 작성 시, 표준 입력보다 약간 높음 |
| 표준 출력 | $50 | 추론 토큰 포함 |
| 긴 컨텍스트 | 입력 및 캐시 2배, 출력 1.5배 | 입력이 272K 토큰을 초과할 때 트리거 |
| Batch / Flex | 표준 가격의 50% | 실시간 응답이 필요 없는 작업에 적합 |
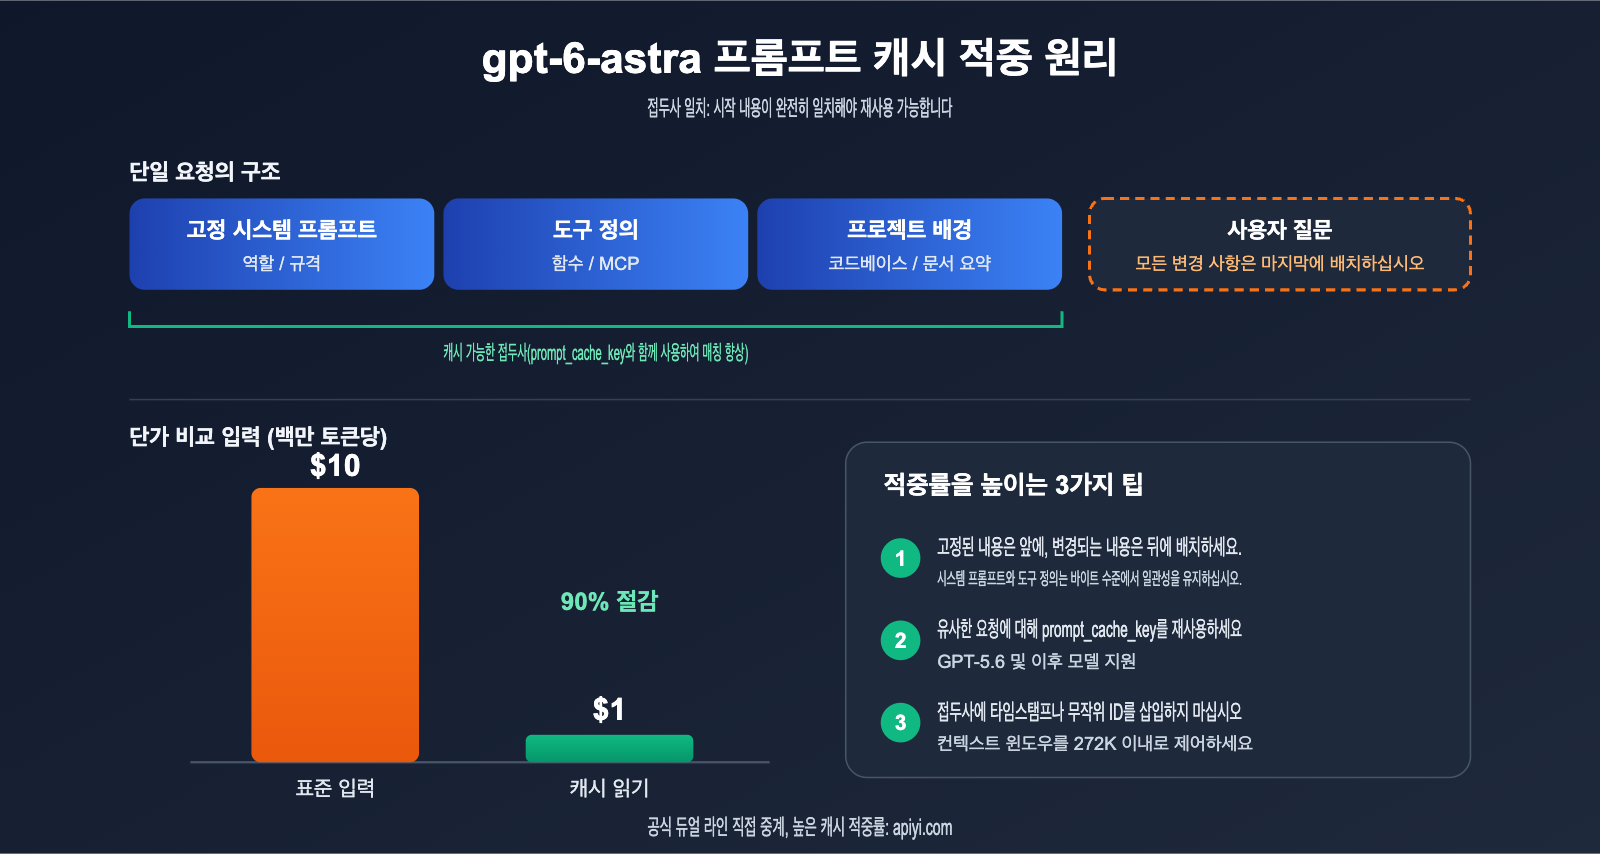
gpt-6-astra 캐시 적중률을 높이는 4가지 팁
프롬프트 캐시는 '접두사(Prefix)'를 기준으로 매칭됩니다. 요청의 시작 부분이 완전히 일치하기만 하면 이전 계산 결과를 재사용할 수 있죠. 이 메커니즘을 활용해 다음과 같이 최적화해 보세요.
- 고정된 내용을 앞부분에 배치: 시스템 프롬프트, 도구 정의, 프로젝트 규격 등 변하지 않는 내용은 메시지 가장 앞에 두고, 사용자 질문이나 타임스탬프처럼 변하는 내용은 뒤로 배치하세요.
- prompt_cache_key 사용: GPT-5.6 이상 모델은 이 매개변수를 지원합니다. 긴 접두사를 공유하는 요청에 동일한 캐시 키를 사용하면 매칭 확률이 크게 향상됩니다.
- 접두사에 동적 값 삽입 금지: 시스템 프롬프트에 현재 시간이나 랜덤 ID를 넣으면 매번 요청의 접두사가 달라져 캐시가 무용지물이 됩니다.
- 컨텍스트 윈도우를 272K 이내로 관리: 이 임계값을 초과하면 긴 컨텍스트 요금이 부과되며, 캐시 읽기 가격도 두 배가 됩니다. 긴 문서는 먼저 검색(Retrieval)을 거친 후 모델에 전달하는 것이 좋습니다.
캐시 적중률은 하위 네트워크의 안정성과도 관련이 있습니다. 요청이 여러 백엔드 사이를 빈번하게 오가면 캐시가 유지되기 어렵습니다. APIYI(apiyi.com)는 OpenAI와 Azure 공식 라인을 모두 지원하며, gpt-6-astra에 최적화된 캐시 친화적 라우팅을 제공합니다. 고정 접두사 환경에서 높은 캐시 적중률을 기대할 수 있으며, 응답 내 cached_tokens 필드를 통해 직접 효과를 확인해 보세요.
gpt-6-astra 성능 저하 및 보조 사용 FAQ
Q1:gpt-6-astra가 정말 OpenAI에 의해 성능이 저하되었나요?
현재 모델 가중치가 교체되었다는 공식적인 증거는 없으며, OpenAI의 공식 발표도 없습니다. 구독형 서비스의 추론 예산 할당 방식 변화와 모델 자체의 출력 분산 때문일 가능성이 높습니다. 본문의 5단계 점검법을 활용해 API의 고정된 설정으로 비교해 본 뒤 결론을 내리는 것을 권장합니다.
Q2:API로 호출하는 gpt-6-astra와 ChatGPT의 모델은 동일한가요?
동일한 모델입니다. 차이점은 API는 사용자가 직접 추론 강도를 지정할 수 있는 반면, 구독형 제품의 추론 예산은 플랫폼이 관리한다는 점입니다. APIYI(apiyi.com)는 공식 직결 방식의 풀버전 gpt-6-astra를 제공하며, 전달한 매개변수에 따라 정확히 추론이 수행됩니다.
Q3:구독 크레딧과 API를 동시에 사용할 수 있나요?
네, 서로 독립적으로 사용할 수 있습니다. 일상적인 대화는 구독 크레딧을 사용하고, 크레딧이 소진되었거나 대량 처리가 필요할 때 API로 전환하는 방식을 추천합니다. Codex 설정 파일 등을 통해 빠르게 전환할 수 있습니다.
Q4:API를 보조로 사용하면 비용이 많이 들지 않을까요?
사용 방식에 따라 다릅니다. 추론 단계를 조절하고, 캐시 적중률을 높이며, 실시간성이 필요 없는 작업은 Batch로 처리하면 비용을 절반 이하로 줄일 수 있습니다. 먼저 APIYI(apiyi.com)에서 실제 작업 몇 가지로 단가를 계산해 본 뒤 규모를 결정하세요.
Q5:gpt-6-astra와 GPT-5.6 Sol은 어떻게 조합하는 게 좋을까요?
Sol은 가격이 훨씬 저렴하여 일반적인 코딩이나 대량 작업에 적합합니다. 반면 Astra는 컴퓨터 제어, 복잡한 추론, 긴 체인의 에이전트 작업에 강점이 있습니다. Sol을 기본 모델로 사용하고, 어려운 문제에서만 Astra로 업그레이드하는 방식을 택하면 품질과 비용을 모두 잡을 수 있습니다.
요약: gpt-6-astra의 불확실성을 제어 가능한 변수로 만들기
gpt-6-astra는 현재 OpenAI의 가장 강력한 플래그십 대규모 언어 모델이지만, 출시 초기 '지능 저하' 논란과 사용량 제한은 구독형 서비스의 본질적인 한계를 드러냈습니다. 추론 예산과 사용 한도가 플랫폼에 의해 결정되므로 사용자는 수동적으로 대응할 수밖에 없다는 점이죠. 모델이 실제로 똑똑해졌는지 고민하는 대신, 고정된 프롬프트와 고정된 추론 단계를 통해 나만의 품질 기준선을 세우는 것이 훨씬 효율적입니다.
실무적으로는 다음 세 단계를 따라보세요. 먼저 5단계 점검법으로 플랫폼 스케줄링, 모델 분산, 그리고 본인의 사용 방식을 구분합니다. 그다음 할당량이 소진되었을 때 API로 보완하며, 핵심 작업은 high 또는 xhigh 단계로 고정하세요. 마지막으로 고정 접두사, prompt_cache_key, 그리고 Batch 처리를 통해 비용을 절감합니다. 이렇게 하면 구독 서비스의 정책이 어떻게 바뀌더라도 여러분의 핵심 워크플로우는 안정적으로 유지될 것입니다.
안정적인 보완 채널이 필요하시다면, APIYI(apiyi.com)를 통해 풀버전 gpt-6-astra를 호출해 보세요. 해당 플랫폼은 OpenAI 및 Azure의 공식 API를 그대로 중계하며, 공식 인터페이스와 완벽하게 호환되고 캐시 적중률이 높아 ChatGPT나 Codex 구독 외의 신뢰할 수 있는 대안으로 적합합니다.
참고 자료:
- OpenAI 모델 문서 (gpt-6-astra): developers.openai.com/api/docs/models/gpt-6-astra
- OpenAI 도움말 센터 Astra 사용량 설명: help.openai.com
- Decrypt의 Astra 지능 저하 논란 보도: decrypt.co
- Microsoft Foundry 프롬프트 캐싱 문서: learn.microsoft.com
- APIYI 모델 문서: docs.apiyi.com
저자 소개: APIYI 기술팀, AI 대규모 언어 모델 API 연동 및 엔지니어링 실무 전문. APIYI(apiyi.com)를 통해 gpt-6-astra 호출 최적화 및 비용 절감 노하우를 공유하고 있습니다.