gpt-6-astra 于 2026 年 9 月 3 日发布、次日全量开放,上线仅一周,社交媒体上就出现了大量“gpt-6-astra 降智了”的吐槽:同样的提示词,输出质量不如首发那几天;Extra high 推理档位跑得更快了,结果却更粗糙。与此同时,ChatGPT 和 Codex 的 Astra 额度比上一代 GPT-5.6 Sol 明显收紧,很多开发者干到一半就被限额卡住。本文将介绍 判断 gpt-6-astra 是否真的降智的 5 步排查法,以及额度用完后用官方直转 API 临时补位的方案,帮你把工作流稳定下来。
核心价值:读完本文,你将能区分“真降智”和“感知偏差”,知道订阅额度的真实边界,并学会用可控的推理强度和缓存策略,以合理成本调用满血版 gpt-6-astra。
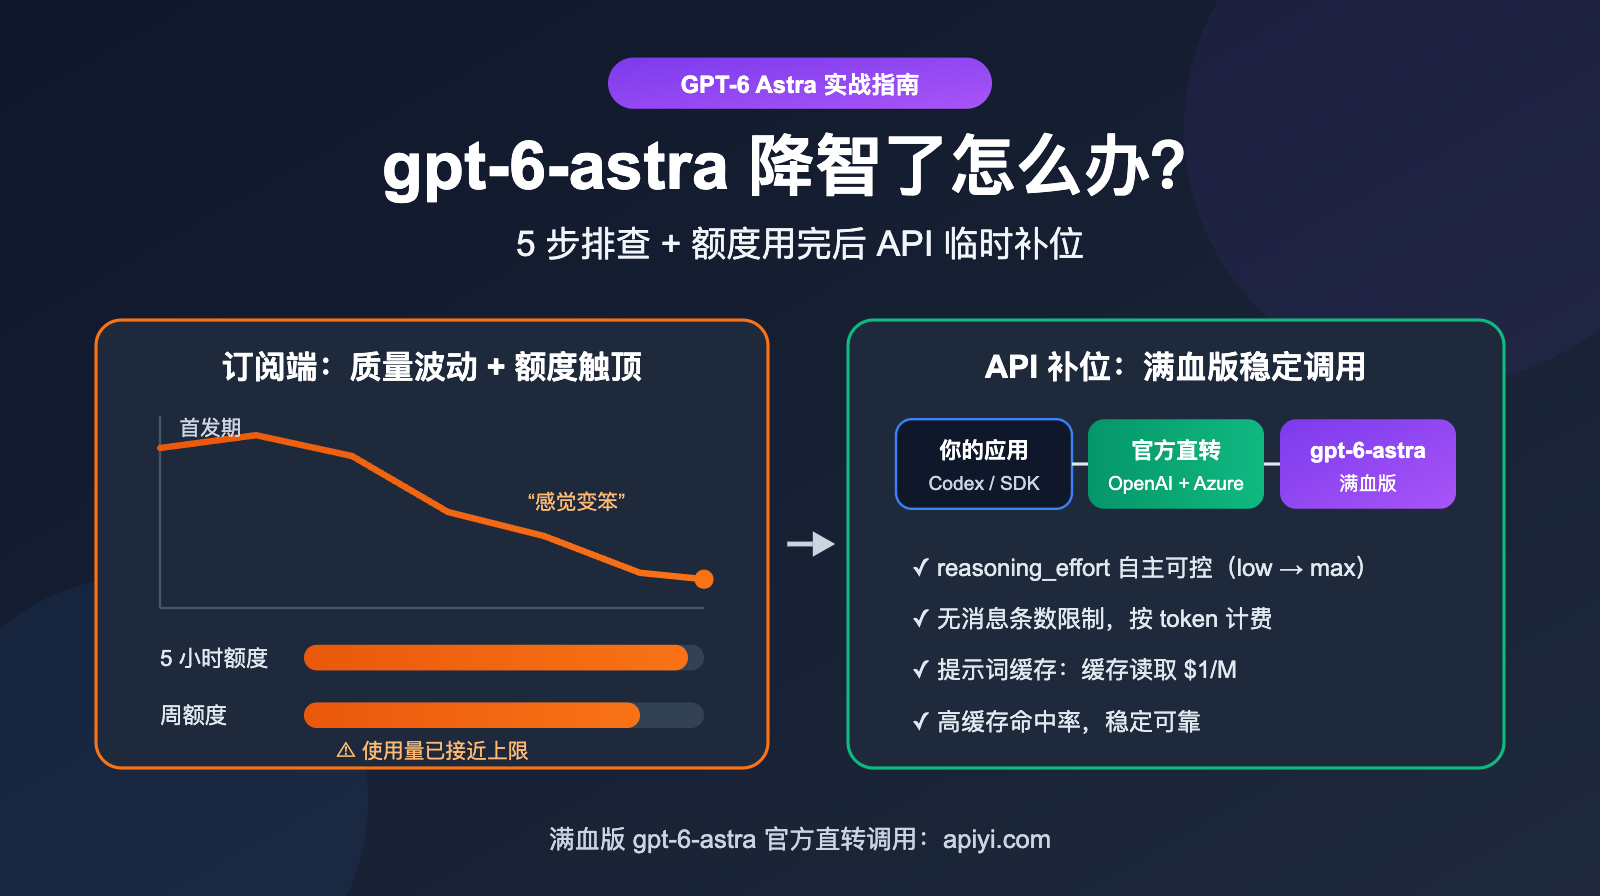
gpt-6-astra 降智争议核心要点
在动手排查之前,先把目前已知的事实摆清楚。根据 Decrypt 等海外媒体的整理,Astra 发布一周后开始出现集中投诉,部分开发者(包括 opencode 团队)因为成本翻倍、质量不及预期而切回了 GPT-5.6 Sol。但截至发稿,OpenAI 尚未就 Astra 发布正式说明,也有不少资深用户认为模型本身没有变化,只是“蜜月期”过后大家开始注意到它的失误。
| 要点 | 已知事实 | 对你的意义 |
|---|---|---|
| 发布时间 | 2026-09-03 向获批用户开放,09-04 全面可用 | 模型仍处于上线初期,服务端策略可能频繁调整 |
| 降智投诉 | 用户反馈同提示词输出变差、高推理档位耗时缩短 | 需要用可复现的方式验证,不能只凭感觉 |
| 官方回应 | 暂无针对 Astra 的正式声明 | 无法确认是否调整过默认推理强度 |
| 历史先例 | 2026 年 7 月 Sol 也遭遇同类质疑,OpenAI 否认刻意削弱,但承认会实验“推理强度”设置 | ChatGPT 端的推理预算并非由你完全掌控 |
| 额度收紧 | Plus 在 Work/Codex 中约 5-45 条/5 小时,约为 Sol 时期的一半 | 重度用户很容易在高峰期触顶 |
gpt-6-astra 为什么会“感觉变笨”
模型权重被偷偷替换的可能性其实很低,更常见的原因出在“推理预算”上。gpt-6-astra 在 API 中支持 low、medium、high、xhigh、max 五档推理强度,档位越高,模型在作答前的思考步骤越多,质量和耗时同步上升。在 ChatGPT 和 Codex 这类订阅产品里,推理预算由平台统一调度,一旦平台为了应对算力压力而下调实际预算,用户看到的就是“更快但更粗糙”的结果,这与投诉内容高度吻合。
另一方面,Theo 等开发者指出,Astra 本身的输出方差就比较大,同一个任务既可能给出惊艳的结果,也可能犯低级错误。首发时大家容易记住惊艳的案例,用久了之后失败案例被放大,这种心理落差同样会被解读为“降智”。所以排查的关键,是把“平台调度”“模型方差”“自身用法”三个变量拆开来看。
gpt-6-astra 降智 5 步排查法
下面这套流程适合在你怀疑 gpt-6-astra 降智时按顺序执行,每一步都能排除一类原因,避免盲目切换模型。
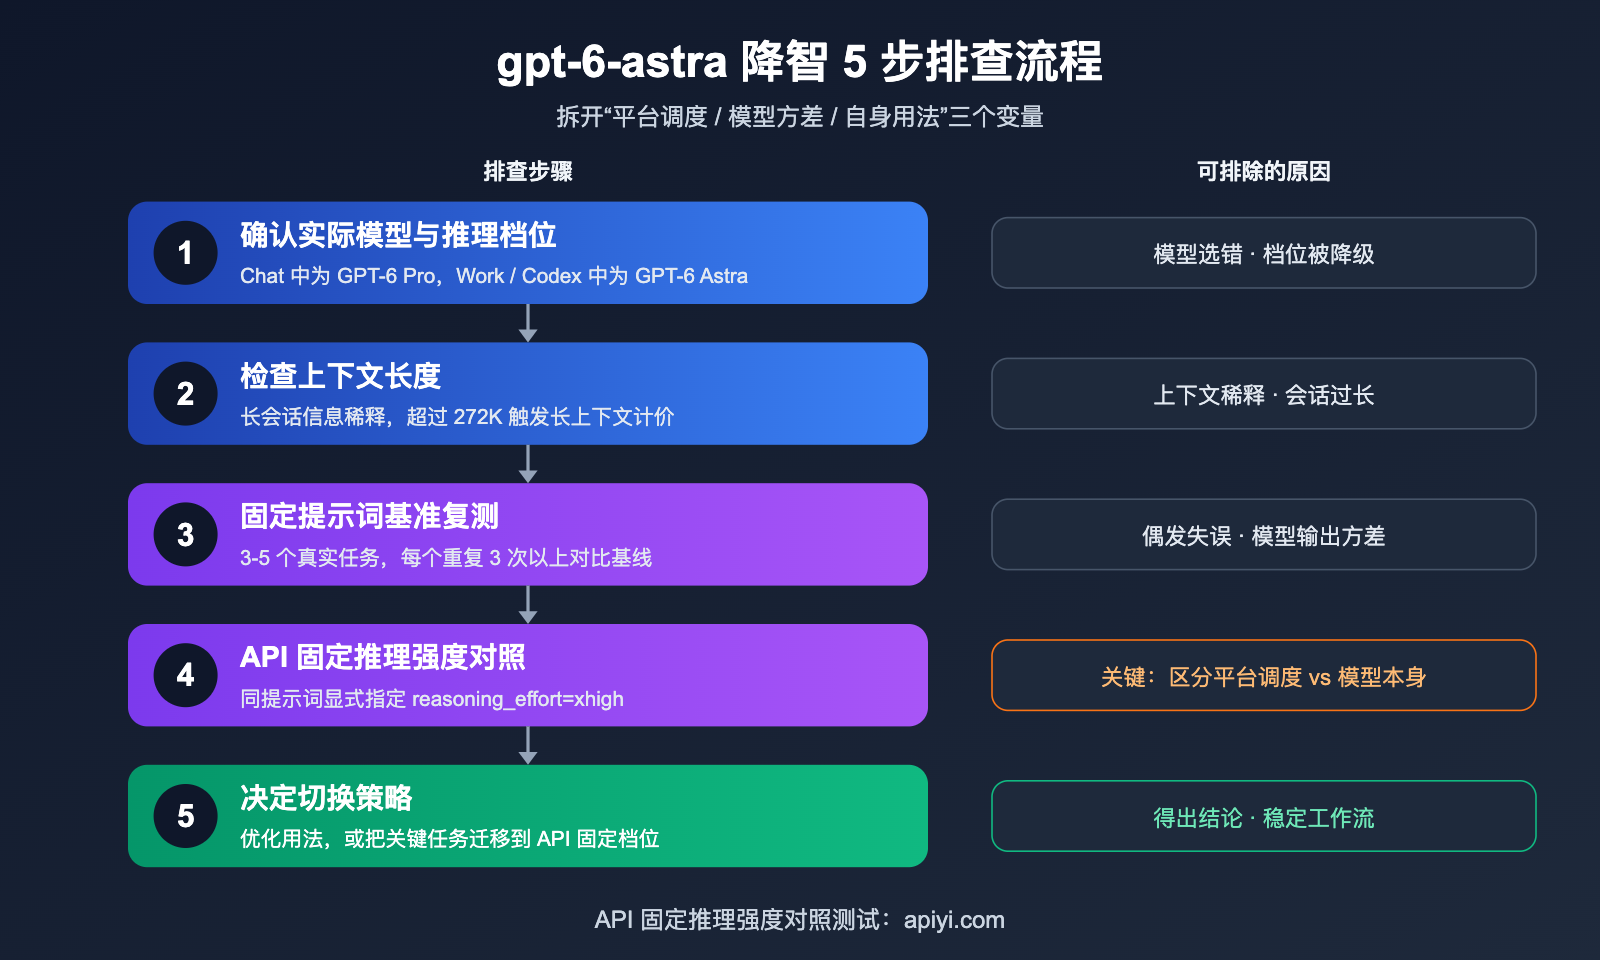
- 确认实际使用的模型和档位:在 ChatGPT 中,Astra 在 Chat 里以 GPT-6 Pro 的名称出现,在 Work 与 Codex 中则是 GPT-6 Astra,两者配额体系不同。先确认你当前对话到底跑的是哪个模型、选的是哪一档思考强度,额度紧张时界面是否已经提示降级。
- 检查上下文是否过长:Astra 的上下文窗口为 1,050,000 tokens,但长会话里早期信息被稀释是所有大模型的通病。如果一个 Codex 会话已经持续了几个小时,先开新会话、精简背景材料再测。
- 用固定提示词做基准复测:挑 3-5 个你熟悉的真实任务,保存首发期的输出作为基线,同一提示词重复跑 3 次以上,看是稳定变差还是偶发失误。单次对比几乎没有统计意义。
- 用 API 固定推理强度做对照:通过 API 显式指定
reasoning_effort,在相同提示词下对比 ChatGPT 端的输出。如果 API 的xhigh结果明显优于订阅端,问题大概率出在平台侧的推理预算,而非模型本身。 - 根据结论决定策略:属于自身用法问题就优化提示词和会话管理;属于平台调度或额度问题,就把关键任务迁移到可控的 API 调用上。
| 现象 | 最可能原因 | 验证方法 | 建议动作 |
|---|---|---|---|
| 回答变快但推理变浅 | 实际推理预算被下调 | API 指定 xhigh 对照 |
关键任务改走 API 并固定档位 |
| 长会话后期频繁出错 | 上下文稀释或超过 272K 区间 | 新开会话复测 | 拆分任务、精简上下文 |
| 同一任务时好时坏 | 模型输出方差较大 | 同提示词跑 3-5 次 | 增加校验步骤或多次采样 |
| 突然提示用量不足 | 5 小时或周额度触顶 | 查看用量面板 | 等待重置或切换 API 补位 |
| 代码质量明显回退 | 档位被切换或提示词漂移 | 对比首发期基线 | 固化系统提示词与档位 |
🎯 排查建议:第 4 步是区分“平台问题”与“模型问题”的关键。我们建议通过 API易 apiyi.com 用同一套提示词分别跑
high和xhigh两档,该平台以纯官方直转方式提供 gpt-6-astra,调用参数与 OpenAI 原生接口一致,对照结果更有说服力。
gpt-6-astra 额度用完了怎么办
即便模型没有降智,额度问题也足以打断工作节奏。根据海外媒体和社区汇总的信息,Astra 在 ChatGPT Work 与 Codex 中采用“5 小时滚动额度 + 周额度”的双重限制,两者都有剩余才能继续使用;此外有报道称在 9 月 5 日全员额度重置后,部分重度用户的上限被进一步收紧。下表为社区整理的估算值,实际以 OpenAI 官方用量面板为准。
| 订阅方案 | Work/Codex 中 Astra 估算额度 | Chat 中 GPT-6 Pro | 适合人群 |
|---|---|---|---|
| Plus | 约 5-45 条 / 5 小时 | 不提供 | 轻度体验、偶尔处理复杂任务 |
| Pro $100 | 约 25-225 条 / 5 小时 | 约 50 条 / 周 | 日常开发主力 |
| Pro $200 | 约 100-900 条 / 5 小时 | 约 200 条 / 周 | 全天候重度使用 |
| API 按量计费 | 无消息条数限制,受 RPM/TPM 约束 | 不适用 | 批量任务、关键任务、临时补位 |
区间跨度之所以这么大,是因为一条消息消耗的额度取决于任务复杂度、推理档位和上下文长度,一次跑满 40 分钟的电脑操作任务,和一次简单问答的消耗完全不是一个量级。对于大多数开发者来说,为了偶尔的额度高峰去升级到 $200 方案并不划算,更经济的做法是保留现有订阅,在额度耗尽时用 API 按量补位。
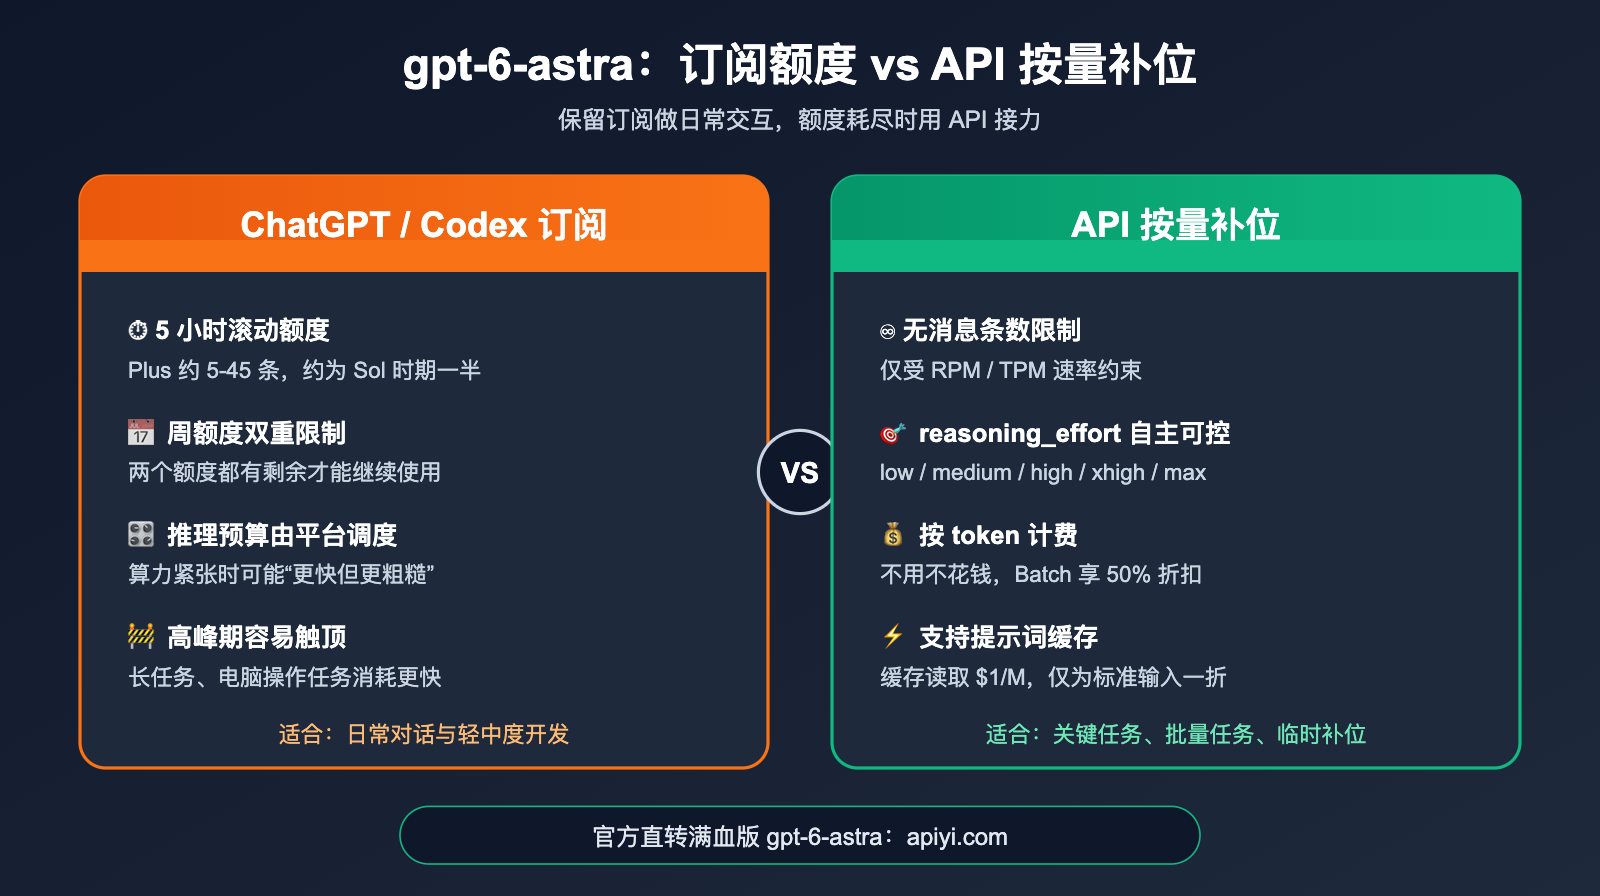
gpt-6-astra API 补位的三个优势
用 API 临时补位,不只是“多了一份额度”,更重要的是换回了控制权。首先,推理强度由你显式指定,不会被平台静默调整,这正好对冲了“降智”的不确定性。其次,API 按 token 计费,不用的时候不花钱,适合额度高峰这种间歇性需求。第三,API 支持 Batch、提示词缓存等成本优化手段,长期跑下来成本可控。
选择渠道时,关键看是否为官方直转。部分第三方渠道可能使用逆向接口或将请求路由到其他模型,这会让“降智”问题雪上加霜。API易 apiyi.com 提供的 gpt-6-astra 为满血版,纯官方直转 OpenAI 与 Azure 双线路,接口参数与官方完全一致,适合作为订阅之外的稳定补充。
gpt-6-astra API 快速上手
gpt-6-astra 支持 Chat Completions、Responses 和 Batch 三个端点,输入支持文本与图像,输出为文本。下面的极简示例使用 OpenAI 官方 SDK,只需替换 base_url 和密钥即可运行。
gpt-6-astra 极简调用示例
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

response = client.chat.completions.create(
    model="gpt-6-astra",
    reasoning_effort="xhigh",  # low / medium / high / xhigh / max
    messages=[
        {"role": "system", "content": "你是一名资深后端工程师,回答需给出可运行代码。"},
        {"role": "user", "content": "用 Python 实现一个带过期时间的 LRU 缓存"}
    ]
)
print(response.choices[0].message.content)
print(response.usage)  # 关注 prompt_tokens_details.cached_tokens
查看完整代码:带缓存键、重试与用量统计的封装
import time
from openai import OpenAI, APIError, RateLimitError

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 固定的长系统提示词放在最前面,便于命中提示词缓存
SYSTEM_PROMPT = open("system_prompt.md", encoding="utf-8").read()


def ask_astra(user_input: str,
              effort: str = "high",
              cache_key: str = "project-alpha-v1",
              max_retries: int = 3) -> str:
    """调用 gpt-6-astra,固定推理强度并复用缓存键"""
    for attempt in range(max_retries):
        try:
            resp = client.chat.completions.create(
                model="gpt-6-astra",
                reasoning_effort=effort,
                prompt_cache_key=cache_key,
                messages=[
                    {"role": "system", "content": SYSTEM_PROMPT},
                    {"role": "user", "content": user_input},
                ],
            )
            usage = resp.usage
            cached = 0
            if usage.prompt_tokens_details:
                cached = usage.prompt_tokens_details.cached_tokens or 0
            hit_rate = cached / usage.prompt_tokens if usage.prompt_tokens else 0
            print(f"输入 {usage.prompt_tokens} | 缓存 {cached} "
                  f"| 命中率 {hit_rate:.1%} | 输出 {usage.completion_tokens}")
            return resp.choices[0].message.content
        except RateLimitError:
            wait = 2 ** attempt
            print(f"触发限流,{wait} 秒后重试")
            time.sleep(wait)
        except APIError as e:
            print(f"接口错误:{e}")
            time.sleep(1)
    raise RuntimeError("多次重试仍失败")


if __name__ == "__main__":
    tasks = [
        "审查这段 SQL 的索引使用情况:SELECT ...",
        "为订单服务设计幂等重试方案",
    ]
    for t in tasks:
        print(ask_astra(t, effort="xhigh")[:200])
💡 上手建议:首次调用建议先用
medium档位跑通链路,再按任务难度逐步上调。可以在 API易 apiyi.com 注册后获取测试额度,确认输出质量符合预期后再迁移正式任务。
在 Codex 中切换 gpt-6-astra API 补位
如果你主要在 Codex CLI 中使用 Astra,额度用完后不必中断工作,可以在 ~/.codex/config.toml 中配置自定义模型提供方,改用 API 密钥继续干活:
model = "gpt-6-astra"
model_provider = "apiyi"
model_reasoning_effort = "high"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
配置完成后执行 export APIYI_API_KEY=你的密钥 再启动 Codex 即可。订阅额度重置后,把 model_provider 注释掉就能切回原来的登录方式,两种模式可以按需来回切换。
gpt-6-astra 推理强度怎么选
推理强度直接决定质量、耗时与成本,建议按任务类型分档,而不是一律拉满。
| 推理强度 | 典型场景 | 质量表现 | 耗时与成本 |
|---|---|---|---|
| low | 格式转换、简单问答、信息抽取 | 满足基础需求 | 最低 |
| medium | 日常代码补全、文档撰写 | 均衡 | 较低 |
| high | 复杂重构、架构设计、数据分析 | 稳定可靠 | 中等 |
| xhigh | 疑难 Bug 定位、长链路 Agent 任务 | 接近首发体验 | 较高 |
| max | 数学证明、安全审计、高价值决策 | 上限最高 | 最高,需控制调用频次 |
🎯 选型建议:如果你怀疑订阅端“降智”,可以把原本在 ChatGPT 里跑的关键任务固定在
xhigh档位调用。通过 API易 apiyi.com 调用时,推理强度完全由请求参数决定,便于把质量波动控制在可解释的范围内。
gpt-6-astra 成本控制与缓存命中率优化
gpt-6-astra 的官方价格为输入 $10、输出 $50(每百万 tokens),是 GPT-5.6 Sol 首发价格的数倍,因此补位用 API 时成本控制必须前置考虑。好消息是 Astra 的缓存输入价格只有 $1,相当于标准输入价的一折,缓存命中率高低会直接拉开账单差距。
| 计费项 | 官方价格(每百万 tokens) | 说明 |
|---|---|---|
| 标准输入 | $10 | 输入不超过 272K tokens 时适用 |
| 缓存读取 | $1 | 命中提示词缓存的部分,节省 90% |
| 缓存写入 | $12.5 | 新写入缓存的前缀,略高于标准输入 |
| 标准输出 | $50 | 包含推理 tokens |
| 长上下文 | 输入与缓存 2 倍、输出 1.5 倍 | 输入超过 272K tokens 时触发 |
| Batch / Flex | 标准价的 50% | 适合不要求实时返回的任务 |
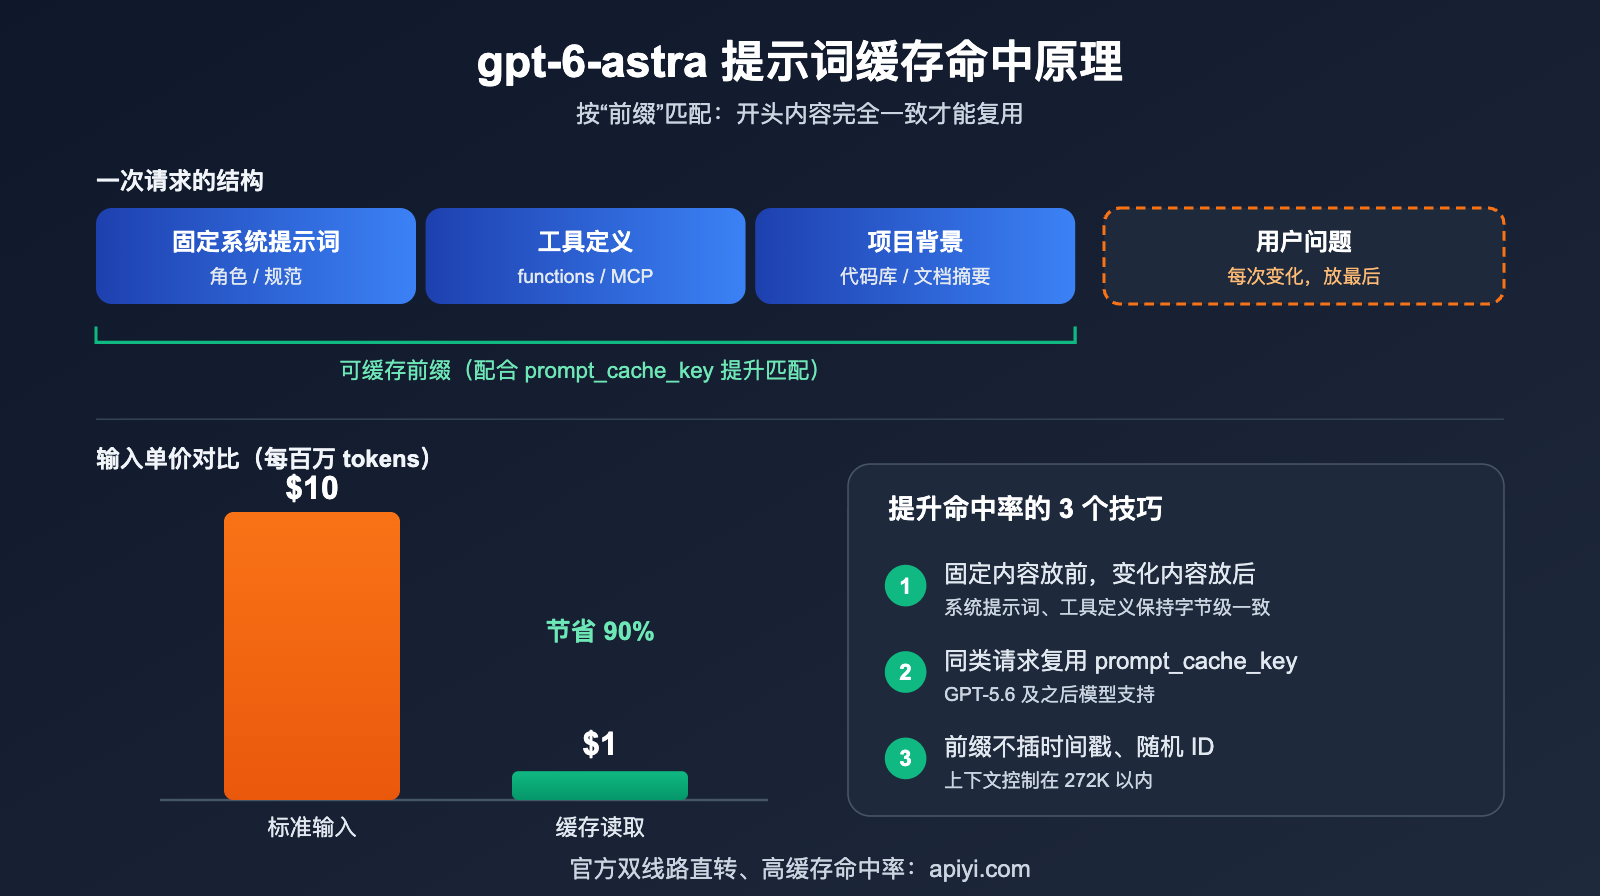
提升 gpt-6-astra 缓存命中率的 4 个技巧
提示词缓存按“前缀”匹配,只要请求开头的内容完全一致,就能复用之前的计算结果。围绕这一机制,可以从以下几个方面优化:
- 固定内容放前面:系统提示词、工具定义、项目规范等不变的内容放在消息最前面,用户问题、时间戳等变化内容放在最后。
- 使用 prompt_cache_key:GPT-5.6 及之后的模型支持该参数,对共享长前缀的请求使用相同的缓存键,能显著提升匹配概率。
- 避免在前缀里插入动态值:在系统提示词里写入当前时间、随机 ID,会让每次请求的前缀都不同,缓存直接失效。
- 控制上下文在 272K 以内:超过该阈值会触发长上下文计价,缓存读取价格也会翻倍,长文档建议先做检索再送入模型。
缓存命中率还与底层线路的稳定性有关,如果请求在不同后端之间频繁漂移,缓存很难持续命中。API易 apiyi.com 采用 OpenAI 与 Azure 官方双线路直转,并针对 gpt-6-astra 做了缓存友好的路由优化,在固定前缀的场景下可以获得较高的缓存命中率,你可以通过响应中的 cached_tokens 字段直接核对效果。
gpt-6-astra 降智与补位常见问题
Q1:gpt-6-astra 真的被 OpenAI 降智了吗?
目前没有官方证据证明模型权重被替换,OpenAI 也尚未发表正式说明。更可能的解释是订阅端推理预算的调度变化,叠加模型本身的输出方差。建议用本文的 5 步排查法,用 API 固定档位做对照后再下结论。
Q2:通过 API 调用的 gpt-6-astra 和 ChatGPT 里的是同一个模型吗?
是同一个模型,区别在于 API 允许你显式指定推理强度,而订阅产品的推理预算由平台调度。API易 apiyi.com 提供的是纯官方直转的满血版 gpt-6-astra,推理强度完全按你传入的参数执行。
Q3:订阅额度和 API 可以同时使用吗?
可以,两者相互独立。比较推荐的做法是日常交互继续用订阅额度,额度耗尽或需要批量处理时切换到 API,Codex 中通过配置文件即可快速切换。
Q4:用 API 补位会不会很贵?
取决于用法。控制推理档位、提高缓存命中率、把非实时任务放进 Batch,能把成本压低一半以上。建议先在 API易 apiyi.com 用少量真实任务测算单次成本,再决定补位规模。
Q5:gpt-6-astra 和 GPT-5.6 Sol 该怎么搭配?
Sol 价格低很多,适合常规编码和批量任务;Astra 在电脑操作、复杂推理和长链路 Agent 任务上优势明显。可以把 Sol 作为默认模型,只在难题上升级到 Astra,这样既保证质量又控制成本。
总结:把 gpt-6-astra 的不确定性变成可控变量
gpt-6-astra 是 OpenAI 目前能力最强的旗舰模型,但上线初期的“降智”争议和额度收紧,暴露了订阅产品的一个本质特点:推理预算和使用上限都由平台决定,用户只能被动接受。面对这种情况,与其反复猜测模型是不是变笨了,不如用固定提示词和固定推理档位建立自己的质量基线。
实操上可以分三步走:先用 5 步排查法区分平台调度、模型方差和自身用法;再在额度耗尽时用 API 补位,把关键任务固定在 high 或 xhigh 档位;最后通过固定前缀、prompt_cache_key 和 Batch 把成本压下来。这样无论订阅端如何调整,你的核心工作流都能保持稳定。
如果你需要一个稳定的补位渠道,推荐通过 API易 apiyi.com 调用满血版 gpt-6-astra。该平台纯官方直转 OpenAI 与 Azure,接口与官方完全兼容,缓存命中率高,适合作为 ChatGPT 和 Codex 订阅之外的可靠补充。
参考资料:
- OpenAI 模型文档(gpt-6-astra): developers.openai.com/api/docs/models/gpt-6-astra
- OpenAI 帮助中心 Astra 用量说明: help.openai.com
- Decrypt 关于 Astra 降智争议的报道: decrypt.co
- Microsoft Foundry 提示词缓存文档: learn.microsoft.com
- API易 模型文档: docs.apiyi.com
作者简介:APIYI 技术团队,专注 AI 大模型 API 接入与工程化实践。欢迎通过 API易 apiyi.com 交流 gpt-6-astra 的调用优化与成本控制经验。