ملخص: تقارن هذه المقالة Qwen4-Max-Preview بالنسخة الرسمية Qwen4-Max في سقف الإخراج وإعدادات الاستدلال والفوترة، وتقدّم خطوات هجرة قابلة للتنفيذ بندًا بندًا قبل إيقاف Qwen4-Max-Preview في 25 نوفمبر.
ستنتهي فترة المعاينة الخاصة بـ Qwen4-Max-Preview ويُوقف تشغيله في 25 نوفمبر 2026، الساعة 24:00 (UTC+8). وقد أصبحت النسخة الرسمية Qwen4-Max متاحة في 16 نوفمبر، ومعرّف النموذج هو qwen4-max. عند الانتقال إلى النسخة الرسمية، يجب فحص خمسة عناصر في الوقت نفسه: المنتجات المتصلة، وسقف الإخراج، وإعدادات الاستدلال الافتراضية، وسلوك الأدوات، والتكلفة. يوفّر كلا الإصدارين نافذة سياق تبلغ مليون Token، لكن سقف الإخراج في وضع التفكير بالنسخة الرسمية انخفض من 393,216 إلى 262,144، كما تغيّر جهد الاستدلال الافتراضي من xhigh إلى high، وتوسّعت الفوترة من Token Plan Credits لتشمل الدفع حسب الاستخدام. لا يكفي تغيير معرّف النموذج وحده لضمان بقاء أداء مهام الإنتاج متطابقًا.
نستعرض فيما يلي أولاً الجدول الزمني والاختلافات في المواصفات بين Qwen4-Max-Preview والنسخة الرسمية، ثم نقدّم بروتوكول API والمناطق والأسعار والتخزين المؤقت للنسخة الرسمية. بعد ذلك، نضع قائمة الهجرة بالترتيب التالي: «حفظ خط الأساس، إعدادات التكامل، معاملات الطلب، التحقق من الوظائف، مراقبة الفواتير، التبديل التدريجي». ونختتم بمعايير القبول لمهام مثل التقارير الطويلة، وتوليد الشيفرة، ومهام الوكيل متعدد الجولات (Agent). وبعد القراءة، يمكنك تحويل هذا التبديل إلى عملية إدارة إصدارات نماذج قابلة لإعادة الاستخدام داخل الفريق.
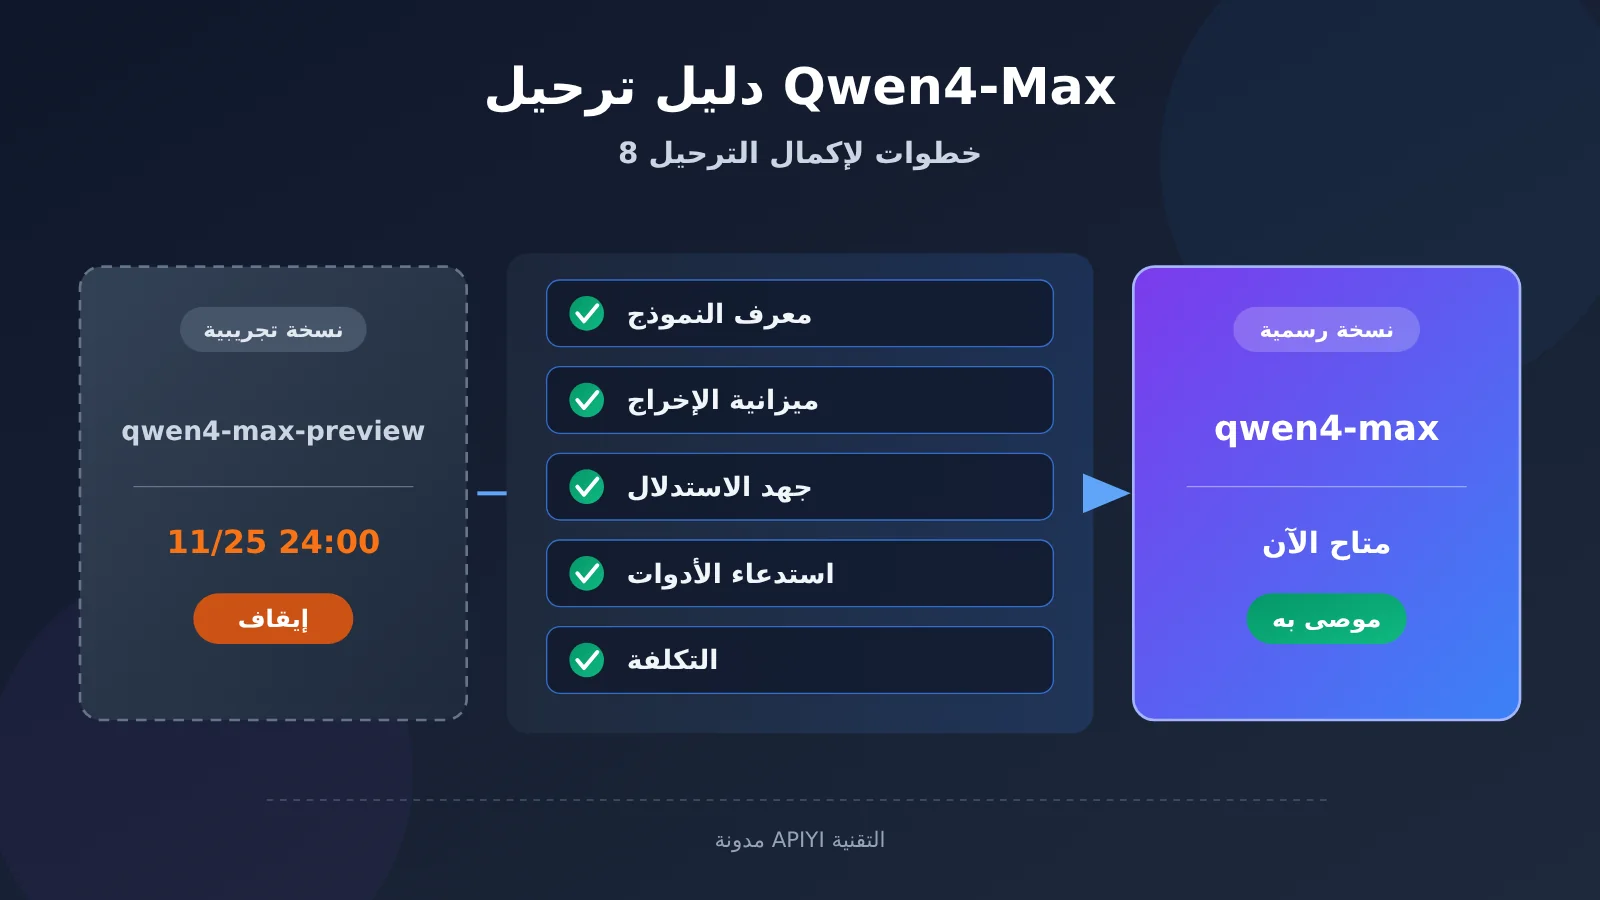
للاطلاع: مصطلحات الترحيل إلى Qwen4-Max
| المصطلح | الشرح |
|---|---|
| Model ID | المعرّف الذي يُستخدم في الطلب لتحديد إصدار النموذج بدقة، مثل qwen4-max. |
| Base URL | العنوان الأساسي للواجهة التي يتصل بها العميل عند استخدام منتج معيّن أو خدمة في منطقة معيّنة. |
| نافذة السياق | السعة الإجمالية التي يستطيع النموذج معالجتها في الطلب الواحد، بما في ذلك المدخلات والسجل والمحتوى المُولَّد. |
| ميزانية المخرجات | الحد الأعلى لعدد Token التي يُسمح بتوليدها في الطلب الواحد. وفي وضع التفكير، تتقاسم مخرجات الاستدلال والرد النهائي هذه الميزانية. |
| reasoning_effort | معامل في الطلب يتحكم في شدة الاستدلال. وتختلف قيمته الافتراضية بين Preview والإصدار الرسمي. |
| thinking_budget | معامل يتحكم في ميزانية Token المخصصة للتفكير. وفي Preview لا يمكن ضبطه في الوقت نفسه مع reasoning_effort. |
| Token Plan | خدمة اشتراك من Alibaba Cloud Bailian تُحتسب بـ Credits، وهي أيضاً القناة الوحيدة للوصول إلى Preview. |
| Function Calling | آلية يعيد فيها النموذج طلب استدعاء وفقاً لتعريف الأداة، فينفّذ التطبيق الأداة ويعيد النتيجة إليه. |
| JSON Schema | مواصفة تصف بنية JSON وحقولها وقيودها، وتُستخدم لتقييد صيغة مخرجات النموذج. |
| TTL | مدة الاحتفاظ بالذاكرة المؤقتة (cache)، وتؤثر في نطاق إعادة استخدامها وفي التكلفة المقابلة. |
| التحقق الانحداري | فحص التغييرات في الوظائف والنتائج والتكاليف بعد تبديل الإصدار، باستخدام مهام تمثيلية جاهزة. |
1 متى ينتهي Qwen4-Max-Preview ومتى يُطلق الإصدار الرسمي
1.1 الجدول الزمني لإصدارات Qwen4-Max
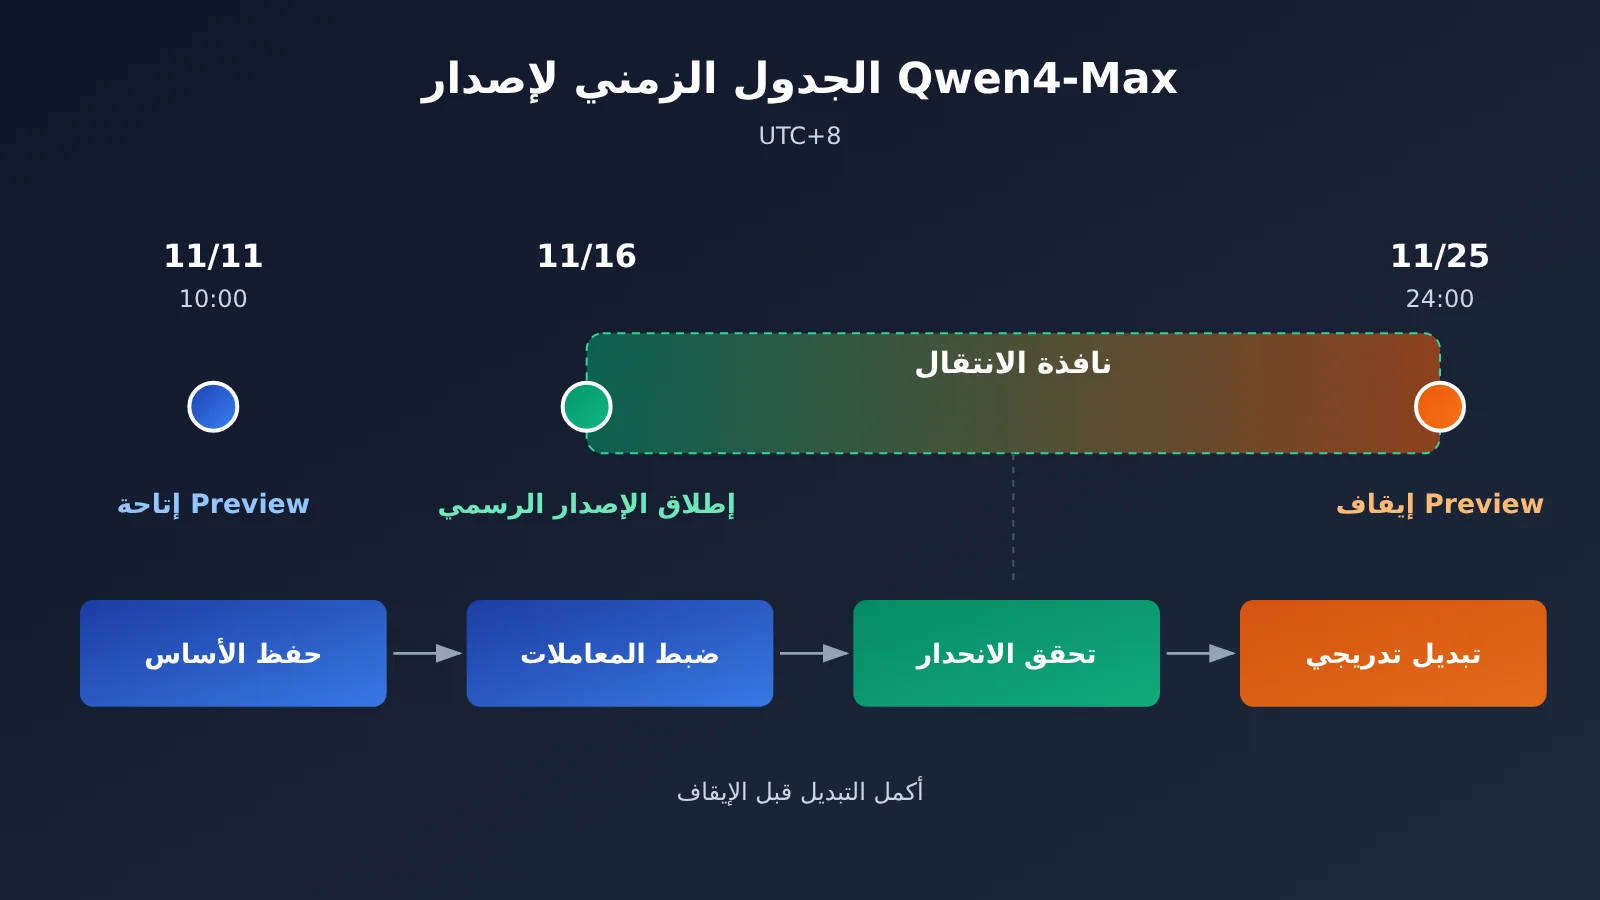
يسرد سجل تحديثات الميزات في Alibaba Cloud Token Plan حدثين مستقلين: إطلاق Preview في 11 نوفمبر، وإطلاق الإصدار الرسمي في 16 نوفمبر. وبعد إصدار النسخة الرسمية، لم يتغيّر موعد إيقاف Preview المقرر أصلاً. كما يظهر تنبيه في أعلى الوثائق الرسمية لـ Preview: “تم إطلاق الإصدار الرسمي Qwen4-Max، ويُنصح باستخدام الإصدار الرسمي”.
| الوقت (UTC+8) | الحدث | المعنى للمطورين |
|---|---|---|
| 2026-11-11 10:00 | فتح Qwen4-Max-Preview | لا يمكن استدعاؤه إلا عبر Token Plan للنسخة الشخصية أو نسخة الفريق |
| 2026-11-16 | إطلاق الإصدار الرسمي Qwen4-Max | يدعم API بالدفع حسب الاستخدام، ويمكن استخدامه أيضاً عبر Token Plan |
| 2026-11-25 24:00 | انتهاء فترة معاينة Preview وإيقافه | لم يعد qwen4-max-preview قابلاً للاستدعاء، ولا يمكن استخدامه كهدف للرجوع إليه |
1.2 معرّفا النموذج وقنوات كل منهما
معرّف النموذج في Preview هو qwen4-max-preview، والاسم المستعار qwen4.0-max-preview. يمكن استدعاء كلا المعرّفين، ويظهران في الفاتورة موحّدين باسم qwen4.0-max-preview. وطريقة الوصول إلى Preview هي مفتاح API مخصص لـ Token Plan بالإضافة إلى Base URL مخصص https://token-plan.cn-beijing.maas.aliyuncs.com، ولا يدعم الدفع حسب الاستخدام.
معرّف النموذج في الإصدار الرسمي هو qwen4-max. ويوفّر الإصدار الرسمي مسارين للاستخدام: الأول Token Plan للنسخة الشخصية أو نسخة الفريق، والثاني API بالدفع حسب الاستخدام من Bailian. تختلف هذان المساران في مفتاح API وBase URL وطريقة الفوترة، لذا يجب تحديد المسار أولاً عند الترحيل.
2 الفروق في المواصفات بين Qwen4-Max-Preview والنسخة الرسمية
2.1 جدول مقارنة مواصفات Qwen4-Max
البيانات التالية مأخوذة من الوثائق الرسمية للنموذج لكل من Preview والنسخة الرسمية.
| المؤشر التقني | Qwen4-Max-Preview | Qwen4-Max النسخة الرسمية |
|---|---|---|
| Model ID | qwen4-max-preview |
qwen4-max |
| نافذة السياق | 1,000,000 | 1,000,000 |
| أقصى إدخال (الوضع غير التفكيري / وضع التفكير) | لم تُدرَج منفصلة في الوثائق | 991,808 / 983,616 |
| أقصى إخراج (في الوضع غير التفكيري) | لم تُدرَج منفصلة في الوثائق | 131,072 |
| أقصى مجموع للتفكير + الإجابة | 393,216 | 262,144 |
| جهد الاستدلال الافتراضي | xhigh | high |
| ميزانية التفكير الافتراضية | حسب معاملات واجهة Preview | 131,072 |
| بروتوكول API | OpenAI Chat Completions، Responses، Anthropic Messages | الثلاثة السابقة + DashScope |
| طريقة الفوترة | ائتمانات Token Plan فقط | API بالدفع حسب الاستخدام، أو Token Plan |
2.2 الفرق بين السياق والإدخال والإخراج وميزانية التفكير
هذه الأرقام الأربعة تقيس أشياء مختلفة، وهي الأكثر عرضة للالتباس عند الانتقال. نافذة السياق هي إجمالي السعة التي يمكن لطلب واحد معالجتها، وهي مليون في النسختين. يحدد أقصى إدخال أكبر قدر من المواد يمكن إدخاله في طلب واحد؛ وفي الوضع التفكيري للنسخة الرسمية يبلغ 983,616، وهو أقل قليلًا من الوضع غير التفكيري، إذ تُترك المساحة المتبقية للاستدلال. ويحدد أقصى إخراج أكبر عدد من الـ Tokens يمكن توليده في مرة واحدة، بينما تحدد ميزانية التفكير كم منها يمكن أن يُستخدم في الاستدلال.
أكبر تغيير يقع في جانب الإخراج. في Preview، تشترك عملية التفكير والإجابة في 393,216 Tokens، أما النسخة الرسمية فسقف المجموع في وضع التفكير هو 262,144، وميزانية التفكير الافتراضية 131,072. وبالتقدير وفق الإعداد الافتراضي، تترك النسخة الرسمية مساحة للرد النهائي تبلغ نحو 130 ألف Tokens. إذا كان عملك يعتمد على مخرجات طويلة تتجاوز 200 ألف Tokens في الطلب الواحد على Preview، فستحتاج بعد التبديل إلى إعادة تصميم طريقة الإخراج.
3 قدرات التكامل عبر API والتكلفة في النسخة الرسمية من Qwen4-Max
3.1 البروتوكولات والوظائف
تدعم النسخة الرسمية أربعة بروتوكولات: OpenAI Chat Completions وOpenAI Responses وAnthropic Messages وDashScope. أما الوظائف، فتسرد الوثائق الرسمية Function Calling واستدعاء الأدوات بالتوازي والبحث عبر الإنترنت وJSON Object وJSON Schema والتخزين المؤقت الصريح والتخزين المؤقت الضمني وملخصات سلسلة التفكير والتشفير.
مقارنةً بنسخة Preview، أضافت وثائق النسخة الرسمية شرحًا لبروتوكول DashScope واستدعاء الأدوات بالتوازي ونوعي التخزين المؤقت. إذا كان التطبيق يتعامل سابقًا مع tool_call واحد فقط، فسيحتاج الآن إلى التأكد من أن الكود يتعامل بشكل صحيح مع حالة إرجاع عدة استدعاءات أدوات في استجابة واحدة.
3.2 المناطق والتسعير حسب الاستخدام
تغطي واجهة API حسب الاستخدام في النسخة الرسمية ست مناطق. عند اختيار المنطقة، لا يقتصر الأمر على السعر؛ بل يجب أيضًا مراعاة زمن تأخر الشبكة، ومتطلبات إقامة البيانات، ونطاق نشر الخدمة. وتُحدد القدرات الدقيقة لكل منطقة وفق مصفوفة القدرات الرسمية.
| المنطقة | نطاق النشر | الإدخال (يوان/مليون Token) | الإخراج (يوان/مليون Token، بما يشمل التفكير) |
|---|---|---|---|
| شمال الصين 2 (بكين) | الصين القارية | 10 | 30 |
| الولايات المتحدة (فيرجينيا) | عالمي | 10 | 30 |
| ألمانيا (فرانكفورت) | عالمي | 10 | 30 |
| اليابان (طوكيو) | عالمي | 10 | 30 |
| هونغ كونغ الصينية | عالمي | 10 | 30 |
| سنغافورة | دولي | 10.938 | 32.813 |
تذكر الصفحة الرسمية لمنطقة بكين حصة مجانية قدرها مليون Token، صالحة لمدة 90 يومًا. ويُحسب تاريخ البدء من أحدث هذه الشروط: تفعيل Bailian، أو إطلاق النموذج، أو الموافقة على الطلب. تنطبق الأسعار أعلاه على النسخة الرسمية فقط. أما سعر 20% في Preview، وتعرفة 8% بعد تطبيق خصم الليل الإضافي، فهي من مزايا Token Plan Credits، ولا يمكن استخدامها في تقدير تكلفة النسخة الرسمية.
3.3 التخزين المؤقت الصريح والضمني
يُحتسب التخزين المؤقت في النسخة الرسمية بشكل منفصل. ينشئ المطور التخزين المؤقت الصريح بنفسه، وهو مناسب للبادئات الثابتة طويلة الأمد مثل موجه النظام وتعليمات الأدوات والمواد المرجعية الثابتة. ويمكن ضبط TTL على 5 دقائق أو ساعة واحدة، وهو مدعوم في Chat Completions وResponses وAnthropic Messages. أما التخزين المؤقت الضمني، فتتعامل معه المنصة تلقائيًا بناءً على شروط مثل تكرار البادئات، دون الحاجة إلى إعداد إضافي.
في الوكيل متعدد الجولات، تحمل كل جولة تعريفات الأدوات والمواد الخلفية نفسها؛ لذا يمكن للاستخدام المعقول للتخزين المؤقت أن يخفض بوضوح تكلفة الإدخال المتكرر. ويُختار TTL حسب الفاصل بين الجلسات: استخدم 5 دقائق للجلسات كثيفة التفاعل، ويمكن اختيار ساعة واحدة لمسارات المعالجة المجمعة ذات الفواصل الطويلة.
4 خطوات الانتقال من Qwen4-Max-Preview إلى النسخة الرسمية
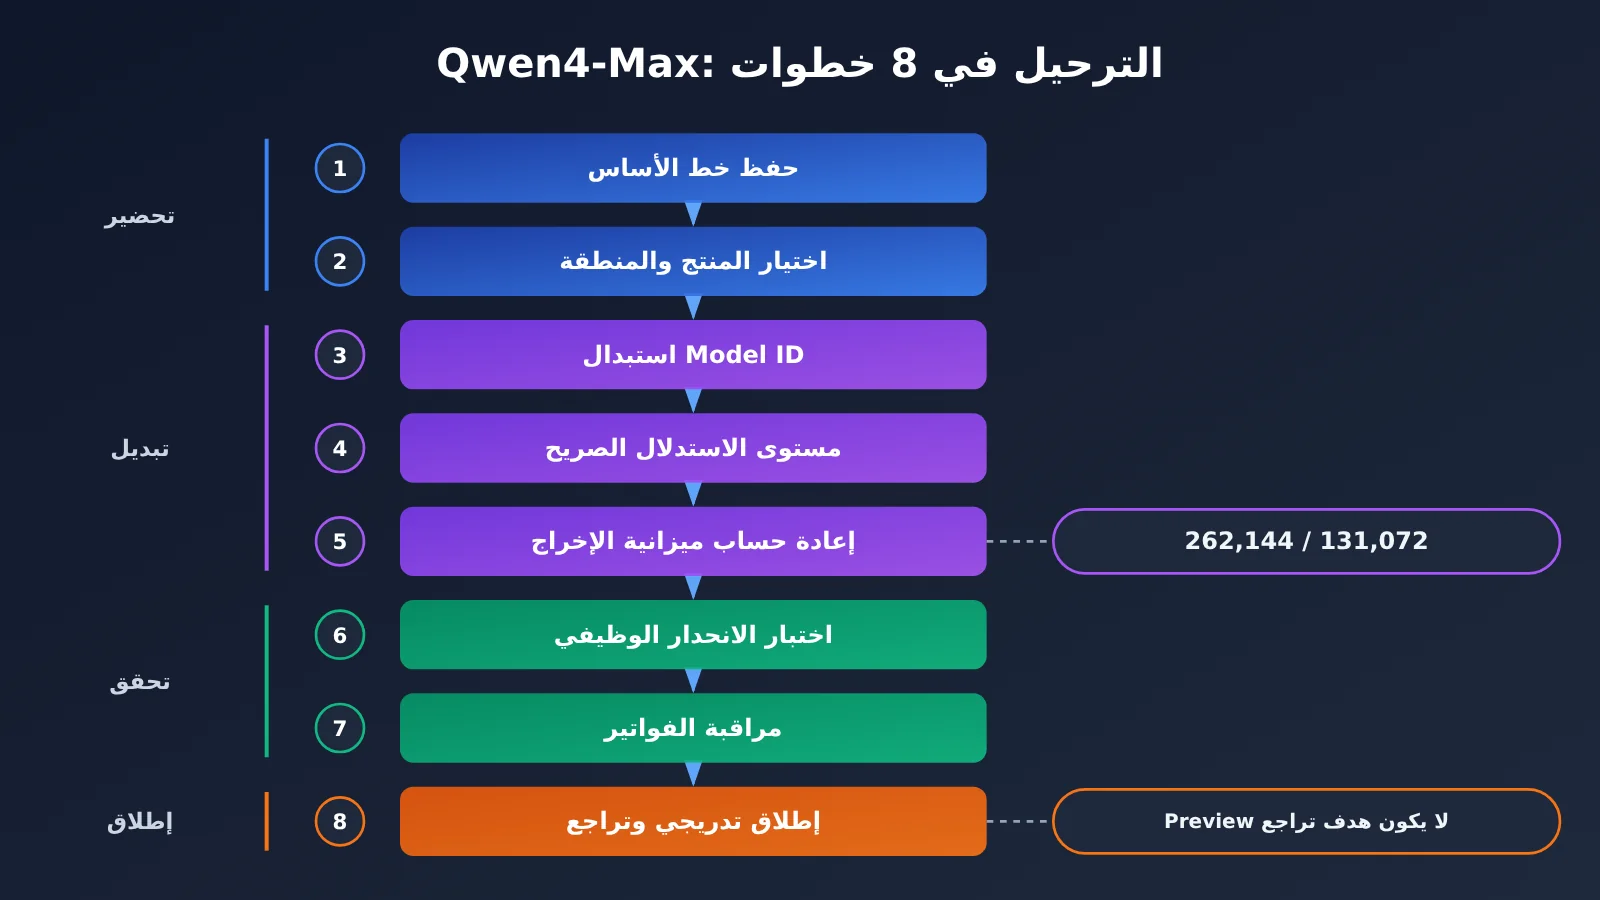
الخطوات الثماني التالية هي قائمة فحص للمطوّرين مستخلصة من المواصفات الرسمية. لم توفّر الجهة الرسمية أداة ترحيل تلقائية، ولم تُصرّح بأن جميع معاملات الطلب متوافقة بسلاسة، لذلك تحتاج كل خطوة إلى تحقّق فعلي داخل عملك الخاص.
| الخطوة | عنصر الفحص | معيار القبول |
|---|---|---|
| 1 | حفظ الإعدادات القديمة والمهام التمثيلية | معاملات طلب Preview وعيّنات المخرجات وزمن التنفيذ والاستخدام موثّقة في الأرشيف |
| 2 | اختيار منتج ال接入 والتحقق من المنطقة ومفتاح API وعنوان Base URL | تستخدم خدمات الخادم الـ API بالدفع حسب الاستخدام، وتستخدم الأدوات التفاعلية Token Plan |
| 3 | استبدال model بـ qwen4-max |
طلب الاختبار السريع يعود بنتيجة سليمة، واسم النموذج في الفاتورة صحيح |
| 4 | ضبط قوة الاستدلال صراحةً | كتابة reasoning_effort أو الحقل المقابل لكل مهمة، دون الاعتماد على القيم الافتراضية |
| 5 | إعادة حساب ميزانية المخرجات | وضع التفكير: الإجمالي ≤ 262,144، وضع عدم التفكير: ≤ 131,072 |
| 6 | التحقق من استدعاء الأدوات وبنية JSON والمخرجات الطويلة والتاريخ متعدد الأدوار | نسبة نجاح المهام التمثيلية تعادل خط الأساس في Preview |
| 7 | مراقبة الاستخدام وفواتير التخزين المؤقت | تكاليف الإدخال والإخراج والتخزين المؤقت مطابقة للمتوقع |
| 8 | التبديل بحركة مرور محدودة والاستعداد لإعدادات الرجوع | هدف الرجوع نموذج ما زال فعّالاً، وPreview ليس ضمنه |
4.1 حفظ التكوين القديم والمهام التمثيلية
قبل إيقاف Preview، صدّر جميع التكوينات التي تستدعي qwen4-max-preview حاليًا، بما في ذلك max_tokens وreasoning_effort أو thinking_budget وتعريفات الأدوات وresponse_format وموجه النظام. في الوقت نفسه، اختر من 10 إلى 30 مهمة تمثيلية، واحفظ مخرجات Preview وزمن التنفيذ والاستخدام كخط أساس للمقارنة. بعد 25 نوفمبر، لن يكون من الممكن الحصول على نتائج Preview.
4.2 اختيار منتج التكامل والتحقق من مفتاح API وBase URL
لا يسمح Token Plan بالاستخدام إلا بشكل تفاعلي داخل أدوات البرمجة أو أدوات الوكلاء مثل Claude Code وCursor وQwen Code وQoder. ولا تدخل ضمن النطاق المسموح النصوص البرمجية الآلية، ولا الواجهات الخلفية للتطبيقات المبنية ذاتيًا، ولا الاستدعاءات المجمعة من منصات سير العمل؛ وقد تؤدي المخالفة إلى تعليق الاشتراك أو حظر مفتاح API. إذا كان Preview يُستخدم فقط داخل أدوات مثل Qoder، فيمكنك الاستمرار عبر Token Plan والتبديل إلى الإصدار الرسمي. أما إذا كنت تريد ربطه بواجهتك الخلفية الخاصة، فينبغي استخدام واجهة API الرسمية ذات الدفع حسب الاستخدام، مع مفتاح API وBase URL الخاصين بالمنطقة المقابلة في لوحة التحكم.
تتضمن النسخة الشخصية من Token Plan أيضًا بندًا بشأن تفويض البيانات: أثناء الاستخدام، تُستخدم المدخلات والمحتوى المولد لتحسين الخدمة. ويجب على الفرق التي تتعامل مع بيانات سرية أن تضع هذا البند في اعتبارها عند اختيار منتج التكامل.
4.3 استبدال معرف النموذج (Model ID): بدء سريع مع Qwen4-Max
كل ما عليك فعله هو تغيير معرف النموذج إلى qwen4-max لإرسال أول طلب. فيما يلي مثال بسيط باستخدام واجهة متوافقة مع OpenAI؛ تحقق أولًا من أن الطلب يعمل بنجاح، ثم انتقل إلى ضبط المعاملات:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحدة، ويمكن استبدالها أيضًا بعنوان Base URL الخاص بمنطقة Bailian المقابلة
)

resp = client.chat.completions.create(
    model="qwen4-max",                   # القيمة الأصلية كانت qwen4-max-preview
    messages=[{"role": "user", "content": "用三句话说明你的版本信息"}],
    reasoning_effort="high",             # كتابته صراحةً وعدم الاعتماد على القيمة الافتراضية
    max_tokens=8192
)
print(resp.choices[0].message.content)
أما النماذج المتاحة ضمن الواجهة المتوافقة مع OpenAI نفسها، فالمرجع هو قائمة النماذج المحدثة على المنصة. في بيئة الإنتاج، أعد التأكد مرة أخرى قبل النشر.
4.4 ضبط معاملات الاستدلال صراحةً
القيمة الافتراضية في Preview هي xhigh، وفي الإصدار الرسمي هي high. إذا لم يحدد الكود السابق جهد الاستدلال، فستنخفض شدة الاستدلال تلقائيًا بعد التبديل، وقد يتغير مع ذلك جودة المهام المعقدة ووقتها واستهلاك الرموز. يُنصح بتحديد جهد الاستدلال حسب نوع المهمة: للمهام المعقدة في البرمجة والاستدلال العلمي، ابدأ بمقارنة مرجعية باستخدام الجهد نفسه المستخدم في Preview، ثم جرّب خفضه في مهام الاستخراج والتنسيق البسيطة.
تنص وثائق Preview على أنه لا يمكن ضبط reasoning_effort وthinking_budget في الوقت نفسه. أما أسماء الحقول وقيمها في الإصدار الرسمي ضمن بروتوكولات Chat Completions وResponses وAnthropic Messages وDashScope، فيجب الرجوع فيها إلى وثائق البروتوكول المقابل. في Preview، يتم تفعيل preserve_thinking افتراضيًا في المحادثات متعددة الجولات، ويجب إعادة محتوى التفكير التاريخي إلى حقل reasoning_content. وإذا كان تطبيقك يعيد إرسال محتوى التفكير، فتحقق أيضًا في الإصدار الرسمي من أن تنسيق الرسائل التاريخية يُقبل بشكل صحيح.
4.5 إعادة حساب ميزانية الإخراج وفق الحد الأقصى الجديد
في إصدار المعاينة (Preview)، يُعدّ max_tokens وmax_completion_tokens متكافئين، إذ يتقاسم التفكير والإجابة ميزانية إجمالية قدرها 393,216. أما في الإصدار الرسمي، فالميزانية الإجمالية لوضع التفكير تبلغ 262,144، والحد الأعلى للإخراج في الوضع غير التفكيري هو 131,072. وكل طلب كان مضبوطًا في المعاينة على قيمة تتجاوز 262,144 يجب خفضه. والطلبات التي كانت ميزانيتها ضيقة أصلًا، يجب أن تراعي أيضًا الجزء الذي تستهلكه ميزانية التفكير الافتراضية البالغة 131,072.
عرض كود إعداد الترحيل الكامل (التحقق من الميزانية + التراجع)
from openai import OpenAI

# الحدود الرسمية في الإصدار النهائي (وضع التفكير = التفكير + الإجابة معًا)
LIMITS = {
    "qwen4-max": {"thinking": 262_144, "non_thinking": 131_072},
}

def plan_max_tokens(model: str, thinking: bool,
                    answer_tokens: int, thinking_tokens: int = 0) -> int:
    """حساب max_tokens حسب الوضع؛ وإذا تجاوز الحد الرسمي يُرفع خطأ مباشرة لتجنّب الاقتطاع الصامت"""
    limit = LIMITS[model]["thinking" if thinking else "non_thinking"]
    need = answer_tokens + (thinking_tokens if thinking else 0)
    if need > limit:
        raise ValueError(f"{model} 预算 {need} 超过上限 {limit},请拆分任务")
    return need

PRIMARY = {
    "model": "qwen4-max",
    "base_url": "https://api.apiyi.com/v1",  # عنوان APIYI المتوافق مع OpenAI
    "reasoning_effort": "high",
}
# يجب أن يكون هدف التراجع نموذجًا لا يزال في الخدمة؛ إذ لا يتوفر qwen4-max-preview بعد إيقافه
FALLBACK = {
    "model": "YOUR_FALLBACK_MODEL",
    "base_url": "https://api.apiyi.com/v1",
}

def call(cfg: dict, messages: list, max_tokens: int):
    client = OpenAI(api_key="YOUR_API_KEY", base_url=cfg["base_url"])
    kwargs = {"model": cfg["model"], "messages": messages, "max_tokens": max_tokens}
    if "reasoning_effort" in cfg:
        kwargs["reasoning_effort"] = cfg["reasoning_effort"]
    return client.chat.completions.create(**kwargs)

def run(messages: list, answer_tokens: int = 60_000, thinking_tokens: int = 131_072):
    budget = plan_max_tokens("qwen4-max", True, answer_tokens, thinking_tokens)
    try:
        resp = call(PRIMARY, messages, budget)
    except Exception as e:
        print(f"主模型失败,切换回退:{e}")
        resp = call(FALLBACK, messages, min(budget, 32_000))
    choice = resp.choices[0]
    if choice.finish_reason == "length":
        print("警告:输出因长度被截断,需要拆分任务或调整预算")
    print("用量:", resp.usage)
    return choice.message.content

if __name__ == "__main__":
    print(run([{"role": "user", "content": "生成一份模型迁移回归报告的大纲"}]))
4.6 التحقق من استدعاء الأدوات والمخرجات المهيكلة والمخرجات الطويلة
أعد التشغيل باستخدام مهام تمثيلية، بندًا بندًا: هل تعيد ميزة Function Calling أسماء الأدوات نفسها وبنية المعاملات نفسها؟ وهل تتعامل الشيفرة بشكل صحيح مع استدعاءات الأدوات المتوازية؟ وهل تنجح مخرجات JSON Schema في اجتياز المدقق الأصلي؟ وهل تنتهي المخرجات الطويلة بـ finish_reason == "length"؟ وهل يظل السياق متماسكًا بعد إعادة إرسال سجل محادثة متعدد الجولات؟ قارن كل بند بخط الأساس المحفوظ في 4.1، وسجّل الفروقات.
4.7 مراقبة الاستخدام وفاتورة التخزين المؤقت
بعد الانتقال من Credits إلى الفوترة حسب الاستخدام، يجب حساب التكلفة على ثلاثة بنود منفصلة: الإدخال، والإخراج (بما في ذلك التفكير)، والتخزين المؤقت. سعر وحدة الإخراج في إصدار الإنتاج يعادل 3 أضعاف سعر الإدخال، كما تُحتسب رموز التفكير ضمن الإخراج، لذا يؤثر إعداد شدة الاستدلال مباشرةً في الفاتورة. يمكنك أولاً إنهاء اختبار الانحدار باستخدام الحصة المجانية في منطقة بكين، ثم تقدير التكلفة الشهرية بناءً على الاستخدام الفعلي.
4.8 التبديل بحركة مرور منخفضة والاحتفاظ بإعداد التراجع
وجّه من 5% إلى 10% من حركة المرور أولاً إلى qwen4-max، وراقب معدل الأخطاء ومعدل الاقتطاع وتكلفة المهمة الواحدة، ثم انتقل إلى التبديل الكامل بعد التأكد من الاستقرار. يجب أن يشير إعداد التراجع إلى نموذج لا يزال في الخدمة، مثل إصدار آخر متاح من السلسلة نفسها، أو نموذج من مزود آخر سبق التحقق منه. بعد إيقاف Preview، لم يعد يصلح كهدف للتراجع.
🎯 توصية تقنية: يُفضّل التحقق من نموذج التراجع على المجموعة نفسها من المهام التمثيلية قبل النشر التدريجي. عبر واجهة APIYI apiyi.com المتوافقة مع OpenAI، يمكنك بمفتاح API واحد التبديل بين عدة نماذج رئيسية، ويكفي تعديل حقل
modelلإتمام تمرين التراجع.
5 المشكلات الأكثر شيوعًا بعد الترحيل إلى Qwen4-Max
5.1 اقتطاع المخرجات
هذه هي المشكلة الأكثر شيوعًا. قد تُقتطع التقارير الطويلة أو الملفات الكبيرة التي كانت تُولّد بالكامل على Preview عند الانتقال إلى الإصدار الرسمي، بسبب حد 262,144 أو انشغال ميزانية التفكير الافتراضية. الحل هو فحص finish_reason، وتوليد المهام الطويلة جدًا على شكل فصول أو ملفات منفصلة، مع تخصيص ميزانية واضحة لجزء الإجابة.
5.2 انخفاض قوة الاستدلال الافتراضية
بعد الانتقال من xhigh إلى high، قد يتغير أداء المهام المعقدة، فيما قد تنخفض مدة المهام البسيطة وتكلفتها. الكود الذي لا يحدد معامل الاستدلال سيغيّر سلوكه دون أن تدري. يجب أن تحدد جميع طلبات الإنتاج قوة الاستدلال صراحةً، وأن تحدد المستوى المناسب لكل نوع مهمة عبر إعادة تشغيل A/B.
5.3 استدعاء الأدوات واختلافات البروتوكول
يدعم الإصدار الرسمي صراحةً استدعاء الأدوات بالتوازي، وقد تحتوي الاستجابة الواحدة على عدة طلبات لاستدعاء الأدوات. الكود الذي يقرأ أول tool_call فقط سيفوت تنفيذ بعض الأدوات، ما يؤدي إلى انقطاع تدفق الـ Agent. عند تبديل البروتوكول، مثل الانتقال من Chat Completions إلى DashScope، تحتاج أيضًا إلى مطابقة تسمية الحقول وطريقة إعادة إرسال محتوى التفكير مع الوثائق من جديد.
5.4 تغيّر معايير التخزين المؤقت والفوترة
يتأثر استهلاك Credits في Preview بمعامل الفوترة وإصابة التخزين المؤقت واستدعاء الأدوات وعوامل أخرى، ولا يمكن تحويله مباشرة إلى سعر وحدة لكل مليون Token. يعتمد الإصدار الرسمي التسعير باليوان لكل مليون Token، ويُحتسب التخزين المؤقت بشكل منفصل. يحتاج نموذج الميزانية السابق المبني على Credits إلى إعادة بناء، مع تضمين تكلفة كتابة التخزين المؤقت الصريح واختيار TTL فيه.
6 المهام التي يجب إعادة اختبارها مع الإصدار الرسمي من Qwen4-Max
| نوع المهمة | نقاط التحقق الأساسية | المعاملات التي يجب مراقبتها |
|---|---|---|
| توليد التقارير الطويلة | هل يتم قطع المخرجات، وهل الأقسام مكتملة، وهل الحقائق متسقة من البداية إلى النهاية | ميزانية الإخراج، finish_reason |
| توليد الشفرة المعقدة | نسبة نجاح الترجمة والاختبارات، وطول الملف الواحد، والتوافق بين الملفات | reasoning_effort، ميزانية الإخراج |
| Agent متعدد الدورات | ترتيب استدعاء الأدوات، والتعامل مع الاستدعاءات المتوازية، وإرجاع سجل التفكير | tool_calls، reasoning_content |
| استرجاع المستندات الطويلة | دقة الربط بين المقاطع، وما إذا كان الإدخال يتجاوز 983,616 أو 991,808 | الحد الأقصى للإدخال، نسبة إصابة التخزين المؤقت |
| مخرجات JSON المهيكلة | نسبة نجاح التحقق من Schema، والحقول الناقصة وأخطاء الأنواع | response_format، JSON Schema |
تحتاج مهام استرجاع المستندات الطويلة إلى انتباه خاص: فالحد الأقصى للإدخال في الإصدار الرسمي يختلف باختلاف الوضع، إذ يقل وضع التفكير بنحو 8,000 Tokens عن الوضع غير التفكيري. والمهام التي تملأ المواد حتى الحد الأقصى قد تتجاوز الحد بعد تبديل الوضع. أما مهام الشفرة فيُفضّل فيها إعادة استخدام مجموعة اختبارات الوحدة الموجودة مباشرة، واتخاذ نسبة نجاح الاختبارات مؤشرًا للقبول، فهذا أكثر موثوقية من قراءة المخرجات يدويًا.
💡 اقتراح للاختيار: إذا كنت بحاجة إلى مقارنة أداء Qwen4-Max مع نماذج رائدة أخرى في هذه المهام في الوقت نفسه، فيمكنك إعادة تشغيل نفس مجموعة المهام عبر الواجهة الموحدة لخدمة APIYI على apiyi.com، ما يقلل من عناء كتابة شفرة تكييف منفصلة لكل مزوّد.
7 الأسئلة الشائعة حول الانتقال إلى Qwen4-Max-Preview
س1: بعد إيقاف Qwen4-Max-Preview، هل تتحوّل الطلبات القديمة تلقائيًا إلى النسخة الرسمية؟
لا تذكر الوثائق الرسمية سوى أن نسخة Preview ستُوقف وتوصي باستخدام النسخة الرسمية، ولم تُشر إلى أي تحويل تلقائي. لذلك يُرجى تغيير حقل `model` يدويًا إلى `qwen4-max` قبل الساعة 24:00 من يوم 25 نوفمبر، وإتمام الفحوصات الواردة في القسم 4 من هذا المقال.
س2: هل يكفي تغيير معرّف النموذج إلى qwen4-max فقط؟
لا يكفي. فقد تغيّر الحد الأعلى للإخراج، وقوة الاستدلال الافتراضية، وطريقة الفوترة. كحد أدنى، عليك إعادة حساب ميزانية الإخراج، وتحديد قوة الاستدلال بشكل صريح، وإجراء اختبارات انحدار على استدعاء الأدوات والإخراج المهيكل.
س3: هل يظل خصم الدفع بنسبة 20% من السعر والخصم الليلي الخاصّان بنسخة Preview ساريين على النسخة الرسمية؟
هذان العرضان ينطبقان فقط على استهلاك Credits الخاصّة بنسخة Preview داخل Token Plan. أما النسخة الرسمية عبر API الدفع حسب الاستخدام، فتُحسب على أساس 10 يوانات للمدخلات و30 يوانًا للمخرجات لكل مليون Token في منطقة بكين، ما يعني أن التكلفة تحتاج إلى إعادة تقدير.
س4: هل يمكن للخدمات الخلفية (backend) مواصلة استخدام مفتاح Token Plan؟
لا. فـ Token Plan يسمح فقط بالاستخدام التفاعلي داخل أدوات البرمجة أو أدوات الوكلاء المحددة. أما الخدمات الخلفية للتطبيقات التي تبنيها بنفسك فينبغي أن تنتقل إلى API الدفع حسب الاستخدام الخاص بالنسخة الرسمية، أو تستخدم خدمة تجميع مثل APIYI apiyi.com توفّر واجهة متوافقة مع OpenAI وتحاسب حسب الاستخدام.
س5: كيف أبني بيئة اختبار انحدار بسرعة أثناء فترة الانتقال؟
اجمع المهام التمثيلية في مجموعة طلبات ثابتة، ثم بدّل حقل `model` في الشيفرة نفسها لإعادة تشغيلها ومقارنة النتائج. ويوفّر APIYI apiyi.com رصيدًا تجريبيًا مجانيًا للمستخدمين الجدد، يمكن استخدامه للتحقق من النموذج الاحتياطي ومقارنة الحلول.
8 الخاتمة: دمج إدارة إصدارات النماذج في سير العمل الإنتاجي لـ Qwen4-Max
كان الانتقال من Qwen4-Max-Preview إلى الإصدار الرسمي يتضمن خمسة أبعاد تحتاج إلى إدارة مستمرة:
- معرّف النموذج: يُحفظ مركزيًا في مركز الإعدادات، ولا يُكتب مباشرة داخل الشفرة، مع الاشتراك في إعلانات دورة حياة النموذج.
- معاملات الواجهة: تُضبط قوة الاستدلال وميزانية التفكير وresponse_format جميعها بشكل صريح.
- حدود المخرجات: سجّل لكل نموذج أربعة أرقام — نافذة السياق، والحد الأقصى للإدخال، والحد الأقصى للإخراج، وميزانية التفكير — وتحقق منها قبل إرسال الطلب.
- التكلفة: راقب الإدخال والإخراج والتخزين المؤقت كلٌّ على حدة، وأعد بناء نموذج الميزانية عند تغيّر نمط الفوترة.
- اختبارات الانحدار: احتفظ بمجموعة المهام التمثيلية ونتائج خط الأساس، وأعد تشغيلها بالكامل مع كل تبديل للإصدار.
دورة حياة إصدار Preview لم تتجاوز أسبوعين، وسيأتي بعد الإصدار الرسمي أيضًا إصدارات جديدة وخطط إيقاف. أنشئ إجراءً ثابتًا يقوم على «حفظ خط الأساس، والمعاملات الصريحة، والتبديل التدريجي، والتقهقر المتاح»، وستنجز الترحيل في غضون أيام عند التبديل التالي. والفرق التي تحتاج إلى خطة تقهقر متعددة النماذج يمكنها إجراء التحقق عبر الواجهة نفسها باستخدام APIYI على apiyi.com.
المراجع
-
الوثائق الرسمية للإصدار الرسمي من Qwen4-Max: السياق، وحدود الإدخال والإخراج، ودرجة الاستدلال الافتراضية، والمنطقة، والأسعار والتخزين المؤقت
- الرابط:
help.aliyun.com/zh/model-studio/qwen4-max - الوصف: المرجع الأساسي لمعاملات الترحيل
- الرابط:
-
الوثائق الرسمية لـ Qwen4-Max-Preview: مواصفات Preview، وطريقة الوصول، وموعد الإيقاف
- الرابط:
help.aliyun.com/zh/model-studio/qwen4-max-preview - الوصف: المرجع الذي نقارن به عند الاحتفاظ بالإعدادات القديمة
- الرابط:
-
تحديثات ميزات Token Plan: سجل إطلاق Preview والإصدار الرسمي
- الرابط:
help.aliyun.com/zh/model-studio/token-plan-product-updates - الوصف: مصدر الجدول الزمني للإصدارات
- الرابط:
-
أذونات Token Plan وقواعد الاستخدام: نطاق الاستخدام التفاعلي والحالات المحظورة
- الرابط:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - الوصف: الأساس الذي نبني عليه الالتزام عند اختيار منتج الوصول
- الرابط:
-
اشتراك Token Plan للنسخة الشخصية ومزاياها: الباقات، وCredits، وعروض Preview
- الرابط:
help.aliyun.com/zh/model-studio/token-plan-personal-overview - الوصف: التمييز بين عروض Preview وفوترة الإصدار الرسمي
- الرابط:
الكاتب: فريق APIYI التقني
التواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لـ APIYI على apiyi.com، ولمزيد من مواد الوصول يمكنكم زيارة مركز الوثائق docs.apiyi.com