摘要:本文比較 Qwen4-Max-Preview 與正式版 Qwen4-Max 的輸出預算、推理默認值和計費方式,並給出 11 月 25 日 Preview 下線前可以逐項執行的遷移檢查步驟。
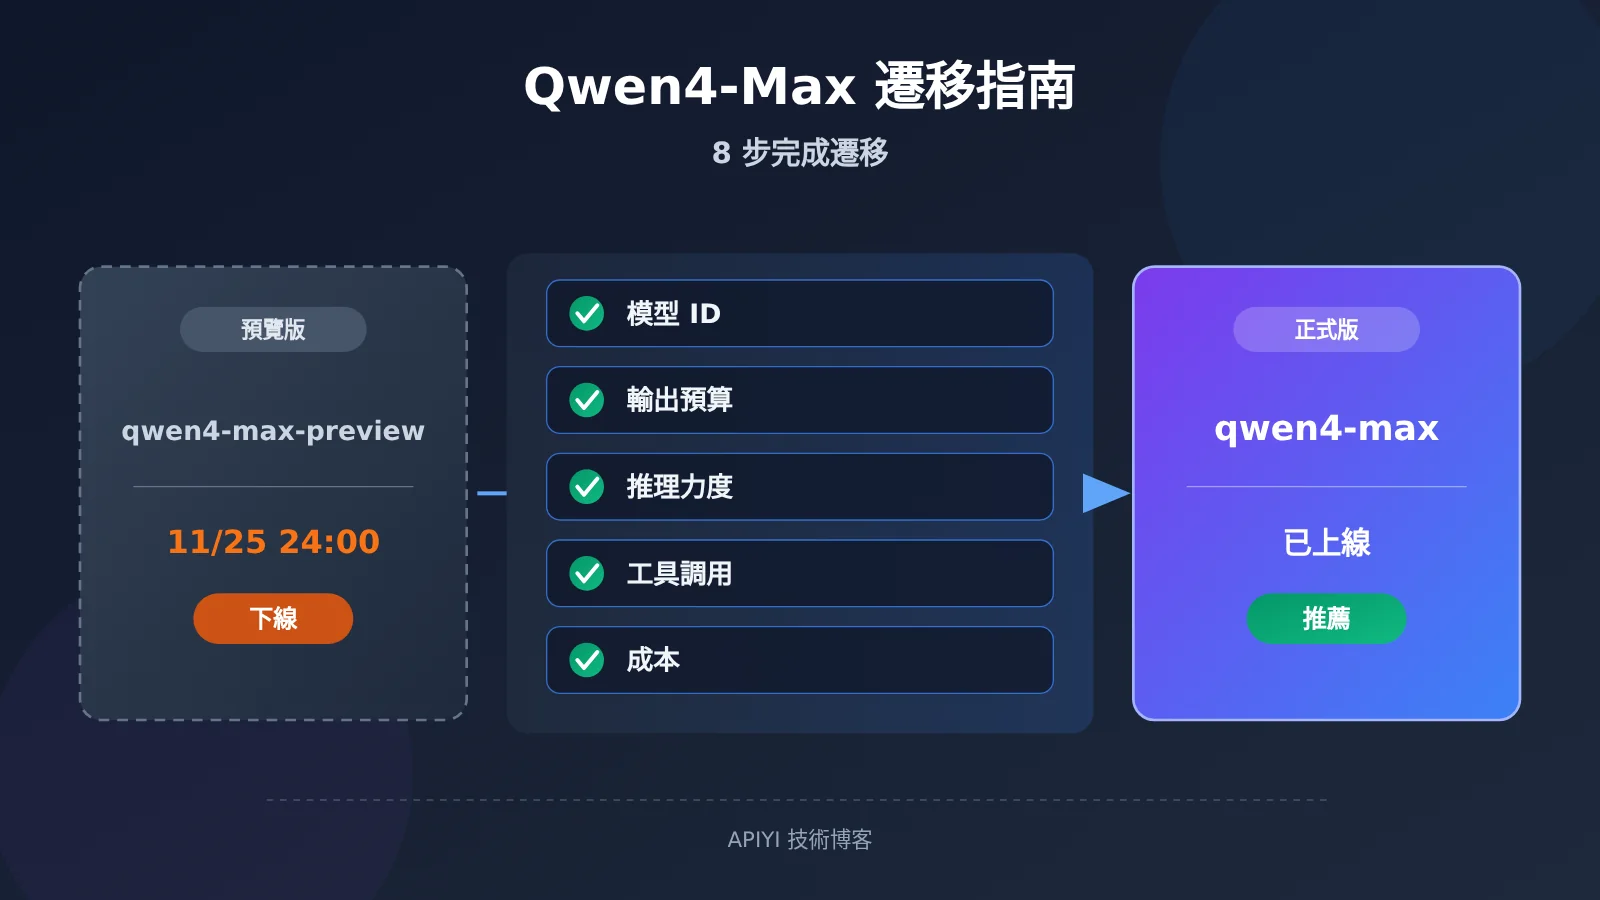
Qwen4-Max-Preview 將於 2026 年 11 月 25 日 24:00(UTC+8)結束預覽並下線。正式版 Qwen4-Max 已於 11 月 16 日上線,模型 ID 爲 qwen4-max。遷移到正式版時,需要同時檢查接入產品、輸出預算、推理默認值、工具行爲和成本這五項。兩個版本都提供 100 萬 Token 上下文,但正式版思考模式下的輸出上限從 393,216 降到 262,144,默認推理力度從 xhigh 變爲 high,計費也從 Token Plan Credits 擴展到按量付費。只修改模型 ID,無法保證生產任務表現一致。
下文先梳理 Preview 與正式版的時間線和規格差異,再介紹正式版的 API 協議、地域、價格與緩存。隨後按“保存基線、接入配置、請求參數、功能驗證、賬單觀察、灰度切換”的順序給出遷移清單,最後列出長報告、代碼生成、多輪 Agent 等任務的驗收要點。讀完後,你可以把這次切換整理成團隊可複用的模型版本管理流程。
To Know:Qwen4-Max 遷移術語
| 術語 | 解釋 |
|---|---|
| Model ID | 請求中用來指定具體模型版本的標識,例如 qwen4-max。 |
| Base URL | 客戶端連接某個產品、某個地域服務時使用的接口基礎地址。 |
| 上下文窗口 | 一次請求中模型可以處理的總容量,包括輸入、歷史和生成內容。 |
| 輸出預算 | 單次請求允許生成的 Token 上限。思考模式下,推理內容和最終回答共用這份預算。 |
| reasoning_effort | 控制推理力度的請求參數。Preview 與正式版的默認值不同。 |
| thinking_budget | 控制思考 Token 預算的參數。在 Preview 中,它不能與 reasoning_effort 同時設置。 |
| Token Plan | 阿里雲百鍊的訂閱服務,使用 Credits 計量,也是 Preview 唯一的接入渠道。 |
| Function Calling | 模型根據工具定義返回調用請求,由應用執行工具並回傳結果的機制。 |
| JSON Schema | 描述 JSON 數據結構、字段和約束的規範,用於約束模型輸出格式。 |
| TTL | 緩存的保留時長,會影響緩存複用的範圍和相應費用。 |
| 迴歸驗證 | 用已有的代表性任務,檢查版本切換後功能、結果和成本的變化。 |
1 Qwen4-Max-Preview 何時結束,正式版何時上線
1.1 Qwen4-Max 版本時間線
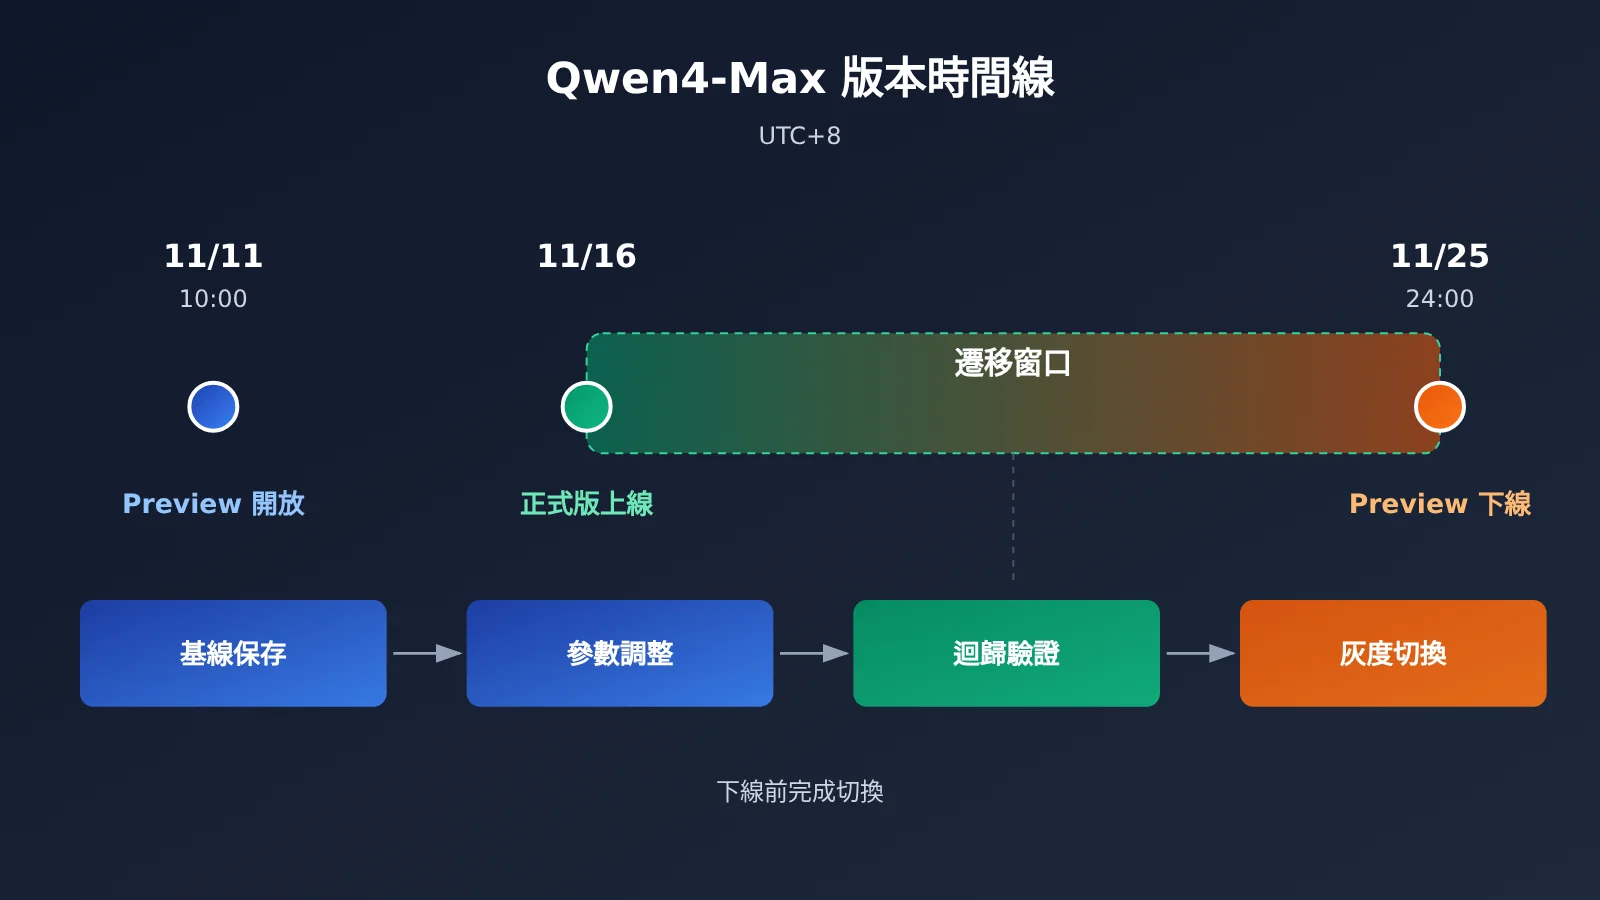
阿里雲 Token Plan 的功能更新記錄列出了兩個獨立事件:11 月 11 日 Preview 上線,11 月 16 日正式版上線。正式版發佈後,Preview 的原定下線時間沒有變化。Preview 官方文檔頂部也已提示“正式版 Qwen4-Max 已上線,建議使用正式版”。
| 時間(UTC+8) | 事件 | 對開發者的含義 |
|---|---|---|
| 2026-11-11 10:00 | Qwen4-Max-Preview 開放 | 只能通過 Token Plan 個人版或團隊版調用 |
| 2026-11-16 | Qwen4-Max 正式版上線 | 支持按量付費 API,也可通過 Token Plan 使用 |
| 2026-11-25 24:00 | Preview 預覽結束並下線 | qwen4-max-preview 無法繼續調用,也不能作爲回退目標 |
1.2 兩個 Model ID 與各自渠道
Preview 的模型 ID 是 qwen4-max-preview,別名 qwen4.0-max-preview。兩個 ID 都能調用,賬單中統一顯示爲 qwen4.0-max-preview。Preview 的接入方式是 Token Plan 專用 API Key 加專用 Base URL https://token-plan.cn-beijing.maas.aliyuncs.com,不支持按量付費。
正式版的模型 ID 是 qwen4-max。正式版提供兩條使用路徑:一是 Token Plan 個人版或團隊版,二是百鍊按量付費 API。這兩條路徑的 Key、Base URL 和計費方式各不相同,遷移時需要先確定走哪條。
2 Qwen4-Max-Preview 與正式版的規格差異
2.1 Qwen4-Max 規格對照表
以下數據來自 Preview 和正式版的官方模型文檔。
| 技術指標 | Qwen4-Max-Preview | Qwen4-Max 正式版 |
|---|---|---|
| Model ID | qwen4-max-preview |
qwen4-max |
| 上下文窗口 | 1,000,000 | 1,000,000 |
| 最大輸入(非思考 / 思考) | 文檔未單獨列出 | 991,808 / 983,616 |
| 最大輸出(非思考模式) | 文檔未單獨列出 | 131,072 |
| 思考 + 回答最大合計 | 393,216 | 262,144 |
| 默認推理力度 | xhigh | high |
| 默認思考預算 | 依 Preview 接口參數 | 131,072 |
| API 協議 | OpenAI Chat Completions、Responses、Anthropic Messages | 前三者 + DashScope |
| 計費方式 | 僅 Token Plan Credits | 按量付費 API,或 Token Plan |
2.2 上下文、輸入、輸出、思考預算的區別
這四個數字衡量的對象不同,遷移時最容易混淆。上下文窗口是一次請求能處理的總容量,兩個版本都是 100 萬。最大輸入決定一次最多能放入多少資料,正式版在思考模式下爲 983,616,比非思考模式少一些,餘量留給推理。最大輸出決定單次最多生成多少 Token,思考預算則決定其中可以有多少用於推理。
最大的變化在輸出側。Preview 的思考與回答共享 393,216 Tokens,正式版在思考模式下合計上限爲 262,144,默認思考預算爲 131,072。按默認配置估算,正式版留給最終回答的空間約爲 13 萬 Tokens。如果業務在 Preview 上依賴單次 20 萬以上的長輸出,切換後需要重新設計輸出方式。
3 Qwen4-Max 正式版的 API 接入能力與成本
3.1 協議與功能
正式版支持 OpenAI Chat Completions、OpenAI Responses、Anthropic Messages 和 DashScope 四種協議。功能方面,官方列出了 Function Calling、並行工具調用、聯網搜索、JSON Object、JSON Schema、顯式緩存、隱式緩存,以及思維鏈摘要與加密。
相比 Preview,正式版文檔新增了 DashScope 協議、並行工具調用和兩類緩存的說明。如果應用原來只處理單個 tool_call,現在需要確認代碼能正確處理一次響應中返回多個工具調用的情況。
3.2 地域與按量價格
正式版按量 API 覆蓋六個地域。選擇地域時,除了價格,還要考慮網絡延遲、數據駐留要求和業務部署範圍。各地域的具體能力以官方能力矩陣爲準。
| 地域 | 部署範圍 | 輸入(元/百萬 Token) | 輸出(元/百萬 Token,含思考) |
|---|---|---|---|
| 華北2(北京) | 中國內地 | 10 | 30 |
| 美國(弗吉尼亞) | 全球 | 10 | 30 |
| 德國(法蘭克福) | 全球 | 10 | 30 |
| 日本(東京) | 全球 | 10 | 30 |
| 中國香港 | 全球 | 10 | 30 |
| 新加坡 | 國際 | 10.938 | 32.813 |
北京地域官方頁面列有 100 萬 Token 免費額度,有效期 90 天。起算時間取開通百鍊、模型發佈、申請通過等條件中較晚的一個。以上價格只適用於正式版。Preview 的 2 折和夜間疊加後的 8% 費率屬於 Token Plan Credits 優惠,不能沿用到正式版的成本測算中。
3.3 顯式緩存與隱式緩存
正式版的緩存單獨計費。顯式緩存由開發者主動創建,適合放入系統提示詞、工具說明、固定參考資料等長期不變的前綴,TTL 可選 5 分鐘或 1 小時,支持 Chat Completions、Responses 和 Anthropic Messages。隱式緩存由平臺根據重複前綴等條件自動處理,不需要額外配置。
多輪 Agent 每輪都會攜帶同樣的工具定義和背景材料,合理使用緩存可以明顯降低重複輸入的費用。TTL 應根據會話間隔來選:交互密集的會話用 5 分鐘,間隔較長的批處理流程可以考慮 1 小時。
4 從 Qwen4-Max-Preview 遷移到正式版的操作步驟
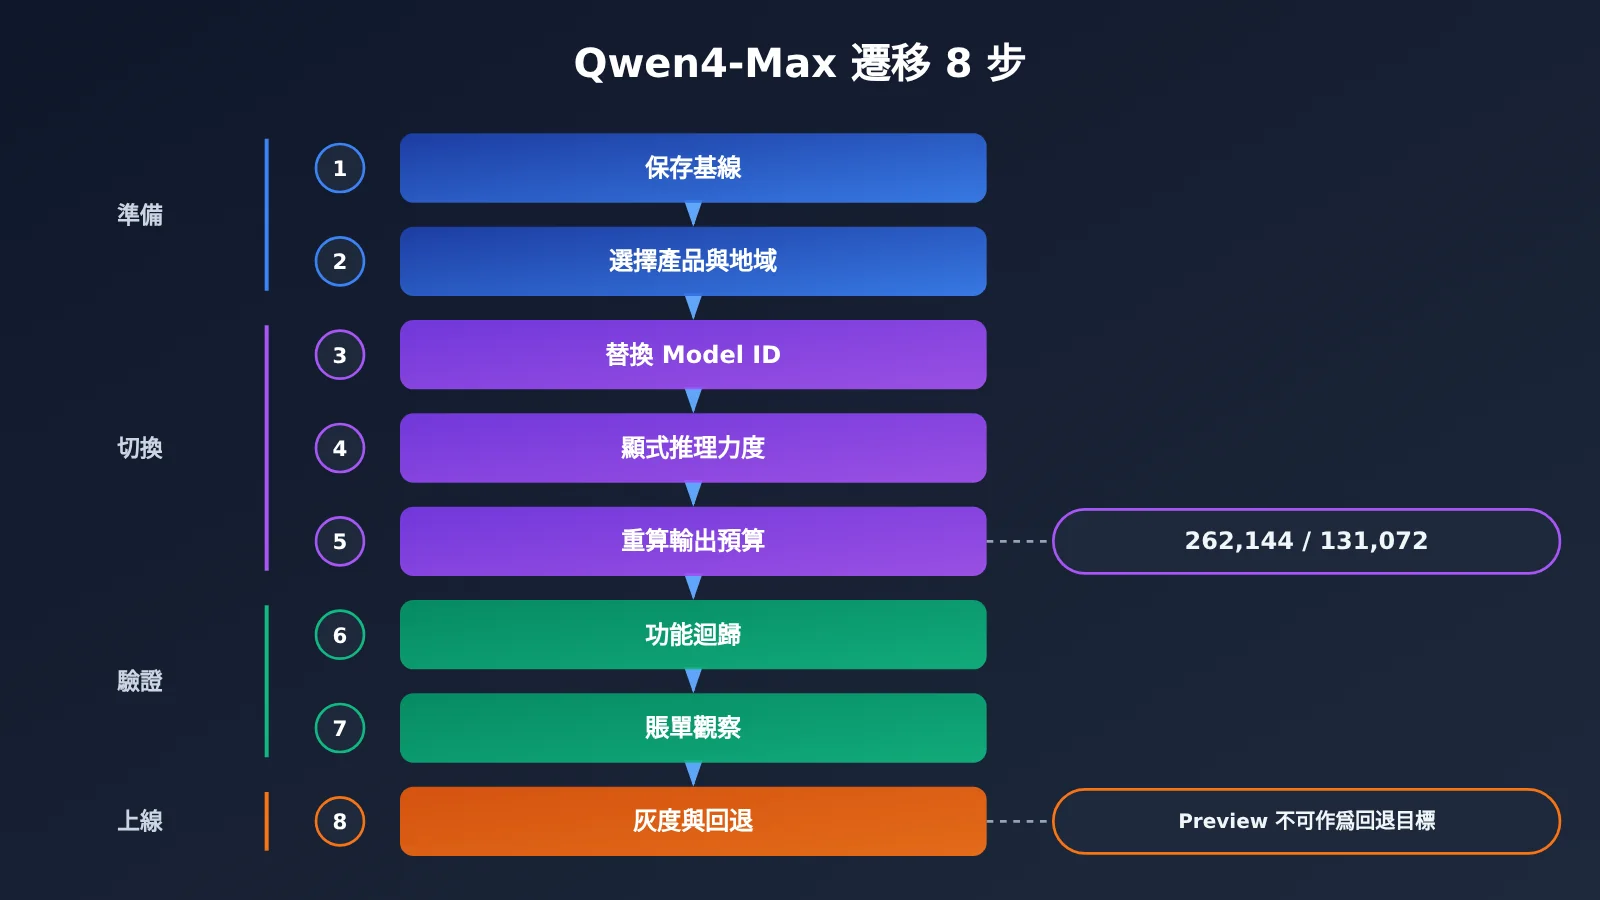
以下 8 步是根據官方規格整理的開發者檢查流程。官方沒有提供自動遷移工具,也沒有聲明所有請求參數可以無縫兼容,因此每一步都需要在自己的業務上實際驗證。
| 步驟 | 檢查項 | 驗收標準 |
|---|---|---|
| 1 | 保存舊配置與代表任務 | Preview 的請求參數、輸出樣本、耗時、用量已歸檔 |
| 2 | 選擇接入產品,覈對地域、Key、Base URL | 後端服務使用按量 API,交互式工具使用 Token Plan |
| 3 | 替換 model 爲 qwen4-max |
冒煙請求返回正常,賬單中的模型名稱正確 |
| 4 | 顯式設置推理力度 | 按任務寫明 reasoning_effort 或對應字段,不依賴默認值 |
| 5 | 重算輸出預算 | 思考模式總量 ≤ 262,144,非思考模式 ≤ 131,072 |
| 6 | 驗證工具調用、JSON 結構、長輸出、多輪歷史 | 代表任務的通過率與 Preview 基線持平 |
| 7 | 觀察用量與緩存賬單 | 輸入、輸出、緩存各項費用符合預期 |
| 8 | 小流量切換並準備回退配置 | 回退目標是仍然有效的模型,Preview 不在其中 |
4.1 保存舊配置與代表任務
在 Preview 下線前,導出當前所有調用 qwen4-max-preview 的配置,包括 max_tokens、reasoning_effort 或 thinking_budget、工具定義、response_format 和系統提示詞。同時挑選 10 到 30 個代表性任務,保存 Preview 的輸出、耗時和用量作爲對比基線。11 月 25 日之後將無法再獲取 Preview 的結果。
4.2 選擇接入產品並覈對 Key 與 Base URL
Token Plan 只允許在 Claude Code、Cursor、Qwen Code、Qoder 等編程工具或智能體工具中交互式使用。自動化腳本、自建應用後端、工作流平臺批量調用都不在允許範圍內,違規可能導致訂閱暫停或 Key 被封禁。如果 Preview 只是在 Qoder 等工具中使用,可以繼續通過 Token Plan 切換到正式版。如果要接入自己的後端,應改用正式版按量 API,並使用控制檯中對應地域的 Key 和 Base URL。
Token Plan 個人版還包含數據授權條款:使用期間,輸入和生成內容會用於服務改進。處理機密資料的團隊,在選擇接入產品時需要把這一條納入評估。
4.3 替換 Model ID:Qwen4-Max 快速上手
模型 ID 改爲 qwen4-max 即可發出第一個請求。下面是一個使用 OpenAI 兼容接口的最小示例,先確認請求能通,再進入參數調整:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 統一接口,也可替換爲百鍊對應地域的 Base URL
)

resp = client.chat.completions.create(
    model="qwen4-max",                   # 原值爲 qwen4-max-preview
    messages=[{"role": "user", "content": "用三句話說明你的版本信息"}],
    reasoning_effort="high",             # 顯式寫明,不依賴默認值
    max_tokens=8192
)
print(resp.choices[0].message.content)
同一 OpenAI 兼容接口下有哪些可用模型,以平臺的實時模型列表爲準。生產環境請在發佈前再確認一次。
4.4 顯式設置推理參數
Preview 默認 xhigh,正式版默認 high。如果原來的代碼沒有寫推理力度,切換後的推理強度會自動下降,複雜任務的質量、耗時和 Token 用量都可能隨之變化。建議按任務類型寫明推理力度:複雜代碼和科研推理先用與 Preview 相同的強度做基線對比,簡單抽取和格式化任務再嘗試降低。
Preview 文檔規定,reasoning_effort 和 thinking_budget 不能同時設置。正式版在 Chat Completions、Responses、Anthropic Messages、DashScope 四種協議中的字段名和取值,應以對應協議文檔爲準。在 Preview 中,多輪對話默認開啓 preserve_thinking,歷史思考內容要放回 reasoning_content 字段。如果你的應用回傳了思考內容,也需要在正式版上驗證歷史消息格式能被正確接收。
4.5 按新上限重算輸出預算
在 Preview 中,max_tokens 和 max_completion_tokens 等價,思考與回答共享 393,216 的總預算。到了正式版,思考模式的總預算爲 262,144,非思考模式的輸出上限爲 131,072。所有在 Preview 上設置超過 262,144 的請求都必須調低。原來預算偏緊的請求,還要考慮默認思考預算 131,072 會佔用的部分。
查看完整遷移配置代碼(預算校驗 + 回退)
from openai import OpenAI

# 正式版官方上限(思考模式爲思考與回答合計)
LIMITS = {
    "qwen4-max": {"thinking": 262_144, "non_thinking": 131_072},
}

def plan_max_tokens(model: str, thinking: bool,
                    answer_tokens: int, thinking_tokens: int = 0) -> int:
    """按模式計算 max_tokens,超出官方上限時直接報錯,避免靜默截斷"""
    limit = LIMITS[model]["thinking" if thinking else "non_thinking"]
    need = answer_tokens + (thinking_tokens if thinking else 0)
    if need > limit:
        raise ValueError(f"{model} 預算 {need} 超過上限 {limit},請拆分任務")
    return need

PRIMARY = {
    "model": "qwen4-max",
    "base_url": "https://api.apiyi.com/v1",  # API易 OpenAI 兼容地址
    "reasoning_effort": "high",
}
# 回退目標必須是仍在服務的模型,qwen4-max-preview 下線後不可用
FALLBACK = {
    "model": "YOUR_FALLBACK_MODEL",
    "base_url": "https://api.apiyi.com/v1",
}

def call(cfg: dict, messages: list, max_tokens: int):
    client = OpenAI(api_key="YOUR_API_KEY", base_url=cfg["base_url"])
    kwargs = {"model": cfg["model"], "messages": messages, "max_tokens": max_tokens}
    if "reasoning_effort" in cfg:
        kwargs["reasoning_effort"] = cfg["reasoning_effort"]
    return client.chat.completions.create(**kwargs)

def run(messages: list, answer_tokens: int = 60_000, thinking_tokens: int = 131_072):
    budget = plan_max_tokens("qwen4-max", True, answer_tokens, thinking_tokens)
    try:
        resp = call(PRIMARY, messages, budget)
    except Exception as e:
        print(f"主模型失敗,切換回退:{e}")
        resp = call(FALLBACK, messages, min(budget, 32_000))
    choice = resp.choices[0]
    if choice.finish_reason == "length":
        print("警告:輸出因長度被截斷,需要拆分任務或調整預算")
    print("用量:", resp.usage)
    return choice.message.content

if __name__ == "__main__":
    print(run([{"role": "user", "content": "生成一份模型遷移回歸報告的大綱"}]))
4.6 驗證工具調用、結構化輸出與長輸出
使用代表任務逐項回放:Function Calling 是否返回相同的工具名和參數結構,並行工具調用是否被代碼正確處理,JSON Schema 輸出能否通過原有的校驗器,長輸出是否以 finish_reason == "length" 結束,多輪歷史回傳後上下文是否連貫。每一項都和 4.1 中保存的基線做對比,並記錄差異。
4.7 觀察用量與緩存賬單
從 Credits 切換到按量計費後,成本要按輸入、輸出(含思考)、緩存三項分別覈算。正式版的輸出單價是輸入的 3 倍,而思考 Token 也計入輸出,所以推理力度設置直接影響賬單。可以先用北京地域的免費額度跑完迴歸,再根據實際用量推算月度成本。
4.8 小流量切換並保留回退配置
先把 5% 到 10% 的流量切到 qwen4-max,觀察錯誤率、截斷率和單次任務成本,確認穩定後再全量切換。回退配置要指向仍在服務的模型,例如同系列的其他可用版本,或已經驗證過的其他廠商模型。Preview 下線後不能作爲回退目標。
🎯 技術建議:回退模型最好在灰度前就完成同一批代表任務的驗證。通過 API易 apiyi.com 的 OpenAI 兼容接口,一個 Key 就能在多家主流模型之間切換,只需修改
model字段即可完成回退演練。
5 Qwen4-Max 遷移後最容易出現的問題
5.1 輸出截斷
這是最常見的問題。Preview 上能完整生成的長報告或大文件,換到正式版後可能因爲 262,144 的上限或默認思考預算的佔用而被截斷。處理辦法是檢查 finish_reason,對超長任務分章節或分文件生成,同時給回答部分預留明確的預算。
5.2 默認推理力度下降
從 xhigh 降到 high 後,複雜任務的表現可能變化,簡單任務的耗時和費用則可能下降。不寫推理參數的代碼會在不知情的情況下改變行爲。所有生產請求都應該顯式設置推理力度,並通過 A/B 回放確定每類任務合適的檔位。
5.3 工具調用與協議差異
正式版明確支持並行工具調用,一次響應中可能出現多個工具調用請求。只讀取第一個 tool_call 的代碼會漏執行工具,導致 Agent 流程中斷。切換協議時,例如從 Chat Completions 換到 DashScope,字段命名和思考內容的回傳方式也需要重新對照文檔。
5.4 緩存與賬單口徑變化
Preview 的 Credits 消耗受計費係數、緩存命中、工具調用等因素影響,不能直接換算成每百萬 Token 的單價。正式版採用元/百萬 Token 計價,緩存單獨計費。原來按 Credits 做的預算模型需要重建,並把顯式緩存的寫入成本和 TTL 選擇納入其中。
6 Qwen4-Max 正式版哪些任務必須重新測試
| 任務類型 | 重點驗證項 | 關注的參數 |
|---|---|---|
| 長報告生成 | 是否截斷、章節是否完整、事實前後是否一致 | 輸出預算、finish_reason |
| 複雜代碼生成 | 編譯與測試通過率、單文件長度、跨文件一致性 | reasoning_effort、輸出預算 |
| 多輪 Agent | 工具調用順序、並行調用處理、歷史思考回傳 | tool_calls、reasoning_content |
| 長文檔檢索 | 跨段落關聯準確率、輸入是否超出 983,616 或 991,808 | 最大輸入、緩存命中 |
| JSON 結構化輸出 | Schema 校驗通過率、字段缺失與類型錯誤 | response_format、JSON Schema |
長文檔檢索需要特別注意:正式版的最大輸入因模式而異,思考模式比非思考模式少約 8,000 Tokens。緊貼上限裝填資料的任務,切換模式後可能超出限制。代碼類任務建議直接複用已有的單元測試集,以測試通過率作爲驗收指標,比人工閱讀輸出更可靠。
💡 選擇建議:如果需要同時比較 Qwen4-Max 與其他旗艦模型在這些任務上的表現,可以用 API易 apiyi.com 的統一接口回放同一批任務,減少爲每個廠商單獨編寫適配代碼的工作量。
7 Qwen4-Max-Preview 遷移常見問題
Q1:Qwen4-Max-Preview 下線後,舊請求會自動轉到正式版嗎?
官方文檔只說明 Preview 將下線並建議使用正式版,沒有提到自動轉發。請在 11 月 25 日 24:00 前手動把 model 改爲 `qwen4-max`,並完成本文第 4 節的檢查。
Q2:只把模型 ID 改成 qwen4-max 就夠了嗎?
不夠。輸出上限、默認推理力度和計費方式都變了。至少還要重算輸出預算、顯式設置推理力度,並對工具調用和結構化輸出做迴歸驗證。
Q3:Preview 的 2 折和夜間優惠在正式版上還有效嗎?
這兩項優惠只適用於 Preview 在 Token Plan 中的 Credits 消耗。正式版按量 API 以北京地域輸入 10 元、輸出 30 元/百萬 Token 爲準,成本需要重新測算。
Q4:後端服務能繼續使用 Token Plan 的 Key 嗎?
不能。Token Plan 只允許在指定的編程或智能體工具中交互式使用。自建應用後端應改用正式版按量 API,或使用 API易 apiyi.com 這類提供 OpenAI 兼容接口、按量計費的聚合服務。
Q5:遷移期間怎樣快速搭建迴歸環境?
把代表任務整理成固定的請求集,用同一段代碼切換 model 字段即可完成回放。API易 apiyi.com 爲新用戶提供免費測試額度,可用於驗證回退模型和對比方案。
8 結語:把模型版本管理納入 Qwen4-Max 生產流程
這次從 Qwen4-Max-Preview 到正式版的切換,涉及五個需要持續管理的維度:
- 模型 ID:集中維護在配置中心,不在代碼裏硬編碼,並訂閱模型生命週期公告。
- 接口參數:推理力度、思考預算、response_format 全部顯式設置。
- 輸出限制:爲每個模型記錄上下文、最大輸入、最大輸出、思考預算四個數字,在發請求前做校驗。
- 成本:按輸入、輸出、緩存分別監控,計費模式變化時重建預算模型。
- 迴歸測試:保留代表任務集和基線結果,每次切換版本都完整回放一遍。
Preview 的生命週期只有兩週,正式版之後同樣會有新版本和下線計劃。建立“基線保存、顯式參數、灰度切換、可用回退”的固定流程,下一次版本更替時就能在幾天內完成遷移。需要準備多模型回退方案的團隊,可以通過 API易 apiyi.com 在同一接口下完成驗證。
參考資料
-
Qwen4-Max 正式版官方文檔:上下文、輸入輸出上限、默認推理力度、地域、價格與緩存
- 鏈接:
help.aliyun.com/zh/model-studio/qwen4-max - 說明: 遷移參數的主要依據
- 鏈接:
-
Qwen4-Max-Preview 官方文檔:Preview 規格、接入方式、下線時間
- 鏈接:
help.aliyun.com/zh/model-studio/qwen4-max-preview - 說明: 保存舊配置時的對照依據
- 鏈接:
-
Token Plan 功能更新:Preview 與正式版的上線記錄
- 鏈接:
help.aliyun.com/zh/model-studio/token-plan-product-updates - 說明: 版本時間線來源
- 鏈接:
-
Token Plan 權限與使用規範:交互式使用範圍與禁止場景
- 鏈接:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - 說明: 選擇接入產品時的合規依據
- 鏈接:
-
Token Plan 個人版訂閱與權益:套餐、Credits 與 Preview 優惠
- 鏈接:
help.aliyun.com/zh/model-studio/token-plan-personal-overview - 說明: 區分 Preview 優惠與正式版計費
- 鏈接:
作者:APIYI 技術團隊
技術交流:歡迎通過 API易 apiyi.com 首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心