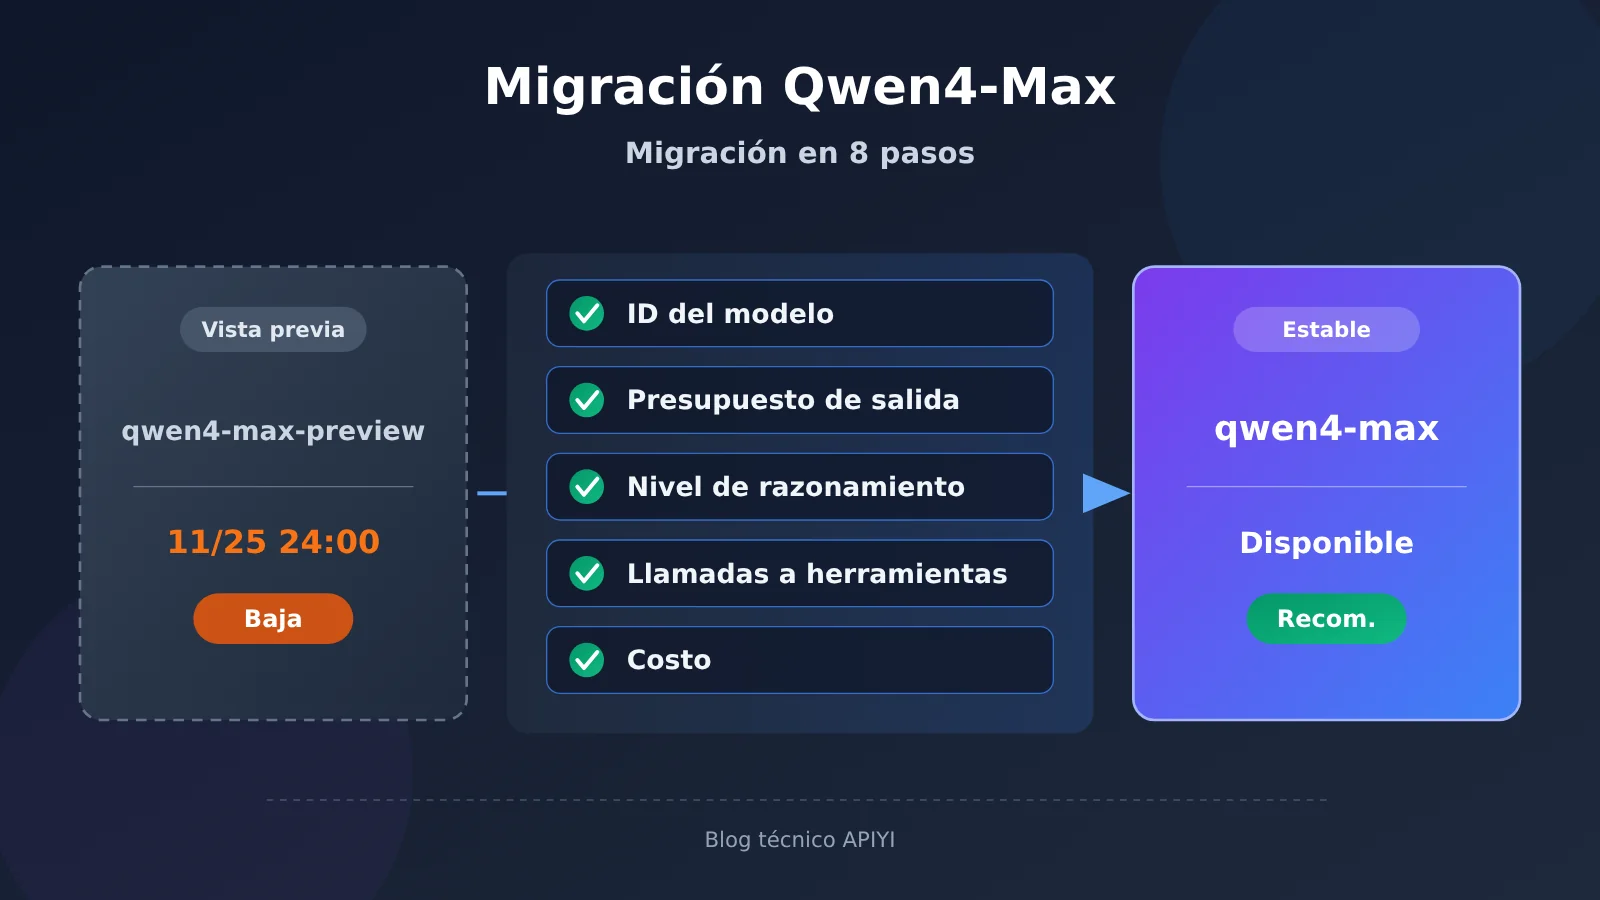
Resumen: Este artículo compara el presupuesto de salida, los valores predeterminados de razonamiento y la forma de facturación de Qwen4-Max-Preview frente a la versión oficial Qwen4-Max, y ofrece pasos de verificación de migración que se pueden ejecutar uno por uno antes del retiro de Preview el 25 de noviembre.
Qwen4-Max-Preview finalizará su fase de preview y se retirará el 25 de noviembre de 2026 a las 24:00 (UTC+8). La versión oficial Qwen4-Max ya está disponible desde el 16 de noviembre, con ID de modelo qwen4-max. Al migrar a la versión oficial, hay que revisar al mismo tiempo cinco aspectos: productos integrados, presupuesto de salida, valores predeterminados de razonamiento, comportamiento de las herramientas y costo. Ambas versions ofrecen una ventana de contexto de 1 millón de tokens, pero en el modo de pensamiento de la versión oficial el límite de salida baja de 393,216 a 262,144, el esfuerzo de razonamiento predeterminado pasa de xhigh a high, y la facturación también se amplía de Token Plan Credits a facturación por uso. Cambiar solo el ID del modelo no garantiza que el comportamiento en tareas de producción sea consistente.
A continuación, primero repasamos la línea de tiempo y las diferencias de especificaciones entre Preview y la versión oficial; después presentamos el protocolo de API, las regiones, los precios y la caché de la versión oficial. Luego presentamos una lista de migración en este orden: guardar la línea base, configuración de integración, parámetros de solicitud, verificación funcional, seguimiento de facturación y conmutación gradual. Al final, enumeramos los puntos de aceptación para tareas como informes extensos, generación de código y Agent multi-turno. Después de leer, podrás consolidar este cambio como un proceso reutilizable de gestión de versiones de modelos para el equipo.
Para saber: terminología de migración de Qwen4-Max
| Término | Explicación |
|---|---|
| Model ID | Identificador que se usa en la solicitud para especificar una versión concreta del modelo, por ejemplo qwen4-max. |
| Base URL | Dirección base de la interfaz que utiliza el cliente para conectarse a un producto o a un servicio de una región determinada. |
| ventana de contexto | Capacidad total que el modelo puede procesar en una sola solicitud, incluidos la entrada, el historial y el contenido generado. |
| Presupuesto de salida | Límite máximo de tokens que se permite generar en una sola solicitud. En modo de razonamiento, el contenido de razonamiento y la respuesta final comparten este presupuesto. |
| reasoning_effort | Parámetro de solicitud que controla la intensidad del razonamiento. El valor predeterminado difiere entre Preview y la versión oficial. |
| thinking_budget | Parámetro que controla el presupuesto de tokens de pensamiento. En Preview, no se puede configurar al mismo tiempo que reasoning_effort. |
| Token Plan | Servicio de suscripción de Alibaba Cloud Bailian, medido en Credits, y también es el único canal de acceso de Preview. |
| Function Calling | Mecanismo mediante el cual el modelo devuelve una solicitud de invocación según la definición de la herramienta; la aplicación ejecuta la herramienta y devuelve el resultado. |
| JSON Schema | Especificación que describe la estructura, los campos y las restricciones de los datos JSON, y se utiliza para restringir el formato de salida del modelo. |
| TTL | Tiempo de retención de la caché, que afecta el alcance de reutilización de la caché y el costo correspondiente. |
| Validación de regresión | Utilizar tareas representativas existentes para comprobar los cambios en funcionalidad, resultados y costos después de cambiar de versión. |
1. ¿Cuándo termina Qwen4-Max-Preview y cuándo estará disponible la versión oficial?
1.1 Cronología de versiones de Qwen4-Max
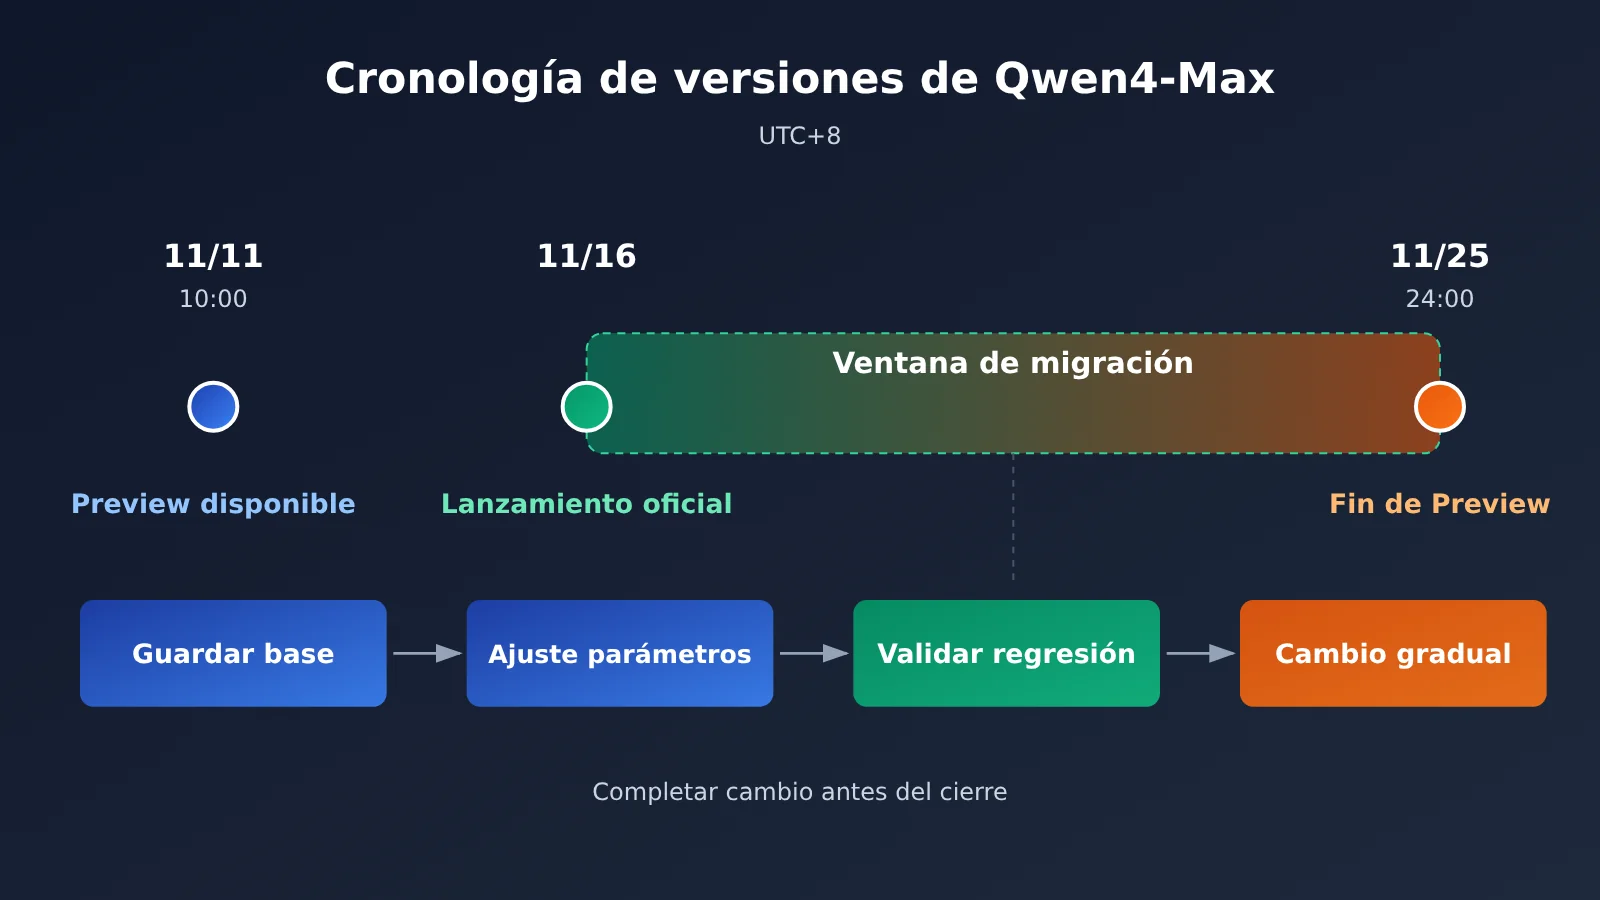
El registro de actualizaciones de funciones de Alibaba Cloud Token Plan enumera dos eventos independientes: el 11 de noviembre se lanzó la Preview y el 16 de noviembre se lanzó la versión oficial. Tras el lanzamiento de la versión oficial, la fecha de retirada prevista originalmente para la Preview no cambió. La documentación oficial de Preview también muestra en la parte superior un aviso: «La versión oficial Qwen4-Max ya está disponible; se recomienda usar la versión oficial».
| Hora (UTC+8) | Evento | Implicaciones para desarrolladores |
|---|---|---|
| 2026-11-11 10:00 | Disponibilidad de Qwen4-Max-Preview | Solo se puede invocar mediante Token Plan personal o de equipo |
| 2026-11-16 | Lanzamiento de la versión oficial de Qwen4-Max | Compatible con la API de pago por uso; también disponible a través de Token Plan |
| 2026-11-25 24:00 | Fin y retirada de la vista previa | qwen4-max-preview deja de poder invocarse y tampoco sirve como objetivo de reversión |
1.2 Los dos ID de modelo y sus canales respectivos
El ID de modelo de Preview es qwen4-max-preview, con alias qwen4.0-max-preview. Ambos ID se pueden invocar y en la factura se muestran de forma unificada como qwen4.0-max-preview. El acceso a Preview se realiza mediante una clave API exclusiva de Token Plan y una Base URL dedicada https://token-plan.cn-beijing.maas.aliyuncs.com; no admite el pago por uso.
El ID de modelo de la versión oficial es qwen4-max. La versión oficial ofrece dos vías de uso: la primera es Token Plan personal o de equipo; la segunda es la API de pago por uso de Bailian. Estas dos vías tienen claves, Base URL y métodos de facturación distintos, por lo que antes de migrar hay que decidir primero cuál se va a utilizar.
2 Diferencias de especificaciones entre Qwen4-Max-Preview y la versión oficial
2.1 Tabla comparativa de especificaciones de Qwen4-Max
Los siguientes datos provienen de la documentación oficial de los modelos Preview y de la versión oficial.
| Indicador técnico | Qwen4-Max-Preview | Qwen4-Max versión oficial |
|---|---|---|
| Model ID | qwen4-max-preview |
qwen4-max |
| Ventana de contexto | 1,000,000 | 1,000,000 |
| Entrada máxima (sin pensamiento / con pensamiento) | La documentación no lo desglosa por separado | 991,808 / 983,616 |
| Salida máxima (modo sin pensamiento) | La documentación no lo desglosa por separado | 131,072 |
| Máximo combinado de pensamiento + respuesta | 393,216 | 262,144 |
| Esfuerzo de razonamiento predeterminado | xhigh | high |
| Presupuesto de pensamiento predeterminado | Según los parámetros de la interfaz de Preview | 131,072 |
| Protocolo de API | OpenAI Chat Completions, Responses y Anthropic Messages | Los tres anteriores + DashScope |
| Método de facturación | Solo Token Plan Credits | API de pago por uso, o Token Plan |
2.2 Diferencias entre contexto, entrada, salida y presupuesto de pensamiento
Estos cuatro números miden cosas distintas, y son los que más fácilmente se confunden al migrar. La ventana de contexto es la capacidad total que puede procesar una solicitud; ambas versiones tienen 1 millón. La entrada máxima determina cuánta información se puede incluir como máximo en una sola solicitud; en el modo con pensamiento, la versión oficial es de 983,616, algo menos que en el modo sin pensamiento, y el margen restante se reserva para la inferencia. La salida máxima determina cuántos Tokens se pueden generar como máximo en una sola vez, mientras que el presupuesto de pensamiento determina cuántos de ellos se pueden destinar a la inferencia.
El cambio más importante está en el lado de la salida. En Preview, el pensamiento y la respuesta comparten 393,216 Tokens; en la versión oficial, en el modo con pensamiento, el límite total combinado es de 262,144, y el presupuesto de pensamiento predeterminado es de 131,072. Estimando con la configuración predeterminada, la versión oficial deja alrededor de 130 mil Tokens para la respuesta final. Si un negocio depende en Preview de salidas largas de más de 200 mil Tokens en una sola vez, después del cambio tendrá que rediseñar la forma de salida.
3 Capacidades de acceso a la API y costes de la versión oficial de Qwen4-Max
3.1 Protocolos y funciones
La versión oficial es compatible con cuatro protocolos: OpenAI Chat Completions, OpenAI Responses, Anthropic Messages y DashScope. En cuanto a funcionalidades, la documentación oficial recoge Function Calling, llamada a herramientas en paralelo, búsqueda en internet, JSON Object, JSON Schema, caché explícita, caché implícita, además de resumen de la cadena de pensamiento y cifrado.
En comparación con la Preview, la documentación de la versión oficial añade el protocolo DashScope, la llamada a herramientas en paralelo y la explicación de los dos tipos de caché. Si tu aplicación antes solo gestionaba un único tool_call, ahora conviene comprobar que el código maneja correctamente varios tool calls devueltos en una misma respuesta.
3.2 Regiones y precios por consumo
La API por consumo de la versión oficial cubre seis regiones. A la hora de elegir región, además del precio, hay que tener en cuenta la latencia de red, los requisitos de residencia de datos y el alcance de despliegue del negocio. Las capacidades concretas de cada región se rigen por la matriz oficial de capacidades.
| Región | Alcance de despliegue | Entrada (yuan/millón de tokens) | Salida (yuan/millón de tokens, incluye razonamiento) |
|---|---|---|---|
| Norte de China 2 (Pekín) | China continental | 10 | 30 |
| EE. UU. (Virginia) | Global | 10 | 30 |
| Alemania (Fráncfort) | Global | 10 | 30 |
| Japón (Tokio) | Global | 10 | 30 |
| Hong Kong, China | Global | 10 | 30 |
| Singapur | Internacional | 10.938 | 32.813 |
La página oficial de la región de Pekín indica una cuota gratuita de 1 millón de tokens con validez de 90 días. El inicio del cómputo se toma del momento más tardío entre la activación de Bailian, la publicación del modelo, la aprobación de la solicitud y demás condiciones. Estos precios solo se aplican a la versión oficial. El 20 % del precio de la Preview y la tarifa del 8 % que resulta al combinarla con el descuento nocturno son ventajas de Token Plan Credits y no pueden trasladarse al cálculo de costes de la versión oficial.
3.3 Caché explícita y caché implícita
En la versión oficial la caché se factura por separado. La caché explícita la crea el propio desarrollador de forma activa y encaja bien con prefijos que no cambian a largo plazo, como indicaciones de sistema, descripciones de herramientas o materiales de referencia fijos; el TTL puede ser de 5 minutos o 1 hora, y es compatible con Chat Completions, Responses y Anthropic Messages. La caché implícita la gestiona automáticamente la plataforma según condiciones como prefijos repetidos, sin necesidad de configuración adicional.
En un Agent de varios turnos, cada turno arrastra las mismas definiciones de herramientas y el mismo material de contexto; usar la caché de forma adecuada puede reducir de manera notable el coste de las entradas repetidas. El TTL debe elegirse según el intervalo entre sesiones: para sesiones con interacción intensa, 5 minutos; para procesos por lotes con intervalos más largos, puede valorarse 1 hora.
4 Pasos para migrar de Qwen4-Max-Preview a la versión oficial
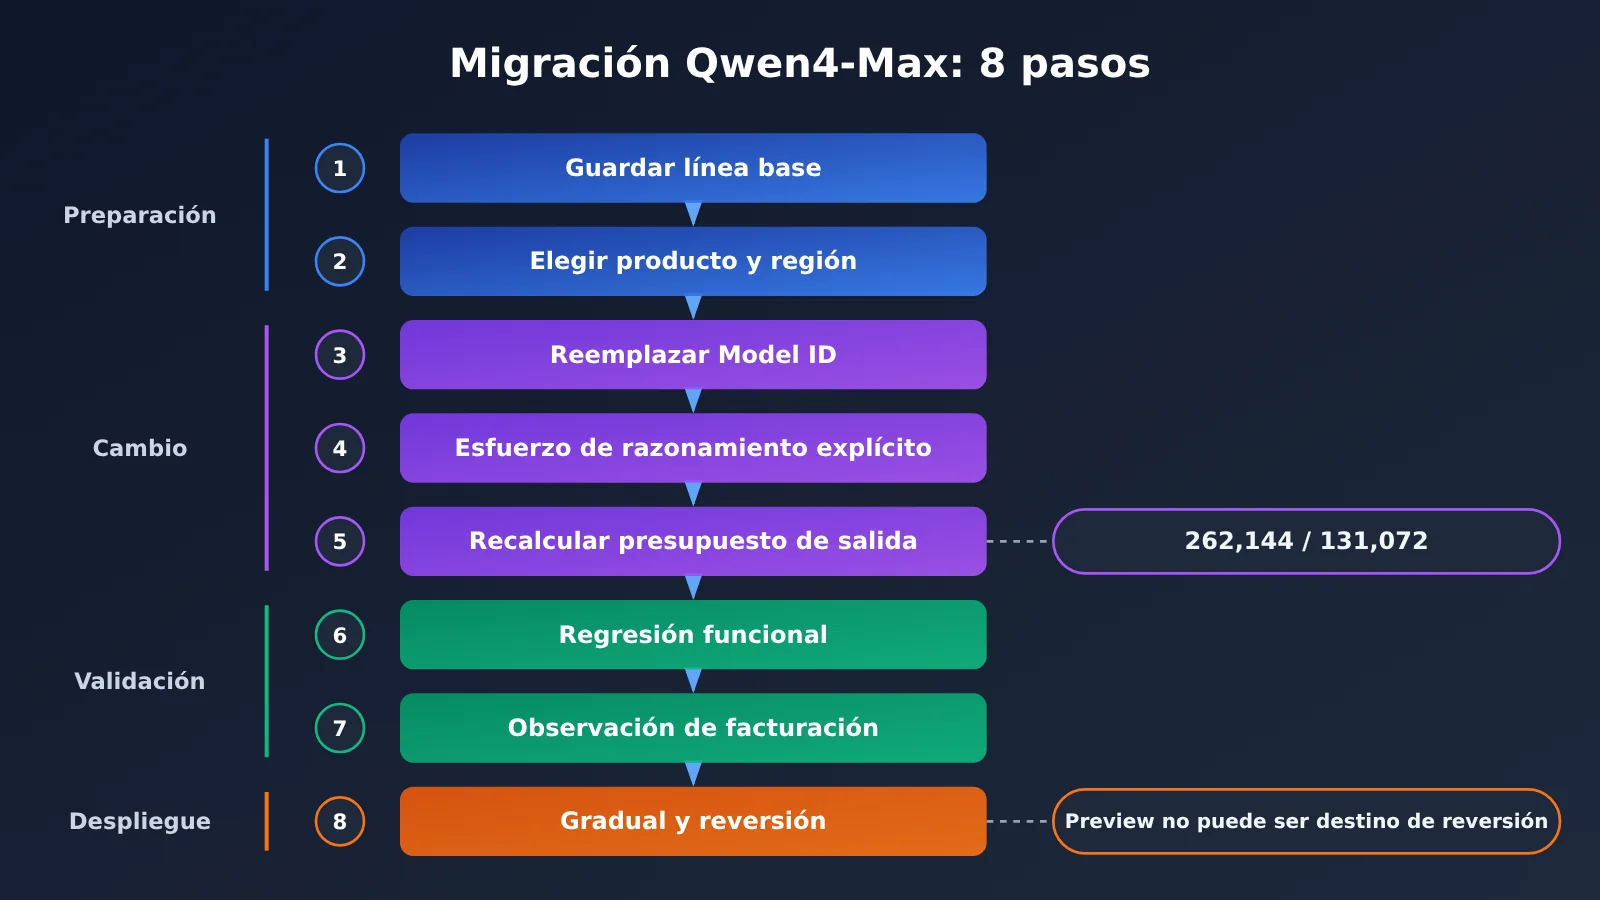
Los siguientes 8 pasos conforman la lista de comprobación para desarrolladores, elaborada a partir de las especificaciones oficiales. No existe ninguna herramienta de migración automática ni ninguna garantía de que todos los parámetros de solicitud sean compatibles sin más, así que cada paso hay que validarlo de verdad sobre tu propio negocio.
| Paso | Elemento a comprobar | Criterio de aceptación |
|---|---|---|
| 1 | Guardar la configuración anterior y las tareas representativas | Los parámetros de solicitud, las muestras de salida, los tiempos y el consumo de Preview quedan archivados |
| 2 | Elegir el producto de acceso y verificar región, clave y Base URL | Los servicios de backend usan la API de pago por uso; las herramientas interactivas usan Token Plan |
| 3 | Sustituir el campo model por qwen4-max |
La petición de smoke test devuelve una respuesta normal y el nombre del modelo en la facturación es correcto |
| 4 | Fijar explícitamente la intensidad de razonamiento | Indicar por tarea reasoning_effort o el campo correspondiente, sin depender de los valores por defecto |
| 5 | Recalcular el presupuesto de salida | En modo de pensamiento el total ≤ 262,144; en modo sin pensamiento ≤ 131,072 |
| 6 | Validar la invocación de herramientas, la estructura JSON, las salidas largas y el historial multiturno | La tasa de éxito de las tareas representativas se mantiene al nivel de la línea base de Preview |
| 7 | Observar el consumo y la facturación de caché | Los costes de entrada, salida y caché se ajustan a lo esperado |
| 8 | Cambiar con poco tráfico y preparar la configuración de rollback | El objetivo de rollback es un modelo que sigue vigente, y Preview no entra en esa lista |
4.1 Guardar la configuración anterior y las tareas representativas
Antes de que Preview deje de estar disponible, exporta todas las configuraciones actuales que invocan qwen4-max-preview, incluyendo max_tokens, reasoning_effort o thinking_budget, las definiciones de herramientas, response_format y las indicaciones del sistema. Además, selecciona de 10 a 30 tareas representativas y guarda la salida, el tiempo de ejecución y el consumo de Preview como línea base de comparación. Después del 25 de noviembre ya no será posible obtener resultados de Preview.
4.2 Elegir el producto de integración y verificar la clave y la Base URL
Token Plan solo permite el uso interactivo en herramientas de programación o de agentes como Claude Code, Cursor, Qwen Code y Qoder. Los scripts automatizados, los backends de aplicaciones propias y las llamadas masivas desde plataformas de flujos de trabajo quedan fuera del alcance permitido; el incumplimiento puede provocar la suspensión de la suscripción o el bloqueo de la clave. Si Preview solo se utiliza en herramientas como Qoder, puedes seguir usando Token Plan para cambiar a la versión oficial. Si necesitas integrarlo en tu propio backend, deberías usar la API de pago por uso de la versión oficial y emplear la clave y la Base URL correspondientes a la región en la consola.
La versión personal de Token Plan también incluye una cláusula de autorización de datos: durante el uso, el contenido de entrada y el contenido generado se utilizarán para mejorar el servicio. Los equipos que trabajan con material confidencial deben incluir este punto en su evaluación al elegir el producto de integración.
4.3 Sustituir el Model ID: inicio rápido con Qwen4-Max
Basta cambiar el ID del modelo a qwen4-max para lanzar la primera solicitud. Abajo tienes un ejemplo mínimo con la interfaz compatible con OpenAI: primero comprueba que la petición pasa, y luego entra en el ajuste de parámetros:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI; también puedes sustituirla por la Base URL de la región correspondiente de Bailian
)

resp = client.chat.completions.create(
    model="qwen4-max",                   # Valor original: qwen4-max-preview
    messages=[{"role": "user", "content": "用三句话说明你的版本信息"}],
    reasoning_effort="high",             # Indícalo de forma explícita, no dependas del valor por defecto
    max_tokens=8192
)
print(resp.choices[0].message.content)
Qué modelos están disponibles bajo esta misma interfaz compatible con OpenAI depende de la lista de modelos en tiempo real de la plataforma. En producción, conviene volver a confirmarlo justo antes de publicar.
4.4 Configurar explícitamente los parámetros de razonamiento
Preview usa xhigh por defecto y la versión oficial usa high. Si tu código anterior no especifica la intensidad de razonamiento, al cambiar de versión esa intensidad bajará automáticamente, y tanto la calidad como el tiempo de respuesta y el consumo de tokens en tareas complejas pueden verse afectados. Lo recomendable es indicar la intensidad de razonamiento según el tipo de tarea: para código complejo y razonamiento científico, empieza usando la misma intensidad que Preview como línea base de comparación; para tareas simples de extracción y formateo, prueba a reducirla.
La documentación de Preview establece que reasoning_effort y thinking_budget no pueden configurarse al mismo tiempo. Los nombres de campo y los valores admitidos en la versión oficial dentro de los cuatro protocolos —Chat Completions, Responses, Anthropic Messages y DashScope— deben consultarse en la documentación del protocolo correspondiente. En Preview, las conversaciones multiturno activan preserve_thinking por defecto, y el contenido de pensamiento previo debe devolverse al campo reasoning_content. Si tu aplicación reenvía contenido de pensamiento, también necesitas verificar en la versión oficial que el formato de los mensajes históricos se reciba correctamente.
4.5 Recalcular el presupuesto de salida según el nuevo límite
En Preview, max_tokens y max_completion_tokens son equivalentes: el razonamiento y la respuesta comparten un presupuesto total de 393.216. En la versión oficial, el presupuesto total del modo de razonamiento es de 262.144, y el límite de salida del modo sin razonamiento es de 131.072. Todas las solicitudes que en Preview tengan configurado un valor superior a 262.144 deben reducirse. Además, en aquellas solicitudes cuyo presupuesto ya era ajustado, hay que tener en cuenta la parte que ocupará el presupuesto de razonamiento predeterminado de 131.072.
Ver el código completo de configuración de migración (validación de presupuesto + respaldo)
from openai import OpenAI

# Límites oficiales de la versión estable (en modo de razonamiento, suma de razonamiento y respuesta)
LIMITS = {
    "qwen4-max": {"thinking": 262_144, "non_thinking": 131_072},
}

def plan_max_tokens(model: str, thinking: bool,
                    answer_tokens: int, thinking_tokens: int = 0) -> int:
    """Calcula max_tokens según el modo; si supera el límite oficial, lanza un error para evitar truncamientos silenciosos"""
    limit = LIMITS[model]["thinking" if thinking else "non_thinking"]
    need = answer_tokens + (thinking_tokens if thinking else 0)
    if need > limit:
        raise ValueError(f"{model} 预算 {need} 超过上限 {limit},请拆分任务")
    return need

PRIMARY = {
    "model": "qwen4-max",
    "base_url": "https://api.apiyi.com/v1",  # Dirección compatible con OpenAI de APIYI
    "reasoning_effort": "high",
}
# El destino de respaldo debe ser un modelo que siga en servicio; qwen4-max-preview no estará disponible tras su retirada
FALLBACK = {
    "model": "YOUR_FALLBACK_MODEL",
    "base_url": "https://api.apiyi.com/v1",
}

def call(cfg: dict, messages: list, max_tokens: int):
    client = OpenAI(api_key="YOUR_API_KEY", base_url=cfg["base_url"])
    kwargs = {"model": cfg["model"], "messages": messages, "max_tokens": max_tokens}
    if "reasoning_effort" in cfg:
        kwargs["reasoning_effort"] = cfg["reasoning_effort"]
    return client.chat.completions.create(**kwargs)

def run(messages: list, answer_tokens: int = 60_000, thinking_tokens: int = 131_072):
    budget = plan_max_tokens("qwen4-max", True, answer_tokens, thinking_tokens)
    try:
        resp = call(PRIMARY, messages, budget)
    except Exception as e:
        print(f"主模型失败,切换回退:{e}")
        resp = call(FALLBACK, messages, min(budget, 32_000))
    choice = resp.choices[0]
    if choice.finish_reason == "length":
        print("警告:输出因长度被截断,需要拆分任务或调整预算")
    print("用量:", resp.usage)
    return choice.message.content

if __name__ == "__main__":
    print(run([{"role": "user", "content": "生成一份模型迁移回归报告的大纲"}]))
4.6 Validación de la invocación de herramientas, la salida estructurada y la salida larga
Repase punto por punto con tareas representativas: si Function Calling devuelve el mismo nombre de herramienta y la misma estructura de parámetros, si el código maneja correctamente las invocaciones paralelas de herramientas, si la salida de JSON Schema pasa el validador original, si la salida larga termina con finish_reason == "length" y si el contexto sigue siendo coherente tras reenviar el historial de varios turnos. Compare cada elemento con la línea base guardada en 4.1 y registre las diferencias.
4.7 Observación del consumo y de la facturación de caché
Tras pasar de Credits a la facturación por consumo, el costo debe calcularse por separado en tres rubros: entrada, salida (incluido el razonamiento) y caché. El precio unitario de salida de la versión oficial es 3 veces el de entrada, y los Tokens de razonamiento también cuentan como salida, así que la configuración de la intensidad de razonamiento incide directamente en la factura. Puede primero completar la regresión con la cuota gratuita de la región de Pekín y luego estimar el costo mensual a partir del consumo real.
4.8 Cambio con tráfico reducido y configuración de reversión conservada
Primero, dirige entre el 5% y el 10% del tráfico a qwen4-max; observa la tasa de errores, la tasa de truncamiento y el coste por tarea, y cuando confirmes que es estable, pasa al 100%. La configuración de reversión debe apuntar a un modelo que siga en servicio, por ejemplo otra versión disponible de la misma familia, o un modelo de otro proveedor que ya hayas validado. Cuando Preview deje de estar disponible, no puede usarse como destino de reversión.
🎯 Consejo técnico: Lo ideal es validar el modelo de reversión con el mismo lote de tareas representativas antes del despliegue gradual. Con la interfaz compatible con OpenAI de APIYI apiyi.com, una sola clave API permite cambiar entre varios modelos principales: solo hay que modificar el campo
modelpara hacer un simulacro de reversión.
5 Problemas más frecuentes después de migrar a Qwen4-Max
5.1 Truncamiento de la salida
Este es el problema más común. Un informe largo o un archivo grande que Preview podía generar completo puede quedar truncado en la versión oficial debido al límite de 262,144 o al consumo del presupuesto de razonamiento predeterminado. La solución consiste en revisar finish_reason, generar las tareas muy extensas por capítulos o por archivos y reservar un presupuesto claro para la parte de respuesta.
5.2 Reducción de la intensidad de razonamiento predeterminada
Al bajar de xhigh a high, el rendimiento en tareas complejas puede cambiar, mientras que el tiempo de ejecución y el coste de las tareas simples pueden reducirse. El código que no especifica parámetros de razonamiento puede cambiar de comportamiento sin que te des cuenta. Todas las solicitudes de producción deben establecer explícitamente la intensidad de razonamiento y determinar, mediante reproducción A/B, el nivel adecuado para cada tipo de tarea.
5.3 Llamadas a herramientas y diferencias de protocolo
La versión oficial admite explícitamente las llamadas a herramientas en paralelo, y una misma respuesta puede incluir varias solicitudes de llamada a herramientas. El código que solo lee el primer tool_call omitirá la ejecución de herramientas y hará que se interrumpa el flujo del agente. Al cambiar de protocolo, por ejemplo de Chat Completions a DashScope, también es necesario contrastar de nuevo con la documentación los nombres de campos y la forma de devolver el contenido de razonamiento.
5.4 Cambios en la caché y en los criterios de facturación
El consumo de Credits de Preview está influido por el coeficiente de facturación, los aciertos de caché, las llamadas a herramientas y otros factores, y no se puede convertir directamente en el precio unitario por millón de tokens. La versión oficial usa una tarifa de yuanes por millón de tokens, con facturación independiente para la caché. Hay que reconstruir el modelo de presupuesto que antes se basaba en Credits e incluir en él el coste de escritura de la caché explícita y la elección del TTL.
6. Qué tareas deben volver a probarse en la versión oficial de Qwen4-Max
| Tipo de tarea | Aspectos clave a validar | Parámetros a vigilar |
|---|---|---|
| Generación de informes largos | si se trunca, si las secciones están completas, si los hechos son coherentes de principio a fin | presupuesto de salida, finish_reason |
| Generación de código complejo | tasa de aprobación de compilación y pruebas, longitud de archivo individual, consistencia entre archivos | reasoning_effort, presupuesto de salida |
| Agent multiturno | orden de las llamadas a herramientas, manejo de llamadas paralelas, retorno del historial de razonamiento | tool_calls, reasoning_content |
| Recuperación en documentos largos | precisión de asociación entre párrafos, si la entrada excede 983,616 o 991,808 | entrada máxima, aciertos de caché |
| Salida estructurada JSON | tasa de aprobación de validación del Schema, campos faltantes y errores de tipo | response_format, JSON Schema |
La recuperación en documentos largos requiere especial atención: la entrada máxima de la versión oficial varía según el modo, y el modo de razonamiento tiene unos 8,000 Tokens menos que el modo sin razonamiento. Las tareas que cargan material justo hasta el límite pueden superar la restricción tras cambiar de modo. Para las tareas de código, conviene reutilizar directamente el conjunto de pruebas unitarias que ya tienes y usar la tasa de aprobación de las pruebas como métrica de aceptación; resulta más fiable que revisar manualmente la salida.
💡 Sugerencia de elección: si necesitas comparar a la vez el rendimiento de Qwen4-Max y de otros modelos insignia en estas tareas, puedes reproducir el mismo lote de tareas con la interfaz unificada de APIYI apiyi.com, lo que reduce el trabajo de escribir código de adaptación para cada proveedor por separado.
7 Preguntas frecuentes sobre la migración de Qwen4-Max-Preview
P1: Una vez retirado Qwen4-Max-Preview, ¿las solicitudes antiguas se redirigirán automáticamente a la versión oficial?
La documentación oficial solo indica que Preview se retirará y recomienda usar la versión oficial; no menciona una redirección automática. Antes del 25 de noviembre a las 24:00, cambie manualmente el campo model a `qwen4-max` y complete las comprobaciones de la sección 4 de este artículo.
P2: ¿Basta con cambiar solo el ID del modelo a qwen4-max?
No es suficiente. El límite de salida, la intensidad de razonamiento predeterminada y el método de facturación han cambiado. Como mínimo, debe recalcular el presupuesto de salida, establecer explícitamente la intensidad de razonamiento y realizar pruebas de regresión en las llamadas a herramientas y en las salidas estructuradas.
P3: ¿El descuento del 80% (2折) y la promoción nocturna de Preview siguen vigentes en la versión oficial?
Estos dos beneficios solo aplican al consumo de Credits de Preview dentro del Token Plan. La API de pago por uso de la versión oficial se rige por 10 yuanes de entrada y 30 yuanes de salida por millón de tokens en la región de Pekín, por lo que los costos deben recalcularse.
P4: ¿El servicio backend puede seguir usando la clave del Token Plan?
No. El Token Plan solo permite el uso interactivo dentro de las herramientas de programación o de agentes especificadas. El backend de una aplicación propia debe migrar a la API de pago por uso de la versión oficial, o bien usar un servicio agregado como APIYI apiyi.com, que ofrece interfaces compatibles con OpenAI y facturación por uso.
P5: ¿Cómo montar rápidamente un entorno de regresión durante la migración?
Organice las tareas representativas en un conjunto fijo de solicitudes; con el mismo código basta cambiar el campo model para reproducirlas. APIYI apiyi.com ofrece crédito de prueba gratuito a los nuevos usuarios, que puede servir para validar el modelo de respaldo y comparar alternativas.
8 Conclusión: incorporar la gestión de versiones de modelos en el flujo de producción de Qwen4-Max
Esta transición de Qwen4-Max-Preview a la versión oficial implica cinco dimensiones que deben gestionarse de forma continua:
- ID del modelo: mantenerlos de forma centralizada en el centro de configuración, no codificarlos directamente en el código, y suscribirse a los anuncios del ciclo de vida del modelo.
- Parámetros de la interfaz: establecer explícitamente el esfuerzo de razonamiento, el presupuesto de pensamiento y response_format.
- Límites de salida: registrar para cada modelo las cuatro cifras de contexto, entrada máxima, salida máxima y presupuesto de pensamiento, y validarlas antes de enviar la solicitud.
- Costo: monitorear por separado entrada, salida y caché, y reconstruir el modelo de presupuesto cuando cambie el esquema de facturación.
- Pruebas de regresión: conservar el conjunto de tareas representativas y los resultados de línea base, y reproducirlos por completo cada vez que se cambie de versión.
El ciclo de vida de Preview es de solo dos semanas, y después de la versión oficial también habrá nuevas versiones y planes de retirada. Establecer un flujo fijo de «guardar línea base, parámetros explícitos, cambio gradual y reversión disponible» permitirá completar la migración en pocos días la próxima vez que cambie la versión. Los equipos que necesiten preparar un plan de reversión con múltiples modelos pueden validarlo bajo la misma interfaz a través de APIYI apiyi.com.
Referencias
-
Documentación oficial de la versión oficial de Qwen4-Max: contexto, límites de entrada y salida, esfuerzo de razonamiento predeterminado, regiones, precios y caché
- Enlace:
help.aliyun.com/zh/model-studio/qwen4-max - Descripción: base principal para los parámetros de migración
- Enlace:
-
Documentación oficial de Qwen4-Max-Preview: especificaciones de Preview, forma de acceso, fecha de retirada
- Enlace:
help.aliyun.com/zh/model-studio/qwen4-max-preview - Descripción: base de comparación al conservar la configuración anterior
- Enlace:
-
Actualizaciones de funciones de Token Plan: registros de lanzamiento de Preview y de la versión oficial
- Enlace:
help.aliyun.com/zh/model-studio/token-plan-product-updates - Descripción: fuente de la línea de tiempo de versiones
- Enlace:
-
Permisos y normas de uso de Token Plan: alcance de uso interactivo y escenarios prohibidos
- Enlace:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - Descripción: base de cumplimiento al seleccionar el producto de acceso
- Enlace:
-
Suscripción personal de Token Plan y beneficios: paquetes, Credits y descuentos de Preview
- Enlace:
help.aliyun.com/zh/model-studio/token-plan-personal-overview - Descripción: distingue los descuentos de Preview de la facturación de la versión oficial
- Enlace:
Autor: Equipo técnico de APIYI
Intercambio técnico: bienvenido a contactarnos a través de la página de inicio de APIYI apiyi.com; para más materiales de acceso, puede visitar el centro de documentación docs.apiyi.com