ملاحظة المؤلف: بمفتاح API واحد، ومجموعة سكربتات ثابتة، وفشل حقن واحد، يمكن إجراء مقارنة أفقية لقدرات استدعاء الأدوات متعدد الجولات لدى عدة نماذج، والحصول على استنتاجات قابلة لإعادة الإنتاج والمراجعة.
عند اختيار نموذج لبناء Agent، تصادف كثير من الفرق المشكلة نفسها. في الأسئلة والأجوبة ذات الجولة الواحدة تتشابه نتائج النماذج المختلفة تقريبًا، لكن بمجرد الدخول إلى حلقة متعددة الجولات من نوع «استدعاء الأداة → الحصول على النتيجة → الاستدعاء مجددًا → معالجة الخطأ → تقديم إجابة منظمة»، تبدأ الفروق في الظهور. يقدّم هذا المقال اختبارًا مصغرًا لاستدعاء الأدوات متعدد الجولات: مفتاح واحد لاختبار عدة نماذج، يساعدك بتكلفة منخفضة جدًا على تحويل هذه الفروق إلى بيانات قابلة للتسجيل والمراجعة.
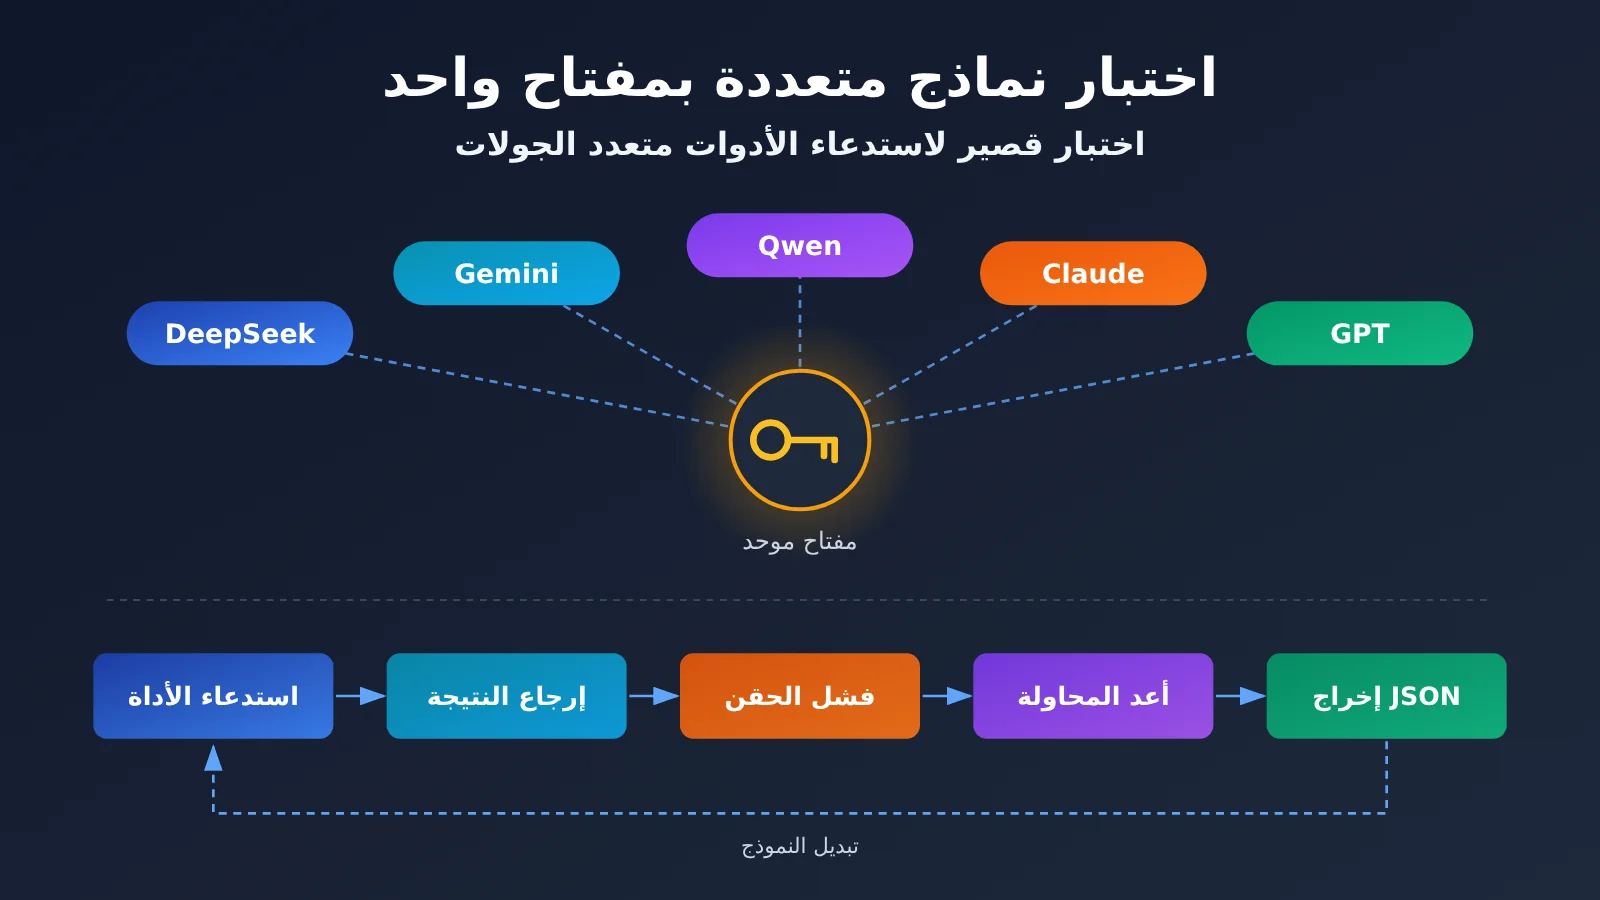
هذا ليس تصنيفًا للنماذج. لا يقدّم هذا المقال أي نتائج أداء لم تُختبر فعليًا، بل يشرح فقط كيفية تصميم الاختبار لتصل إلى استنتاجات داخل سيناريو عملك. يكمن مفتاح الاختبار في ضبط المتغيرات: مفتاح API واحد، ونفس تعريفات الأدوات، ونفس بيانات Mock، مع تغيير اسم النموذج فقط. عبر منصات تجميع مثل APIYI apiyi.com، يمكن لمفتاح واحد استدعاء نماذج متعددة مثل DeepSeek وGemini وQwen وClaude وGPT، ما يقلل كثيرًا من تكلفة التبديل عند المقارنة الأفقية.
القيمة الأساسية: بعد قراءة هذا المقال، ستتمكن من بناء اختبار لاستدعاء الأدوات متعدد الجولات من 5 خطوات وقابل لإعادة الإنتاج. يغطي هذا الاختبار خمس مراحل أساسية: اختيار الأداة، والتحقق من المعاملات، وإرجاع معرّف الاستدعاء، وإعادة المحاولة عند الفشل، والتحقق النهائي من JSON.
النقاط الأساسية في اختبار صغير لاستدعاء الأدوات متعدد الجولات
قبل تصميم اختبار استدعاء الأدوات متعدد الجولات، علينا أولًا أن نحدد ما نعنيه بـ«قابلية إعادة الإنتاج». فالمدخلات نفسها، عندما تُشغَّل في أوقات مختلفة وبواسطة أشخاص مختلفين، يجب أن تعطي نتيجة من النوع نفسه قابلة للمقارنة. ولا يمكن اعتبار مخرجات جميلة لمرة واحدة استنتاجًا نهائيًا. يوضح الجدول التالي الهيكل الأساسي للاختبار.
| النقطة | الشرح | القيمة |
|---|---|---|
| مفتاح واحد، نماذج متعددة | تمر جميع النماذج عبر نقطة دخول واجهة واحدة، مع تغيير حقل model فقط | استبعاد التشويش الناتج عن الشبكة والمصادقة وإصدار SDK |
| أدوات Mock ثابتة | قيم إرجاع الأدوات محددة مسبقًا بشكل ثابت، دون الاتصال بقاعدة بيانات حقيقية أو خدمة خارجية | تكون نتائج الأدوات متطابقة تمامًا في كل تشغيل |
| حقن فشل واحد | عند أول استدعاء لأداة معينة، يُعاد خطأ قابل لإعادة المحاولة بشكل ثابت | ملاحظة ما إذا كان النموذج يعيد المحاولة بشكل صحيح، وما إذا كان يختلق البيانات |
| نهاية منظمة | يجب أن تكون الإجابة النهائية JSON مطابقًا لـ Schema | يمكن لبرنامج تحديد النجاح أو الفشل تلقائيًا |
| تسجيل كامل | حفظ معاملات الطلب والاستجابة الخام وusage والزمن المستغرق | يمكن مراجعة الاستنتاجات، وإجراء اختبار انحدار بعد تغيير إصدار النموذج |
لماذا يجب أن يكون اختبار استدعاء الأدوات متعدد الجولات «صغيرًا»؟
يجب أن يكون الاختبار صغيرًا لأن الاختبارات الكبيرة يصعب إعادة إنتاجها. قد تضم سلسلة الأدوات في الأعمال الحقيقية ما يزيد على عشرة أدوات وتعتمد على أنظمة خارجية، وأي تقلّب في أحد جوانبها قد يُفسَّر خطأً على أنه مشكلة في النموذج. لا يحتاج الاختبار الصغير الجيد إلا إلى أداتين أو ثلاث أدوات للقراءة فقط، مع فشل واحد يُحقَن يدويًا، ليغطي أكثر أجزاء الحلقة متعددة الجولات عرضةً للخطأ.
كما يجب أن يكون الاختبار «كاملًا». يجب أن يُنفّذ الحلقة بأكملها، لا أن يكتفي بالنظر فيما إذا كان النموذج سيبدأ استدعاء أداة في الجولة الأولى. تقدم كثير من النماذج أداءً جيدًا في الجولة الأولى، لكن المشكلة تظهر في الجولتين الثانية والثالثة: عدم إرفاق معرّف الاستدعاء الصحيح، أو الاستسلام فور تلقي خطأ، أو اختلاق رقم تتبع شحنة في غياب البيانات. لا يمكن رصد هذه المشكلات إلا بإكمال الحلقة حتى الجولة الأخيرة.
مبادئ تصميم اختبار عدة نماذج بمفتاح واحد
ضبط المتغيرات شرط مسبق للاختبار المقارن. إذا استخدم النموذج A حزمة SDK الرسمية، واستخدم النموذج B حزمة SDK تابعة لجهة خارجية، وغيّر النموذج C عنوان وكيل آخر، فلن نستطيع تمييز ما إذا كان الفرق الأخير ناتجًا عن النموذج أم عن مسار الاتصال. بعد توحيد نقطة الدخول، تبقى طريقة المصادقة واستراتيجية إعادة المحاولة وإعدادات المهلة وتنسيق السجلات متسقة، ويكون المتغير الوحيد هو النموذج نفسه.
اختبار مصغّر للبدء السريع في استدعاء الأدوات متعدد الجولات
لا يتضمن هذا القسم كودًا، بل يسرد المعاملات وتعريفات الأدوات وخطوات التنفيذ فقط. يمكنك التنفيذ بأي لغة تجيدها، سواء Python أو Node.js أو Shell script. النقطة المهمة هي كتابة كل عنصر إعداد في ملف إعداد ثابت، وحفظه مع نتائج الاختبار.
الخطوة 1: توحيد الواجهة ومعاملات التشغيل
حدّد أولاً مدخل الواجهة ومعاملات أخذ العينات. يدعم APIYI صيغتي واجهة OpenAI وAnthropic في الوقت نفسه؛ ويمكن استخدام المفتاح نفسه للاستدعاء بأسلوب Chat Completions أو بأسلوب Messages. يسرد الجدول التالي عناصر الإعداد المقترح تثبيتها.
| عنصر الإعداد | القيمة المقترحة | الوصف |
|---|---|---|
| base_url (تنسيق OpenAI) | https://api.apiyi.com/v1 |
الاستدعاء عبر مدخل APIYI الموحّد، والعنوان الدقيق وفق وثائق docs.apiyi.com |
| base_url (تنسيق Anthropic) | راجع عنوان التوافق مع Anthropic في وثائق APIYI | يُستخدم لاختبار بروتوكول tool_use / tool_result |
| api_key | المفتاح نفسه | مشترك بين جميع النماذج لاستبعاد فروق المصادقة |
| temperature | 0 أو أقل ما يمكن | لتقليل العشوائية؛ وإذا لم يدعمه بعض نماذج الاستدلال فسجّل القيمة الفعلية |
| max_tokens | قيمة ثابتة | لتجنّب التقييم الخاطئ بسبب اقتطاع المخرجات |
| tool_choice | auto | لمراقبة قرار النموذج المستقل دون فرض الاستدعاء |
| الحد الأقصى لجولات التكرار | حد أعلى ثابت، مثل 6 جولات | لمنع النموذج من الانزلاق إلى إعادة محاولة لا نهائية |
| عدد مرات تشغيل كل نموذج | عدد ثابت من المرات، مثل 5 مرات | استخدم نتائج عدة مرات للحكم على الاستقرار، بدلاً من الاعتماد على أداء مرة واحدة |
🚀 اقتراح البدء السريع: يمكنك أولاً التسجيل في APIYI عبر apiyi.com والحصول على مفتاح، ثم استدعاء النماذج المرشحة واحداً تلو الآخر بالمفتاح نفسه. وبعد التأكد من أن كل نموذج يعيد استجابة طبيعية لاستدعاء الأدوات، ابدأ الاختبار الرسمي. راجع تعليمات الربط في docs.apiyi.com.
الخطوة 2: تعريف أداتين إلى ثلاث أدوات للقراءة فقط
لتصميم الأدوات شرطان: أن تكون للقراءة فقط، وأن تكون حتمية. الغرض من «للقراءة فقط» منع تفعيل عمليات الكتابة عن طريق الخطأ أثناء الاختبار، والغرض من كونها حتمية ضمان أن تكون قيمة الإرجاع نفسها في كل مرة. يُنصح باستخدام سيناريو وهمي للاستعلام عن طلب، يتضمن أداتين:
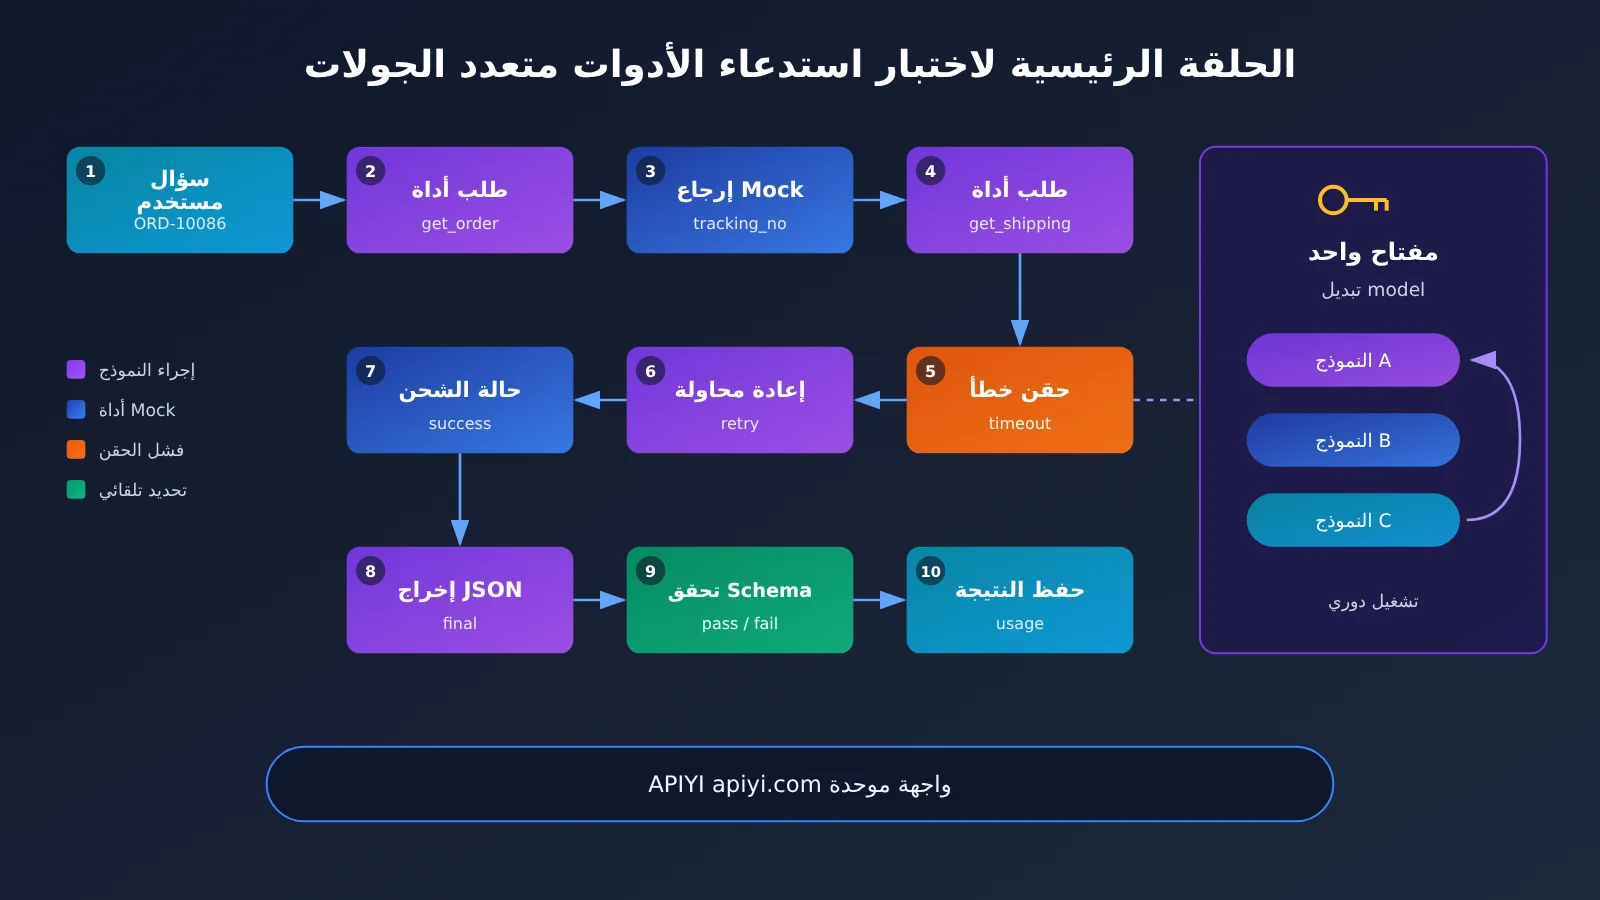
- get_order: المعامل order_id (سلسلة نصية، وصيغتها ثابتة: “ORD-” متبوعة بأرقام). تعيد دائمًا حالة الطلب واسم المنتج ورقم التتبع tracking_no.
- get_shipping: المعامل tracking_no (سلسلة نصية). في الاستدعاء الأول تعيد دائمًا خطأً، يتضمن محتوى الخطأ error بقيمة timeout وretryable بقيمة true؛ وفي الاستدعاء الثاني وما بعده تعيد حالة شحن ثابتة وتاريخ تسليم متوقع.
- أداة تشتيت اختيارية get_coupon: لا علاقة لها بالسؤال، وتُستخدم لمراقبة ما إذا كان النموذج سيستدعيها بلا داعٍ.
يجب كتابة Schema المعاملات بشكل صارم: أنواع الحقول، والحقول الإلزامية، وصيغة التعبير النمطي regex — كلها يجب أن تكون واضحة. تمر المعاملات التي يولّدها النموذج أولاً عبر تحقق Schema قبل تسليمها إلى دالة Mock. وعند فشل التحقق، يجب تسجيل ذلك على أنه «خطأ في المعاملات»، دون تصحيحه بصمت.
الخطوة 3: كتابة موجه ثابت وسؤال مستخدم ثابت
يحتوي موجه System على القواعد فقط، لا على الإجابات. يمكنك أن تطلب من النموذج ألا يجيب إلا استنادًا إلى البيانات التي تعيدها الأدوات؛ وأن يعيد المحاولة مرتين كحد أقصى عندما تعيد الأداة خطأً قابلًا لإعادة المحاولة؛ وأن يُخرج في النهاية كائن JSON واحدًا فقط، بحقول: order_status وshipping_status وeta وdata_source. سؤال المستخدم ثابت، ويُصاغ في جملة واحدة، مثل: «ساعدني في معرفة أين وصل الطلب ORD-10086 الآن».
بمجرد تثبيت الموجه، لا يُعدّل بعد ذلك. إذا ظهر أثناء الاختبار أن أحد النماذج فشل بسبب غموض في الموجه، فالإجراء الصحيح هو إنشاء رقم إصدار جديد وإعادة اختبار جميع النماذج بالإصدار الجديد، بدلًا من تعديل الموجه لهذا النموذج وحده.
الخطوة 4: تنفيذ الحلقة وحقن الفشل
تسير منطقية التنفيذ وفق الترتيب التالي:
- إرسال رسالتي system وuser، إلى جانب تعريفات الأدوات.
- إذا احتوى الرد على استدعاءات أدوات، يتم التحقق من المعاملات واحدًا تلو الآخر، ثم تنفيذ دالة Mock المقابلة، وإرجاع النتيجة وفق ما يقتضيه البروتوكول.
- عند أول استدعاء لـ get_shipping، يُعاد دائمًا خطأ قابل لإعادة المحاولة.
- تكرار الخطوة 2 حتى يقدّم النموذج ردًا نهائيًا لا يتضمن استدعاء أدوات، أو حتى الوصول إلى الحد الأقصى لعدد الدورات.
- التحقق من الرد النهائي باستخدام JSON Schema، وحفظ جميع الرسائل والرد الخام وقيمة usage لكل دورة.
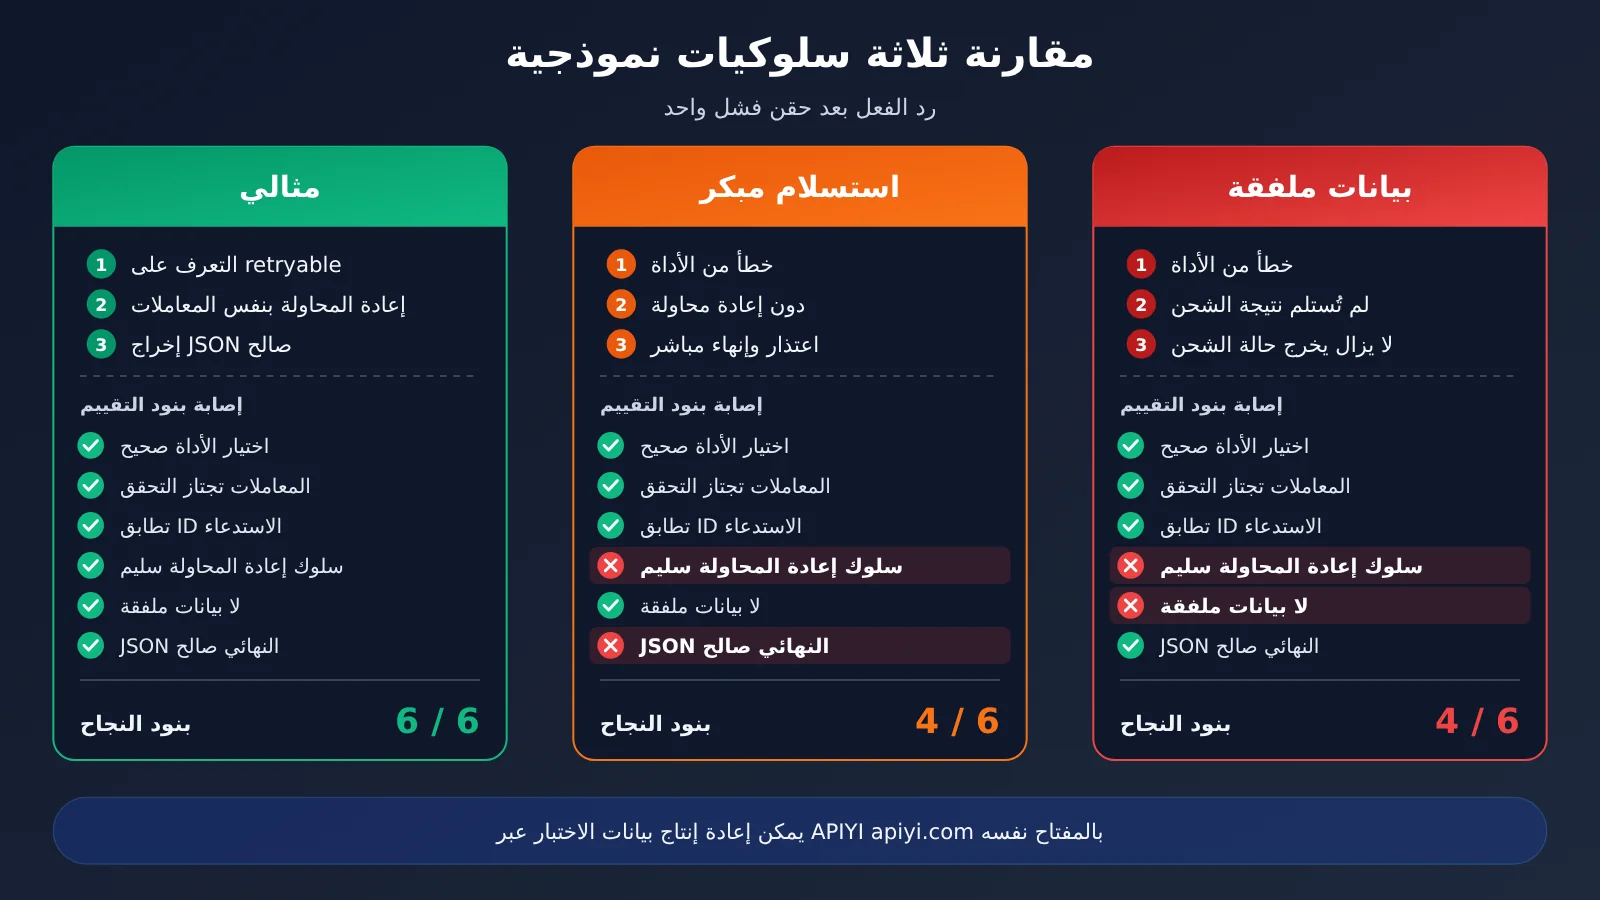
حقن الفشل هو الجزء الأكثر تمييزًا في هذا الاختبار بأكمله. السلوك المثالي هو أن يدرك النموذج أن retryable قيمته true، فيستدعي get_shipping مرة أخرى بالمعاملات نفسها. أما سلوكيات المشكلة الشائعة فهي ثلاثة: الاعتذار للمستخدم وإنهاء المحادثة مباشرة؛ أو اختلاق حالة شحن من عنده؛ أو تعديل المعاملات وإعادة المحاولة مرارًا حتى تجاوز الحد الأقصى لعدد الدورات.
الخطوة 5: التقييم وفق قائمة التحقق وتوثيق الأثر
بعد انتهاء كل تشغيل، يتم الحكم على كل بند برمجيًا، مع الحرص على ألّا يعتمد الأمر على التقييم الذاتي البشري قدر الإمكان. أما العنصر البشري فلا يتولى سوى مراجعة العينات التي تُعلّمها البرامج على أنها غير طبيعية.
اختلافات بروتوكول استدعاء الأدوات متعدد الجولات: تنسيق OpenAI وAnthropic
لكي يعمل الاختبار نفسه مع تنسيقي الواجهتين، لا بد أولاً من فهم فروق تفاصيل البروتوكول. فروق صغيرة في البروتوكول قد تؤدي إلى مشكلات من نوع «يعمل مع curl ولا يعمل مع العميل». يُنصح أولاً بتأكيد صحة البروتوكول باستخدام أصغر طلب ممكن، ثم البدء في مقارنة قدرات النماذج.
| المرحلة | تنسيق متوافق مع OpenAI | تنسيق متوافق مع Anthropic |
|---|---|---|
| تعريف الأدوات | مصفوفة tools، كل عنصر منها type قيمته function، وتُكتب المعاملات في parameters | مصفوفة tools، ويُكتب مخطط المعاملات (Schema) في input_schema |
| بدء النموذج للاستدعاء | tool_calls داخل رسالة assistant، وكل منها يحمل id | tool_use داخل كتلة محتوى assistant، وكل منها يحمل id |
| شكل المعاملات | تكون arguments عادةً سلسلة JSON، وتحتاج إلى تحليل من جانبك | يكون input كائن JSON مباشرةً |
| إعادة النتائج | رسالة تحمل role بقيمة tool، وتحتوي على tool_call_id | كتلة محتوى tool_result داخل رسالة user، وتحمل tool_use_id |
| الإشارة إلى الأخطاء | عادةً يُعرَّف حقل خطأ مخصص داخل محتوى النتيجة | يدعم tool_result علامة is_error |
| الاستدعاء المتوازي | قد تتضمن استجابة واحدة عدة tool_calls | قد تتضمن استجابة واحدة عدة كتل tool_use |
هناك عدة أخطاء شائعة يسهل الوقوع فيها. أولاً، في تنسيق OpenAI يكون arguments سلسلة نصية، وقد تُخرج بعض النماذج أحياناً أحرفاً زائدة تؤدي إلى فشل التحليل. وينبغي احتساب هذه النقطة نفسها ضمن التقييم، لا معالجتها بالتسامح داخل الشيفرة. ثانياً، عند إعادة النتيجة يجب أن يقابل المعرّف ID المعرّف المستخدم في بدء الاستدعاء واحداً بواحد، مع الانتباه خصوصاً إلى الترتيب في الاستدعاءات المتوازية. ثالثاً، بعض النماذج تُخرج نصاً وتبدأ استدعاء أداة في الرد نفسه، لذا يجب أن يكون منطق المعالجة متوافقاً مع النوعين معاً.
💡 نصيحة تقنية: عبر المدخل الموحد لـ APIYI apiyi.com، يمكن استخدام المفتاح نفسه لتشغيل الاختبار نفسه بتنسيق OpenAI وتنسيق Anthropic على التوالي. بهذه الطريقة يمكن التمييز بين ما إذا كانت المشكلة في النموذج نفسه أم في طبقة تكييف البروتوكول.
قائمة تقييم استدعاء الأدوات متعدد الجولات وقالب التسجيل
قائمة التقييم هي ما يجعل النتائج قابلة لإعادة الإنتاج. يجب أن يكون كل بند قابلاً للحكم برمجياً، وأن يرتبط بمخاطر أعمال حقيقية. يوضح الجدول التالي بنود الفحص الموصى بها، ويمكنك إضافة بنود أو حذفها بحسب طبيعة عملك.
| بند الفحص | طريقة الحكم | خطر العمل المرتبط |
|---|---|---|
| اختيار الأداة صحيح | في الجولة الأولى يُستدعى get_order، دون استدعاء أدوات مُضلِّلة | الاستدعاءات الزائدة تزيد زمن الاستجابة والتكلفة |
| المعاملات تجتاز التحقق | تستوفي المعاملات Schema، بما في ذلك النوع والحقول المطلوبة والتنسيق | المعاملات الخاطئة تصل إلى الأنظمة الحقيقية |
| معرّف الاستدعاء مطابق بشكل صحيح | النتيجة المرتجعة تتطابق مع معرّف الاستدعاء الذي بدأ العملية | اضطراب السياق في الجولات المتعددة |
| سلوك إعادة المحاولة سليم | بعد استلام خطأ قابل لإعادة المحاولة، تُعاد المحاولة بالمعاملات نفسها دون تجاوز الحد | التخلي المبكر أو إعادة المحاولة بلا نهاية |
| لا توجد بيانات مُختلقة | كل الحقول في الإجابة النهائية يمكن العثور عليها في قيم إرجاع الأدوات | الهلوسة تؤثر مباشرة في المستخدم |
| JSON النهائي صالح | يجتاز التحقق من JSON Schema دون نص زائد | فشل التحليل في الأنظمة اللاحقة |
| عدد الجولات واستهلاك Token | تسجيل إجمالي الجولات وToken الإدخال والإخراج | تقييم التكلفة وزمن الاستجابة |
بعد تشغيل كل نموذج عدداً ثابتاً من المرات، تُجمَّع النتائج في جدول واحد. تشمل الأعمدة المقترحة: معرّف النموذج، وصيغة الواجهة، ورقم التشغيل، وعدد البنود الناجحة، وتفاصيل البنود الفاشلة، وإجمالي الجولات، وToken الإدخال، وToken الإخراج، والزمن المستغرق، وتاريخ الاختبار. يُحفظ رأس الجدول مع ملف التكوين في مستودع الإصدارات. وعند ترقية النموذج أو الانتقال إلى إصدار جديد، يكفي إعادة تشغيل المجموعة نفسها من السكربتات لإجراء مقارنة انحدار.
كيف تُسجَّل تكلفة استدعاء الأدوات متعدد الجولات
يجب تسجيل استهلاك Token لكل جولة على حدة، لا الاكتفاء بالجولة الأخيرة. في الحلقة متعددة الجولات، تعيد كل جولة إرسال الرسائل السابقة ونتائج الأدوات كمدخلات، لذا يتراكم Token الإدخال جولة بعد جولة. وكلما زادت إعادات المحاولة، ارتفعت التكلفة. ولهذا يستحق بند «سلوك إعادة المحاولة سليم» تقييماً منفصلاً.
عند حساب التكلفة، اضرب Token الإدخال وToken الإخراج في usage — وإن حدثت إصابة في ذاكرة التخزين المؤقت، فهناك أيضاً Token ذاكرة التخزين المؤقت — في سعر الوحدة المقابل لكل منها. جميع أسعار الإدخال والإخراج وأسعار التخزين المؤقت وقواعد الفوترة لدى كل النماذج تعتمد على البيانات الفعلية في صفحة أسعار APIYI: docs.apiyi.com/models. لا تورد هذه المقالة أرقاماً محددة، لأن الأسعار تتغير، وتثبيتها في المقال يجعلها عرضة للتقادم بسهولة.
مفتاح واحد لاختبار عدة نماذج: قائمة النماذج المرشحة
يُفضّل أن تغطي النماذج المرشحة جهات مصنّعة وفئات مختلفة، مثل نموذج اقتصادي عالي الكفاءة، ونموذج أساسي للعمل اليومي، ونموذج أقوى في الاستدلال. يعرض الجدول التالي سلاسل النماذج ونقاط الاختبار فقط، دون تقديم استنتاجات؛ إذ ينبغي أن تأتي الاستنتاجات من بيانات اختبارك الفعلية.
| سلسلة النماذج | نقاط الاختبار المقترحة | صيغة الواجهة الموصى بها | المنصات المتاحة |
|---|---|---|---|
| سلسلة DeepSeek | استقرار تحليل سلاسل المعاملات، وإعادة المحاولة بعد فشل الحقن | متوافق مع OpenAI | APIYI apiyi.com، API الرسمي |
| سلسلة Gemini | النزعة إلى الاستدعاء المتوازي، وهل يحتوي JSON النهائي على نص إضافي | متوافق مع OpenAI | APIYI apiyi.com، API الرسمي |
| سلسلة Qwen | الاستدعاء الخاطئ لأدوات التشويش، ومطابقة المعرّفات عبر الجولات المتعددة | متوافق مع OpenAI | APIYI apiyi.com، API الرسمي |
| سلسلة Claude | معالجة is_error في tool_result، والتحكم في عدد الجولات |
متوافق مع Anthropic | APIYI apiyi.com، API الرسمي |
| سلسلة GPT | الالتزام الصارم بـ Schema، واستهلاك Token | متوافق مع OpenAI | APIYI apiyi.com، API الرسمي |
أما معرّفات النماذج وإصداراتها المتاحة فعليًا، فتُعتمد وفق قائمة نماذج APIYI. عند تسجيل النتائج، احرص على كتابة معرّف النموذج كاملاً، ولا تكتفِ باسم السلسلة. قد تختلف الإصدارات المختلفة ضمن السلسلة نفسها اختلافًا كبيرًا في أداء استدعاء الأدوات.
💡 نصيحة للاختيار: يعتمد اختيار النموذج على مدى تعقيد أدواتك، ودرجة تحمّلك للهلوسة، وميزانية التكلفة. يُوصى بتشغيل كل نموذج مرشح لمرة واحدة على APIYI apiyi.com باستخدام المفتاح نفسه، ثم الجمع بين النتائج وبيانات الأسعار في docs.apiyi.com/models لاتخاذ قرار شامل.
الأسئلة الشائعة (FAQ)
س1: ما هو اختبار استدعاء الأدوات متعدد الجولات المصغّر؟
هو اختبار صغير الحجم ومحدَّد النتائج. يعتمد على 2 إلى 3 أدوات وهمية (Mock) وحقن فشل واحد، ليترك النموذج ينفّذ دورة كاملة: «استدعاء الأداة، معالجة النتيجة، إعادة المحاولة، إخراج إجابة منظَّمة»، ثم يتحقق البرنامج من كل بند على حدة ليحكم بالنجاح أو الفشل. ما يهمّه هو ما إذا كانت الدورة تعمل باستقرار، وليس مستوى معرفة النموذج.
س2: لماذا نُشدّد على اختبار عدة نماذج بمفتاح واحد؟
من أجل ضبط المتغيرات. فالمفاتيح المختلفة وSDK وعناوين الوكيل تُدخل فروقًا في المصادقة والمهلات وتوافق البروتوكول، فتُشوّه نتائج المقارنة. وبعد توحيد نقطة الدخول، لا يتغيّر سوى حقل `model`، وبذلك يمكن إرجاع الفروق الملاحَظة إلى النموذج نفسه.
س3: هل ضبط temperature على 0 يضمن التكرار التام للنتائج؟
لا يضمن ذلك تمامًا. فحتى مع temperature = 0 تبقى مخرجات بعض النماذج متذبذبة قليلًا، كما أن نماذج الاستدلال قد لا تدعم خفض هذا المعامل أصلًا. لذلك يجب تشغيل الاختبار عدة مرات بشكل ثابت، والنظر إلى معدل النجاح وتوزيع حالات الفشل، لا إلى نتيجة مرة واحدة. كذلك يجب تسجيل قيم المعاملات المستخدمة فعليًا.
س4: ما السيناريوهات التي يناسبها هذا الاختبار؟
– **اختيار الـ Agent**: مقارنة استقرار النماذج المرشَّحة في دورة الأدوات قبل الإطلاق.
– **اختبار الانحدار عند ترقية النموذج**: بعد إصدار نسخة جديدة، أعِد تشغيل السكربت نفسه للتأكد من عدم وجود تراجع.
– **التحقق من ترحيل البروتوكول**: عند الانتقال من صيغة OpenAI إلى صيغة Anthropic، تأكَّد من سلامة طبقة التوافق.
س5: كيف أبدأ سريعًا في استدعاء هذه النماذج؟
1. زر APIYI على apiyi.com وسجّل حسابًا واحصل على مفتاح.
2. اقرأ docs.apiyi.com وتأكَّد من عنوان التوافق مع OpenAI وعنوان التوافق مع Anthropic.
3. اضبط الإعدادات وفق جدول المعاملات في الخطوة 1 من هذا المقال، وابدأ بأصغر طلب للتأكد من أن كل نموذج يعيد استدعاء أداة.
تدعم APIYI الوصول الموحَّد إلى عدة نماذج مذكورة في هذا المقال، والتبديل بينها يحتاج فقط إلى تعديل حقل `model`.
س6: كيف يمكن تقدير تكلفة الاختبار؟
التكلفة تساوي تقريبًا «عدد النماذج × عدد مرات التشغيل × إجمالي الـ Token لكل تشغيل × سعر الوحدة». ففي الدورة متعددة الجولات تتراكم Tokens الإدخال جولةً بعد جولة، وتزيد إعادة المحاولة الاستهلاك أكثر. أما أسعار الوحدة وقواعد فوترة التخزين المؤقت فتُؤخذ من البيانات الفعلية في صفحة الأسعار docs.apiyi.com/models. يُنصح بتشغيل كل نموذج مرة واحدة أولًا لتقدير الاستهلاك، ثم تحديد عدد مرات التشغيل الرسمي.
س7: ما القيود التي يشملها هذا الاختبار؟
لا تستطيع الاختبارات الصغيرة تغطية سوى أنماط الفشل النمطية، ولا تمثل كل سيناريوهات الأعمال المعقدة. فبيانات أدوات المحاكاة (Mock) تأتي نظيفة ومرتبة، في حين قد يعيد النظام الحقيقي بيانات مشوّشة الصياغة أو فائقة الطول. وبعد نجاح الاختبار، يُستحسن إضافة عينات استثنائية ظهرت فعليًا في العمل، ثم توسيع الحالات تدريجيًا.
أهم النقاط الأساسية في اختبار استدعاء الأدوات متعدد الجولات
- التحكم في المتغيرات أولًا: استخدم مفتاحًا واحدًا وإعدادًا واحدًا، وغيّر حقل model فقط.
- أدوات للقراءة فقط وحتمية: ثبّت قيم الإرجاع في Mock، لتحصل في كل تشغيل على البيانات نفسها.
- حقن الفشل أمر لا مفر منه: خطأ واحد قابل لإعادة المحاولة هو أفضل ما يكشف قدرة النموذج على التعامل مع الحلقات.
- التقييم برمجي: كل بند فحص يمكن الحكم عليه آليًا، ويقتصر دور الإنسان على مراجعة الحالات الاستثنائية.
- تسجيل كامل للأثر: احفظ الاستجابة الأصلية وقيمة usage في كل جولة ومعرّف النموذج الكامل، لتسهيل اختبارات الانحدار.
- الأسعار تُؤخذ من الصفحة الرسمية: احسب التكلفة بناءً على صفحة أسعار APIYI على docs.apiyi.com/models.
- مدخل موحّد يوفّر الجهد: بفضل توافق APIYI مع صيغ OpenAI وAnthropic، يستطيع سكربت واحد تغطية البروتوكولين معًا.
الخلاصة
اختبار مصغّر لاستدعاء الأدوات متعدد الجولات لعدة نماذج بمفتاح واحد، ويرتكز على ثلاث نقاط:
- قابلية إعادة الإنتاج: تثبيت الإعدادات، وتثبيت بيانات Mock، وتثبيت نسخة الموجه، ثم التشغيل عدة مرات.
- قابلية الحكم: استخدام التحقق عبر Schema وقائمة تقييم بدلاً من الانطباع الذاتي.
- قابلية الانحدار: تسجيل كامل للأثر، بحيث يمكن بعد ترقية النموذج إعادة الاختبار بسرعة باستخدام نفس مجموعة السكربتات.
لن تخبرك هذه الطريقة “أي نموذج هو الأفضل”، لكنها ستخبرك أي نموذج أكثر استقرارًا وأقل استهلاكًا لـ Token داخل سلسلة أدواتك، وأكثر قابلية للتحكم عند الفشل. يُنصح أولاً بتشغيل سيناريو الاستعلام عن الطلبات الوارد في هذا المقال لإتمام العملية، ثم استبداله بالأدوات الموجودة في عملك.
نوصي بإجراء التحقق المتقاطع متعدد النماذج عبر APIYI على apiyi.com باستخدام المفتاح نفسه. طريقة الوصول موضحة في docs.apiyi.com، وأسعار وآلية الفوترة وفقًا لما هو منشور في docs.apiyi.com/models.
📚 المراجع
- توثيق استدعاء الدوال في OpenAI: شرح بروتوكول tools وtool_calls ورسائل دور tool
- الرابط:
platform.openai.com/docs/guides/function-calling -
الشرح: فهم كيفية معالجة سلاسل المعاملات وtool_call_id في التنسيق المتوافق مع OpenAI
-
توثيق استخدام الأدوات في Anthropic: شرح كتل المحتوى tool_use وtool_result
- الرابط:
docs.anthropic.com/en/docs/build-with-claude/tool-use -
الشرح: التعرف على استخدام input_schema وtool_use_id وis_error
-
مركز توثيق APIYI: شرح الوصول إلى الواجهة الموحدة
- الرابط:
docs.apiyi.com -
الشرح: الاطلاع على عناوين التوافق مع OpenAI وAnthropic وأمثلة الاستدعاء
-
صفحة النماذج والأسعار في APIYI: قائمة النماذج وآلية الفوترة
- الرابط:
docs.apiyi.com/models - الشرح: جميع أسعار الإدخال والإخراج والتخزين المؤقت وفقًا للبيانات الفعلية في هذه الصفحة
المؤلف: فريق APIYI التقني
التواصل التقني: نرحب بتواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI على apiyi.com، ولمزيد من مواد الوصول يمكنكم زيارة مركز توثيق docs.apiyi.com