著者注:1つのAPIキー、1つの固定スクリプト、1回の注入失敗を使って複数モデルのマルチターン・ツール呼び出し能力を横並び比較し、再現可能で検証可能な結論を得る。
Agent向けのモデルを選ぶとき、多くのチームが同じ問題に直面します。単一ターンのQ&Aでは各モデルの性能にほとんど差がありませんが、「ツールを呼び出す → 結果を受け取る → さらに呼び出す → エラーを処理する → 構造化された回答を返す」というマルチターンのループに入ると、違いがはっきりと現れます。本記事では、1つのAPIキーで複数モデルのマルチターン・ツール呼び出しをテストする小さな検証を紹介します。低コストで、この違いを記録・検証できるデータに変える方法です。
これはモデルのランキングではありません。 本記事では、実測していないベンチマークスコアは一切提供しません。テストの設計方法だけを解説し、読者の皆さんがご自身の業務シーンで結論を出せるようにします。テストの鍵は変数の制御です。同じAPIキー、同じツール定義、同じMockデータを使い、モデル名だけを変えます。APIYI apiyi.com のようなアグリゲーションプラットフォームを利用すれば、1つのAPIキーで DeepSeek、Gemini、Qwen、Claude、GPT など複数のモデルを呼び出せるため、横並び比較の際の切り替えコストを大幅に削減できます。
コアバリュー:本記事を読み終えると、5ステップで再現可能なマルチターン・ツール呼び出しテストを構築できるようになります。このテストは、ツール選択、パラメータ検証、呼び出しIDの返送、失敗時のリトライ、最終JSON検証という5つの重要なポイントをカバーします。
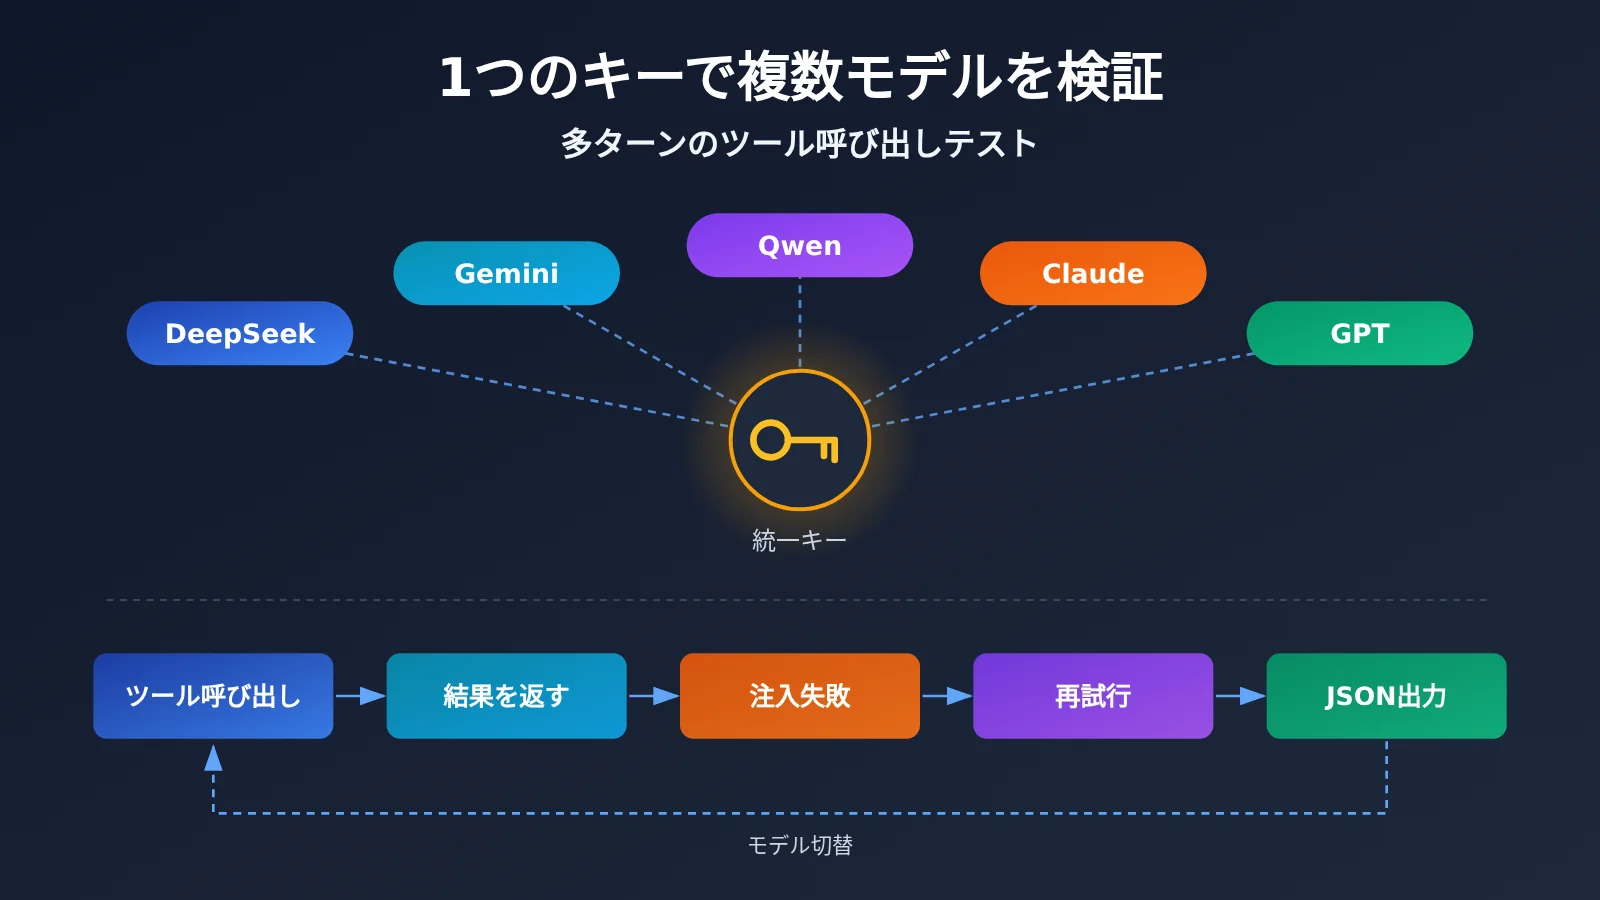
マルチターン・ツール呼び出し小テストの核心ポイント
マルチターンのツール呼び出しテストを設計する前に、「再現可能」とは何かを明確にします。同じ入力であれば、時間や実行者が違っても、比較可能な同種の結果が得られるべきです。一度だけの見栄えのよい出力は結論にはできません。以下の表がテスト全体の骨格です。
| ポイント | 説明 | 価値 |
|---|---|---|
| 1つのキー、複数モデル | すべてのモデルが同じインターフェース入口を通り、model フィールドだけを変更 |
ネットワーク、認証、SDKバージョンによるノイズを排除 |
| 固定Mockツール | ツールの戻り値をハードコードし、実DBや外部サービスには接続しない | 毎回の実行で見えるツール結果が完全に一致 |
| 1回だけ失敗を注入 | あるツールの初回呼び出しが必ず再試行可能なエラーを返す | モデルが正しく再試行できるか、データを捏造しないかを観察 |
| 構造化された終点 | 最終回答はSchemaに準拠したJSONでなければならない | プログラムで自動的に合格/不合格を判定できる |
| 完全な証跡 | リクエストパラメータ、生のレスポンス、usage、所要時間を保存 | 結論を再確認でき、モデルバージョン変更後に回帰テストできる |
マルチターン・ツール呼び出しテストはなぜ「小さく」するのか
テストは小さくする必要があります。大きなテストは再現しにくいからです。実際の業務のツールチェーンには十数個のツールがあり、外部システムに依存していることもあります。どこか一箇所でも変動すると、それがモデルの問題だと誤認されてしまいます。よい小テストは、読み取り専用のツールを2〜3個用意し、人為的に1回の失敗を注入するだけで、マルチターンのループで最もエラーが起きやすい箇所をカバーできます。
テストは「完全」であることも必要です。モデルが最初のターンでツール呼び出しを発行できるかだけを見るのではなく、ループ全体を最後まで実行しなければなりません。多くのモデルは最初のターンではうまくいきますが、問題は2回目、3回目のターンに現れます。正しい呼び出しIDを付けなかったり、エラーを受け取るとすぐに諦めたり、データがないのに自分で配送追跡番号をでっち上げたりします。こうした問題は、ループを最終ターンまで実行して初めて見えてきます。
1つのキーで複数モデルをテストする設計原則
比較テストの前提は変数を制御することです。Aモデルが公式SDK、BモデルがサードパーティSDK、Cモデルが別のプロキシアドレスを使っていると、最終的な差分がモデル由来なのか経路由来なのか分からなくなります。入口を統一すれば、認証方式、再試行ポリシー、タイムアウト設定、ログ形式がすべて揃い、唯一の変数はモデルそのものになります。
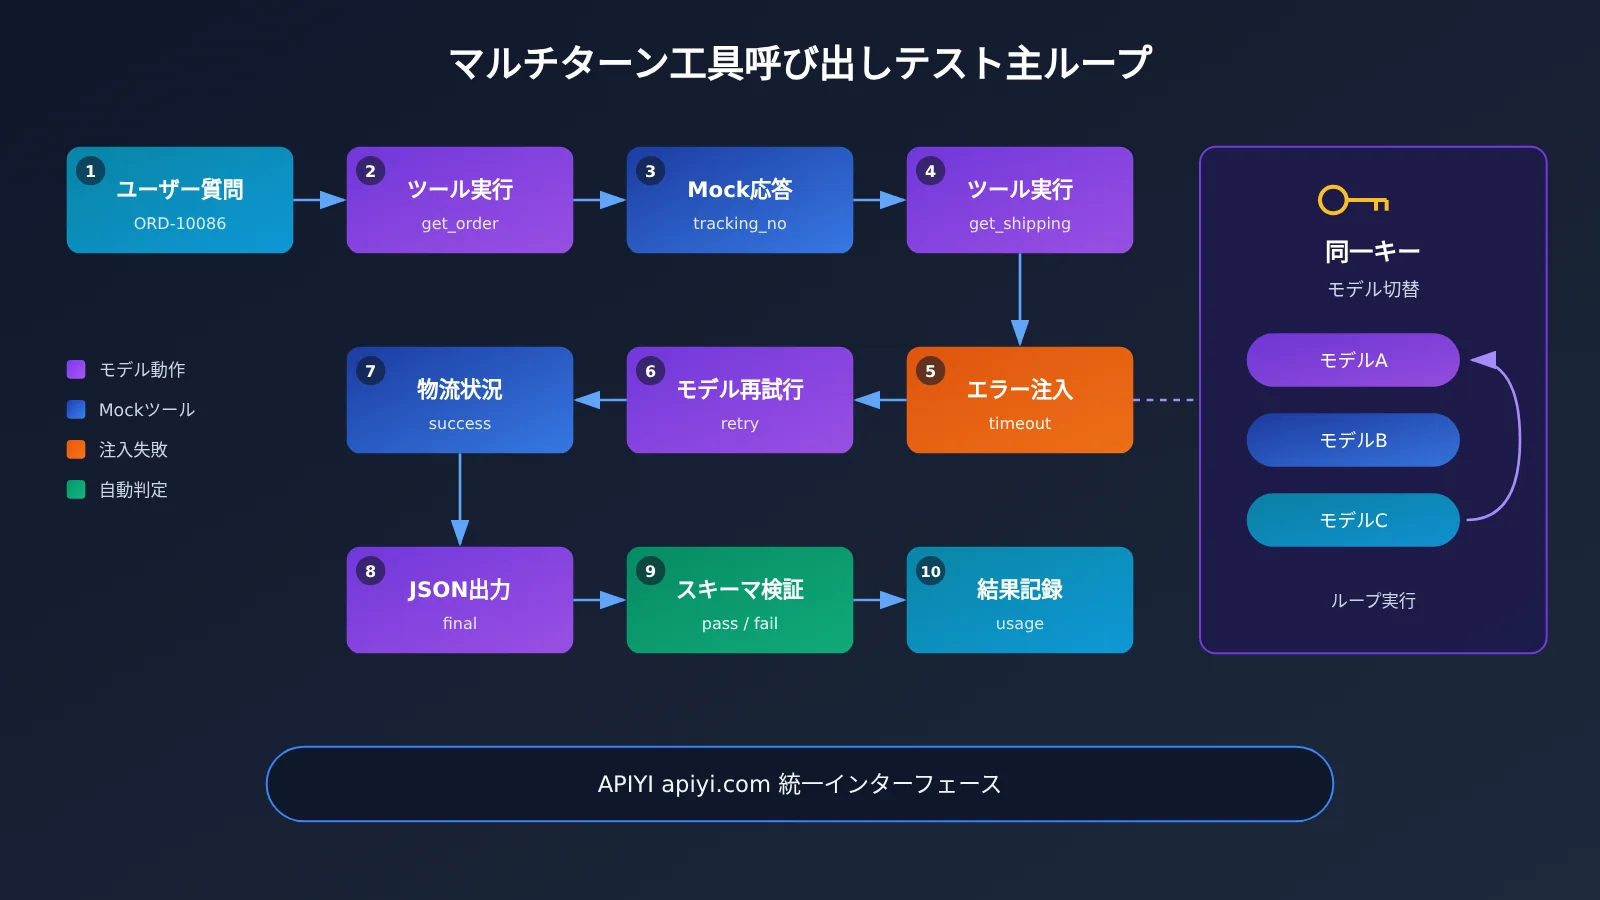
マルチターン・ツール呼び出しの小テストを素早く始める
このセクションではコードは掲載せず、パラメータ、ツール定義、実行手順のみを列挙します。Python、Node.js、Shellスクリプトなど、使い慣れた言語で実装してかまいません。ポイントは、各設定項目を固定の設定ファイルに書き出し、テスト結果と一緒に保存することです。
ステップ1:インターフェースと実行パラメータを統一する
まずインターフェースのエントリポイントとサンプリングパラメータを決めます。APIYI は OpenAI と Anthropic の2種類のインターフェース形式に同時対応しており、同じキーで Chat Completions 形式でも Messages 形式でも呼び出せます。以下の表に、固定しておくことを推奨する設定項目を挙げます。
| 設定項目 | 推奨値 | 説明 |
|---|---|---|
| base_url(OpenAI 形式) | https://api.apiyi.com/v1 |
APIYI の統一エントリポイント経由で呼び出し。具体的なアドレスは docs.apiyi.com のドキュメントに準じます |
| base_url(Anthropic 形式) | APIYI ドキュメント内の Anthropic 互換アドレスを参照 | tool_use / tool_result プロトコルのテストに使用 |
| api_key | 同じキー | すべてのモデルで共用し、認証の差異を排除 |
| temperature | 0 または可能な限り低く | ランダム性を低減。一部の推論モデルが非対応の場合は実際の値を記録 |
| max_tokens | 固定値 | 出力の切り捨てによる誤判定を避ける |
| tool_choice | auto | モデルの自律的な判断を観察し、呼び出しを強制しない |
| 最大ループ回数 | 固定の上限、たとえば 6 回 | モデルが無限リトライに陥るのを防ぐ |
| モデルごとの実行回数 | 固定回数、たとえば 5 回 | 複数回の結果で安定性を判断し、単発のパフォーマンスでは評価しない |
🚀 クイックスタートのヒント:まず APIYI apiyi.com で登録してキーを取得し、同じキーで候補モデルを順に呼び出してみましょう。各モデルが正常なツール呼び出しレスポンスを返すことを確認してから、本格的なテストを開始してください。接続方法は docs.apiyi.com を参照してください。
ステップ2:読み取り専用ツールを2〜3個定義する
ツール設計には2つの要件があります。読み取り専用であること、そして決定的であることです。読み取り専用はテスト中に誤って書き込み操作を引き起こさないためであり、決定的であることは毎回同じ戻り値を保証するためです。架空の注文照会シナリオを使い、2つのツールを含めることをおすすめします:
- get_order:パラメータは order_id(文字列、形式は「ORD-」+ 数字に固定)。注文ステータス、商品名、追跡番号 tracking_no を固定で返します。
- get_shipping:パラメータは tracking_no(文字列)。初回呼び出しは固定でエラーを返し、エラー内容には error が timeout、retryable が true が含まれます。2回目以降は固定の配送ステータスと配達予定日を返します。
- オプションの妨害ツール get_coupon:問題とは無関係で、モデルが余計な呼び出しをするかどうかを観察するために使います。
パラメータのスキーマは厳密に書く必要があります。フィールド型、必須項目、正規表現の形式をすべて明確にします。モデルが生成したパラメータは、まずスキーマ検証を経てから Mock 関数に渡します。検証に失敗した場合は「パラメータエラー」として記録し、こっそり修正してはいけません。
ステップ3:固定されたプロンプトとユーザーの質問を書く
System プロンプトにはルールだけを書き、答えは書きません。モデルに対して、ツールが返したデータのみに基づいて回答すること;ツールがエラーを返し、リトライ可能な場合は最大2回までリトライすること;最終的に1つの JSON オブジェクトのみを出力し、フィールドには order_status、shipping_status、eta、data_source を含めることを要求できます。ユーザーの質問は「注文 ORD-10086 が今どこにあるか調べてください」のような一文に固定します。
プロンプトは一度決めたらもう変更しません。テストで特定のモデルがプロンプトの曖昧さによって失敗したことが判明した場合、正しいやり方は新しいバージョン番号を切り、すべてのモデルを新しいバージョンで再テストすることであり、そのモデルだけにプロンプトを変更することではありません。
ステップ4:実行ループと失敗注入
実行ロジックは次の順序で進みます。
- system メッセージと user メッセージ、およびツール定義を送信します。
- 応答にツール呼び出しが含まれている場合は、パラメータを順に検証し、対応する Mock 関数を実行して、結果をプロトコルの要件に従って返却します。
- get_shipping の最初の呼び出しでは、固定で再試行可能なエラーを返します。
- モデルがツール呼び出しを含まない最終応答を返すか、最大ターン数に達するまで、ステップ2を繰り返します。
- JSON Schema で最終応答を検証し、すべてのメッセージ、元の応答、各ターンの usage を保存します。
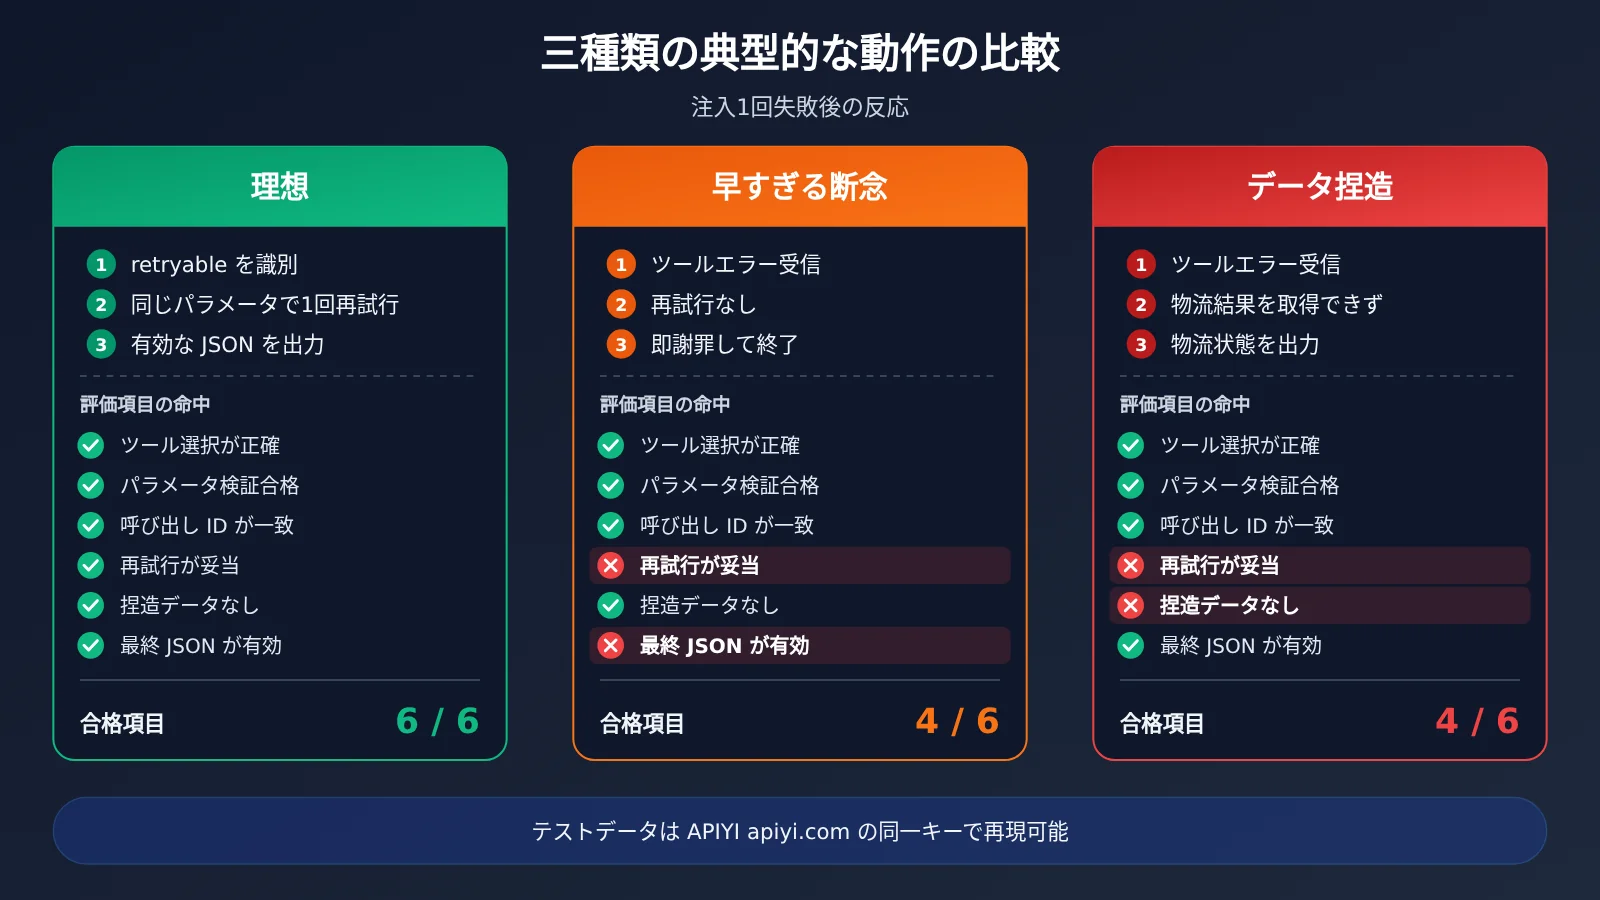
失敗注入は、このテストで最も判別力のある部分です。理想的な動作は、モデルが retryable が true であることを認識し、同じパラメータで get_shipping をもう一度呼び出すことです。よくある問題動作は3つあります。ユーザーにそのまま謝罪して終了する、配送ステータスを捏造する、パラメータを変更して上限ターンを超えるまで繰り返し再試行する、です。
ステップ5:チェックリストに沿って採点し記録を残す
各実行の終了後、項目ごとにプログラムで判定し、できるだけ人手による主観的採点に頼らないようにします。人手は、プログラムが異常とマークしたサンプルの再確認のみを担当します。
マルチターン・ツール呼び出しのプロトコル差異:OpenAI 形式と Anthropic 形式
同じテストを両方のインターフェース形式で実行するには、まずプロトコルの細部の違いを理解しておく必要があります。プロトコル上のわずかな違いが「curl では通るのにクライアントでは失敗する」といった問題を引き起こします。まず最小限のリクエストでプロトコルが正しいことを確認し、それからモデルの能力比較を始めるのがおすすめです。
| 段階 | OpenAI 互換形式 | Anthropic 互換形式 |
|---|---|---|
| ツール定義 | tools 配列。各項目の type は function で、パラメータは parameters に記述 | tools 配列。パラメータのスキーマは input_schema に記述 |
| モデルによる呼び出しの発行 | assistant メッセージ内の tool_calls。各要素に id を付与 | assistant のコンテンツブロック内の tool_use。各要素に id を付与 |
| パラメータの形式 | arguments は通常 JSON 文字列で、自前でパースが必要 | input はそのまま JSON オブジェクト |
| 結果の返却 | role が tool のメッセージで、tool_call_id を保持 | user メッセージ内の tool_result コンテンツブロックで、tool_use_id を保持 |
| エラーの明示 | 通常は結果内容にエラーフィールドを独自定義 | tool_result は is_error フラグに対応 |
| 並列呼び出し | 1回のレスポンスに複数の tool_calls が含まれ得る | 1回のレスポンスに複数の tool_use ブロックが含まれ得る |
つまずきやすいポイントがいくつかあります。1つ目は、OpenAI 形式では arguments が文字列であり、一部のモデルが余計な文字を出力してパースに失敗することがある点です。これはコード側でフォールバック処理をするのではなく、それ自体をスコアに含めるべき項目です。2つ目は、結果を返すときの ID が呼び出し時の ID と1対1で対応している必要がある点です。特に並列呼び出しでは順序に注意してください。3つ目は、同じ返信の中でテキスト出力とツール呼び出しの両方を行うモデルがある点です。処理ロジックはこの両方のコンテンツに対応できる必要があります。
💡 技術的なヒント:APIYI apiyi.com の統一エンドポイントを使えば、同じ APIキーで OpenAI 形式と Anthropic 形式のそれぞれに対して同じテストセットを実行できます。これにより、問題がモデル自体にあるのか、プロトコル適応層にあるのかを切り分けられます。
マルチターン・ツール呼び出しのスコアリングチェックリストと記録テンプレート
スコアリングチェックリストは、結論を再現可能にするための鍵です。各項目はプログラムで判定でき、実際の業務リスクに対応している必要があります。以下の表は推奨されるチェック項目で、業務に応じて追加・削除できます。
| チェック項目 | 判定方法 | 対応する業務リスク |
|---|---|---|
| ツール選択が正しい | 1回目の呼び出しで get_order を呼び出し、妨害ツールを呼び出していない | 余分な呼び出しは遅延とコストを増やす |
| パラメータが検証を通過 | パラメータが Schema(型、必須、フォーマット)を満たしている | 誤ったパラメータが実際のシステムに到達する |
| 呼び出し ID が正しく対応 | 返却された結果と呼び出し元の ID が一致している | マルチターンのコンテキストが錯乱する |
| リトライ動作が妥当 | リトライ可能なエラーを受信後、同じパラメータで上限を超えずにリトライしている | 早すぎる諦めや無限リトライ |
| データの捏造がない | 最終回答のフィールドがすべてツールの戻り値に見つかる | ハルシネーションがユーザーに直接影響する |
| 最終 JSON が正当 | JSON Schema 検証を通過し、余分なテキストがない | 下流のパースが失敗する |
| ターン数と Token 使用量 | 総ターン数、入力・出力 Token を記録する | コストと遅延の評価 |
各モデルを固定回数実行した後、結果表にまとめます。推奨される列は、モデル ID、インターフェース形式、実行番号、合格項目数、失敗項目の詳細、総ターン数、入力 Token、出力 Token、所要時間、テスト日時です。ヘッダーと設定ファイルは一緒にバージョン管理リポジトリにコミットします。モデルをアップグレードしたり新しいバージョンに切り替えたりする際は、同じスクリプトを再実行するだけで回帰比較ができます。
マルチターン・ツール呼び出しのコスト基準をどう記録するか
Token 使用量はターンごとに個別に記録する必要があり、最後のターンだけを見てはいけません。マルチターンのループでは、各ターンで以前のメッセージとツール結果が再び入力として送信されるため、入力 Token はターンを追うごとに累積します。リトライが増えるほどコストも高くなります。これが「リトライ動作が妥当」という項目を単独で採点する価値がある理由でもあります。
費用を計算する際は、usage の入力・出力 Token(キャッシュヒットがあればキャッシュ Token も)に、それぞれ対応する単価を掛けます。すべてのモデルの入力単価、出力単価、キャッシュ価格、課金基準は、APIYI の価格ページ docs.apiyi.com/models の実際のデータに準拠します。 本記事では具体的な数字は記載しません。価格は調整されることがあり、記事に固定で書いてしまうとすぐに古くなるからです。
1つのキーで複数モデルをテスト:候補モデルリスト
候補モデルは、異なるベンダーや異なるポジショニングをカバーすることをおすすめします。たとえば、コストパフォーマンスに優れたモデル、主力モデル、推論能力が高いモデルをそれぞれ選ぶとよいでしょう。以下の表はモデル系列とテストの観点のみをまとめたもので、結論は記載していません。結論は、あなた自身の実測データから導き出してください。
| モデル系列 | テスト推奨の観点 | 推奨インターフェース形式 | 利用可能なプラットフォーム |
|---|---|---|---|
| DeepSeek 系列 | パラメータ文字列の解析安定性、インジェクション失敗後のリトライ | OpenAI 互換 | APIYI apiyi.com、公式 API |
| Gemini 系列 | 並列呼び出しの傾向、最終 JSON にテキストが混入しないか | OpenAI 互換 | APIYI apiyi.com、公式 API |
| Qwen 系列 | 妨害ツールの誤呼び出し、複数ターンでの ID 対応 | OpenAI 互換 | APIYI apiyi.com、公式 API |
| Claude 系列 | tool_result の is_error 処理、ターン数の制御 | Anthropic 互換 | APIYI apiyi.com、公式 API |
| GPT 系列 | 厳格な Schema 準拠、トークン使用量 | OpenAI 互換 | APIYI apiyi.com、公式 API |
実際に利用可能なモデル ID とバージョンは、APIYI のモデルリストを参照してください。結果を記録する際は、必ず完全なモデル ID を書き、系列名だけを書かないようにしましょう。同じ系列でもバージョンが異なると、ツール呼び出しの挙動が大きく異なる場合があります。
💡 選択のヒント:どのモデルを選ぶかは、ツールの複雑さ、ハルシネーションへの許容度、コスト予算によって決まります。APIYI apiyi.com 上で同じキーを使って候補モデルをそれぞれ1ラウンドずつ実行し、さらに docs.apiyi.com/models の価格データと組み合わせて総合的に判断することをおすすめします。
よくある質問(FAQ)
Q1:マルチターンのツール呼び出し小テストとは何ですか?
小規模で結果が決まっているテストです。2〜3個のモックツールと1回の注入失敗を使い、モデルに「ツール呼び出し → 結果処理 → リトライ → 構造化された回答の出力」というループを最後まで実行させ、その後にプログラムで項目ごとに合格かどうかを判定します。注目するのはループを安定して最後まで回せるかどうかであり、モデルの知識レベルではありません。
Q2:なぜ1つのキーで複数モデルをテストすることを強調するのですか?
変数を制御するためです。異なるキー、SDK、プロキシアドレスは認証・タイムアウト・プロトコル適応の違いを生み、比較結果を歪めてしまいます。入口を統一すれば、変わるのは model フィールドだけになり、測定された差異をモデル自体に帰属させられます。
Q3:temperature を 0 にすれば完全に再現できますか?
完全には保証できません。temperature が 0 でも一部のモデルの出力にはわずかな揺らぎがあり、推論系モデルはこのパラメータの引き下げに対応していない場合もあります。そのためテストは複数回実行して合格率と失敗の分布を見るべきで、1回の結果だけを見てはいけません。実際に使用したパラメータ値も記録しておきましょう。
Q4:このテストはどのような場面に適していますか?
– **Agent の選定**:リリース前に、候補モデルのツールループ上の安定性を比較する。
– **モデルアップグレードの回帰テスト**:新バージョン公開後に同じスクリプトで再実行し、劣化がないことを確認する。
– **プロトコル移行の検証**:OpenAI 形式から Anthropic 形式に切り替える際に、アダプテーション層に問題がないことを確認する。
Q5:これらのモデルをすぐに呼び出すにはどうすればよいですか?
1. APIYI apiyi.com にアクセスしてアカウントを登録し、キーを取得します。
2. docs.apiyi.com を読み、OpenAI 互換アドレスと Anthropic 互換アドレスを確認します。
3. 本文のステップ1のパラメータ表に従って設定し、まず最小リクエストで各モデルがツール呼び出しを返せることを確認します。
APIYI は本文で紹介した複数のモデルの統一接続に対応しており、モデルを切り替える際は model フィールドを変更するだけです。
Q6:テストコストはどう見積もりますか?
コストはおおよそ「モデル数 × 実行回数 × 1回あたりの累計 Token × 単価」です。マルチターンのループでは入力 Token がターンごとに累積し、リトライでさらに使用量が増えます。単価とキャッシュ課金のルールは APIYI の価格ページ docs.apiyi.com/models の実際のデータを基準にしてください。まず各モデルを1回ずつ実行して使用量を見積もり、その後で本番実行の回数を決めることをおすすめします。
Q7:このテストにはどのような限界がありますか?
小規模なテストは典型的な失敗パターンしかカバーできず、すべての複雑な業務を代表するものではありません。モックツールが返すデータは非常にクリーンですが、実際のシステムはフォーマットが乱れていたり、極端に長いデータを返すことがあります。テストに合格した後は、業務で実際に発生した異常サンプルを追加し、徐々にケースを拡充していくことをおすすめします。
マルチターン・ツール呼び出し小テストの核心ポイント Key Takeaways
- 変数の固定を優先:1つのキー、1つの設定セットを使い、model フィールドだけを変更します。
- ツールは読み取り専用で決定的に:Mock の戻り値を固定値にして、毎回同じデータが表示されることを保証します。
- 失敗を必ず注入する:リトライ可能なエラーを1回入れることで、モデルのループ処理能力を最もよく見分けられます。
- 採点をプログラム化:各チェック項目を自動判定でき、人間は異常の再確認だけを担当します。
- 完全な記録を残す:生のレスポンス、各ターンの usage、完全なモデル ID を保存し、リグレッションを容易にします。
- 価格は公式ページに準拠:コスト計算は APIYI の価格ページ docs.apiyi.com/models に準拠します。
- 統一エントリーポイントが便利:APIYI が OpenAI と Anthropic の形式に対応しているため、1つのスクリプトで両方のプロトコルをカバーできます。
まとめ
1つのキーで複数モデルをテストするマルチターン・ツール呼び出しの小テストは、3つの点が核心です:
- 再現可能:設定を固定し、Mock データを固定し、プロンプトのバージョンを固定して、複数回実行します。
- 判定可能:スキーマ検証と採点チェックリストで主観的な印象を置き換えます。
- リグレッション可能:完全な記録を残し、モデル更新後に同じスクリプトで素早く再テストできます。
この方法は「どのモデルが最良か」を教えてくれるわけではありませんが、あなたのツールチェーンの中で、どのモデルがより安定し、Token を節約でき、失敗時の挙動もより制御しやすいかを教えてくれます。まずは本記事の注文照会シナリオでフローを一通り実行し、その後で自分の業務のツールに置き換えることをおすすめします。
複数モデルの横断検証は、APIYI apiyi.com を通じて同じキーで完了することをおすすめします。接続方法は docs.apiyi.com を、価格と課金基準は docs.apiyi.com/models をご参照ください。
📚 参考資料
- OpenAI 関数呼び出しドキュメント:tools、tool_calls、tool ロールメッセージのプロトコル説明
- リンク:
platform.openai.com/docs/guides/function-calling -
説明:OpenAI 互換形式におけるパラメータ文字列と tool_call_id の扱いを理解するための資料です
-
Anthropic ツール使用ドキュメント:tool_use と tool_result コンテンツブロックの説明
- リンク:
docs.anthropic.com/en/docs/build-with-claude/tool-use -
説明:input_schema、tool_use_id、is_error の使い方を理解できます
-
APIYI ドキュメントセンター:統一インターフェース接続ガイド
- リンク:
docs.apiyi.com -
説明:OpenAI と Anthropic の互換エンドポイントおよび呼び出し例を確認できます
-
APIYI モデル・料金ページ:モデル一覧と課金基準
- リンク:
docs.apiyi.com/models - 説明:入力・出力・キャッシュのすべての単価は、このページの実際のデータを基準とします
著者:APIYI 技術チーム
技術交流:APIYI apiyi.com のウェブサイトトップページからお気軽にお問い合わせください。その他の接続資料は docs.apiyi.com のドキュメントセンターでご確認いただけます