작성자 노트: 하나의 키, 하나의 고정 스크립트, 한 번의 주입 실패로 여러 모델의 멀티턴 도구 호출 능력을 가로로 비교해 재현 가능하고 검토 가능한 결론을 얻습니다.
모델을 골라 에이전트를 만들 때 많은 팀이 같은 문제를 겪어요. 단일 턴 질의응답에서는 각 모델의 성능이 비슷하지만, “도구 호출 → 결과 받기 → 다시 호출 → 오류 처리 → 구조화된 답변 제공”이라는 멀티턴 루프에 들어가면 차이가 드러나죠. 이 글에서는 하나의 키로 여러 모델의 멀티턴 도구 호출을 테스트하는 작은 실험을 소개하고, 아주 낮은 비용으로 이런 차이를 기록하고 다시 검토할 수 있는 데이터로 바꾸는 방법을 알려드려요.
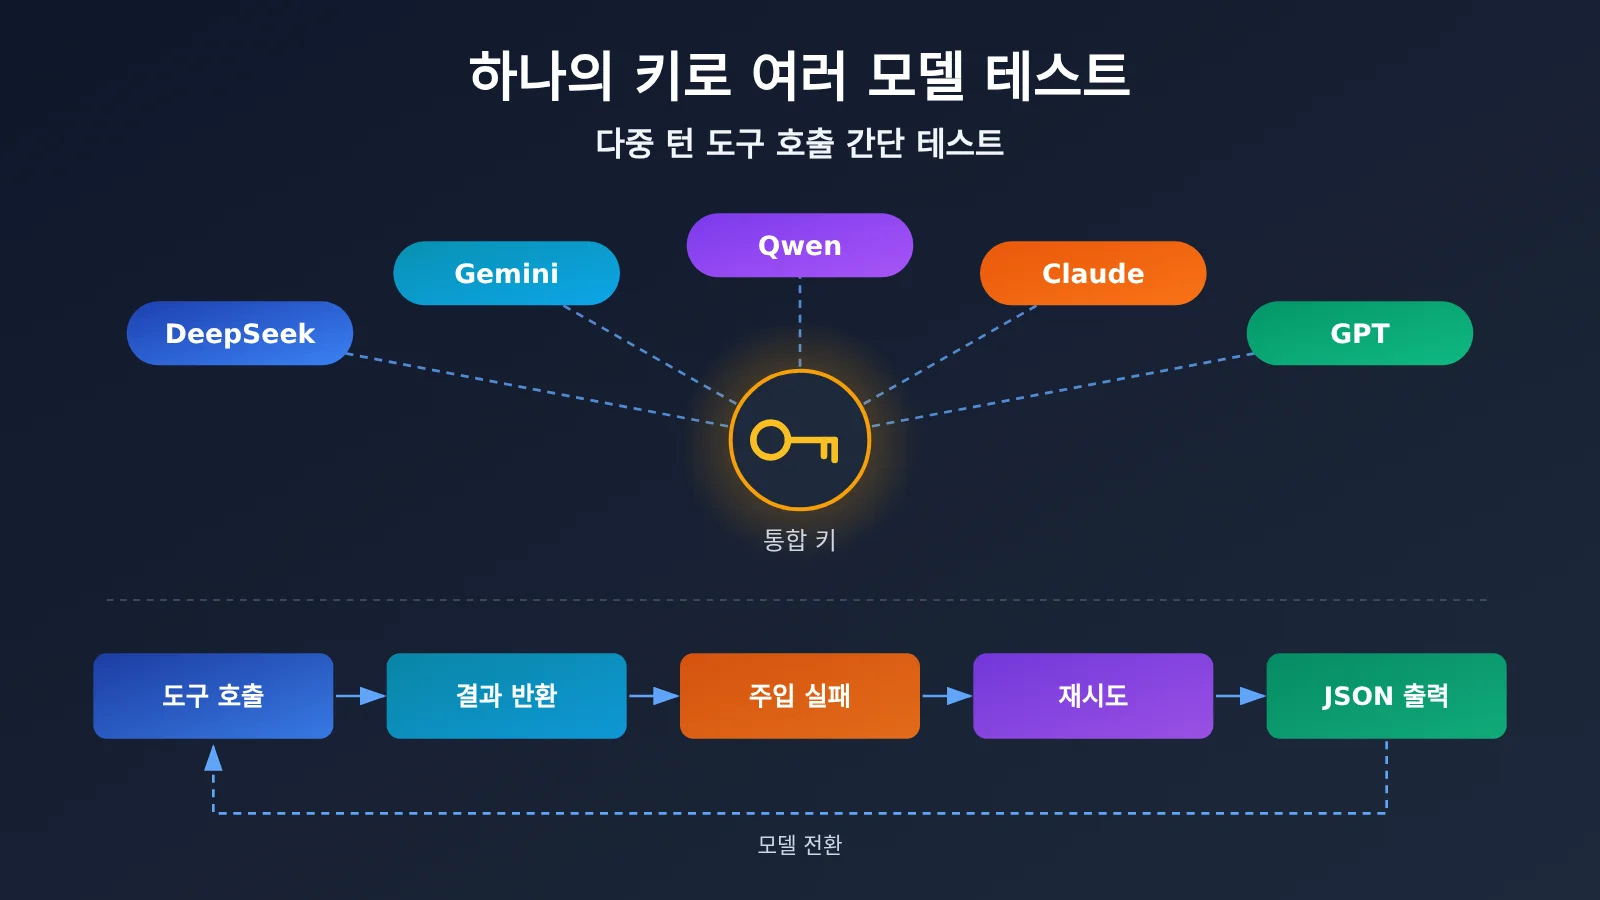
이 글은 모델 순위표가 아닙니다. 실측하지 않은 점수는 제공하지 않고, 어떻게 테스트를 설계해 자신의 업무 시나리오에서 결론을 낼 수 있는지만 다뤄요. 테스트의 핵심은 변수 통제예요. 동일한 키, 동일한 도구 정의, 동일한 Mock 데이터를 쓰고 모델 이름만 바꿉니다. APIYI apiyi.com 같은 API 중계 서비스를 이용하면 하나의 키로 DeepSeek, Gemini, Qwen, Claude, GPT 등 여러 모델을 호출할 수 있어 가로 비교할 때 전환 비용이 크게 줄어요.
핵심 가치: 이 글을 읽고 나면 5단계 재현 가능한 멀티턴 도구 호출 테스트를 만들 수 있어요. 도구 선택, 파라미터 검증, 호출 ID 반환, 실패 재시도, 최종 JSON 검증이라는 다섯 가지 핵심 단계를 다룹니다.
다중 턴 도구 호출 소규모 테스트 핵심 포인트
다중 턴 도구 호출 테스트를 설계하기 전에 먼저 “재현 가능”이 무엇을 뜻하는지 분명히 해야 해요. 같은 입력을 다른 시간에, 다른 사람이 실행해도 비교 가능한 같은 유형의 결과가 나와야 하죠. 한 번의 그럴듯한 출력만으로 결론을 내릴 수는 없어요. 아래 표가 전체 테스트의 골격이에요.
| 요점 | 설명 | 가치 |
|---|---|---|
| 하나의 키, 여러 모델 | 모든 모델이 같은 인터페이스 진입점을 사용하고 model 필드만 바꿔요 | 네트워크, 인증, SDK 버전에서 오는 간섭을 배제해요 |
| 고정 Mock 도구 | 도구 반환값을 하드코딩하고 실제 데이터베이스나 외부 서비스에 연결하지 않아요 | 실행할 때마다 보이는 도구 결과가 완전히 동일해요 |
| 실패 1회 주입 | 특정 도구의 첫 호출은 항상 재시도 가능한 오류를 반환하도록 고정해요 | 모델이 올바르게 재시도하는지, 데이터를 꾸며내지는 않는지 관찰해요 |
| 구조화된 최종 출력 | 최종 답변은 반드시 Schema를 충족하는 JSON이어야 해요 | 프로그램으로 통과 또는 실패를 자동 판정할 수 있어요 |
| 전체 기록 보존 | 요청 파라미터, 원본 응답, usage와 소요 시간을 저장해요 | 결론을 다시 검토할 수 있고, 모델 버전을 바꾼 뒤 회귀 테스트할 수 있어요 |
다중 턴 도구 호출 테스트는 왜 “작아야” 할까요
테스트는 작아야 해요. 큰 테스트는 재현하기 어렵기 때문이죠. 실제 비즈니스의 도구 체인에는 도구가 십여 개에 달할 수 있고 외부 시스템에 의존하기도 해서, 어느 한 곳만 흔들려도 모델 문제로 오인하기 쉬워요. 좋은 소규모 테스트는 읽기 전용 도구 2~3개와 인위적으로 주입한 실패 한 번이면, 다중 턴 루프에서 가장 잘 틀리는 부분을 커버할 수 있어요.
테스트는 “완전”해야도 해요. 전체 루프를 끝까지 실행해야 하고, 모델이 첫 번째 턴에 도구 호출을 시작하는지만 봐서는 안 돼요. 많은 모델이 첫 턴은 잘하지만 문제는 두 번째, 세 번째 턴에서 드러나요. 올바른 호출 ID를 포함하지 않거나, 오류를 받은 뒤 바로 포기하거나, 데이터가 없는데도 운송장 번호를 스스로 지어내는 식이죠. 이런 문제는 루프를 마지막 턴까지 돌려야만 드러나요.
하나의 키로 여러 모델을 테스트하는 설계 원칙
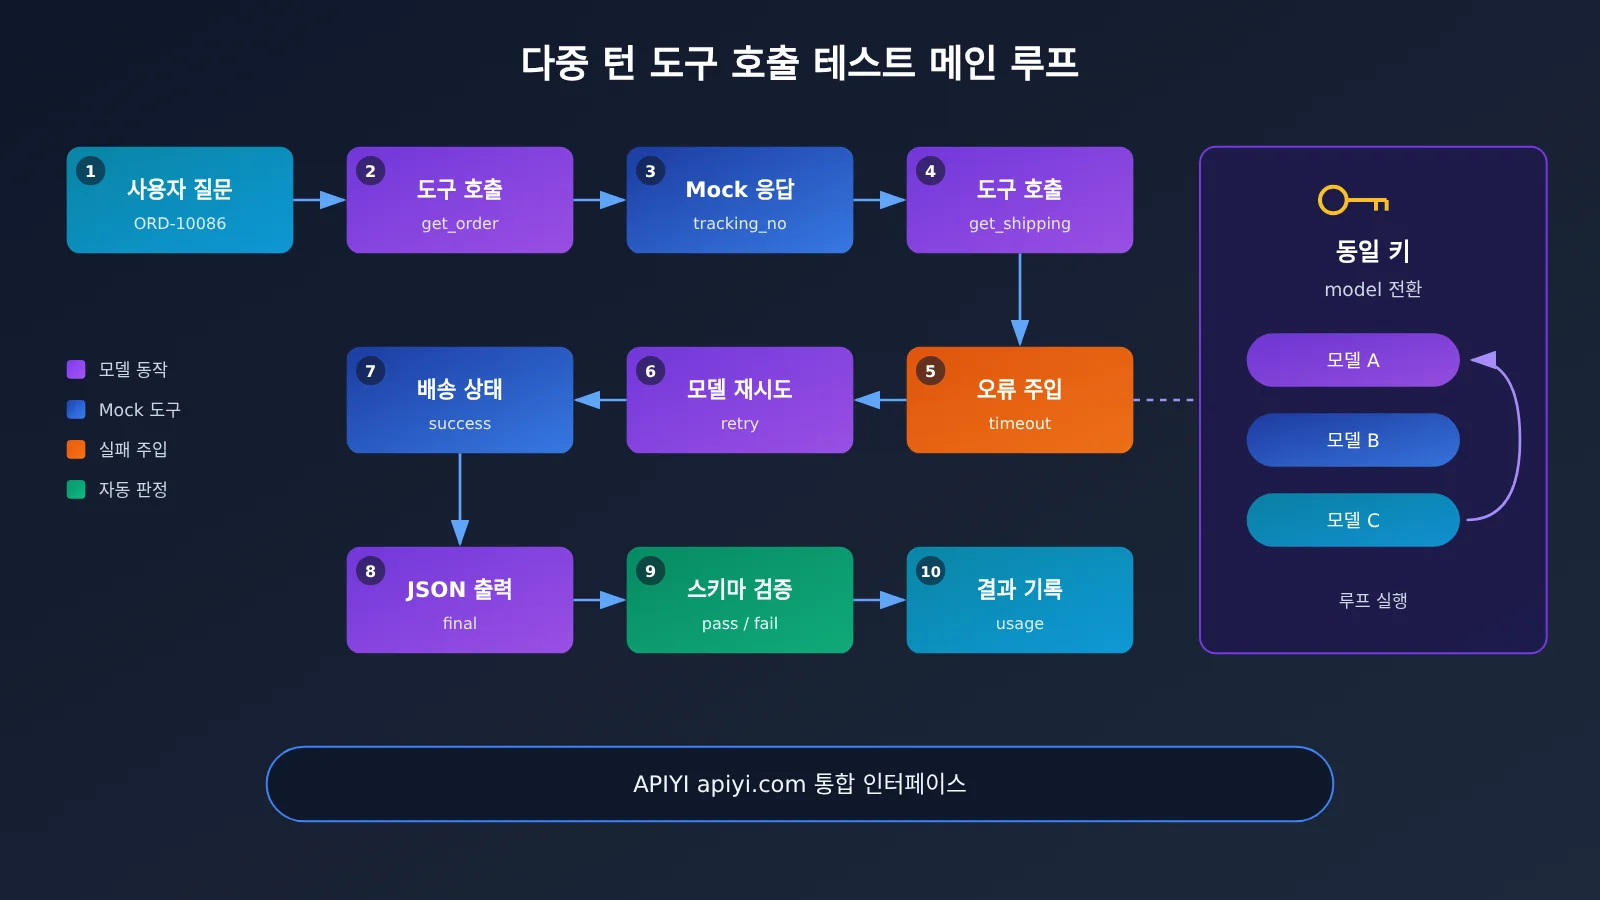
변수 통제는 비교 테스트의 전제 조건이에요. A 모델은 공식 SDK를 쓰고, B 모델은 서드파티 SDK를 쓰며, C 모델은 또 다른 프록시 주소를 쓴다면, 마지막 차이가 모델에서 온 건지 연결 경로에서 온 건지 구분할 수 없어요. 진입점을 통일하면 인증 방식, 재시도 전략, 타임아웃 설정, 로그 형식이 모두 일관되게 유지되고, 유일한 변수는 모델 자체가 돼요.
멀티턴 도구 호출 미니 테스트로 빠르게 시작하기
이 섹션에서는 코드를 붙이지 않고, 파라미터와 도구 정의, 실행 단계만 나열할게요. Python, Node.js, Shell 스크립트 등 익숙한 언어로 구현하면 돼요. 핵심은 각 설정 항목을 고정된 설정 파일에 기록하고, 테스트 결과와 함께 저장하는 거예요.
1단계: 통합 인터페이스와 실행 파라미터
먼저 인터페이스 진입점과 샘플링 파라미터를 정하세요. APIYI는 OpenAI와 Anthropic 두 인터페이스 형식을 동시에 지원해서, 같은 키로 Chat Completions 스타일 호출도, Messages 스타일 호출도 할 수 있어요. 아래 표는 고정하기를 권장하는 설정 항목이에요.
| 설정 항목 | 권장 값 | 설명 |
|---|---|---|
| base_url(OpenAI 형식) | https://api.apiyi.com/v1 |
APIYI 통합 진입점으로 호출하며, 구체 주소는 docs.apiyi.com 문서를 기준으로 해요 |
| base_url(Anthropic 형식) | APIYI 문서의 Anthropic 호환 주소 참조 | tool_use / tool_result 프로토콜 테스트용 |
| api_key | 동일한 키 | 모든 모델이 공유해서 인증 차이를 배제해요 |
| temperature | 0 또는 최대한 낮게 | 무작위성을 줄여요. 일부 추론 모델이 지원하지 않으면 실제 값을 기록하세요 |
| max_tokens | 고정값 | 출력이 잘려서 오판하는 걸 피해요 |
| tool_choice | auto | 모델이 스스로 결정하는지 관찰하고, 호출을 강제하지 않아요 |
| 최대 루프 횟수 | 고정 상한, 예: 6회 | 모델이 무한 재시도에 빠지는 걸 방지해요 |
| 모델당 실행 횟수 | 고정 횟수, 예: 5회 | 여러 번의 결과로 안정성을 판단하고, 단일 실행 성능은 보지 않아요 |
🚀 빠른 시작 제안: 먼저 APIYI apiyi.com에서 가입하고 키를 발급받은 뒤, 같은 키로 후보 모델을 차례로 호출해 보세요. 각 모델이 정상적인 도구 호출 응답을 반환하는지 확인한 다음 본격적인 테스트를 시작하면 돼요. 연동 설명은 docs.apiyi.com에서 확인할 수 있어요.
2단계: 읽기 전용 도구 2~3개 정의하기
도구 설계에는 두 가지 요구 사항이 있어요. 바로 읽기 전용과 결정성이에요. 읽기 전용은 테스트 도중 실수로 쓰기 작업이 실행되는 걸 막기 위해서고, 결정성은 호출할 때마다 같은 값을 반환하도록 보장하기 위해서예요. 가상의 주문 조회 시나리오를 하나 두고, 여기에 두 개의 도구를 넣는 걸 추천해요.
- get_order: 매개변수는 order_id(문자열, 형식은 “ORD-“에 숫자가 붙는 형태로 고정)예요. 주문 상태, 상품명, 운송장 번호 tracking_no를 고정으로 반환해요.
- get_shipping: 매개변수는 tracking_no(문자열)예요. 첫 번째 호출은 고정으로 오류를 반환하는데, 오류 내용에는 error가 timeout, retryable이 true라는 정보가 담겨요. 두 번째 호출부터는 고정된 배송 상태와 예상 도착일을 반환해요.
- 선택 사항인 방해 도구 get_coupon: 질문과는 무관하고, 모델이 쓸데없는 호출을 하는지 관찰하는 용도예요.
매개변수 Schema는 엄격하게 작성해야 해요. 필드 타입, 필수 항목, 정규식 형식을 모두 명확히 밝혀야 하죠. 모델이 생성한 매개변수는 먼저 Schema 검증을 거친 다음에 Mock 함수로 넘겨요. 검증에 실패하면 “매개변수 오류”로 한 번 기록하고, 몰래 고쳐서는 안 돼요.
3단계: 고정된 프롬프트와 사용자 질문 작성하기
System 프롬프트에는 규칙만 쓰고, 답은 쓰지 않아요. 모델이 도구가 반환한 데이터만 근거로 답하도록 요구할 수 있어요. 도구가 오류를 내고 재시도가 가능할 때는 최대 2회까지 재시도하고, 최종적으로는 JSON 객체 하나만 출력하도록 하죠. 필드에는 order_status, shipping_status, eta, data_source가 들어가요. 사용자 질문은 한 문장으로 고정해요. 예를 들면 “주문 ORD-10086이 지금 어디쯤 왔는지 확인해 주세요” 같은 식이에요.
프롬프트는 한 번 정하면 다시 수정하지 않아요. 만약 테스트 중에 특정 모델이 프롬프트의 모호함 때문에 실패했다면, 올바른 방법은 새 버전 번호를 열고 모든 모델을 새 버전으로 다시 테스트하는 거예요. 그 모델 하나만을 위해 프롬프트를 고치는 게 아니에요.
4단계: 실행 루프와 실패 주입
실행 로직은 다음 순서로 진행해요.
- system 메시지와 user 메시지, 그리고 도구 정의를 전송해요.
- 응답에 도구 호출이 있으면 파라미터를 순서대로 검증하고, 해당 Mock 함수를 실행한 뒤 결과를 프로토콜 요구 사항에 맞춰 반환해요.
- get_shipping의 첫 번째 호출에는 항상 재시도 가능한 오류를 반환해요.
- 모델이 도구 호출이 없는 최종 응답을 내놓거나 최대 라운드 수에 도달할 때까지 2단계를 반복해요.
- JSON Schema로 최종 응답을 검증하고, 모든 메시지와 원본 응답, 각 라운드의 usage를 저장해요.
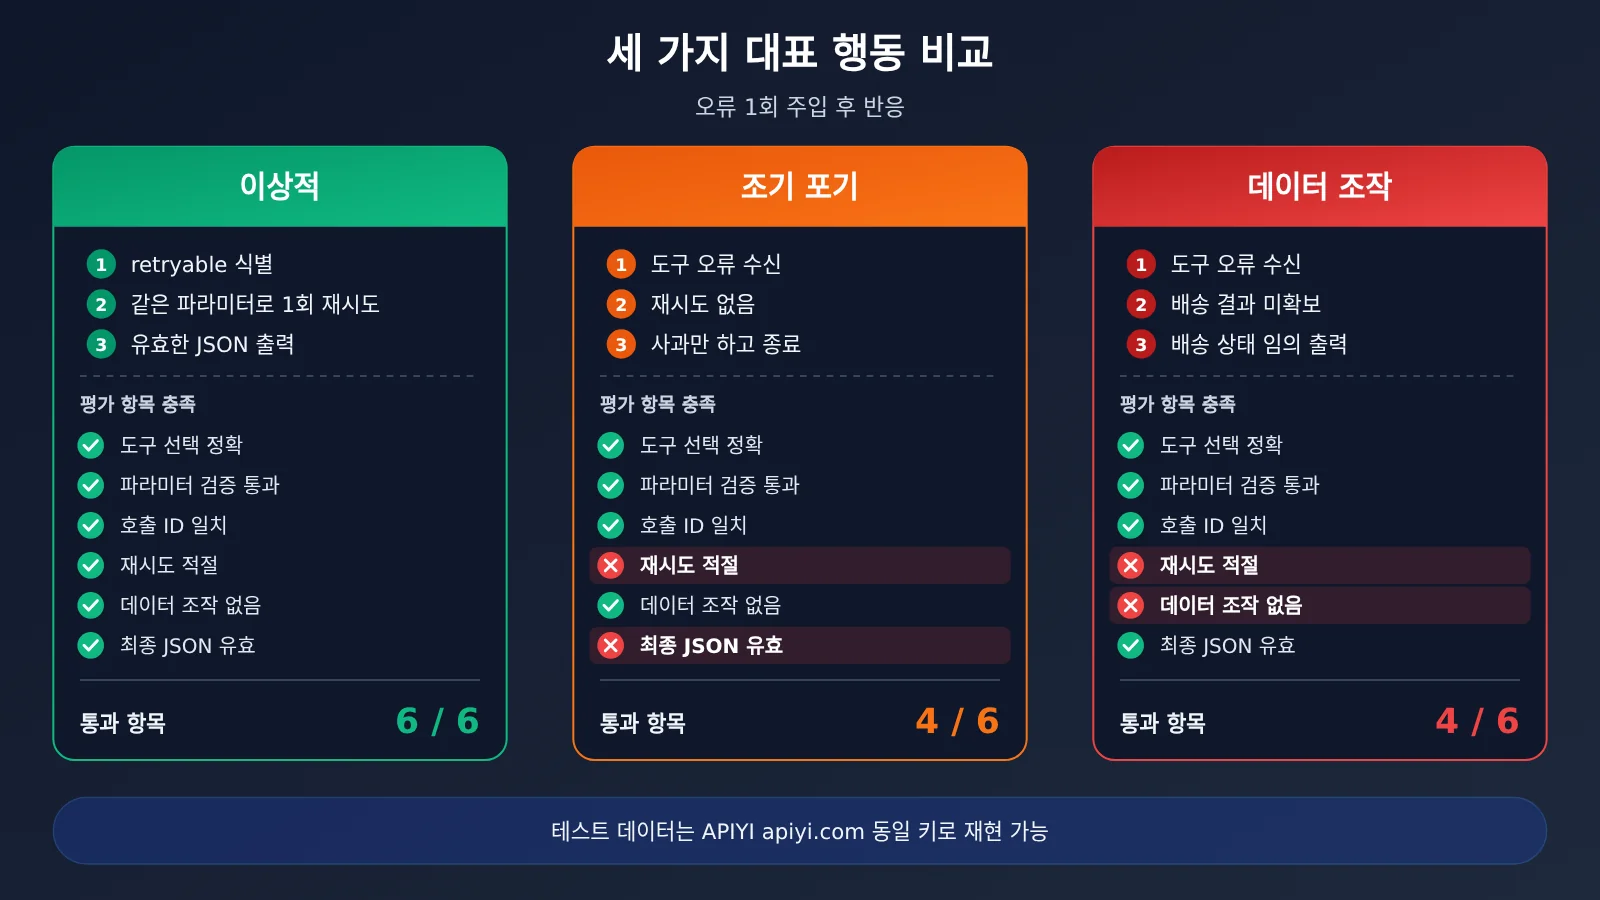
실패 주입은 이 테스트에서 가장 변별력이 큰 부분이에요. 이상적인 동작은 모델이 retryable이 true임을 인식하고 동일한 파라미터로 get_shipping을 한 번 더 호출하는 거예요. 흔한 문제 동작은 세 가지예요. 사용자에게 바로 사과하고 끝내기, 배송 상태를 지어내기, 파라미터를 바꿔 가며 반복 재시도하다 라운드 수 상한을 넘기기예요.
5단계: 체크리스트로 점수 매기고 기록 남기기
각 실행이 끝난 뒤에는 프로그램으로 항목별 판정을 내리고, 가능한 한 사람의 주관적인 점수 매기기에 의존하지 않아요. 사람은 프로그램이 이상하다고 표시한 샘플을 재검토하는 역할만 맡아요.
다중 턴 도구 호출 프로토콜 차이: OpenAI와 Anthropic 형식
같은 테스트를 두 인터페이스 형식에서 모두 실행하려면 먼저 프로토콜 세부 사항의 차이를 이해해야 해요. 프로토콜의 아주 작은 차이도 “curl은 통하는데 클라이언트에서는 안 되는” 같은 문제를 일으킬 수 있어요. 가장 작은 요청으로 프로토콜이 올바른지 먼저 확인한 뒤 모델 성능 비교를 시작하는 걸 권장해요.
| 단계 | OpenAI 호환 형식 | Anthropic 호환 형식 |
|---|---|---|
| 도구 정의 | tools 배열, 각 항목의 type은 function, 매개변수는 parameters에 작성 | tools 배열, 매개변수 스키마는 input_schema에 작성 |
| 모델 호출 시작 | assistant 메시지의 tool_calls, 각 항목에 id 포함 | assistant 콘텐츠 블록의 tool_use, 각 항목에 id 포함 |
| 매개변수 형태 | arguments는 보통 JSON 문자열이라 직접 파싱해야 함 | input은 바로 JSON 객체 |
| 결과 반환 | role이 tool인 메시지, tool_call_id 포함 | user 메시지의 tool_result 콘텐츠 블록, tool_use_id 포함 |
| 오류 표시 | 일반적으로 결과 콘텐츠 안에 사용자 정의 오류 필드를 둠 | tool_result에서 is_error 표시를 지원 |
| 병렬 호출 | 한 응답에 여러 tool_calls가 포함될 수 있음 | 한 응답에 여러 tool_use 블록이 포함될 수 있음 |
가장 자주 밟는 함정이 몇 가지 있어요. 첫째, OpenAI 형식에서 arguments는 문자열인데, 일부 모델이 가끔 불필요한 문자를 출력해 파싱에 실패할 수 있어요. 이 항목 자체가 평가 점수에 포함되어야 하며, 코드에서 예외를 허용하는 방식으로 처리해서는 안 됩니다. 둘째, 결과를 반환할 때 ID는 호출을 시작할 때의 ID와 일대일로 대응해야 하며, 특히 병렬 호출에서는 순서에 주의해야 해요. 셋째, 일부 모델은 같은 응답에서 텍스트를 출력하면서 동시에 도구 호출을 시작하기도 하므로, 처리 로직이 두 콘텐츠를 모두 지원해야 해요.
💡 기술 팁: APIYI apiyi.com의 통합 진입점을 통해 동일한 키로 OpenAI 형식과 Anthropic 형식을 각각 사용해 같은 테스트 세트를 실행할 수 있어요. 이렇게 하면 문제가 모델 자체에 있는지, 아니면 프로토콜 어댑터 계층에 있는지 구분할 수 있습니다.
다중 턴 도구 호출 평가 체크리스트와 기록 템플릿
평가 체크리스트는 결론을 재현 가능하게 만드는 핵심이에요. 각 항목은 프로그램으로 판정할 수 있어야 하고, 실제 비즈니스 리스크와 직접 연결되어야 해요. 아래 표는 권장 검사 항목이며, 비즈니스에 맞게 추가하거나 삭제할 수 있어요.
| 검사 항목 | 판정 방식 | 대응하는 비즈니스 리스크 |
|---|---|---|
| 도구 선택 정확성 | 첫 번째 턴에서 get_order를 호출하고, 간섭 도구는 호출하지 않음 | 불필요한 호출이 지연과 비용을 증가시킴 |
| 파라미터 검증 통과 | 파라미터가 스키마를 충족함(타입, 필수 여부, 형식 포함) | 잘못된 파라미터가 실제 시스템에 전달됨 |
| 호출 ID 정확 대응 | 반환된 결과가 호출을 시작한 ID와 일치 | 다중 턴 컨텍스트가 꼬임 |
| 재시도 동작 합리성 | 재시도 가능한 오류를 받은 뒤 동일한 파라미터로 재시도하되 상한을 넘지 않음 | 너무 이르게 포기하거나 무한 재시도 |
| 데이터 날조 없음 | 최종 답변의 필드를 모두 도구 반환값에서 찾을 수 있음 | 환각이 사용자에게 직접 영향 |
| 최종 JSON 유효 | JSON 스키마 검증을 통과하고 불필요한 텍스트가 없음 | 다운스트림 파싱 실패 |
| 턴 수와 Token 사용량 | 총 턴 수, 입력 및 출력 Token 기록 | 비용과 지연 평가 |
각 모델을 정해진 횟수만큼 실행한 뒤 하나의 결과 표로 집계하세요. 권장 열은 모델 ID, 인터페이스 형식, 실행 번호, 통과 항목 수, 실패 항목 상세, 총 턴 수, 입력 Token, 출력 Token, 소요 시간, 테스트 날짜예요. 표 헤더와 설정 파일은 함께 버전 관리 저장소에 넣어 두세요. 모델을 업그레이드하거나 새 버전으로 바꿀 때 같은 스크립트 세트로 다시 실행하면 회귀 비교를 할 수 있어요.
다중 턴 도구 호출의 비용 산정 기준은 어떻게 기록할까요
Token 사용량은 마지막 턴만 보지 말고 턴별로 각각 기록해야 해요. 다중 턴 루프에서는 매 턴 이전 메시지와 도구 결과를 다시 입력으로 보내기 때문에 입력 Token이 턴마다 누적돼요. 재시도가 많을수록 비용도 높아져요. 그래서 “재시도 동작 합리성” 항목을 따로 점수화할 가치가 있어요.
비용을 계산할 때는 usage의 입력·출력 Token(캐시 적중이 있으면 캐시 Token도 포함)에 각각의 단가를 곱하세요. 모든 모델의 입력 단가, 출력 단가, 캐시 가격, 과금 기준은 APIYI 가격 페이지 docs.apiyi.com/models의 실제 데이터를 기준으로 삼아요. 이 글에는 구체적인 숫자를 적지 않았어요. 가격은 조정될 수 있어서 글에 고정해 두면 금방 구식이 되기 쉽거든요.
하나의 키로 여러 모델 테스트하기: 후보 모델 목록
후보 모델은 서로 다른 제공사와 포지션을 아우르는 것이 좋아요. 예를 들어 가성비 모델 하나, 주력 모델 하나, 추론 능력이 강한 모델 하나를 포함하는 식이죠. 아래 표는 모델 시리즈와 테스트 시 주안점만 나열하며, 결론은 제시하지 않아요. 결론은 여러분의 실제 테스트 데이터에서 나와야 합니다.
| 모델 시리즈 | 권장 테스트 주안점 | 권장 인터페이스 형식 | 사용 가능 플랫폼 |
|---|---|---|---|
| DeepSeek 시리즈 | 파라미터 문자열 파싱 안정성, 주입 실패 후 재시도 | OpenAI 호환 | APIYI apiyi.com, 공식 API |
| Gemini 시리즈 | 병렬 호출 경향, 최종 JSON에 텍스트가 섞이는지 여부 | OpenAI 호환 | APIYI apiyi.com, 공식 API |
| Qwen 시리즈 | 간섭 도구의 잘못된 호출, 멀티턴 ID 매핑 | OpenAI 호환 | APIYI apiyi.com, 공식 API |
| Claude 시리즈 | tool_result의 is_error 처리, 턴 수 제어 | Anthropic 호환 | APIYI apiyi.com, 공식 API |
| GPT 시리즈 | 엄격한 Schema 준수, Token 사용량 | OpenAI 호환 | APIYI apiyi.com, 공식 API |
실제 사용 가능한 모델 ID와 버전은 APIYI 모델 목록을 기준으로 확인하세요. 결과를 기록할 때는 반드시 전체 모델 ID를 적고, 시리즈명만 쓰지 마세요. 같은 시리즈라도 버전에 따라 도구 호출 성능이 크게 달라질 수 있어요.
💡 선택 가이드: 어떤 모델을 고를지는 도구의 복잡도, 환각(hallucination) 허용도, 비용 예산에 따라 달라져요. APIYI apiyi.com에서 같은 키로 후보 모델을 각각 한 번씩 실행해 보고, docs.apiyi.com/models의 가격 데이터를 함께 고려해 종합적으로 판단하는 걸 권장해요.
자주 묻는 질문 FAQ
Q1: 다중 턴 도구 호출 소규모 테스트란 무엇인가요?
규모가 아주 작고 결과가 결정적인 테스트예요. 2~3개의 Mock 도구와 한 번의 주입된 실패를 사용해 모델이 “도구 호출, 결과 처리, 재시도, 구조화된 답변 출력”의 루프를 완전히 한 번 돌도록 하고, 프로그램으로 각 항목의 통과 여부를 판정해요. 이 테스트가 주목하는 것은 루프가 안정적으로 끝까지 돌아가는지이지, 모델의 지식 수준이 아니에요.
Q2: 왜 하나의 키로 여러 모델을 테스트하는 것을 강조하나요?
변수를 통제하기 위해서예요. 서로 다른 키, SDK, 프록시 주소는 인증, 타임아웃, 프로토콜 적응에서 차이를 만들어 비교 결과를 왜곡시켜요. 진입점을 통일하면 유일하게 변하는 것은 model 필드뿐이라, 측정된 차이를 모델 자체로 귀인할 수 있어요.
Q3: temperature를 0으로 설정하면 완전한 재현이 보장되나요?
완전히 보장되지는 않아요. temperature가 0이어도 일부 모델의 출력에는 여전히 미세한 변동이 있고, 추론형 모델은 해당 파라미터를 낮추는 것을 지원하지 않을 수도 있어요. 그래서 테스트는 여러 번 고정 실행하면서 통과율과 실패 분포를 봐야 하고, 특정 한 번의 결과만 봐서는 안 돼요. 실제 사용한 파라미터 값도 기록해 두어야 해요.
Q4: 이 테스트는 어떤 시나리오에 적합한가요?
– **Agent 선정**: 출시 전에 후보 모델들의 도구 루프 안정성을 비교해요.
– **모델 업그레이드 회귀 테스트**: 새 버전이 출시된 후 같은 스크립트로 다시 실행해 성능 저하가 없는지 확인해요.
– **프로토콜 마이그레이션 검증**: OpenAI 형식에서 Anthropic 형식으로 전환할 때 어댑터 계층에 문제가 없는지 확인해요.
Q5: 이 모델들을 어떻게 빠르게 호출하기 시작할 수 있나요?
1. APIYI apiyi.com에 방문해 계정을 등록하고 키를 받으세요.
2. docs.apiyi.com을 읽고 OpenAI 호환 주소와 Anthropic 호환 주소를 확인하세요.
3. 본문 1단계의 파라미터 표에 따라 구성하고, 먼저 최소 요청으로 각 모델이 도구 호출을 반환하는지 확인하세요.
APIYI는 본문에서 언급한 여러 모델을 통합 접속으로 지원하며, 모델 전환은 model 필드만 수정하면 돼요.
Q6: 테스트 비용은 어떻게 추정하나요?
비용은 대략 “모델 수 × 실행 횟수 × 실행 1회당 누적 Token × 단가”와 같아요. 다중 턴 루프의 입력 Token은 턴마다 누적되고, 재시도는 사용량을 더 늘려요. 단가와 캐시 과금 규칙은 APIYI 가격 페이지 docs.apiyi.com/models의 실제 데이터를 기준으로 해요. 먼저 각 모델을 1회씩 실행해 사용량을 추정한 뒤, 정식 실행 횟수를 정하는 것을 권장해요.
Q7: 이 테스트에는 어떤 한계가 있나요?
소규모 테스트는 전형적인 실패 모드만 커버할 수 있고, 모든 복잡한 비즈니스를 대표할 수는 없어요. Mock 도구가 반환하는 데이터는 매우 깔끔하지만, 실제 시스템은 형식이 엉망이거나 매우 긴 데이터를 반환할 수 있어요. 테스트를 통과한 후에는 비즈니스에서 실제로 나타났던 이상 샘플을 추가해 케이스를 점진적으로 확장하는 것을 권장해요.
다중 턴 도구 호출 소규모 테스트 핵심 요점(Key Takeaways)
- 변수 통제 우선: 하나의 키와 하나의 설정을 사용하고, model 필드만 바꿔요.
- 도구는 읽기 전용이며 결정적: Mock 반환값을 하드코딩해서 매번 실행할 때 동일한 데이터를 보도록 보장해요.
- 실패를 반드시 주입: 재시도 가능한 오류를 한 번 넣는 것이 모델의 루프 처리 능력을 가장 잘 구분해 줘요.
- 채점은 프로그램으로: 각 검사 항목을 자동으로 판정하고, 사람은 이상 징후만 재확인해요.
- 완전한 기록 유지: 원본 응답, 매 턴의 usage, 전체 모델 ID를 저장해 회귀에 대비해요.
- 가격은 공식 페이지 기준: 비용 계산은 APIYI 가격 페이지 docs.apiyi.com/models를 기준으로 해요.
- 통합 진입점이 더 편리: APIYI가 OpenAI와 Anthropic 형식을 모두 지원하므로, 하나의 스크립트로 두 프로토콜을 모두 커버할 수 있어요.
정리
하나의 키로 여러 모델을 테스트하는 다중 턴 도구 호출 소규모 테스트의 핵심은 세 가지예요:
- 재현 가능: 설정 고정, Mock 데이터 고정, 프롬프트 버전 고정, 그리고 여러 번 실행.
- 판정 가능: 주관적 인상 대신 스키마 검증과 채점 체크리스트를 사용해요.
- 회귀 가능: 완전한 기록을 남겨, 모델이 업그레이드된 뒤에도 같은 스크립트로 빠르게 재테스트할 수 있어요.
이 방법은 “어떤 모델이 최고인지”를 알려주지는 않지만, 여러분의 도구 체인에서 어떤 모델이 더 안정적이고 Token을 더 아끼며, 실패했을 때의 양상도 더 통제 가능한지를 알려줘요. 먼저 이 글의 주문 조회 시나리오로 흐름을 검증한 뒤, 자신의 비즈니스에 맞는 도구로 교체하는 것을 권해요.
APIYI apiyi.com을 통해 동일한 키로 여러 모델의 횡적 검증을 완료하는 것을 추천해요. 연동 방법은 docs.apiyi.com을 참고하고, 가격과 과금 기준은 docs.apiyi.com/models를 기준으로 해요.
📚 참고 자료
- OpenAI 함수 호출 문서: tools, tool_calls 및 tool 역할 메시지의 프로토콜 설명
- 링크:
platform.openai.com/docs/guides/function-calling -
설명: OpenAI 호환 형식에서 파라미터 문자열과 tool_call_id를 처리하는 방법을 이해하기
-
Anthropic 도구 사용 문서: tool_use 및 tool_result 콘텐츠 블록 설명
- 링크:
docs.anthropic.com/en/docs/build-with-claude/tool-use -
설명: input_schema, tool_use_id 및 is_error 사용법 알아보기
-
APIYI 문서 센터: 통합 인터페이스 연동 설명
- 링크:
docs.apiyi.com -
설명: OpenAI 및 Anthropic 호환 주소와 호출 예시 확인하기
-
APIYI 모델 및 가격 페이지: 모델 목록 및 과금 기준
- 링크:
docs.apiyi.com/models - 설명: 모든 입력, 출력 및 캐시 단가는 이 페이지의 실제 데이터를 기준으로 함
작성자: APIYI 기술팀
기술 교류: APIYI apiyi.com 사이트 홈페이지에서 문의해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있습니다