Note de l’auteur : avec une seule clé API, un jeu de scripts figé et un échec injecté, comparer les capacités d’appels d’outils en plusieurs tours de plusieurs modèles, pour obtenir des conclusions reproductibles et vérifiables.
Quand on choisit un modèle pour construire un agent, beaucoup d’équipes rencontrent le même problème. En questions-réponses à un seul tour, les modèles se valent à peu près. Dès qu’on entre dans une boucle multi-tours « appeler un outil → récupérer le résultat → rappeler → gérer l’erreur → fournir une réponse structurée », les écarts apparaissent. Cet article présente un petit test d’appels d’outils en plusieurs tours avec une seule clé API pour plusieurs modèles, pour vous aider à transformer ces écarts, à très faible coût, en données que l’on peut enregistrer et vérifier.
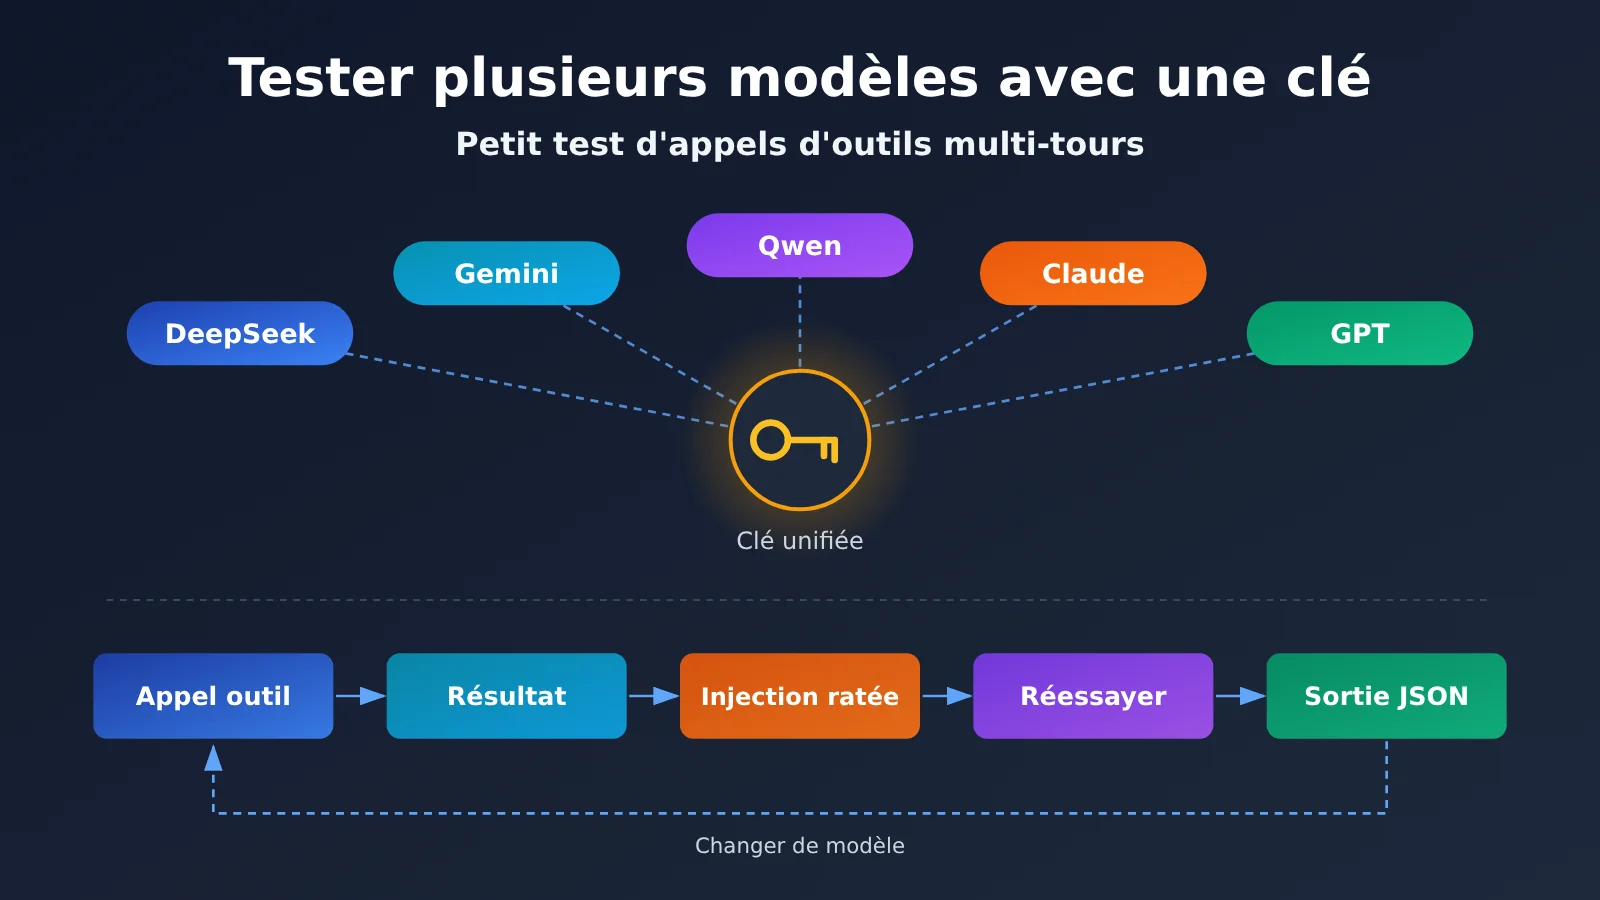
Ce n’est pas un classement de modèles. Cet article ne fournit aucun score de benchmark non vérifié ; il explique seulement comment concevoir le test pour que vous puissiez tirer vos propres conclusions dans votre contexte métier. La clé du test, c’est de contrôler les variables : la même clé API, la même définition d’outils, les mêmes données Mock ; seule change le nom du modèle. Avec une plateforme agrégatrice comme APIYI apiyi.com, une seule clé API suffit pour appeler plusieurs modèles tels que DeepSeek, Gemini, Qwen, Claude ou GPT, ce qui réduit beaucoup le coût de bascule lors d’une comparaison entre modèles.
L’essentiel : après lecture, vous saurez mettre en place un test reproductible en 5 étapes pour les appels d’outils en plusieurs tours. Il couvre cinq points clés : la sélection des outils, la validation des paramètres, le renvoi de l’ID d’appel, la nouvelle tentative en cas d’échec et la validation du JSON final.
Points essentiels d’un petit test d’appels d’outils en plusieurs tours
Avant de concevoir un test d’appels d’outils en plusieurs tours, il faut d’abord clarifier ce que signifie « reproductible ». La même entrée, exécutée à des moments différents et par des personnes différentes, doit produire le même type de résultat comparable. Une jolie sortie obtenue une seule fois ne suffit pas à tirer une conclusion. Le tableau ci-dessous constitue la structure d’ensemble du test.
| Point clé | Explication | Intérêt |
|---|---|---|
| Une clé API, plusieurs modèles | Tous les modèles passent par la même entrée d’interface, seul le champ model change | Élimine les interférences liées au réseau, à l’authentification et à la version du SDK |
| Outils mock figés | Les valeurs de retour des outils sont codées en dur, sans connexion à une vraie base de données ni à un service externe | Les résultats des outils sont identiques à chaque exécution |
| Une erreur injectée une seule fois | Le premier appel d’un outil renvoie systématiquement une erreur réessayable | Observer si le modèle réessaie correctement et s’il n’invente pas de données |
| Sortie structurée | La réponse finale doit être un JSON conforme au schéma | Le succès ou l’échec peut être déterminé automatiquement par programme |
| Traçabilité complète | Conserver les paramètres de requête, la réponse brute, l’usage et le temps d’exécution | Les conclusions sont vérifiables et une régression est possible après changement de version du modèle |
Pourquoi un test d’appels d’outils en plusieurs tours doit rester « petit »
Le test doit rester petit, parce qu’un test volumineux est difficile à reproduire. Dans un vrai contexte métier, une chaîne d’outils peut comporter une dizaine d’outils et dépendre de systèmes externes ; la moindre variation sera prise à tort pour un problème du modèle. Un bon petit test n’a besoin que de 2 à 3 outils en lecture seule, avec une panne injectée artificiellement, pour couvrir les étapes les plus sujettes à erreur de la boucle en plusieurs tours.
Le test doit aussi être « complet ». Il doit exécuter toute la boucle, et il ne suffit pas de regarder si le modèle déclenche un appel d’outil au premier tour. Beaucoup de modèles se comportent bien au premier tour ; les problèmes arrivent aux deuxième et troisième tours : ils n’envoient pas le bon ID d’appel, abandonnent dès qu’ils reçoivent une erreur, ou inventent un numéro de suivi de colis alors qu’ils n’ont aucune donnée. On ne voit ces problèmes qu’en allant jusqu’au dernier tour de la boucle.
Principes de conception pour tester plusieurs modèles avec une seule clé API
Le contrôle des variables est la condition préalable à tout test comparatif. Si le modèle A utilise le SDK officiel, le modèle B un SDK tiers et le modèle C une autre adresse de proxy, on ne saura plus si la différence finale vient du modèle ou du chemin réseau. Une fois l’entrée unifiée, le mode d’authentification, la stratégie de réessai, les délais d’attente et le format des logs restent identiques ; la seule variable est le modèle lui-même.
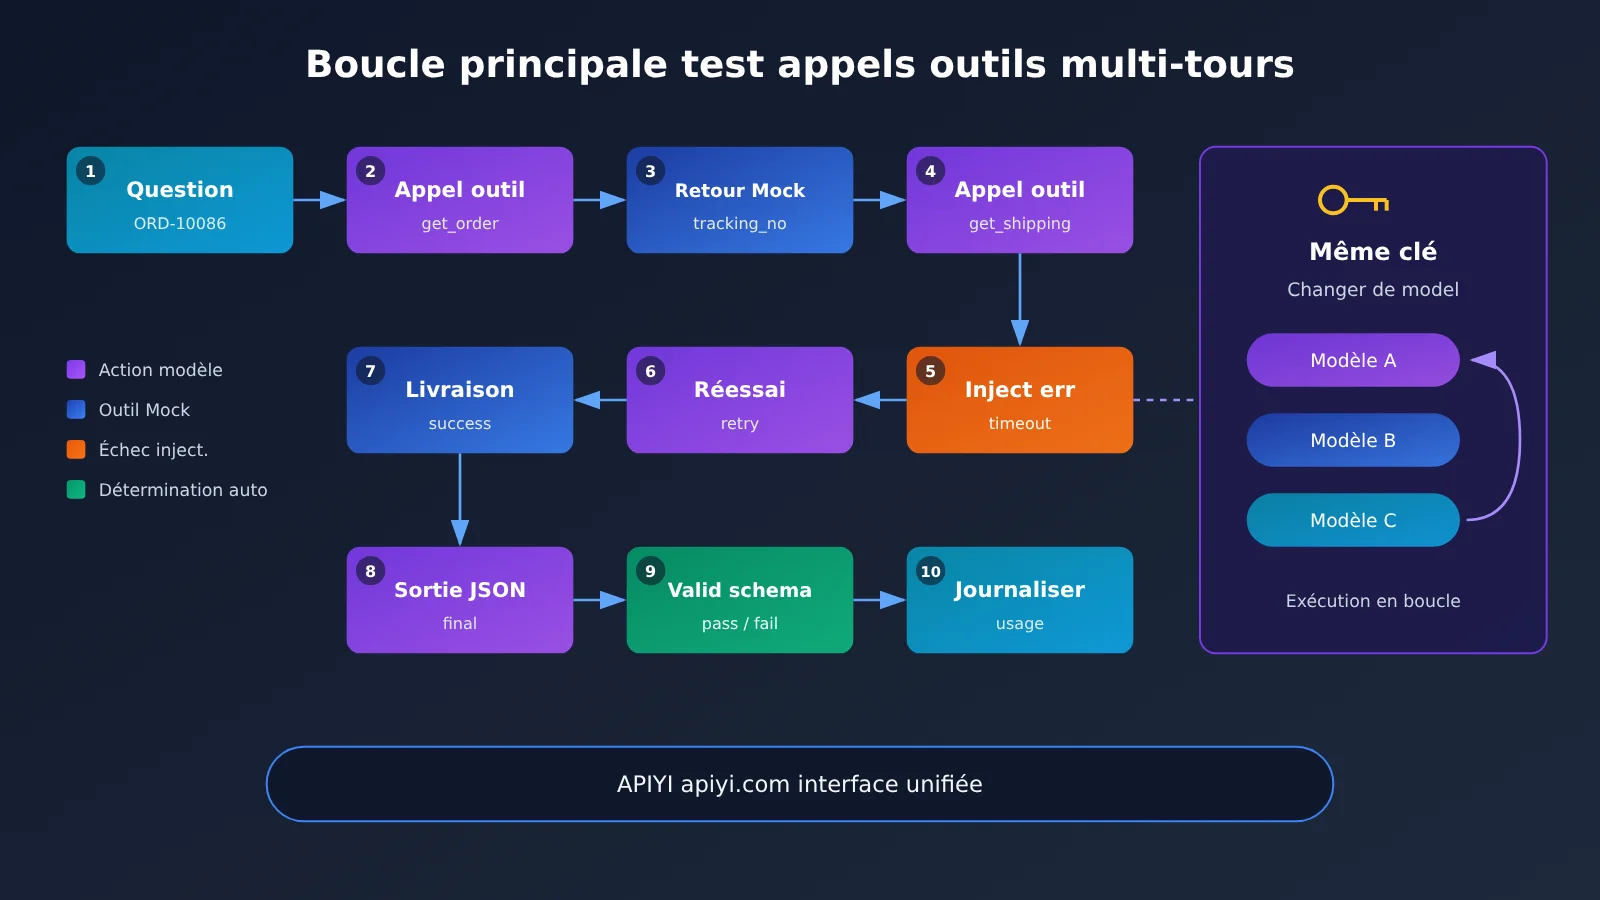
Prise en main rapide d’un petit test d’appels d’outils multi-tours
Cette section ne contient pas de code : elle liste uniquement les paramètres, la définition des outils et les étapes d’exécution. Vous pouvez l’implémenter dans n’importe quel langage que vous maîtrisez — Python, Node.js ou un script Shell. L’important est que chaque élément de configuration soit écrit dans un fichier de configuration fixe et conservé avec les résultats du test.
Étape 1 : unifier l’endpoint et les paramètres d’exécution
Commencez par définir le point d’entrée de l’interface et les paramètres d’échantillonnage. APIYI est compatible à la fois avec les formats d’interface OpenAI et Anthropic : une même clé permet aussi bien des appels de style Chat Completions que des appels de style Messages. Le tableau ci-dessous répertorie les éléments de configuration qu’il est recommandé de fixer.
| Paramètre | Valeur recommandée | Description |
|---|---|---|
| base_url (format OpenAI) | https://api.apiyi.com/v1 |
Appeler via le point d’entrée unifié APIYI ; l’adresse exacte fait foi dans la documentation docs.apiyi.com |
| base_url (format Anthropic) | Voir l’adresse de compatibilité Anthropic dans la documentation APIYI | Pour tester le protocole tool_use / tool_result |
| api_key | La même clé | Partagée par tous les modèles afin d’éliminer les différences d’authentification |
| temperature | 0 ou aussi bas que possible | Réduire l’aléatoire ; si certains modèles de raisonnement ne le prennent pas en charge, noter la valeur réelle |
| max_tokens | Valeur fixe | Éviter de tirer de mauvaises conclusions à cause d’une sortie tronquée |
| tool_choice | auto | Observer la décision autonome du modèle, sans forcer l’appel |
| Nombre maximal de tours de boucle | Plafond fixe, par exemple 6 tours | Éviter que le modèle ne parte en tentatives infinies |
| Nombre d’exécutions par modèle | Nombre fixe, par exemple 5 | Juger la stabilité sur plusieurs résultats, pas sur une seule exécution |
🚀 Conseil pour démarrer rapidement : vous pouvez d’abord vous inscrire sur APIYI apiyi.com et récupérer une clé, puis appeler les modèles candidats les uns après les autres avec cette même clé. Une fois que chaque modèle renvoie bien une réponse normale d’appel d’outil, lancez le test officiel. Les instructions d’intégration sont disponibles sur docs.apiyi.com.
Étape 2 : définir 2 à 3 outils en lecture seule
La conception des outils repose sur deux exigences : lecture seule et déterminisme. La lecture seule évite de déclencher accidentellement des opérations d’écriture pendant les tests, tandis que le déterminisme garantit que chaque appel renvoie la même valeur. Je recommande de partir d’un scénario fictif de consultation de commande, avec deux outils :
- get_order : le paramètre est order_id (chaîne de caractères, format fixe constitué de « ORD- » suivi de chiffres). L’outil renvoie toujours le statut de la commande, le nom du produit et le numéro de suivi tracking_no.
- get_shipping : le paramètre est tracking_no (chaîne de caractères). Le premier appel renvoie toujours une erreur, avec error égal à timeout et retryable égal à true ; à partir du deuxième appel, l’outil renvoie un statut logistique et une date de livraison prévue fixes.
- Outil perturbateur facultatif get_coupon : sans rapport avec la question, il sert à observer si le modèle effectue des appels superflus.
Le schéma des paramètres doit être écrit de manière stricte : type de champ, champs obligatoires et format regex doivent être explicites. Les paramètres générés par le modèle doivent d’abord passer la validation du schéma avant d’être transmis à la fonction Mock. En cas d’échec de validation, il faut l’enregistrer comme une « erreur de paramètre », sans la corriger discrètement.
Étape 3 : rédiger une invite et une question utilisateur fixes
L’invite System ne contient que des règles, pas de réponse. On peut demander au modèle de répondre uniquement à partir des données renvoyées par les outils ; de réessayer au maximum 2 fois lorsqu’un outil renvoie une erreur réessayable ; et de produire finalement un seul objet JSON, avec les champs order_status, shipping_status, eta et data_source. La question utilisateur est fixe et tient en une phrase, par exemple « Peux-tu me dire où en est la commande ORD-10086 maintenant ? ».
Une fois l’invite définie, elle ne doit plus être modifiée. Si un modèle échoue pendant les tests à cause d’une ambiguïté dans l’invite, la bonne démarche consiste à ouvrir une nouvelle version, puis à retester tous les modèles avec cette nouvelle version, plutôt que de modifier l’invite uniquement pour ce modèle.
Étape 4 : exécuter la boucle et injecter un échec
La logique d’exécution se déroule dans l’ordre suivant :
- Envoyer les messages system et user, ainsi que la définition des outils.
- Si la réponse contient des appels d’outils, valider les paramètres un par un, exécuter la fonction Mock correspondante, puis renvoyer le résultat conformément au protocole.
- Pour le premier appel à get_shipping, renvoyer systématiquement une erreur réessayable.
- Répéter l’étape 2 jusqu’à ce que le modèle produise une réponse finale sans appel d’outil, ou jusqu’à atteindre le nombre maximal de tours.
- Valider la réponse finale avec JSON Schema, et enregistrer tous les messages, la réponse brute ainsi que l’usage de chaque tour.
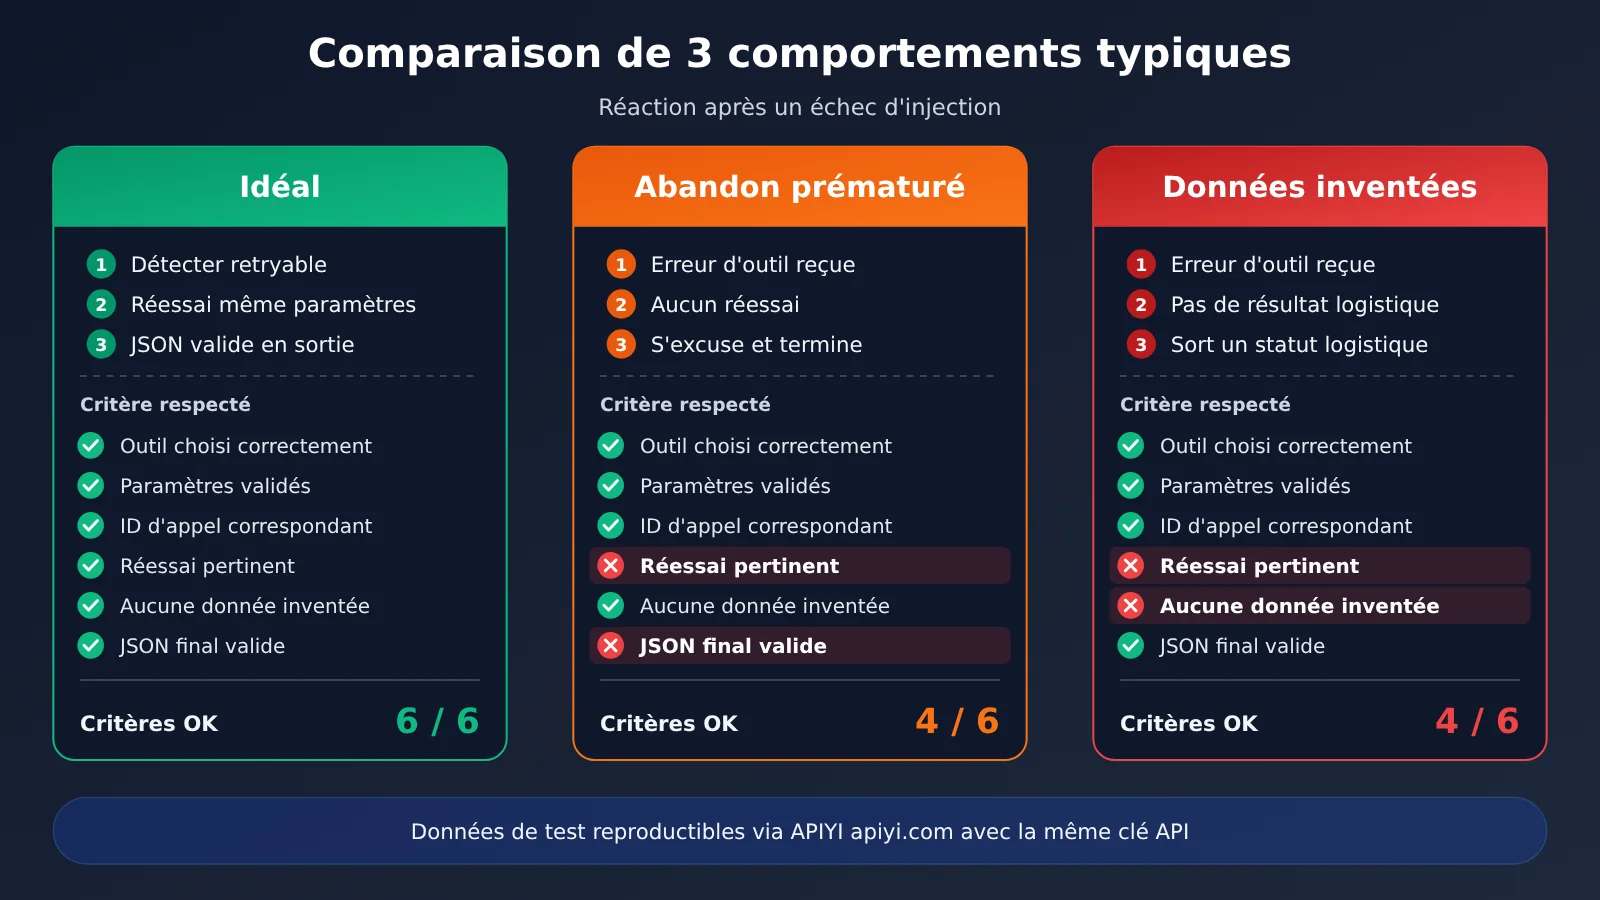
L’injection d’échec est la partie la plus discriminante de tout le test. Le comportement idéal consiste, pour le modèle, à identifier que retryable vaut true et à rappeler get_shipping une seconde fois avec les mêmes paramètres. Trois comportements problématiques reviennent souvent : s’excuser directement auprès de l’utilisateur et s’arrêter là ; inventer un statut de livraison ; modifier les paramètres et réessayer en boucle jusqu’à dépasser la limite de tours.
Étape 5 : noter selon la checklist et conserver une trace
Après chaque exécution, on évalue chaque point par programme, en évitant autant que possible la notation subjective humaine. L’humain se contente de réexaminer les échantillons que le programme a signalés comme anormaux.
Différences de protocole pour les appels d’outils multi-tours : formats OpenAI et Anthropic
Pour qu’un même test puisse tourner avec les deux formats d’interface, il faut d’abord comprendre les différences de détail entre les protocoles. De petites variations dans le protocole suffisent à provoquer des problèmes du genre « ça passe avec curl, mais pas dans le client ». Le conseil : commencez par une requête minimale pour confirmer que le protocole est correct, puis seulement comparez les capacités des modèles.
| Étape | Format compatible OpenAI | Format compatible Anthropic |
|---|---|---|
| Définition des outils | Tableau tools, chaque élément de type function, paramètres dans parameters |
Tableau tools, le schéma des paramètres est dans input_schema |
| Lancement de l’appel par le modèle | tool_calls dans le message assistant, chacun avec un id |
Blocs tool_use dans le contenu assistant, chacun avec un id |
| Forme des paramètres | arguments est généralement une chaîne JSON, à parser soi-même |
input est directement un objet JSON |
| Renvoi du résultat | Message avec role valant tool, portant tool_call_id |
Bloc tool_result dans un message user, portant tool_use_id |
| Marquage d’erreur | En général, on définit un champ d’erreur personnalisé dans le contenu du résultat | tool_result prend en charge le marqueur is_error |
| Appels parallèles | Une réponse peut contenir plusieurs tool_calls |
Une réponse peut contenir plusieurs blocs tool_use |
Quelques pièges reviennent le plus souvent. Premier point : au format OpenAI, arguments est une chaîne, et certains modèles ajoutent parfois des caractères superflus, ce qui fait échouer le parsing. Ce cas doit lui-même entrer dans la notation, plutôt que d’être rattrapé par une tolérance dans le code. Deuxième point : lors du renvoi des résultats, les ID doivent correspondre un à un avec ceux des appels initiaux, et il faut être particulièrement vigilant à l’ordre en cas d’appels parallèles. Troisième point : certains modèles produisent à la fois du texte et un appel d’outil dans une même réponse ; la logique de traitement doit gérer les deux types de contenu en même temps.
💡 Conseil technique : grâce au point d’entrée unifié d’APIYI apiyi.com, vous pouvez utiliser une seule clé API pour exécuter la même série de tests au format OpenAI puis au format Anthropic. Cela permet de distinguer si le problème vient du modèle lui-même ou de la couche d’adaptation du protocole.
Checklist d’évaluation et modèle d’enregistrement pour les appels d’outils multi-tours
La checklist est ce qui rend les conclusions reproductibles. Chaque point doit pouvoir être jugé par un programme et correspondre à un risque métier réel. Le tableau ci-dessous propose les contrôles recommandés, à adapter selon votre activité.
| Point de contrôle | Méthode de vérification | Risque métier associé |
|---|---|---|
| Sélection d’outil correcte | Le premier tour appelle get_order, sans appeler d’outil parasite | Les appels superflus ajoutent latence et coût |
| Paramètres validés | Les paramètres respectent le schéma : types, champs obligatoires et formats | Des paramètres erronés atteignent le système réel |
| Correspondance correcte des ID d’appel | L’ID du résultat renvoyé correspond à celui de l’appel émis | Contexte multi-tours désynchronisé |
| Comportement de nouvelle tentative raisonnable | Après une erreur réessayable, nouvelle tentative avec les mêmes paramètres sans dépasser la limite | Abandon trop rapide ou tentatives infinies |
| Aucune donnée inventée | Chaque champ de la réponse finale se retrouve dans les valeurs renvoyées par l’outil | Les hallucinations touchent directement l’utilisateur |
| JSON final valide | Passe la validation JSON Schema, sans texte superflu | Échec de parsing en aval |
| Nombre de tours et consommation de tokens | On enregistre le nombre total de tours, les tokens d’entrée et de sortie | Évaluation du coût et de la latence |
Une fois qu’un modèle a tourné un nombre fixe de fois, on consolide le tout dans un tableau de résultats. Colonnes suggérées : ID du modèle, format d’interface, numéro d’exécution, nombre de points réussis, détail des points échoués, nombre total de tours, tokens d’entrée, tokens de sortie, durée, date du test. On met l’en-tête et le fichier de configuration dans le dépôt de version. Quand un modèle est mis à jour ou qu’on passe à une nouvelle version, il suffit de relancer le même script pour obtenir une comparaison de régression.
Comment compter les coûts des appels d’outils multi-tours
La consommation de tokens doit être relevée tour par tour, pas seulement sur le dernier tour. Dans une boucle multi-tours, chaque tour renvoie les messages et les résultats d’outils précédents comme entrée : les tokens d’entrée s’accumulent donc progressivement. Plus il y a de tentatives, plus le coût grimpe. C’est précisément pour cela que le point « comportement de nouvelle tentative raisonnable » mérite une note à part.
Pour calculer le coût, on multiplie les tokens d’entrée et de sortie du champ usage (et les tokens de cache s’il y a des hits de cache) par le prix unitaire correspondant. Pour tous les modèles, les prix d’entrée, de sortie, de cache et les règles de facturation sont ceux affichés sur la page tarifs d’APIYI, docs.apiyi.com/models. Cet article ne donne pas de chiffres précis : les prix évoluent, et des valeurs codées en dur deviennent vite obsolètes.
Une seule clé pour tester plusieurs modèles : la liste des modèles candidats
Il est conseillé de couvrir différents fournisseurs et différents positionnements parmi les modèles candidats : par exemple un modèle au meilleur rapport qualité-prix, un modèle principal, et un modèle plus solide en raisonnement. Le tableau ci-dessous ne liste que les séries de modèles et les points d’attention à tester, sans donner de conclusion : les conclusions doivent venir de vos propres données de test.
| Série de modèles | Points d’attention à tester | Format d’API recommandé | Plateformes disponibles |
|---|---|---|---|
| Série DeepSeek | Stabilité de l’analyse syntaxique des chaînes de paramètres, nouvelle tentative après échec d’injection | Compatible OpenAI | APIYI apiyi.com, API officielle |
| Série Gemini | Tendance aux appels parallèles, présence éventuelle de texte parasite dans le JSON final | Compatible OpenAI | APIYI apiyi.com, API officielle |
| Série Qwen | Appels erronés d’outils perturbateurs, correspondance des ID sur plusieurs tours | Compatible OpenAI | APIYI apiyi.com, API officielle |
| Série Claude | Gestion de is_error dans tool_result, contrôle du nombre de tours | Compatible Anthropic | APIYI apiyi.com, API officielle |
| Série GPT | Respect strict du schéma, consommation de tokens | Compatible OpenAI | APIYI apiyi.com, API officielle |
Pour les ID et versions de modèles réellement disponibles, référez-vous à la liste de modèles d’APIYI. Lorsque vous consignez les résultats, écrivez toujours l’ID complet du modèle, pas seulement le nom de la série. Les différentes versions d’une même série peuvent se comporter très différemment en matière d’appel d’outils.
💡 Conseil de choix : le modèle à retenir dépend de la complexité de vos outils, de votre tolérance aux hallucinations et de votre budget. Je vous conseille de faire tourner chaque modèle candidat une fois sur APIYI apiyi.com avec la même clé, puis de croiser avec les données tarifaires de docs.apiyi.com/models pour vous décider.
FAQ – questions fréquentes
Q1 : Qu’est-ce qu’un petit test d’invocation d’outils multi-tours ?
C’est un test à petite échelle, au résultat déterministe. Avec 2 à 3 outils Mock et une injection d’échec, on fait parcourir au modèle tout le cycle « appeler l’outil, traiter le résultat, réessayer, produire une réponse structurée », puis on vérifie chaque point par programme. Ce qui compte, c’est que la boucle se déroule de façon stable, pas le niveau de connaissance du modèle.
Q2 : Pourquoi insister sur l’idée de tester plusieurs modèles avec une seule clé ?
Pour maîtriser les variables. Des clés, des SDK et des adresses proxy différents introduisent des écarts d’authentification, de timeout et d’adaptation de protocole, ce qui fausse la comparaison. Avec un point d’entrée unique, seul le champ model change : les différences mesurées peuvent alors être attribuées au modèle lui-même.
Q3 : Mettre temperature à 0 garantit-il une reproductibilité totale ?
Non, pas totalement. Même avec temperature à 0, certains modèles produisent encore de légères variations, et les modèles de raisonnement peuvent ne pas accepter une valeur aussi basse. Il faut donc répéter le test plusieurs fois et regarder le taux de réussite et la distribution des échecs, plutôt qu’un seul passage. Les valeurs de paramètres réellement utilisées doivent aussi être consignées.
Q4 : À quels cas d’usage ce test convient-il ?
– **Choix d’Agent** : comparer la stabilité des modèles candidats sur la boucle d’outils avant la mise en production.
– **Régression lors d’une montée de version** : après la sortie d’une nouvelle version, relancer le même script pour confirmer l’absence de régression.
– **Validation d’une migration de protocole** : lors du passage du format OpenAI au format Anthropic, vérifier que la couche d’adaptation ne pose pas de problème.
Q5 : Comment commencer rapidement à appeler ces modèles ?
1. Rendez-vous sur APIYI apiyi.com pour créer un compte et récupérer une clé.
2. Consultez docs.apiyi.com pour identifier l’adresse compatible OpenAI et l’adresse compatible Anthropic.
3. Configurez selon le tableau de paramètres de l’étape 1 de cet article, puis commencez par une requête minimale pour vérifier que chaque modèle renvoie bien un appel d’outil.
APIYI permet d’accéder de façon unifiée aux différents modèles cités dans cet article ; pour changer de modèle, il suffit de modifier le champ model.
Q6 : Comment estimer le coût du test ?
Le coût est à peu près égal à « nombre de modèles × nombre d’exécutions × tokens cumulés par exécution × prix unitaire ». Dans une boucle multi-tours, les tokens d’entrée s’accumulent à chaque tour, et les réessais augmentent encore la consommation. Les prix unitaires et les règles de facturation du cache sont ceux de la page tarifaire d’APIYI, docs.apiyi.com/models. Mieux vaut lancer d’abord une exécution par modèle pour estimer la consommation, puis décider du nombre d’exécutions définitif.
Q7 : Quelles sont les limites de ce test ?
Un petit test ne couvre que les modes d’échec typiques et ne représente pas tous les cas métier complexes. Les données renvoyées par les outils Mock sont très propres, alors qu’un système réel peut renvoyer des données mal formatées ou trop longues. Une fois le test validé, je conseille d’ajouter des échantillons d’anomalies réellement rencontrées en production et d’enrichir progressivement les cas de test.
Points clés du mini-test d’invocation d’outils en plusieurs tours
- Priorité au contrôle des variables : une seule clé, une seule configuration, et on ne change que le champ
model. - Des outils en lecture seule et déterministes : les valeurs de retour du mock sont codées en dur, pour que chaque exécution voie exactement les mêmes données.
- Injecter un échec, obligatoirement : une erreur réessayable est ce qui distingue le mieux la capacité d’un modèle à gérer une boucle.
- Une notation programmatique : chaque point de contrôle doit pouvoir être évalué automatiquement ; l’humain se contente de vérifier les anomalies.
- Une traçabilité complète : conservez la réponse brute, l’
usagede chaque tour et l’ID complet du modèle, pour faciliter les régressions. - Le prix officiel fait foi : le calcul des coûts se base sur la page tarifaire d’APIYI, docs.apiyi.com/models.
- Un point d’entrée unique, c’est plus simple : grâce à la compatibilité d’APIYI avec les formats OpenAI et Anthropic, un seul script couvre les deux protocoles.
En résumé
Un mini-test d’invocation d’outils en plusieurs tours, avec une seule clé pour comparer plusieurs modèles : l’essentiel tient en trois points.
- Reproductible : configuration figée, données mock figées, version d’invite figée, et plusieurs exécutions.
- Évaluable : remplacer l’impression subjective par une validation de schéma et une grille de notation.
- Régressable : avec une traçabilité complète, on peut retester rapidement avec le même script après une mise à jour du modèle.
Cette méthode ne vous dira pas « quel modèle est le meilleur », mais elle vous dira lequel est le plus stable dans votre chaîne d’outils, lequel consomme le moins de tokens, et lequel a le comportement le plus maîtrisable en cas d’échec. Mon conseil : commencez par faire tourner le scénario de consultation de commande présenté dans cet article pour valider le processus, puis remplacez les outils par ceux de votre propre métier.
Je vous recommande de passer par APIYI (apiyi.com) pour réaliser cette comparaison horizontale de plusieurs modèles avec une même clé. Les modalités d’intégration sont décrites sur docs.apiyi.com, et les prix comme les règles de facturation font foi sur docs.apiyi.com/models.
📚 Ressources complémentaires
- Documentation OpenAI sur l’appel de fonctions : description du protocole pour
tools,tool_callset les messages de rôletool - Lien :
platform.openai.com/docs/guides/function-calling -
Description : comprendre la gestion des chaînes de paramètres et des
tool_call_iddans le format compatible OpenAI -
Documentation Anthropic sur l’utilisation des outils : description des blocs de contenu
tool_useettool_result - Lien :
docs.anthropic.com/en/docs/build-with-claude/tool-use -
Description : comprendre l’usage de
input_schema,tool_use_idetis_error -
Centre de documentation APIYI : explications sur l’accès à l’interface unifiée
- Lien :
docs.apiyi.com -
Description : consulter les adresses compatibles OpenAI et Anthropic ainsi que des exemples d’appel
-
Page modèles et tarifs APIYI : liste des modèles et base de facturation
- Lien :
docs.apiyi.com/models - Description : tous les prix unitaires d’entrée, de sortie et de cache se basent sur les données réelles de cette page
Auteur : l’équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI, sur apiyi.com ; vous trouverez davantage de ressources d’intégration dans le centre de documentation docs.apiyi.com