Catatan penulis: Dengan satu kunci API, satu set skrip tetap, dan satu kegagalan injeksi, bandingkan kemampuan pemanggilan alat multi-putaran beberapa model secara berdampingan, lalu dapatkan kesimpulan yang dapat direproduksi dan diperiksa ulang.
Saat memilih model untuk membuat Agent, banyak tim menghadapi masalah yang sama. Dalam tanya jawab satu putaran, performa tiap model tampak mirip; begitu masuk ke siklus multi-putaran “panggil alat → dapatkan hasil → panggil lagi → tangani error → beri jawaban terstruktur”, perbedaannya baru muncul. Artikel ini memperkenalkan uji kecil pemanggilan alat multi-putaran dengan satu kunci untuk beberapa model, untuk membantu Anda dengan biaya sangat rendah mengubah perbedaan tersebut menjadi data yang bisa dicatat dan diperiksa ulang.
Ini bukan daftar peringkat model. Artikel ini tidak menyajikan skor apa pun yang belum diuji secara nyata; artikel ini hanya membahas cara merancang pengujian agar Anda bisa menarik kesimpulan dalam skenario bisnis Anda sendiri. Kunci pengujiannya adalah mengendalikan variabel: kunci yang sama, definisi alat yang sama, data Mock yang sama, hanya nama model yang diubah. Melalui platform agregator seperti APIYI apiyi.com, satu kunci dapat memanggil banyak model seperti DeepSeek, Gemini, Qwen, Claude, dan GPT, sehingga biaya peralihan saat membandingkan secara berdampingan jauh lebih sedikit.
Nilai inti: Setelah membaca artikel ini, Anda dapat menyusun pengujian pemanggilan alat multi-putaran 5 langkah yang dapat direproduksi. Pengujian ini mencakup lima tahap kunci: pemilihan alat, validasi parameter, pengembalian ID pemanggilan, percobaan ulang saat gagal, dan validasi JSON akhir.
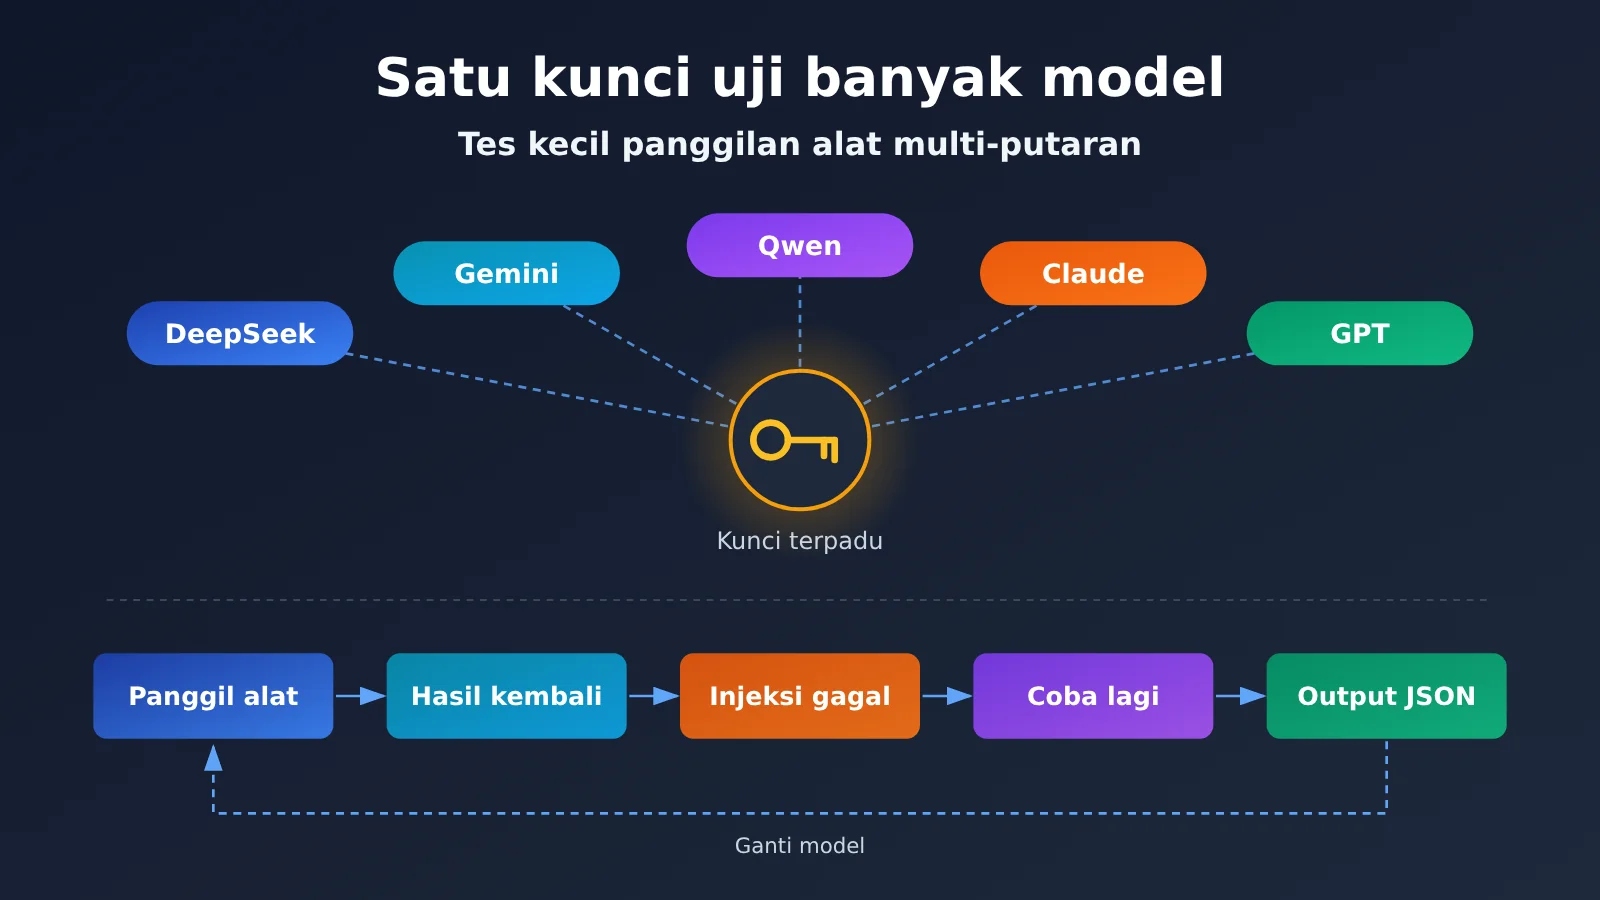
Poin inti pengujian kecil pemanggilan tool multi-putaran
Sebelum merancang pengujian pemanggilan tool multi-putaran, tentukan dulu apa yang dimaksud dengan “dapat direproduksi”. Input yang sama, saat dijalankan pada waktu berbeda oleh orang berbeda, seharusnya menghasilkan hasil sejenis yang dapat dibandingkan. Output sekali jalan yang terlihat bagus tidak bisa dijadikan kesimpulan. Tabel berikut adalah kerangka keseluruhan pengujian.
| Poin | Penjelasan | Nilai |
|---|---|---|
| Satu kunci, banyak model | Semua model melewati satu pintu masuk antarmuka, hanya mengubah field model | Menghilangkan gangguan dari jaringan, autentikasi, dan versi SDK |
| Tool Mock tetap | Nilai kembalian tool ditulis mati, tidak terhubung ke database nyata atau layanan eksternal | Hasil tool yang terlihat setiap kali dijalankan sepenuhnya sama |
| Suntikkan satu kegagalan | Panggilan pertama suatu tool selalu mengembalikan error yang dapat dicoba ulang | Amati apakah model dapat mencoba ulang dengan benar, apakah ia mengarang data |
| Titik akhir terstruktur | Jawaban akhir harus berupa JSON yang sesuai Schema | Dapat otomatis dinilai lulus atau gagal oleh program |
| Jejak lengkap | Simpan parameter permintaan, respons mentah, usage, dan waktu proses | Kesimpulan dapat ditinjau ulang; setelah mengganti versi model dapat dilakukan regresi |
Mengapa pengujian pemanggilan tool multi-putaran harus “kecil”
Pengujian harus kecil karena pengujian besar sulit direproduksi. Rantai tool di bisnis nyata bisa berisi belasan tool dan bergantung pada sistem eksternal; fluktuasi di titik mana pun bisa disalahartikan sebagai masalah model. Pengujian kecil yang baik hanya membutuhkan 2 sampai 3 tool baca-saja, ditambah satu kegagalan yang disuntikkan secara sengaja, dan sudah cukup mencakup bagian paling rawan error dalam loop multi-putaran.
Pengujian juga harus “lengkap”. Ia harus menjalankan seluruh loop, bukan hanya melihat apakah model memulai pemanggilan tool pada putaran pertama. Banyak model tampil bagus di putaran pertama, tetapi masalah muncul di putaran kedua dan ketiga: tidak membawa ID pemanggilan yang benar, langsung menyerah setelah menerima error, atau mengarang nomor resi logistik sendiri saat tidak ada data. Masalah-masalah ini baru terlihat kalau loop dijalankan sampai putaran terakhir.
Prinsip desain menguji banyak model dengan satu kunci
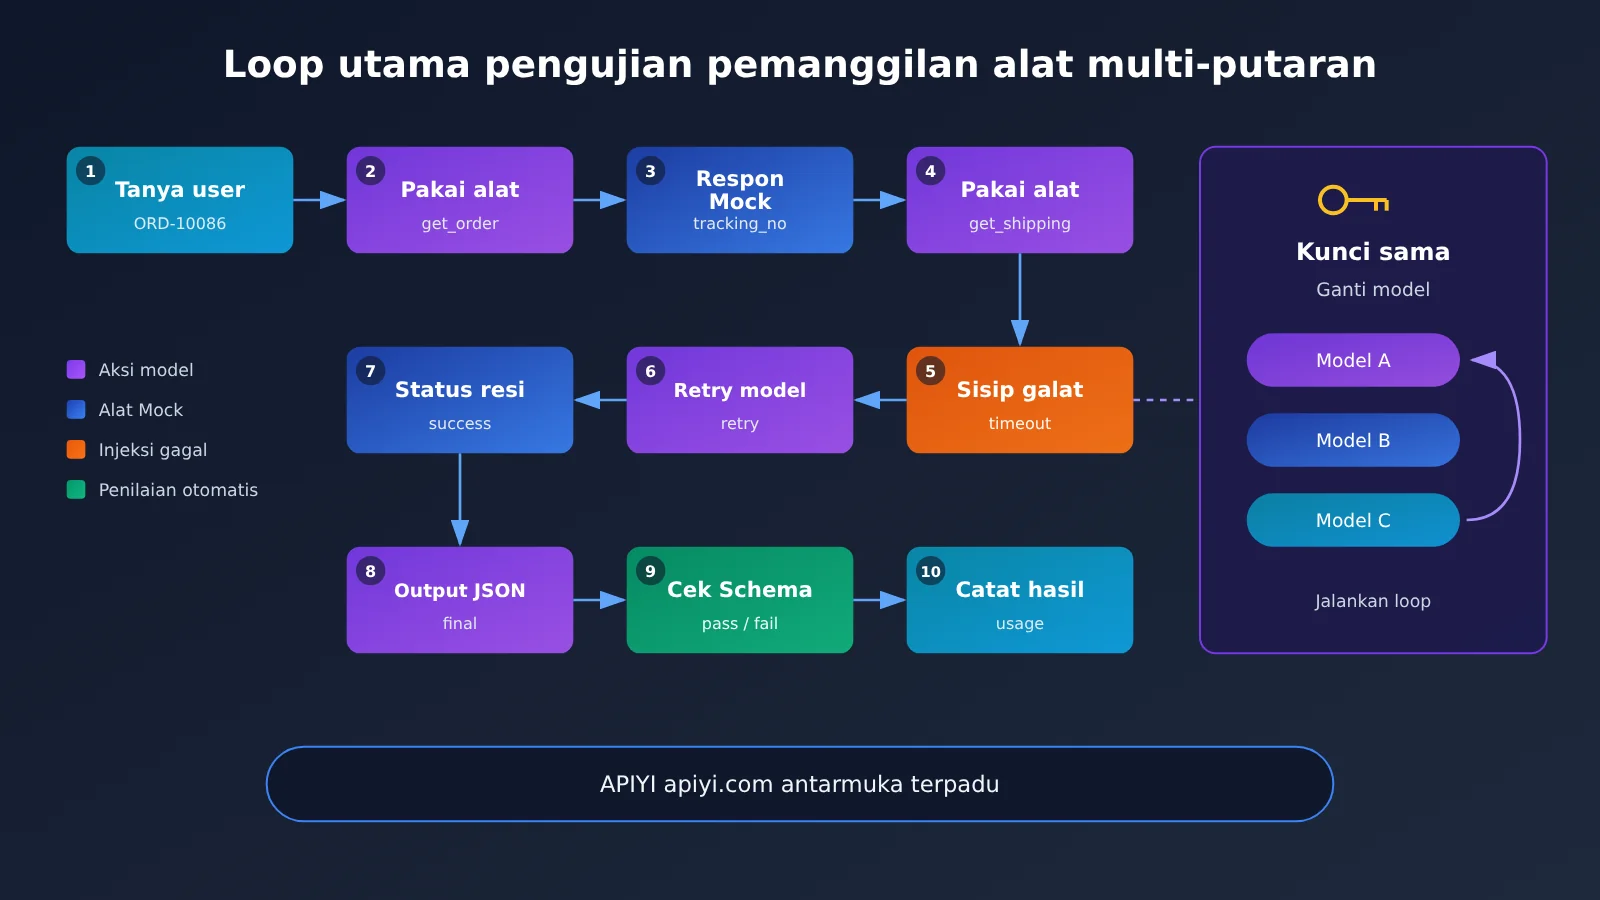
Kontrol variabel adalah prasyarat pengujian perbandingan. Jika model A memakai SDK resmi, model B memakai SDK pihak ketiga, dan model C berganti ke alamat proksi lain, perbedaan akhirnya tidak bisa dipastikan berasal dari model atau dari jalur koneksi. Setelah pintu masuk disatukan, cara autentikasi, strategi percobaan ulang, pengaturan timeout, dan format log semuanya konsisten; satu-satunya variabel adalah model itu sendiri.
Panduan Cepat Uji Pemanggilan Tool Multi-putaran
Bagian ini tidak menyertakan kode, hanya mencantumkan parameter, definisi tool, dan langkah eksekusi. Anda bisa menggunakan bahasa apa pun yang familiar: Python, Node.js, atau skrip Shell. Intinya, setiap konfigurasi ditulis ke file konfigurasi tetap dan disimpan bersama hasil pengujian.
Langkah 1: Antarmuka terpadu dan parameter eksekusi
Tentukan dulu endpoint antarmuka dan parameter sampling. APIYI kompatibel dengan format OpenAI dan Anthropic sekaligus; kunci yang sama dapat digunakan untuk panggilan gaya Chat Completions maupun Messages. Tabel berikut mencantumkan item konfigurasi yang disarankan untuk difixkan.
| Item konfigurasi | Nilai yang disarankan | Keterangan |
|---|---|---|
| base_url (format OpenAI) | https://api.apiyi.com/v1 |
Dipanggil melalui endpoint terpadu APIYI; alamat spesifik mengikuti dokumentasi di docs.apiyi.com |
| base_url (format Anthropic) | Lihat alamat kompatibel Anthropic di dokumentasi APIYI | Untuk menguji protokol tool_use / tool_result |
| api_key | Kunci yang sama | Dipakai bersama oleh semua model, menghilangkan perbedaan autentikasi |
| temperature | 0 atau serendah mungkin | Mengurangi keacakan; jika sebagian model penalaran tidak mendukung, catat nilai aktualnya |
| max_tokens | Nilai tetap | Menghindari salah penilaian karena output terpotong |
| tool_choice | auto | Amati keputusan otonom model, jangan paksa pemanggilan |
| Jumlah putaran loop maksimum | Batas atas tetap, misalnya 6 putaran | Mencegah model terjebak dalam percobaan ulang tanpa henti |
| Jumlah eksekusi per model | Jumlah tetap, misalnya 5 kali | Gunakan hasil beberapa kali untuk menilai stabilitas, bukan performa satu kali |
🚀 Saran memulai cepat: Anda dapat mendaftar di APIYI apiyi.com dan mendapatkan kunci, lalu menggunakan kunci yang sama untuk memanggil model kandidat secara berurutan. Setelah memastikan setiap model dapat mengembalikan respons pemanggilan tool yang normal, barulah mulai pengujian resmi. Petunjuk integrasi lihat docs.apiyi.com.
Langkah 2: Mendefinisikan 2 sampai 3 alat hanya-baca
Ada dua persyaratan dalam desain alat: hanya-baca dan deterministik. Hanya-baca bertujuan mencegah operasi tulis tidak sengaja terpicu selama pengujian, sedangkan deterministik bertujuan memastikan nilai yang dikembalikan selalu sama setiap kali dipanggil. Disarankan menggunakan skenario fiktif pencarian pesanan, yang mencakup dua alat:
- get_order: parameternya adalah order_id (string, formatnya tetap “ORD-” diikuti angka). Selalu mengembalikan status pesanan, nama barang, dan nomor resi pengiriman tracking_no.
- get_shipping: parameternya adalah tracking_no (string). Pemanggilan pertama selalu mengembalikan error, dengan isi error berisi error bernilai timeout dan retryable bernilai true; pemanggilan kedua dan seterusnya mengembalikan status logistik serta perkiraan tanggal pengiriman yang tetap.
- Alat pengganggu opsional get_coupon: tidak berkaitan dengan masalah, digunakan untuk mengamati apakah model akan memanggilnya secara berlebihan.
Skema parameter harus ditulis secara ketat: tipe field, item wajib, dan format regex semuanya harus jelas. Parameter yang dihasilkan model harus melalui validasi Skema terlebih dahulu sebelum diserahkan ke fungsi Mock. Jika validasi gagal, catat sebagai satu “kesalahan parameter”, jangan diam-diam memperbaikinya.
Langkah 3: Menulis petunjuk tetap dan pertanyaan pengguna
System prompt hanya berisi aturan, tidak berisi jawaban. Anda dapat meminta model untuk hanya menjawab berdasarkan data yang dikembalikan alat; ketika alat melaporkan error dan dapat dicoba ulang, coba ulang maksimal 2 kali; pada akhirnya hanya keluarkan satu objek JSON, dengan field meliputi order_status, shipping_status, eta, dan data_source. Pertanyaan pengguna ditetapkan sebagai satu kalimat, misalnya “tolong bantu saya cek pesanan ORD-10086 sekarang sudah sampai mana”.
Setelah petunjuk ditetapkan, jangan diubah lagi. Jika selama pengujian ditemukan suatu model gagal karena ambiguitas petunjuk, cara yang benar adalah membuka nomor versi baru, lalu semua model diuji ulang dengan versi baru tersebut, bukan hanya mengubah petunjuk untuk model ini saja.
Langkah 4: Jalankan loop dan suntikkan kegagalan
Logika eksekusi berjalan dengan urutan berikut:
- Kirim pesan system dan user, beserta definisi tool.
- Jika respons berisi pemanggilan tool, validasi parameternya satu per satu, jalankan fungsi Mock yang sesuai, lalu kembalikan hasilnya sesuai ketentuan protokol.
- Untuk pemanggilan
get_shippingyang pertama, selalu kembalikan error yang bisa dicoba ulang (retryable). - Ulangi langkah 2 sampai model memberikan balasan akhir tanpa pemanggilan tool, atau sampai mencapai jumlah putaran maksimum.
- Validasi balasan akhir dengan JSON Schema, lalu simpan seluruh pesan, respons mentah, dan usage tiap putaran.
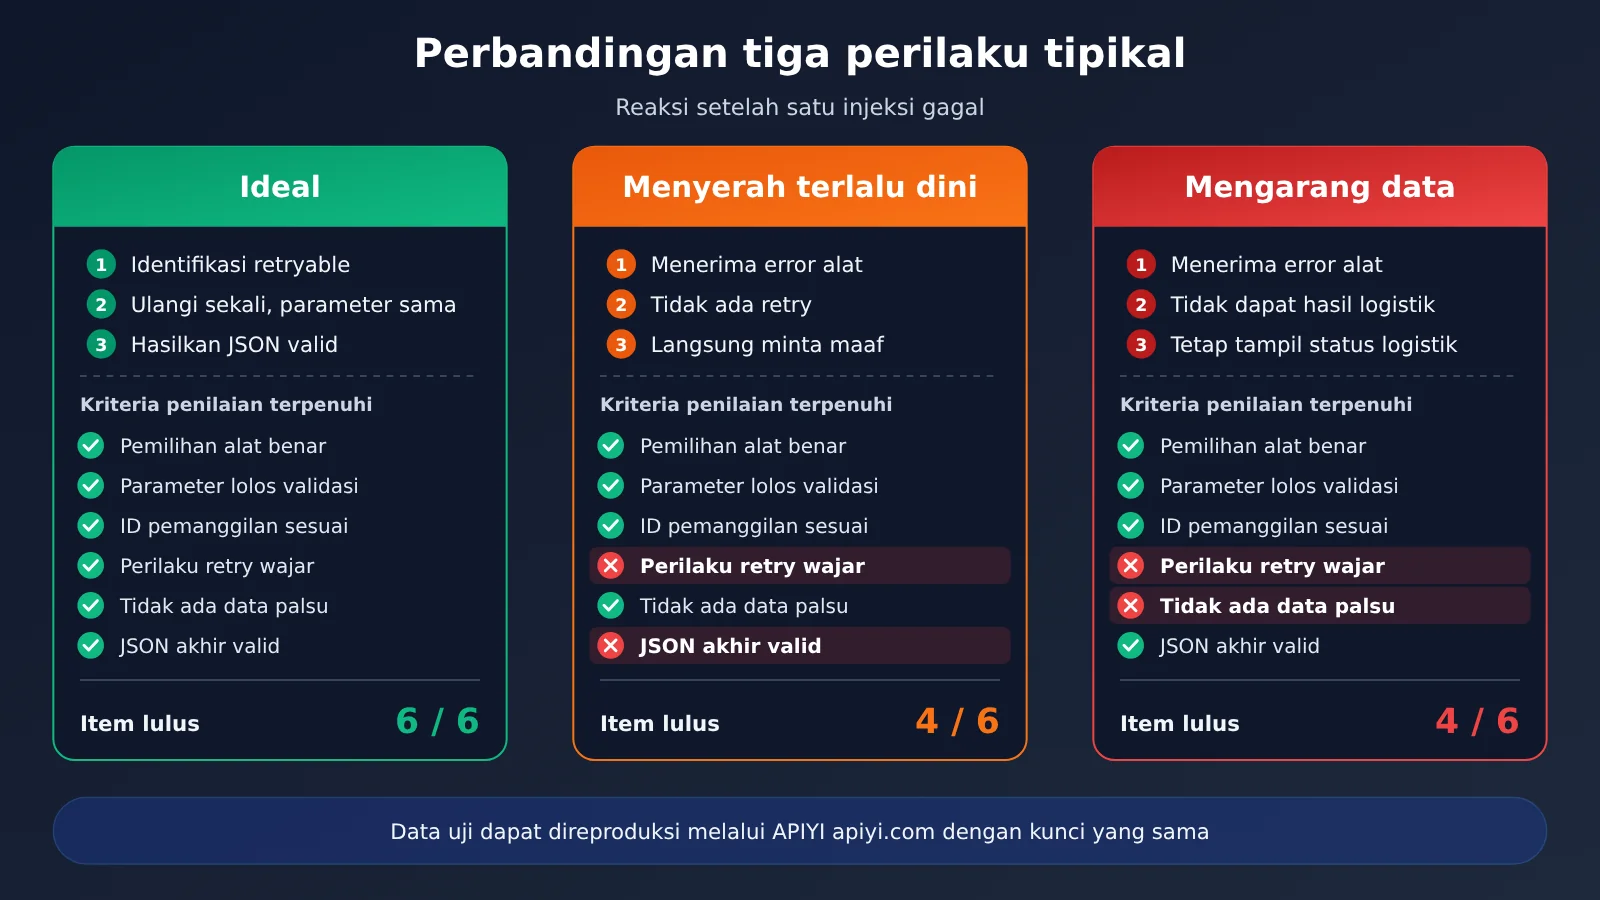
Menyuntikkan kegagalan adalah bagian yang paling membedakan dalam keseluruhan tes ini. Perilaku idealnya adalah model mengenali bahwa retryable bernilai true, lalu memanggil get_shipping sekali lagi dengan parameter yang sama. Ada tiga perilaku bermasalah yang umum terjadi: langsung meminta maaf kepada pengguna lalu mengakhiri; mengarang status pengiriman; atau mengubah parameter lalu mencoba ulang berulang kali hingga melewati batas putaran.
Langkah 5: Beri skor sesuai daftar periksa dan tinggalkan jejak
Setelah setiap eksekusi selesai, lakukan penilaian per item secara terprogram, sebisa mungkin tanpa mengandalkan penilaian subjektif manusia. Manusia hanya bertugas meninjau ulang sampel yang ditandai sebagai anomali oleh program.
Perbedaan protokol pemanggilan alat multi-putaran: format OpenAI dan Anthropic
Agar satu pengujian yang sama dapat berjalan di kedua format antarmuka, kita perlu memahami perbedaan detail protokolnya terlebih dahulu. Perbedaan kecil dalam protokol pun bisa menyebabkan masalah seperti “curl berhasil, tetapi klien gagal”. Disarankan untuk terlebih dahulu memastikan protokol benar menggunakan permintaan minimal, baru kemudian mulai membandingkan kemampuan model.
| Tahap | Format kompatibel OpenAI | Format kompatibel Anthropic |
|---|---|---|
| Definisi alat | Array tools, setiap item bertipe function, parameter ditulis di parameters | Array tools, Skema parameter ditulis di input_schema |
| Model memulai pemanggilan | tool_calls dalam pesan assistant, masing-masing dengan id | tool_use dalam blok konten assistant, masing-masing dengan id |
| Bentuk parameter | arguments biasanya berupa string JSON, perlu diuraikan sendiri | input langsung berupa objek JSON |
| Pengembalian hasil | Pesan dengan role tool, membawa tool_call_id | Blok konten tool_result dalam pesan user, membawa tool_use_id |
| Penandaan kesalahan | Umumnya field kesalahan kustom di dalam konten hasil | tool_result mendukung penanda is_error |
| Pemanggilan paralel | Satu respons mungkin berisi beberapa tool_calls | Satu respons mungkin berisi beberapa blok tool_use |
Ada beberapa jebakan yang paling sering terjadi. Pertama, dalam format OpenAI, arguments adalah string, dan sebagian model kadang menghasilkan karakter berlebih yang menyebabkan kegagalan penguraian. Hal ini sendiri seharusnya sudah masuk dalam penilaian, bukan ditangani dengan toleransi kesalahan di dalam kode. Kedua, saat mengembalikan hasil, ID harus berkorespondensi satu-satu dengan ID pemanggilan yang dimulai, terutama saat pemanggilan paralel, urutannya harus diperhatikan. Ketiga, sebagian model akan mengeluarkan teks sekaligus memulai pemanggilan alat dalam satu balasan yang sama, sehingga logika pemrosesan harus kompatibel dengan kedua jenis konten tersebut.
💡 Saran teknis: Melalui pintu masuk terpadu APIYI apiyi.com, Anda dapat menggunakan kunci yang sama untuk menjalankan rangkaian pengujian yang sama melalui format OpenAI dan format Anthropic secara terpisah. Dengan begitu, Anda dapat membedakan apakah masalahnya berasal dari model itu sendiri atau dari lapisan adaptasi protokol.
Daftar Periksa Penilaian Pemanggilan Tool Multi-Putaran dan Templat Pencatatan
Daftar periksa adalah kunci agar kesimpulan bisa direproduksi. Setiap item harus bisa dinilai secara terprogram dan berkaitan dengan risiko bisnis nyata. Tabel berikut adalah item pemeriksaan yang disarankan; Anda bisa menambah atau mengurangi sesuai kebutuhan bisnis.
| Item pemeriksaan | Cara penilaian | Risiko bisnis yang terkait |
|---|---|---|
| Pemilihan tool benar | Panggilan putaran pertama menggunakan get_order, tidak memanggil tool pengganggu | Panggilan berlebih menambah latensi dan biaya |
| Parameter lolos validasi | Parameter memenuhi Schema, termasuk tipe, wajib isi, dan format | Parameter salah akan masuk ke sistem nyata |
| ID panggilan cocok dengan benar | Hasil yang dikembalikan memiliki ID yang sama dengan panggilan yang diajukan | Konteks multi-putaran menjadi kacau |
| Perilaku percobaan ulang wajar | Setelah menerima error yang bisa dicoba ulang, coba lagi dengan parameter sama dan tidak melewati batas | Menyerah terlalu cepat atau mencoba ulang tanpa batas |
| Tidak ada data yang dikarang | Semua field dalam jawaban akhir dapat ditemukan di nilai kembalian tool | Halusinasi langsung memengaruhi pengguna |
| JSON final valid | Lolos validasi JSON Schema, tanpa teks berlebih | Parsing di hilir gagal |
| Jumlah putaran dan penggunaan Token | Catat total putaran, Token input, dan Token output | Menilai biaya dan latensi |
Setelah setiap model dijalankan dengan jumlah tetap, rangkum menjadi satu tabel hasil. Kolom yang disarankan meliputi: ID model, format API, nomor eksekusi, jumlah item lulus, rincian item gagal, total putaran, Token input, Token output, durasi, dan tanggal pengujian. Simpan header tabel bersama file konfigurasi di repositori versi. Saat model ditingkatkan atau diganti ke versi baru, jalankan ulang dengan skrip yang sama untuk melakukan perbandingan regresi.
Bagaimana mencatat dasar biaya pemanggilan tool multi-putaran
Penggunaan Token harus dicatat per putaran, bukan hanya melihat putaran terakhir. Dalam loop multi-putaran, setiap putaran mengirim ulang pesan dan hasil tool sebelumnya sebagai input, sehingga Token input terakumulasi dari putaran ke putaran. Semakin banyak percobaan ulang, semakin tinggi biaya. Itulah sebabnya item “perilaku percobaan ulang wajar” layak dinilai secara terpisah.
Saat menghitung biaya, kalikan Token input dan output dari usage (jika ada cache hit, juga Token cache) dengan harga satuan masing-masing. Semua harga satuan input, harga satuan output, harga cache, dan dasar penagihan model mengikuti data aktual di halaman harga APIYI docs.apiyi.com/models. Artikel ini tidak mencantumkan angka spesifik karena harga bisa berubah dan mudah kedaluwarsa jika ditulis mati di artikel.
Satu kunci API menguji banyak model: daftar model kandidat
Model kandidat sebaiknya mencakup berbagai vendor dan berbagai posisi, misalnya satu model dengan rasio harga-kinerja tinggi, satu model utama, dan satu model dengan kemampuan penalaran lebih kuat. Tabel berikut hanya mencantumkan seri model dan fokus pengujian, tanpa memberikan kesimpulan; kesimpulan harus berasal dari data hasil pengujian Anda sendiri.
| Seri model | Fokus pengujian yang disarankan | Format antarmuka yang disarankan | Platform yang tersedia |
|---|---|---|---|
| Seri DeepSeek | stabilitas parsing string parameter, percobaan ulang setelah injeksi gagal | Kompatibel OpenAI | APIYI apiyi.com, API resmi |
| Seri Gemini | kecenderungan panggilan paralel, apakah JSON final menyertakan teks tambahan | Kompatibel OpenAI | APIYI apiyi.com, API resmi |
| Seri Qwen | kesalahan pemanggilan alat pengganggu, kecocokan ID multi-putaran | Kompatibel OpenAI | APIYI apiyi.com, API resmi |
| Seri Claude | penanganan is_error pada tool_result, kontrol jumlah putaran | Kompatibel Anthropic | APIYI apiyi.com, API resmi |
| Seri GPT | kepatuhan ketat terhadap Schema, penggunaan Token | Kompatibel OpenAI | APIYI apiyi.com, API resmi |
ID dan versi model yang tersedia secara spesifik mengacu pada daftar model APIYI. Saat mencatat hasil, pastikan untuk menulis ID model lengkap, jangan hanya menulis nama seri. Versi berbeda dalam seri yang sama bisa memiliki performa yang sangat berbeda dalam pemanggilan alat.
💡 Saran pemilihan: Pilihan model bergantung pada kompleksitas alat Anda, toleransi terhadap halusinasi, dan anggaran biaya. Sebaiknya di APIYI apiyi.com gunakan kunci yang sama untuk menjalankan satu putaran pada masing-masing model kandidat, lalu padukan dengan data harga di docs.apiyi.com/models untuk melakukan penilaian menyeluruh.
Pertanyaan Umum (FAQ)
Q1: Apa itu tes kecil pemanggilan alat multi-putaran?
Ini adalah tes berskala kecil dengan hasil yang deterministik. Dengan 2 sampai 3 alat Mock dan satu kegagalan yang disuntikkan, model diminta menjalankan satu putaran penuh “memanggil alat, memproses hasil, mencoba ulang, mengeluarkan jawaban terstruktur”, lalu program menilai satu per satu apakah lulus. Fokusnya adalah apakah loop dapat berjalan stabil sampai selesai, bukan tingkat pengetahuan model.
Q2: Mengapa ditekankan satu kunci untuk menguji beberapa model?
Untuk mengendalikan variabel. Kunci, SDK, dan alamat proksi yang berbeda akan membawa perbedaan pada autentikasi, timeout, dan adaptasi protokol, sehingga hasil perbandingan menjadi tidak akurat. Setelah menggunakan satu pintu masuk yang sama, satu-satunya yang berubah hanyalah kolom model, sehingga perbedaan yang terukur dapat diatribusikan ke model itu sendiri.
Q3: Apakah temperature disetel ke 0 menjamin hasil yang sepenuhnya dapat direproduksi?
Tidak sepenuhnya terjamin. Bahkan dengan temperature 0, output sebagian model masih berfluktuasi ringan, dan model penalaran mungkin tidak mendukung penurunan parameter tersebut. Karena itu, tes harus dijalankan beberapa kali secara tetap, melihat tingkat kelulusan dan distribusi kegagalan, bukan hanya hasil dari satu kali percobaan. Nilai parameter yang benar-benar dipakai juga harus dicatat.
Q4: Skenario apa saja yang cocok untuk tes ini?
– **Pemilihan Agent**: membandingkan stabilitas model kandidat pada loop alat sebelum peluncuran.
– **Regresi peningkatan model**: setelah versi baru dirilis, menjalankan ulang dengan skrip yang sama untuk memastikan tidak ada kemunduran.
– **Verifikasi migrasi protokol**: saat beralih dari format OpenAI ke format Anthropic, memastikan lapisan adaptasi tidak bermasalah.
Q5: Bagaimana cara cepat mulai memanggil model-model ini?
1. Kunjungi APIYI apiyi.com untuk mendaftar akun dan mendapatkan kunci.
2. Baca docs.apiyi.com untuk memastikan alamat kompatibel OpenAI dan alamat kompatibel Anthropic.
3. Konfigurasikan sesuai tabel parameter pada langkah 1 artikel ini, mulai dengan permintaan minimal untuk memastikan setiap model dapat mengembalikan pemanggilan alat.
APIYI mendukung akses terpadu untuk beberapa model yang disebutkan dalam artikel ini, mengganti model cukup dengan mengubah kolom model.
Q6: Bagaimana cara memperkirakan biaya tes?
Biaya kira-kira sama dengan “jumlah model × jumlah eksekusi × token kumulatif per eksekusi × harga satuan”. Token input pada loop multi-putaran akan terakumulasi setiap putaran, dan percobaan ulang akan menambah penggunaan lebih lanjut. Harga satuan dan aturan penagihan cache mengacu pada data aktual di halaman harga APIYI docs.apiyi.com/models. Disarankan menjalankan 1 kali per model terlebih dahulu untuk memperkirakan penggunaan, lalu menentukan jumlah eksekusi resmi.
Q7: Apa keterbatasan tes ini?
Tes kecil hanya dapat mencakup pola kegagalan yang tipikal, tidak dapat mewakili semua bisnis yang kompleks. Data yang dikembalikan oleh alat Mock sangat bersih, sedangkan sistem nyata mungkin mengembalikan data dengan format berantakan atau sangat panjang. Setelah tes lulus, disarankan menambahkan sampel anomali yang benar-benar muncul di bisnis, lalu memperluas kasus uji secara bertahap.
Poin-Poin Penting Uji Kecil Pemanggilan Alat Multi-Giliran
- Prioritaskan variabel kontrol: Gunakan satu kunci dan satu set konfigurasi, hanya ubah bidang model.
- Alat bersifat read-only dan deterministik: Nilai kembalian Mock di-hardcode agar setiap kali dijalankan menghasilkan data yang sama.
- Wajib menyuntikkan kegagalan: Satu error yang dapat dicoba ulang paling bisa membedakan kemampuan penanganan loop pada model.
- Penilaian terprogram: Setiap item pemeriksaan dapat ditentukan secara otomatis; manusia hanya bertugas memeriksa ulang anomali.
- Jejak lengkap: Simpan respons mentah, usage setiap putaran, dan ID model lengkap agar memudahkan regresi.
- Harga mengacu pada halaman resmi: Perhitungan biaya mengacu pada halaman harga APIYI di docs.apiyi.com/models.
- Pintu masuk terpadu lebih praktis: Dengan APIYI yang kompatibel dengan format OpenAI dan Anthropic, satu set skrip dapat mencakup dua protokol.
Kesimpulan
Uji kecil pemanggilan alat multi-giliran untuk menguji beberapa model dengan satu kunci, intinya ada tiga poin:
- Dapat direproduksi: Konfigurasi tetap, data Mock tetap, versi petunjuk tetap, lalu jalankan berkali-kali.
- Dapat ditentukan: Gunakan validasi Schema dan daftar periksa penilaian sebagai pengganti kesan subjektif.
- Dapat diregresi: Jejak lengkap, sehingga setelah model di-upgrade dapat menguji ulang dengan cepat memakai skrip yang sama.
Metode ini tidak akan memberi tahu Anda “model mana yang terbaik”, tetapi dapat memberi tahu Anda dalam rantai alat Anda, model mana yang lebih stabil, lebih hemat Token, dan perilaku saat gagal juga lebih terkendali. Disarankan untuk menjalankan alur terlebih dahulu dengan skenario query pesanan dalam artikel ini, lalu menggantinya dengan alat di bisnis Anda sendiri.
Direkomendasikan untuk melakukan verifikasi silang multi-model melalui APIYI apiyi.com dengan kunci yang sama. Cara integrasi lihat docs.apiyi.com, sedangkan harga dan dasar penagihan mengacu pada docs.apiyi.com/models.
📚 Referensi
- Dokumentasi pemanggilan fungsi OpenAI: penjelasan protokol untuk
tools,tool_calls, dan pesan dengan perantool - Tautan:
platform.openai.com/docs/guides/function-calling -
Keterangan: memahami cara penanganan string parameter dan
tool_call_iddalam format yang kompatibel dengan OpenAI -
Dokumentasi penggunaan tool Anthropic: penjelasan blok konten
tool_usedantool_result - Tautan:
docs.anthropic.com/en/docs/build-with-claude/tool-use -
Keterangan: memahami penggunaan
input_schema,tool_use_id, danis_error -
Pusat dokumentasi APIYI: penjelasan akses antarmuka terpadu
- Tautan:
docs.apiyi.com -
Keterangan: lihat alamat kompatibel OpenAI dan Anthropic beserta contoh pemanggilannya
-
Halaman model dan harga APIYI: daftar model dan dasar penagihan
- Tautan:
docs.apiyi.com/models - Keterangan: semua harga satuan input, output, dan cache mengacu pada data aktual di halaman ini
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui beranda situs APIYI apiyi.com. Materi akses lainnya dapat dilihat di pusat dokumentasi docs.apiyi.com