作者注:比较模型成本时,只看每百万 token 单价很容易选错。本文给出「单价 × 实际 token 消耗」的测算框架,以及用自己的任务做小样本复测的完整步骤。
很多团队选模型时会先打开价格页,看到 A 模型每百万 token 只要几毛钱,B 模型要好几美元,就认定 A 更省钱。但月底账单经常和预期对不上,有时“便宜”的模型反而花得更多。本文介绍 「单价 × 实际 token 消耗 + 缓存折算」的真实成本测算法,帮助你在选型阶段就算清楚账。
这不是又一篇价格表汇总。价格表会过时,测算方法不会。我们会把公开测算中的个案现象抽象成通用框架,再落到你自己的任务上复测。
核心价值:读完本文,你将能够解释“标价便宜不等于账单便宜”的原因,并用 20 到 50 条真实请求测出每个候选模型的单任务成本。
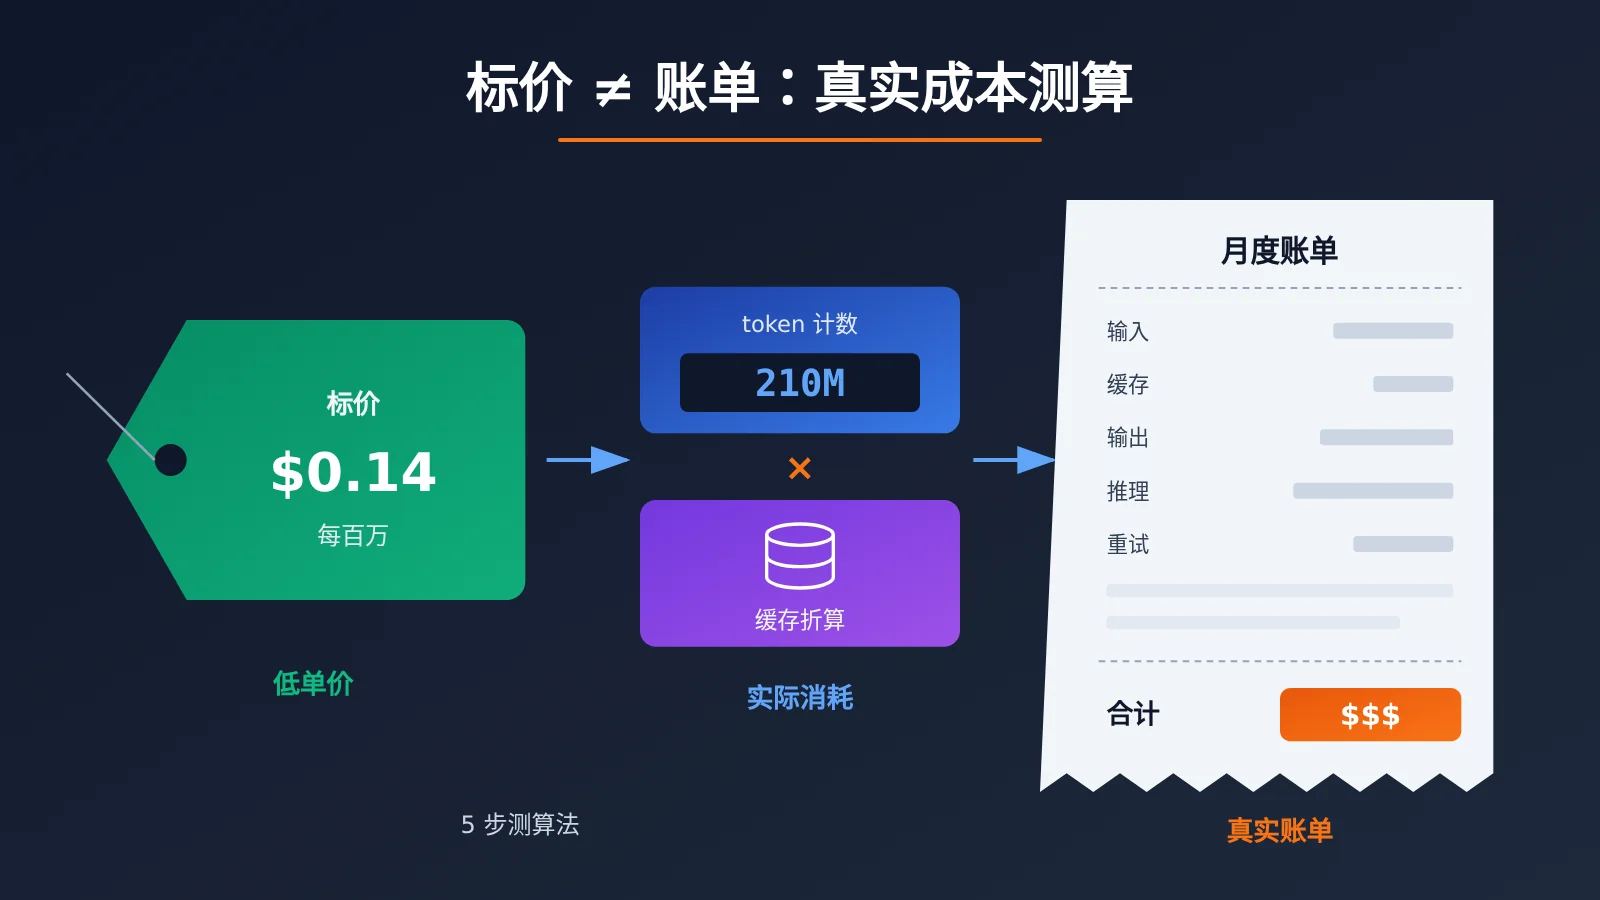
模型真实成本核心要点
| 要点 | 说明 | 对选型的影响 |
|---|---|---|
| 单价只是乘数之一 | 账单 = 各类 token 数量 × 各自单价,再求和 | 只比单价,相当于只比较了一半公式 |
| 分词差异 | 同一段文本在不同模型中被切成的 token 数不同 | 输入成本需要按各模型实际计数折算 |
| 推理 token | 推理型模型的思考过程通常按输出计费,用户看不到 | 可见回答很短,账单却可能很高 |
| 缓存命中 | 重复的前缀命中缓存后,按更低的缓存价计费 | 长系统提示词、多轮对话场景差异显著 |
| 成功率与重试 | 答错或格式不合格需要重跑 | 有效成本 = 单次成本 ÷ 成功率 |
为什么只看每百万 token 单价会算错真实成本
每百万 token 单价衡量的是“每个 token 多少钱”,但账单衡量的是“完成一件事多少钱”。两者之间隔着一个关键变量:完成这件事需要多少 token。不同模型在这个变量上的差距,常常比单价差距还大。
一个典型现象来自第三方博客 2026 年 8 月 1 日的测算:DeepSeek V4 Flash 和 Gemini 3.6 Flash 在 Artificial Analysis 上得分相同,都是 50 分。前者标价 $0.14/M,后者 $1.50/M,单价相差约 10 倍。但在同一套评测中,前者消耗约 2.1 亿 token,后者约 5900 万,消耗量相差 3 倍以上。单价优势被消耗量吃掉了一大部分,实际差距远没有 10 倍。
另一个现象是分词差异。同一来源 2026 年 8 月 12 日的文章把一份完全相同的文档分别交给 9 个模型计数,结果从 614 到 957 个 token 不等,最大和最小之间相差约 56%。也就是说,即使两个模型的输入单价完全一样,同一份提示词的输入费用也可能差一半以上。
💡 数据说明:以上数字来自第三方博客的单次测算,评测任务、模型版本和价格都有时效性,只能作为“现象存在”的证据,不能直接用于你的预算。你自己的任务需要自己复测。
模型账单构成:真实成本由哪几类 token 组成
要把成本算准,先得知道账单上到底有几个计费项。大多数厂商的计费可以拆成下表几类,具体名称和是否单独计费以各家官方文档为准。
| 计费项 | 含义 | 常见计价方式 | 容易忽略的点 |
|---|---|---|---|
| 未命中缓存的输入 | 本次新发送、没有命中缓存的提示词 | 输入单价 | 受分词器影响,同文不同价 |
| 缓存命中的输入 | 与之前请求相同的前缀部分 | 缓存读取价,通常远低于输入单价 | 前缀必须完全一致才能命中 |
| 缓存写入 | 部分厂商对首次写入缓存单独收费 | 可能高于普通输入价 | 命中率低时反而更贵 |
| 可见输出 | 用户最终看到的回答 | 输出单价 | 输出单价通常是输入的数倍 |
| 推理 token | 模型内部思考过程 | 一般按输出单价计 | 不显示在回答里,但计入账单 |
把这几项写成一个公式,就是本文的核心测算框架:
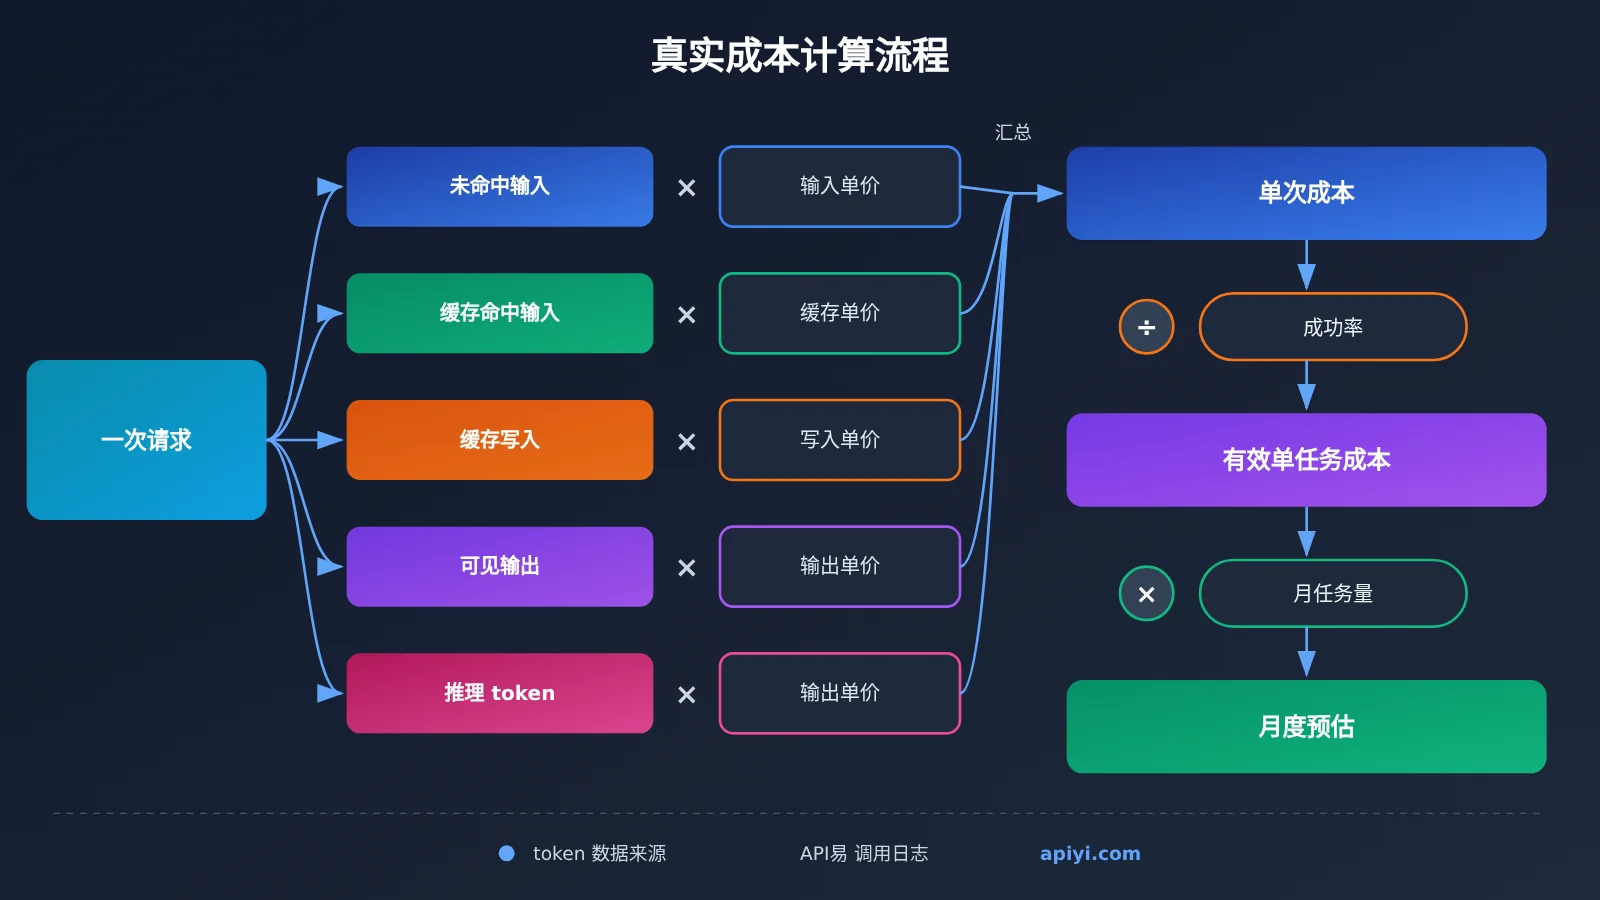
- 单次请求成本 = 未命中输入 token × 输入单价 + 缓存命中 token × 缓存单价 + 缓存写入 token × 写入单价 + (可见输出 + 推理 token)× 输出单价
- 有效单任务成本 = 单次请求成本 × 平均调用次数 ÷ 任务成功率
- 月度预估 = 有效单任务成本 × 月任务量
缓存这一项的影响往往被低估。同一来源 2026 年 8 月 6 日的文章提到,DeepSeek V4 Flash 的缓存命中价格比未命中便宜约 50 倍,而不同托管方的缓存价格之间差距可达 28 倍。这说明“同一个模型、走不同渠道”的账单也可能完全不同,缓存价格必须按你实际使用的渠道核实。
推理 token 对真实成本的放大效应
推理型模型是“标价便宜、账单昂贵”最常见的来源。用户只问了一句话,模型回答了 200 字,但它在内部可能先思考了几千个 token。这部分通常按输出单价计费,而输出单价本就比输入高出数倍。
第三方的公开测算也反映了这一点。一篇 2026 年 8 月 4 日的文章称,Qwen 3.8 Max 在 Artificial Analysis 上比 DeepSeek V4 Flash 高 3 分,但在其实测的 3 个任务上成本高出约 345 倍,速度慢约 6 倍。另一篇同系列文章在相同评测方法下给出:Kimi K3 得 57 分花费 $2,437,DeepSeek V4 Flash 得 50 分花费 $72,Qwen 3.7 Max 得 46 分却花费 $1,604。分数更低、花费更高的情况确实存在,原因往往就在 token 消耗量上。
同一家厂商的不同版本之间也会出现差异。有文章指出,Claude Opus 4.5 到 4.8 与 Opus 5 标价相同,都是 $5/$25,但实测存在约 1.30 倍的 token 消耗差距。价格不变,账单却可能变了 30%,这在升级模型版本时很容易被忽略。
用 token 消耗量估算真实成本:5 步快速上手
下面是一套不需要写复杂脚本也能执行的小样本测算流程。核心原则只有一条:同一任务、同一输入,分别统计输入、输出、缓存和推理 token。
第 1 步:准备有代表性的任务样本
从生产环境或真实需求中挑选 20 到 50 条请求,覆盖短问答、长文档、多轮对话等主要类型。样本要保留完整的系统提示词和上下文,因为缓存命中主要发生在这些重复前缀上。不要只用一句“你好”去测,那样测不出分词差异和缓存效果。
第 2 步:固定变量,分别调用候选模型
对每个候选模型使用相同的系统提示词、相同的用户输入、相同的 max_tokens 和温度设置。推理型模型如果支持推理强度参数,需要记录本次使用的档位,因为档位不同,推理 token 可能相差很多。
在这一步,统一入口能省掉不少麻烦。通过 API易 apiyi.com 这类聚合平台,可以用同一个 API Key 和同一套 OpenAI 兼容调用方式切换不同厂商的模型,只改模型名就能跑完整组对比,不用为每家分别开户、充值和适配 SDK。
第 3 步:逐条记录各类 token
每次调用后,从响应的 usage 字段中读取 token 数。以 OpenAI 兼容格式为例,常见字段包括:
usage.prompt_tokens:输入 token 总数usage.prompt_tokens_details.cached_tokens:其中命中缓存的部分usage.completion_tokens:输出 token 总数usage.completion_tokens_details.reasoning_tokens:其中的推理 token
不同厂商的字段名并不统一,例如 Anthropic 格式使用 cache_read_input_tokens 和 cache_creation_input_tokens 区分缓存读取与写入,具体以各家文档为准。
如果不想自己解析响应,也可以直接看平台侧的记录。API易 提供每次调用的日志和用量统计,适合把同一批样本在不同模型上的消耗放在一起对比。需要注意的是,日志中是否单独列出缓存 token 和推理 token、缓存命中是否单独计价,请以控制台实际显示和平台计费说明为准,测算前先确认这一点。
🚀 快速开始:建议先在 API易 apiyi.com 上用 20 条样本跑一轮小规模对比,确认各模型的 token 消耗量级,再决定是否扩大样本。统一余额计费的好处是,多模型测试的花费集中在一个账户里,测完对账也更直观。
第 4 步:按测算模板汇总
把记录结果填进下面这张模板,每个模型一行。单价一栏务必注明查询日期和来源。
| 字段 | 填写说明 | 数据来源 |
|---|---|---|
| 模型与版本 | 写明具体版本号或日期后缀 | 调用参数 |
| 单价及查询日期 | 输入、输出、缓存读取、缓存写入各一列 | 官方定价页或所用平台的价格页 |
| 平均未命中输入 token | 样本均值 | 响应 usage 或平台日志 |
| 平均缓存命中 token | 样本均值,并计算命中率 | 响应 usage 或平台日志(如 API易 用量统计) |
| 平均可见输出 token | 输出总数减去推理部分 | 响应 usage |
| 平均推理 token | 推理型模型单独记录 | 响应 usage |
| 任务成功率 | 人工或规则判定合格比例 | 评审记录 |
| 有效单任务成本 | 按前文公式计算 | 汇总计算 |
第 5 步:用有效单任务成本做决策
最后比较的不是单价,而是“有效单任务成本”。下面用一组示意价格演示计算过程,数字是为说明方法虚构的,不代表任何模型的真实报价。
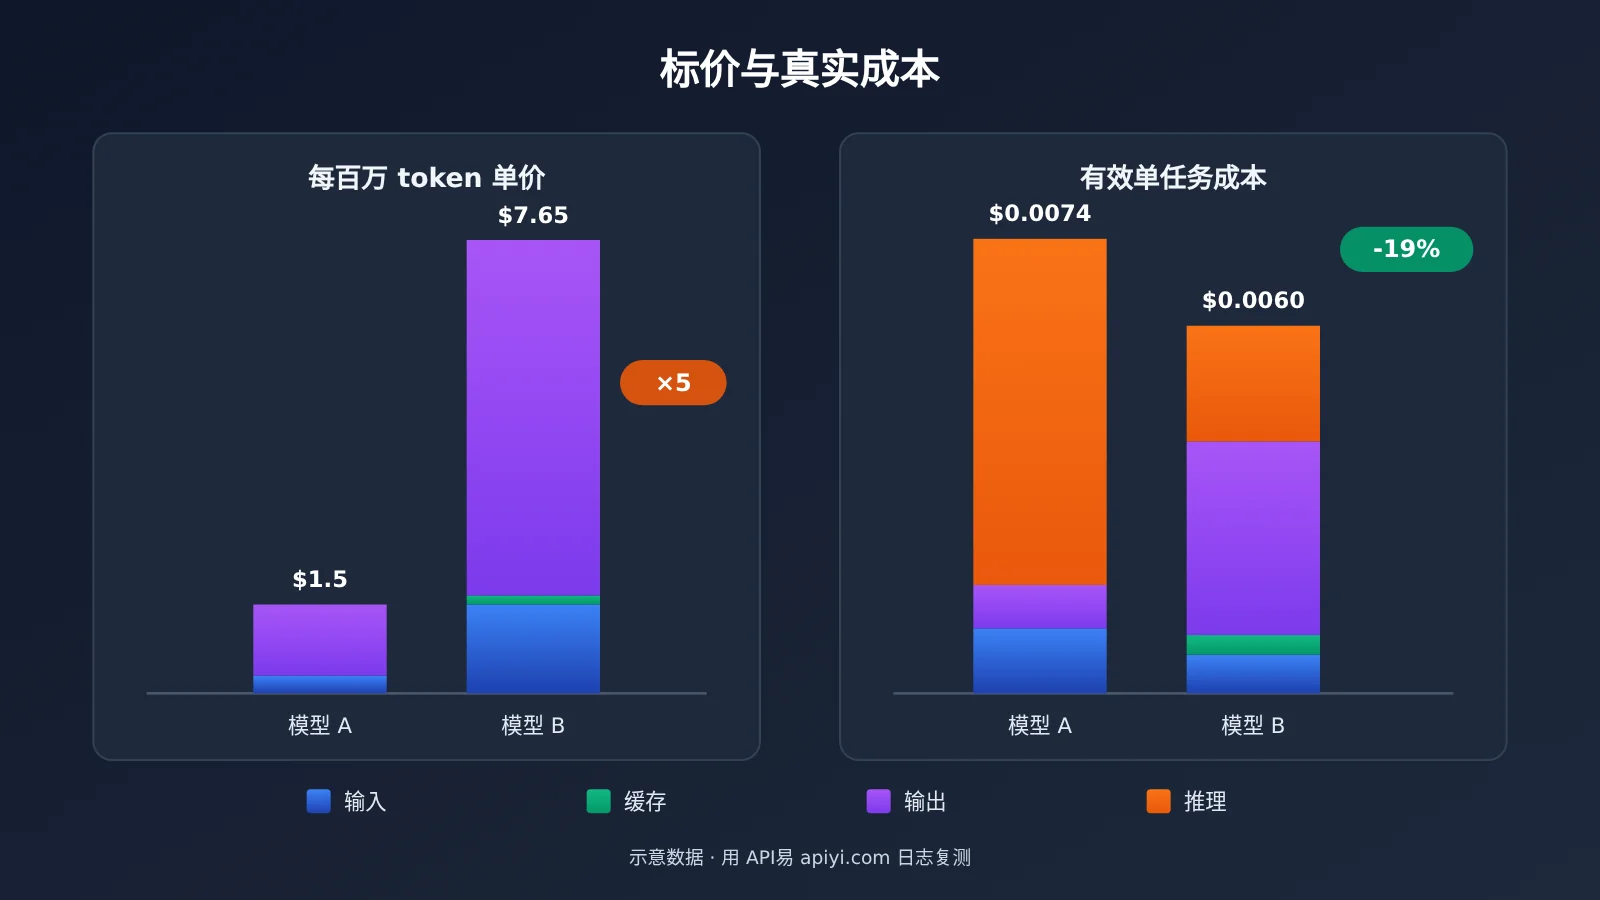
假设模型 A 标价输入 $0.3/M、输出 $1.2/M;模型 B 标价输入 $1.5/M、输出 $6/M、缓存读取 $0.15/M,单价是 A 的 5 倍。
| 计算项 | 模型 A(低标价) | 模型 B(高标价) |
|---|---|---|
| 未命中输入 token | 3,000 | 400 |
| 缓存命中 token | 0 | 2,000 |
| 可见输出 + 推理 token | 500 + 4,000 | 500 + 300 |
| 输入费用 | $0.0009 | $0.0006 + $0.0003 |
| 输出费用 | $0.0054 | $0.0048 |
| 单次请求成本 | $0.0063 | $0.0057 |
| 任务成功率 | 85% | 95% |
| 有效单任务成本 | 约 $0.0074 | 约 $0.0060 |
在这个示意场景中,模型 B 的分词更紧凑,输入总量少了 600 token;它的长系统提示词大部分命中了缓存;推理过程也短得多。最终,标价贵 5 倍的 B,有效成本反而比 A 低约 19%。现实中结论可能相反,这正是必须用自己的任务复测的原因。
测算真实成本时的注意事项
测算框架本身不复杂,但有几个坑会让结果失真,执行前值得逐条检查:
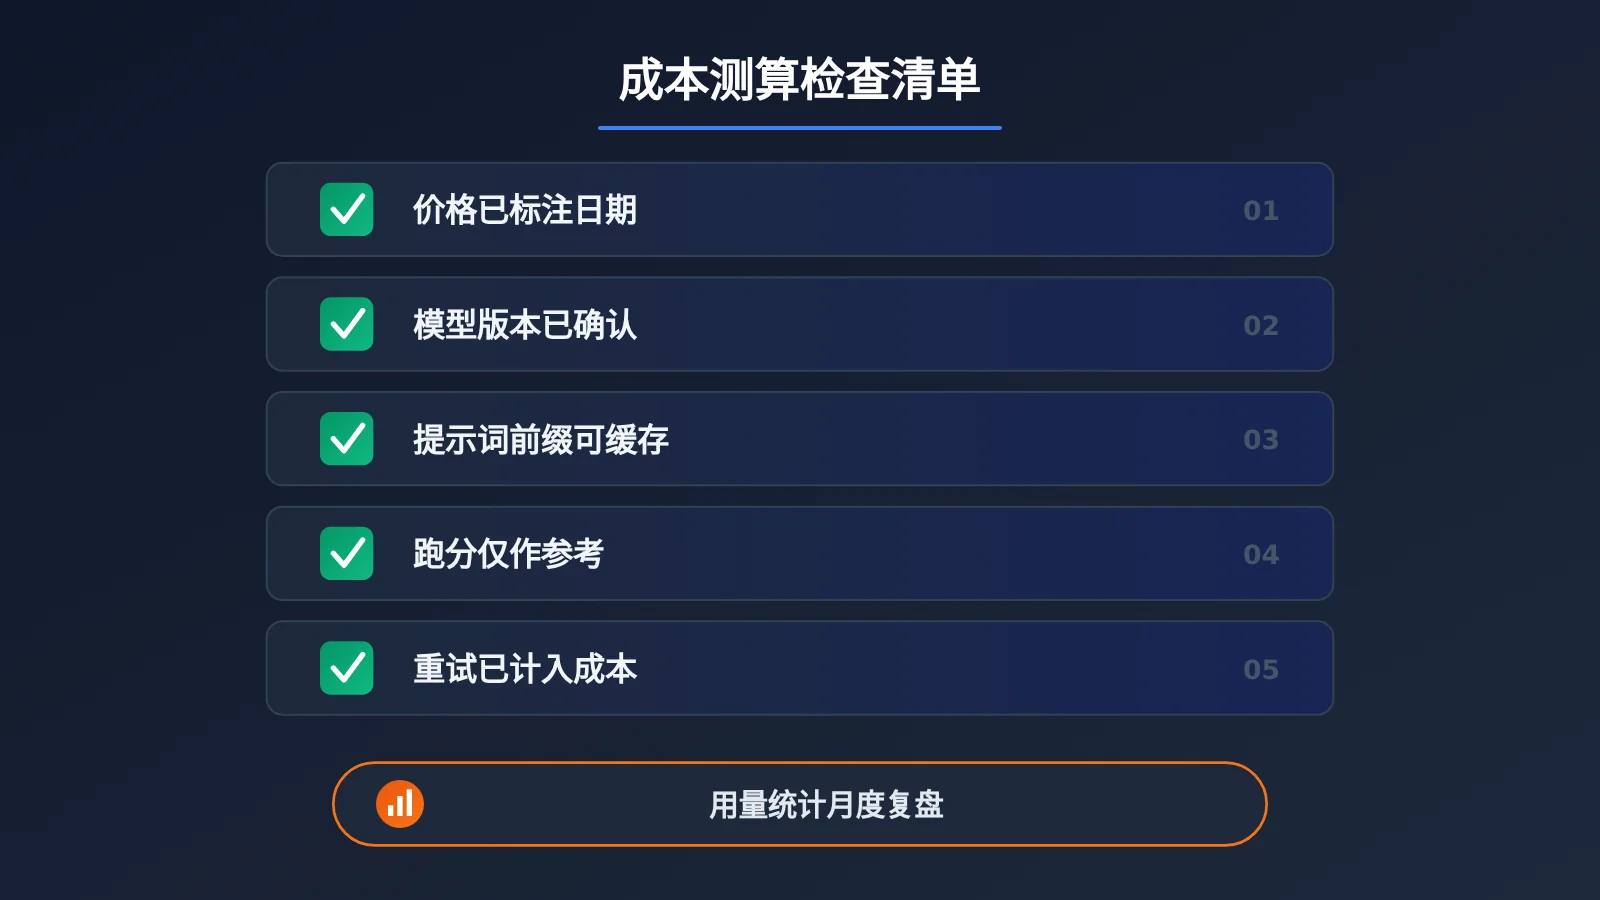
- 价格必须标注日期:模型价格调整频繁,参考资料中就提到 DeepSeek V4 Pro 0813 从 2026 年 8 月 16 日起实行高峰与非高峰分时定价。同一模型在不同时段、不同渠道的价格都可能不同。
- 注意模型别名指向的版本:有文章提到,某个看起来“最常用”的模型名实际调用的是旧版本。测算时记录响应中返回的模型标识,避免测 A 版本、上线 B 版本。
- 缓存命中依赖前缀一致:把动态内容(时间戳、用户 ID)放在提示词开头,会导致每次前缀都不同,缓存几乎无法命中。测算时要用和生产一致的提示词结构。
- 第三方跑分只作参考:Artificial Analysis 一类的综合分数,以及按任务计算的成本,反映的是评测机构的任务分布,不等于你的业务场景。
- 把重试算进去:429 限流、格式错误、答案不合格导致的重跑都会产生费用,成功率要基于实际判定结果计算。
💰 成本优化建议:测算完成后,可以把“有效单任务成本”作为选型的主指标,把跑分和延迟作为约束条件。在 API易 apiyi.com 上切换模型只需修改模型名,便于在测算结论变化时快速调整线上配置,同时继续用调用日志监控实际消耗。
常见问题 FAQ
Q1:什么是模型的“真实成本”?
真实成本是完成一个具体任务实际支付的费用,而不是每百万 token 的标价。它等于各类 token(未命中输入、缓存命中、缓存写入、可见输出、推理)的实际数量分别乘以对应单价,再考虑成功率和重试后得到的有效单任务成本。
Q2:为什么同一份文档在不同模型里 token 数不一样?
因为每个模型使用的分词器不同,对中文、代码、标点的切分粒度不同。公开测算中,同一份文档在 9 个模型中被计为 614 到 957 个 token。所以输入成本必须按各模型自己报告的 token 数计算,不能用一个模型的计数套到其他模型上。
Q3:推理 token 一定要算进成本吗?
要算。多数厂商把推理 token 计入输出并按输出单价收费,它不会出现在回答正文里,却可能占输出的大部分。测算推理型模型时,建议单独记录 `reasoning_tokens`,并在相同推理强度档位下对比。
Q4:缓存命中能省多少钱?
取决于厂商的缓存定价和你的命中率。参考资料中提到 DeepSeek V4 Flash 缓存命中价约为未命中的 1/50,但不同托管方的缓存价格差距可达 28 倍。长系统提示词、固定知识库前缀、多轮对话等场景收益最大,具体数值请以所用渠道的价格说明为准。
Q5:如何快速对多个模型做小样本成本测算?
推荐使用支持多模型统一接入的平台来做:
1. 在 API易 apiyi.com 注册并获取 API Key
2. 准备 20 到 50 条真实任务样本,固定提示词和参数
3. 逐个切换模型名调用,用调用日志和用量统计汇总各类 token
4. 按本文模板计算有效单任务成本
这样可以在一个账户、一套调用方式下完成全部对比,减少多家开户和对账的成本。
Q6:第三方博客给出的“每任务成本”能直接用吗?
不建议直接用于预算。这类数据适合用来发现“可能存在 token 消耗差异”的模型组合,帮你缩小候选范围。但评测任务、模型版本、价格和缓存条件都和你的业务不同,最终数字需要用自己的样本复测。
Q7:这套测算方法有哪些局限?
小样本只能反映样本覆盖的任务类型,业务分布变化后需要重测。另外,部分平台的日志未必区分缓存和推理 token,此时只能从模型响应的 `usage` 字段自行采集。价格和模型版本也会变动,建议每次调价或升级后重新跑一轮。
模型真实成本测算核心要点 Key Takeaways
- 单价只是公式的一半:账单取决于单价乘以实际 token 消耗量
- 分词差异不可忽略:同一文档在不同模型中 token 数可相差 50% 以上
- 推理 token 会放大输出成本:看不见的思考过程同样按输出计费
- 缓存价格因渠道而异:命中率和缓存单价共同决定长提示词场景成本
- 以有效单任务成本做决策:把成功率和重试一并计入
- 用统一入口做复测:借助 API易 的统一接口和调用日志,同一样本跑多个模型更省事
总结
用 token 消耗量和缓存估算模型真实成本,关键在三点:
- 拆开账单:分别统计未命中输入、缓存命中、缓存写入、可见输出和推理 token,各乘对应单价。
- 用自己的任务复测:第三方跑分和价格只能作为参考,同一任务、同一输入下的实测数据才可靠。
- 比较有效单任务成本:把成功率和重试算进去,再结合月任务量做预算。
模型价格会变,新模型会不断出现,但这套测算方法可以长期复用。建议在下一次选型前,先用 20 条真实样本跑一轮对比,再决定上线哪个模型。如果需要在多个厂商的模型之间快速切换测试,可以通过 API易 apiyi.com 统一接入,用调用日志直接核对每个模型的实际消耗。
📚 参考资料
- Ofox.ai Blog 第 23 页:包含 DeepSeek V4 Flash 与 Gemini 3.6 Flash 的 token 消耗对比、缓存价格差异、Qwen 系列成本测算等文章摘要
- 链接:
ofox.ai/blog/page/23/ -
说明:文章发布于 2026 年 8 月,数据为第三方单次测算,仅作现象参考
-
Ofox.ai Blog 第 22 页:包含同一文档在 9 个模型中的 token 计数对比、Claude 版本间 token 消耗差距、DeepSeek V4 Pro 分时定价等信息
- 链接:
ofox.ai/blog/page/22/ -
说明:适合了解分词差异和版本差异的具体案例
-
Ofox.ai Blog 第 25 页:包含 Kimi K3 与 GLM-5.2、Opus 4.8 的单任务成本对比
- 链接:
ofox.ai/blog/page/25/ - 说明:价格与跑分有时效性,使用前请以各厂商官方定价页为准
作者:API易 技术团队
技术交流:欢迎在 API易 apiyi.com 网站首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心