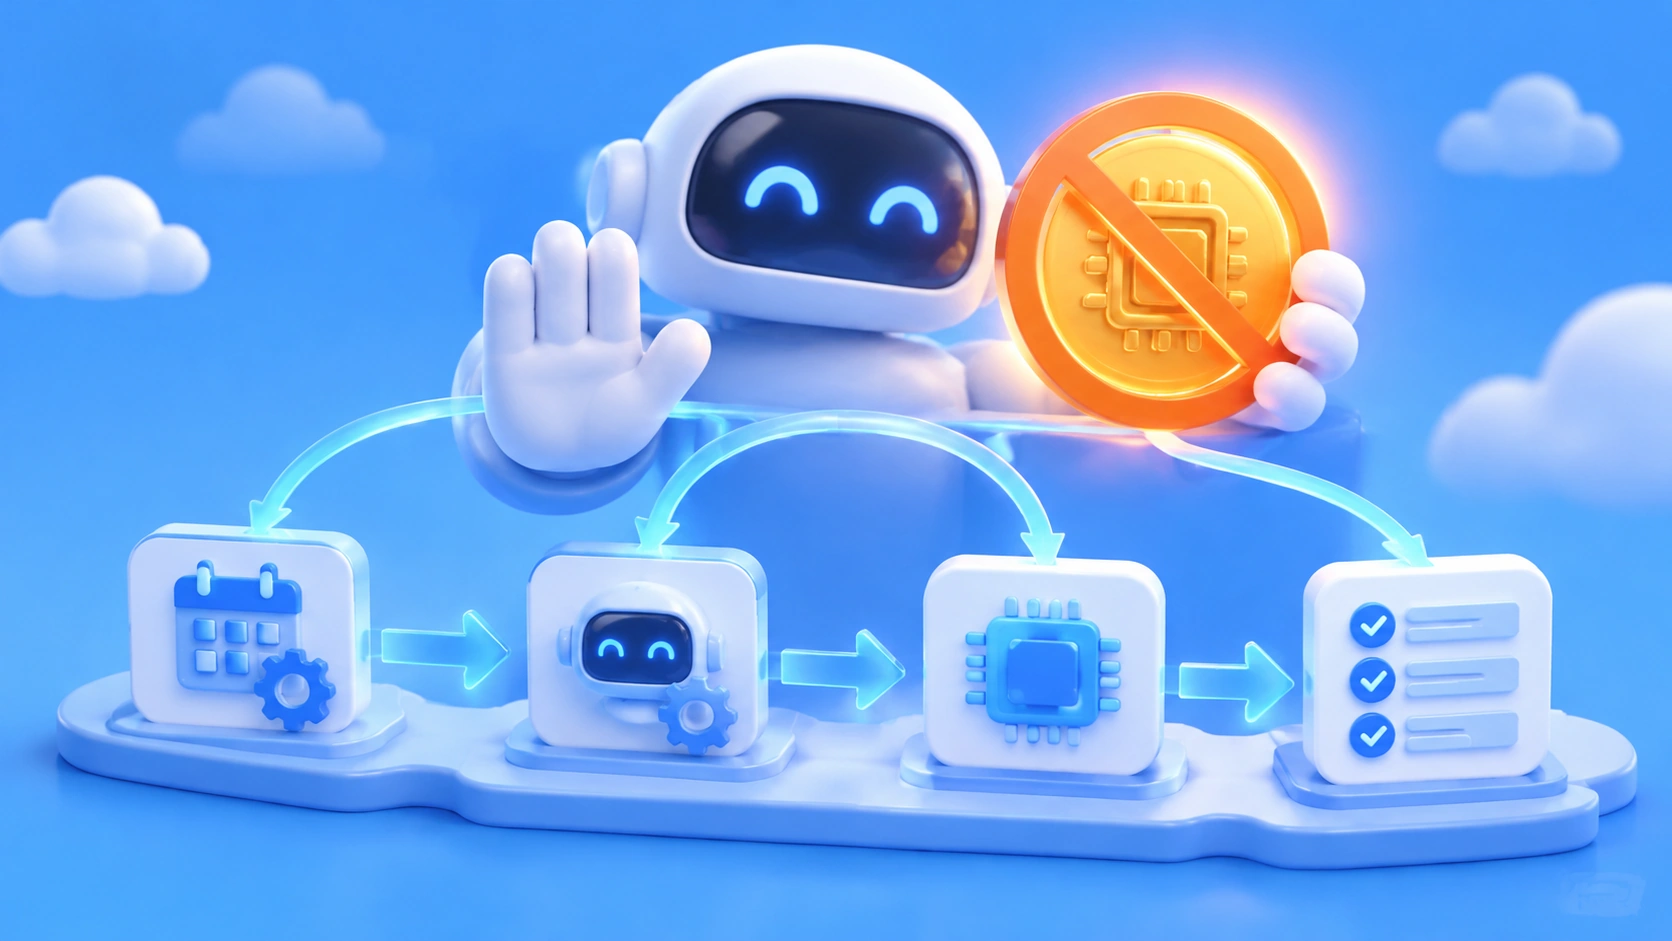
作者注:从星尘智能来杰”别打一个螺丝收我一份 token 费”的比喻出发,拆解 AI 工作流里哪些环节该交给固定程序,哪些环节才需要大模型判断。
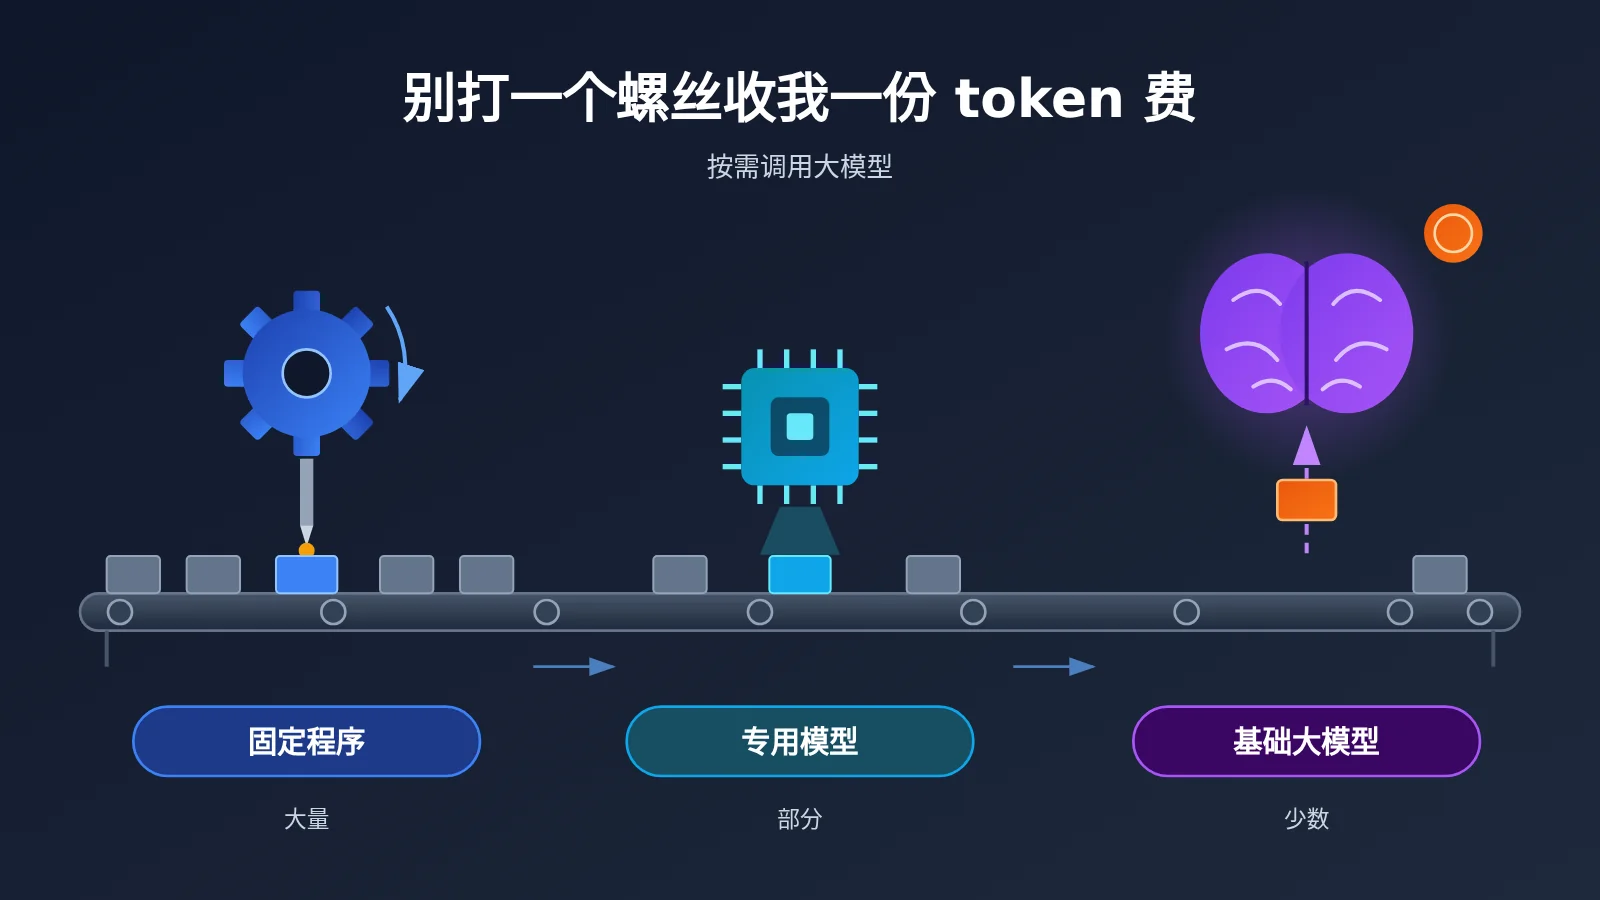
2026 年 11 月 5 日,爱范儿「多样性公司」栏目发布了对星尘智能创始人兼 CEO 来杰的专访。其中一句话被很多做 AI 应用的人反复转述:“我希望打螺丝的是固定化程序,每天 24 小时一直转,别打一个螺丝收我一份 token 费。”
这不是一句段子。来杰在专访里谈的是机器人分工:具身模型负责物理动作,遇到问题再用自然语言去问基础大模型。这套思路放到软件工作流里,恰好对应一个很实际的问题:一个 AI 应用里,到底哪些环节不该调用大模型?
核心价值:本文把专访中的机器人观点转译为软件工作流的调用边界设计,给出 5 类不该调用大模型的环节、一套分层判断标准,以及一个可直接改造的路由代码示例。需要先说明的是,机器人和软件是两类系统,下文的迁移属于类比推演,效果需要用你自己的实际用量来验证。
「别打一个螺丝收我一份 token 费」核心信息速览
这句话出自专访的最后一个问题。被问到希望机器人帮人类摆脱什么时,来杰明确表示不希望机器人”进厂打螺丝”。一方面他认为机器人的价值在于能力的广泛性,另一方面从成本看,重复劳动不值得为每一次动作支付 token 费。
| 信息项 | 详情 |
|---|---|
| 信息来源 | 爱范儿「多样性公司」栏目第 15 篇专访 |
| 发布时间 | 2026 年 11 月 5 日 |
| 受访者 | 星尘智能创始人兼 CEO 来杰,曾为腾讯 Robotics X 机器人实验室 1 号员工 |
| 核心观点 | 重复性动作应交给固定化程序,不应每次都付 token 费 |
| 分工思路 | 具身模型负责物理执行,遇到问题再用自然语言询问基础大模型 |
| 对软件的启发 | AI 工作流需要划分固定程序、专用模型、基础大模型的调用边界 |
需要强调的是,专访内容是创始人观点,文中没有给出成本实测或第三方验证数据。我们借用的是它的分工逻辑,而不是任何具体结论。
来杰的”打视频问妈妈”比喻:大模型只补上下文
专访里有一个比”打螺丝”更能说明分工的比喻。来杰说,自己不会做饭但想做,就给妈妈打视频电话,妈妈会说”先在热锅里放点油”,但不用说哪瓶是油;有疑问时再追问。关键在于:妈妈负责补充上下文知识,但放油这个动作必须自己会,因为妈妈在电话那头没法替你放油。
对应到机器人上,具身模型要自己感知重量、捏握力度、有没有抓稳这些物理参数,只在”捏不住有点不稳该怎么办”这类问题上去问基础大模型。来杰认为把触觉信息也训练进基础大模型”不是做不到,而是成本不合适,并且通讯的带宽也会有问题”。他还补充,这不是简单的分层,而更像蚂蚁式的智能体化:每个智能体能力未必强,但组合起来很强大。
| 机器人系统中的角色 | 专访中的职责 | 软件工作流中的类比角色 |
|---|---|---|
| 固定化程序 | 24 小时重复打螺丝 | 规则引擎、正则、脚本、数据库查询 |
| 具身模型 | 物理执行、感知参数、把状态翻译成自然语言 | 分类、抽取、向量检索等专用小模型 |
| 基础大模型 | 补充上下文知识、给出疑难方案 | 复杂推理、开放式生成、异常决策 |
| AOS 操作系统 | 把能力封装成技能模块,与大模型和 Agent 适配 | 工作流编排层、工具调用层、路由器 |
这张映射表是本文的推演,不是专访原话。机器人涉及物理世界的实时控制和通讯带宽限制,软件工作流则更多受 token 计费、延迟和稳定性约束,两者的瓶颈并不完全相同。
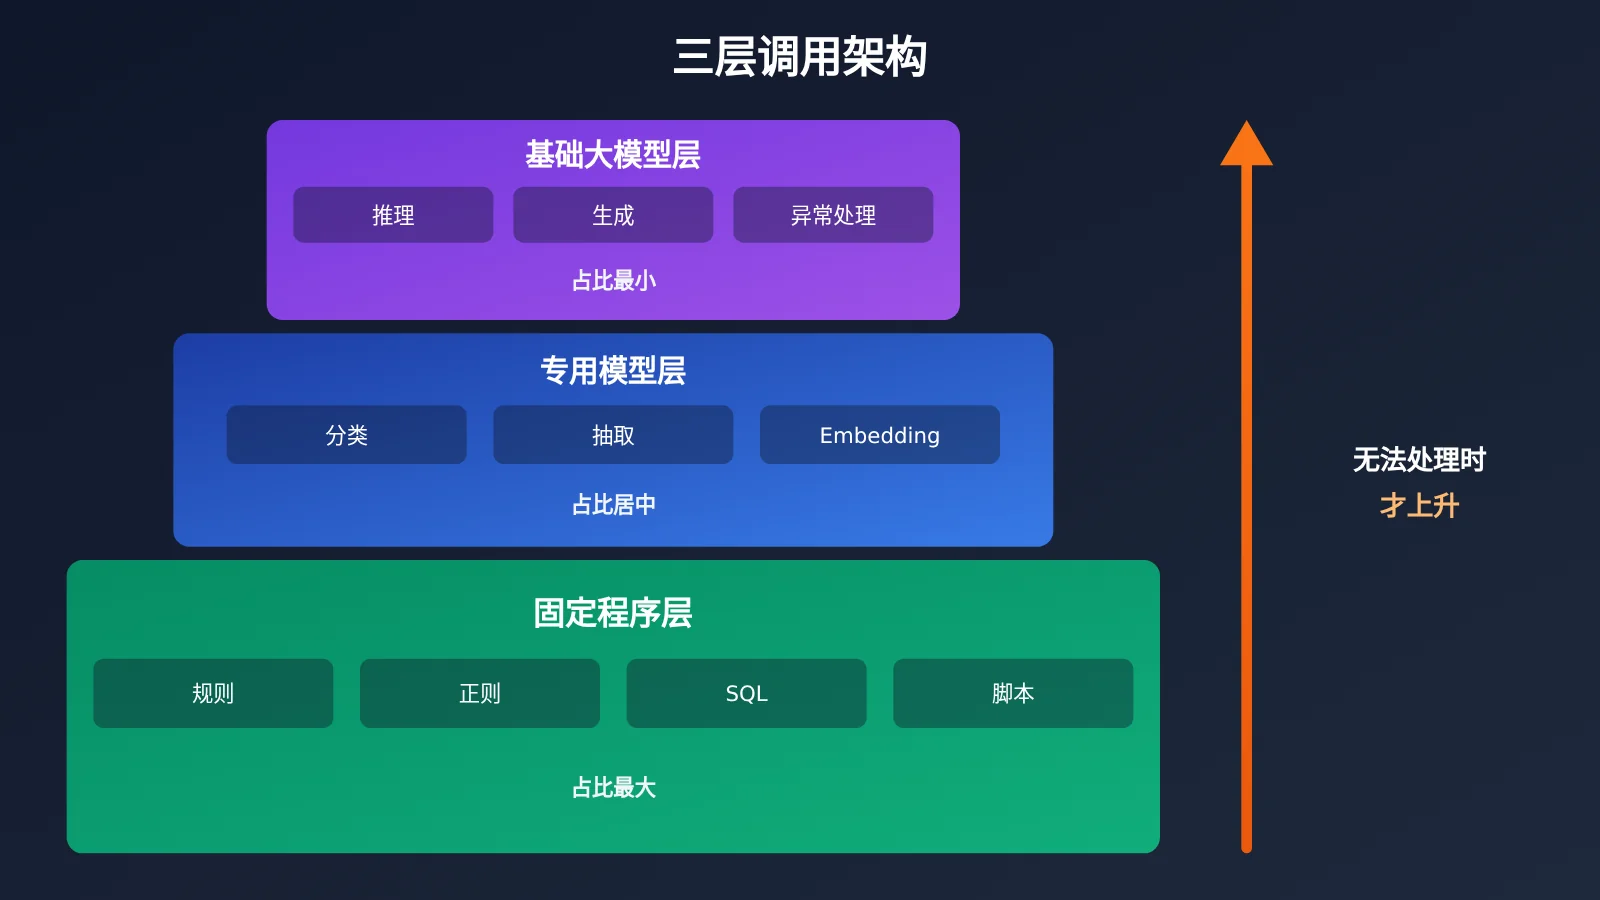
AI 应用哪些环节不该调用大模型:5 条判断标准
很多团队做 Agent 的第一版,习惯把所有步骤都塞给大模型:格式校验让大模型做,日期转换让大模型做,甚至”判断字段是否为空”也写成提示词。原型阶段这样做很快,但上线后每一次请求都在为确定性工作付费,还引入了不必要的随机性。
借用”打螺丝”的思路,我们可以用下面 5 条标准判断一个环节是否值得调用大模型。
| 判断维度 | 倾向固定程序 | 倾向专用模型 | 倾向基础大模型 |
|---|---|---|---|
| 输入是否结构化 | 字段固定、格式明确 | 半结构化文本 | 开放式自然语言 |
| 输出是否唯一 | 有唯一正确答案 | 有限类别 | 多种合理答案 |
| 规则能否穷举 | 能写成 if/else | 规则多但模式稳定 | 规则无法穷举 |
| 出错代价 | 必须零误差 | 可接受少量误差并复核 | 需要综合权衡 |
| 调用频率 | 极高频、每次都执行 | 高频 | 低频、按需触发 |
适合交给固定程序的”螺丝型”环节
以下几类环节通常属于”打螺丝”,确定性高、重复性强,用大模型反而降低稳定性:
- 格式校验与清洗:邮箱、手机号、JSON 结构、必填字段检查,正则和 Schema 校验即可完成。
- 数据查询与计算:订单状态、库存数量、金额汇总,应直接查数据库或调用业务接口,不要让大模型”推算”。
- 固定模板输出:通知短信、标准回执、报表表头,用模板引擎填充变量即可。
- 流程控制与重试:分支跳转、超时重试、限流排队,属于编排层逻辑,不需要模型参与。
- 高频缓存命中:同一问题被反复询问时,先查缓存或 FAQ 库,命中就直接返回。
真正需要大模型判断的环节
与之相对,真正值得调用基础大模型的,是”妈妈在电话那头才能回答的问题”:用户意图模糊需要澄清、需要综合多份资料写出结论、遇到规则没覆盖的异常情况、需要生成有创造性的内容。这些环节的共同点是:答案不唯一,规则无法穷举,且出现频率相对较低。
专用模型则处在两者之间。意图分类、实体抽取、情感判断、文本向量化这类任务,用较小的模型往往就能胜任,可以理解为软件版的”具身模型”:自己把能做的做完,把处理不了的情况整理成清晰的问题交给上一层。
AI 工作流分层设计示例:不该调用大模型的环节先拦截
下面以一个常见的”客服工单自动处理”流程为例,演示如何把调用边界落到具体步骤上。这是一个设计示例,并非真实项目的实测数据。
| 工作流步骤 | 负责层 | 处理方式 | 是否消耗 token |
|---|---|---|---|
| 工单字段校验 | 固定程序 | Schema 校验,缺字段直接打回 | 否 |
| 查询订单与物流状态 | 固定程序 | 调用业务数据库接口 | 否 |
| 常见问题匹配 | 固定程序 / 专用模型 | 关键词规则优先,向量检索兜底 | 少量 |
| 意图分类 | 专用模型 | 小模型输出有限类别 | 少量 |
| 复杂投诉与异常处理 | 基础大模型 | 结合订单上下文生成处理建议 | 是 |
| 回复模板填充 | 固定程序 | 模板引擎输出最终文本 | 否 |
可以看到,6 个步骤中只有一步必须调用基础大模型。具体能节省多少 token、成功率是否下降、延迟如何变化,取决于你的流量结构和规则覆盖率,必须用实际日志来评估。
极简示例:规则优先,模型兜底
下面这段代码展示了最小化的分层路由思路:先用规则拦截”螺丝型”请求,再交给小模型分类,只有复杂情况才调用大模型。模型名称仅为示例,请以平台实际可用的模型列表为准。
import re
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

def handle(query: str) -> str:
    # 第一层:固定程序,能用规则解决的不调用模型
    if re.search(r"(订单号|单号)\s*[::]?\s*\d{8,}", query):
        return "已为您查询订单状态(走业务接口,不消耗 token)"
    # 第二层:小模型做意图分类
    intent = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": f"只输出类别(咨询/投诉/其他):{query}"}],
        max_tokens=5,
    ).choices[0].message.content.strip()
    if intent != "投诉":
        return f"已归类为:{intent},转入标准流程"
    # 第三层:只有复杂投诉才调用基础大模型
    return client.chat.completions.create(
        model="claude-sonnet-4",
        messages=[{"role": "user", "content": f"请给出投诉处理建议:{query}"}],
    ).choices[0].message.content
查看带用量记录的完整实现代码
import re
import time
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SMALL_MODEL = "gpt-4o-mini"       # 示例:分类/抽取用的小模型
LARGE_MODEL = "claude-sonnet-4"   # 示例:复杂推理用的大模型

@dataclass
class UsageLog:
    records: list = field(default_factory=list)

    def add(self, layer: str, tokens: int, latency: float):
        self.records.append({"layer": layer, "tokens": tokens, "latency": latency})

    def summary(self):
        result = {}
        for r in self.records:
            s = result.setdefault(r["layer"], {"count": 0, "tokens": 0, "latency": 0.0})
            s["count"] += 1
            s["tokens"] += r["tokens"]
            s["latency"] += r["latency"]
        return result

log = UsageLog()

RULES = [
    (re.compile(r"(订单号|单号)\s*[::]?\s*\d{8,}"), "order_lookup"),
    (re.compile(r"(营业时间|几点开门)"), "faq_hours"),
]

def rule_layer(query: str):
    for pattern, action in RULES:
        if pattern.search(query):
            return action
    return None

def call_model(model: str, prompt: str, layer: str, max_tokens: int = 512) -> str:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    tokens = resp.usage.total_tokens if resp.usage else 0
    log.add(layer, tokens, time.time() - start)
    return resp.choices[0].message.content.strip()

def handle(query: str) -> str:
    start = time.time()
    action = rule_layer(query)
    if action:
        log.add("rule", 0, time.time() - start)
        return f"[规则层] 执行动作:{action}"

    intent = call_model(
        SMALL_MODEL,
        f"只输出一个类别(咨询/投诉/其他),不要解释:{query}",
        layer="small",
        max_tokens=5,
    )
    if "投诉" not in intent:
        return f"[专用模型层] 归类为:{intent}"

    return call_model(
        LARGE_MODEL,
        f"你是资深客服主管,请针对以下投诉给出处理建议:{query}",
        layer="large",
    )

if __name__ == "__main__":
    for q in ["订单号:2026110612345 到哪了", "你们营业时间是?", "收到的商品破损,客服一直不回复"]:
        print(handle(q))
    print(log.summary())
🚀 快速上手建议:分层路由要跑出可信结论,关键是用同一套接口在不同层切换模型并记录消耗。推荐通过 API易 apiyi.com 用一个 API Key 同时调用小模型和大模型,配合平台用量统计对比各层的 token 消耗,新用户可先用免费测试额度做原型验证。
「别打一个螺丝收我一份 token 费」的影响分析
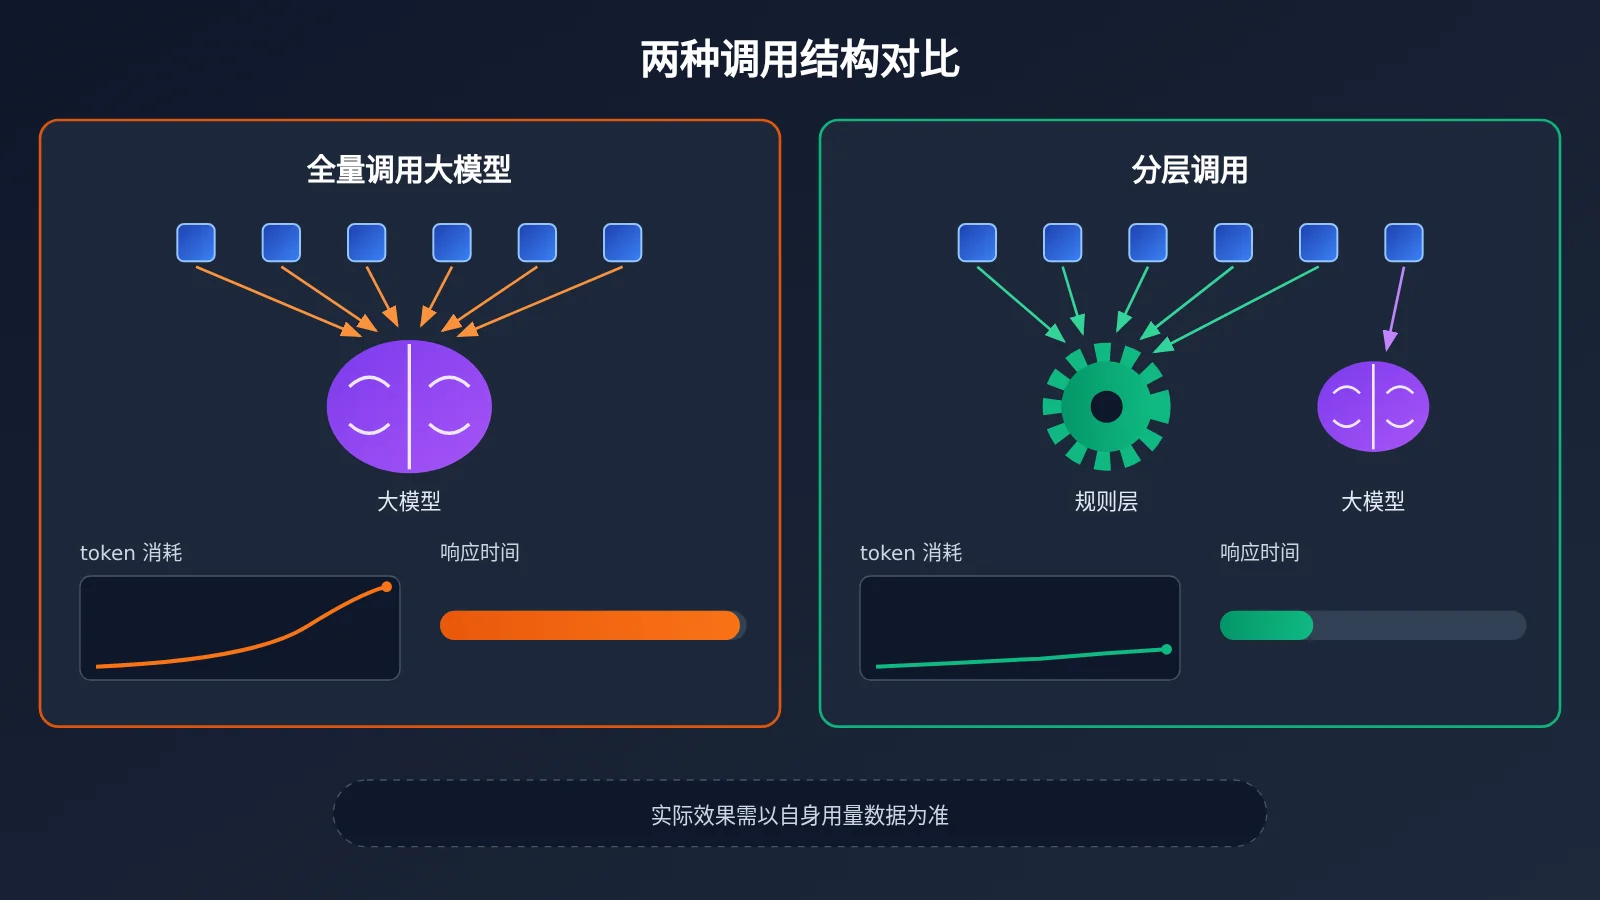
上图展示的是两种设计的结构差异,而不是实测数值。具体对比数据建议在 API易 apiyi.com 上用相同请求集分别跑两种方案,再结合用量记录得出结论。
| 对比维度 | 全量调用大模型 | 分层调用 | 可用平台 |
|---|---|---|---|
| 开发速度 | 原型最快,写提示词即可 | 需要额外梳理规则和路由 | API易 apiyi.com、各家官方 API |
| token 消耗 | 每个环节都计费 | 只有疑难环节计费为主 | 同上 |
| 结果确定性 | 确定性任务也可能出现随机偏差 | 规则层结果可预期 | 同上 |
| 响应延迟 | 每步都需等待模型生成 | 规则层几乎即时返回 | 同上 |
| 维护成本 | 提示词越堆越长 | 规则需要随业务更新 | 同上 |
对工作流搭建者和开发者的影响
- 设计顺序会反过来:不再是”先接大模型,再想办法省钱”,而是先列出所有步骤,标记哪些是”螺丝”,再决定模型放在哪里。
- 专用模型的位置更重要:像具身模型把物理状态翻译成自然语言一样,中间层的价值在于把模糊输入整理成结构化问题,让大模型的每次调用都更聚焦。
- 可观测性成为刚需:分层之后必须按层记录调用次数、token 和延迟,否则无法判断某一层是否该上调或下沉。
对产品负责人的影响
- 成本模型更可预测:确定性环节不计 token,费用主要集中在可估算的疑难请求上。
- 需要接受”不是越智能越好”:把查订单交给大模型看起来更智能,但用户真正需要的是准确和快速。
- 验证指标要提前定义:分层前后的 token 消耗、任务成功率、端到端延迟,这三项应作为上线前的对比基线。
对行业的影响
来杰的观点代表了一种思路:基础大模型越来越强,并不意味着所有能力都要塞进同一个模型,而是让不同能力的”智能体”各司其职。在软件领域,这与工具调用、Agent 编排的发展方向是一致的。不过,专访讨论的是机器人场景,这一思路在软件工作流中的收益有多大,还缺少公开的案例数据,需要更多团队的实践来检验。
常见问题 FAQ
Q1:「别打一个螺丝收我一份 token 费」这句话是什么意思?
这是星尘智能创始人来杰在 2026 年 11 月爱范儿专访中的说法。他认为机器人进厂打螺丝这类重复劳动应该交给固定化程序 24 小时运转,而不是每一次动作都调用模型并支付 token 费。放到 AI 应用中,就是确定性、高频的环节不该调用大模型。
Q2:机器人的分层思路可以直接用到软件工作流吗?
不能直接等同。机器人涉及实时控制、触觉感知和通讯带宽,软件工作流主要受 token 计费、延迟和稳定性约束。可以借鉴的是”执行层自己完成、疑难问题再上升”的分工逻辑,具体收益需要用实际案例验证。
Q3:怎么判断一个环节该用小模型还是大模型?
看输出是否有限、规则是否稳定。输出是有限类别、模式稳定的任务(如意图分类、字段抽取),优先尝试小模型;需要综合推理、开放生成或处理异常的任务再交给大模型。建议在 API易 apiyi.com 用同一批样本分别测试不同模型,比较准确率和消耗后再定。
Q4:分层之后一定能降低成本吗?
不一定。如果业务请求本身大部分都是复杂问题,规则层拦截不了多少,分层收益就有限;如果规则写得过宽导致误拦截,还可能降低成功率。正确做法是先记录现状,再对比分层前后的 token 消耗、成功率和延迟。
Q5:如何快速搭建一个分层调用的原型?
可以按以下步骤:
1. 列出工作流全部步骤,标记”螺丝型”环节并用规则实现
2. 访问 API易 apiyi.com 注册并获取 API Key,用 OpenAI 兼容接口同时接入小模型和大模型
3. 参考本文代码实现路由,并按层记录 token 和延迟
统一接口的好处是切换模型只需改 `model` 参数,便于反复对比。
Q6:分层设计有哪些常见坑?
– **规则膨胀**:规则越写越多,最后比提示词还难维护,需要定期清理。
– **层间信息丢失**:小模型分类后没有把上下文传给大模型,导致大模型重复理解。
– **缺少兜底**:规则和小模型都判断失败时,应有转大模型或转人工的出口。
「别打一个螺丝收我一份 token 费」核心要点 Key Takeaways
- 观点来源:出自 2026 年 11 月爱范儿对星尘智能来杰的专访,属于创始人观点。
- 分工逻辑:执行层自己完成动作,只在疑难问题上询问基础大模型补充上下文。
- 5 类螺丝环节:格式校验、数据查询、模板输出、流程控制、缓存命中不该调用大模型。
- 三层结构:固定程序打底、专用模型居中、基础大模型只处理开放和异常问题。
- 类比有边界:机器人结论不能直接套用软件场景,收益需用自身数据验证。
- 验证三指标:分层前后对比 token 消耗、任务成功率、端到端延迟。
- 上手方式:可通过 API易 apiyi.com 统一接口切换各层模型并观察用量。
总结
「别打一个螺丝收我一份 token 费」这句话,本质上是在提醒我们重新审视 AI 工作流的调用边界:
- 先识别螺丝:确定性高、频率高、有唯一答案的环节,交给固定程序。
- 再放专用模型:有限类别、模式稳定的任务,用小模型完成并整理问题。
- 最后才是大模型:开放推理、异常决策、创造性生成,才值得为之付 token 费。
这套方法不依赖某个具体模型或某次发布,可以长期作为 Agent 设计的检查清单。真正落地时,请务必用自己的业务日志验证分层前后的差异,而不是直接假设成本一定下降。
如果你正在设计分层工作流,可以通过 API易 apiyi.com 用一个 API Key 接入不同规格的模型,在各层灵活切换并对照用量统计,用数据决定每一颗”螺丝”该由谁来拧。
📚 参考资料
- 爱范儿 – 对话星尘智能来杰:「多样性公司」栏目第 15 篇专访
- 链接:
ifanr.com/1687805 -
说明: 本文”打螺丝与 token 费”比喻、具身模型与基础大模型分工思路的原始出处
-
OpenAI Chat Completions 接口文档:OpenAI 兼容接口参数说明
- 链接:
platform.openai.com/docs/api-reference/chat - 说明: 理解
model、max_tokens、usage等字段,便于实现按层用量记录
作者: APIYI 技术团队
技术交流: 欢迎在 API易 网站首页联系我们,更多模型接入与用量统计说明可查阅 API易 文档中心