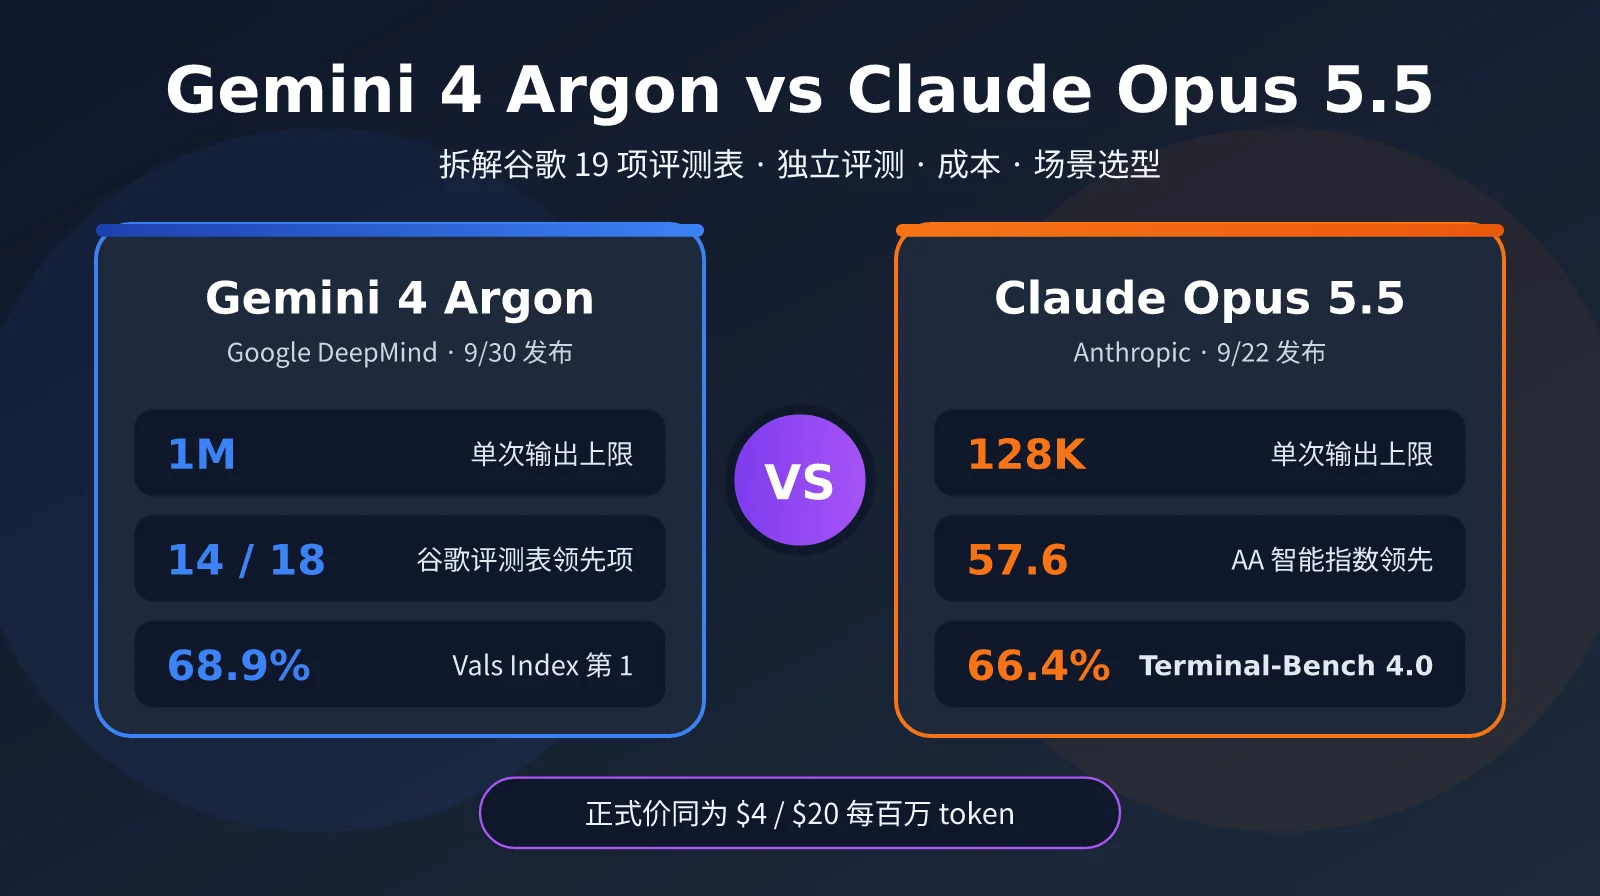
9 月下旬到 10 月初,前沿大模型密集更新:Anthropic 在 9 月 22 日发布 Claude Opus 5.5,仅 8 天后 Google 推出 Gemini 4 Argon。两款模型的定位高度重合,都主打长链路推理、智能体编程和企业知识工作,正式价格也都是输入 $4、输出 $20 每百万 token。Gemini 4 Argon vs Claude Opus 5.5 自然成了开发者选型时最常被问到的问题。
目前公开信息不多,最完整的一手数据是 Google 在 Argon 评测文档中给出的一张 19 项基准对比表,其中就包含 Claude Opus 5.5。本文以这张表为主线逐项拆解,同时补充 Artificial Analysis、Vals 等第三方独立评测,以及价格、输出上限、可用性等工程因素,帮你判断两款模型各自适合什么场景。
核心价值:读完本文,你能看懂谷歌评测表里哪些数字可信、哪些需要打折扣,并根据自己的业务场景在 Gemini 4 Argon 和 Claude Opus 5.5 之间做出选择。
Gemini 4 Argon vs Claude Opus 5.5 基础参数对比
在看评测分数之前,先对比两款模型的基础参数。两者的正式价格完全一致,真正的差异集中在输出上限、可用性和尝鲜价三个方面。
| 对比项 | Gemini 4 Argon | Claude Opus 5.5 |
|---|---|---|
| 发布日期 | 2026 年 9 月 30 日 | 2026 年 9 月 22 日 |
| 当前可用性 | Fairwind 计划 + Vertex AI 逐步放量,付费 API 未全面开放 | 已全面可用:Claude API、Bedrock、Vertex AI、Foundry |
| 模型 ID | 官方尚未公布 | claude-opus-5-5 |
| 价格(输入/输出) | 尝鲜 $2/$10,正式 $4/$20 | $4/$20 |
| 缓存读取 | 输入价 95% 折扣($0.10 起) | $0.20 |
| Batch 批量价 | 未公布 | $2/$10 |
| 上下文窗口 | 官方未公布(第三方称 1M) | 1M,无长上下文附加费 |
| 单次输出上限 | 1M token | 128K token |
| 推理控制 | High 等推理档位 | low 到 max 五档 effort,自适应思考 |
从参数表可以看出,Argon 最大的硬优势是 1M 输出上限,是 Opus 5.5 的约 8 倍,适合超长代码生成和大规模迁移任务。Opus 5.5 最大的优势则是今天就能稳定用上:模型 ID 明确,主流云平台全部上架,还有 Batch 半价和五档 effort 控制,工程化程度明显更成熟。
🎯 对比建议:两款模型的正式价格相同,选型主要看任务类型。我们建议通过 API易 apiyi.com 平台用同一套接口调用 Claude Opus 5.5 和 Gemini 系列模型,用自己的真实任务做并排测试,比单看榜单更可靠。
Gemini 4 Argon vs Claude Opus 5.5 谷歌评测表逐项拆解
下面是 Google 在 Argon 评测文档中公布的对比数据,这里只保留 Argon 和 Opus 5.5 两列,并按类别整理。需要注意,这是 Google 发布的厂商表格:Argon 的成绩由 Google 自己跑出,Opus 5.5 的成绩大多来自公开榜单或 Anthropic 系统卡,部分基准由 Google 统一重跑。
| 类别 | 基准测试 | Gemini 4 Argon | Claude Opus 5.5 | 领先方 |
|---|---|---|---|---|
| 知识工作 | Vals Index | 68.9% | 67.0% | Argon +1.9 |
| 知识工作 | AutomationBench | 51.3% | 42.5% | Argon +8.8 |
| 知识工作 | Vals Finance Agent v2 | 65.4% | 58.6% | Argon +6.8 |
| 知识工作 | Harvey 法律 Agent | 19.6% | 3.8% | Argon +15.8 |
| 智能体编程 | DeepSWE v1.1 | 77.9% | 74.2% | Argon +3.7 |
| 智能体编程 | FrontierSWE v2 | 55.0% | 62.3% | Opus +7.3 |
| 智能体编程 | Vibe Code Bench | 91.9% | 90.3% | Argon +1.6 |
| 智能体编程 | Terminal-Bench 4.0 | 57.4% | 66.4% | Opus +9.0 |
| ML 工程 | PostTrainBench | 45.3% | 49.3% | Opus +4.0 |
| 科学数学 | Terminal-Bench Science 0.1 | 57.6% | 63.3% | Opus +5.7 |
| 科学数学 | LABBench 2 | 88.8% | 73.1% | Argon +15.7 |
| 科学数学 | RiemannBench | 76.0% | 69.6% | Argon +6.4 |
| 长上下文 | GraphWalks ≤128K | 99.7% | 90.6% | Argon +9.1 |
| 长上下文 | GraphWalks 256K–1M | 84.2% | 66.8% | Argon +17.4 |
| 计算机操作 | Agent’s Last Exam | 39.5% | 38.2% | Argon +1.3 |
| 多模态 | Chartography | 71.6% | 66.3% | Argon +5.3 |
| 多模态 | LVBench 长视频 | 91.7% | 83.7% | Argon +8.0 |
| 网络安全 | CWE-bench v1 | 68.0% | 67.0% | Argon +1.0 |
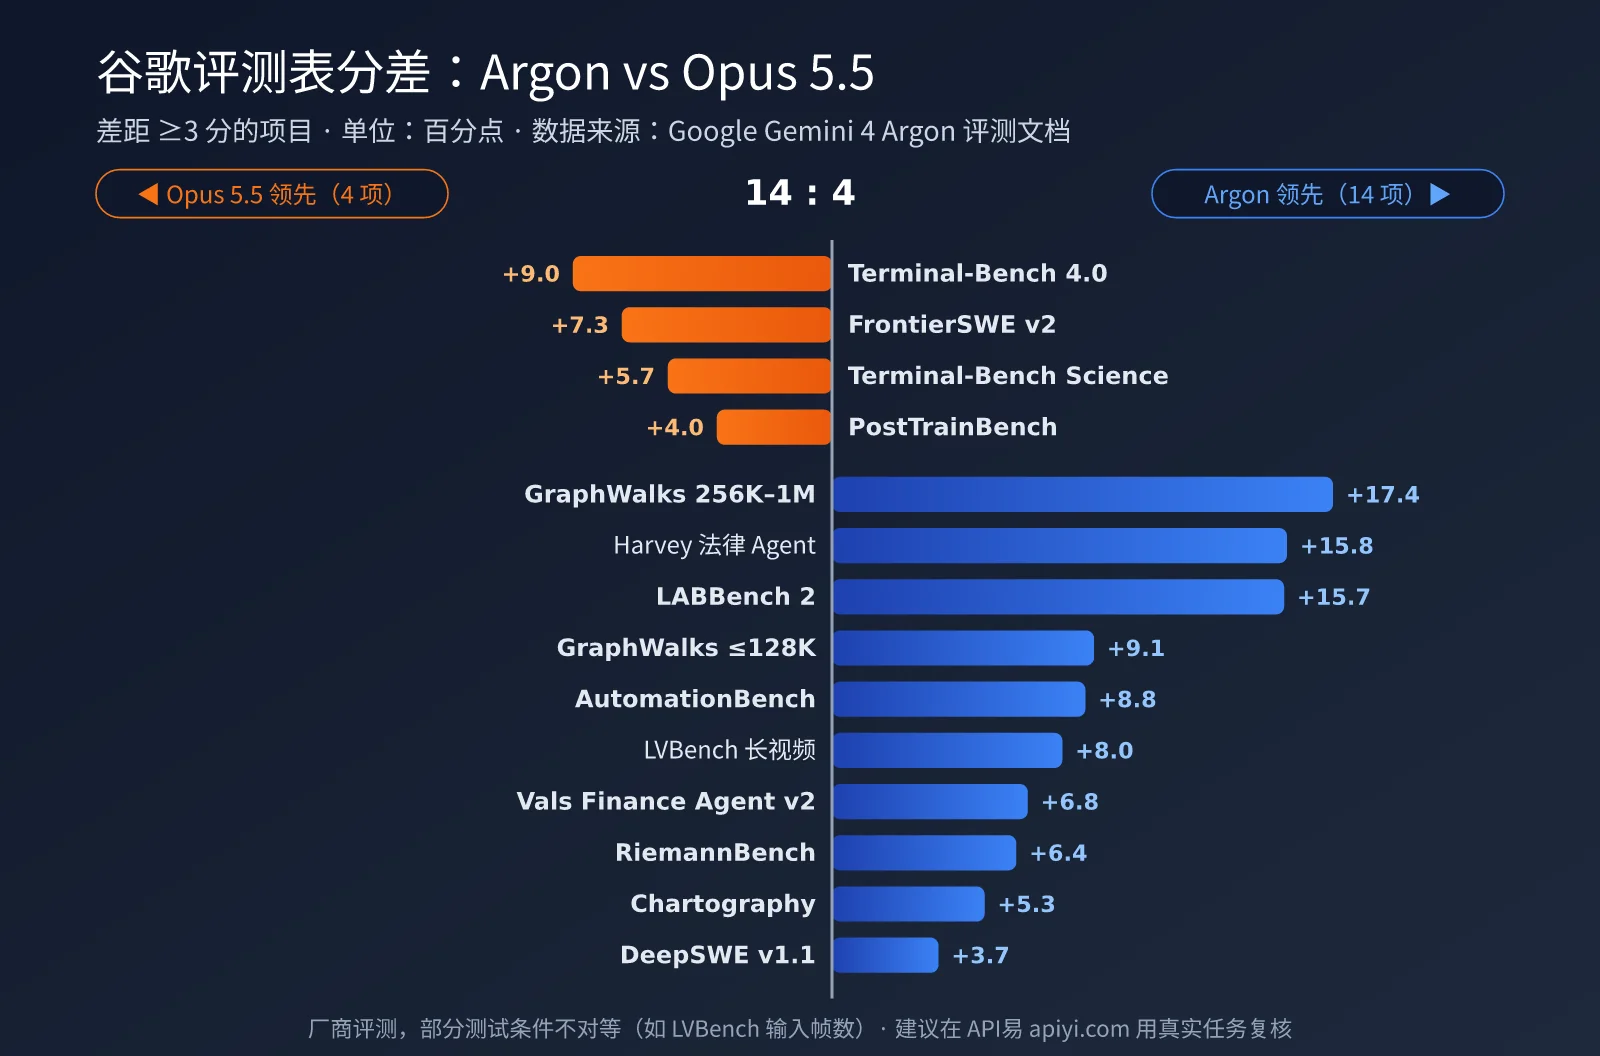
在两者都有成绩的 18 项基准中,Argon 领先 14 项,Opus 5.5 领先 4 项。Opus 5.5 胜出的 4 项很有规律:FrontierSWE v2、Terminal-Bench 4.0、PostTrainBench 和 Terminal-Bench Science,全部是需要在真实终端环境中长时间操作、反复执行命令的任务。Argon 的大比分领先则集中在长上下文(GraphWalks 256K–1M 领先 17.4 分)、法律 Agent 和生命科学(LABBench 2)上。
谷歌评测表中需要打折扣的地方
厂商评测表天然对自家模型有利,这张表的脚注里也有几处值得注意的细节。理解这些细节,才能正确解读 Gemini 4 Argon vs Claude Opus 5.5 的分差:
- LVBench 输入帧数不同:Argon 按每秒 1 帧读取完整视频,而 Opus 5.5 受 API 限制只能输入 600 帧,长视频成绩的差距部分来自输入条件不对等。
- Terminal-Bench Science 放宽了超时:Argon 的验证超时设置为默认值的 6 倍,即便如此 Argon 仍落后 Opus 5.5 5.7 分。
- DeepSWE 测试框架不同:Argon 使用 mini-swe agent 框架自测,Claude 的成绩取自 Anthropic 系统卡,两边的测试框架并不一致。
- 与 Anthropic 自报数据存在出入:Anthropic 自己公布的 Opus 5.5 成绩中,AutomationBench 为 40.0%,带工具的 Chartography 达到 89.0%,OSWorld 2.0 为 81.8%。Google 表格中 Chartography 只取了 66.3%,OSWorld 一栏则直接留空。
换句话说,测试条件对齐时,两者的差距比表格看起来要小。Argon 在长上下文、法律、生命科学方面的领先幅度足够大,可信度较高;而 Vals Index、Vibe Code、CWE-bench 等只差 1–2 分的项目,基本可以视为打平。
Gemini 4 Argon vs Claude Opus 5.5 独立评测结果
第三方独立评测的结论和谷歌评测表并不一致,甚至在综合智能指数上方向相反。下表汇总了 Artificial Analysis(AA)和 Vals 两家机构的公开数据。
| 独立评测项目 | Gemini 4 Argon | Claude Opus 5.5 | 领先方 |
|---|---|---|---|
| AA 智能指数 v4.3 | 52.6 | 57.6 | Opus +5.0 |
| Vals Index 排名 | 68.90%(第 1) | 66.97%(第 3) | Argon +1.9 |
| AA Terminal-Bench 4.0 | 57.1% | 59.6% | Opus +2.5 |
| AA Humanity’s Last Exam | 57.1% | 61.4% | Opus +4.3 |
| AA SciCode | 61.8% | 66.9% | Opus +5.1 |
| AA 长上下文推理 | 79.7% | 84.7% | Opus +5.0 |
| AA GDPval(Elo) | 1611 | 1846 | Opus +235 |
| AA AutomationBench | 77.5% | 69.5% | Argon +8.0 |
| AA 输出速度 | 48.9 token/s | 92.2 token/s | Opus 约快 1.9 倍 |
在 AA 的测试中,Opus 5.5 在推理、科学编程、长上下文推理和 GDPval 职业任务上全面领先,Argon 只在 AutomationBench 业务自动化上明显胜出。不过 AA 的对比并不完全公平:Argon 只测了 High 档位,而 Opus 5.5 使用的是自适应推理的 Max 档位,部分差距可能来自推理强度设置,而不完全是能力差距。
Vals Index 则把 Argon 排在 41 个模型中的第一,Opus 5.5 第三,但两者的差距约为 1.5 个标准误,说明 Argon 略占上风,但优势并不确定。综合来看,Gemini 4 Argon vs Claude Opus 5.5 在综合能力上属于同一档次,不存在一方碾压另一方的情况。
💡 评测提示:不同评测机构的结论方向可能相反,最终还是要用自己的数据说话。API易 apiyi.com 平台支持在统一接口下切换 Claude、Gemini、GPT 等系列模型,适合快速搭建自己的小型评测集。
Gemini 4 Argon vs Claude Opus 5.5 核心差异解读
把分数放到一边,两款模型在设计思路上的差异,其实比单项基准的分差更能指导选型。
长链路任务的两种思路
Gemini 4 Argon 的思路是把单次输出的空间做大。1M 输出上限意味着一次请求就能连续生成数十万行代码或超长报告,Google 内部用它完成了 Fuchsia Zircon 内核 80 万行以上的 C/C++ 到 Rust 迁移,以及替换 libgav1 中 3.2 万行 SIMD 代码等任务。这种设计减少了任务拆分和上下文拼接,特别适合“一次性产出大量内容”的场景。
Claude Opus 5.5 的思路是把推理过程做得更可控。它没有追求超大输出,而是提供 low 到 max 五档 effort 和始终开启的自适应思考,让开发者按任务难度调节推理深度和成本。配合 Claude Code 等智能体框架,Opus 5.5 更擅长在多轮工具调用中反复执行、观察、修正,这也解释了它为什么在 Terminal-Bench 这类终端交互型任务上明显领先。
速度、延迟与稳定性
Artificial Analysis 的测试显示,Opus 5.5 的输出速度约为 92 token/s,接近 Argon 48.9 token/s 的两倍。对需要实时交互的编程助手、客服 Agent 来说,这个差距会直接体现在用户体验上。Argon 的优势在于单次请求能完成更多工作,适合对实时性要求不高、但单任务体量巨大的后台作业。
此外,Opus 5.5 已经在多个云平台稳定运行了数周,配额、限流和错误处理都有成熟文档;Argon 仍处于放量初期,配额和限流策略尚不明确。对 SLA 要求较高的生产系统来说,这一点的权重不应低于基准分数。
安全与提示词注入防护
两家都把智能体安全作为重点。Google 称 Argon 是其迄今对间接提示词注入最具韧性的模型,在 Gray Swan IPI 基准上领先,但没有公布具体分数;第三方安全厂商的分析则显示,Opus 5.5 在同一基准上与 Claude Fable 5.1 并列最低注入成功率。也就是说,两款模型在提示词注入防护上都处于第一梯队,各自都能宣称领先。对于需要读取外部网页、邮件、文档的 Agent,无论选择哪一款,都仍然需要在模型之外做好工具权限隔离和人工确认机制。
Gemini 4 Argon vs Claude Opus 5.5 成本对比
两者正式价相同,但同样的任务消耗的 token 量不同,实际成本差异很大。下表是第三方机构实测的单任务成本。
| 成本口径 | Gemini 4 Argon | Claude Opus 5.5 | 差距 |
|---|---|---|---|
| AA 单任务平均成本 | $1.99(尝鲜价) | $5.98 | Argon 约为 1/3 |
| AA 跑完整个指数总成本 | $2,407 | $8,708 | Argon 约为 28% |
| Vals 单次测试成本 | $15.68 | $32.14 | Argon 约为 49% |
| 按正式价折算 AA 单任务 | 约 $3.98 | $5.98 | Argon 仍便宜约 1/3 |
| Batch 批量任务 | 未公布 | 半价 $2/$10 | Opus 有确定的批量折扣 |
即使按 $4/$20 的正式价折算,Argon 在 AA 测试中的单任务成本仍比 Opus 5.5 低约三分之一。部分原因是 Opus 5.5 在 Max 档位下推理过程较长。如果把 Opus 5.5 的 effort 调到 medium 或 high,成本会明显下降,这也是 Opus 5.5 五档 effort 控制的实际价值。另外,对离线批处理任务来说,Opus 5.5 确定可用的 Batch 半价,目前比 Argon 尚未公布的批量价格更有确定性。
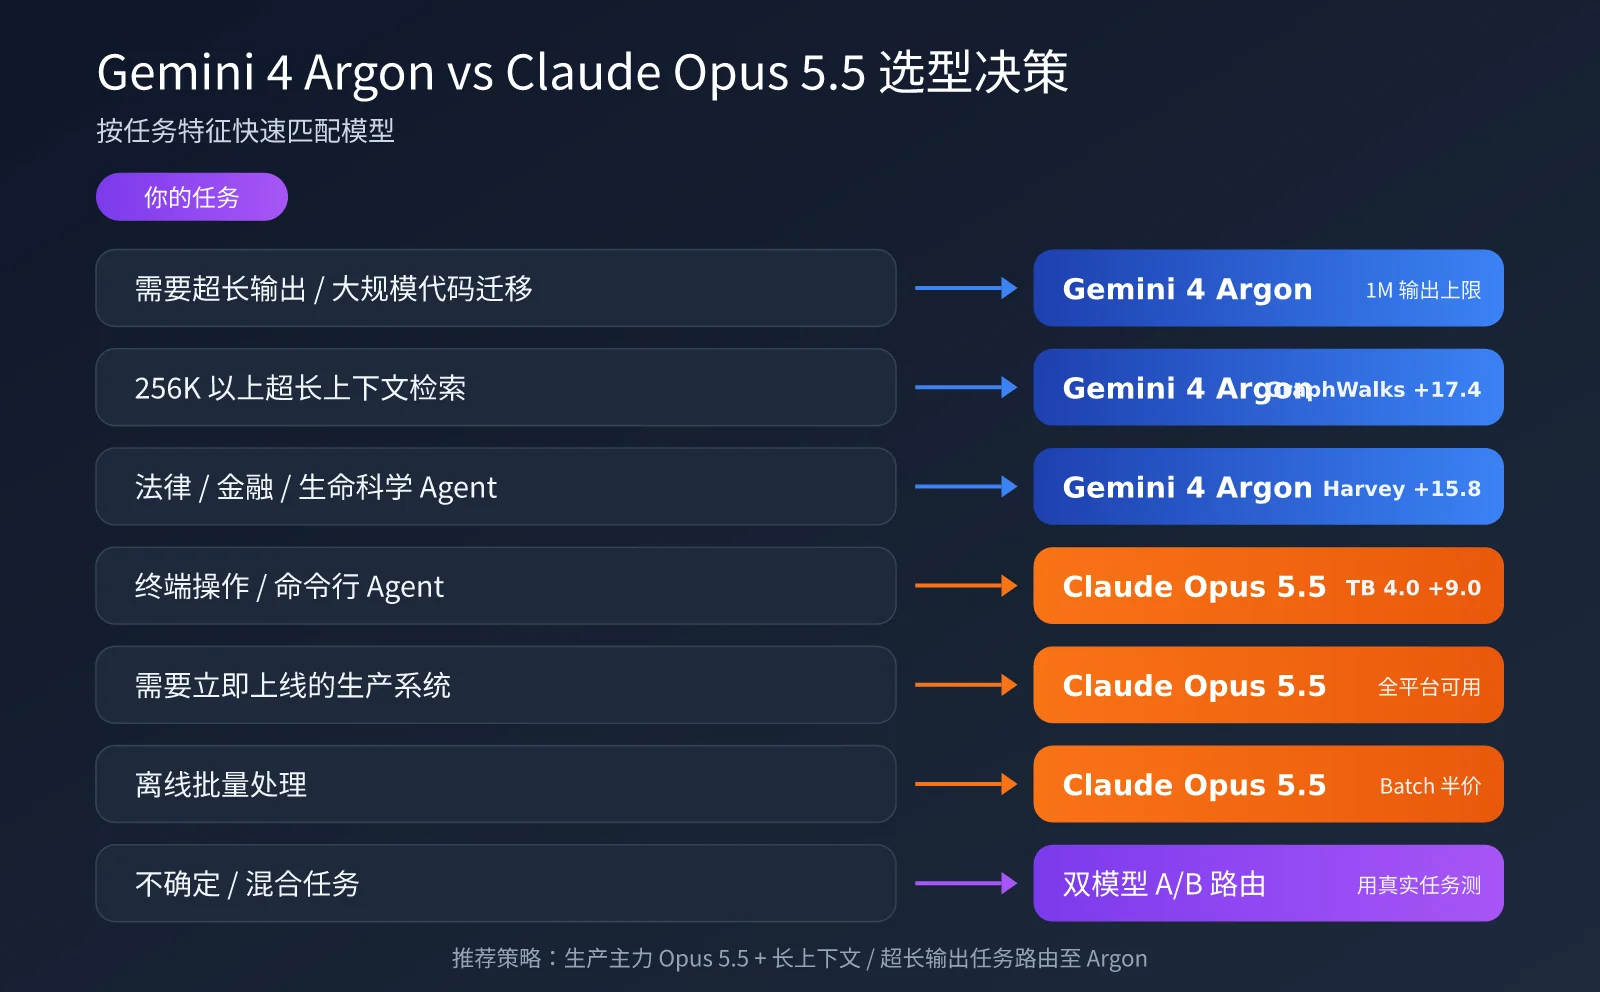
Gemini 4 Argon vs Claude Opus 5.5 场景推荐与决策建议
结合谷歌评测表、独立评测、成本和可用性,可以按任务场景给出比较明确的推荐:
| 应用场景 | 推荐模型 | 核心理由 |
|---|---|---|
| 大规模代码迁移 / 超长代码生成 | Gemini 4 Argon | 1M 输出上限,DeepSWE 领先 3.7 分 |
| 256K 以上超长上下文检索 | Gemini 4 Argon | GraphWalks 256K–1M 领先 17.4 分 |
| 法律、金融专业 Agent | Gemini 4 Argon | Harvey 领先 15.8 分,Finance Agent 领先 6.8 分 |
| 长视频与图表理解 | Gemini 4 Argon | LVBench、Chartography 均领先 |
| 终端操作、命令行 Agent | Claude Opus 5.5 | Terminal-Bench 4.0 领先 9 分 |
| 科研编程与复杂推理 | Claude Opus 5.5 | AA 的 SciCode、HLE、CritPt 均领先 |
| 需要立即上线的生产系统 | Claude Opus 5.5 | 全平台可用,模型 ID 与配额明确 |
| 离线批量处理 | Claude Opus 5.5 | Batch 半价 $2/$10 已确定 |
Gemini 4 Argon vs Claude Opus 5.5 双模型路由实践
对大多数团队来说,最务实的策略不是二选一,而是双模型路由:生产主力先用 Opus 5.5,把 Argon 擅长的长上下文、超长输出任务逐步路由过去。下面是一个基于 OpenAI 兼容接口的极简示例。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # API易 统一接口
)

OPUS = "claude-opus-5-5"
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")  # 以平台实际上线 ID 为准

def pick_model(prompt_tokens: int, need_long_output: bool) -> str:
    # 超长上下文或超长输出走 Argon,其余默认 Opus 5.5
    return ARGON if prompt_tokens > 256_000 or need_long_output else OPUS

model = pick_model(prompt_tokens=12_000, need_long_output=False)
resp = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "排查这个 CI 流水线失败的原因"}],
)
print(model, resp.choices[0].message.content)
查看完整代码:同一任务双模型 A/B 对比
import os
import time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

MODELS = {
    "claude-opus-5-5": (4.0, 20.0),
    os.getenv("ARGON_MODEL", "gemini-4-argon"): (
        float(os.getenv("ARGON_PRICE_IN", "2")),
        float(os.getenv("ARGON_PRICE_OUT", "10")),
    ),
}

TASKS = [
    "阅读以下合同条款,列出对乙方不利的 5 处风险并给出修改建议:...",
    "把这段 Python 2 代码迁移到 Python 3.12 并补充类型注解:...",
    "根据以下日志定位服务超时的根因:...",
]


def run(model: str, task: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        max_tokens=16000,
        messages=[{"role": "user", "content": task}],
    )
    u = resp.usage
    price_in, price_out = MODELS[model]
    cost = (u.prompt_tokens * price_in + u.completion_tokens * price_out) / 1_000_000
    return {
        "model": model,
        "latency": round(time.time() - start, 1),
        "out_tokens": u.completion_tokens,
        "cost": round(cost, 4),
        "answer": resp.choices[0].message.content,
    }


if __name__ == "__main__":
    for task in TASKS:
        print("=" * 60, "\n任务:", task[:30])
        for model in MODELS:
            r = run(model, task)
            print(f"[{r['model']}] {r['latency']}s, 输出 {r['out_tokens']} token, ${r['cost']}")
这个 A/B 脚本会记录每个模型在同一任务上的延迟、输出 token 和成本。建议准备 30–50 个能代表你业务的真实任务,人工或用评分模型打分后,再决定两款模型的路由比例。
🚀 快速上手:可以先在 API易 apiyi.com 注册获取测试额度,用 Claude Opus 5.5 跑通上面的 A/B 脚本。Argon 在平台正式上线后,只需修改环境变量中的模型名,即可完成对比测试。
常见问题
Q1:Gemini 4 Argon 和 Claude Opus 5.5 到底谁更强?
没有绝对答案。在谷歌评测表中 Argon 领先 14 项、Opus 5.5 领先 4 项;但在 Artificial Analysis 的综合智能指数中,Opus 5.5 以 57.6 对 52.6 领先。两者属于同一档次:Argon 强在长上下文、超长输出和专业领域 Agent,Opus 5.5 强在终端操作、复杂推理和工程成熟度。
Q2:谷歌评测表的数据可信吗?
可以作为参考,但需要打折扣。这是 Google 发布的厂商表格,部分基准的测试条件并不对等,例如 LVBench 的输入帧数、Terminal-Bench Science 的超时设置。与 Anthropic 自报数据相比,部分 Opus 5.5 成绩也偏低。建议重点参考领先幅度在 5 分以上的项目,1–2 分的差距可视为打平。
Q3:现在能同时调用两款模型吗?
Claude Opus 5.5 已在 Claude API、Bedrock、Vertex AI 和 Foundry 全面可用。Gemini 4 Argon 目前仍在分阶段放量,Vertex AI 已可拉取,但付费 API 尚未全面开放。建议通过 API易 apiyi.com 先接入 Opus 5.5 和 Gemini 系列模型,Argon 正式上线后直接切换 model 参数进行对比。
Q4:两款模型价格一样,哪个实际更省钱?
按第三方实测,Argon 的单任务成本约为 Opus 5.5 的三分之一到二分之一,尝鲜期优势更明显。但 Opus 5.5 可以通过降低 effort 档位和使用 Batch 半价来大幅降低成本。最准确的方式是用真实任务记录 usage 后计算,API易 apiyi.com 平台的统一计费账单方便直接对比两个模型的实际花费。
总结
Gemini 4 Argon vs Claude Opus 5.5 是一场势均力敌的对决。从谷歌评测表看,Argon 在长上下文、法律金融 Agent、生命科学和多模态上优势明显,1M 输出上限更是独一档的能力;从独立评测看,Opus 5.5 在推理、科研编程和终端操作上更胜一筹,而且已经全平台可用、工程化成熟。
现阶段的推荐策略是:生产环境以 Claude Opus 5.5 为主力,Gemini 4 Argon 作为长上下文和超长输出任务的专用模型逐步引入,同时用自己的真实任务集持续做 A/B 对比。等 Argon 付费 API 全面开放、更多独立评测出炉后,再根据数据调整路由比例。
我们建议通过 API易 apiyi.com 平台统一接入 Claude 与 Gemini 系列模型,在一套接口、一份账单下完成多模型对比与路由,让选型决策建立在真实数据之上。
参考资料:
- Google 官方博客 Gemini 4 Argon 发布文章: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Anthropic Claude Opus 5.5 发布信息: anthropic.com/news
- Artificial Analysis 智能指数与模型对比: artificialanalysis.ai
- Vals AI 模型评测榜单: vals.ai
- Gemini 4 Argon 完整评测表整理(ToolScout): toolscout.ai/news/gemini-4-argon-benchmarks
作者:APIYI Team | 持续追踪前沿大模型评测与选型,更多模型接入资讯请访问 API易 apiyi.com