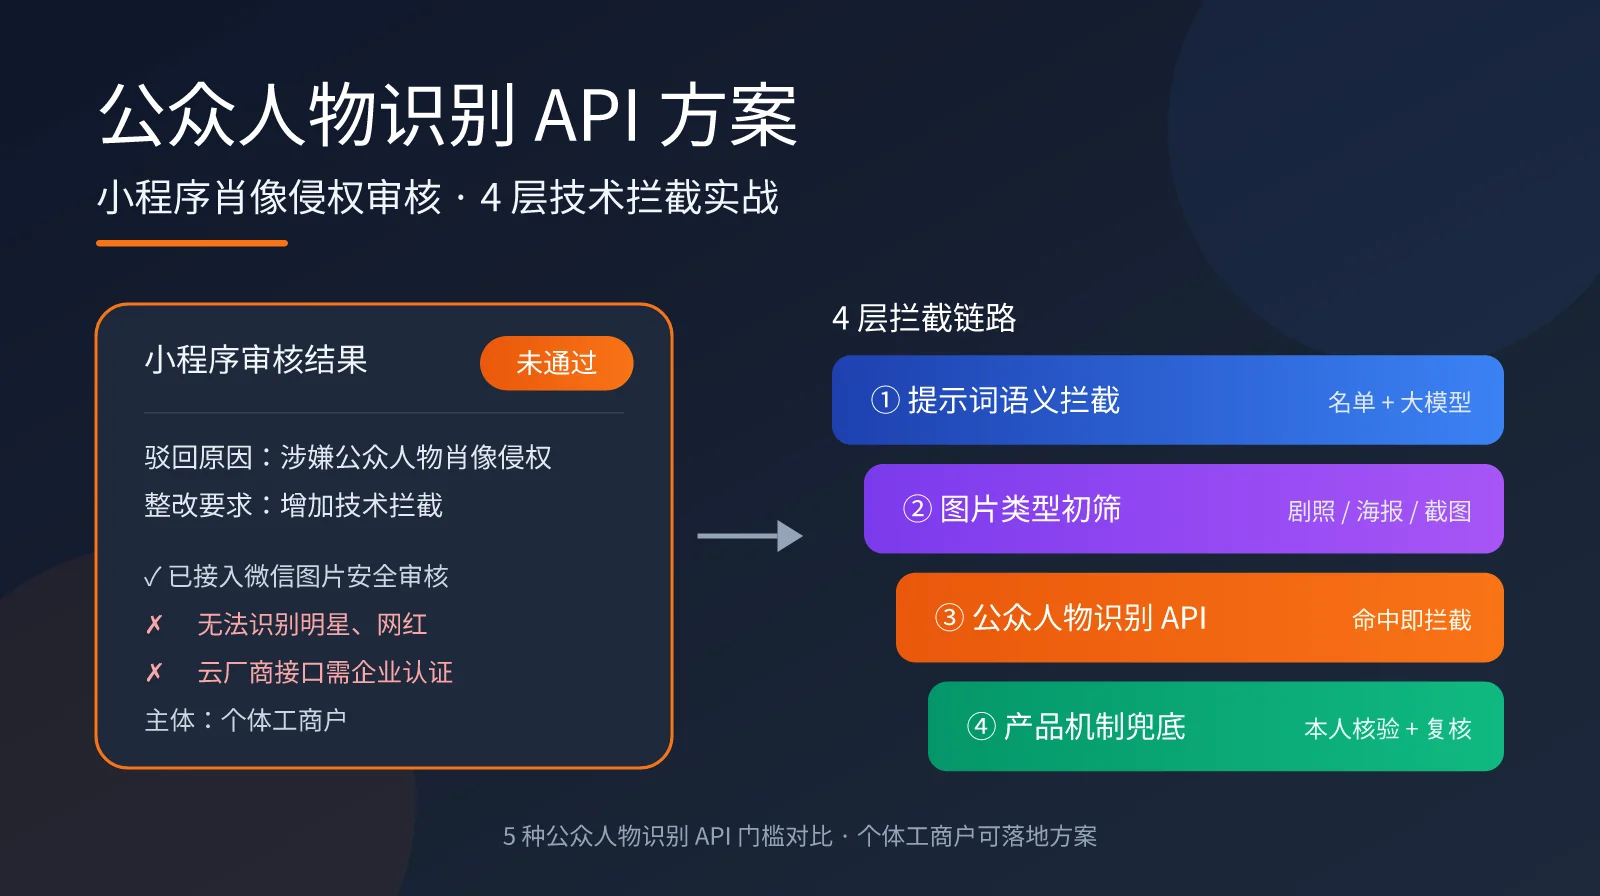
最近一位做 AI 图片小程序的开发者在群里求助:小程序审核卡在公众人物肖像侵权问题上,微信要求“增加技术拦截”。他已经接入了微信图片安全审核,但这个接口识别不了明星和网红;阿里云有现成的明星识别接口,却要求企业认证,而他们是个体工商户。
这类问题在 AI 写真、换脸、头像生成、海报设计类小程序里非常普遍。审核人员关心的不是“你有没有接内容安全接口”,而是“用户能不能用你的产品生成或传播某位公众人物的肖像”。只要拦截链路上有一个环节缺失,就可能反复被驳回。
本文围绕公众人物识别 API 展开,先说清楚微信内容安全接口的能力边界,再对比 5 种主流公众人物识别 API 的接入门槛,最后给出一套个体工商户也能落地的 4 层技术拦截方案。
核心价值:读完本文,你能明确知道该选哪个公众人物识别 API、怎么组合拦截链路,以及提交审核时如何把技术方案讲清楚。
公众人物识别 API 为什么成了小程序审核的硬门槛
微信对 AI 生成类、图片编辑类小程序的审核越来越严格,背后有明确的监管依据。《互联网信息服务深度合成管理规定》自 2023 年 1 月 10 日起施行,要求提供人脸、人声等生物识别信息编辑功能的服务方,提示使用者告知被编辑的个人并取得其单独同意。2025 年 9 月 1 日起施行的《人工智能生成合成内容标识办法》又进一步要求对 AI 生成内容做显式和隐式标识。
在这个背景下,平台最担心的是“明星脸”被滥用:用户上传某位演员的剧照做 AI 写真、用网红照片换脸、输入明星名字生成“同款”图片。这些行为都可能构成肖像权侵权,而小程序作为服务提供方需要承担“技术拦截”义务。因此审核反馈里的“增加技术拦截”,本质是要求你在用户上传和生成两个环节都具备识别公众人物的能力。
微信内容安全接口的能力边界
很多开发者的第一反应是接微信官方的内容安全接口,但它解决的是另一类问题。下表对比了微信接口能覆盖的范围和肖像侵权场景真正需要的能力。
| 检测维度 | 微信 msgSecCheck / mediaCheckAsync | 肖像侵权拦截实际需要 |
|---|---|---|
| 色情、低俗 | ✅ 支持 | 需要 |
| 时政敏感 | ✅ 支持(部分涉政人物) | 需要 |
| 暴恐、违法、辱骂 | ✅ 支持 | 需要 |
| 娱乐明星识别 | ❌ 不返回人物身份 | 核心需求 |
| 网红、主播识别 | ❌ 不支持 | 核心需求 |
| 提示词中的明星名字 | ⚠️ 仅判断文本违规,不判断肖像意图 | 核心需求 |
微信 msgSecCheck 用于文本检测,mediaCheckAsync 用于图片和音频的异步检测,主要识别色情、时政、暴恐、辱骂等违规内容,它们并不会告诉你“这张图里是哪位明星”。所以仅接入微信接口,在审核人员眼里只完成了“通用内容安全”,并没有完成“公众人物肖像拦截”。
🎯 技术建议:公众人物识别 API 只是拦截链路中的一环,文本提示词侧的拦截往往更关键、也更便宜。我们建议通过 API易 apiyi.com 平台调用大模型做提示词语义审核,它兼容 OpenAI 接口格式,个人开发者也能直接注册使用,便于快速补齐这一层。
5 种公众人物识别 API 方案对比
为了避免信息失真,下面的方案均基于各厂商英文官方文档整理。需要提前说明的是,公众人物识别属于人脸识别范畴,几乎所有大厂都对它设置了访问门槛,这正是个体工商户感到“无路可走”的原因。
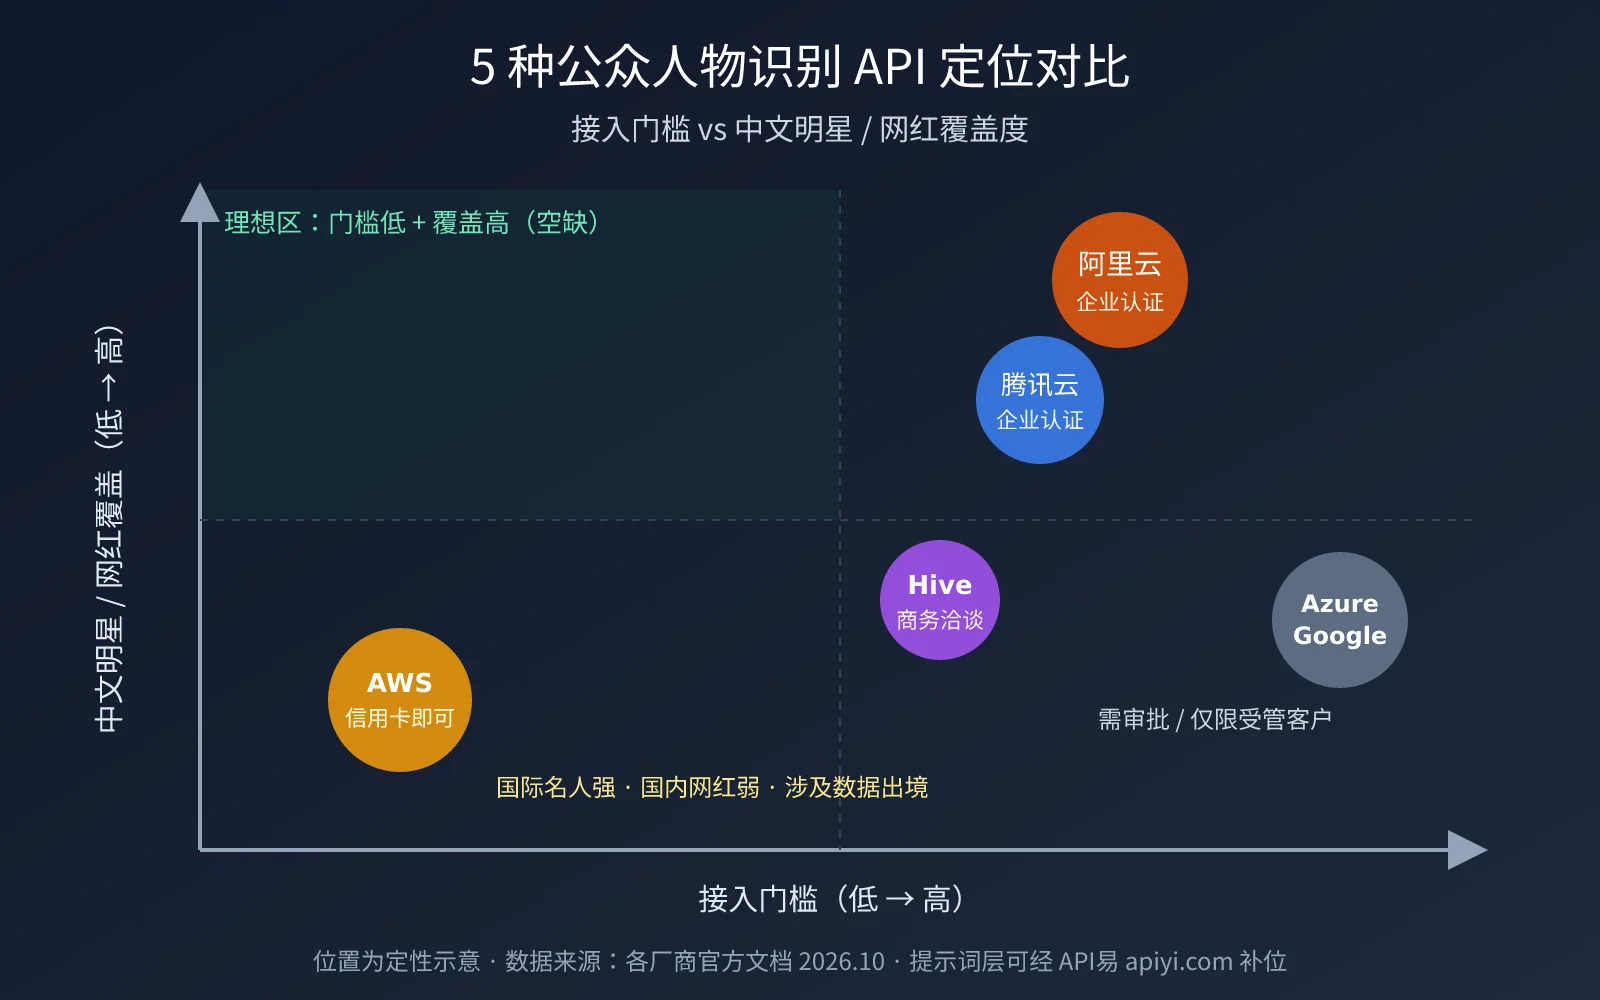
公众人物识别 API 门槛与能力一览
| 方案 | 接口能力 | 接入门槛 | 中文明星/网红覆盖 | 计费参考 |
|---|---|---|---|---|
| 阿里云视觉智能 / 内容安全 | 明星识别 DetectCelebrity;图片审核增强版可通过 infoType=publicFigure 返回公众人物名称和位置 |
据开发者反馈需企业实名认证 | 高 | 按调用量计费 |
| 腾讯云图片内容安全 IMS | 返回违规标签与二级标签,部分场景可返回人物名称 | 企业认证(个体工商户可尝试营业执照认证) | 中高 | 按调用量计费 |
| AWS Rekognition | RecognizeCelebrities 单图最多识别 64 位名人,返回姓名、ID、置信度和参考链接 |
海外账号绑定信用卡即可,无需审批 | 国际名人强,国内网红弱 | 首个 100 万张每张 $0.001 |
| Hive Celebrity Recognition | 覆盖 5 万+ 政治人物、运动员、宗教领袖和明星 | 需申请 API Key,偏企业商务 | 中 | 官网未公开 |
| Azure / Google Cloud Vision | 名人识别 | Azure 自 2022 年 6 月起仅对受管客户开放;Google 仅限通过人工审核的媒体娱乐客户 | 中 | 需审批 |
从表中可以看出,门槛最低的是 AWS Rekognition,但它的名人库以国际影视、体育、政商人物为主,对国内网红、主播覆盖有限。而且人脸属于《个人信息保护法》中的敏感个人信息,把用户上传的照片发送到境外服务,还会涉及数据出境合规问题,这一点在提交审核材料时也需要考虑。
个体工商户的现实选择
先澄清一个容易被误解的点:在国内主流云厂商的实名体系里,持有营业执照的个体工商户通常可以走“企业认证”通道,只是部分高敏感接口还会叠加额外的资质审核。所以“个体工商户不是企业”并不完全成立,建议先联系阿里云或腾讯云客服确认具体接口的开通条件。
如果确认无法开通,那就需要换一个思路:不把所有压力压在“识别出是谁”这一步,而是通过多层拦截让公众人物肖像根本进不了生成链路。审核人员看重的是拦截效果和机制完整性,而不是你用了哪家的公众人物识别 API。
公众人物识别 4 层技术拦截架构
下面这套架构的设计原则是“前置拦截、逐层收紧”。越靠前的层越便宜、越快,越靠后的层越精准、越贵,大部分风险请求在前两层就会被拦下。
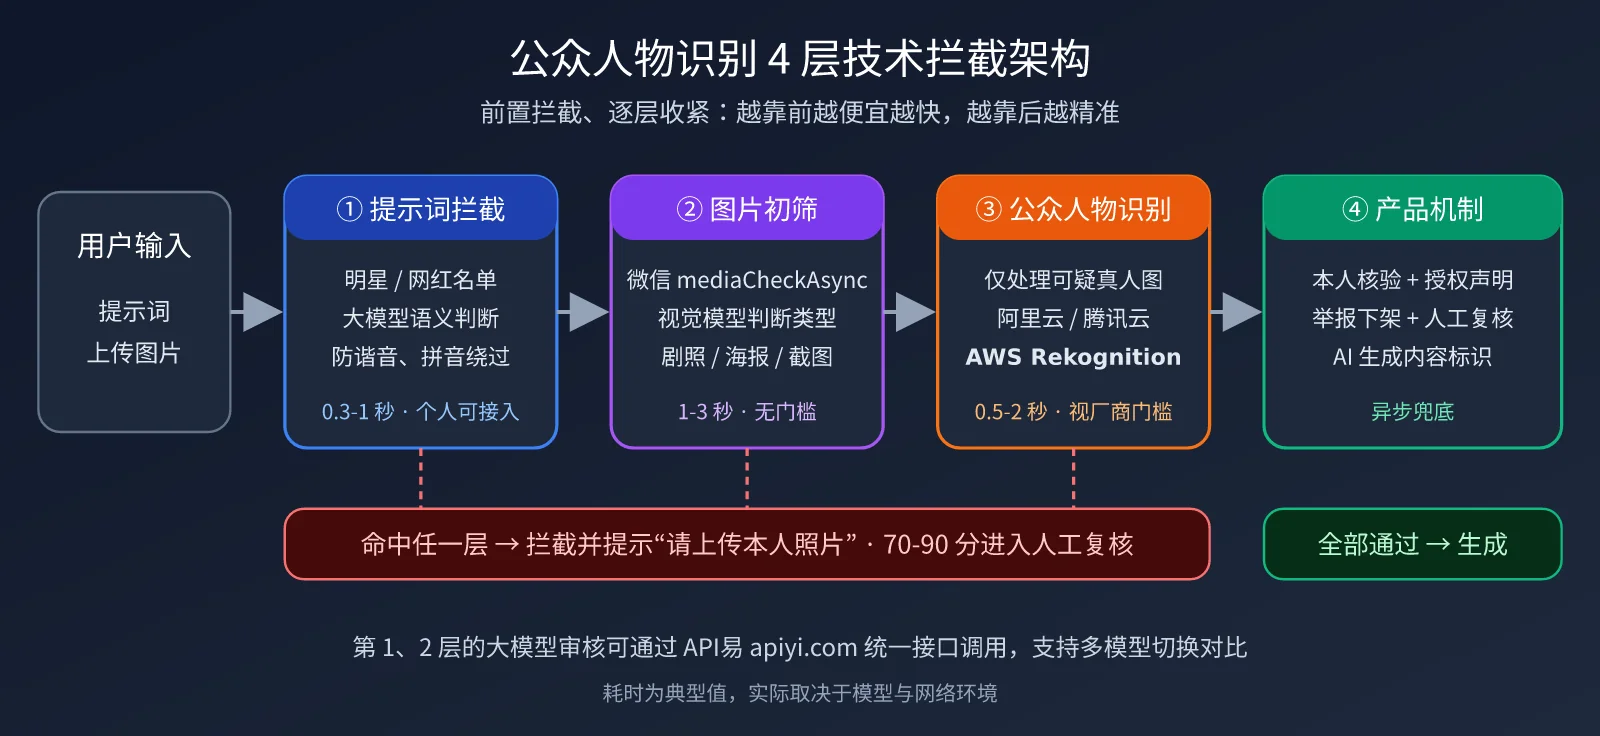
4 层拦截的职责划分
| 层级 | 拦截对象 | 实现方式 | 典型耗时 | 门槛 |
|---|---|---|---|---|
| 第 1 层 提示词拦截 | “生成某明星写真”“换成某网红的脸” | 关键词名单 + 大模型语义判断 | 0.3-1 秒 | 无,个人可接入 |
| 第 2 层 图片初筛 | 剧照、海报、杂志封面、直播截图 | 微信 mediaCheckAsync + 视觉大模型判断图片类型 | 1-3 秒 | 无 |
| 第 3 层 公众人物识别 API | 已知公众人物的真实照片 | 阿里云 / 腾讯云 / AWS Rekognition | 0.5-2 秒 | 视厂商而定 |
| 第 4 层 产品机制 | 漏网内容与争议内容 | 授权声明、举报下架、人工复核、AI 标识 | 异步 | 无 |
第 1 层是性价比最高的一层。对于 AI 生成类小程序,大量侵权请求都来自提示词,例如直接输入明星名字或“像某某一样的脸”。仅靠关键词名单很容易被谐音、拼音、缩写绕过,用大模型做语义判断能显著提高召回率。
第 2 层的思路是“不识别是谁,只识别是什么”。视觉大模型通常会拒绝说出照片中真人的身份,OpenAI 也明确限制了 GPT-4o 识别真实人物的能力,但判断一张图是不是“影视剧照、明星海报、杂志封面、带台标的直播截图”完全在它的能力范围内。这类图片本身就是高风险信号,可以直接拦截或转入第 3 层。
第 1 层:提示词语义拦截代码示例
下面是一个极简示例,用大模型判断提示词是否涉及真实公众人物。模型返回结构化 JSON,后端据此决定放行或拦截。
import json
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")  # API易 统一接口

def check_prompt(prompt: str) -> dict:
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        response_format={"type": "json_object"},
        messages=[
            {"role": "system", "content": "判断用户提示词是否要求生成、模仿或替换真实公众人物(明星、网红、主播、政治人物、运动员)的肖像。"
             "只输出 JSON:{\"risk\": true/false, \"names\": [], \"reason\": \"\"}"},
            {"role": "user", "content": prompt},
        ],
    )
    return json.loads(resp.choices[0].message.content)

print(check_prompt("帮我生成一张和那个唱《青花瓷》的歌手同款的写真"))
这个示例里,提示词没有直接出现人名,关键词名单无法命中,但大模型能通过语义推断出指向具体歌手,从而判定为高风险。
📦 展开查看完整版:提示词 + 图片双层拦截
import base64, json
import boto3
from openai import OpenAI

llm = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")  # API易 统一接口
rek = boto3.client("rekognition", region_name="ap-southeast-1")

BLOCK_NAMES = {"示例明星A", "示例网红B"}  # 本地名单,命中直接拦截

def llm_json(messages):
    resp = llm.chat.completions.create(
        model="gpt-4o-mini",
        response_format={"type": "json_object"},
        messages=messages,
    )
    return json.loads(resp.choices[0].message.content)

def layer1_prompt(prompt: str) -> bool:
    if any(n in prompt for n in BLOCK_NAMES):
        return True
    r = llm_json([
        {"role": "system", "content": "判断提示词是否涉及真实公众人物肖像,只输出 JSON:{\"risk\": bool}"},
        {"role": "user", "content": prompt},
    ])
    return r.get("risk", False)

def layer2_image(img_bytes: bytes) -> str:
    """不识别身份,只判断图片类型,返回 block / suspect / pass"""
    b64 = base64.b64encode(img_bytes).decode()
    r = llm_json([
        {"role": "system", "content": "不要识别人物身份。只判断图片类型,输出 JSON:"
         "{\"type\": \"selfie|film_still|poster|magazine|live_screenshot|non_human|other\", \"real_person\": bool}"},
        {"role": "user", "content": [
            {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{b64}"}},
        ]},
    ])
    if r.get("type") in {"film_still", "poster", "magazine", "live_screenshot"}:
        return "block"
    return "suspect" if r.get("real_person") else "pass"

def layer3_celebrity(img_bytes: bytes, threshold: float = 90.0) -> bool:
    res = rek.recognize_celebrities(Image={"Bytes": img_bytes})
    return any(c["MatchConfidence"] >= threshold for c in res["CelebrityFaces"])

def moderate(prompt: str, img_bytes: bytes | None) -> str:
    if layer1_prompt(prompt):
        return "blocked: prompt"
    if img_bytes:
        verdict = layer2_image(img_bytes)
        if verdict == "block":
            return "blocked: image_type"
        if verdict == "suspect" and layer3_celebrity(img_bytes):
            return "blocked: public_figure"
    return "pass"
完整版中,第 3 层只对第 2 层判定为“真人照片”的图片调用,既节省公众人物识别 API 的费用,也减少了需要外发的人脸数据量。如果你已经开通了阿里云或腾讯云的接口,只需要把 layer3_celebrity 替换为对应 SDK 调用即可。
🚀 快速开始:第 1 层和第 2 层都依赖大模型,建议先用 API易 apiyi.com 获取测试额度,拿 100 条真实用户提示词和图片跑一遍,统计拦截率和误杀率后再上线。同一套代码可以切换 GPT、Gemini、Claude 等多种模型对比效果。
公众人物识别结果的阈值与处置策略
识别结果不是简单的“是”或“否”,置信度阈值直接决定误杀率和漏放率。Hive 官方文档给出的参考是:真实照片建议阈值 0.85,AI 生成内容建议 0.9。AWS Rekognition 返回的 MatchConfidence 为 0-100 区间,可以按同样思路设置。
| 置信度区间 | 处置动作 | 用户提示 | 说明 |
|---|---|---|---|
| ≥ 90 | 直接拦截 | “图片疑似包含公众人物肖像,请上传本人照片” | 高置信命中,误杀概率低 |
| 70-90 | 拦截并进入人工复核队列 | “图片审核中,请稍候” | 撞脸、角度遮挡常落在此区间 |
| 检测到人脸但未匹配 | 放行,保留日志 | 无 | 普通用户的正常照片 |
| 未检测到人脸 | 放行 | 无 | 风景、宠物、物品等 |
对 AI 写真类产品,更稳妥的做法是叠加“本人核验”:要求用户先上传一张自拍作为基准,后续上传的照片必须与基准人脸相似度达标才允许生成。这样即使公众人物识别 API 覆盖不到某位小众网红,也能从机制上杜绝“用别人的脸”。
💡 选择建议:如果你的业务以国内网红、主播为主要风险来源,任何海外公众人物识别 API 的覆盖都不够,应把重心放在第 1 层提示词拦截和“本人核验”机制上。第 1 层的大模型调用可以通过 API易 apiyi.com 接入,成本通常只有图片识别的几分之一。
提交审核时如何描述公众人物拦截方案
技术做好了,还要让审核人员看得懂。建议在审核备注或补充材料中按以下结构说明:
- 拦截链路:说明提示词、图片上传、生成结果三个环节分别接入了哪些检测能力。
- 公众人物识别能力:写清使用的公众人物识别 API 或替代方案,以及命中后的处置动作。
- 产品机制:用户协议中的肖像授权条款、上传前的“仅限本人照片”确认弹窗、举报入口和下架时效。
- AI 内容标识:生成图片添加“AI 生成”显式标识,并在文件元数据中写入隐式标识。
- 测试证据:附上用明星照片、明星名字提示词测试被拦截的截图或录屏。
其中第 5 点最有说服力。审核人员往往会直接用明星照片测试,如果你的录屏能展示“上传明星剧照 → 被拦截”“输入明星名字 → 被拦截”,通过率会明显提升。
公众人物识别 API 常见问题
Q1:只用大模型能完全替代公众人物识别 API 吗?
不能完全替代。主流视觉大模型出于隐私政策通常会拒绝说出照片中真人的身份,而且即使能识别也不稳定,不适合做确定性的身份判断。大模型最适合做提示词语义拦截和图片类型判断,身份识别仍建议交给专门的公众人物识别 API。可以通过 API易 apiyi.com 用同一批样本测试不同模型的拦截效果,再决定分工。
Q2:AWS Rekognition 能识别国内明星吗?
能识别部分知名度较高的华语影视明星和体育明星,但对国内网红、主播、短视频达人的覆盖明显不足。另外它是境外服务,处理人脸这类敏感个人信息需要评估数据出境合规,建议只对第 2 层筛出的可疑图片调用,并在隐私政策中如实告知。
Q3:个体工商户一定无法开通阿里云明星识别吗?
不一定。个体工商户持营业执照通常可以完成云厂商的企业认证,但部分接口会追加资质审核。建议直接提交工单询问具体接口的开通条件,同时准备腾讯云作为备选。
Q4:提示词拦截的大模型调用成本高吗?
很低。一次提示词审核通常只消耗几百个 token,使用轻量模型时单次成本远低于一次图片识别。通过 API易 apiyi.com 调用还可以按量计费,适合审核量波动较大的小程序。
Q5:拦截做了还是被驳回怎么办?
先确认驳回原因是否还有“存量内容”问题,例如小程序内的示例图、模板图是否本身就使用了明星照片。很多开发者技术拦截做完了,却因为首页的示例效果图用了明星形象而再次被驳回,这部分需要全部替换为自有版权或 AI 生成的虚拟人像。
总结
小程序因公众人物肖像侵权被要求“增加技术拦截”,核心不是找到一个万能的公众人物识别 API,而是建立一条完整的拦截链路。微信内容安全接口只覆盖通用违规,识别不了明星网红;阿里云、腾讯云的公众人物识别能力最贴合国内场景,但需要企业认证;AWS Rekognition 门槛最低但对国内网红覆盖有限,并且涉及数据出境;Azure 和 Google 则基本不对普通开发者开放。
对个体工商户来说,最务实的路径是:先确认能否用营业执照完成云厂商企业认证,同时立刻上线提示词语义拦截和图片类型初筛这两层,再叠加本人核验、授权声明和人工复核机制,最后用测试录屏向审核人员证明拦截有效。
推荐通过 API易 apiyi.com 快速搭建第 1 层和第 2 层的大模型审核能力,用真实样本验证拦截率后再提交审核。
作者:APIYI Team,专注 AI 大模型 API 应用落地,更多技术方案与测试额度可访问 API易 apiyi.com 获取。