作者注:基於官方披露信息解讀 Astra for Law 的 2.3 億 URL 法律搜索索引、測試成績與 API 定價,釐清其專業能力的來源。
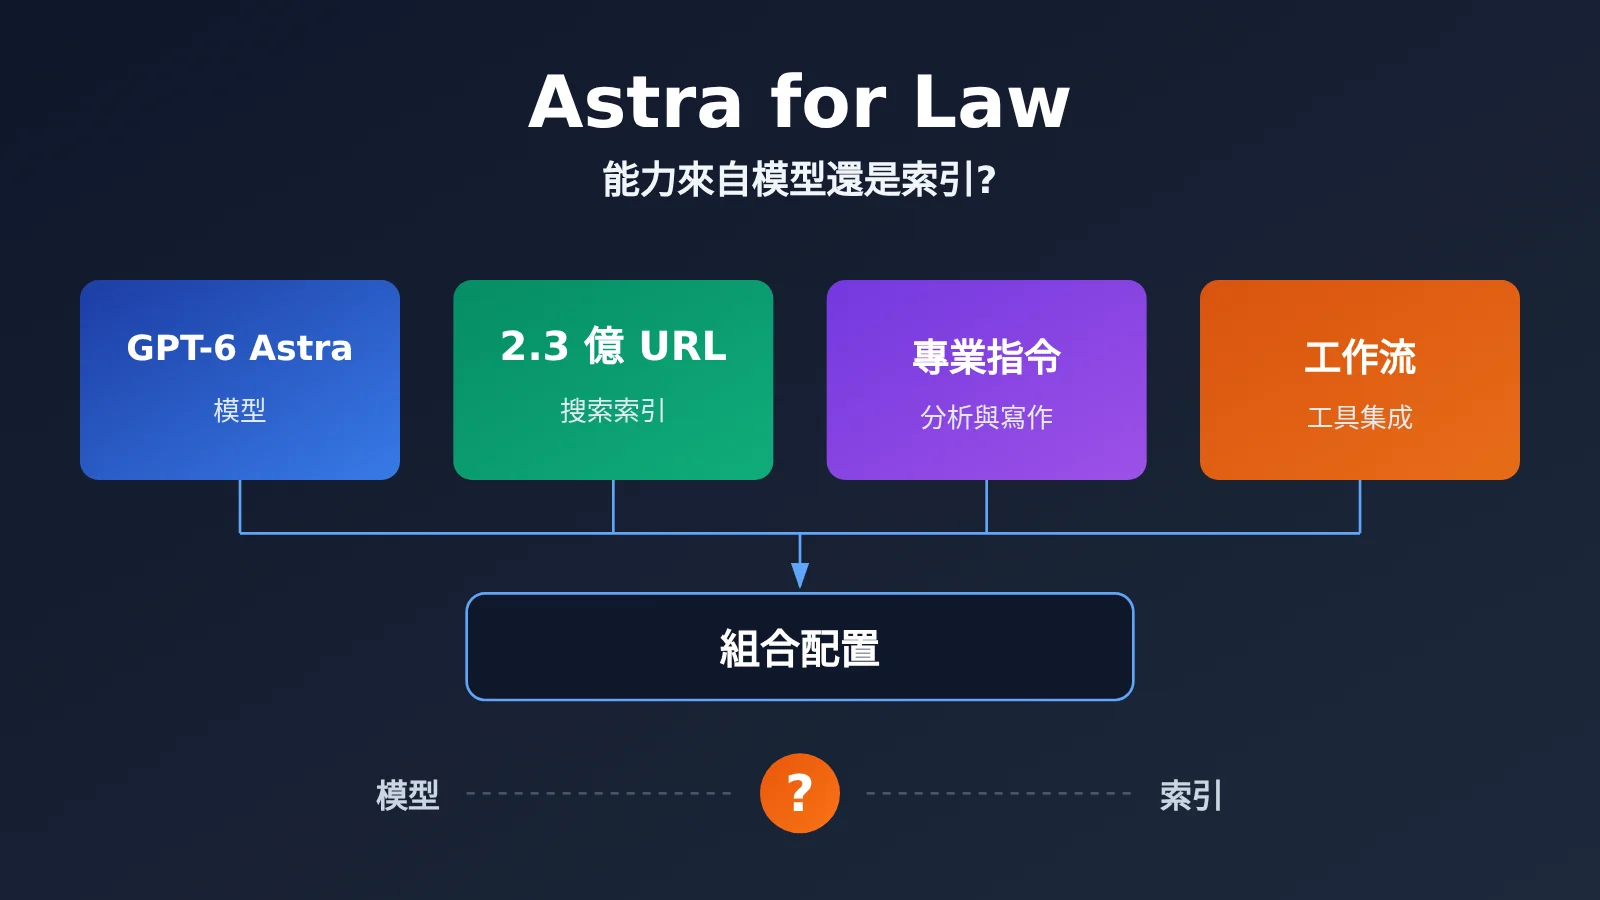
OpenAI 官方 API 定價頁面新增了法律配置 gpt-6-astra-law,多家科技媒體於 2026 年 10 月 31 日關注到這一條目。與它一同受到關注的,還有 Astra for Law 超過 2.3 億個 URL 的法律搜索索引。這引出一個核心問題:它的專業能力究竟來自模型,還是來自索引?
這不是小道消息,產品說明、索引規模和價格都能在 OpenAI 官方頁面覈實。但官方數據目前只能說明“完整配置優於通用配置”,還無法把提升幅度拆分到模型、索引或指令上。
核心價值:3 分鐘瞭解 Astra for Law 的真實構成、關鍵數字的準確含義,以及開發者現階段能做什麼。
Astra for Law 2.3 億 URL 核心信息速覽
截至 2026 年 11 月 2 日,公開信息可以彙總如下。其中最容易被誤讀的是 API 狀態:價格已經公開,但不等於所有開發者都能調用。
| 信息項 | 詳情 |
|---|---|
| 發佈時間 | 2026 年 9 月 17 日 |
| 發佈方 | OpenAI |
| 產品定位 | 面向律師事務所和法律科技公司的專業 AI 基礎平臺 |
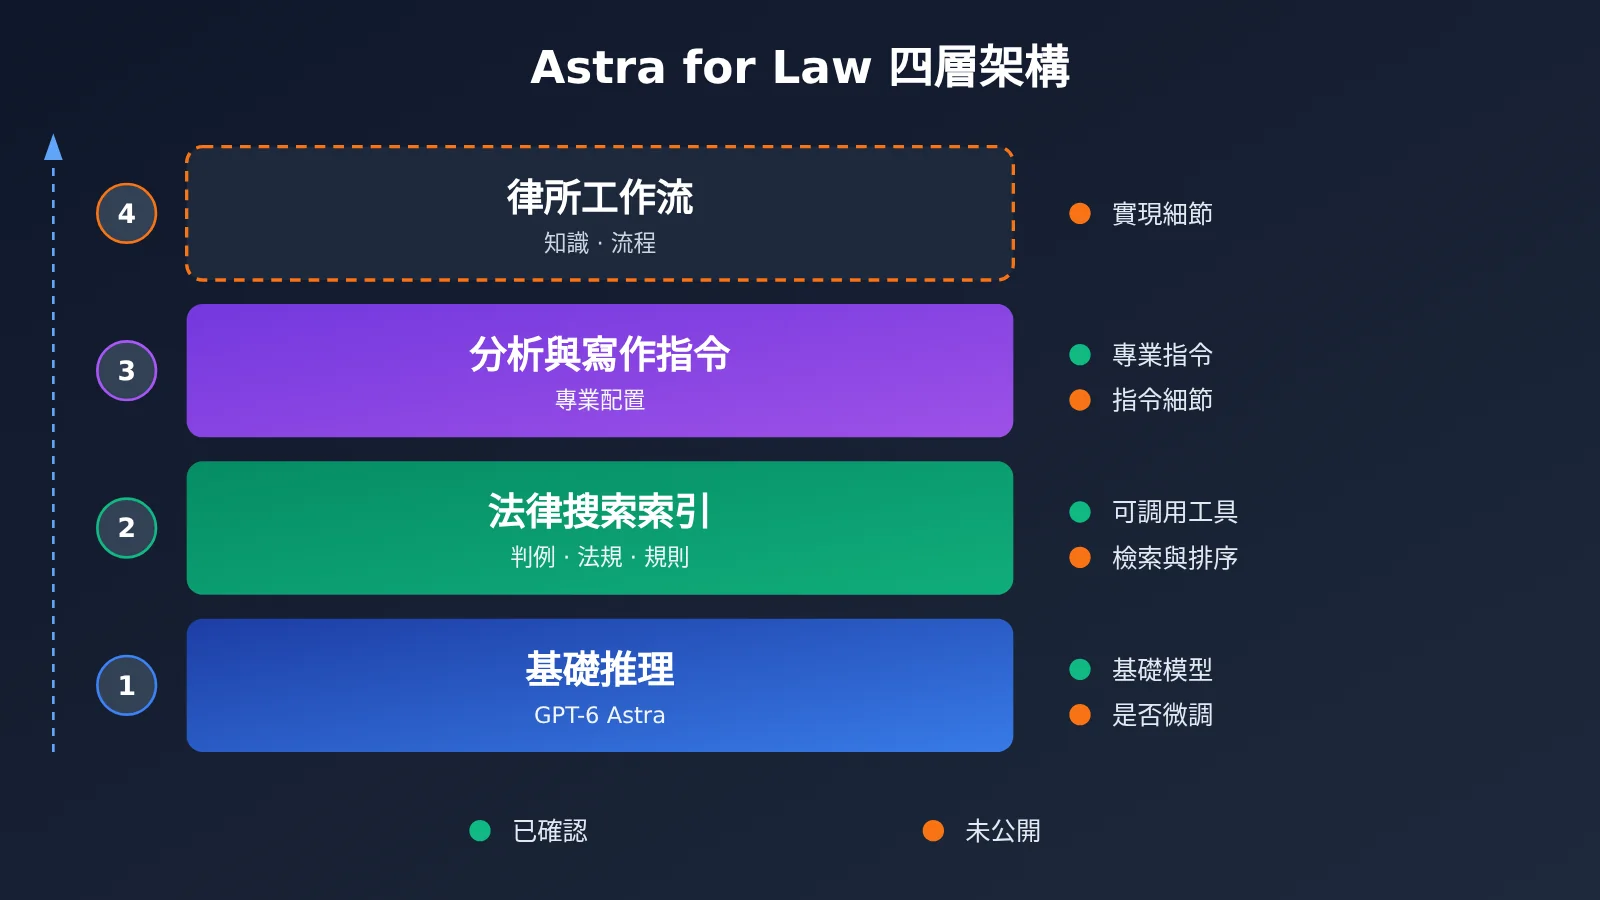
| 技術構成 | GPT-6 Astra、法律搜索索引、法律分析與寫作指令、工具及工作流集成 |
| 索引規模 | 超過 2.3 億個 URL,每日添加新來源 |
| 使用範圍 | 初期通過 Trusted Access 面向符合資格的美國律師事務所 |
| API 狀態 | 官方仍描述爲未來開放,正式開放日期未公佈 |
Astra for Law 的 2.3 億 URL 法律搜索索引包含什麼
這個索引覆蓋美國判例法、成文法、行政法規、法院規則和行政裁決。OpenAI 還與非營利機構 Free Law Project 合作,把 CourtListener 的美國判例數據引入研究環境。
一個 URL 可能對應頁面、文書、記錄或其他法律資料,因此“2.3 億 URL”不等於“2.3 億份判決書”。下面幾組數字的統計口徑也不同,不能相減,也不能用來推算其他資料的數量。
| 數字 | 披露方 | 準確含義 | 不能理解爲 |
|---|---|---|---|
| 超過 2.3 億 URL | OpenAI | 完整法律搜索索引的規模 | 2.3 億份獨立判決書 |
| 超過 900 萬條 | Free Law Project | CourtListener 的法律裁判記錄 | OpenAI 索引的全部內容 |
| 超過 2000 個法院 | Free Law Project | CourtListener 的數據來源範圍 | 全球法院覆蓋 |
| 超過 99.9% | Free Law Project | 已發表美國先例性判例的覆蓋率 | 全部法律資料的完整率 |
覆蓋範圍也有明確邊界。該索引目前以美國法律材料爲核心,尚無可信官方材料證明它對中國現行法律法規、裁判文書和司法解釋有同等級的專用覆蓋。
Astra for Law 的專業能力來自模型還是法律搜索索引
目前最準確的答案是:來自組合,而且現有數據無法精確拆分。 OpenAI 將 Astra for Law 定義爲基於 GPT-6 Astra 的法律專業配置,並明確把法律搜索索引稱爲可調用的工具之一。公開說明強調的是配置、檢索、工具和指令,但沒有確認是否做過法律領域微調、蒸餾或獨立參數訓練。
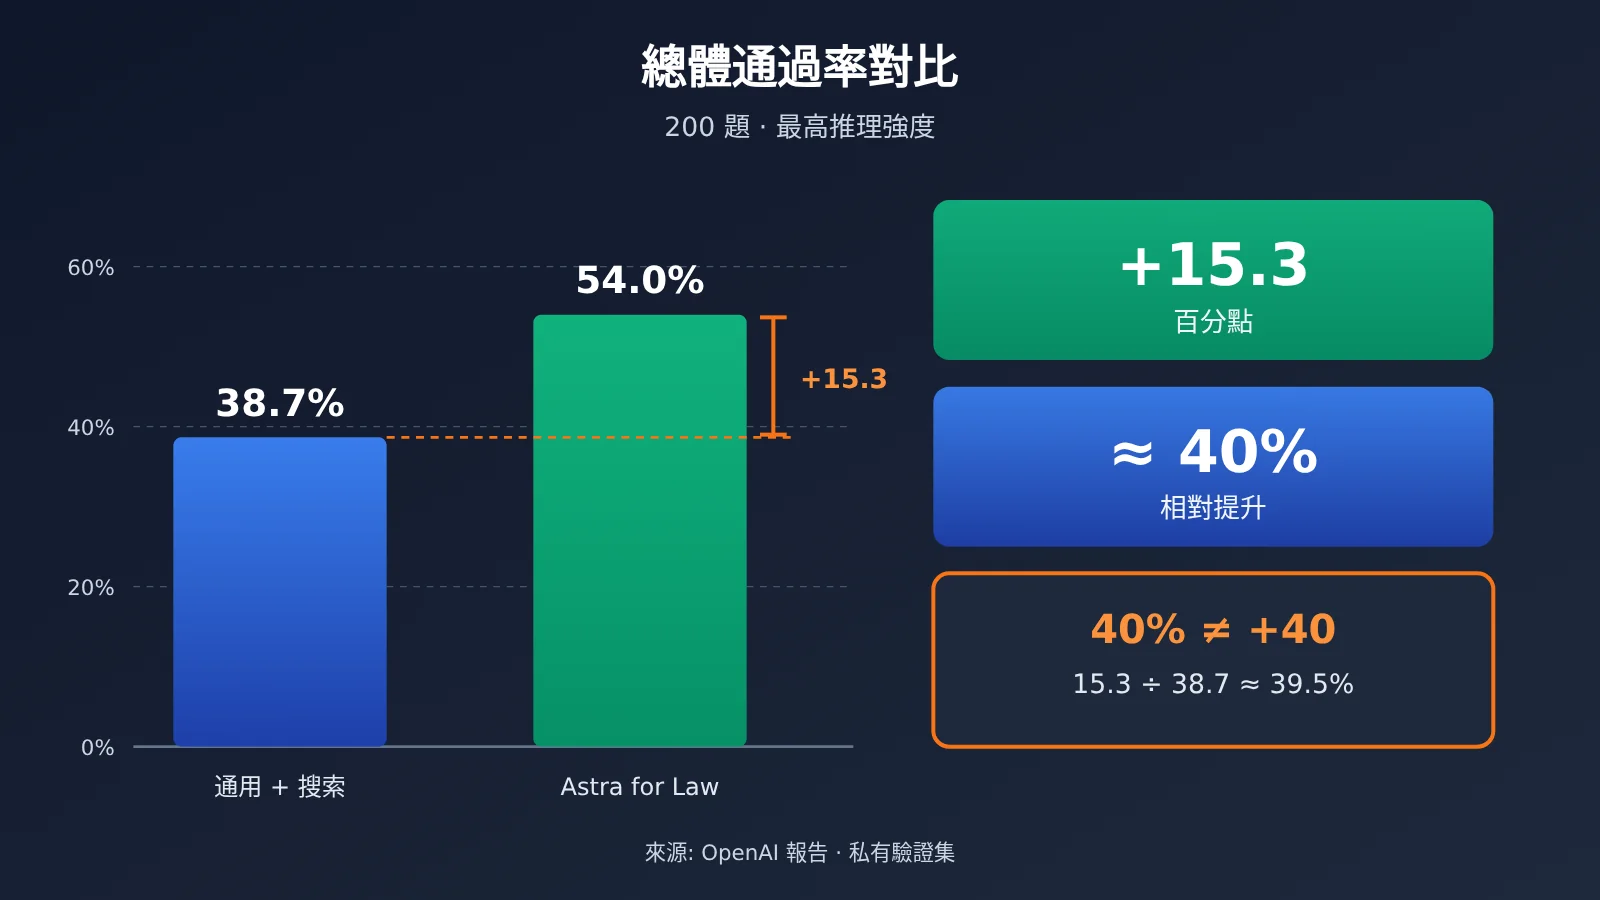
最有力的數據來自 OpenAI 報告的一項測試。它使用 Vals AI Legal Research Bench 私有驗證集中的 200 道美國法律研究題,在最高推理強度下比較兩種配置。
| 對比指標 | Astra for Law | 通用 Astra + 網頁搜索 | 差異 |
|---|---|---|---|
| 總體正確性檢查通過率 | 54.0% | 38.7% | 提升 15.3 個百分點,相對提升約 40% |
| 判例法問題的參考判例數量 | 更多 | 基線 | 多 24% |
| 正確判決書中的相關段落(同等推理強度) | 更多 | 基線 | 最多增加 54% |
從這組結果可以得出三點判斷:
- 基礎模型仍是地基:查找資料後的理解、推理和生成都依賴 GPT-6 Astra,但這組測試沒有單獨測量模型本身的貢獻。
- 檢索指標提升明顯:判例數量和相關段落指標都指向專用檢索更強,但找到更多案例不等於法律意見一定更正確。
- 無法歸因到單一組件:測試比較的是完整配置,索引、指令和其他設置同時發生變化,所以不能寫成“法律索引單獨提升了 40%”。
這項結果還有明確的使用邊界。它是 OpenAI 使用私有驗證集報告的成績,不等於 Vals AI 獨立復現,也不代表法律諮詢、勝訴預測或合同審查的準確率就是 54%。公開榜單上的通用模型結果與這次測試配置不同,同樣不能直接混合排名。
爲什麼法律搜索索引不能只靠網頁搜索替代
法律研究要找的不只是語義相關的文本。法院層級、司法轄區、判例是否具有約束力、是否已被推翻或限制適用,都會影響一份依據的實際價值。同一個合同爭議,在不同州的法律體系下也可能得出不同結論。
普通搜索可以找到相關內容,卻不能保證引用的法律權威真正適用。這正是專用法律索引和專業指令要共同解決的問題,不過也不能據此認爲所有引用都已自動通過有效性驗證。
🎯 技術建議:如果你在做垂直領域知識庫,可以先用同一組題目比較“僅模型”“模型 + 通用搜索”“模型 + 專用知識庫”三種配置。通過 API易 apiyi.com 的統一接口切換模型,能減少重複對接的工作量。
Astra for Law 與傳統 RAG 架構有什麼關係
傳統 RAG 的流程是:用戶提問、查詢知識庫、取回相關片段,再由模型結合上下文生成回答。Astra for Law 在思路上與之相近,都不只依賴模型參數中的知識。但這只是思想層面的相似,不能把常見 RAG 方案直接當成它的內部實現。
| 技術問題 | 公開狀態 | 正確寫法 |
|---|---|---|
| 是否使用法律搜索索引 | 已確認 | 屬於 Astra for Law 可調用的工具 |
| 索引內容類型 | 已確認 | 判例法、成文法、法規、法院規則、行政裁決 |
| 向量或混合檢索方式 | 未公開 | 不應斷言具體方案 |
| Embedding 與 Reranking | 未公開 | 不應推測具體模型或算法 |
| 切塊策略與召回數量 | 未公開 | 不應套用通用參數 |
| 權威性排序實現 | 未公開 | 只能描述目標,不能描述實現 |
OpenAI 的通用 File Search 確實採用向量存儲,並結合語義搜索與關鍵詞搜索。但目前沒有公開信息確認它和法律索引使用同一底層實現,因此其參數不能直接套用到法律版。
用 RAG 思路復現法律研究的基本模式
下面的示例不會調用 gpt-6-astra-law,也無法復現 Legal Search Index。它只演示“檢索依據、限定來源、要求引用”這一通用模式,模型名稱請以實際可用列表爲準。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

context = "[DOC-1] 示例資料:此處放入檢索到的法律片段"
response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[
        {"role": "system", "content": "僅依據給定資料回答,並標註來源編號。資料不足時明確說明。"},
        {"role": "user", "content": f"資料:{context}\n問題:該條款有哪些風險?"}
    ]
)
print(response.choices[0].message.content)
查看帶元數據過濾的完整示例
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 以下均爲虛構演示數據,不是真實法律資料
DOCS = [
    {
        "id": "DOC-1",
        "title": "示例判決 A",
        "jurisdiction": "示例州",
        "year": 2024,
        "text": "示例內容:合同終止條款需要事先書面通知。"
    },
    {
        "id": "DOC-2",
        "title": "示例判決 B",
        "jurisdiction": "其他州",
        "year": 2023,
        "text": "示例內容:合同終止通知可以採用電子方式。"
    }
]


def retrieve(keywords, jurisdiction, top_k=3):
    """按司法轄區過濾,再按關鍵詞命中數和年份排序"""
    candidates = [d for d in DOCS if d["jurisdiction"] == jurisdiction]
    scored = []
    for doc in candidates:
        score = sum(keyword in doc["text"] for keyword in keywords)
        if score > 0:
            scored.append((score, doc["year"], doc))
    scored.sort(key=lambda item: (item[0], item[1]), reverse=True)
    return [item[2] for item in scored[:top_k]]


def answer(question, keywords, jurisdiction):
    docs = retrieve(keywords, jurisdiction)
    if not docs:
        return "未檢索到符合司法轄區要求的資料,請人工複覈。"

    context = "\n".join(
        f"[{d['id']}] {d['title']}({d['jurisdiction']},{d['year']}):{d['text']}"
        for d in docs
    )
    response = client.chat.completions.create(
        model="gpt-6.1-sol",  # 以平臺實際可用模型爲準
        messages=[
            {
                "role": "system",
                "content": (
                    "你是法律研究助手。僅依據給定資料回答,並標註來源編號。"
                    "指出不確定性和缺失信息。輸出僅供專業人員複覈,不構成法律意見。"
                )
            },
            {
                "role": "user",
                "content": f"資料:\n{context}\n\n問題:{question}"
            }
        ]
    )
    return response.choices[0].message.content


print(answer("終止合同是否需要書面通知?", ["合同", "通知"], "示例州"))
建議:可以通過 API易 apiyi.com 獲取免費測試額度,用自己的題集驗證不同模型的表現。評估時建議同時記錄引用是否準確、依據是否適用,而不只看回答讀起來是否流暢。
Astra for Law API 定價對開發者的影響
定價條目透露出一個重要信號:gpt-6-astra-law 與通用 gpt-6-astra 的基礎 Token 單價相同,目前沒有額外溢價。以下爲官方定價頁列出的標準模式費率,促銷價格至少持續到 2026 年 12 月 31 日。
| 模型 | 輸入 / 百萬 Token | 緩存輸入 / 百萬 Token | 輸出 / 百萬 Token |
|---|---|---|---|
gpt-6-astra-law |
$10 | $1 | $50 |
gpt-6-astra |
$10 | $1 | $50 |
gpt-6.1-sol |
$2 | $0.10 | $10 |
gpt-6.1-terra |
$1 | $0.05 | $5 |
按單價計算,10 萬普通輸入 Token 加 1 萬輸出 Token 的費用約爲 $1.50;若輸入全部符合緩存計費條件,則約爲 $0.60。這只是示意賬單,未包含可能發生的工具、檢索或特殊處理費用。法律索引在 API 中如何計費也尚未獲得全面確認,不能默認檢索免費。
💰 成本說明:法律版的 Token 單價是 Sol 的 5 倍,但實際任務成本還取決於輸出長度、工具調用和任務成功率。預算敏感的項目可以先通過 API易 apiyi.com 用現有模型跑通檢索流程,再按完整任務成本評估升級必要性。
對開發者的影響
- 能力建設重心變化:垂直 AI 的競爭不只在模型選擇,還包括數據質量、來源追溯和專業規則設計。
- 評估方式需要升級:應在同一題集上比較完整配置,並把引用準確性和轄區適用性納入指標。
- 上線計劃要留餘地:開放日期、速率限制和工具參數都未確認,暫不宜把它作爲產品上線的唯一依賴。
對法律 AI 行業的影響
- 競爭繼續升溫:Anthropic、Google、Thomson Reuters、Harvey 和 Legora 都在推進法律 AI 產品或能力。
- 競合關係並存:Harvey、Legora 既可能是競爭者,也被 OpenAI 列爲未來的 API 客戶。
- 律所知識仍有價值:Sullivan & Cromwell 的合同分析器引入了內部談判手冊和歷史合同先例,說明公共法律索引並不能替代組織知識。Ropes & Gray、Cooley 等合作案例也有類似特點,但不能都視爲最終版 API 的生產實測。
常見問題 FAQ
Q1:Astra for Law 是獨立訓練的法律模型嗎?
目前沒有證據支持這種說法。官方定位是基於 GPT-6 Astra 的法律專業配置,包含法律索引、專業指令和工具。是否額外進行過法律領域微調或參數訓練,尚無公開確認。
Q2:54.0% 是否代表法律諮詢準確率?
不代表。54.0% 是特定法律研究測試中的總體正確性檢查通過率,不適用於所有法律場景,也不代表勝訴率或合同審查準確率。產品輸出仍需要律師審覈。
Q3:現在可以調用 gpt-6-astra-law 嗎?
不能據此認爲普通開發者已可調用。官方幫助中心仍說明,產品初期面向符合資格的美國律所,API 將在未來開放。模型標識和價格公開,不等於所有 API Key 都有訪問權限。
Q4:2.3 億 URL 適合中國法律場景嗎?
目前無法確認。該索引明確以美國法律材料爲核心,沒有可信官方材料證明它對中國法律具有同等級覆蓋。中國場景需要接入合規的本地數據源,並單獨進行實測。
Q5:現階段如何驗證類似的法律 RAG 方案?
可以按三步進行:
1. 在 API易 apiyi.com 註冊並獲取 API Key 和免費測試額度。
2. 用本文示例接入自有的合規法律資料。
3. 建立帶標準答案的題集,比較不同模型和檢索方案。
Q6:Astra for Law 目前有哪些限制?
主要限制是訪問範圍窄、API 細節未公開,也缺少獨立第三方的大規模實測。延遲、吞吐、真實錯誤率和單案成本等數據同樣不足。隱私控制也不能消除幻覺或錯誤引用,正式結論仍需人工複覈。如果想先比較通用模型的表現,可以通過 API易 apiyi.com 做小規模測試。
Astra for Law 核心要點 Key Takeaways
- 產品本質:Astra for Law 是基於 GPT-6 Astra 的法律專業配置,並非已確認的獨立模型。
- 索引規模:2.3 億是 URL 數量,不是判決書數量,覆蓋重點是美國法律資料。
- 能力來源:專業表現來自模型、索引、指令和工作流的組合,現有數據無法精確拆分。
- 測試成績:54.0% 對比 38.7% 是官方報告結果,相對提升約 40%。
- 價格信號:法律版與通用 Astra 基礎單價相同,檢索工具費用仍未完全確認。
- API 狀態:價格已公開,但普通開發者的開放時間和權限尚未確認。
- 落地方式:可先通過 API易 apiyi.com 測試通用模型,驗證自有知識庫和檢索流程。
總結:Astra for Law 2.3 億 URL 帶來的啓示
回到最初的問題,Astra for Law 的專業能力不能簡單歸功於模型或索引。模型負責理解、推理和生成,法律搜索索引提供可追溯的依據,專業指令規範分析和寫作方式,律所知識則把能力帶入實際工作流。
官方測試證明了完整配置在特定法律研究任務中的優勢,卻沒有給出各組件的貢獻比例。對開發者來說,更實際的做法是先建好自己的數據、檢索和評測體系,並持續關注 API 的正式開放信息。
如果你正在規劃專業知識庫應用,推薦通過 API易 apiyi.com 用統一接口對比多個模型,先以較低成本驗證方案的可行性。
📚 參考資料
- OpenAI:Astra for Law 產品發佈:產品定位、索引規模、測試結果和合作案例
- 鏈接:
openai.com/index/astra-for-law -
說明:本文核心技術信息和官方測試數據的主要來源
-
OpenAI API 定價頁面:法律配置的模型標識和 Token 價格
- 鏈接:
developers.openai.com/api/docs/pricing -
說明:可覈實價格和促銷期限,建議調用前再次確認
-
OpenAI 幫助中心:Astra for Law:訪問資格與 API 開放狀態
- 鏈接:
help.openai.com/en/articles/20001528-astra-for-law -
說明:判斷當前能否使用時應優先查看
-
Free Law Project:CourtListener 數據覆蓋:美國判例數據來源和覆蓋範圍
- 鏈接:
wiki.free.law/c/courtlistener/help/data-coverage/case-law -
說明:有助於理解 99.9% 覆蓋率的準確口徑
-
Vals AI Legal Research Bench:法律研究測試方法和公開榜單
- 鏈接:
www.vals.ai/benchmarks/legal_research -
說明:適合用來設計法律 AI 的評測維度
-
OpenAI File Search 技術說明:通用文件檢索工具的工作方式
- 鏈接:
developers.openai.com/api/docs/guides/tools-file-search -
說明:可作爲 RAG 技術參照,但不代表法律索引的內部實現
-
Reuters:OpenAI 法律業務發佈報道:法律 AI 市場競爭背景
- 鏈接:
www.reuters.com/legal/litigation/openai-launches-legal-focused-ai-platform-escalating-race-law-firm-users-2026-09-17 - 說明:有助於瞭解行業競爭格局
作者:API易技術團隊
技術交流:歡迎在 API易網站首頁聯繫我們,更多資料可訪問 docs.apiyi.com 文檔中心