作者注:基於 OpenAI Images 2.6 安全系統卡,解讀 AI 動圖審覈的時間維度難題、77.66% 召回率的含義,以及開發者如何處理審覈攔截。
2026 年 11 月 4 日,OpenAI 隨 Images 2.6 發佈安全系統卡,並披露了一組專門針對動圖的測試結果:在 310 個已標註違規的 GIF 樣本上,審覈機制的 召回率爲 77.66%。這個數字很容易被誤讀,它既不是線上違規率,也不是審覈系統的總體準確率。
這不是一份渲染風險的解讀。本文以官方系統卡和 API 文檔爲依據,並明確區分官方事實、測試結果和我們的技術分析。
核心價值:3 分鐘瞭解 AI 動圖審覈爲什麼更難、這些數字該怎麼讀,以及開發者需要調整什麼。
AI 動圖審覈核心信息速覽
| 信息項 | 官方披露內容 | 閱讀時要注意 |
|---|---|---|
| 發佈時間 | 2026 年 11 月 4 日隨 Images 2.6 發佈 | 事實截至 2026 年 11 月 5 日 |
| 新增風險 | 部分違規含義體現在連續動作和幀間關係中 | 系統卡將其與靜態圖片評估分開討論 |
| 新增防護 | 聯合審覈動畫幀網格(frame grid)和生成說明(generation caption) | 具體算法與幀採樣方式未公開 |
| GIF 測試 | 310 個違規 GIF 樣本,召回率 77.66% | 針對性樣本,不代表普通用戶內容分佈 |
| 靜態圖片測試 | 3,077 條對抗性請求 | 屬於離線評估,與 GIF 測試的口徑不同 |
爲什麼 AI 動圖比靜態圖片更難審覈
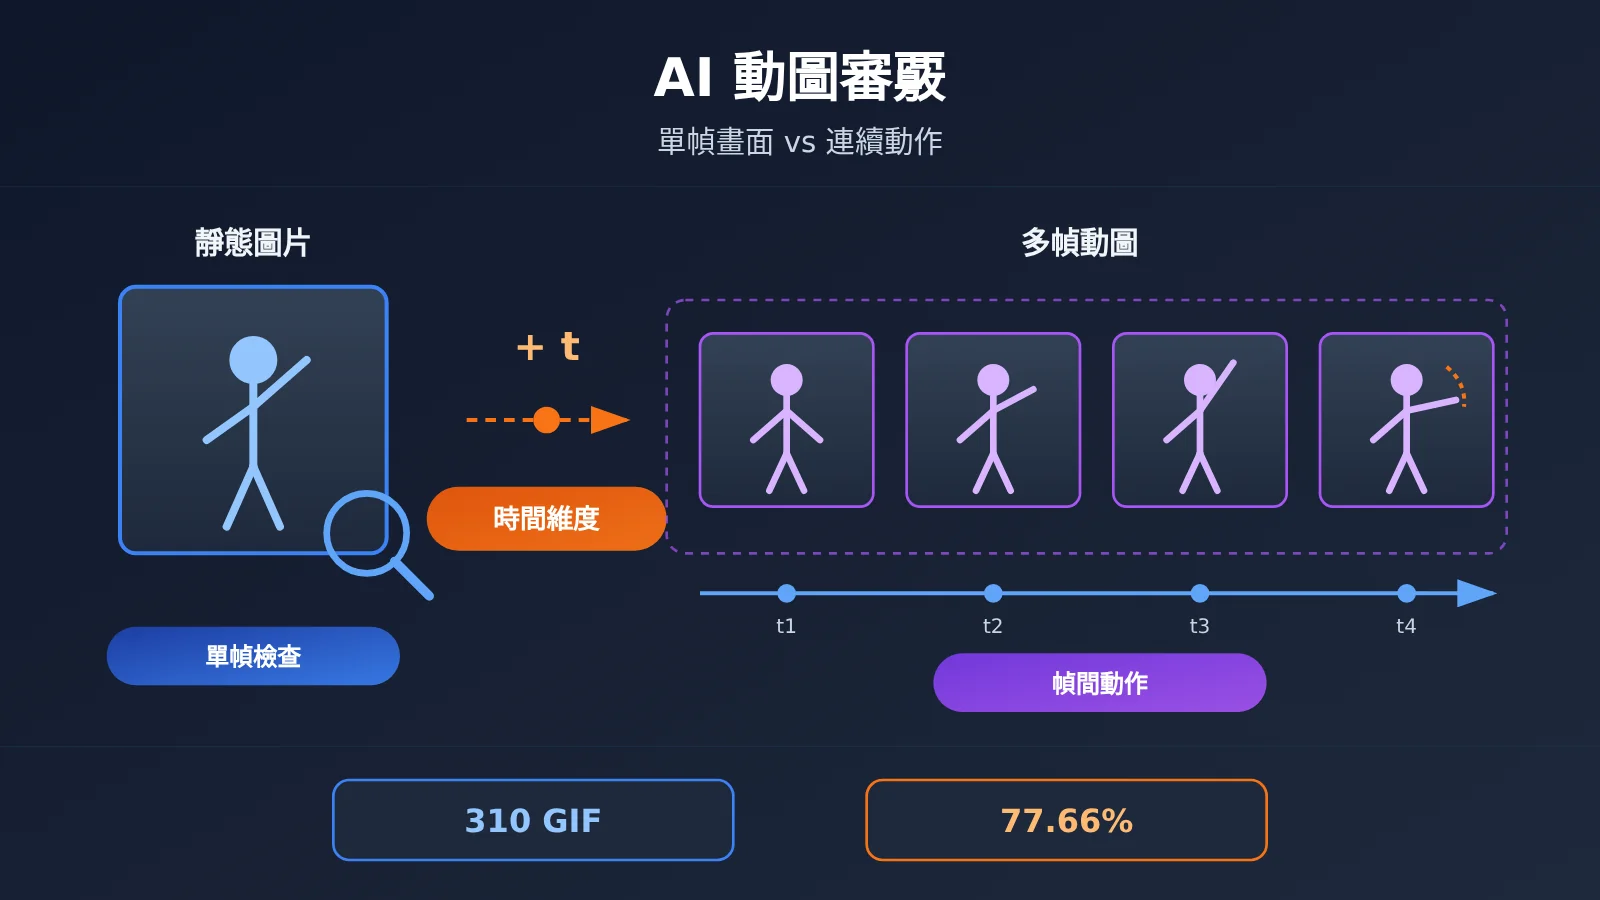
OpenAI 在系統卡第 3.2.2 節指出,某些違規含義存在於動作過程中,而不在某一幀裏。多幀之間的關係、同一元素的運動方式,都可能改變內容的含義。因此,孤立分析靜態畫面可能無法充分判斷動畫風險。官方舉出的風險類別之一,是帶有性意味的動作。
下面用一個我們自擬的中性例子說明,它並非官方案例。一張“手臂抬起”的圖片信息有限,單看這一幀,很難判斷對方是在打招呼還是準備攻擊。只有看到後續幀中手臂是左右擺動,還是快速揮向另一個人,才能得出更可靠的判斷。單幀回答的是“畫面裏有什麼”,連續幀還要回答“正在發生什麼”。
由此可以歸納出動圖審覈的三個額外判斷點。這部分是我們的技術分析,不代表 OpenAI 披露的算法細節:
- 時間順序:相同的幾幀換一種排列,可能呈現完全不同的事件。
- 動作關係:人物或物體之間是靠近、接觸還是分開,往往要跨幀才能看清。
- 整體語義:每一幀單看都不違規,並不代表連起來播放後依然合規。
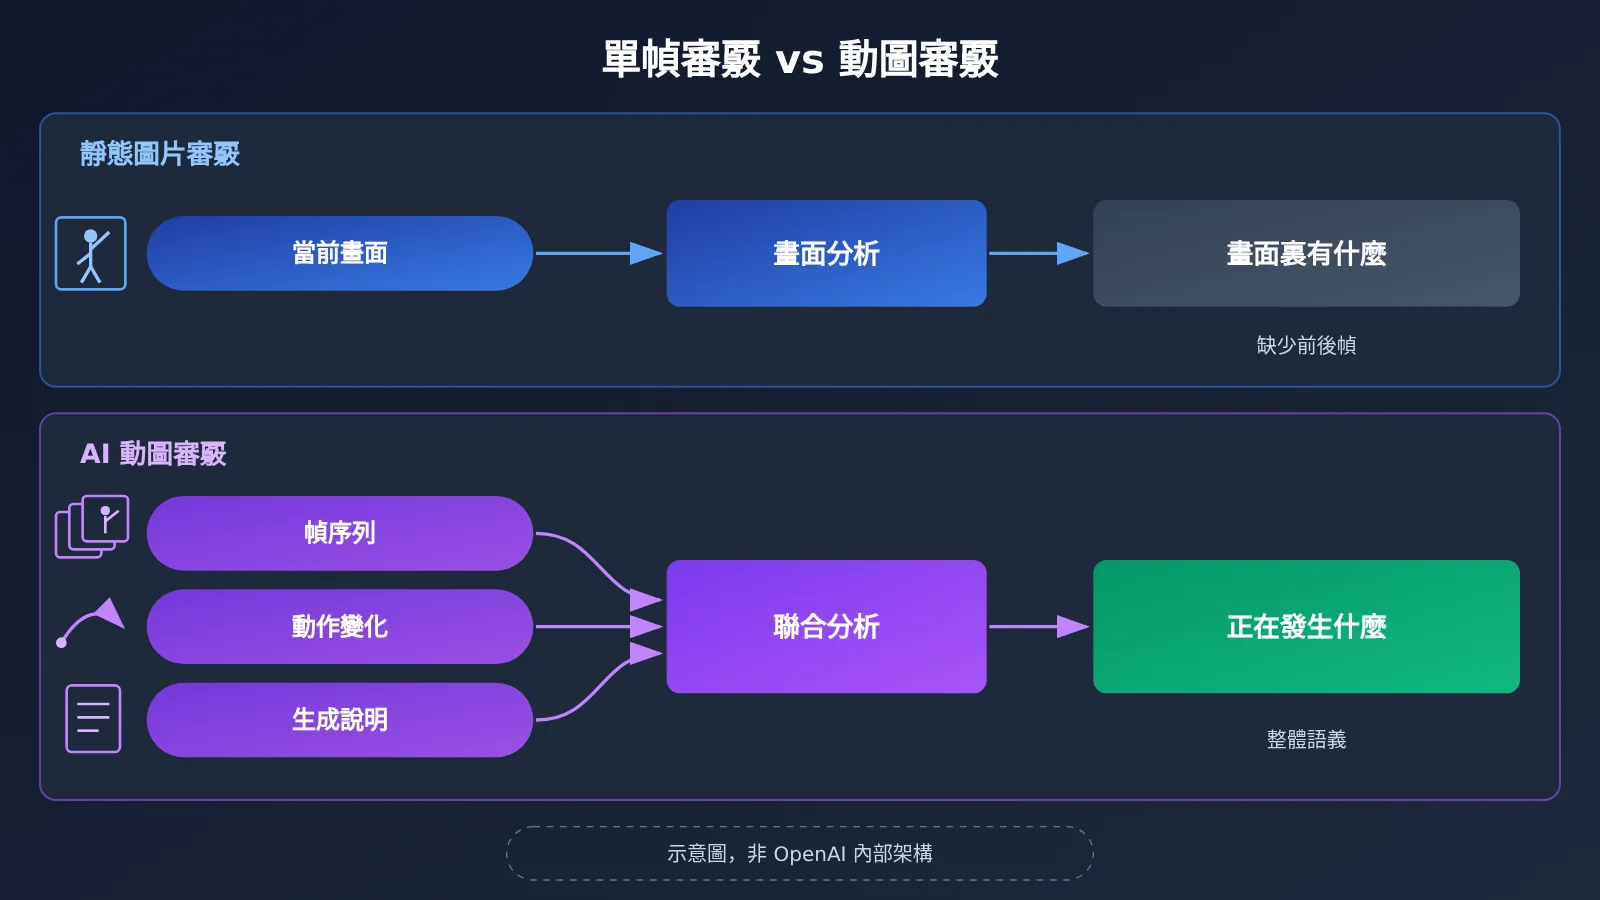
AI 動圖審覈與靜態圖片審覈的差異
| 對比維度 | 靜態圖片審覈 | AI 動圖審覈 |
|---|---|---|
| 判斷對象 | 單個畫面的視覺內容 | 整組幀及其整體語義 |
| 關鍵信息 | 物體、場景、文字等 | 還包括動作、順序、幀間關係 |
| 官方新增措施 | 沿用多層安全檢查 | 幀網格加生成說明的聯合審覈 |
| 攔截策略 | 按現有政策判斷 | 部分類別採用更寬的攔截範圍 |
| 公開數據缺口 | 有 3,077 條對抗性請求評估 | 缺少誤報率、延遲和第三方複測 |
API 參數也能說明這個問題的複雜度。官方文檔顯示,GIF 輸出支持 2 到 64 幀,默認 9 幀;每幀時長可設爲 20 到 2000 毫秒,默認 200 毫秒。我們認爲,幀數越多,審覈時越需要兼顧細節與成本,而播放節奏也可能影響觀感。但官方並未公開是否逐幀分析所有畫面,也未說明幀時長如何參與判斷。
OpenAI 如何審覈 AI 動圖:多層機制加幀網格
根據系統卡第 3.1 節,Images 2.6 的靜態圖像安全系統由三層檢查組成,GIF 防護是在此基礎上增加的額外機制。
- 生成前的請求審覈:用基於語言模型的政策檢查判斷用戶請求,不合規的請求可能在進入生成階段前被拒絕。
- 輸入審覈:用多模態安全推理模型檢查提示詞和輸入圖片,並判斷編輯請求是否具有違規意圖。
- 輸出審覈:審查生成結果,在展示給用戶之前攔截被判定違規的內容。
對於 GIF,官方說明安全推理模型會檢查整組動畫幀,同時參考生成說明,並結合時間上的動作變化作出判斷。某些內容類別還採用了比靜態圖像更寬的攔截範圍,以覆蓋推斷出的動作風險。這說明審覈對象已從孤立的畫面,擴展到動畫的整體語義。
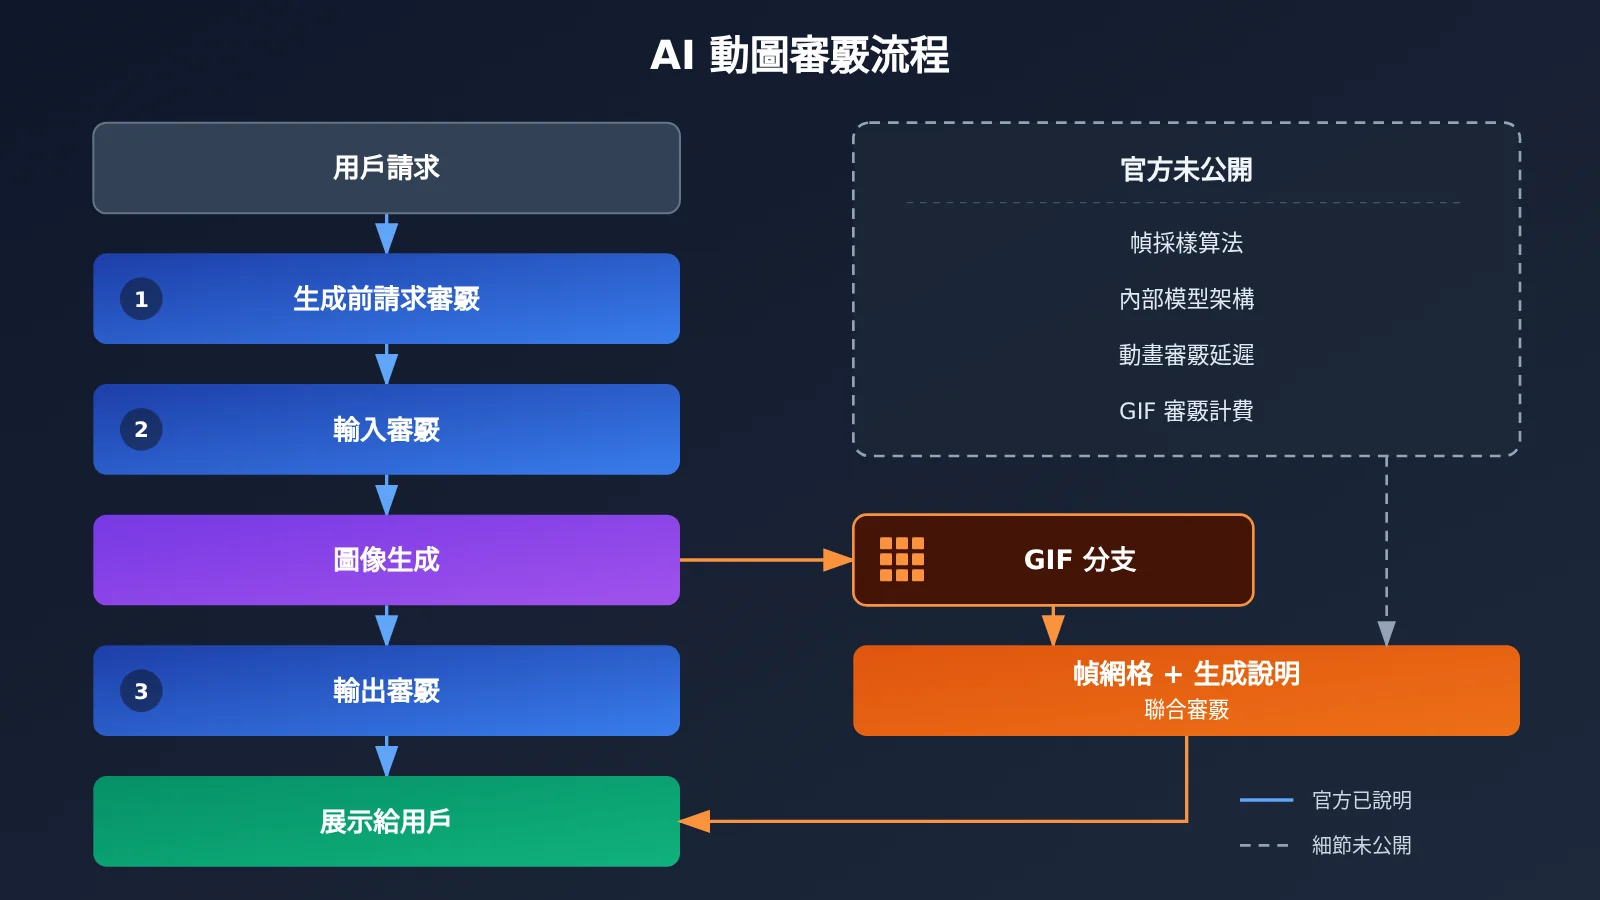
官方沒有公開的內容同樣值得注意,包括幀採樣算法、內部模型架構、動畫審覈引入的延遲,以及 GIF 審覈的單獨計費方式。如果你想了解審覈攔截在自己業務中如何表現,可以通過 API易 apiyi.com 的統一接口先跑通錯誤處理流程,再結合實際模型逐項驗證。
如何理解 AI 動圖審覈的 77.66% 召回率
這項測試針對 310 個被標註爲違反政策的 GIF,對生成說明和動畫幀網格進行聯合審覈。召回率回答的問題是:在這批已知違規樣本中,有多大比例被審覈機制檢測到。OpenAI 也明確承認,基於動作的違規仍然難以檢測,現有措施可能遺漏部分違規內容。
| 這個數字 | 判斷 | 原因 |
|---|---|---|
| 是已知違規樣本的檢出比例 | ✅ 可以這樣理解 | 這正是召回率的測試含義 |
| 是審覈系統的總體準確率 | ❌ 不能這樣理解 | 測試只覆蓋違規樣本 |
| 是正常內容的通過率 | ❌ 不能這樣理解 | 樣本中沒有用於計算該指標的正常內容 |
| 22.34% 是線上違規 GIF 的出現概率 | ❌ 不能這樣理解 | 樣本經過針對性選取,不代表真實分佈 |
| 能說明誤報情況 | ❌ 不能這樣理解 | 測試未提供誤報率或完整精確率 |
所以,77.66% 更適合作爲衡量“困難樣本檢出能力”的參考,而不是對線上安全水平的總體評價。它的價值在於官方給出了可討論的測試結果,同時也暴露了動作類風險尚未完全解決。
3,077 條對抗測試揭示的 AI 圖片審覈分層邏輯
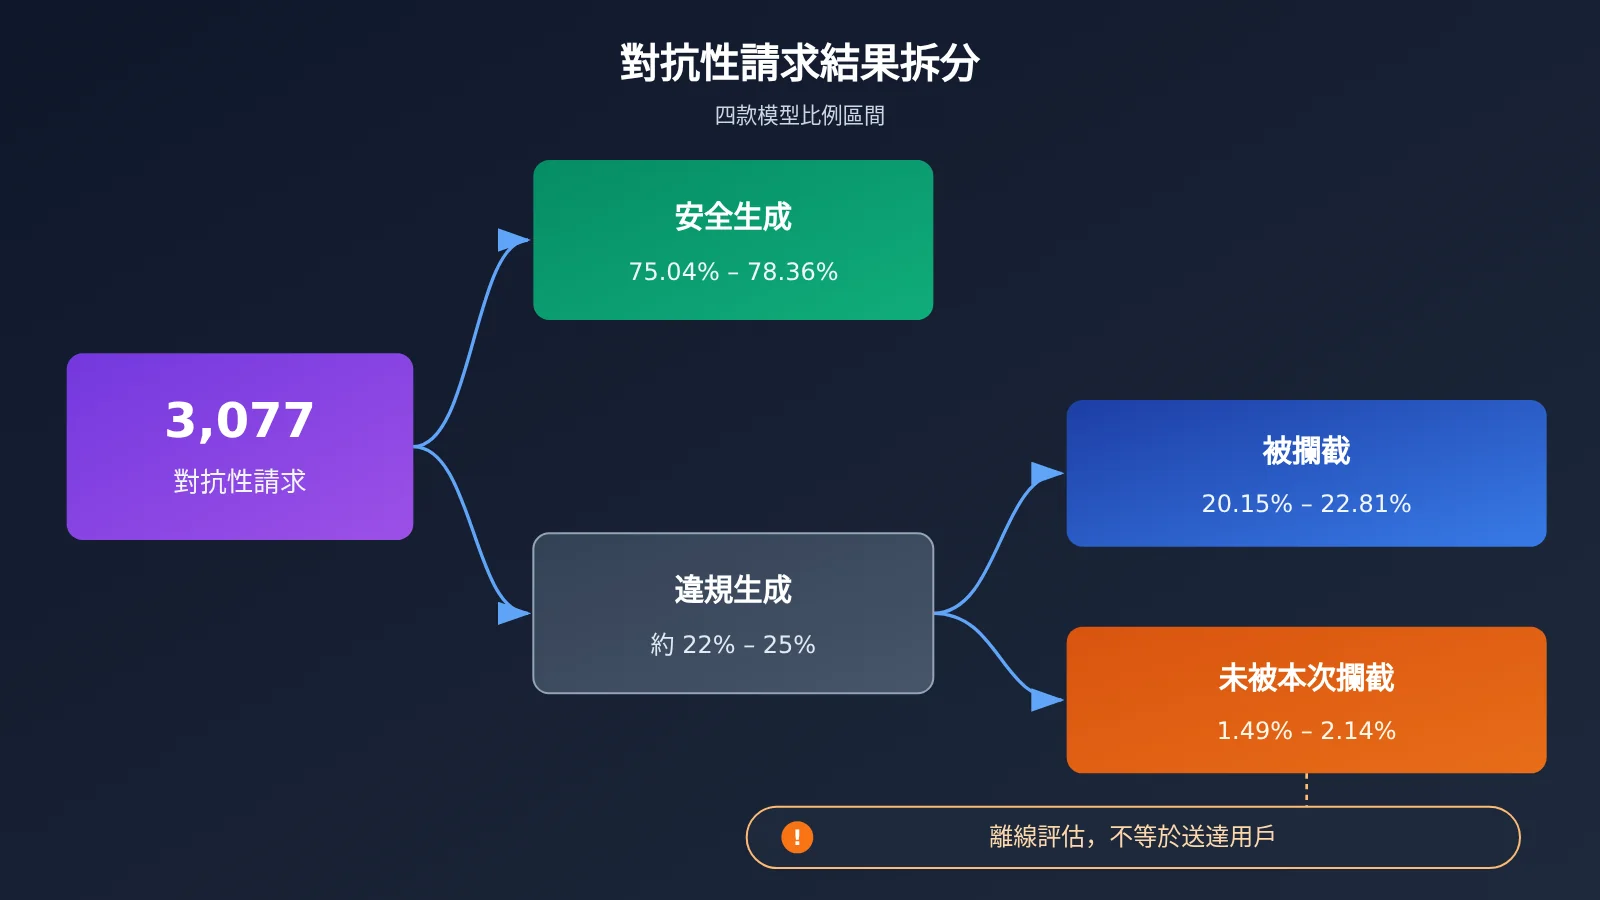
系統卡還用 3,077 條專門設計的困難請求評估靜態圖片安全。需要強調的是,這組數據不是 GIF 測試結果,但它清楚地展示了“模型自身安全”“審覈攔截能力”“最終未攔截結果”是三個不同的指標。
| 模型(靜態圖片評估) | 安全生成 | 違規生成且被攔截 | 違規生成未被本次審覈攔截 |
|---|---|---|---|
| GPT-Image-2.5 Sunburst | 76.15% | 21.94% | 1.92% |
| GPT-Image-2.6 Sunburst | 75.50% | 22.78% | 1.72% |
| GPT-Image-2.5 Flare | 78.36% | 20.15% | 1.49% |
| GPT-Image-2.6 Flare | 75.04% | 22.81% | 2.14% |
這些數據不支持“新版全面更安全”或“新版更危險”的簡單結論。官方說明,Sunburst 和 Flare 的總體未攔截比例變化都沒有達到統計顯著性。不過,Flare 的安全生成比例從 78.36% 降至 75.04%,這一變化具有統計顯著性。
“未被本次審覈攔截”也只是離線評估結果,不等於違規內容實際送達了用戶。此外,77.66% 與這組靜態數據的樣本和機制都不相同,不宜直接比較後得出“動圖比圖片差多少”的結論。
AI 動圖審覈對開發者和內容平臺的影響
對 API 開發者:把審覈攔截當成正常業務狀態
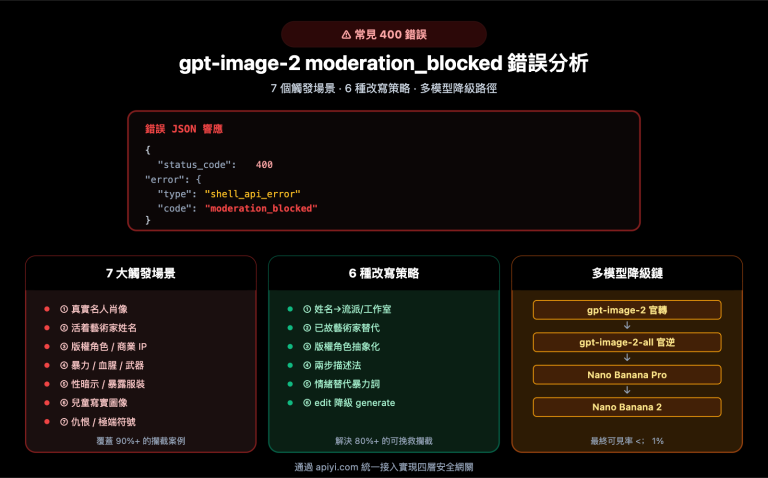
OpenAI 圖像 API 的 moderation 參數支持 auto 和 low 兩個取值,其中 low 只是過濾限制相對較少,並不等於關閉安全系統。請求被攔截時,可能返回 error.code = "moderation_blocked"。部分錯誤還會附帶審覈階段和粗粒度類別,但這些字段不保證每次返回。
| 字段或動作 | 官方說明 | 落地建議 |
|---|---|---|
error.code |
可能爲 moderation_blocked |
作爲錯誤分支的主要判斷依據 |
moderation_stage |
可能是 input、output、unknown |
寫入日誌,供客服和排查使用 |
categories |
如 sexual、violence 等粗粒度類別 |
按存在與否處理,不作爲必需字段 |
| 用戶提示 | 清晰但不過度透露內部規則 | 引導用戶修改描述 |
| 重試策略 | 不自動重試需用戶修正輸入的審覈錯誤 | 由用戶修改後重新提交 |
下面的極簡示例演示如何捕獲審覈攔截,請把模型名替換爲你實際可用的模型:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

try:
    result = client.images.generate(model="YOUR_IMAGE_MODEL", prompt="一隻揮手的卡通吉祥物")
except openai.APIStatusError as e:
    if e.code == "moderation_blocked":
        print("內容未通過審覈,請修改描述後重新提交")
    else:
        raise
查看 GIF 生成與審覈日誌完整示例
import base64
import logging
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def generate_gif(prompt: str, model: str = "YOUR_IMAGE_MODEL") -> str | None:
    try:
        result = client.images.generate(
            model=model,
            prompt=prompt,
            extra_body={
                "output_format": "gif",
                "frame_count": 9,
                "frame_duration_ms": 200,
            },
        )
    except openai.APIStatusError as e:
        if e.code != "moderation_blocked":
            raise
        # 詳情字段不保證返回,需要做兼容處理
        body = e.body if isinstance(e.body, dict) else {}
        details = body.get("moderation_details") or {}
        logging.warning(
            "moderation_blocked stage=%s categories=%s",
            details.get("moderation_stage"),
            details.get("categories"),
        )
        # 不自動重試,交由用戶修改描述
        return None

    with open("output.gif", "wb") as f:
        f.write(base64.b64decode(result.data[0].b64_json))
    return "output.gif"
以上 GIF 參數來自 OpenAI 官方文檔。官方的 GIF 輸出屬於 `images/generations` 功能,`images/edits` 接口不支持直接輸出 GIF。
建議:先用穩定的
error.code建立錯誤分支,再補充日誌和界面提示。可以通過 API易 apiyi.com 獲取免費測試額度來驗證調用流程;具體模型和 GIF 參數的支持情況,請以平臺最新模型列表和文檔爲準。
對內容平臺:誤報和漏報都要有處理路徑
官方尚未公佈 GIF 審覈的誤報率。不過,部分類別採用更寬的攔截範圍,這意味着平臺應當考慮正常創作被誤攔的可能,並設計好提示和申訴渠道。同時,官方也承認可能存在遺漏,所以允許用戶發佈和傳播 GIF 的平臺,不宜把上游審覈當作唯一防線。
以下是我們的實踐建議,不是官方要求:
- 發佈前複覈:對公開傳播的內容保留平臺自身的政策檢查和用戶舉報入口。
- 按完整動畫複覈:人工或自動複覈時不要只看封面幀,要結合完整播放效果。
- 分開記錄:將“請求被攔截”“發佈後被舉報”分開統計,便於定位問題環節。
對來源識別:水印不能替代內容審覈
系統卡介紹了多層來源識別方案,包括繼續支持 C2PA 元數據,以及引入 Google DeepMind 的 SynthID 隱形水印。前者主要記錄來源信息,後者則將不可見信號嵌入媒體內容。但這並不意味着每個導出的 GIF 都一定帶有可驗證水印,也不能保證水印經過壓縮或轉碼後依然保留。
未檢測到水印,同樣不能證明內容不是 AI 生成的。OpenAI 也承認不存在單一、完整的來源識別方案。來源標記回答的是“它可能從哪裏來”,審覈回答的是“它能否被生成或傳播”,兩者應該互相補充。
AI 動圖審覈常見問題 FAQ
Q1:77.66% 是否說明 22.34% 的違規動圖已經發給了用戶?
不能這樣解讀。77.66% 是 310 個已標註違規 GIF 上的測試召回率,樣本經過針對性選取,既不反映線上內容分佈,也不是真實違規內容的送達概率。
Q2:AI 動圖審覈能否直接用靜態圖片分類器逐幀檢查?
逐幀檢查可以發現部分單幀違規,但難以覆蓋只有在連續動作中才顯現的含義。因此,動圖審覈不等於簡單地把每幀分別輸入靜態分類器。OpenAI 的做法是結合幀網格和生成說明進行聯合審覈,具體算法並未公開。
Q3:目前有獨立的 GIF 審覈複測數據嗎?
截至 2026 年 11 月 5 日,本文掌握的資料中尚無可靠公開的獨立第三方複測。不同動畫長度下的性能、誤報率、實際延遲和各類違規動作的細分檢出率也都缺少公開數據。
Q4:把 moderation 設爲 low,能關閉 AI 動圖審覈嗎?
不能。`low` 只是限制相對較少的過濾模式,並不等於關閉安全系統或繞過內容政策。生產環境建議從默認的 `auto` 開始,並根據業務場景評估是否需要調整。
Q5:收到 moderation_blocked 後應該怎麼處理?
建議停止自動重試,向用戶展示清晰的修改提示,並在日誌中記錄可用的審覈階段和類別。想快速驗證這條錯誤處理鏈路,可以在 API易 apiyi.com 註冊並獲取測試額度,把本文示例中的模型名替換爲平臺當前可用的模型後運行。
Q6:如何在不同圖像模型之間比較審覈差異?
建議準備一組符合政策、貼近業務且邊界清晰的測試提示詞,分別記錄生成結果、攔截情況和錯誤字段。通過 API易 apiyi.com 的統一接口可以減少切換模型時的代碼改動,但測試結果只適用於你的樣本,不應推廣成模型的總體安全結論。
AI 動圖審覈核心要點 Key Takeaways
- 核心難點:違規含義可能存在於動作過程和幀間關係中。
- 官方措施:在多層審覈基礎上,聯合審覈幀網格與生成說明。
- 關鍵數字:77.66% 是 310 個違規 GIF 樣本上的召回率。
- 常見誤讀:該數字不是線上違規率、總體準確率或正常內容通過率。
- 評估方法:模型自身安全、審覈攔截和最終未攔截結果要分開看。
- 數據缺口:GIF 誤報率、審覈延遲和第三方複測目前都缺少可靠公開數據。
- 落地動作:以
error.code處理攔截,可通過 API易 apiyi.com 驗證調用流程。
總結
AI 動圖不僅增加了生成維度,也給內容安全判斷增加了時間維度。審覈系統不能只看“畫面裏有什麼”,還要判斷“這些畫面連起來在表達什麼”。
OpenAI 的幀網格聯合審覈和 310 個 GIF 樣本的測試結果,體現了這一思路,也說明動作類風險仍未完全解決。在誤報率和第三方複測缺位的情況下,開發者和平臺更應該關注測試範圍,併爲攔截、誤攔和漏檢都設計好處理路徑。
如果你正在把圖像生成接入產品,可以通過 API易 apiyi.com 先用免費額度驗證接口調用和錯誤處理,再結合平臺文檔確認具體模型與參數的支持情況。
📚 參考資料
- OpenAI:ChatGPT Images 2.6 System Card:多層審覈與 GIF 風險的主要來源
- 鏈接:
deploymentsafety.openai.com/chatgpt-images-2-6 -
說明: 重點查看 3.1、3.2.1、3.2.2 和第 4 節
-
OpenAI:System Card PDF:310 個 GIF 樣本測試數據的出處
- 鏈接:
deploymentsafety.openai.com/chatgpt-images-2-6/chatgpt-images-2-6.pdf -
說明: 適合覈對本文引用的評估數字和測試範圍
-
OpenAI API:Image generation 文檔:開發者接口說明
- 鏈接:
developers.openai.com/api/docs/guides/image-generation -
說明: 包含 GIF 參數、
moderation參數和審覈錯誤處理建議 -
OpenAI:Introducing Images 2.6:官方發佈公告
- 鏈接:
openai.com/index/introducing-images-2-6 - 說明: 用於瞭解 GIF 功能的發佈背景和產品範圍
作者:API易 技術團隊
技術交流:歡迎在 API易 apiyi.com 網站首頁聯繫我們,更多資料可訪問 docs.apiyi.com 文檔中心