作者注:本文拆解 Flint-interactive 如何用“語義事件 + 更新操作”降低 agent 生成交互圖表的成本與出錯率,並梳理三種接入路徑。
如果你在做數據分析或報表類 AI agent,可能已經遇到過這種情況:agent 能很快畫出一張靜態圖,但只要加上“點擊篩選”或“框選聯動”,就要反覆改上好幾輪。一會兒佈局錯位,一會兒高亮失效,修好一處又壞掉另一處,token 和時間都花在了調試上。
微軟研究院在 2026 年 10 月 22 日發佈了 Flint-interactive,它是構建在 Flint 之上的一門交互式數據可視化語言。本文不推薦新的圖表庫,而是把 Flint-interactive 當作一個案例,討論怎樣爲 agent 設計高層輸出規格,讓它少寫底層渲染代碼。
核心價值:讀完本文,你會理解 agent 生成交互圖表時的成本和可靠性瓶頸,掌握“視覺邏輯交給編譯器、交互邏輯用語義事件描述”的設計思想,並知道對話內、應用內、自定義交互這三條接入路徑分別適合什麼場景。
爲什麼讓 agent 直接寫 Flint-interactive 之外的交互代碼成本高
讓 agent 直接寫交互圖表代碼,看上去最靈活。但研究博客指出,即使使用能力很強的前沿模型,實際落地時仍然有兩個明顯的瓶頸。
第一個瓶頸是生成成本高。agent 很少能一輪就交付令人滿意的交互圖表,通常要經過多輪推理、編碼和調試,每一輪都消耗 token 和時間。第二個瓶頸是可靠性差。交互式可視化本身就複雜,表現力強的交互圖表很容易出現佈局錯亂或交互失效,而且修復時還可能引入新的問題。
那麼,直接使用圖表庫自帶的交互是否可行?博客的判斷是,一些可視化庫的內置交互表現力不夠,很難做出定製化的交互圖表。歸根結底,缺少的是一門“既有表現力、又足夠高層”的交互描述語言。
| 方案 | agent 需要輸出的內容 | 主要問題 | 適合程度 |
|---|---|---|---|
| 直接寫底層渲染代碼 | 事件監聽、命中檢測、重繪邏輯 | 多輪調試,token 消耗大,容易改出新 bug | 表現力最強,穩定性差 |
| 只用圖表庫內置交互 | 開關幾個配置項 | 交互種類有限,難以定製 | 穩定,但表現力不足 |
| Flint-interactive 規格 | 語義事件到更新操作的映射 | 需要學習新的規格體系 | 兼顧表現力與可靠性 |
如果你的 agent 背後需要頻繁切換模型來跑這類多輪生成任務,可以通過 API易 apiyi.com 的統一接口接入多個主流模型。同一套調用代碼就能對比不同模型的輪次和消耗,先摸清“寫底層代碼”這條路在你的場景裏到底有多貴。
Flint-interactive 核心要點
| 要點 | 說明 | 對開發者的價值 |
|---|---|---|
| 語義事件 | 編譯器把點擊、拖拽、按鍵等原始觸發解析成“選中了哪些圖表元素和數據” | agent 不需要處理像素座標和命中檢測 |
| 更新操作 | 用 set-style、set-annotation、set-viewport 等高層操作描述畫面變化 | 不必操作渲染器特定的圖形標記 |
| Flint Canvas 狀態機 | 跟蹤畫布上的用戶交互,管理渲染狀態 | 運行時由框架託管,減少狀態錯亂 |
| 可組合 | 事件生成和視覺更新都是可組合的,能連接表格、文本、組件 | 可以搭建數據故事和聯動儀表盤 |
語義事件:Flint-interactive 只關心“用戶選中了什麼數據”
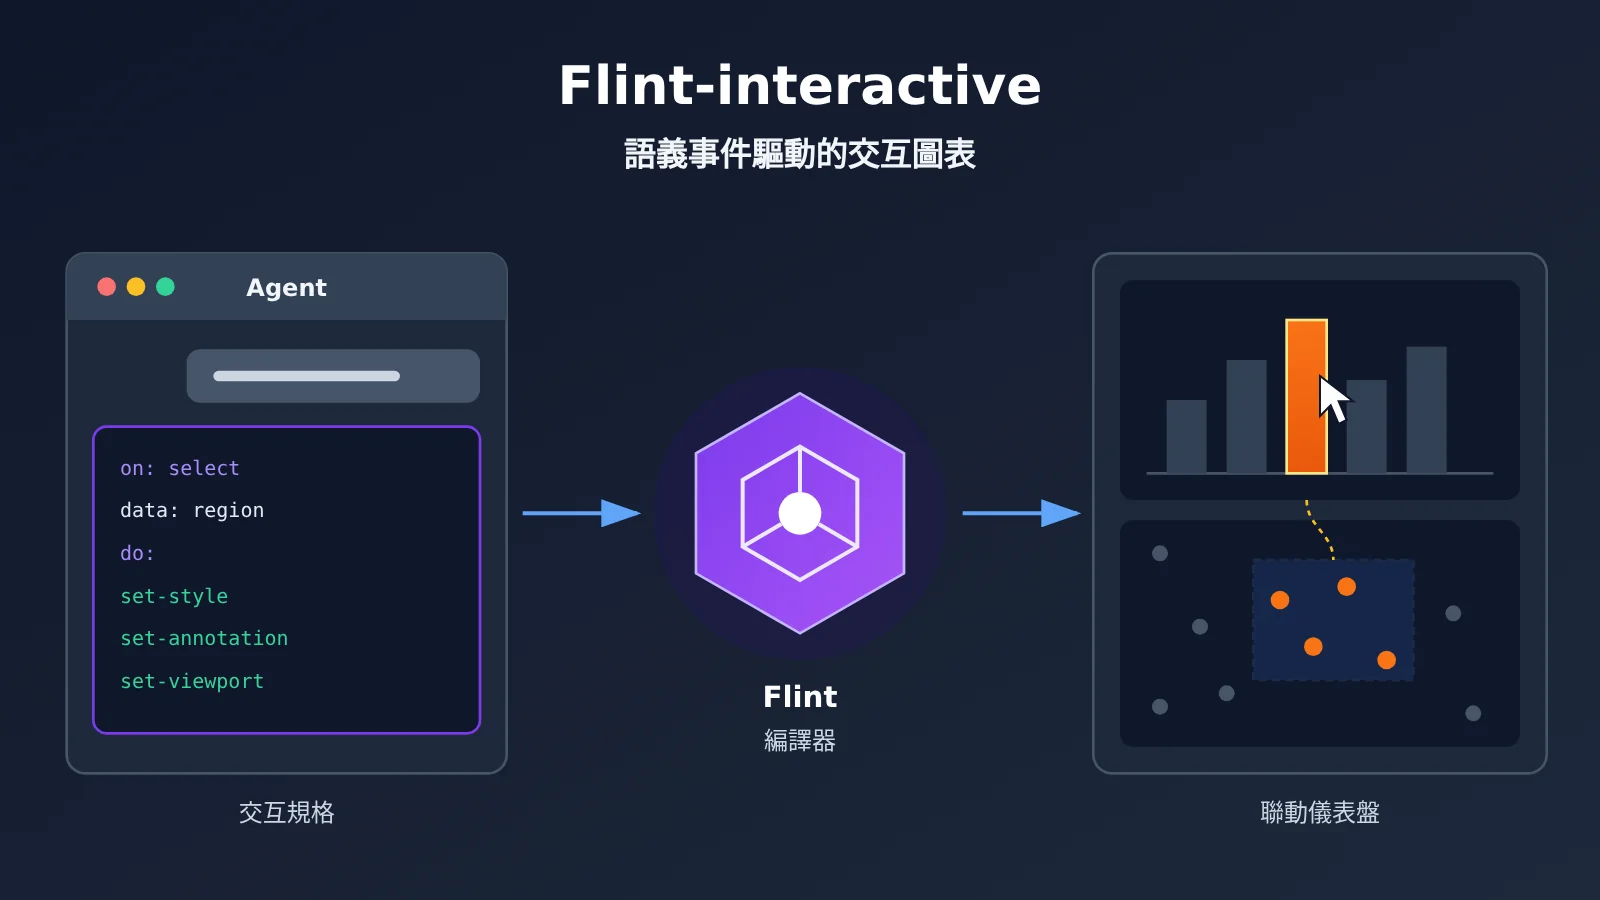
語義事件是 Flint-interactive 最核心的概念。傳統寫法裏,agent 要處理“鼠標在座標 (x, y) 按下又拖到哪裏”,再自己算出這塊區域覆蓋了哪些數據點。在 Flint 裏,這一步由編譯器完成,它直接產出“用戶框選了這幾個國家分組”這樣帶含義的事件。
可以把它類比成前端開發中“原生 DOM 事件”和“業務事件”的區別。你寫業務時不會關心 mousedown 的座標,只關心“用戶選中了訂單 A”。語義事件就是在可視化領域做了同樣的抽象,而且這層抽象由編譯器保證正確。
更新操作:Flint-interactive 用聲明式結果代替命令式重繪
拿到語義事件後,交互邏輯只需要回答一個問題:畫面應該變成什麼樣。博客中列出的更新操作包括用 set style 高亮數據、用 set annotation 給某個點加標籤、用 set viewport 平移或縮放視圖。
這有點像 SQL 和手寫循環的關係。寫 SQL 時你描述“要什麼結果”,數據庫決定怎麼執行;寫 Flint 交互時你描述“哪些數據要高亮”,編譯器負責轉換成具體的畫布變化,包括命中檢測和底層視覺更新。
狀態機:Flint Canvas 託管交互運行時
Flint Canvas 本質上是一個狀態機,它持續追蹤畫布上的用戶交互並管理渲染狀態。對於 agent 來說,這意味着它不用自己維護“當前選中了誰、上一次高亮是否已清除”這類容易出錯的中間狀態。
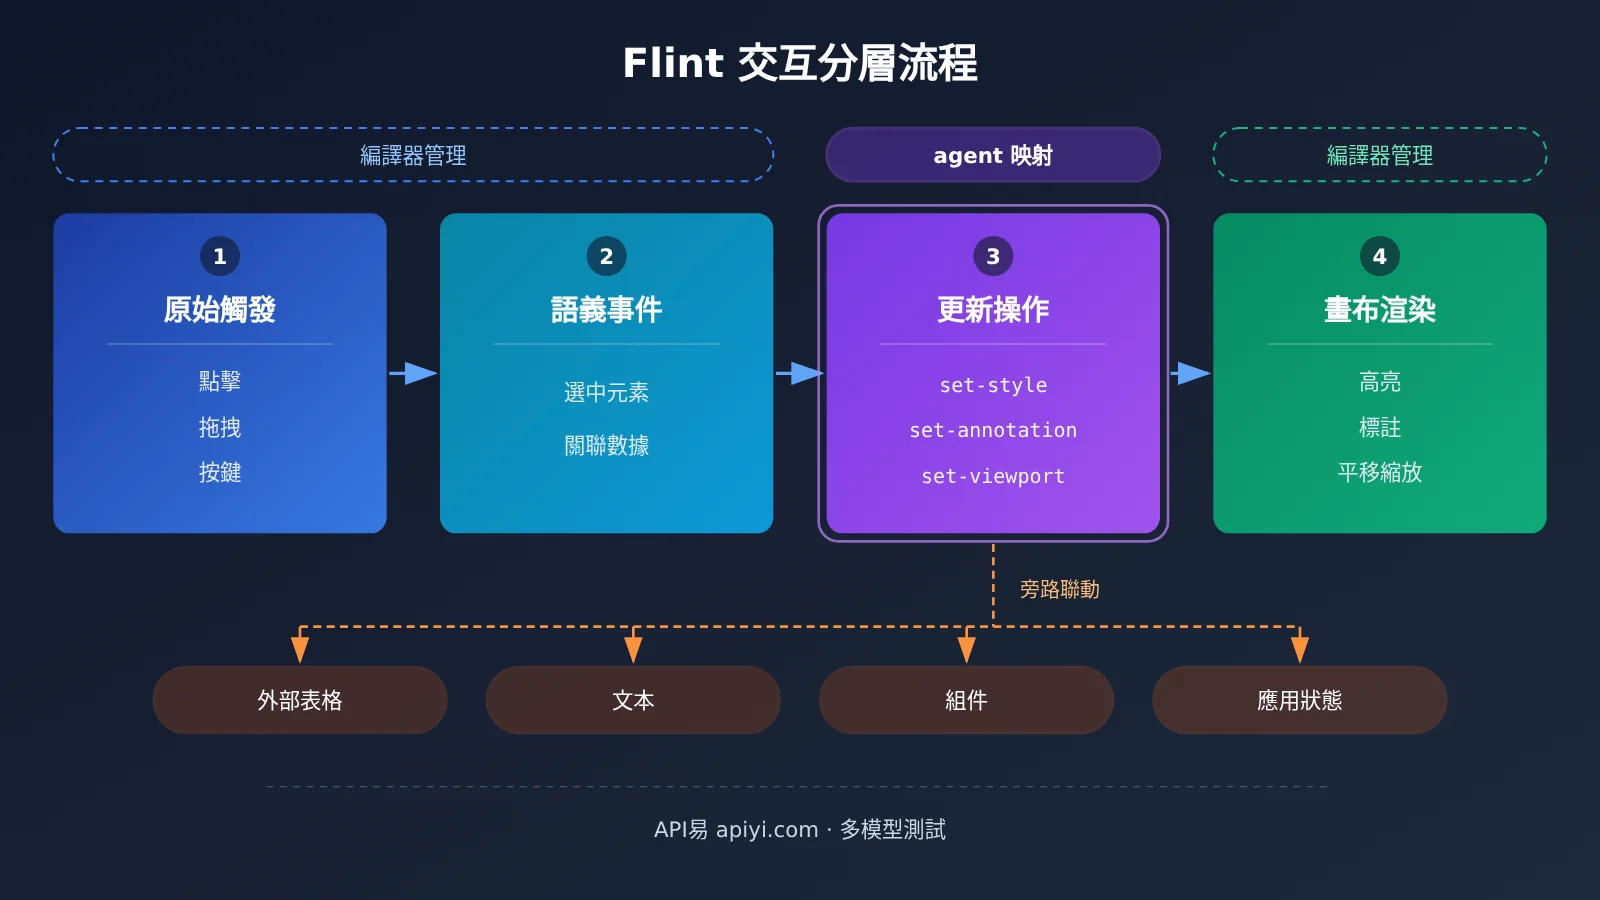
上圖對應博客中的核心劃分:視覺邏輯由編譯器管理,交互邏輯由用戶在語義層面描述。agent 只負責中間那層“什麼事件對應什麼更新”的映射,最難出錯的兩端都交給了框架。
Flint-interactive 背後的可遷移原則:爲 agent 設計高層輸出規格
在 Flint-interactive 之外,這個案例更值得借鑑的是它的工程判斷:不要讓 agent 輸出它最容易寫錯的那一層。底層渲染代碼依賴關係複雜、反饋鏈路長,agent 在這一層反覆試錯,成本自然高。
換個角度看,Flint 把一個開放式的編程問題,收斂成一個“在有限詞彙裏做映射”的問題。agent 的輸出空間變小、結構變規整,可校驗性也隨之提高。這個思路同樣適用於工作流編排、表單生成、報表排版等場景。
| 判斷維度 | 適合交給 agent 輸出 | 適合交給編譯器或運行時 |
|---|---|---|
| 是否表達業務意圖 | 是,如“選中國家後高亮同組” | 否,如像素座標換算 |
| 是否依賴大量隱性狀態 | 依賴少,單次映射即可描述 | 依賴多,需要持續追蹤 |
| 出錯後是否容易定位 | 規格結構清晰,易校驗 | 渲染細節分散,難排查 |
| 是否可複用 | 可沉澱爲預設,如 linked-brush | 通用基礎設施,一次實現 |
在爲自家 agent 設計輸出格式時,可以拿這張表逐項檢查。如果某一層同時滿足“表達意圖、狀態依賴少、易校驗”,就適合交給 agent;反之,就應該下沉到確定性的代碼或編譯器裏。
需要說明的是,研究博客並沒有給出降低 token 消耗或提升成功率的量化數據。這一設計原則的收益,建議你在自己的任務上實測驗證,而不是直接套用結論。
Flint-interactive 快速上手:3 種接入路徑
博客給出了三條使用路徑,分別面向圖表使用者、應用開發者和交互設計者。下面按照從輕到重的順序介紹。
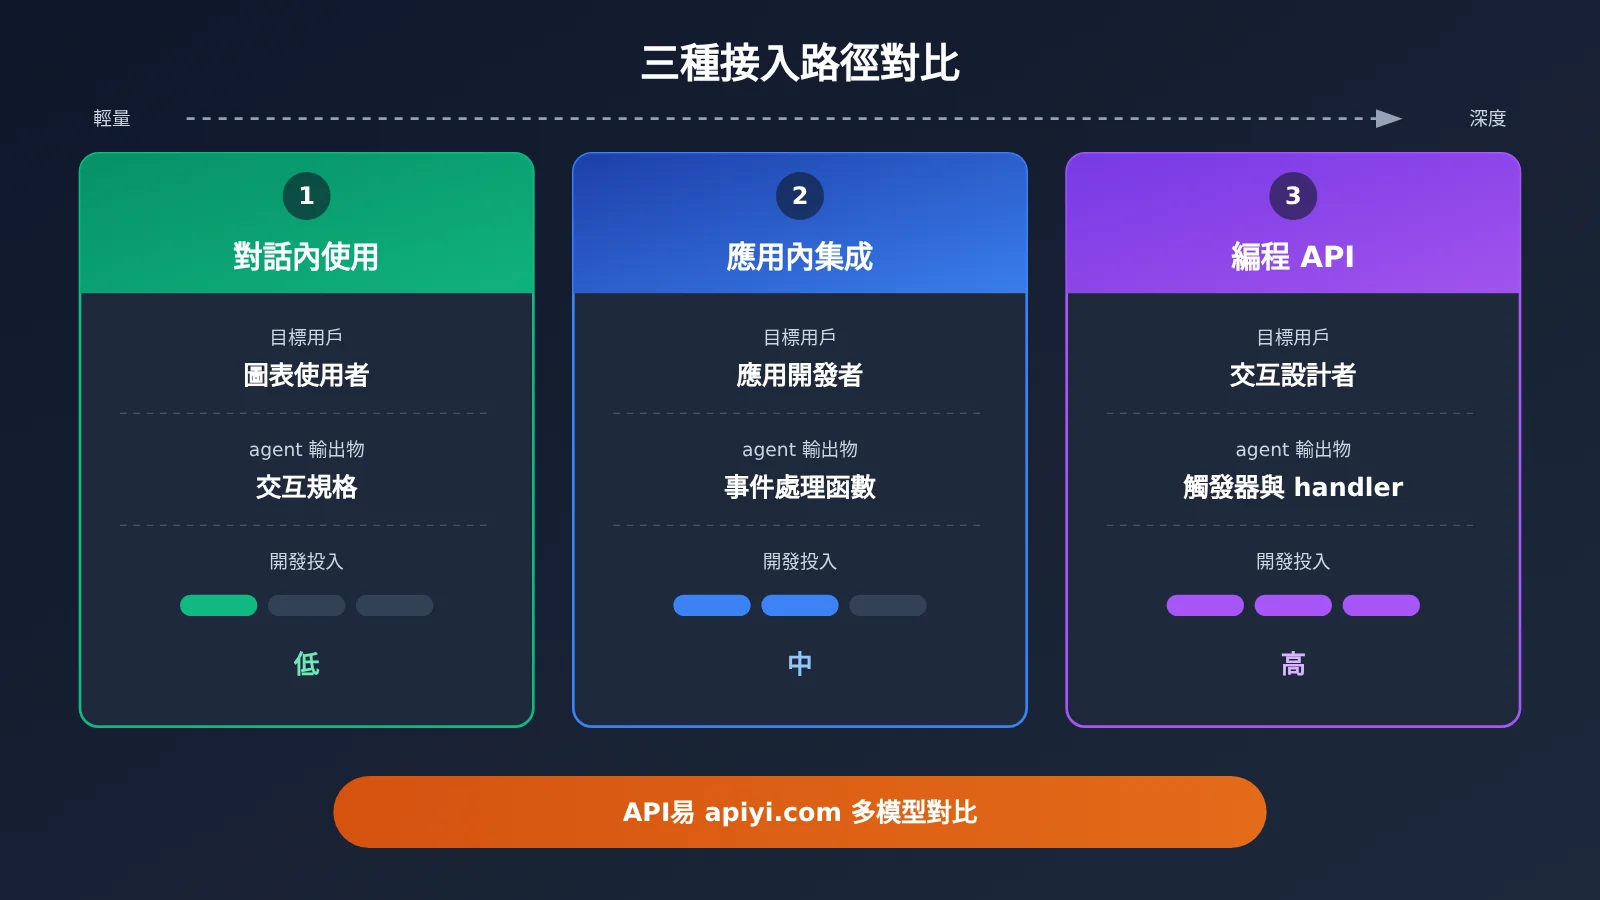
| 接入路徑 | 目標用戶 | agent 或應用輸出什麼 | 典型場景 |
|---|---|---|---|
| 對話內使用(Flint-MCP + MCP Apps) | 圖表使用者 | Flint 圖表規格 + interaction_spec |
在聊天中探索數據,把選中內容帶入追問 |
| 應用內集成(Flint Interactive Canvas) | 應用開發者 | 語義事件處理函數 + 發送給 Canvas 的更新操作 | 儀表盤、數據故事、圖表與表格聯動 |
| 自定義交互(編程 API) | 交互設計者 | 觸發器 trigger + 自定義 handle 函數 | 超出預設的定製交互,如 DimpVis |
路徑一:在對話中使用 Flint-interactive(MCP)
這是最輕量的方式。通過 Flint-MCP 和 MCP Apps,可以在聊天或畫布環境中直接使用 Flint Interactive,具體配置需要按照官方的 MCP 設置指南完成。接入後,流程大致如下:
- 按照官方 MCP 設置指南,把 Flint-MCP 接入支持 MCP Apps 的聊天或畫布環境;
- 告訴 agent 要畫什麼圖,以及想要哪些交互,例如“支持框選並聯動高亮同組國家”;
- agent 會在 Flint 圖表規格之外生成一份
interaction_spec,並在對話中渲染出可交互的圖表; - 在圖表上做選擇,選中的內容可以作爲上下文傳給後續的對話輪次。
第 4 步很有價值。用戶框選某一段異常數據後直接追問“這幾個點爲什麼偏高”,agent 拿到的是結構化的選擇結果,而不是一段模糊的文字描述。
路徑二:在應用中集成 Flint-interactive Canvas
如果要在自己的儀表盤或數據故事裏使用,可以選擇 Flint Interactive Canvas。這裏的數據流是雙向的,可以拆成兩個方向來理解:
- 圖表 → 應用:Flint Canvas 會發出語義事件,你的應用通過事件處理函數接收,用來篩選表格、更新另一張圖表或修改應用狀態;
- 應用 → 圖表:應用裏的組件想控制圖表變化時,向 Flint Canvas 發送更新操作即可。
博客中的示例展示了圖表與表格的雙向聯動:點擊表格行可以高亮圖表中的點,反之亦然。對報表類產品來說,這正是“圖文聯動”體驗的基礎。博客還提到,可以把 interaction-author 技能分享給你的編程 agent,讓它幫你往應用裏添加交互預設。
路徑三:用編程 API 創建 Flint-interactive 自定義交互
當預設交互(例如 linked-brush 聯動框選)不夠用時,可以通過編程 API 定義一個觸發器 trigger 和一個自定義 handle 函數,把語義事件映射成一串自定義的圖表更新。
博客中的例子是:點擊某個國家後將其高亮,並用名稱爲它加上標籤。這個 handler 組合了 set-style 和 set-annotation 兩個操作,全程不需要操作渲染器特定的圖形標記。更復雜的 DimpVis 示例裏,用戶可以沿時間路徑拖動一個點,觀察所有城市的氣溫與降水如何變化。
🚀 上手建議:先用路徑一在對話裏驗證你的數據適不適合做交互,再決定是否投入路徑二或路徑三。驅動 agent 的模型可以通過 API易 apiyi.com 統一接入,在同一套代碼裏切換幾個主流模型,觀察哪個更穩定地產出合法的
interaction_spec。
評估 agent 生成 Flint-interactive 規格的可靠性
博客沒有說明哪些模型或 agent 能更好地生成 Flint 規格,所以上線前最好建立一套簡單的評估流程。建議關注下面幾個指標:
| 評估指標 | 觀察方式 | 說明 |
|---|---|---|
| 首輪可用率 | 統計第一輪生成即可正確渲染並交互的比例 | 直接反映生成成本 |
| 平均修復輪次 | 記錄從首次生成到可用所需的對話輪數 | 對應 token 與時間消耗 |
| 交互意圖命中 | 人工檢查交互行爲是否與需求一致 | 規格合法不代表意圖正確 |
| 迴歸穩定性 | 修改一處交互後,其他交互是否仍正常 | 對應博客提到的可靠性問題 |
不妨準備一批固定的交互需求作爲測試集,用同樣的提示詞分別跑“直接寫渲染代碼”和“輸出 Flint 規格”兩種方式。藉助 API易 這類多模型聚合接口,可以在一個腳本里橫向對比多個模型,省去分別對接各家 SDK 的工作量。
常見問題 FAQ
Q1: 什麼是 Flint-interactive?
Flint-interactive 是微軟研究院在 Flint 之上推出的交互式數據可視化語言。它通過編譯器把用戶交互翻譯成語義事件,再用高層更新操作修改圖表,讓用戶和 agent 能用簡潔的規格描述點擊、篩選、縮放、高亮和跨圖表聯動等交互。
Q2: Flint-interactive 和讓 agent 直接寫圖表交互代碼有什麼區別?
直接寫代碼時,agent 要同時處理事件、命中檢測和重繪,表現力強,但多輪調試成本高,也更容易出錯。Flint-interactive 把視覺邏輯交給編譯器,agent 只描述“什麼語義事件對應什麼更新”,輸出更短,結構也更容易校驗。
Q3: Flint-interactive 是什麼時候發佈的?
微軟研究院博客於 2026 年 10 月 22 日發佈了這項研究,屬於近期的研究成果。關於開源許可、成熟度和生產可用性,參考資料中沒有明確說明,用於正式項目前建議先查閱官方倉庫的最新信息。
Q4: Flint-interactive 最適合哪些應用場景?
– **對話式數據分析**:在聊天中框選數據點,把選擇結果帶入追問;
– **報表與儀表盤**:多張圖表聯動,點擊圖表篩選明細表格;
– **數據故事**:圖表與正文段落雙向高亮,類似數據新聞裏的交互敘事。
Q5: 搭建使用 Flint-interactive 的 agent 時,模型調用怎麼準備?
Flint 解決的是“輸出什麼”,模型本身仍需要另外接入。比較省事的做法是通過 API易 apiyi.com 接入多個主流模型,用統一接口跑同一批交互需求,對比各模型生成規格的首輪可用率和修復輪次,再決定生產環境用哪一個。
Q6: 產品負責人如何判斷團隊要不要引入 Flint-interactive?
可以先回答兩個問題:你的用戶是否真的需要在圖表上做探索,以及 agent 當前生成交互圖表的返工率高不高。如果兩個答案都是肯定的,就值得用路徑一做小範圍驗證。測試階段可以藉助 API易 平臺快速切換模型,把驗證成本控制在較低水平。
Q7: Flint-interactive 有哪些已知限制或待確認之處?
– **缺少量化數據**:博客沒有公佈節省 token 或提升成功率的具體數字;
– **模型適配未知**:沒有說明哪些模型生成 Flint 規格效果最好;
– **交互詞彙有限**:預設之外的交互需要用編程 API 自行實現,官方鼓勵在 GitHub 上提交新的預設來擴充詞彙。
Flint-interactive 核心要點 Key Takeaways
- 成本根源:agent 直接寫交互代碼需要多輪調試,token 消耗大,修復過程還容易引入新 bug;
- 語義事件:編譯器把點擊、拖拽等原始操作翻譯成“選中了哪些數據”;
- 更新操作:用 set-style、set-annotation、set-viewport 聲明畫面變化,不碰底層渲染;
- 職責分離:視覺邏輯交給編譯器,交互邏輯在語義層描述,Canvas 狀態機託管運行時;
- 三種路徑:對話內用 MCP,應用內用 Canvas,定製交互用編程 API;
- 可遷移原則:爲 agent 設計高層輸出規格,把最容易出錯的那一層下沉到確定性系統;
- 落地驗證:結合 API易 統一接口對比多個模型,實測規格生成的穩定性。
總結
Flint-interactive 的語義事件思路可以歸結爲三點:
- 問題定位準確:交互圖表難生成,原因不在模型不夠強,而在缺少一門既有表現力又足夠高層的交互語言;
- 職責劃分清晰:編譯器負責事件解析和畫面更新,agent 只描述“事件 → 更新”的映射;
- 接入方式分層:從對話內試用到應用集成再到自定義交互,可以按需求逐步投入。
對正在開發報表或數據分析 agent 的團隊來說,即使暫時不用 Flint,也可以借鑑它的設計原則,重新審視自家 agent 的輸出格式。
在動手驗證時,推薦通過 API易 apiyi.com 統一接入多個主流模型,用同一批交互需求對比生成效果,儘快找到適合你業務的模型與規格組合。
📚 參考資料
- Microsoft Research Blog – Flint-interactive:Flint-interactive 官方研究博客
- 鏈接:
microsoft.com/en-us/research/blog/flint-interactive-a-language-for-creating-interactive-data-visualizations - 說明:介紹語義事件、更新操作、Canvas 狀態機以及 MCP、Canvas、編程 API 三種使用方式,博客內附有 MCP 設置指南、交互示例庫和編程 API 的入口
作者:API易 技術團隊
技術交流:歡迎訪問 API易 apiyi.com 與我們交流 agent 與多模型接入的實踐經驗,更多資料可查閱 docs.apiyi.com 文檔中心