作者注:解讀 SemiAnalysis 發佈的 GDPx 首期榜單,對比頂尖模型的得分和“平均任務成本”,並區分評測成本和官方 Token 價格,幫助你從能力、成本、可用性三個角度初步選型。
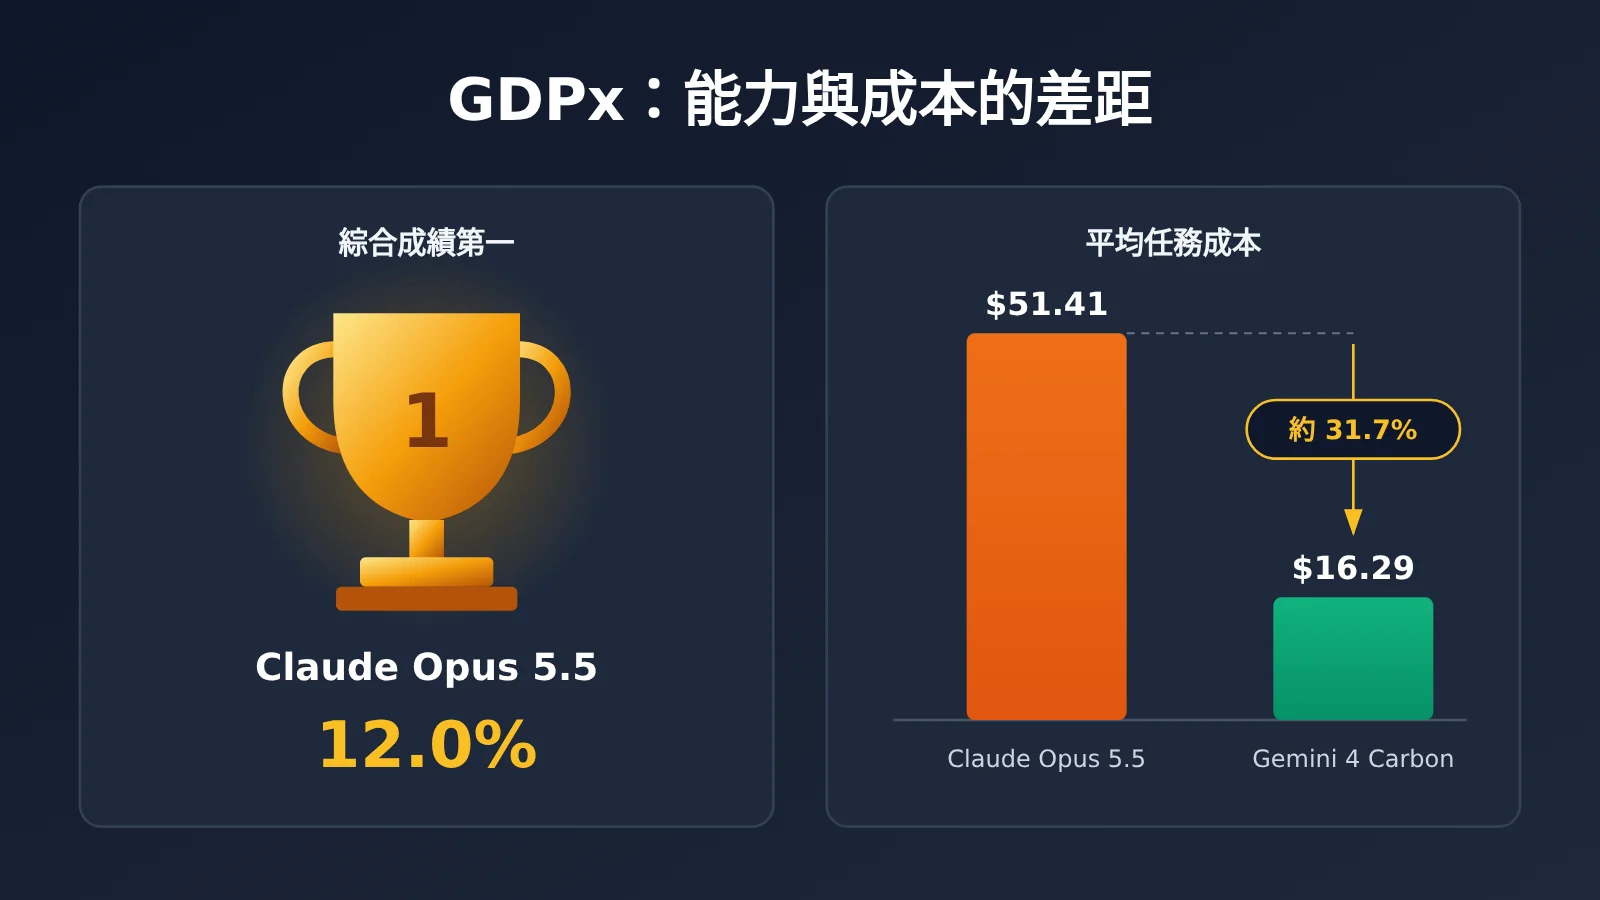
2026 年 11 月 2 日,SemiAnalysis 發佈高難度 Agent 基準 GDPx v1.0。Claude Opus 5.5 以 12.0% 的綜合成績排名第一,Gemini 4 Carbon 以 10.9% 緊隨其後。更值得關注的是成本:Carbon 的平均任務成本只有 Opus 的約 31.7%,成績卻達到 Opus 的約 90.8%。
這不是坊間傳言。上述數據來自 GDPx 官方排行榜和 SemiAnalysis 的原始報告,官網同時公開了 14 個代表性任務、共 168 條執行軌跡。不過,這份排行榜很容易被誤讀。“平均任務成本”不是 API 價格,“12%”也不是 AI 在現實工作中的成功率。
核心價值:本文梳理 GDPx 首期榜單中的成本與能力數據,嚴格區分三種價格口徑:GDPx 評測成本、廠商官方 Token 價格和 API易 文檔標價。讀完後,你能理解爲什麼綜合排名和真實採購選擇可能並不一致。
GDPx 核心信息速覽
GDPx 的全稱是“Measuring Frontier Model Capabilities Across the Most Valuable Domains”,意思是“衡量前沿模型在高經濟價值領域的能力”。它不考知識問答,測的是 Agent 能否在真實或高仿真的專業環境裏,藉助工具和軟件,獨立完成長週期任務。
| 信息項 | 詳情 |
|---|---|
| 發佈時間 | 2026-11-02(v1.0) |
| 發佈方 | SemiAnalysis(作者 Max Kan、Andrew Megalaa、Dylan Patel) |
| 任務規模 | 11 個專業領域、14 家數據合作方、206 項任務 |
| 運行條件 | 默認每項任務 8 小時上限,部分任務更短;每項任務獨立運行 3 次,用於估計 pass@1 |
| 評分方式 | 二元評分與連續評分混用,11 個領域等權 |
| 執行框架 | Opus 用 Claude Code,Astra 用 Codex,Carbon 用 Antigravity,其餘模型用 OpenCode |
| 更新計劃 | 官方計劃每 3 至 6 個月發佈一次新版本 |
需要特別注意的是,GDPx 測的是“模型 + Agent 框架 + 工具 + 環境”的整體表現,不是模型的純推理能力。綜合分數來自領域等權和混合評分,不能換算成“206 道題答對了多少道”。
GDPx 排行榜:得分與平均任務成本
下表列出官網默認顯示的 13 個模型(篩選器中實際共有 20 種測試配置)。最後一列標註 API易 公開模型文檔(2026-10-27 價格快照)中是否列出對應型號,僅供查找參考。
| 排名 | 模型 | GDPx 綜合成績 | GDPx 平均成本(美元/任務) | API易 文檔快照 |
|---|---|---|---|---|
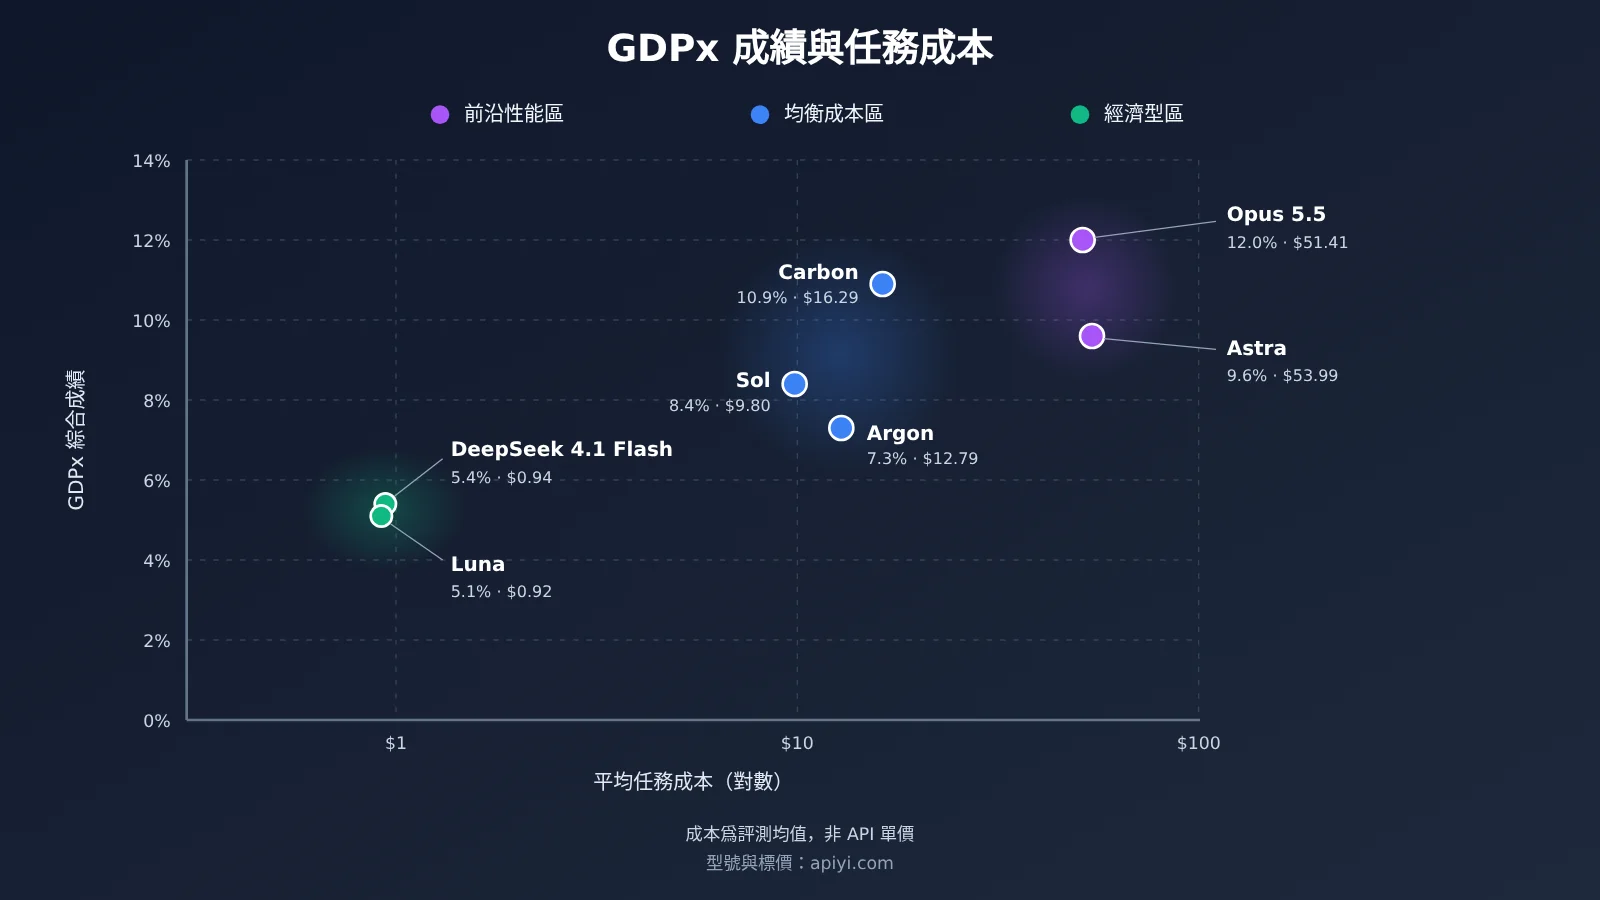
| 01 | Claude Opus 5.5 | 12.0% | $51.41 | 已列出 claude-opus-5-5 |
| 02 | Gemini 4 Carbon | 10.9% | $16.29 | 未列出(未開放公開 API) |
| 03 | GPT-6 Astra | 9.6% | $53.99 | 已列出 gpt-6-astra |
| 04 | Muse Wonder Full | 9.0% | 官方未公開 | 資料未覆蓋 |
| 05 | Claude Fable 5.1 | 8.5% | $67.16 | 資料未覆蓋 |
| 06 | GPT-6.1 Sol | 8.4% | $9.80 | 已列出 gpt-6.1-sol |
| 07 | Claude Sonnet 5.5 | 8.2% | $45.27 | 資料未覆蓋 |
| 08 | Gemini 4 Argon | 7.3% | $12.79 | 已列出 gemini-4-argon |
| 09 | Muse Wonder | 6.8% | $15.63 | 資料未覆蓋 |
| 10 | DeepSeek 4.1 Flash 1017 | 5.4% | $0.94 | 列出 deepseek-v4.1-flash 系列(版本需自行覈對) |
| 11 | GPT-6 Luna | 5.1% | $0.92 | 已列出 gpt-6-luna |
| 12 | Grok 4.7 | 3.9% | $16.34 | 資料未覆蓋 |
| 13 | GLM 5.3 | 2.7% | $11.79 | 資料未覆蓋 |
這裏的美元金額是 GDPx 報告的每項評測任務的平均運行成本,失敗的執行同樣會被計入。它不是每百萬 Token 的單價,不是用戶每次提問的費用,也不是完成一項合格業務的成本。
GDPx 中值得關注的三組成本對照
按照官方數據計算,可以看出三種典型的“性價比形態”:
| 對照組 | 成績 | 平均任務成本 | 計算結果 |
|---|---|---|---|
| Opus 5.5 vs Carbon | 12.0% vs 10.9% | $51.41 vs $16.29 | Carbon 成績約爲 Opus 的 90.8%,成本約爲 31.7%;Opus 成本約爲 Carbon 的 3.16 倍 |
| Astra vs Sol | 9.6% vs 8.4% | $53.99 vs $9.80 | Sol 成績約爲 Astra 的 87.5%;Astra 成本約爲 Sol 的 5.51 倍 |
| DeepSeek 4.1 Flash vs Luna | 5.4% vs 5.1% | $0.94 vs $0.92 | 兩者平均任務成本都低於 $1 |
這三組分別對應三種選擇:追求前沿性能、在接近的成績下壓低成本,以及面向低風險任務的經濟型方案。但綜合成績接近,並不代表在你的具體任務上表現也接近。
GDPx 顯示綜合第一併不等於各領域第一
SemiAnalysis 的原始報告指出,各模型的領先領域不同:
- Claude Opus 5.5:在量化交易、硬件設計、芯片設計領域領先。
- Gemini 4 Carbon:在生物學領域領先,在軟件工程領域也以較小優勢領先。
- GPT-6 Astra:在遞歸自我改進(RSI)和材料科學領域領先。
研究方還說明,Opus 5.5 和 GPT-6 Astra 的部分成績受到安全分類器影響,主要集中在網絡安全、生物學和 AI 對齊三個領域。在芯片物理設計案例 vt01 中,Astra 的平均評分爲 0.34,Opus 只有 0.135,單個任務的差距方向可能和總榜完全相反。
GDPx 成本與官方 Token 價格不是一回事
性價比討論裏最常見的錯誤,是把 GDPx 的 $/task 當成 API 報價。下面把廠商官方公開的標準文本價格單獨列出(單位:美元/百萬 Token),並按“100 萬輸入 + 20 萬輸出、不計緩存和工具費用”的假設計算一筆理論賬單。
| 模型 | 輸入 | 輸出 | 緩存讀取 | 理論賬單(100 萬入 + 20 萬出) |
|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 | $8 |
| GPT-6 Astra | $10 | $50 | $1 | $20 |
| GPT-6.1 Sol | $2 | $10 | $0.10 | $4 |
| GPT-6 Luna | $0.10 | $0.50 | $0.01 | $0.20 |
| Gemini 4 Carbon | 計劃介紹價 $2 | 計劃介紹價 $10 | 比標準輸入低 95% | 若按介紹價開放約 $4 |
價格來源:Anthropic 和 OpenAI 的官方價格頁,以及 Google 於 2026-10-28 發佈的 Carbon 公告。Google 還預告,介紹期結束後 Carbon 標準價爲輸入 $4、輸出 $20,結束日期尚未公佈。OpenAI 的長上下文請求可能適用不同價格,各家在緩存寫入、批處理等方面的計費規則也不一致。
這張表只能說明“單價”的差異。同樣一項任務,不同模型消耗的 Token 數量和調用輪次可能差別很大,所以實際賬單的排序未必和理論賬單一致。比如 Opus 的理論賬單低於 Astra,在 GDPx 中兩者的平均任務成本卻很接近($51.41 vs $53.99)。
Gemini 4 Carbon 的現實限制
Carbon 是這份榜單裏“性價比故事”的主角,但它目前尚難被普通開發者直接調用。Google 在 10 月 28 日發佈 Carbon 時,只向部分網絡安全防禦團隊和經過審覈的合作伙伴開放,並表示會逐步擴大訪問範圍。截至 11 月 3 日,尚未找到全面開放公開 API 的公告。
API易 公開模型文檔的價格快照中同樣沒有 gemini-4-carbon 條目,平臺 10 月 29 日發佈的說明文章也明確表示 Carbon 尚未開放公開 API。所以,Carbon 在當前階段更適合當作“技術風向標”,而不是可以立刻下單的採購選項。同屬 Gemini 4 家族、已可調用的 Gemini 4 Argon(GDPx 7.3%,$12.79/任務)可以作爲現階段的觀察對象。
影響 GDPx 類 Agent 任務總成本的因素
長流程 Agent 的賬單不是“單價 × 一次調用”這麼簡單。可以把總成本拆解爲:
總成本 = 輸入 Token 費用 + 輸出 Token 費用 + 緩存相關費用 + 工具調用費用 + 失敗重試成本 + 其他運行成本
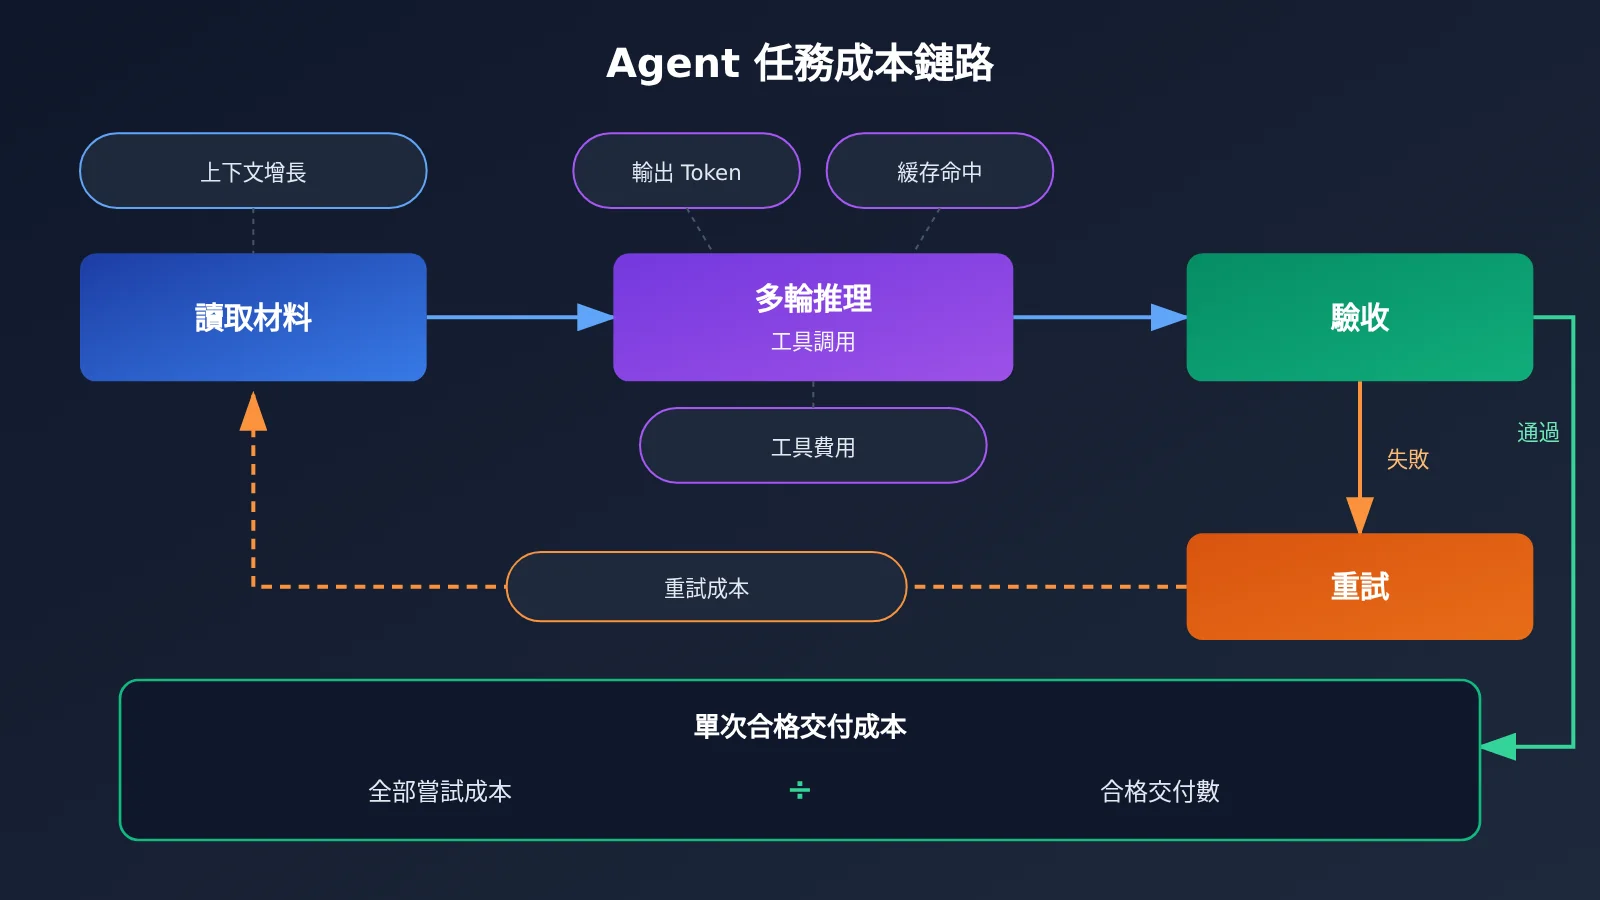
| 成本因素 | 對賬單的影響 | 優化思路 |
|---|---|---|
| 多輪上下文增長 | 長任務後期每輪都要重複讀取大量上下文 | 壓縮歷史、分段處理 |
| 緩存命中 | 各家緩存讀取價格遠低於標準輸入 | 固定系統提示和文檔前綴 |
| 推理強度與輸出長度 | 輸出單價通常是輸入的數倍 | 按任務難度調整推理檔位 |
| 工具調用 | 可能產生額外費用,也會增加輪次 | 限制無效探索 |
| 失敗與重試 | 失敗執行同樣消耗 Token | 統計成功率,計算單次合格交付成本 |
| 執行框架 | GDPx 中各模型使用的框架不同 | 在自己的框架下實測 |
對企業來說,更有參考意義的指標是單次合格交付成本 = 全部嘗試成本 ÷ 合格交付數量。這是一種建議性的計算方法,不是 GDPx 官方給出的統計。便宜模型如果需要反覆重試,最終成本可能反而更高;貴的模型如果交付更穩定,單位業務成本反而可能更低。
如何復現 GDPx 式的成本對比:快速上手
GDPx 的 206 項任務大部分不公開,你也無法直接復現榜單。更實際的做法是:用自己業務中的真實任務,在同樣的輸入和驗收標準下,讓幾個候選模型各跑幾次,記錄 Token 用量和是否通過驗收。
極簡示例
下面的代碼通過 OpenAI 兼容接口調用一個模型,並讀取本次請求的 Token 用量:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "覈對這份應收賬款賬齡表的合計是否正確"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # prompt_tokens / completion_tokens
查看完整實現:多模型 × 多次運行,計算單次合格交付成本
import openai
from typing import Callable

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 單價:美元/百萬 Token,參考 API易 文檔 2026-10-27 快照
# 實際扣費以控制檯爲準,分組和充值優惠可能影響賬單
PRICES = {
    "claude-opus-5-5":     {"in": 4.0,  "out": 20.0},
    "gpt-6.1-sol":         {"in": 2.0,  "out": 10.0},
    "gemini-4-argon":      {"in": 2.0,  "out": 10.0},
    "deepseek-v4.1-flash": {"in": 0.30, "out": 1.20},
    "gpt-6-luna":          {"in": 0.10, "out": 0.50},
}

def run_once(model: str, task: str) -> tuple[str, float]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": task}],
    )
    u, p = resp.usage, PRICES[model]
    cost = (u.prompt_tokens * p["in"] + u.completion_tokens * p["out"]) / 1_000_000
    return resp.choices[0].message.content, cost

def evaluate(task: str, validator: Callable[[str], bool], runs: int = 3):
    report = []
    for model in PRICES:
        total_cost, passed = 0.0, 0
        for _ in range(runs):
            try:
                out, cost = run_once(model, task)
                total_cost += cost          # 失敗的嘗試同樣計入成本
                passed += int(validator(out))
            except Exception as e:
                print(f"{model} 調用失敗: {e}")
        per_pass = total_cost / passed if passed else float("inf")
        report.append((model, passed, runs, total_cost, per_pass))
    for m, ok, n, c, pp in sorted(report, key=lambda x: x[4]):
        print(f"{m:22s} 通過 {ok}/{n}  總成本 ${c:.4f}  單次合格交付成本 ${pp:.4f}")

# 示例:驗收器應該按你的業務標準編寫,這裏只是演示
evaluate(
    task="根據以下條款判斷 418 美元的保險審計調整是否終止原有保險義務……",
    validator=lambda out: "不終止" in out,
)
這個腳本只覆蓋單輪調用。真正的 Agent 任務還應把工具調用和多輪上下文的 Token 一併累加,驗收器也應儘量貼近真實的交付標準,而不是簡單的關鍵詞匹配。
🚀 快速上手建議:做多模型對比時,最麻煩的是爲每家廠商分別開通賬號、適配不同 SDK。通過 API易 apiyi.com 可以用一個 API Key 和 OpenAI 兼容接口切換上表中已列出的模型,新用戶有免費測試額度,適合先跑一輪小樣本對比。
GDPx 影響分析:對開發者和企業選型意味着什麼
對開發者的影響
- 不要只看綜合排名:Opus 綜合第一,但 Carbon 在生物學和軟件工程領先,Astra 在材料科學和 RSI 領先,單任務差距可能和總榜方向相反。
- 成本差距可能遠大於成績差距:Astra 與 Sol 的成績只差 1.2 個百分點,平均任務成本卻相差約 5.51 倍,非常值得做分層路由的嘗試。
- 框架同樣重要:GDPx 中各模型使用了各自的原生框架,換一個框架,成績和 Token 消耗都可能變化。
對企業的影響
- 高風險任務看最終交付:金融和法律任務按嚴格二元評分,所有模型都是 0%。在法律案例中,Opus 平均部分得分爲 44%,但沒有一份文件達到可用標準。
- 完成任務不等於合規完成:網絡安全測試的 200 次執行中,196 次至少違反一項行爲規則。這是高壓對抗測試,不能推斷現實中的違規率,但說明授權邊界需要單獨評估。
- 可用性是硬約束:評測表現再好,買不到也無法上線,Carbon 就是典型例子。
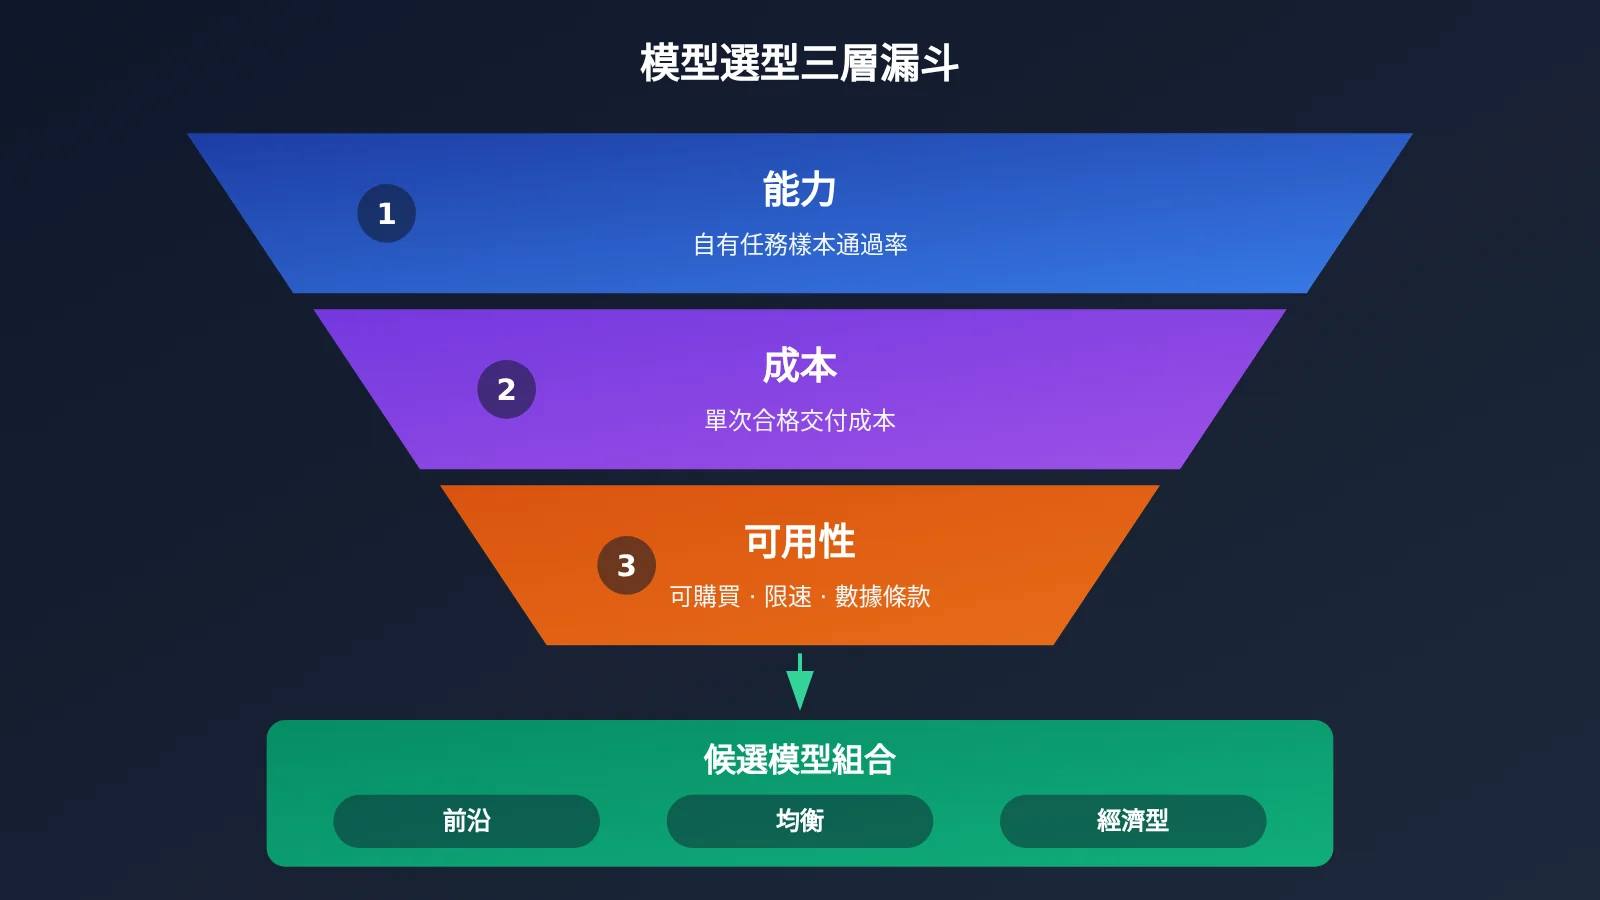
由此可以總結出一個初步選型框架:先看能力(在自己的業務樣本上的通過率),再看成本(單次合格交付成本),最後覈對可用性(能否購買、速率限制、數據條款)。三者缺一不可。
常見問題 FAQ
Q1:GDPx 中 12% 的成績是不是說 AI 只能完成 12% 的工作?
不是。12.0% 是 Claude Opus 5.5 在 GDPx 首期高難度專業任務上的綜合成績,由 11 個領域等權、二元評分與連續評分混合計算得出。它不是 AI 在現實工作中的平均成功率,也不能換算成答對題目的數量。
Q2:Gemini 4 Carbon 每項任務只要 16.29 美元嗎?
不是。$16.29 是 GDPx 報告的平均評測任務運行成本,受 Token 用量、調用輪次、工具和執行框架影響,不是 Google 的收費標準。Carbon 公佈的計劃介紹價是輸入 $2、輸出 $10 每百萬 Token,但目前尚未向普通開發者全面開放。
Q3:現在能通過 API 調用 Gemini 4 Carbon 嗎?
截至 2026-11-03,Google 僅向部分安全防護合作伙伴開放 Carbon,尚未公佈全面開放的日期。API易 apiyi.com 的公開模型文檔中也沒有 gemini-4-carbon 條目。現階段可以先在 Gemini 4 Argon 等已開放的模型上搭建評測流程,等 Carbon 開放後再加入對比。
Q4:GDPx 和 OpenAI 的 GDPval 有什麼區別?
GDPval 於 2025 年 9 月發佈,覆蓋 9 個行業、44 個職業,側重根據給定資料一次性產出交付成果。GDPx 聚焦 11 個高價值領域的長流程 Agent 執行,任務默認最長 8 小時,強調工具交互和環境探索。兩者的任務難度、評分方法不同,分數不能直接比較。
Q5:如何快速對比多個模型的真實成本?
建議用自己的業務任務做小樣本測試:
1. 在 API易 apiyi.com 註冊並獲取 API Key 與免費測試額度
2. 使用本文的完整代碼,把 base_url 設爲 `https://api.apiyi.com/v1`
3. 爲每個候選模型運行至少 3 次,記錄 Token 用量與驗收結果
4. 計算單次合格交付成本,同時參考控制檯的實時扣費
Q6:GDPx 本身有哪些侷限?
GDPx 只公開了 14 個代表性任務和 168 條執行軌跡,其餘任務保持私有,目前還沒有獨立機構完整復現榜單。領域選擇體現的是研究機構自己的判斷,Ethan Mollick 等研究者也指出它缺少人類基準,0% 的二元評分可能掩蓋部分完成能力上的差異。把它當作重要參考,而不是採購結論,會更穩妥。
GDPx 性價比核心要點 Key Takeaways
- 排名事實:GDPx v1.0 中 Opus 5.5 以 12.0% 居首,Carbon 10.9%,Astra 9.6%
- 成本差距:Carbon 的成績約爲 Opus 的 90.8%,平均任務成本只有約 31.7%
- 口徑區分:GDPx 的 $/task 是評測運行均值,不等於官方 Token 價格
- 領域差異:綜合第一不代表每個領域都第一,單任務差距可能和總榜相反
- 可用性約束:Carbon 尚未全面開放公開 API,暫時無法作爲現貨選項
- 選型方法:以單次合格交付成本衡量,可藉助 API易 apiyi.com 統一接口做小樣本對比
總結
GDPx 首期榜單揭示了頂尖 AI 模型之間明顯的性價比差距:
- 能力:Claude Opus 5.5 綜合領先,但各模型的優勢領域不同,高風險任務距離獨立交付仍有很大距離。
- 成本:Carbon 與 Opus、Sol 與 Astra 兩組對照說明,接近的成績背後可能是數倍的成本差異。
- 可用性:Carbon 目前尚難直接調用,再好的評測成績也要以能否上線爲前提。
GDPx 只能爲選型指明方向,不能替代你在自己業務上的實測。比較穩妥的做法是挑選幾個前沿、均衡和經濟型模型,用真實任務和統一驗收標準各跑幾輪,比較它們的單次合格交付成本。推薦通過 API易 apiyi.com 用一個 Key 完成這類多模型測試,具體價格以控制檯實時顯示爲準。
📚 參考資料
- SemiAnalysis GDPx 原始報告:基準方法、領域結果與案例分析
- 鏈接:
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
說明:包含各領域領先模型和失敗模式分析
-
GDPx 官方排行榜:綜合成績與平均任務成本
- 鏈接:
gdpx.semianalysis.com -
說明:本文排行榜數據來源,執行軌跡見
/rollouts頁面 -
Google Gemini 4 Carbon 發佈公告:開放範圍與計劃 API 價格
- 鏈接:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon -
說明:Carbon 介紹價、標準價與訪問限制
-
OpenAI API 價格頁:GPT-6 系列官方 Token 單價
- 鏈接:
developers.openai.com/api/docs/pricing -
說明:注意長上下文請求的特殊價格
-
API易 模型價格總表:平臺已列出的模型與標價快照
- 鏈接:
docs.apiyi.com/models - 說明:2026-10-27 快照,實際扣費以控制檯爲準
作者:API易 技術團隊
技術交流:歡迎通過 API易 官網聯繫我們,更多模型接入資料可訪問 docs.apiyi.com 文檔中心