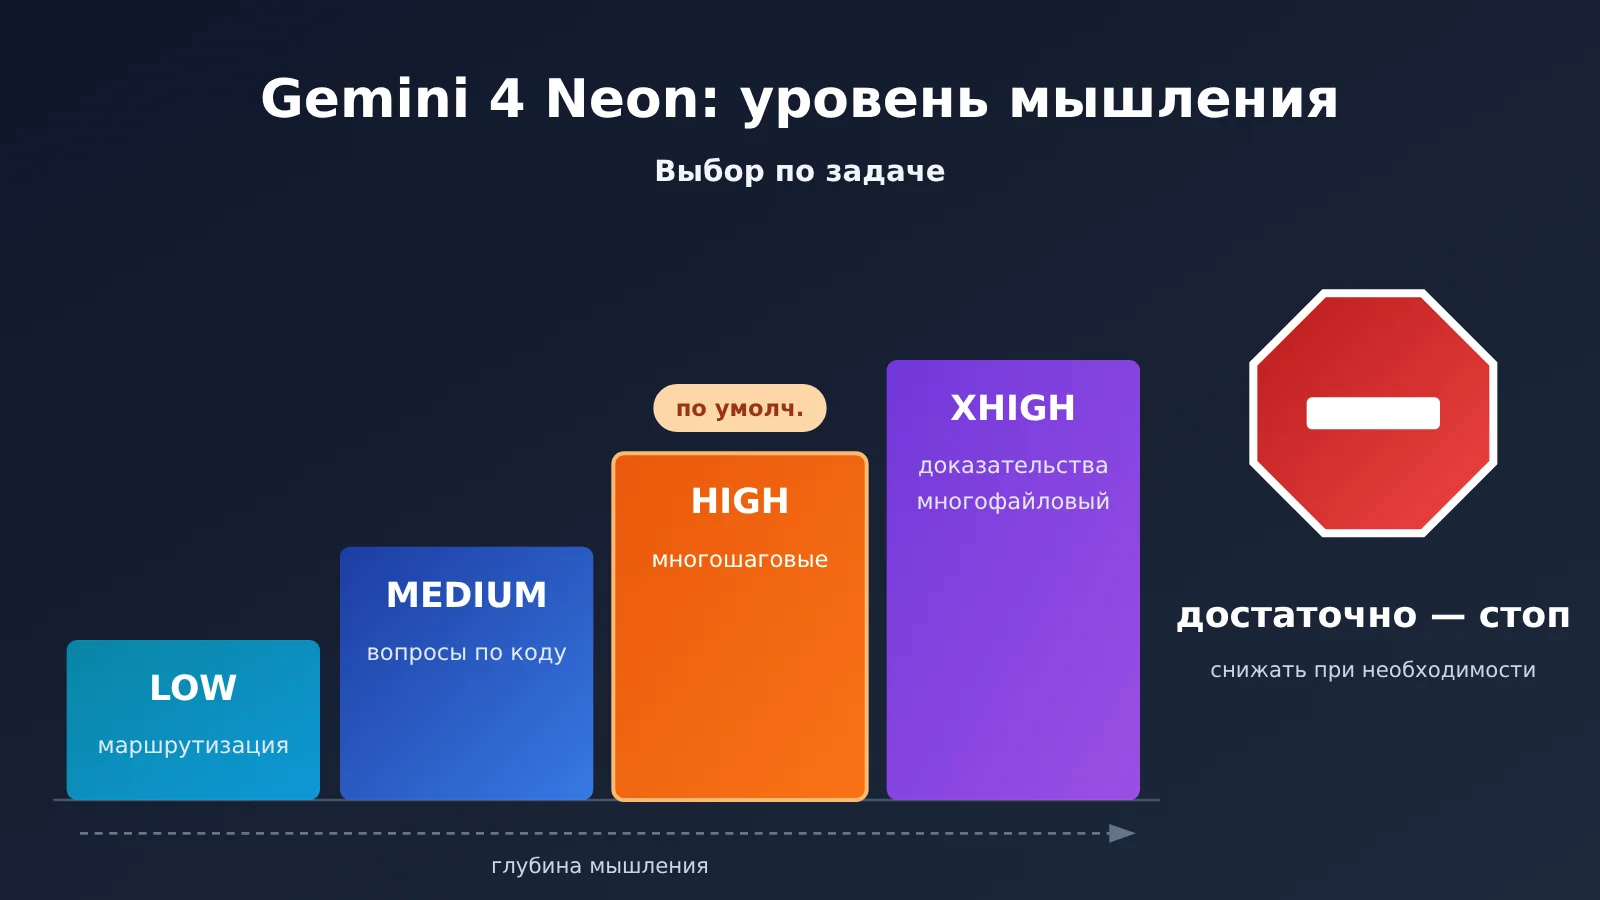
Примечание автора: у Gemini 4 Neon есть четыре уровня размышления, по умолчанию — HIGH, а токены размышления тарифицируются по цене выходных. В этой статье разберём, для каких задач подходит каждый уровень, и объясним, почему нельзя просто перенести настройки уровней из Carbon на Neon.
После подключения Gemini 4 Neon у многих разработчиков первая проблема — не качество, а счёт. Токены размышления оплачиваются по цене выходных, и чем выше уровень, тем дольше модель думает перед ответом и тем больше выходных токенов тратит. Наша рекомендация: выбирайте уровень под задачу, останавливайтесь, когда хватает — так вы найдёте подходящий баланс между качеством и стоимостью.
Это не очередная статья в духе «чем выше, тем лучше». В документации Google Cloud уже подробно описано, для каких сценариев подходит каждый уровень Neon. Мы опирались на официальные документы и собрали таблицу соответствий, по которой можно настраивать сразу, а также добавили несколько частых ошибок и мест, где легко запутаться.
Главное: после прочтения вы будете знать, что у Gemini 4 Neon по умолчанию стоит HIGH, для задач классификации и маршрутизации достаточно LOW, XHIGH нужен только для самой тяжёлой работы, и при этом не перенесёте настройки из Carbon или Antigravity в вызовы API по ошибке.
Ключевые моменты об уровнях рассуждения Gemini 4 Neon
Начнём с самых важных выводов. Все они взяты из документации Google Cloud по Gemini 4 Neon (версия от 2026-11-19) и со страницы последней модели в AI Studio:
| Момент | Пояснение | Что это даёт вам |
|---|---|---|
| Четыре уровня рассуждения | LOW, MEDIUM, HIGH, XHIGH, по умолчанию HIGH | Если не передавать параметр, уровень уже будет довольно высоким — понижать его нужно сознательно |
| Старые параметры вызывают ошибку | thinking_budget и MINIMAL возвращают HTTP 400 |
При миграции старого кода обязательно меняйте параметры |
| Плата за токены рассуждения | Токены рассуждения тарифицируются по цене выходных токенов | Уровень напрямую влияет на стоимость выходной стороны |
| Уровни не универсальны для разных моделей | У Carbon только три уровня, по умолчанию medium; у Hydrogen, как и у Neon, четыре уровня | Нельзя копировать конфигурацию одной модели в другую |
| Интерфейс и API различаются | В интерфейсе Antigravity Extra — это xhigh, и лимит контекста там другой | Не стоит судить о поведении API по опыту в IDE |
Соответствие четырёх уровней рассуждения Gemini 4 Neon и задач
Официальная документация для каждого уровня указывает рекомендуемые сценарии. Ниже они собраны в таблицу, чтобы было удобно сверяться при настройке:
| Уровень рассуждения | Рекомендуемые официально сценарии | Типичные бизнес-примеры | Подсказка по выбору |
|---|---|---|---|
LOW |
Классификация, маршрутизация и суммаризация с высокой пропускной способностью | Разметка тикетов, определение намерения, выделение главного из длинного текста | Для пакетных задач выбирайте этот уровень в первую очередь |
MEDIUM |
Обычное программирование, вопросы-ответы по документации | Написание функций, исправление багов, ответы на вопросы по базе знаний | Подходит для большинства повседневных запросов разработки |
HIGH (по умолчанию) |
Многошаговые вызовы инструментов, сложная мультимодальность | Агент последовательно вызывает инструменты, смешанный анализ текста и изображений | Именно этот уровень используется, если не передавать параметр |
XHIGH |
Доказательства, научный анализ, самые тяжёлые многофайловые проекты | Математические выводы, анализ экспериментальных данных, рефакторинг сразу нескольких модулей | Используйте только для самых тяжёлых задач |
В этой таблице нужно обратить внимание на два момента. Во-первых, значение по умолчанию — HIGH, а не MEDIUM. То есть если в коде ничего не указывать, каждый запрос классификации будет рассуждать с интенсивностью «многошагового вызова инструментов», а для сценариев с высокой пропускной способностью это обычно пустая трата ресурсов. Во-вторых, XHIGH — это максимальный уровень Neon; он предназначен для доказательств и самых тяжёлых инженерных задач. Если включать XHIGH для повседневных запросов на программирование, чаще всего вы получите только более долгое ожидание и больше выходных токенов.
Почему для Gemini 4 Neon действует принцип «остановиться, когда достаточно»
Всё дело в том, как устроена тарификация. Токены рассуждений оплачиваются по цене вывода, а у Gemini 4 Neon цена вывода в 5 раз выше цены ввода (в объявлении Google указано: ввод $3, кэш $0.15, вывод $15 — все значения за миллион токенов). Чем больше модель рассуждает, тем больше самых дорогих токенов.
Сколько именно токенов рассуждений добавляет каждый уровень, зависит от сложности самой задачи: официальных фиксированных пропорций нет, и в этой статье мы тоже не будем приводить цифры вроде «сколько денег экономит понижение на один уровень». Надёжнее всего прогнать на собственной выборке задач режимы LOW и HIGH (по умолчанию), сравнить расход выходных токенов в ответах и качество результата, а уже потом решать, стоит ли понижать уровень.
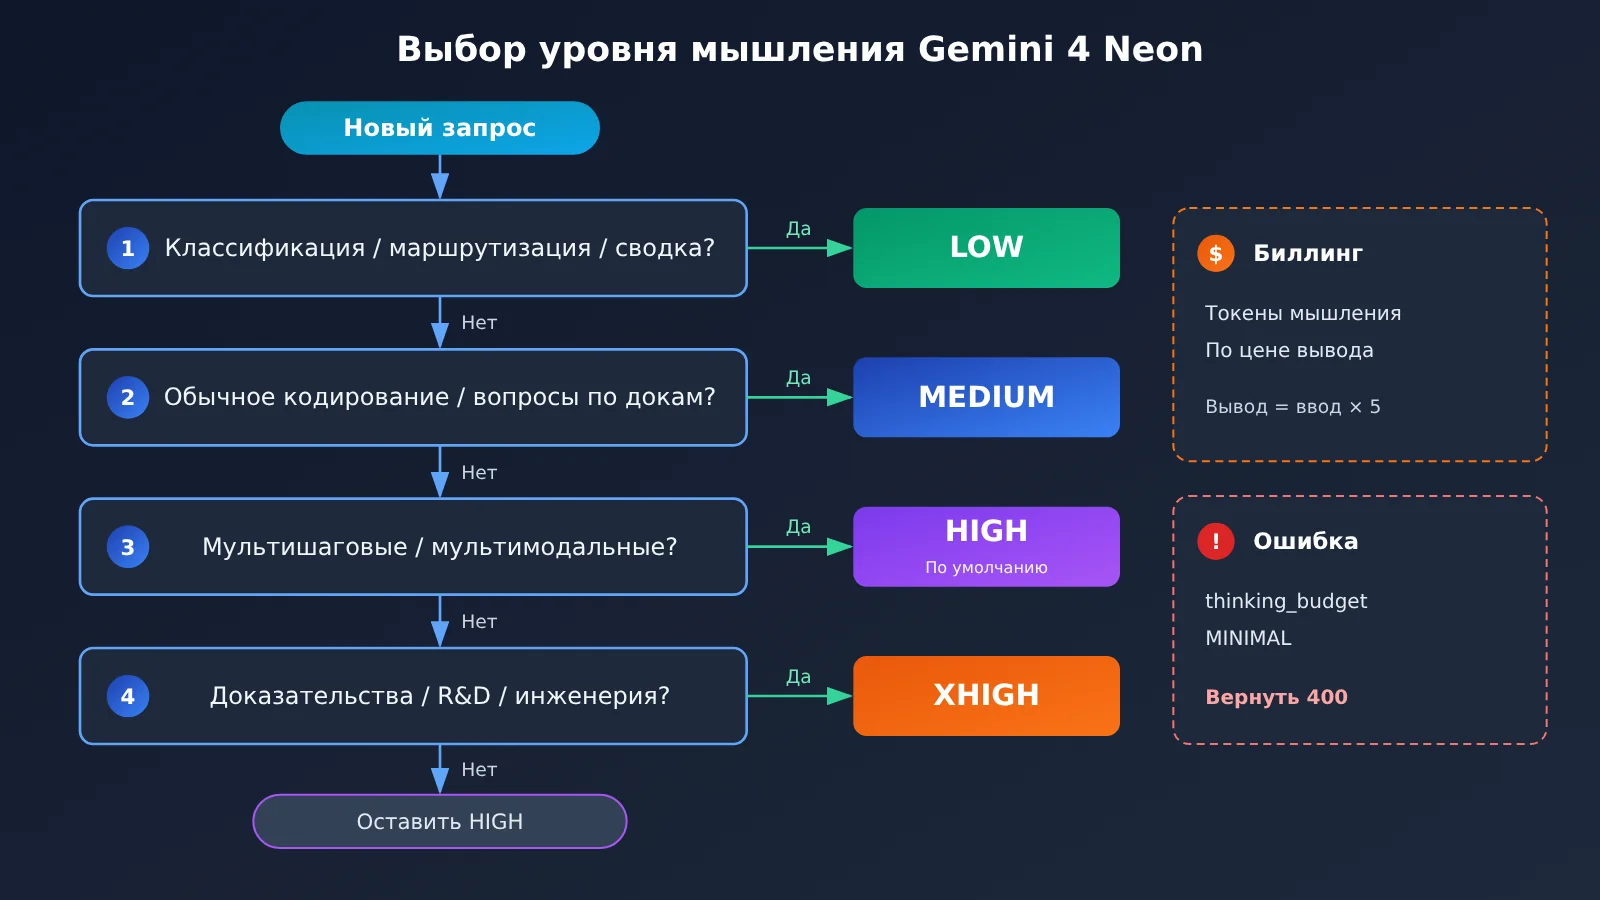
Быстрый старт с уровнями мышления Gemini 4 Neon
Простейший пример: классификация на уровне LOW
APIYI предоставляет OpenAI-совместимый интерфейс. Достаточно изменить base_url в официальном Python SDK openai, и можно вызывать Gemini 4 Neon. Ниже — ключевой код по шагам; каждый шаг можно копировать напрямую:
- Установите SDK:
pip install openai - Создайте клиент:
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - Укажите модель:
model="gemini-4-neon" - Задайте уровень мышления:
reasoning_effort="low" - Отправьте запрос:
client.chat.completions.create(model="gemini-4-neon", reasoning_effort="low", messages=[{"role": "user", "content": "判断这条工单属于:账单 / 技术 / 其他。工单内容:……"}]) - Прочитайте результат:
resp.choices[0].message.content
Для задачи классификации нужен всего один ярлык, и уровня LOW уже достаточно. Если перейти к написанию кода или ответам на вопросы по документации, замените шаг 4 на reasoning_effort="medium".
Важно: имя параметра зависит от формата интерфейса. В нативном API Gemini уровень мышления задаётся в поле thinking_level внутри thinking_config; допустимые значения — LOW / MEDIUM / HIGH / XHIGH. В OpenAI-совместимом формате интенсивность мышления обычно передаётся через reasoning_effort. Точное сопоставление полей смотрите в документации платформы; перед запуском в продакшене советуем одним запросом проверить, что уровень действительно применяется.
Полная идея реализации: автоматический выбор уровня по типу задачи
В продакшене лучше, чтобы бизнес-логика выбирала уровень по типу задачи, а не использовала одно жёстко заданное значение глобально. Реализацию можно разбить на следующие шаги:
1. Определите таблицу соответствий: `LEVEL_MAP = {«classify»: «low», «route»: «low», «summary»: «low», «code»: «medium», «doc_qa»: «medium», «agent»: «high», «multimodal»: «high», «proof»: «xhigh», «multi_file»: «xhigh»}`
2. Задайте значение по умолчанию: `level = LEVEL_MAP.get(task_type, «high»)`. Для неизвестных задач используется официальный уровень по умолчанию HIGH — так вы случайно не снизите качество.
3. Создайте единый клиент: `client = OpenAI(api_key=os.getenv(«APIYI_KEY»), base_url=»https://api.apiyi.com/v1″)`
4. Выполните вызов: `client.chat.completions.create(model=»gemini-4-neon», reasoning_effort=level, messages=messages)`
5. Логируйте использование: записывайте количество выходных токенов из `resp.usage` вместе с `task_type` и `level`, чтобы было удобно считать затраты на мышление по типам задач.
6. Обрабатывайте ошибки 400: после перехвата исключения проверьте, не остались ли в запросе `thinking_budget` или `MINIMAL`. Оба этих значения на Neon возвращают HTTP 400.
Значение по умолчанию из шага 2 очень важно. Если в таблице соответствий не оказалось какого-то типа задачи, лучше потратить чуть больше токенов на HIGH по умолчанию, чем молча перейти на LOW и получить неверный ответ. Когда логов накопится достаточно, можно по данным постепенно понижать уровни для отдельных категорий.
Рекомендация: сначала прогоните небольшой набор реальных бизнес-примеров на LOW, MEDIUM и HIGH по умолчанию, а затем выбирайте уровень для продакшена. Зарегистрируйтесь на APIYI apiyi.com — вы получите бесплатный тестовый лимит; с одним API-ключом можно переключаться между Neon, Hydrogen и Carbon и сравнивать их.
Сравнение уровней мышления Gemini 4 Neon, Carbon и Hydrogen
Многие попадаются на одни и те же грабли: кажется, что вся серия Gemini 4 по умолчанию использует один и тот же набор уровней. Но если посмотреть на актуальную страницу моделей в AI Studio, всё оказывается не так:
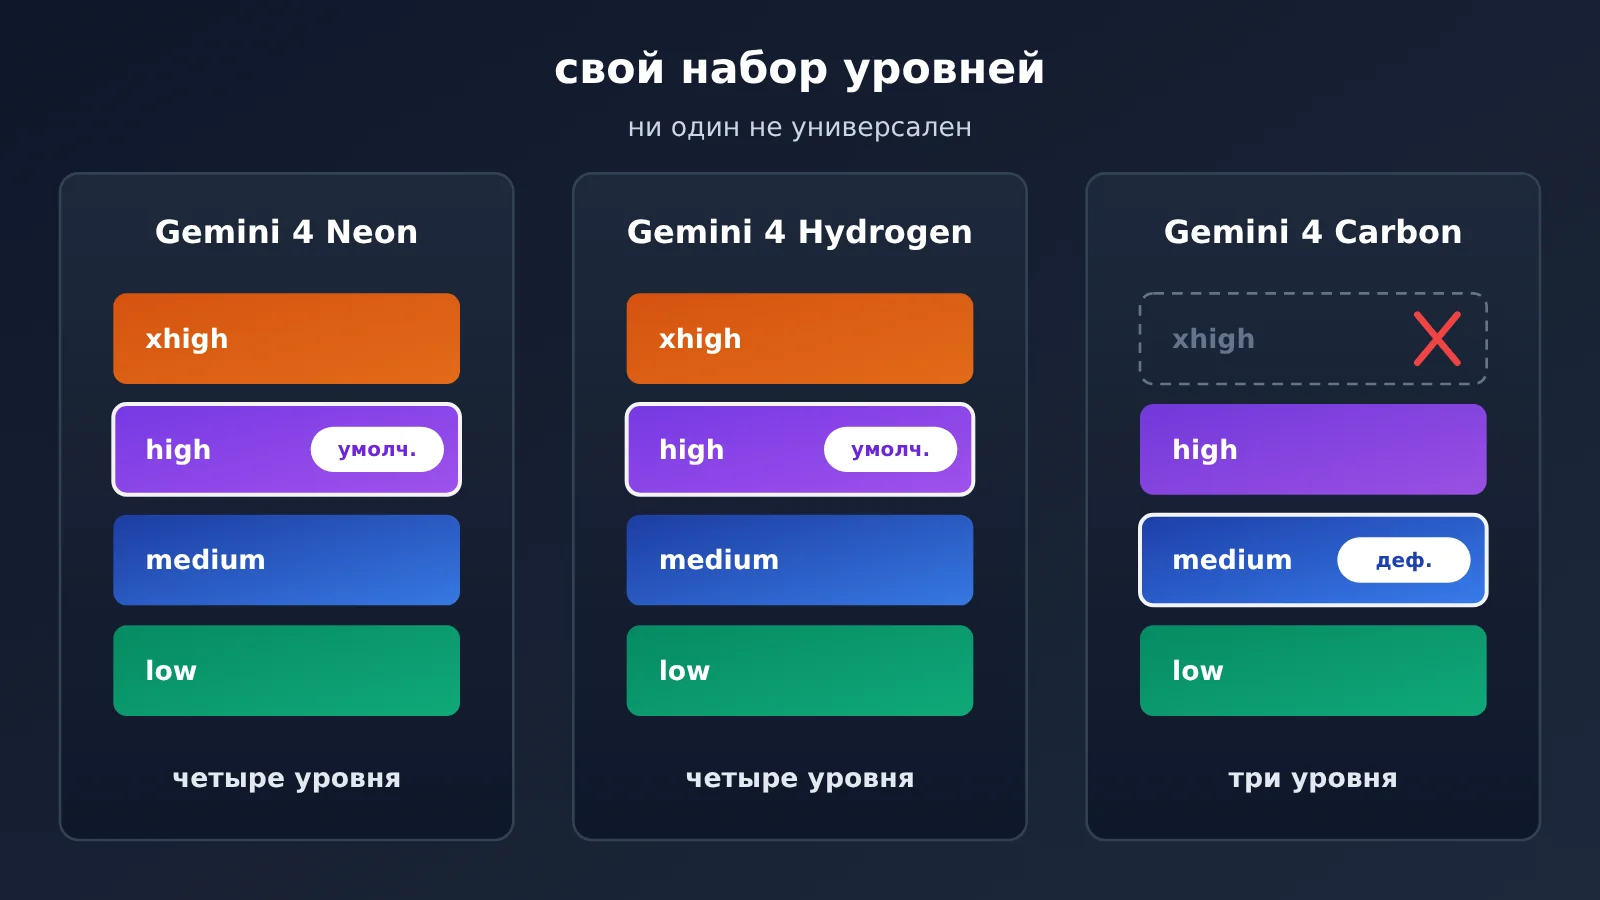
| Модель | Уровни мышления | Уровень по умолчанию | Есть ли xhigh | Доступные платформы |
|---|---|---|---|---|
| gemini-4-neon | low / medium / high / xhigh | high | Да | APIYI, официальный Google |
| gemini-4-hydrogen | low / medium / high / xhigh | high | Да | APIYI, официальный Google |
| gemini-4-carbon | low / medium / high | medium | Нет | APIYI, официальный Google |
Что значит разница в уровнях
Сравнение с Carbon: у Carbon уровень по умолчанию — medium, максимальный — high, xhigh отсутствует. Если конфигурацию, написанную для Carbon (например, «по умолчанию medium, для тяжёлых задач включаем high»), напрямую перенести на Neon, то «тяжёлые задачи» в Neon задействуют только средний уровень, а задачи, требующие доказательств, которым действительно нужен XHIGH, не получат максимальной глубины. И наоборот: если передать xhigh в Carbon, это значение не входит в поддерживаемый диапазон.
Сравнение с Hydrogen: у Hydrogen, как и у Neon, четыре уровня, и по умолчанию тоже high, так что настройки уровней этих моделей можно использовать как ориентир друг для друга. Но одинаковые названия уровней не означают одинаковую глубину мышления и стоимость: после смены модели всё равно нужно всё перепроверить.
Ситуация с Antigravity: в интерфейсе Antigravity xhigh отображается как Extra, а в CLI по-прежнему пишется xhigh. Верхний предел контекста там — 512K, а контекстное окно API — 1,048,576 token, это не одно и то же окно. Поэтому опыт, полученный в IDE, нельзя напрямую использовать для оценки поведения API при вызовах с длинным контекстом.
Пояснение к сравнению: все три модели можно вызывать через один и тот же эндпоинт
https://api.apiyi.com/v1, достаточно поменять полеmodel. Рекомендуется тестировать каждую модель отдельно в пределах поддерживаемых ею уровней и не переносить настройки уровней с одной модели на другую.
Сверка цен и эндпоинтов Gemini 4 Neon
При выборе тарифа цена за единицу волнует всегда. В таблице ниже — цены APIYI, сверенные 2026-11-20, все в долларах за миллион токенов. Источников данных два: сводная таблица моделей на APIYI apiyi.com docs.apiyi.com/models.md (обновлена 2026-11-19 10:59, UTC+8) и интерфейс ценообразования https://api.apiyi.com/api/pricing (версия shell-api-modelmak-v1, где model_ratio, равный 1, соответствует входу $2 / миллион токенов).
| ID модели | Вход | Чтение кэша | Выход | Примечание |
|---|---|---|---|---|
gemini-4-neon |
$3 |
$0.15 |
$15 |
В интерфейсе ценообразования model_ratio 1.5, completion_ratio 5, cache_ratio 0.05, совпадает с ценой Google |
gemini-4-hydrogen |
$1.5 |
$0.075 |
$7.5 |
Тоже четыре тарифа, по умолчанию high |
gemini-4-carbon |
$2 |
$0.1 |
$10 |
Совпадает с вводной ценой Google до 2026-11-30; с 1 декабря стандартная цена Google — вход $4, выход $20 |
Стоит учесть: gemini-4-neon в этой версии сводной таблицы моделей ещё не указан, но в интерфейсе ценообразования запись для него уже есть, и пересчитанная цена совпадает с объявленной Google. При сверке цен лучше ориентироваться на интерфейс ценообразования. Для Neon цена выхода $15 действует и для thinking tokens, так что чем выше тариф, тем заметнее влияние этого столбца.
Частые вопросы (FAQ)
Вопрос 1: Что такое уровни мышления Gemini 4 Neon?
Уровень мышления определяет, сколько внутренних рассуждений модель проводит перед тем, как выдать финальный ответ. Neon предлагает четыре уровня — LOW, MEDIUM, HIGH и XHIGH, по умолчанию HIGH. Токены, потраченные на рассуждения, тарифицируются по цене вывода, поэтому уровень влияет сразу на два параметра — качество ответа и стоимость.
Вопрос 2: Чем уровни мышления Gemini 4 Neon отличаются от Carbon?
У Carbon всего три уровня — low, medium и high, по умолчанию medium, а xhigh отсутствует. У Neon уровней четыре, по умолчанию high. Системы уровней у них разные, так что конфигурацию нельзя просто копировать с одной модели на другую. У Hydrogen набор уровней такой же, как у Neon: четыре уровня, по умолчанию high.
Вопрос 3: Почему мой запрос к Gemini 4 Neon возвращает HTTP 400?
Самая частая причина — в запросе всё ещё используется старый параметр `thinking_budget` или уровень выставлен как `MINIMAL`. Официальная документация прямо говорит, что оба этих варианта на Neon вернут HTTP 400. Достаточно заменить их на один из уровней от LOW до XHIGH.
Вопрос 4: Для каких задач подходит каждый уровень мышления Gemini 4 Neon?
— **LOW**: высоконагруженные задачи — классификация тикетов, маршрутизация запросов, пакетное суммирование
— **MEDIUM**: повседневное программирование, вопросы-ответы по документации
— **HIGH**: многошаговые вызовы инструментов в агентах, сложный мультимодальный анализ текста и изображений
— **XHIGH**: математические доказательства, научный анализ данных, самые тяжёлые многофайловые проекты
Вопрос 5: Как быстро вызвать Gemini 4 Neon через API и задать уровень мышления?
1. Зайдите на APIYI apiyi.com, зарегистрируйте аккаунт и получите API-ключ и бесплатную тестовую квоту
2. Укажите в SDK `base_url` как `https://api.apiyi.com/v1`, а `model` как `gemini-4-neon`
3. Передайте уровень мышления в зависимости от типа задачи — например, для классификации используйте `low`
Тот же ключ можно использовать и для вызова Hydrogen, и для Carbon — так удобно сравнивать результаты в пределах доступных у каждой модели уровней.
Вопрос 6: Какие ограничения есть у настройки уровней мышления Gemini 4 Neon?
— **Стоимость**: токены рассуждений тарифицируются по цене вывода `$15` за миллион токенов, так что высокие уровни заметно увеличивают расход на вывод
— **Параметры**: не поддерживаются `thinking_budget` и `MINIMAL`
— **Контекст**: лимит 512K в Antigravity и 1,048,576 в API — это не одно и то же контекстное окно
— **Экономия**: официальных данных о фиксированном проценте расхода токенов по уровням нет — его нужно измерять на собственных бизнес-примерах
Вопрос 7: Какой уровень выбрать, если сложность задачи непонятна?
Оставьте уровень по умолчанию — HIGH — и записывайте расход выходных токенов. Когда данные покажут, что для какого-то класса задач качество на MEDIUM или LOW не проседает, тогда и снижайте уровень именно для этого класса. Делать XHIGH уровнем по умолчанию обычно нет смысла.
Ключевые тезисы об уровнях рассуждений Gemini 4 Neon
- По умолчанию — HIGH: если не передавать параметр, Neon рассуждает с интенсивностью, рассчитанной на многошаговые вызовы инструментов.
- Для классификации и маршрутизации используйте LOW: для высоконагруженных задач разметки, маршрутизации и суммаризации официально рекомендуется LOW.
- XHIGH — только для самых тяжёлых задач: доказательства, научный анализ и многофайловые инженерные проекты.
- Не копируйте конфигурацию Carbon: у Carbon только три уровня, по умолчанию — medium, xhigh отсутствует.
- Старые параметры вызывают ошибку:
thinking_budgetиMINIMALвозвращают HTTP 400. - Рассуждения тарифицируются как выходные токены: чем выше уровень, тем больше самых дорогих выходных токенов.
- Сначала тестируйте, потом настраивайте: в APIYI apiyi.com с одним и тем же API-ключом сравните результаты и расход на разных уровнях.
Итог
Главное об уровнях рассуждений Gemini 4 Neon:
- Выбирайте уровень под задачу: LOW — для классификации, маршрутизации и суммаризации; MEDIUM — для кодинга и вопросов-ответов; HIGH — для многошаговых инструментов и мультимодальных задач; XHIGH — только для самых тяжёлых задач.
- Следите за значением по умолчанию: это HIGH; для высоконагруженных задач уровень нужно понижать вручную.
- Уровни не универсальны для разных моделей: у Neon и Hydrogen по четыре уровня, у Carbon — три; каждый настраивается отдельно.
Смысл принципа «достаточно — остановитесь» такой: сначала запустите рабочий процесс на уровне по умолчанию, затем по логам выходных токенов постепенно понижайте уровень для отдельных категорий, а не выставляйте сразу все запросы на максимум. Рекомендую в APIYI apiyi.com на бесплатной квоте сравнить LOW, MEDIUM и HIGH, а потом фиксировать продакшн-конфигурацию.
📚 Справочные материалы
-
Google Cloud — руководство по модели Gemini 4 Neon: уровни рассуждения, значения по умолчанию, описание ошибок и сценарии применения
- Ссылка:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Пояснение: основной источник для соответствия четырёх уровней и пояснений по HTTP 400 (2026-11-19)
- Ссылка:
-
Страница актуальных моделей в Google AI Studio: уровни и значения по умолчанию для Carbon и Hydrogen
- Ссылка:
aistudio.google.com - Пояснение: использовалась для проверки различий в уровнях у разных моделей Gemini 4
- Ссылка:
Автор: техническая команда APIYI
Обратная связь: если при настройке уровня рассуждения Gemini 4 Neon возникнут вопросы, напишите нам через главную страницу сайта APIYI