Примечание автора: у «скорости» Gemini 4 Neon есть как минимум три способа измерения. В этой статье отдельно разбираются время до первого токена, вывод токенов в секунду и время на решение одной задачи, а также указывается источник каждой цифры.
Gemini 4 Neon выпущен 18 ноября 2026 года. В посте Сундара Пичаи о выпуске говорится, что модель быстрее справляется с задачами в сложной разработке ПО, интеллектуальной работе и научных процессах. Многие, увидев эту фразу, воспринимают её как «самая быстрая во всём». На самом деле у измерения скорости есть как минимум три метрики, и рейтинги по ним не совпадают.
Все цифры скорости в этой статье взяты со страницы модели Artificial Analysis и из статей Artificial Analysis; результаты бенчмарков — из официальных заявлений и карточек моделей. Ни один показатель мы не измеряли сами. Цифры из разных источников и с разными методиками приводятся рядом, без усреднения и без синтеза новых значений.
Ключевая ценность: после прочтения вы сможете разобраться, каковы у Gemini 4 Neon время до первого токена, скорость вывода в секунду и время на одну задачу, узнаете, как четыре уровня рассуждений влияют на скорость и оценки, и поймёте, на какой показатель смотреть при выборе модели.
Ключевые показатели скорости Gemini 4 Neon
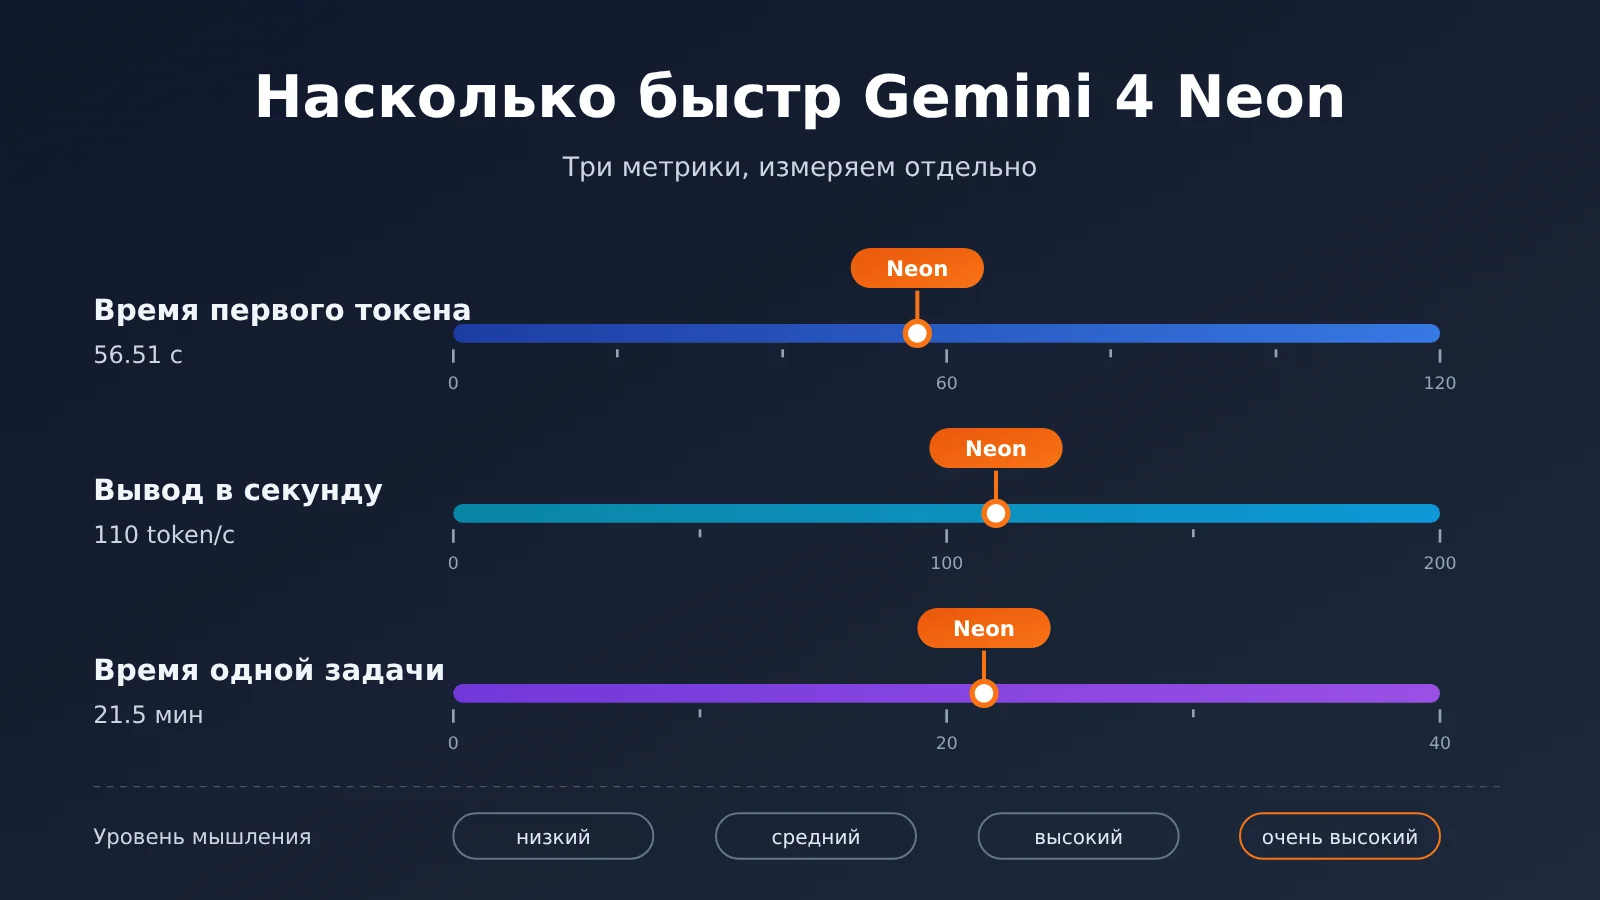
Сначала разберём три показателя, которые легко перепутать. Все значения Neon в таблице ниже — для уровня xhigh; они взяты со страницы модели на Artificial Analysis (прочитано 2026-11-19, индекс v5.0.1).
| Показатель | Что означает | Значение Gemini 4 Neon xhigh | Что ощущает пользователь |
|---|---|---|---|
| Время до первого токена | Ожидание от отправки запроса до появления первого токена ответа | 56.51 секунды | Во время диалога — «сколько висит, прежде чем начать печатать» |
| Скорость вывода | Сколько токенов генерируется за секунду после начала вывода | 110 токенов/с | Насколько быстро «строчится» потоковый вывод |
| Время на одну задачу | Сколько в среднем занимает решение одной задачи из индекса | 21.5 минуты | За сколько «сдаётся» одна задача |
| Объём вывода при прогоне индекса | Сколько токенов всего выводится за полный прогон индекса | 283 млн токенов | Вторая половина того, что определяет время на одну задачу |
Почему у Gemini 4 Neon три показателя скорости стоит смотреть по отдельности
Время до первого токена сильнее всего влияет на чат-взаимодействие. Прежде чем выдать первый токен ответа, «думающая» модель должна сначала завершить часть рассуждений, поэтому время до первого токена часто измеряется секундами или даже минутами и сильно зависит от уровня рассуждений.
Скорость вывода измеряет только пропускную способность «после начала вывода» и не говорит о том, сколько всего модели нужно сказать. Время на одну задачу зависит сразу от двух вещей: сколько токенов в секунду модель выдаёт и сколько токенов всего требуется на эту задачу. Модель может иметь высокую скорость вывода, но если она привыкла писать очень длинные рассуждения, на одну задачу она всё равно может уйти медленнее. Дальше сравнение Neon с GPT-6.2 Sol и GPT-6.2 Astra как раз об этом.
Ключевые возможности Gemini 4 Neon: место в семействе и четыре уровня мышления
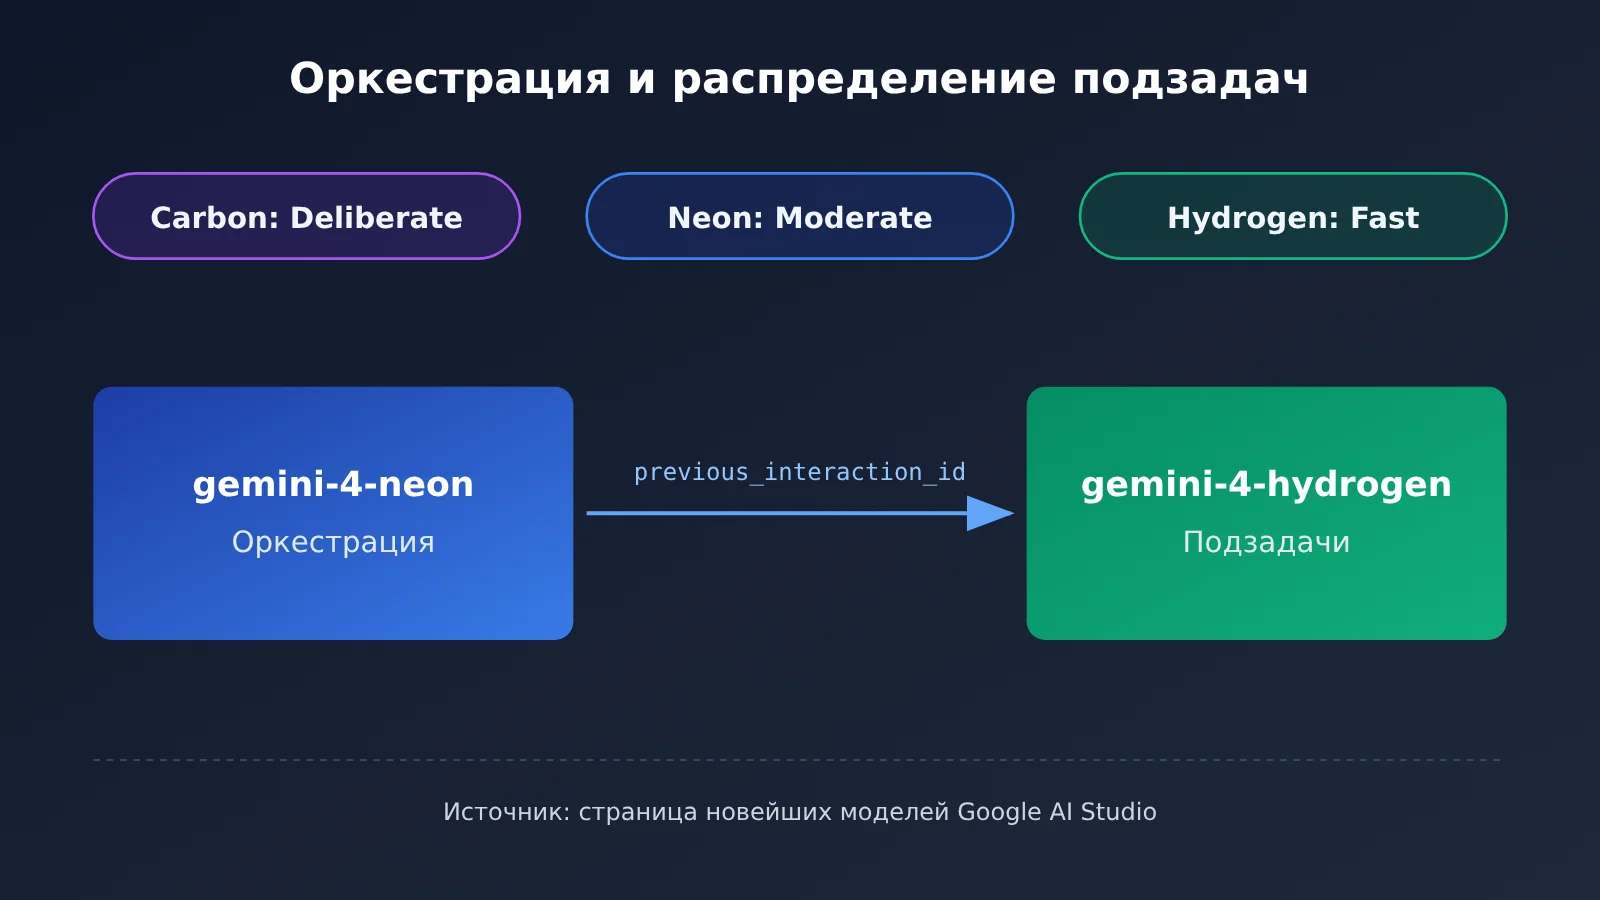
На последней странице моделей Google AI Studio три модели Gemini 4 получили качественные метки скорости: Carbon — Deliberate, Neon — Moderate, Hydrogen — Fast. То есть по официальной оценке самой Google Neon занимает в семействе среднее положение, а Fast — это именно Hydrogen. В блоге Google Carbon тоже позиционируется как модель для самых сложных долгосрочных задач, Hydrogen — для быстрого повседневного выполнения, а Neon — как компромиссный вариант для частых сложных процессов.
| Модель | Оценка скорости в AI Studio | Уровни мышления | Уровень по умолчанию | Позиция в семействе (блог Google / руководство разработчика) |
|---|---|---|---|---|
| Gemini 4 Carbon | Deliberate | low, medium, high | medium | Сложные долгосрочные задачи |
| Gemini 4 Neon | Moderate | low, medium, high, xhigh | high | Компромиссный вариант для частых сложных процессов |
| Gemini 4 Hydrogen | Fast | Данные не раскрыты | Данные не раскрыты | Быстрый повседневный цикл |
Возможности и спецификации Gemini 4 Neon
Согласно карточке модели, Gemini 4 Neon создана на основе Gemini 4 Carbon, знания обрезаны по март 2026 года, на вход принимаются текст, изображения, аудио и видео, а единое контекстное окно — до 1 млн токенов. По умолчанию синхронный вывод — до 64 тыс. токенов, фоновое длительное декодирование — до 1 млн токенов. В руководстве разработчика Google Cloud указан ID модели gemini-4-neon, общий лимит — 1048576 токенов, включая ввод и вывод; причём вывод включает рассуждения, вызовы функций и итоговый ответ.
Что касается возможностей, официально заявленный Google индекс Artificial Analysis Intelligence Index на уровне xhigh составляет 61 — третье место в общем зачёте; в блоге также признают, что модель уступает более крупным и медленным моделям. В сравнительной таблице карточки модели только три столбца: Neon, Claude Opus 5.5 и GPT-6.2 Sol. Результаты не-Gemini моделей по умолчанию взяты из отчётов самих компаний, так что эта таблица — официальная сводка, а не повторный тест, проведённый одной лабораторией в один день. В таблице есть и пункты, где Neon проигрывает: например, в Terminal-bench 4.1 точность с поправкой на читерство у Opus 5.5 составляет 65.8%, что выше 65.2% у Neon.
В руководстве разработчика также описан вариант оркестрации: gemini-4-neon выступает главным контроллером, а previous_interaction_id передаётся в gemini-4-hydrogen, который выполняет более быстрые подзадачи. Если вам кажется, что Neon недостаточно быстр, этот путь стоит рассмотреть скорее, чем просто понижать уровень (это наше мнение, а не дословная цитата из руководства).
Данные о скорости Gemini 4 Neon: разбираем все четыре уровня размышления
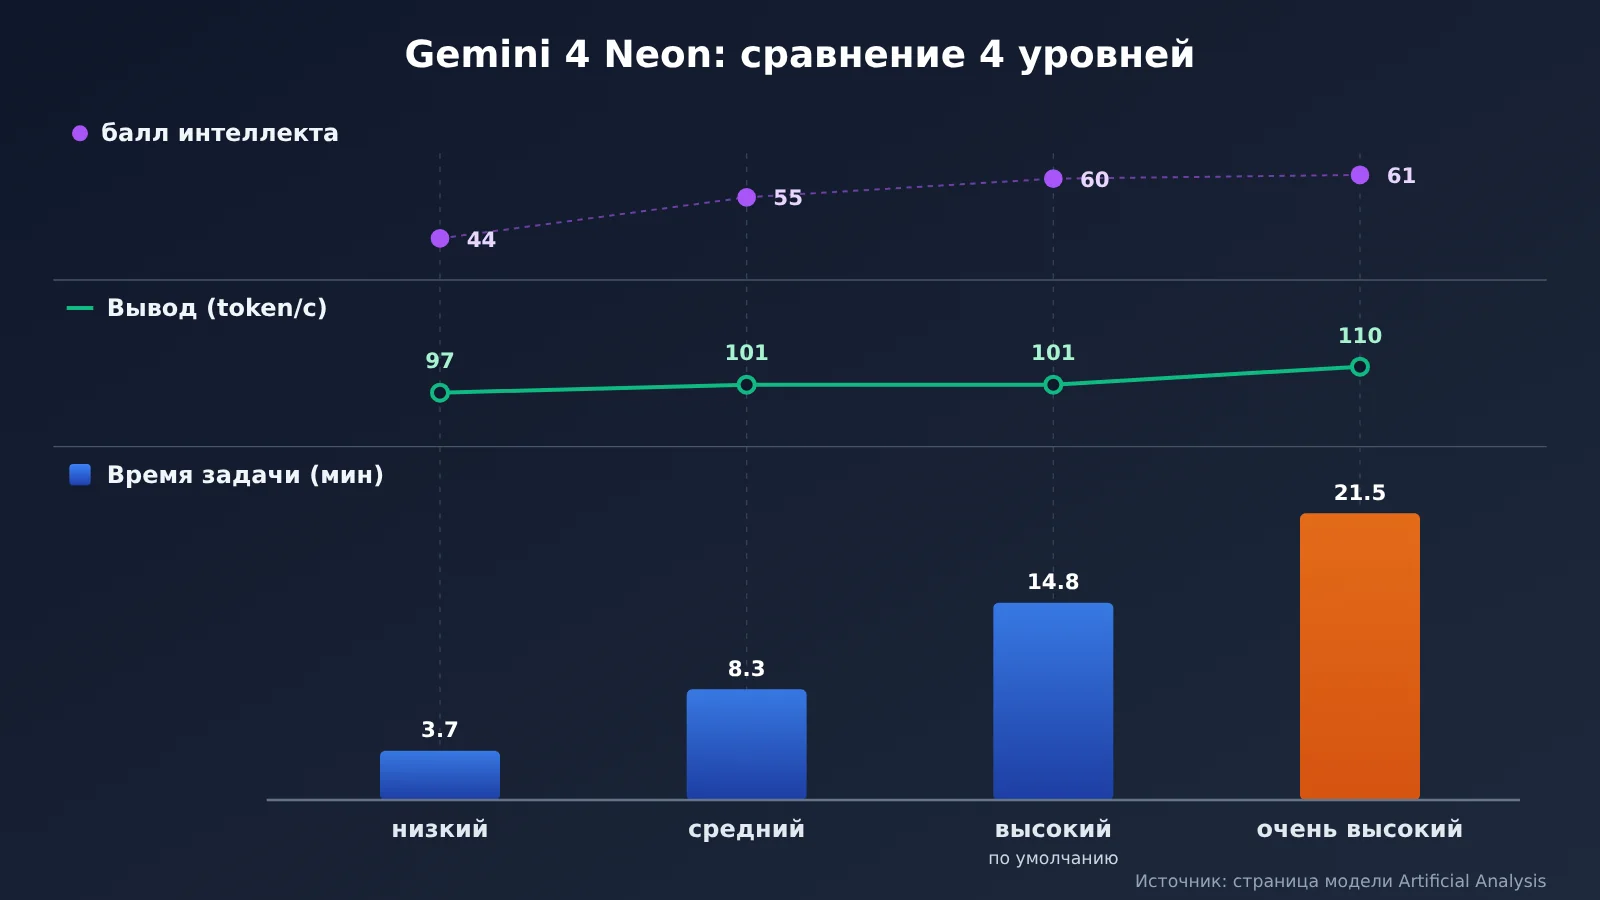
Таблица ниже взята со страницы модели на Artificial Analysis. Про время до первого токена в самом правом столбце надо сказать отдельно: в сводной таблице на странице указано только 56.51 секунды для xhigh, а значения для high, medium и low взяты из раздела FAQ на той же странице — это отдельный блок, не сводная таблица, так что при цитировании сохраняйте эту ссылку на источник.
| Уровень размышления | Балл интеллекта | Время на задачу | Вывод в секунду | Время до первого токена (раздел FAQ на странице модели) |
|---|---|---|---|---|
| xhigh | 61 | 21.5 минуты | 110 token/сек | 56.51 секунды |
| high (по умолчанию) | 60 | 14.8 минуты | 101 token/сек | 40.64 секунды |
| medium | 55 | 8.3 минуты | 101 token/сек | 20.14 секунды |
| low | 44 | 3.7 минуты | 97 token/сек | 13.93 секунды |
Если посмотреть на таблицу, вывод в секунду во всех четырёх режимах гуляет всего в диапазоне от 97 до 110 token/сек, а время на задачу растягивается с 3.7 минуты до 21.5 минуты. Переключение уровня меняет в первую очередь то, «сколько надо думать», а на «как быстро модель пишет в секунду» почти не влияет. Это вывод, который я делаю из чисел в таблице, — сама страница модели так не формулирует.
Цена в баллах тоже заметна. С high по умолчанию (60 баллов) при переходе на medium теряется всего 5 баллов, а на low падаем до 44. xhigh даёт на 1 балл больше, чем high, зато время на задачу вырастает почти на 7 минут — стоит ли оно того, зависит от вашей задачи.
Gemini 4 Neon быстрее в секунду — почему на одну задачу всё равно может уйти больше времени
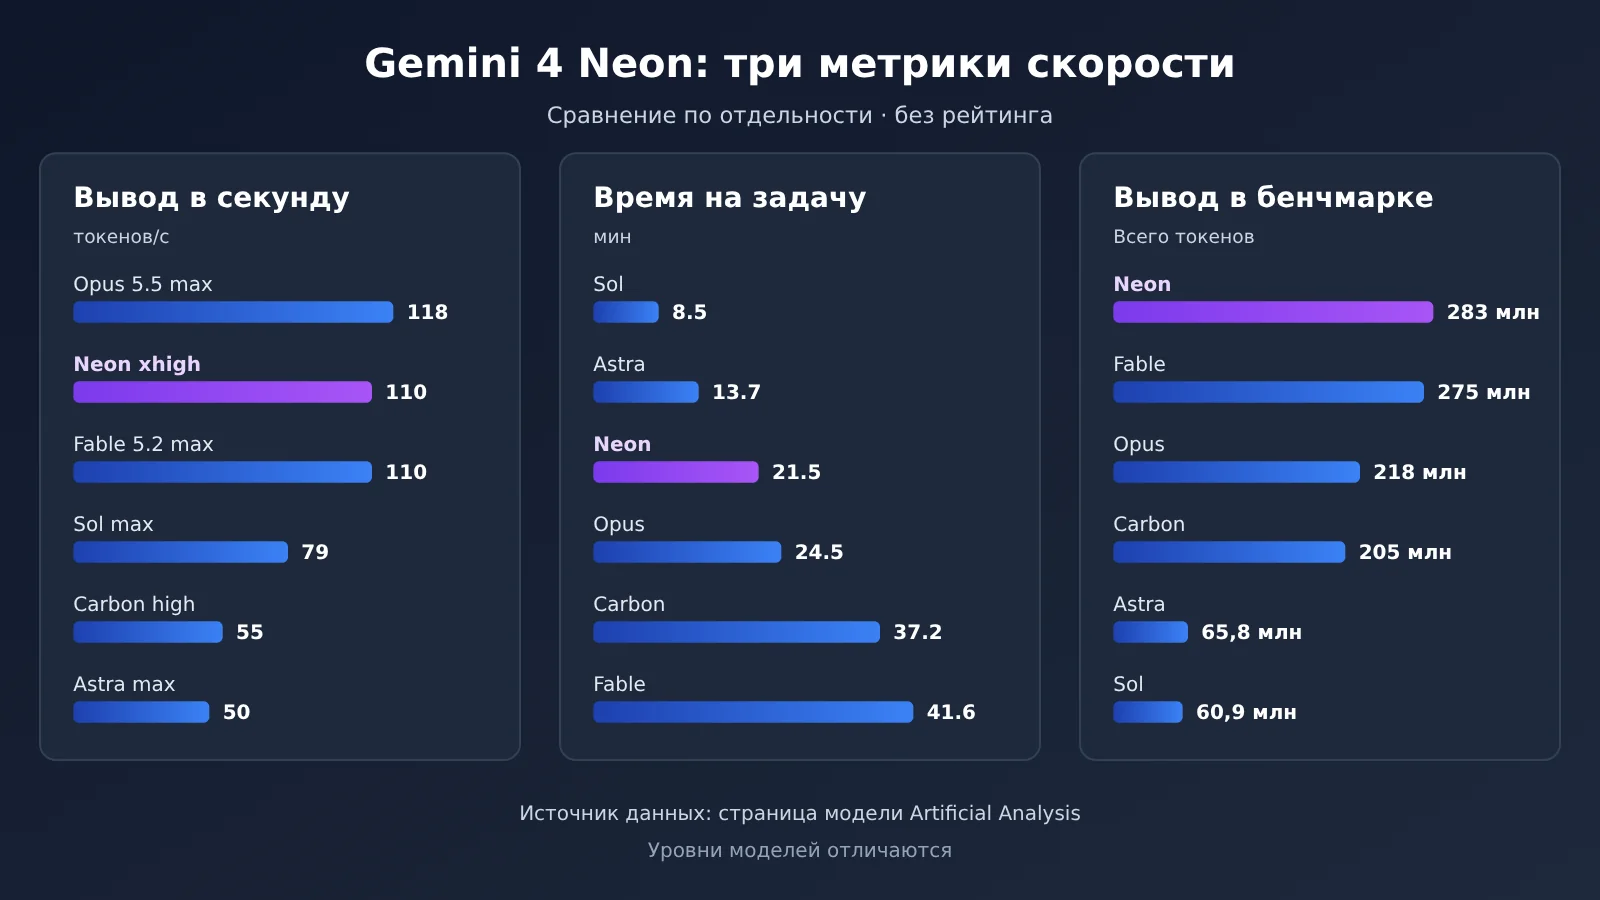
На странице модели Artificial Analysis указано: Neon в режиме xhigh при прогоне полного набора тестов индекса выдал 283 млн выходных токенов и получил 8,12 млрд входных. Чем больше выходных токенов, тем дольше общее время — даже при 110 токенах в секунду. GPT-6.2 Astra в режиме max выдаёт всего 50 токенов в секунду, но на прогоне индекса — только 65,8 млн выходных токенов, а время на одну задачу составляет 13,7 минуты. GPT-6.2 Sol в режиме max выдаёт 79 токенов в секунду, 60,9 млн выходных токенов, время на одну задачу — 8,5 минуты.
Так что «больше выходных токенов в секунду» и «задача завершается раньше» — это две разные вещи. Если сравнить Neon с этими двумя моделями GPT, у Neon скорость вывода выше, но время на одну задачу всё равно больше. Причина именно в том, что Neon выдаёт гораздо больше токенов.
Сравниваем Gemini 4 Neon с другими моделями по отдельности
Все цифры в таблице ниже взяты со страницы моделей Artificial Analysis. У моделей разные уровни настройки (Neon — xhigh, Carbon — high, остальные — max), поэтому смотреть можно только на относительные значения внутри одного столбца. Это не соревнование на равных условиях.
| Модель (уровень) | Балл интеллекта | Время на задачу | Вывод, токенов/с | Время до первого токена | Токенов за прогон индекса |
|---|---|---|---|---|---|
| Gemini 4 Neon (xhigh) | 61 | 21,5 минуты | 110 | 56,51 секунды | 283 млн |
| Gemini 4 Carbon (high) | 60 | 37,2 минуты | 55 | 73,04 секунды | 205 млн |
| Claude Opus 5.5 (max) | 59 | 24,5 минуты | 118 | 335,85 секунды | 218 млн |
| Claude Fable 5.2 (max) | 65 | 41,6 минуты | 110 | 247,46 секунды | 275 млн |
| GPT-6.2 Astra (max) | 62 | 13,7 минуты | 50 | 197,65 секунды | 65,8 млн |
| GPT-6.2 Sol (max) | 57 | 8,5 минуты | 79 | 75,06 секунды | 60,9 млн |
Посмотрим по трём показателям:
- Вывод в секунду: у Claude Opus 5.5 max — 118 токенов/с, больше, чем 110 у Neon xhigh; у Claude Fable 5.2 max и у Neon — одинаковые 110.
- Время на одну задачу: у GPT-6.2 Sol max — 8,5 минуты, у GPT-6.2 Astra max — 13,7 минуты. Оба быстрее, чем 21,5 минуты у Neon xhigh.
- Время до первого токена: у Neon xhigh — 56,51 секунды, самое маленькое значение в таблице. Но у строк разные уровни настройки, поэтому нельзя сделать вывод, что он лидирует по всем показателям.
У ускорения Neon по сравнению с Carbon есть два разных набора цифр. На странице моделей Artificial Analysis для Carbon high указаны 55 токенов/с и 37,2 минуты. В статье Artificial Analysis даны приблизительные значения: у Neon одна задача занимает около 21 минуты, это примерно на 40% меньше, чем около 36 минут у Carbon. Ускорение связано со скоростью вывода — примерно 110 против примерно 57 токенов/с, — а ещё Neon выдаёт примерно на 15% больше токенов на задачу. Эти два набора цифр для Carbon считаются по-разному, поэтому здесь мы их не вычитаем.
Как быстро начать: выбор уровня Gemini 4 Neon и методика измерения скорости
gemini-4-neon сейчас вызывается через официальные каналы Google. Ниже два блока шагов: сначала — как выбрать уровень Neon, затем — как собрать процесс замера скорости на уже доступных в APIYI моделях Gemini 4, чтобы после появления Neon осталось только сменить модель.
Шаг 1. Разберитесь с четырьмя уровнями размышления Neon. В руководстве разработчика Google Cloud указано, что у gemini-4-neon есть только уровни размышления low, medium, high и xhigh, по умолчанию — high. Если передать thinking_budget или MINIMAL, вернётся HTTP 400 — на этом чаще всего спотыкается код, перенесённый со старых версий Gemini.
Шаг 2. Понижайте уровень под требования к скорости. Если кажется, что модель работает медленно, можно снизить уровень с high по умолчанию до medium или low. Согласно странице модели на Artificial Analysis, время на одну задачу сократится с 14.8 минуты на high до 8.3 или 3.7 минуты, а балл интеллекта — с 61 на xhigh (60 на high по умолчанию) до 55 или 44. У low падение балла очень большое, поэтому перед понижением уровня лучше сначала проверить его на выборке собственных задач.
Шаг 3. Подготовьте аккаунт и ключ APIYI. Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ. Поместите ключ в переменную окружения (например, APIYI_API_KEY) и читайте её в коде — не храните ключ в открытом виде.
Шаг 4. Выберите способ вызова. В OpenAI-совместимом интерфейсе в поле base_url укажите https://api.apiyi.com/v1, а в качестве имени модели — уже доступные gemini-4-carbon или gemini-4-hydrogen. Если используете нативный протокол Gemini, адрес — https://api.apiyi.com, версия API — v1beta.
Шаг 5. Записывайте три показателя отдельно. Включите потоковый вывод stream и отдельно фиксируйте время до первого токена ответа, количество токенов в секунду после начала вывода и общее время выполнения задачи. Затем запишите общее число токенов, выданных в этом запуске. Зная число выходных токенов, можно понять, долгое выполнение — это «медленно пишет» или «много пишет».
🚀 Совет для быстрого старта: методику замера скорости лучше сначала отработать на уже доступных моделях Gemini 4. APIYI закрывает Gemini, Claude и GPT одним ключом: скрипт записи трёх показателей достаточно написать один раз, чтобы сравнивать несколько моделей, а после появления Neon останется только поменять ID модели.
Цена Gemini 4 Neon и сверка моделей в APIYI
Официальная цена Gemini 4 Neon (на странице тарифов Google AI Studio) — 3 $ за миллион входных токенов и 15 $ за миллион выходных.
В APIYI мы проверили два источника: сводную таблицу APIYI (docs.apiyi.com/models.md, на странице указано обновление 2026-11-16 09:39, UTC+8) и API тарифов, запрошенный 2026-11-19 (api.apiyi.com/api/pricing, версия shell-api-modelmak-v1, всего 285 моделей). Ниже — доступные модели, которые можно сопоставить по обоим источникам; единица — доллары за миллион токенов.
| ID модели | Вход | Чтение кэша | Выход | Эндпоинт | Примечание (источник) |
|---|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | chat, gemini | Соответствует вводной цене Google до 2026-11-30 (сводная таблица APIYI) |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat, gemini | Сводная таблица APIYI |
claude-opus-5-5 / claude-opus-5-5-thinking |
4 | 0.2 | 20 | chat, messages | Сводная таблица APIYI |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 | 0.2 | 40 | chat, messages | Сводная таблица APIYI |
gpt-6.2-sol |
2 (свыше 272000 — 3) | 0.1 | 10 (в API тарифов верхняя ступень ≈ 11.25) | responses (рекомендуется), chat | В сводной таблице указана только ступенчатая цена для входа |
gpt-6.2-astra |
8 (свыше 272000 — 16) | 0.4 | 40 (в API тарифов верхняя ступень ≈ 60) | responses, chat | В сводной таблице указана только ступенчатая цена для входа |
Есть несколько деталей, которые стоит учесть. Цена gemini-4-carbon в прайсе совпадает с вводной ценой Google, а не с последующей стандартной ценой 4/20. Названия групп в двух источниках различаются. Для моделей Gemini в сводной таблице указаны Default, SVIP, а в API тарифов — default, svip; для моделей Claude в сводной таблице — ClaudeCode, Claude_Reverse, Claude_Enterprise, Default, SVIP, а в API тарифов — ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default, svip. Повышенная цена на выход для моделей GPT отражена только в API тарифов: при превышении 272000 токенов CompletionRatio там меняется с 5 на 3.75.
gemini-4-neon нет ни в сводной таблице APIYI, ни в API тарифов — модель пока не добавлена в каталог. Мы как можно скорее добавим её; актуальные модели и цены смотрите в списке моделей на платформе.
Разбор сильных и слабых сторон Gemini 4 Neon
Сильные стороны
- Выдача токенов в секунду выше, чем у предыдущих моделей семейства: на странице модели в Artificial Analysis указано: Neon xhigh — 110 токенов/с, Carbon high — 55 токенов/с.
- Задержка до первого токена относительно небольшая: у xhigh до первого токена 56.51 секунды — наименьшее значение в таблице выше (уровни разные, так что это только для справки).
- Уровни размечены достаточно подробно: четыре режима обдумывания — от 3.7 минуты на low до 21.5 минуты на xhigh, так что можно выбирать под задачу.
- Спецификации полные: в карточке модели перечислены входные данные — текст, изображения, аудио и видео, а также единое контекстное окно на 1 млн токенов; в руководстве для разработчиков сказано, что неявное кэширование автоматически работает для общих префиксов длиннее 4096 токенов.
Ограничения
- Слишком много выходных токенов: в ходе прогона бенчмарка модель выдала 283 млн выходных токенов, из-за этого на xhigh одна задача занимает больше времени, чем у Sol и Astra. Что делать: понизить уровень или отдать подзадачи Hydrogen.
- Официальная оценка скорости — всего лишь Moderate: в AI Studio метку Fast получил Hydrogen, поэтому там, где нужна максимально быстрая интерактивность, сначала стоит попробовать Hydrogen.
- Некоторые настройки не поддерживаются: в руководстве для разработчиков прямо сказано, что явное кэширование контекста не поддерживается, а
thinking_budgetиMINIMALвозвращают400. - Нет бесплатного тарифа: на странице тарифов AI Studio указано, что у
gemini-4-neonнет бесплатного тарифа. - Цифры бенчмарков считаются по разным методикам: Coding Agent Index в блоге Google — 58.6, в статье Artificial Analysis — 59; 12.8% и 39.0% в SWE-sweep получены на двух разных harness. Когда читаете цифры, смотрите, откуда они.
Часто задаваемые вопросы (FAQ)
Q1: Gemini 4 Neon — самая быстрая модель в семействе Gemini 4?
Судя по классификации на актуальной странице моделей Google AI Studio, Hydrogen — это Fast, Neon — Moderate, а Carbon — Deliberate. Официальная формулировка «быстрее справляется» в основном подразумевает сравнение с Carbon.
Q2: Сколько ждать первого токена у Gemini 4 Neon?
В сводной таблице на странице модели Artificial Analysis указано 56.51 секунды для xhigh. В блоке FAQ на той же странице отдельно приводятся 40.64 секунды для high, 20.14 секунды для medium и 13.93 секунды для low — эти три значения взяты из FAQ, а не из сводной таблицы, это разные разделы.
Q3: Почему Gemini 4 Neon выдаёт 110 токенов в секунду, а на одну задачу всё равно уходит 21.5 минуты?
Потому что она выдаёт много токенов. На странице модели Artificial Analysis записано, что Neon на xhigh в прогоне индекса выдала 283 млн токенов, тогда как Sol max — только 60.9 млн, а Astra max — только 65.8 млн. Поэтому две последние модели работают медленнее в секунду, но на одну задачу у них уходит меньше времени.
Q4: Какой уровень у Gemini 4 Neon по умолчанию? Как переключить, если нужно быстрее?
В руководстве для разработчиков указано, что по умолчанию стоит high. Если нужно быстрее, можно снизить до medium или low: по странице модели Artificial Analysis на одну задачу тогда уйдёт 8.3 и 3.7 минуты соответственно, а балл интеллекта упадёт с 61 у xhigh (у high — 60) до 55 или 44.
Q5: Можно ли уже вызывать Gemini 4 Neon через APIYI?
По состоянию на 2026-11-19 модели `gemini-4-neon` ещё нет в общем списке APIYI и в интерфейсе цен — она пока не подключена, но мы подключим её в ближайшее время. На этом этапе можно зарегистрироваться на apiyi.com и отладить схему замера скорости на уже доступных `gemini-4-carbon` или `gemini-4-hydrogen`; OpenAI-совместимый адрес тот же, что в разделе быстрого старта выше.
Q6: Насколько Gemini 4 Neon дешевле Carbon?
Здесь три разных счёта: в блоге Google говорят, что при уровне high по умолчанию стоимость одной задачи на 32% ниже, чем у Carbon; в статье Artificial Analysis — что примерно на 17% меньше, чем у Carbon по недисконтной цене; а на странице модели Artificial Analysis по вводной цене Carbon high стоит 4.90 доллара за задачу. Методики разные, свести это в одно число нельзя.
Q7: Можно ли напрямую сравнивать результаты Gemini 4 Neon с конкурентами?
Стоит осторожно. В карточке модели отмечено, что результаты не-Gemini по умолчанию взяты из данных самих вендоров — это официальная сводка, а не повторный замер в один и тот же день; в сравнении Artificial Analysis при этом есть разница в уровнях (xhigh, high и max смешаны).
Gemini 4 Neon: ключевые выводы
- Скорость — это три разных показателя: время до первого токена, вывод токенов в секунду и время на одну задачу независимы друг от друга, и их рейтинги могут противоречить друг другу.
- Официальная оценка — средняя: AI Studio помечает Neon как Moderate, и только Hydrogen считается Fast.
- Данные xhigh: на странице модели Artificial Analysis указано 61 балл, 21,5 минуты, 110 токенов/с и 56,51 секунды до первого токена.
- Объём вывода растягивает время: 283 млн выходных токенов делают время Neon на задачу больше, чем у Sol и Astra.
- Вывод в секунду — не самый высокий: 118 токенов/с у Opus 5.5 max выше, чем 110 у Neon.
- Снижение уровня ради скорости: medium — 8,3 минуты и 55 баллов, low — 3,7 минуты и 44 балла, по умолчанию high.
- Текущий доступ: APIYI пока не добавил Neon в каталог, но можно заранее отладить процесс замера скорости на уже доступных моделях Gemini 4.
Итог
Ключевые выводы о скорости Gemini 4 Neon:
- Относительно Carbon действительно быстрее: оба набора данных Artificial Analysis показывают, что вывод в секунду у Neon примерно вдвое выше, чем у Carbon, а время на задачу заметно меньше.
- В более широком контексте — не везде лидер: вывод в секунду ниже, чем у Opus 5.5 max, а время на задачу больше, чем у Sol max и Astra max.
- Уровни — главный переключатель: вывод в секунду между четырьмя уровнями меняется незначительно, а разница во времени в основном зависит от количества «мыслящих» токенов.
Наша оценка: в интерактивных сценариях смотрите прежде всего на время до первого токена, в пакетной обработке — на время на одну задачу, и только для стримингового опыта имеет смысл обращать внимание на вывод в секунду. «Достаточно ли быстр» Neon — зависит от того, какой показатель для вас важнее. Рекомендуем сначала на APIYI apiyi.com прогнать на существующих моделях Gemini 4 весь процесс записи трёх метрик, а после появления Neon в каталоге просто заменить модель и сравнить.
📚 Справочные материалы
-
Публикация Sundar Pichai: выпуск Gemini 4 Neon и охват доступа
- Ссылка:
x.com/sundarpichai/status/2123167780988125621 - Пояснение: канал публикации и официальная формулировка «быстрее доводить до конца»
- Ссылка:
-
Блог Google «Introducing Gemini 4 Neon»: официальные собственные результаты тестов, цены и позиционирование в семействе
- Ссылка:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Пояснение: все цифры взяты из официальных заявлений
- Ссылка:
-
Карточка модели DeepMind: спецификации и сравнительная таблица из трёх колонок
- Ссылка:
deepmind.google/models/model-cards/gemini-4-neon/ - Пояснение: результаты других моделей, кроме Gemini, по умолчанию взяты из официальных заявлений соответствующих компаний
- Ссылка:
-
Руководство для разработчиков Google Cloud: идентификаторы моделей, режимы размышления и описание ошибок
- Ссылка:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Пояснение: четыре режима размышления, значение по умолчанию — high, условия возникновения HTTP 400
- Ссылка:
-
Страницы цен и актуальных моделей Google AI Studio: официальные цены и словесное описание скорости
- Ссылка:
aistudio.google.com/docs/pricing,aistudio.google.com/docs/latest-model - Пояснение: три уровня — Deliberate, Moderate, Fast
- Ссылка:
-
Статья Artificial Analysis: стороннее сравнение Neon и Carbon
- Ссылка:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Пояснение: приблизительные значения — около 21 минуты, около 36 минут, около 57 токенов/с и т. п.
- Ссылка:
-
Страница модели Artificial Analysis: четыре уровня скорости и данные по моделям для сравнения
- Ссылка:
artificialanalysis.ai/models/gemini-4-neon - Пояснение: данные прочитаны 19.11.2026, индекс v5.0.1, в разделе FAQ дополнительно приведено время до первого токена для каждого уровня
- Ссылка:
-
Сводная таблица APIYI: размещённые модели и цены
- Ссылка:
docs.apiyi.com/models.md - Пояснение: модели и цены приведены согласно списку моделей платформы
- Ссылка:
Автор: техническая команда APIYI
Технические вопросы: по прогрессу размещения Gemini 4 Neon и вопросам о моделях добро пожаловать на главную страницу APIYI apiyi.com, чтобы связаться с нами