Nota do autor: o Gemini 4 Neon tem quatro níveis de raciocínio (thinking levels), o padrão é HIGH, e os tokens de pensamento são cobrados pelo preço de saída (output). Este artigo explica para que tipo de tarefa cada nível serve e também deixa claro por que não dá para simplesmente copiar a configuração de níveis do Carbon para o Neon.
Depois de integrar o Gemini 4 Neon, o primeiro problema que muitos desenvolvedores esbarram não é a qualidade do resultado, mas a fatura. Os tokens de pensamento são cobrados pelo preço de saída; quanto mais alto o nível, mais o modelo pondera antes de entregar a resposta e mais tokens de saída são gerados. A recomendação deste artigo é escolher o nível conforme a tarefa, parar quando bastar, para você achar o nível certo entre resultado e custo.
Este não é um artigo de “quanto mais alto, melhor”. A documentação do Google Cloud já descreve de forma bem específica os cenários de aplicação de cada nível do Neon. Com base na documentação oficial, este artigo organiza tudo numa tabela de referência que você pode seguir direto para configurar, além de acrescentar alguns erros e pontos de confusão comuns.
Valor central: ao terminar este artigo, você vai saber que o Gemini 4 Neon já vem com HIGH como padrão, que tarefas de classificação e roteamento precisam apenas de LOW, que XHIGH fica reservado para os trabalhos mais pesados — e que não vai aplicar por engano configurações do Carbon ou do Antigravity na chamada de API.
Pontos-chave dos níveis de pensamento do Gemini 4 Neon
Vamos começar pelas conclusões mais importantes. Todas vêm da documentação do Gemini 4 Neon no Google Cloud (versão de 2026-11-19) e da página mais recente de modelos do AI Studio:
| Ponto | Descrição | Valor para você |
|---|---|---|
| Quatro níveis de pensamento | LOW, MEDIUM, HIGH, XHIGH, padrão HIGH | Se você não passar o parâmetro, já fica numa faixa alta e precisa baixar o nível manualmente |
| Parâmetros antigos geram erro | thinking_budget e MINIMAL retornam HTTP 400 |
É preciso alterar os parâmetros ao migrar código antigo |
| Cobrança de tokens de pensamento | Tokens de pensamento são cobrados pelo preço unitário de saída | O nível impacta diretamente o custo do lado da saída |
| Níveis não são universais entre modelos | Carbon tem apenas três níveis, padrão medium; Hydrogen tem quatro, igual ao Neon | Não dá para copiar a configuração de um modelo para outro |
| Interface e API são diferentes | O “Extra” na interface do Antigravity é o xhigh, e o limite de contexto também é diferente | Evite inferir o comportamento da API a partir da experiência no IDE |
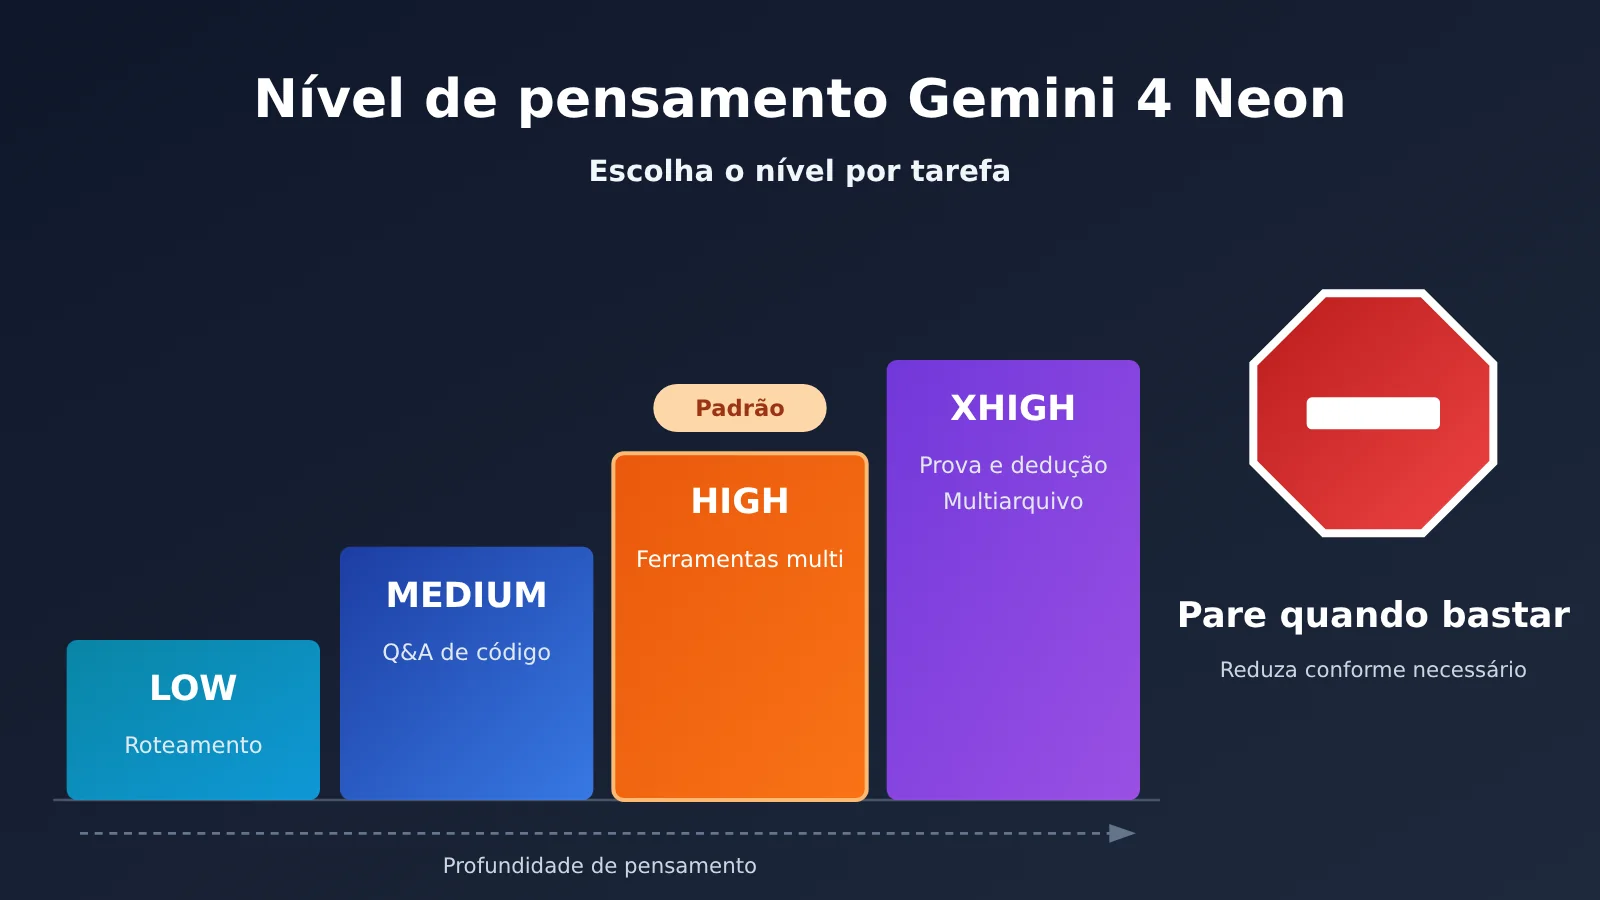
Níveis de pensamento do Gemini 4 Neon e correspondência com tarefas
A documentação oficial indica os cenários recomendados para cada nível. Organizei na tabela abaixo para facilitar a consulta na hora de configurar:
| Nível de pensamento | Cenário recomendado oficial | Exemplo típico de negócio | Dica de escolha |
|---|---|---|---|
LOW |
Classificação, roteamento e resumos de alta throughput | Etiquetar tickets, identificar intenção, extrair pontos-chave de textos longos | Prefira este nível para tarefas em lote |
MEDIUM |
Codificação geral, perguntas e respostas sobre documentos | Escrever funções, corrigir bugs, responder perguntas com base em uma base de conhecimento | Suficiente para a maioria das solicitações de desenvolvimento do dia a dia |
HIGH (padrão) |
Chamadas de ferramentas em múltiplas etapas, multimodalidade complexa | Agente chamando ferramentas em sequência, análise mista de texto e imagem | É este o nível quando você não passa nenhum parâmetro |
XHIGH |
Provas, análise científica, os projetos mais pesados com múltiplos arquivos | Deduções matemáticas, análise de dados experimentais, refatoração atravessando vários módulos | Use apenas nas tarefas mais pesadas |
Há dois pontos de atenção nesta tabela. Primeiro, o valor padrão é HIGH, não MEDIUM. Ou seja, se você não escrever nada no código, toda requisição de classificação vai raciocinar com a intensidade de “chamadas de ferramentas em múltiplas etapas”, o que normalmente é desperdício em cenários de alta throughput. Segundo, XHIGH é o nível máximo do Neon, destinado a provas e às tarefas de engenharia mais pesadas; colocar XHIGH em requisições de codificação do dia a dia provavelmente só vai render mais tempo de espera e mais tokens de saída.
Por que o Gemini 4 Neon deve “parar quando já é suficiente”
O ponto central do custo está na forma de cobrança. Os tokens de pensamento são cobrados pelo preço unitário de saída, e o preço de saída do Gemini 4 Neon é 5 vezes o preço de entrada (o preço anunciado pelo Google é $3 para entrada, $0.15 para cache e $15 para saída, todos por milhão de tokens). Quanto mais pensamento, maior a fatia mais cara dos tokens.
Quanto cada nível consome a mais em tokens de pensamento depende da complexidade da tarefa em si. A documentação oficial não traz uma proporção fixa, e este artigo também não apresenta números do tipo “quanto se economiza baixando um nível”. A abordagem mais segura é rodar LOW e o padrão HIGH nos seus próprios exemplos de negócio, comparar o consumo de tokens de saída e a qualidade das respostas retornadas, e só então decidir se vale baixar o nível.
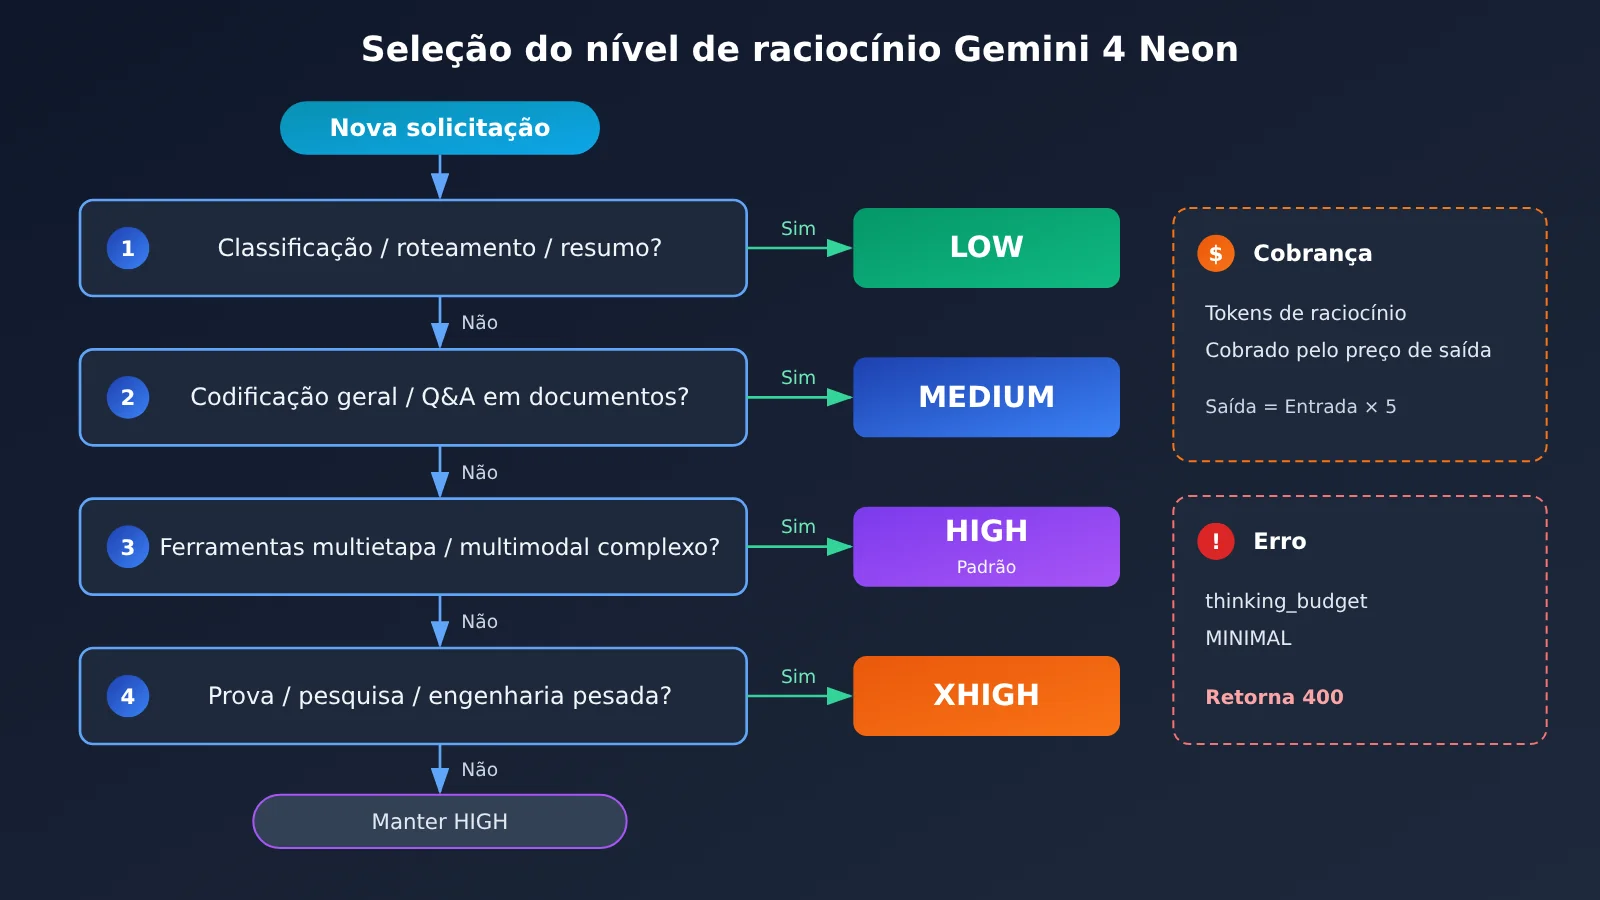
Guia rápido dos níveis de pensamento do Gemini 4 Neon
Exemplo mínimo: usar o nível LOW para classificação
A APIYI oferece uma interface compatível com OpenAI. Basta alterar o base_url no SDK oficial openai para Python e você já consegue chamar o Gemini 4 Neon. Abaixo, os passos com o código principal; cada um pode ser copiado diretamente:
- Instale o SDK:
pip install openai - Crie o cliente:
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - Especifique o modelo:
model="gemini-4-neon" - Defina o nível de pensamento:
reasoning_effort="low" - Envie a requisição:
client.chat.completions.create(model="gemini-4-neon", reasoning_effort="low", messages=[{"role": "user", "content": "判断这条工单属于:账单 / 技术 / 其他。工单内容:……"}]) - Leia o resultado:
resp.choices[0].message.content
Para tarefas de classificação, basta uma etiqueta, e o nível LOW já atende. Se você mudar para geração de código ou para responder perguntas com base em documentos, troque o passo 4 por reasoning_effort="medium".
Vale explicar que o nome do parâmetro depende do formato de interface que você usa. Na interface nativa do Gemini, o nível de pensamento fica no campo thinking_level dentro de thinking_config, com valores LOW / MEDIUM / HIGH / XHIGH. No formato compatível com OpenAI, a intensidade de raciocínio geralmente é passada via reasoning_effort. O mapeamento específico dos campos deve ser consultado na documentação da plataforma; antes de colocar em produção, recomendo enviar uma requisição para confirmar que o nível realmente está ativo.
Ver a implementação completa: escolher o nível automaticamente por tipo de tarefa
Em produção, uma prática melhor é deixar o código de negócio escolher o nível com base no tipo de tarefa, em vez de fixar um valor globalmente. A implementação pode ser dividida nos seguintes passos:
1. Defina a tabela de mapeamento: `LEVEL_MAP = {“classify”: “low”, “route”: “low”, “summary”: “low”, “code”: “medium”, “doc_qa”: “medium”, “agent”: “high”, “multimodal”: “high”, “proof”: “xhigh”, “multi_file”: “xhigh”}`
2. Defina um valor de fallback: `level = LEVEL_MAP.get(task_type, “high”)`; para tarefas desconhecidas, use o HIGH padrão oficial, assim você não reduz a qualidade sem querer
3. Centralize o cliente: `client = OpenAI(api_key=os.getenv(“APIYI_KEY”), base_url=”https://api.apiyi.com/v1″)`
4. Faça a chamada: `client.chat.completions.create(model=”gemini-4-neon”, reasoning_effort=level, messages=messages)`
5. Registre o uso: grave no log a quantidade de tokens de saída em `resp.usage`, junto com `task_type` e `level`, para facilitar a análise do custo de raciocínio por tipo de tarefa
6. Trate erros 400: ao capturar a exceção, verifique se a requisição ainda inclui `thinking_budget` ou `MINIMAL`; esses dois valores retornam HTTP 400 no Neon
O valor de fallback do passo 2 é importante. Se a tabela de mapeamento esquecer algum tipo de tarefa, é melhor gastar mais tokens com o HIGH padrão do que cair silenciosamente para LOW e gerar uma resposta errada. Depois de acumular logs por um tempo, você pode ajustar cada categoria para baixo com base nos dados.
Recomendação: primeiro rode uma pequena amostra de tarefas reais com LOW, MEDIUM e o HIGH padrão, e depois decida o nível em produção. Cadastre-se na APIYI (apiyi.com) para ganhar cota gratuita de testes; com uma única chave API, você pode alternar e comparar entre Neon, Hydrogen e Carbon.
Comparação dos níveis de raciocínio do Gemini 4 Neon com Carbon e Hydrogen
Muita gente se dá mal porque assume, por padrão, que a série Gemini 4 compartilha o mesmo conjunto de níveis. Segundo a página de modelos mais recente do AI Studio, a realidade não é bem assim:
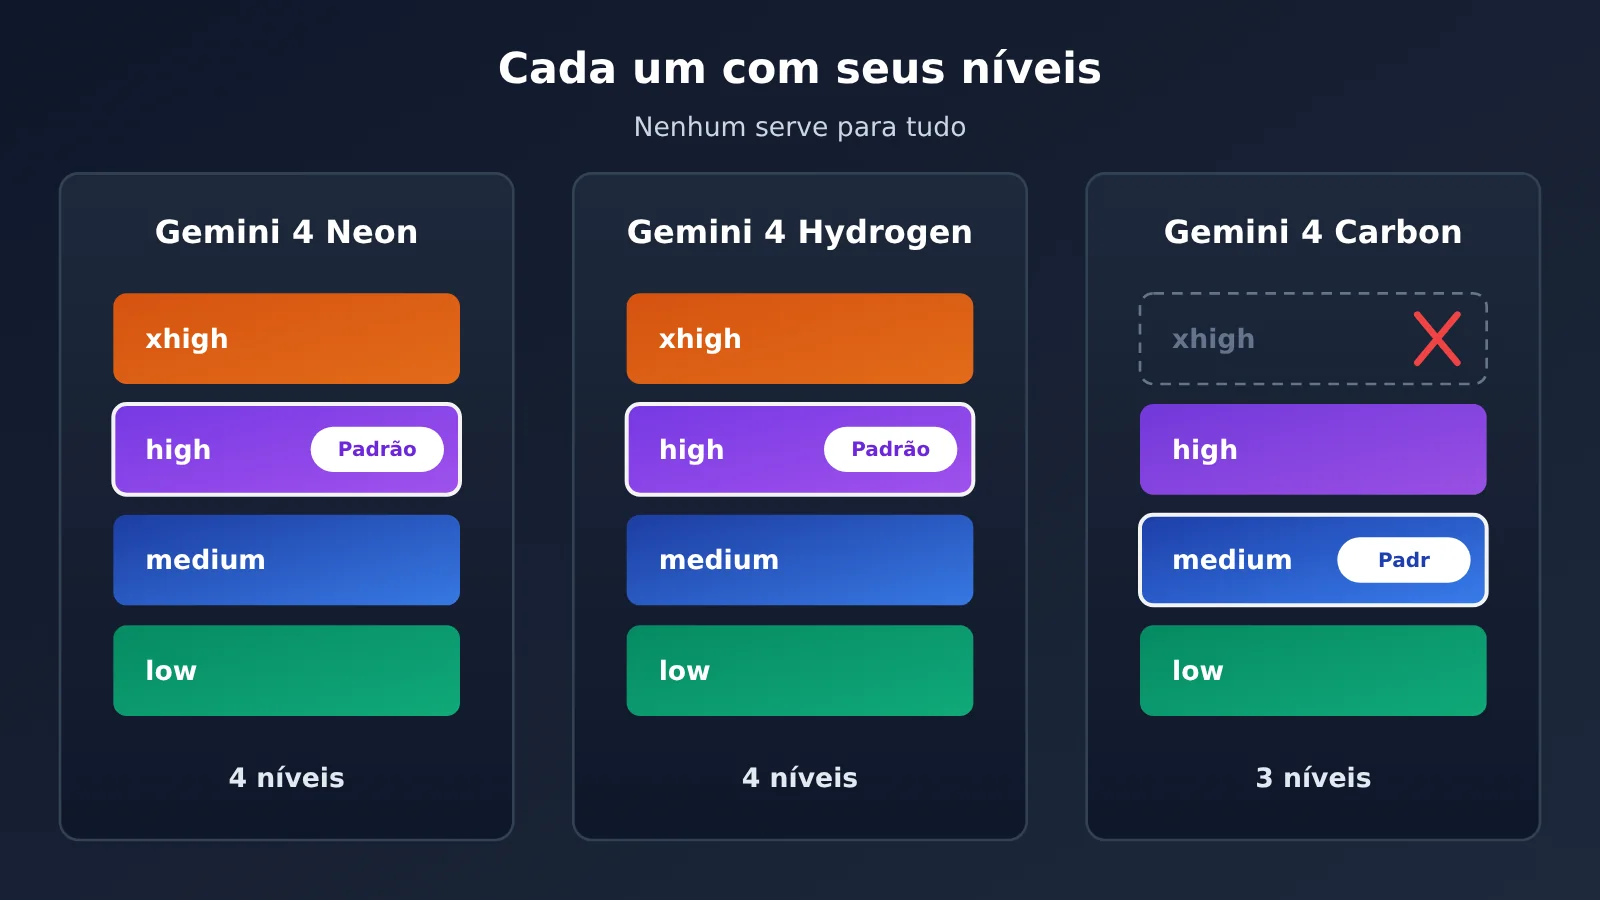
| Modelo | Nível de raciocínio | Nível padrão | Possui xhigh | Plataformas disponíveis |
|---|---|---|---|---|
| gemini-4-neon | low / medium / high / xhigh | high | Sim | APIYI, Google oficial |
| gemini-4-hydrogen | low / medium / high / xhigh | high | Sim | APIYI, Google oficial |
| gemini-4-carbon | low / medium / high | medium | Não | APIYI, Google oficial |
Interpretação das diferenças entre níveis
Análise comparativa do Carbon: O nível padrão do Carbon é medium, o nível mais alto é high e não há xhigh. Se você aplicar diretamente ao Neon uma configuração escrita para o Carbon (por exemplo, “padrão medium, tarefas pesadas em high”), as “tarefas pesadas” do Neon vão usar apenas o nível intermediário, e tarefas de prova que realmente precisam de XHIGH não vão atingir a intensidade máxima. Por outro lado, passar o xhigh do Neon para o Carbon também não está entre os valores que ele aceita.
Análise comparativa do Hydrogen: Hydrogen, assim como Neon, tem quatro níveis, e o padrão também é high, então as configurações de nível dos dois podem servir de referência mútua. Mas nomes de níveis iguais não significam que a profundidade de raciocínio e o custo no mesmo nível sejam iguais; depois de trocar de modelo, ainda é preciso reavaliar.
O caso do Antigravity: Na interface do Antigravity, xhigh aparece como Extra; na CLI, continua sendo escrito como xhigh. O limite de contexto dele é 512K, enquanto a janela de contexto da API é de 1,048,576 tokens; não são a mesma janela. Por isso, a experiência obtida na IDE não pode ser usada diretamente para estimar o desempenho com contexto longo em chamadas de API.
Observação comparativa: Os três modelos podem ser invocados pelo mesmo endpoint
https://api.apiyi.com/v1; basta trocar o campomodel. Recomenda-se testar cada um separadamente dentro da faixa de níveis que ele suporta, sem copiar configurações de nível de um modelo para outro.
Verificação de preços e endpoints do Gemini 4 Neon
Na hora de escolher um nível, o preço unitário sempre pesa. A tabela abaixo traz os preços da APIYI conferidos em 2026-11-20, todos em dólares por milhão de tokens. As fontes são duas: a tabela geral de modelos em docs.apiyi.com/models.md da APIYI apiyi.com (atualizada em 2026-11-19 10:59, UTC+8) e o endpoint de preços https://api.apiyi.com/api/pricing (versão shell-api-modelmak-v1, em que model_ratio igual a 1 corresponde a entrada de $2 por milhão de tokens).
| ID do modelo | Entrada | Leitura de cache | Saída | Observações |
|---|---|---|---|---|
gemini-4-neon |
$3 |
$0.15 |
$15 |
Endpoint de preços com model_ratio 1.5, completion_ratio 5 e cache_ratio 0.05, igual ao preço de tabela do Google |
gemini-4-hydrogen |
$1.5 |
$0.075 |
$7.5 |
Também em quatro níveis, padrão high |
gemini-4-carbon |
$2 |
$0.1 |
$10 |
Igual ao preço introdutório do Google válido até 2026-11-30; a partir de 1º de dezembro, o preço padrão do Google passa a ser $4 de entrada e $20 de saída |
Vale notar que o gemini-4-neon ainda não aparece na tabela geral de modelos dessa versão, mas o endpoint de preços já tem a entrada correspondente, e o preço convertido bate com o comunicado do Google. Na hora de conferir preços, a recomendação é usar o endpoint de preços como referência. Para o Neon, o preço de saída de $15 vale também para os tokens de raciocínio, então quanto mais alto o nível, maior o impacto dessa coluna.
Perguntas Frequentes (FAQ)
Q1: O que é o nível de raciocínio do Gemini 4 Neon?
O nível de raciocínio define quanto o modelo faz de inferência interna antes de chegar à resposta final. O Neon oferece quatro níveis — LOW, MEDIUM, HIGH e XHIGH — com HIGH como padrão. Os tokens gerados pelo raciocínio são cobrados pelo preço de saída, então o nível afeta ao mesmo tempo a qualidade da resposta e o custo.
Q2: Qual é a diferença entre os níveis de raciocínio do Gemini 4 Neon e do Carbon?
O Carbon tem apenas três níveis — low, medium e high — com medium como padrão e sem xhigh; o Neon tem quatro níveis, com high como padrão. Os dois modelos usam sistemas de níveis diferentes, então a configuração de um não pode ser copiada para o outro. O Hydrogen tem os mesmos níveis do Neon: quatro opções, com high como padrão.
Q3: Por que minhas requisições ao Gemini 4 Neon retornam HTTP 400?
A causa mais comum é que a requisição ainda usa o parâmetro antigo `thinking_budget`, ou define o nível como `MINIMAL`. A documentação oficial deixa claro que as duas formas retornam HTTP 400 no Neon. Basta mudar para um dos níveis entre LOW e XHIGH.
Q4: Para que tipo de tarefa serve cada nível de raciocínio do Gemini 4 Neon?
– **LOW**: classificação de chamados, roteamento de requisições, resumos em lote e outras tarefas de alto throughput
– **MEDIUM**: programação do dia a dia, perguntas e respostas baseadas em documentos
– **HIGH**: chamadas de ferramentas em múltiplas etapas por agentes, análise multimodal complexa de texto e imagem
– **XHIGH**: provas matemáticas, análise de dados científicos, os projetos de engenharia mais pesados com múltiplos arquivos
Q5: Como chamar o Gemini 4 Neon rapidamente via API e definir o nível de raciocínio?
1. Acesse APIYI apiyi.com, crie sua conta e obtenha a chave API e a cota gratuita de testes
2. Defina o `base_url` do SDK como `https://api.apiyi.com/v1` e o `model` como `gemini-4-neon`
3. Passe o nível de raciocínio conforme o tipo de tarefa, por exemplo `low` para tarefas de classificação
A mesma chave também serve para chamar o Hydrogen e o Carbon, o que facilita comparar os resultados dentro da faixa de níveis de cada um.
Q6: Quais são as limitações ao definir o nível de raciocínio do Gemini 4 Neon?
– **Custo**: os tokens de raciocínio são cobrados pela tarifa de saída de `$15` por milhão de tokens, e níveis mais altos aumentam bastante o volume de saída
– **Parâmetros**: não há suporte a `thinking_budget` nem a `MINIMAL`
– **Contexto**: o limite de 512K no Antigravity não é a mesma janela de 1.048.576 da API
– **Economia**: a documentação oficial não informa uma proporção fixa de consumo de tokens por nível, então é preciso medir com suas próprias amostras de uso real
Q7: Se eu não tenho certeza da complexidade da tarefa, qual nível devo escolher?
Mantenha o padrão HIGH e registre o consumo de tokens de saída. Quando os dados mostrarem que alguma categoria de tarefa não perde qualidade em MEDIUM ou LOW, aí sim reduza o nível só para essa categoria. Definir XHIGH como padrão normalmente não faz sentido.
Pontos-chave dos níveis de raciocínio do Gemini 4 Neon
- O padrão é HIGH: se você não passar o parâmetro, o Neon já pensa com a intensidade de chamadas de ferramentas em várias etapas
- Para roteamento por classificação, use LOW: tarefas de alta vazão, como marcação, roteamento e resumo, têm recomendação oficial de LOW
- Deixe o XHIGH para as tarefas mais pesadas: só use em demonstrações, análise científica e engenharia com vários arquivos
- Não copie a configuração do Carbon: o Carbon tem apenas três níveis, o padrão é medium e não existe xhigh
- Parâmetros antigos geram erro:
thinking_budgeteMINIMALretornam HTTP 400 - O raciocínio é cobrado como saída: quanto mais alto o nível, mais tokens de saída caros você consome
- Teste antes de definir: na APIYI apiyi.com, compare o resultado e o consumo de diferentes níveis usando a mesma chave
Resumo
Pontos-chave dos níveis de raciocínio do Gemini 4 Neon:
- Escolha o nível pela tarefa: LOW para classificação, roteamento e resumo; MEDIUM para codificação e perguntas e respostas; HIGH para ferramentas em várias etapas e multimodal; XHIGH só para as tarefas mais pesadas
- Fique de olho no valor padrão: o padrão é HIGH, então tarefas de alta vazão precisam baixar o nível de propósito
- Os níveis não são universais entre modelos: Neon e Hydrogen têm quatro níveis, o Carbon tem três, e cada um é configurado separadamente
A ideia de “pare quando já for suficiente” é: primeiro coloque o negócio para rodar com o nível padrão e depois vá reduzindo por categoria com base nos logs de tokens de saída, em vez de mandar todas as requisições no máximo desde o início. Vale a pena usar a cota gratuita na APIYI apiyi.com para fazer uma rodada de comparação entre LOW, MEDIUM e HIGH e só então definir a configuração de produção.
📚 Materiais de referência
-
Google Cloud – Guia do modelo Gemini 4 Neon: níveis de pensamento, configuração padrão, descrição de erros e cenários de aplicação
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Descrição: principal base para a correspondência entre os quatro níveis deste artigo e a explicação do HTTP 400 (19/11/2026)
- Link:
-
Página dos modelos mais recentes do Google AI Studio: níveis e valores padrão do Carbon e do Hydrogen
- Link:
aistudio.google.com - Descrição: usada para confirmar as diferenças de níveis entre os diferentes modelos Gemini 4
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: se você encontrar problemas ao configurar os níveis de pensamento do Gemini 4 Neon, fique à vontade para nos contatar pela página inicial do site oficial da APIYI