Catatan penulis: Gemini 4 Neon memiliki empat tingkat berpikir, default-nya HIGH, dan token berpikir ditagih dengan tarif output. Artikel ini menjelaskan tugas seperti apa yang cocok untuk masing-masing tingkat, sekaligus mengapa konfigurasi tingkat dari Carbon tidak bisa langsung diterapkan ke Neon.
Setelah terhubung ke Gemini 4 Neon, masalah pertama yang dihadapi banyak developer sering kali bukan hasil, melainkan tagihan. Token berpikir dihitung dengan harga output; semakin tinggi tingkat yang dipakai, semakin banyak model berpikir sebelum memberikan jawaban, dan semakin banyak pula token output. Saran dalam artikel ini adalah pilih tingkat sesuai tugas, berhenti saat sudah cukup, untuk membantu Anda menemukan tingkat yang pas antara hasil dan biaya.
Ini bukan artikel pengenalan parameter yang menganut prinsip “semakin tinggi semakin baik”. Dokumentasi Google Cloud sudah menuliskan secara spesifik skenario yang cocok untuk setiap tingkat Neon. Artikel ini berpedoman pada dokumentasi resmi, merangkumnya menjadi tabel perbandingan yang bisa langsung diikuti saat konfigurasi, dan menambahkan beberapa error umum serta poin yang sering membingungkan.
Nilai inti: Setelah membaca artikel ini, Anda akan tahu bahwa default Gemini 4 Neon adalah HIGH, tugas klasifikasi dan perutean cukup memakai LOW, XHIGH hanya disiapkan untuk pekerjaan paling berat, dan Anda tidak akan salah menerapkan pengaturan dari Carbon atau Antigravity ke pemanggilan API.
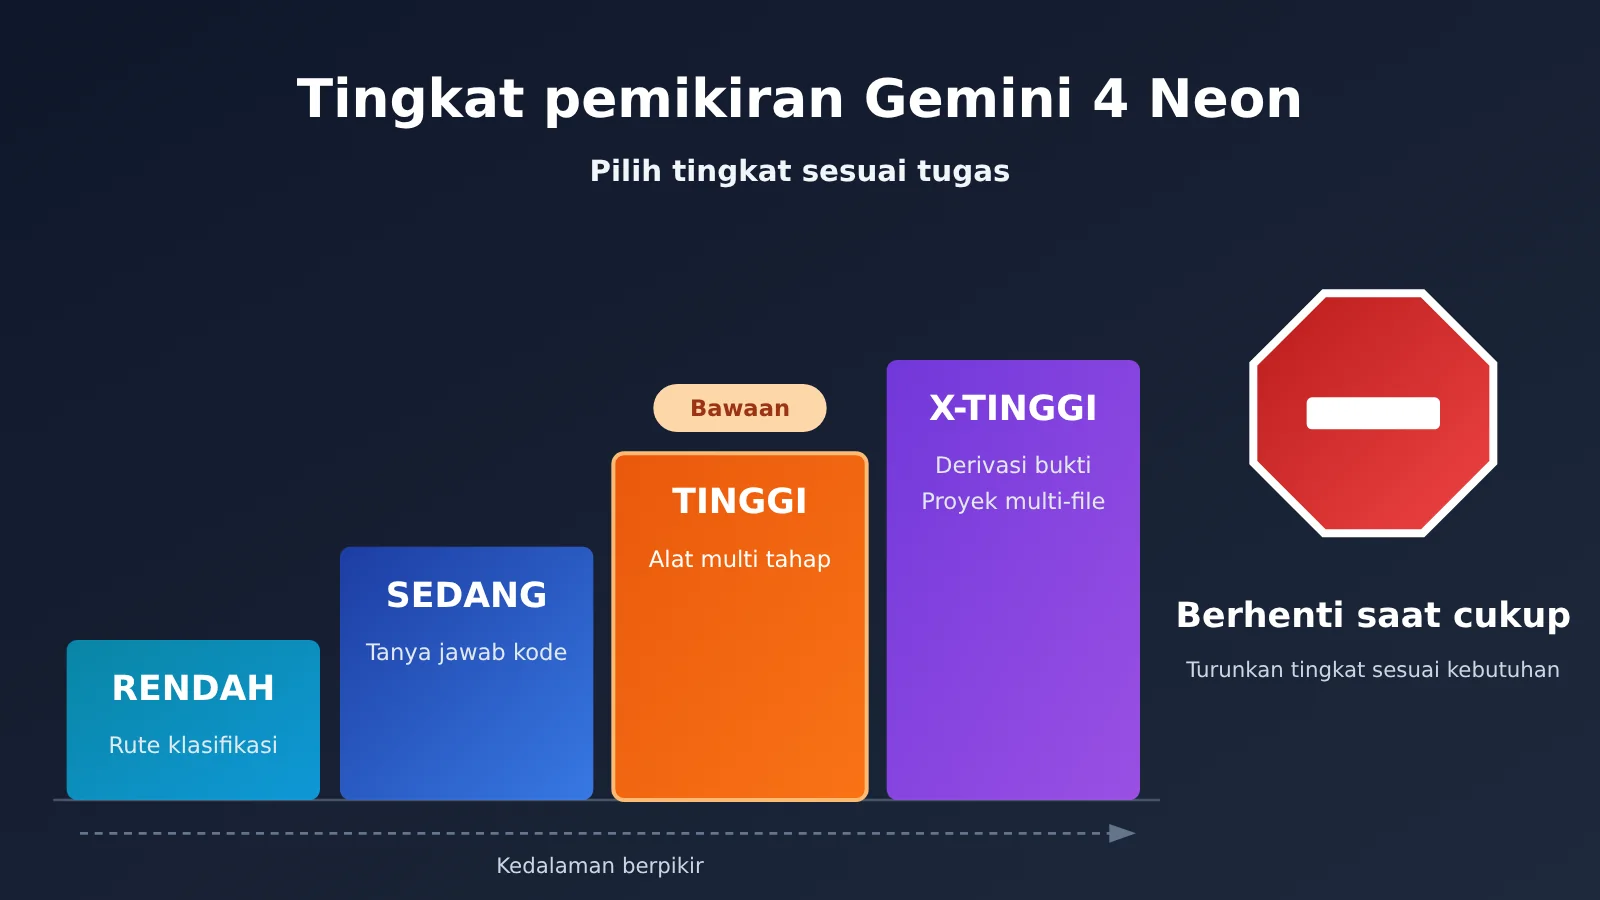
Poin Inti Tingkat Berpikir Gemini 4 Neon
Mari kita lihat beberapa kesimpulan paling penting terlebih dahulu. Semuanya berasal dari dokumentasi Gemini 4 Neon di Google Cloud (versi 2026-11-19) dan halaman model terbaru di AI Studio:
| Poin | Penjelasan | Nilai untuk Anda |
|---|---|---|
| Empat tingkat berpikir | LOW, MEDIUM, HIGH, XHIGH, default HIGH | Saat tidak mengirim parameter, tingkatnya sudah cenderung tinggi; Anda perlu menurunkannya secara aktif |
| Parameter lama akan error | thinking_budget dan MINIMAL akan mengembalikan HTTP 400 |
Parameter harus diubah saat memigrasikan kode lama |
| Penagihan token pemikiran | Token pemikiran dihitung dengan harga satuan output | Tingkat berpikir langsung memengaruhi biaya sisi output |
| Tingkat tidak berlaku lintas model | Carbon hanya memiliki tiga tingkat, default medium; Hydrogen sama seperti Neon, memiliki empat tingkat | Konfigurasi satu model tidak bisa disalin ke model lain |
| Antarmuka dan API berbeda | Extra di antarmuka Antigravity adalah xhigh, dan batas konteksnya juga berbeda | Hindari menyimpulkan perilaku API dari pengalaman IDE |
Empat Tingkat Berpikir Gemini 4 Neon dan Kesesuaian Tugas
Dokumentasi resmi mencantumkan skenario yang direkomendasikan untuk setiap tingkat. Dirangkum dalam tabel berikut agar mudah dicocokkan saat mengonfigurasi:
| Tingkat berpikir | Skenario yang direkomendasikan resmi | Contoh kasus bisnis | Tips pemilihan |
|---|---|---|---|
LOW |
Klasifikasi, routing, ringkasan dengan throughput tinggi | Pelabelan tiket, identifikasi intent, ekstraksi poin penting dari teks panjang | Untuk tugas batch, prioritaskan tingkat ini |
MEDIUM |
Pengodean umum, tanya jawab dokumen | Menulis fungsi, memperbaiki bug, menjawab pertanyaan berdasarkan basis pengetahuan | Cukup untuk sebagian besar permintaan pengembangan sehari-hari |
HIGH (default) |
Pemanggilan alat multi-langkah, multimodal kompleks | Agent memanggil alat secara berurutan, analisis campuran teks dan gambar | Saat tidak mengirim parameter, inilah tingkat yang dipakai |
XHIGH |
Pembuktian, analisis ilmiah, proyek multi-file terberat | Derivasi matematika, analisis data eksperimen, refactoring lintas beberapa modul | Gunakan hanya untuk tugas terberat |
Ada dua hal yang perlu diperhatikan dari tabel ini. Pertama, nilai default adalah HIGH, bukan MEDIUM. Artinya, jika Anda tidak menulis apa pun di kode, setiap permintaan klasifikasi akan berpikir dengan intensitas “pemanggilan alat multi-langkah”, yang biasanya boros untuk skenario throughput tinggi. Kedua, XHIGH adalah tingkat tertinggi Neon; kegunaannya adalah pembuktian dan tugas rekayasa terberat. Membuka XHIGH untuk permintaan pengodean sehari-hari biasanya hanya akan menghasilkan waktu tunggu lebih lama dan token output lebih banyak.
Mengapa Gemini 4 Neon Perlu “Berhenti Saat Sudah Cukup”
Kunci biaya terletak pada cara penagihan. Token pemikiran dihitung dengan harga satuan output, sedangkan harga satuan output Gemini 4 Neon adalah 5 kali harga satuan input (pengumuman Google mencantumkan harga input $3, cache $0.15, output $15, semuanya per juta token). Semakin banyak berpikir, semakin banyak bagian token yang paling mahal.
Berapa banyak token pemikiran tambahan yang dikonsumsi setiap tingkat bergantung pada kompleksitas tugas itu sendiri; pihak resmi tidak memberikan proporsi tetap, dan artikel ini juga tidak menyajikan angka semacam “berapa banyak yang bisa dihemat dengan menurunkan satu tingkat”. Pendekatan yang lebih aman adalah menjalankan LOW dan HIGH default pada sampel bisnis Anda masing-masing, membandingkan penggunaan token output dan kualitas jawaban dalam hasil yang dikembalikan, lalu memutuskan apakah akan menurunkan tingkat.
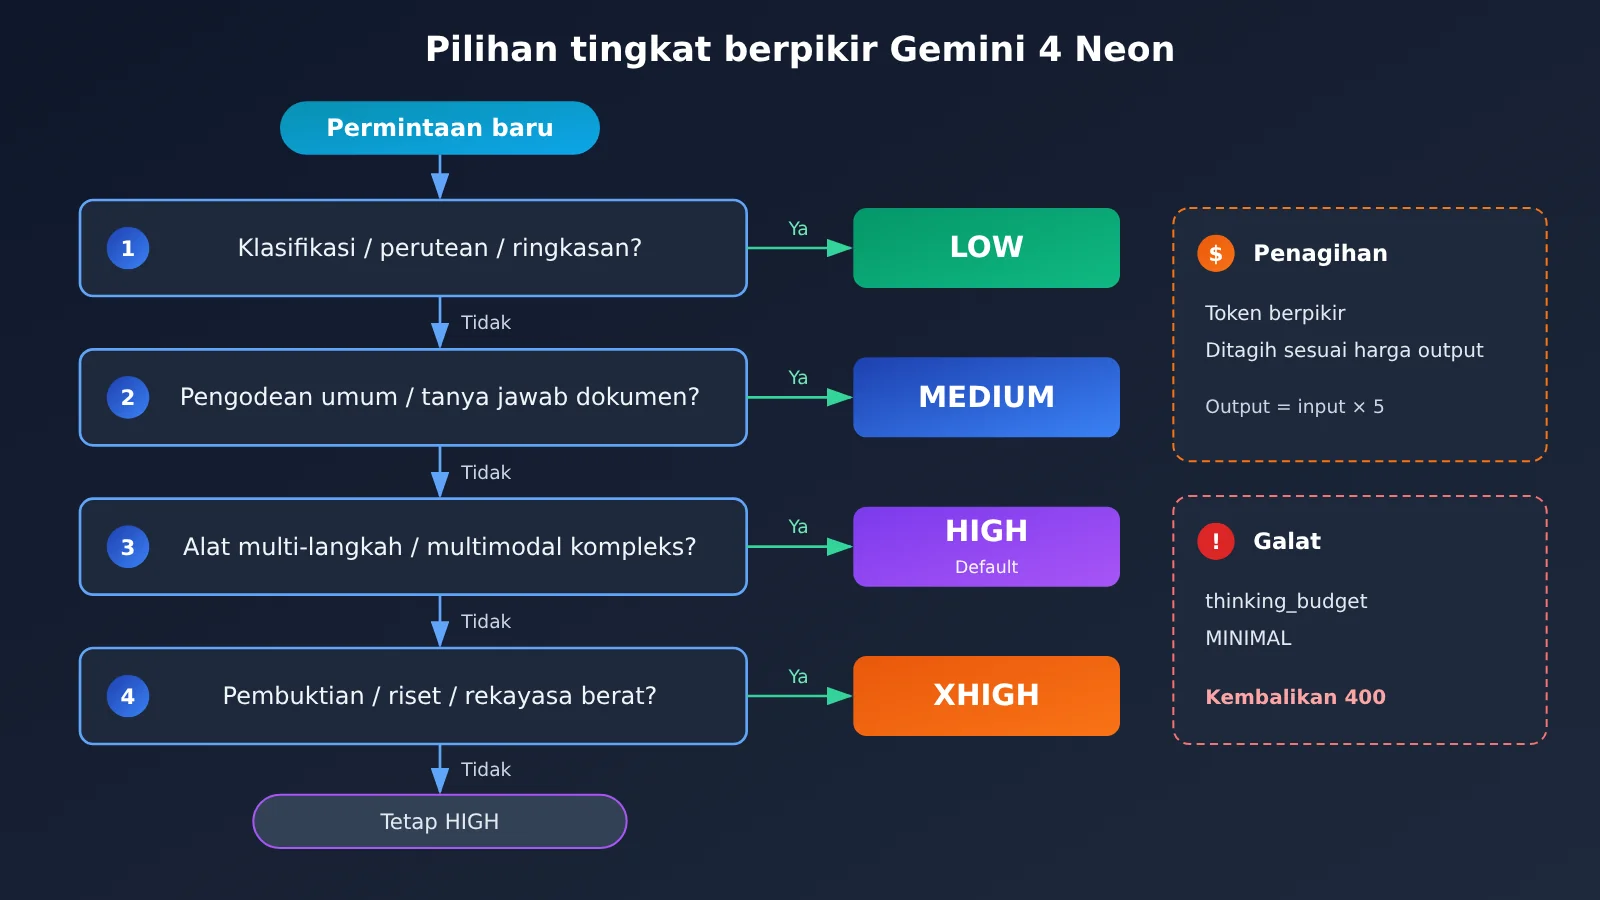
Panduan Cepat Tingkat Penalaran Gemini 4 Neon
Contoh Minimal: Klasifikasi dengan Level LOW
APIYI menyediakan antarmuka yang kompatibel dengan OpenAI. Cukup ubah base_url pada SDK Python openai resmi, dan Anda sudah bisa memanggil Gemini 4 Neon. Berikut kode-kode penting yang ditulis langkah demi langkah, setiap langkah bisa langsung disalin:
- Instal SDK:
pip install openai - Buat klien:
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - Tentukan model:
model="gemini-4-neon" - Atur tingkat penalaran:
reasoning_effort="low" - Kirim permintaan:
client.chat.completions.create(model="gemini-4-neon", reasoning_effort="low", messages=[{"role": "user", "content": "Tentukan apakah tiket ini termasuk: penagihan / teknis / lainnya. Isi tiket: ……"}]) - Baca hasil:
resp.choices[0].message.content
Tugas klasifikasi hanya membutuhkan satu label, dan level LOW sudah cukup memenuhi kebutuhan. Jika diubah menjadi menulis kode atau menjawab pertanyaan berdasarkan dokumen, cukup ganti langkah ke-4 dengan reasoning_effort="medium".
Perlu dicatat bahwa nama parameter bergantung pada format antarmuka yang Anda gunakan. Pada antarmuka native Gemini, tingkat pemikiran ditulis di field thinking_level dalam thinking_config, dengan nilai LOW / MEDIUM / HIGH / XHIGH. Pada format yang kompatibel dengan OpenAI, intensitas penalaran umumnya dikirim melalui reasoning_effort. Pemetaan field spesifik mengacu pada dokumentasi platform; sebelum rilis, disarankan untuk memverifikasi dengan satu permintaan bahwa level tersebut benar-benar berlaku.
Lihat pendekatan implementasi lengkap: pilih level otomatis berdasarkan jenis tugas
Di lingkungan produksi, praktik yang lebih baik adalah membiarkan kode bisnis memilih level berdasarkan jenis tugas, bukan menetapkan satu nilai secara global. Implementasi dapat dibagi menjadi beberapa langkah berikut:
1. Tentukan tabel pemetaan: `LEVEL_MAP = {“classify”: “low”, “route”: “low”, “summary”: “low”, “code”: “medium”, “doc_qa”: “medium”, “agent”: “high”, “multimodal”: “high”, “proof”: “xhigh”, “multi_file”: “xhigh”}`
2. Atur nilai fallback: `level = LEVEL_MAP.get(task_type, “high”)`, tugas yang tidak dikenal menggunakan default resmi HIGH, sehingga kualitas tidak turun secara tak terduga
3. Satukan klien: `client = OpenAI(api_key=os.getenv(“APIYI_KEY”), base_url=”https://api.apiyi.com/v1″)`
4. Lakukan pemanggilan: `client.chat.completions.create(model=”gemini-4-neon”, reasoning_effort=level, messages=messages)`
5. Catat penggunaan: tulis jumlah token output dari `resp.usage` bersama `task_type` dan `level` ke log, untuk memudahkan penghitungan biaya penalaran per jenis tugas
6. Tangani error 400: setelah menangkap exception, periksa apakah permintaan masih membawa `thinking_budget` atau `MINIMAL`, kedua nilai ini akan mengembalikan HTTP 400 pada Neon
Nilai fallback pada langkah ke-2 sangat penting. Jika tabel pemetaan melewatkan suatu jenis tugas, lebih baik menggunakan default HIGH dengan menghabiskan lebih banyak token daripada diam-diam turun ke LOW yang menyebabkan jawaban salah. Setelah log terkumpul selama beberapa waktu, turunkan level per kategori berdasarkan data.
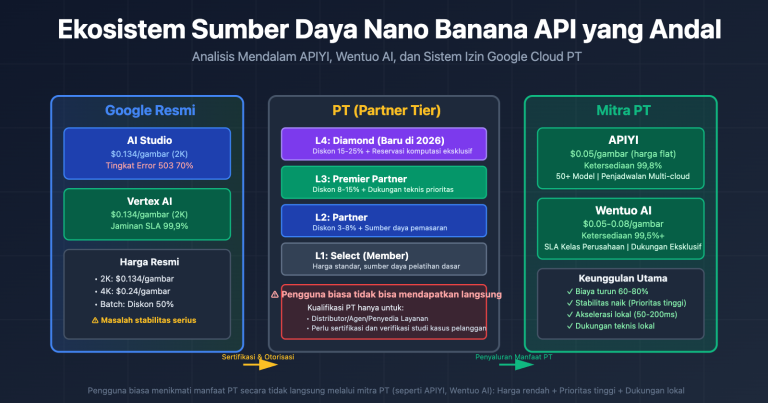
Saran: Jalankan dulu beberapa sampel bisnis nyata dengan LOW, MEDIUM, dan default HIGH, lalu tentukan level untuk produksi. Daftar melalui APIYI apiyi.com untuk mendapatkan kuota uji gratis; satu kunci API sudah bisa beralih dan membandingkan antara Neon, Hydrogen, dan Carbon.
Perbandingan Tingkat Berpikir Gemini 4 Neon, Carbon, dan Hydrogen
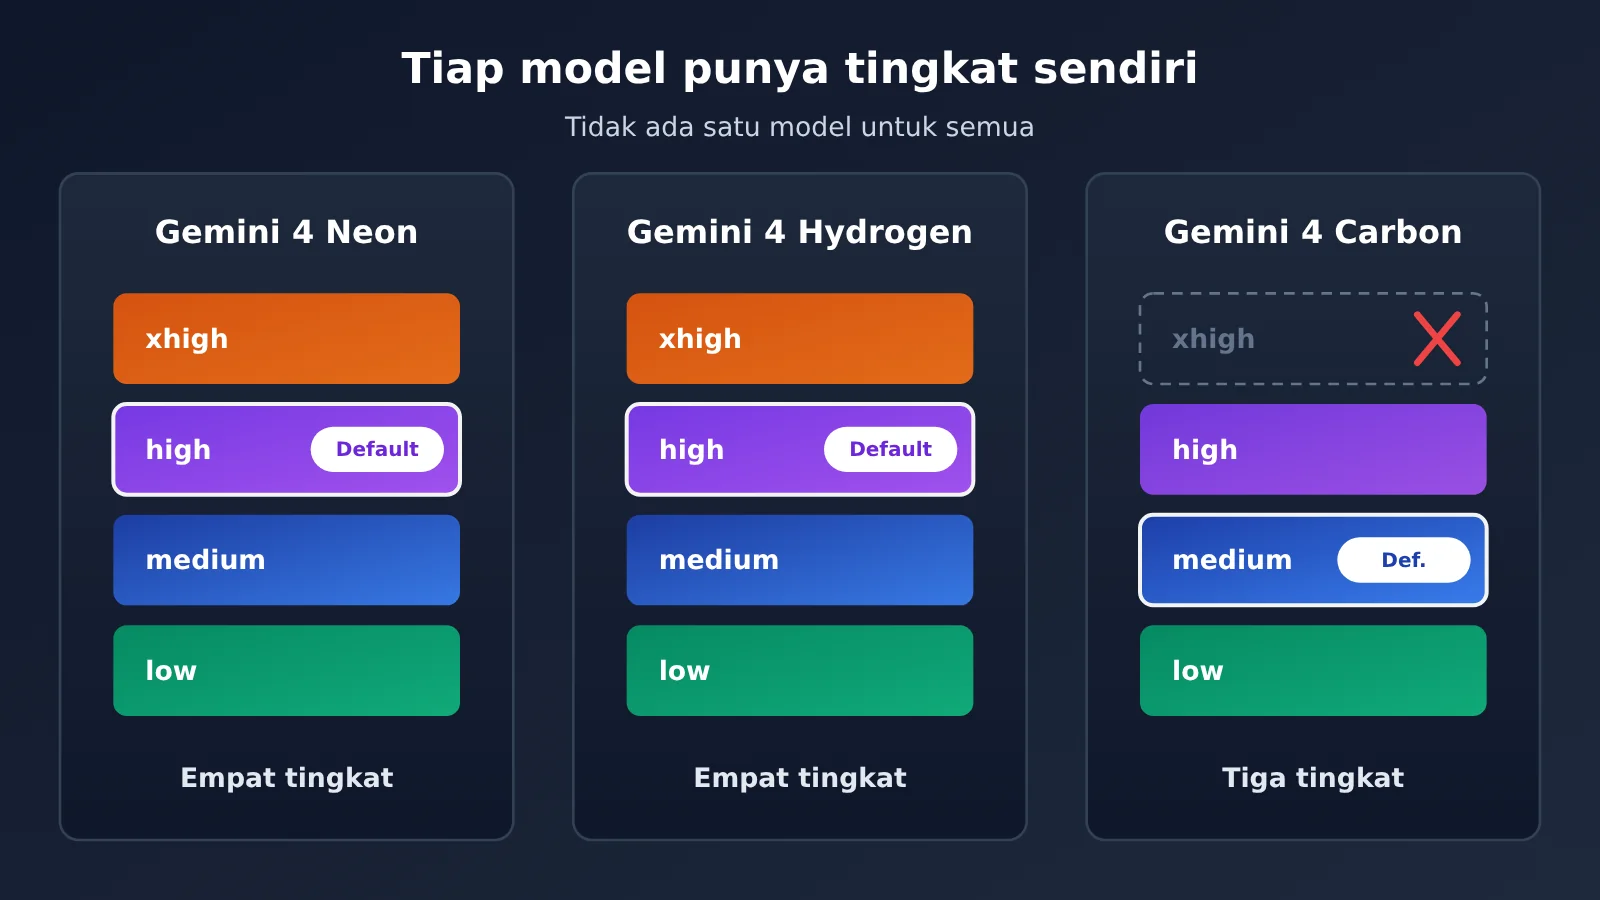
Banyak orang tersandung karena mengira seri Gemini 4 memakai satu set tingkat berpikir yang sama. Berdasarkan halaman model terbaru di AI Studio, faktanya tidak demikian:
| Model | Tingkat berpikir | Tingkat default | Ada xhigh | Platform yang tersedia |
|---|---|---|---|---|
| gemini-4-neon | low / medium / high / xhigh | high | Ada | APIYI, Google resmi |
| gemini-4-hydrogen | low / medium / high / xhigh | high | Ada | APIYI, Google resmi |
| gemini-4-carbon | low / medium / high | medium | Tidak ada | APIYI, Google resmi |
Penjelasan perbedaan tingkat
Analisis acuan Carbon: Tingkat default Carbon adalah medium, tingkat tertingginya high, dan tidak ada xhigh. Kalau konfigurasi yang ditulis untuk Carbon (misalnya “default medium, buka high untuk pekerjaan berat”) langsung dipakai pada Neon, maka “pekerjaan berat” di Neon hanya akan memakai tingkat tengah, dan tugas-tugas pembuktian yang sebenarnya butuh XHIGH justru tidak mencapai intensitas tertinggi. Sebaliknya, mengirim xhigh milik Neon ke Carbon juga tidak termasuk nilai yang didukungnya.
Analisis acuan Hydrogen: Hydrogen punya empat tingkat seperti Neon, dan default-nya juga high, jadi konfigurasi tingkat antara keduanya bisa saling dijadikan acuan. Tapi nama tingkat yang sama tidak berarti kedalaman berpikir dan biaya pada tingkat tersebut juga sama — setelah berganti model, tetap perlu evaluasi ulang.
Situasi Antigravity: Di antarmuka Antigravity, xhigh ditampilkan sebagai Extra, sementara di CLI tetap ditulis xhigh. Batas konteksnya 512K, sedangkan jendela konteks API adalah 1,048,576 token — keduanya bukan jendela yang sama. Karena itu, pengalaman yang didapat di IDE tidak bisa langsung dipakai untuk memperkirakan performa konteks panjang pada pemanggilan API.
Catatan perbandingan: Ketiga model bisa dipanggil lewat endpoint yang sama,
https://api.apiyi.com/v1, cukup ganti fieldmodel. Sebaiknya uji masing-masing secara terpisah dalam rentang tingkat yang didukungnya, jangan menyalin konfigurasi tingkat dari satu model ke model lain.
Verifikasi Harga dan Endpoint Gemini 4 Neon
Saat memilih tier, harga satuan pasti menjadi perhatian. Tabel berikut berisi harga APIYI yang diverifikasi pada 2026-11-20, semuanya dalam dolar AS per juta token. Sumber datanya ada dua: daftar model lengkap APIYI apiyi.com di docs.apiyi.com/models.md (diperbarui 2026-11-19 10:59, UTC+8), serta endpoint harga https://api.apiyi.com/api/pricing (versi shell-api-modelmak-v1; saat model_ratio bernilai 1, setara dengan input $2 / juta token).
| ID Model | Masukan | Baca cache | Keluaran | Catatan |
|---|---|---|---|---|
gemini-4-neon |
$3 |
$0.15 |
$15 |
Endpoint harga model_ratio 1.5, completion_ratio 5, cache_ratio 0.05; sesuai harga resmi Google |
gemini-4-hydrogen |
$1.5 |
$0.075 |
$7.5 |
Juga tersedia dalam empat tier, default high |
gemini-4-carbon |
$2 |
$0.1 |
$10 |
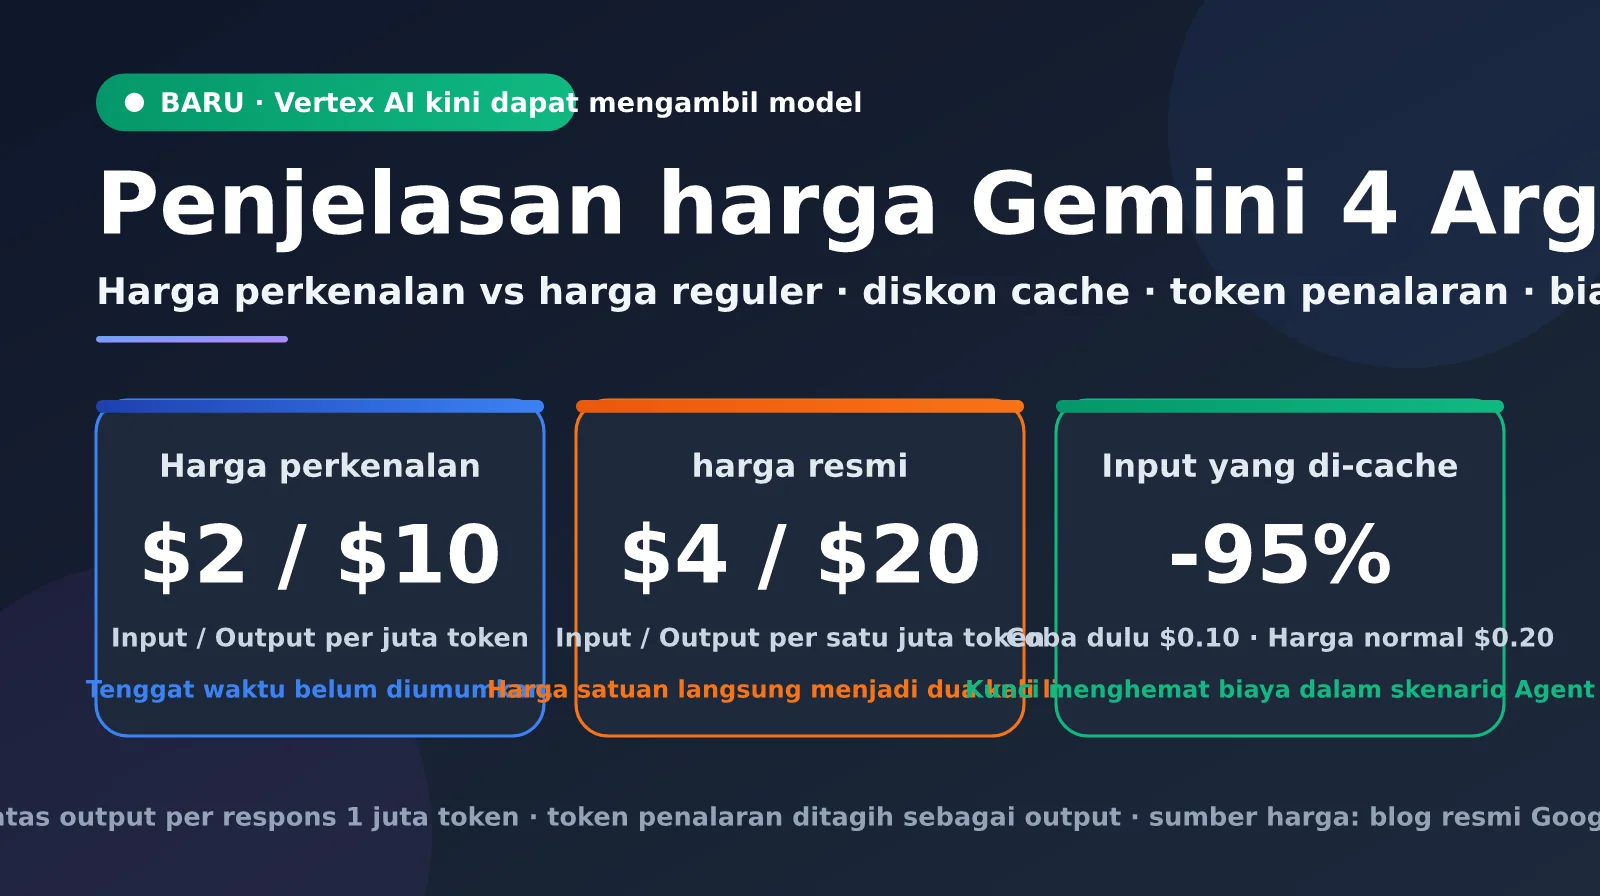
Sesuai harga perkenalan Google hingga 2026-11-30; mulai 1 Desember, harga standar Google adalah input $4, output $20 |
Perlu diperhatikan bahwa gemini-4-neon belum tercantum dalam daftar model lengkap versi ini, tetapi endpoint harga sudah memiliki entri terkait, dan harga hasil konversinya sama dengan pengumuman Google. Saat memverifikasi harga, sebaiknya gunakan endpoint harga sebagai acuan. Untuk Neon, harga satuan output $15 juga berlaku untuk token thinking, jadi semakin tinggi tier, semakin besar pengaruh kolom ini.
Pertanyaan Umum (FAQ)
Q1: Apa itu tingkat penalaran Gemini 4 Neon?
Tingkat penalaran menentukan seberapa banyak model melakukan penalaran internal sebelum memberikan jawaban akhir. Neon menyediakan empat tingkat: LOW, MEDIUM, HIGH, dan XHIGH, dengan default HIGH. Token yang dihasilkan dari penalaran ditagih sesuai harga output, jadi tingkat yang dipilih juga memengaruhi kualitas jawaban dan biaya.
Q2: Apa perbedaan tingkat penalaran antara Gemini 4 Neon dan Carbon?
Carbon hanya memiliki tiga tingkat, yaitu low, medium, dan high, dengan default medium, tanpa xhigh; Neon punya empat tingkat dengan default high. Sistem tingkat keduanya berbeda, jadi konfigurasinya tidak bisa langsung disalin. Tingkat Hydrogen sama dengan Neon, yaitu empat tingkat dengan default high.
Q3: Mengapa permintaan Gemini 4 Neon saya mengembalikan HTTP 400?
Penyebab paling umum adalah permintaan masih menggunakan parameter lama `thinking_budget`, atau tingkatnya diatur ke `MINIMAL`. Dokumentasi resmi menyatakan dengan jelas bahwa kedua cara penulisan ini akan mengembalikan HTTP 400 di Neon. Cukup gunakan salah satu tingkat antara LOW hingga XHIGH.
Q4: Tingkat penalaran mana yang cocok untuk tugas apa?
– **LOW**: tugas dengan throughput tinggi seperti klasifikasi tiket dukungan, perutean permintaan, dan ringkasan batch
– **MEDIUM**: coding sehari-hari dan tanya jawab berbasis dokumen
– **HIGH**: pemanggilan alat multi-langkah oleh Agent dan analisis multimodal gambar-teks yang kompleks
– **XHIGH**: pembuktian matematika, analisis data ilmiah, dan proyek multi-file paling berat
Q5: Bagaimana cara cepat memanggil Gemini 4 Neon melalui API dan mengatur tingkat penalaran?
1. Kunjungi APIYI apiyi.com untuk mendaftar akun, lalu dapatkan kunci API dan kuota pengujian gratis
2. Atur `base_url` SDK ke `https://api.apiyi.com/v1` dan `model` ke `gemini-4-neon`
3. Teruskan tingkat penalaran sesuai jenis tugas, misalnya `low` untuk tugas klasifikasi
Kunci yang sama juga dapat digunakan untuk memanggil Hydrogen dan Carbon, sehingga mudah membandingkan hasil dalam rentang tingkat masing-masing.
Q6: Apa saja batasan dalam mengatur tingkat penalaran Gemini 4 Neon?
– **Biaya**: token penalaran ditagih berdasarkan harga satuan output `$15` per juta token; tingkat tinggi akan meningkatkan penggunaan output secara signifikan
– **Parameter**: tidak mendukung `thinking_budget` dan `MINIMAL`
– **Konteks**: batas 512K di Antigravity bukan jendela konteks yang sama dengan 1,048,576 di API
– **Penghematan**: pihak resmi tidak memberikan proporsi tetap konsumsi token untuk tiap tingkat, jadi perlu diukur menggunakan sampel bisnis Anda sendiri
Q7: Jika tidak yakin dengan kompleksitas tugas, tingkat mana yang harus dipilih?
Pertahankan default HIGH dan catat penggunaan token output. Setelah data menunjukkan bahwa kualitas untuk jenis tugas tertentu tidak menurun pada MEDIUM atau LOW, barulah turunkan tingkat untuk jenis tugas tersebut. Biasanya tidak perlu menjadikan XHIGH sebagai default.
Poin-Poin Utama Tingkat Berpikir Gemini 4 Neon
- Default-nya HIGH: saat parameter tidak dikirim, Neon berpikir dengan intensitas pemanggilan tool multi-langkah
- Routing klasifikasi pakai LOW: untuk tugas pelabelan, routing, dan ringkasan dengan throughput tinggi, rekomendasi resminya adalah LOW
- XHIGH untuk tugas terberat: hanya dipakai untuk pembuktian, analisis ilmiah, dan pekerjaan rekayasa multi-file
- Jangan menyalin konfigurasi Carbon: Carbon hanya punya tiga tingkat, default-nya medium, dan tidak punya xhigh
- Parameter lama bakal error:
thinking_budgetdanMINIMALakan mengembalikan HTTP 400 - Pemikiran ditagih sebagai output: semakin tinggi tingkatnya, semakin banyak token output termahal yang terpakai
- Uji dulu, baru tetapkan: di APIYI apiyi.com, pakai Key yang sama untuk membandingkan hasil dan pemakaian di berbagai tingkat
Ringkasan
Inti dari tingkat berpikir Gemini 4 Neon:
- Pilih tingkat sesuai tugas: LOW untuk klasifikasi, routing, dan ringkasan; MEDIUM untuk coding dan tanya jawab; HIGH untuk tool multi-langkah dan multimodal; XHIGH hanya untuk tugas terberat
- Waspadai nilai default: default-nya sudah HIGH, jadi tugas dengan throughput tinggi perlu diturunkan tingkatnya secara aktif
- Tingkat tidak berlaku lintas model: Neon dan Hydrogen punya empat tingkat, Carbon tiga tingkat, masing-masing dikonfigurasi terpisah
“Berhenti saat sudah cukup” artinya: jalankan dulu bisnisnya dengan tingkat default, lalu turunkan per kategori berdasarkan log token output — bukan langsung menaikkan semua permintaan ke tingkat tertinggi sejak awal. Disarankan di APIYI apiyi.com memakai kuota gratis untuk membandingkan LOW, MEDIUM, dan HIGH dalam satu putaran, baru kemudian menetapkan konfigurasi untuk produksi.
📚 Referensi
-
Google Cloud – Panduan Model Gemini 4 Neon: tingkat berpikir, tingkat default, penjelasan error, dan skenario penggunaan
- Tautan:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Keterangan: dasar utama untuk pemetaan empat tingkat dan penjelasan HTTP 400 dalam artikel ini (2026-11-19)
- Tautan:
-
Halaman Model Terbaru Google AI Studio: tingkat dan nilai default Carbon serta Hydrogen
- Tautan:
aistudio.google.com - Keterangan: digunakan untuk memastikan perbedaan tingkat antar berbagai model Gemini 4
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi Teknis: Jika Anda mengalami masalah saat mengonfigurasi tingkat berpikir Gemini 4 Neon, jangan ragu menghubungi kami melalui beranda situs resmi APIYI