Nota del autor: Gemini 4 Neon tiene cuatro niveles de pensamiento; el predeterminado es HIGH y los tokens de pensamiento se facturan como salida. Este artículo explica para qué tipo de tarea sirve cada nivel y también por qué no se puede aplicar directamente a Neon la configuración de niveles de Carbon.
Después de integrar Gemini 4 Neon, el primer problema que encuentran muchos desarrolladores no es la calidad de los resultados, sino la factura. Los tokens de pensamiento se facturan al precio de salida: cuanto más alto el nivel, más piensa el modelo antes de responder y más tokens de salida genera. La recomendación de este artículo es elegir el nivel según la tarea y detenerse cuando ya sea suficiente, para ayudarte a encontrar el nivel adecuado entre resultados y costo.
Este no es un artículo de divulgación de parámetros del tipo “cuanto más alto, mejor”. La documentación de Google Cloud ya describe con bastante detalle para qué sirve cada nivel de Neon. Este artículo se basa en la documentación oficial, la organiza en una tabla comparativa que puedes seguir directamente para configurar, y añade algunos errores comunes y puntos de confusión.
Valor clave: al terminar este artículo, sabrás que Gemini 4 Neon viene con HIGH por defecto, que para tareas de clasificación y enrutamiento LOW es suficiente, que XHIGH se reserva para las tareas más pesadas y que no aplicarás por error la configuración de Carbon o Antigravity a las llamadas a la API.
Gemini 4 Neon: puntos clave de los niveles de razonamiento
Primero, las conclusiones más importantes. Todas provienen de la documentación de Google Cloud sobre Gemini 4 Neon (versión 2026-11-19) y de la página más reciente del modelo en AI Studio:
| Punto clave | Explicación | Valor para ti |
|---|---|---|
| Cuatro niveles de razonamiento | LOW, MEDIUM, HIGH y XHIGH; el valor predeterminado es HIGH | Si no pasas el parámetro, ya estás en un nivel bastante alto; tienes que bajarlo tú |
| Los parámetros antiguos provocan errores | thinking_budget y MINIMAL devuelven HTTP 400 |
Al migrar código antiguo, hay que cambiar los parámetros |
| Facturación de tokens de razonamiento | Los tokens de razonamiento se cobran al precio de salida | El nivel afecta directamente al costo del lado de salida |
| Los niveles no son intercambiables entre modelos | Carbon solo tiene tres niveles y su valor predeterminado es medium; Hydrogen tiene cuatro, igual que Neon | No puedes copiar la configuración de un modelo a otro |
| La interfaz y la API no coinciden | En la interfaz de Antigravity, Extra equivale a xhigh, y el límite de contexto también es diferente | Evita deducir el comportamiento de la API a partir de la experiencia en el IDE |
Los cuatro niveles de razonamiento de Gemini 4 Neon y las tareas correspondientes
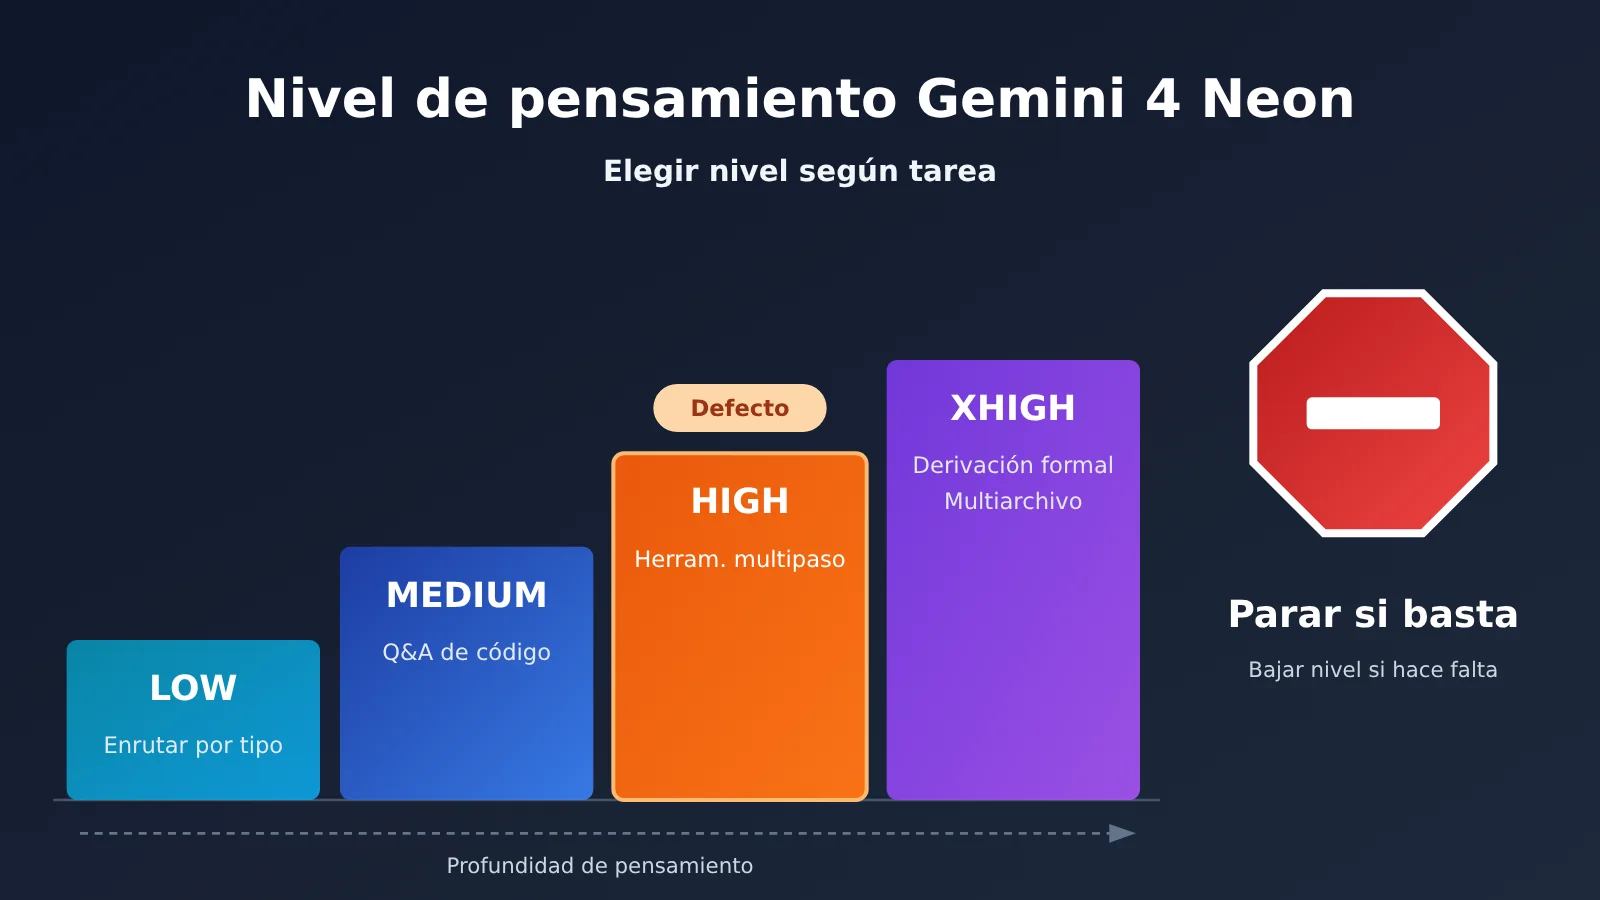
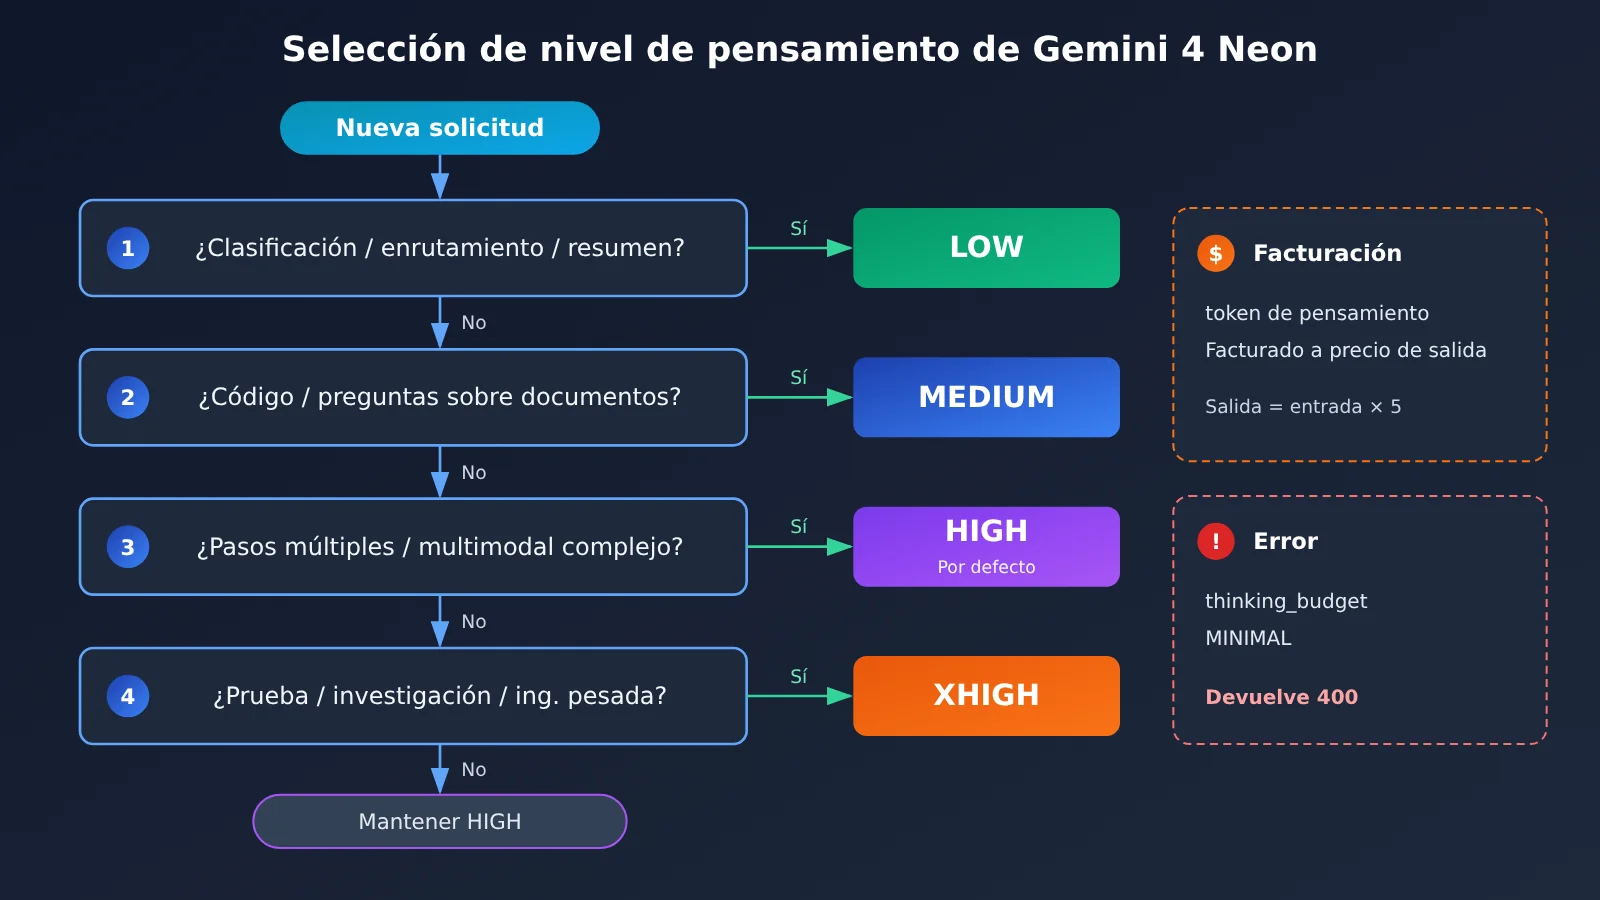
La documentación oficial indica los escenarios recomendados para cada nivel. Los he resumido en la siguiente tabla para que los consultes al configurar:
| Nivel de razonamiento | Escenario recomendado por la documentación oficial | Ejemplo típico de negocio | Consejo para elegir |
|---|---|---|---|
LOW |
Clasificación, enrutamiento y resúmenes de alto volumen | Etiquetado de tickets, reconocimiento de intenciones, extracción de puntos clave de textos largos | Para tareas por lotes, elige este nivel primero |
MEDIUM |
Codificación general, preguntas y respuestas sobre documentos | Escribir funciones, corregir errores, responder preguntas a partir de una base de conocimiento | Suficiente para la mayoría de solicitudes de desarrollo diarias |
HIGH (predeterminado) |
Llamadas a herramientas en varios pasos, multimodalidad compleja | Agentes que llaman herramientas de forma consecutiva, análisis combinado de texto e imágenes | Este es el nivel que se usa cuando no pasas el parámetro |
XHIGH |
Pruebas formales, análisis científico, ingeniería multiarchivo más exigente | Derivaciones matemáticas, análisis de datos experimentales, refactorización de varios módulos | Resérvalo para las tareas más exigentes |
Hay dos detalles que conviene tener en cuenta en esta tabla. Primero, el valor predeterminado es HIGH, no MEDIUM. Es decir, si no escribes nada en el código, cada solicitud de clasificación pensará con la intensidad de “llamadas a herramientas en varios pasos”, lo que normalmente supone un desperdicio en escenarios de alto volumen. Segundo, XHIGH es el nivel máximo de Neon y está pensado para pruebas formales y las tareas de ingeniería más exigentes. Activar XHIGH en solicitudes de codificación diarias, la mayoría de las veces solo te dará esperas más largas y más tokens de salida.
Por qué Gemini 4 Neon tiene que «detenerse cuando ya es suficiente»
La clave del coste está en cómo se factura. Los tokens de pensamiento se cobran al precio de salida, y el precio de salida de Gemini 4 Neon es 5 veces el de entrada (Google anuncia $3 de entrada, $0.15 en caché y $15 de salida, todas las cifras por millón de tokens). Cuanto más «piensa», mayor es la porción de tokens más caros.
Cuántos tokens de pensamiento adicionales consume cada nivel depende de la complejidad de la propia tarea; la documentación oficial no ofrece una proporción fija y este artículo tampoco da cifras del tipo «cuánto se ahorra bajando un nivel». Lo prudente es ejecutar LOW y el HIGH predeterminado sobre tus propias muestras de negocio, comparar el consumo de tokens de salida y la calidad de las respuestas devueltas, y solo entonces decidir si conviene bajar de nivel.
Inicio rápido con los niveles de razonamiento de Gemini 4 Neon
Ejemplo minimalista: clasificar con el nivel LOW
APIYI ofrece una interfaz compatible con OpenAI: basta con cambiar el base_url del SDK oficial openai de Python para invocar Gemini 4 Neon. A continuación detallo el código clave paso a paso; cada paso se puede copiar directamente:
- Instalar el SDK:
pip install openai - Crear el cliente:
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - Especificar el modelo:
model="gemini-4-neon" - Definir el nivel de razonamiento:
reasoning_effort="low" - Enviar la solicitud:
client.chat.completions.create(model="gemini-4-neon", reasoning_effort="low", messages=[{"role": "user", "content": "判断这条工单属于:账单 / 技术 / 其他。工单内容:……"}]) - Leer el resultado:
resp.choices[0].message.content
Una tarea de clasificación solo necesita una etiqueta, así que el nivel LOW ya cubre el requisito. Si en cambio se trata de escribir código o responder preguntas basadas en documentos, basta con cambiar el paso 4 por reasoning_effort="medium".
Cabe aclarar que el nombre del parámetro depende del formato de interfaz que uses. En la interfaz nativa de Gemini, el nivel de razonamiento se indica en el campo thinking_level dentro de thinking_config, con valores LOW / MEDIUM / HIGH / XHIGH. En el formato compatible con OpenAI, la intensidad de razonamiento se pasa normalmente mediante reasoning_effort. La correspondencia exacta de campos depende de la documentación de la plataforma; antes de salir a producción conviene confirmar con una sola solicitud que el nivel realmente está surtiendo efecto.
Ver la implementación completa: selección automática del nivel según el tipo de tarea
En producción, lo mejor es que el código de negocio elija el nivel según el tipo de tarea en lugar de fijar un único valor global. La implementación se puede dividir en estos pasos:
1. Definir la tabla de mapeo: `LEVEL_MAP = {«classify»: «low», «route»: «low», «summary»: «low», «code»: «medium», «doc_qa»: «medium», «agent»: «high», «multimodal»: «high», «proof»: «xhigh», «multi_file»: «xhigh»}`
2. Establecer un valor de respaldo: `level = LEVEL_MAP.get(task_type, «high»)`, de modo que las tareas desconocidas mantengan el HIGH predeterminado y no reduzcan la calidad por accidente
3. Unificar el cliente: `client = OpenAI(api_key=os.getenv(«APIYI_KEY»), base_url=»https://api.apiyi.com/v1″)`
4. Lanzar la llamada: `client.chat.completions.create(model=»gemini-4-neon», reasoning_effort=level, messages=messages)`
5. Registrar el consumo: escribir en el log el número de tokens de salida de `resp.usage` junto con `task_type` y `level`, para poder analizar el coste de razonamiento por tipo de tarea
6. Gestionar el error 400: tras capturar la excepción, comprueba si la solicitud todavía lleva `thinking_budget` o `MINIMAL`; ambos valores devuelven HTTP 400 en Neon
El valor de respaldo del paso 2 es importante. Si la tabla de mapeo se olvida de algún tipo de tarea, es preferible gastar algunos tokens de más con el HIGH predeterminado que bajar silenciosamente a LOW y provocar respuestas erróneas. Cuando el log haya acumulado datos durante un tiempo, ve ajustando cada categoría a la baja según lo observado.
Sugerencia: primero ejecuta unas cuantas muestras reales de negocio con LOW, MEDIUM y el HIGH predeterminado, y luego decide el nivel para producción. Al registrarte a través de APIYI apiyi.com obtienes cuota de prueba gratuita; con una sola clave API puedes alternar y comparar entre Neon, Hydrogen y Carbon.
Comparativa de los niveles de razonamiento de Gemini 4 Neon, Carbon e Hydrogen
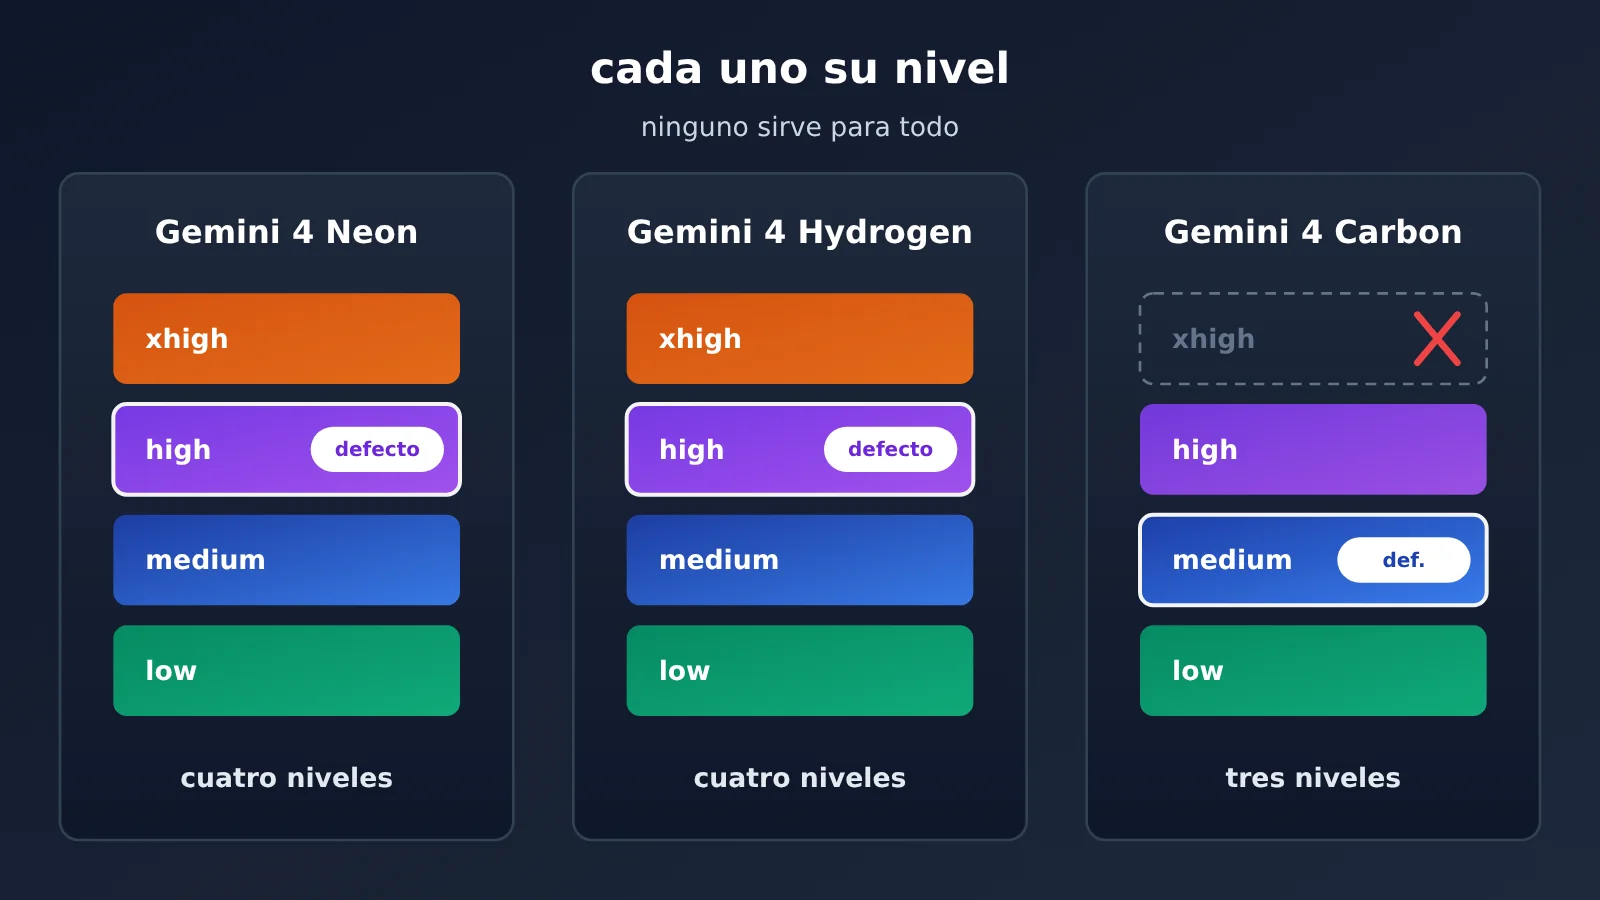
Mucha gente acaba tropezando porque da por hecho que toda la serie Gemini 4 comparte el mismo conjunto de niveles. Según la página de modelos más reciente de AI Studio, la realidad no es esa:
| Modelo | Niveles de razonamiento | Nivel predeterminado | ¿Tiene xhigh? | Plataformas disponibles |
|---|---|---|---|---|
| gemini-4-neon | low / medium / high / xhigh | high | Sí | APIYI, Google oficial |
| gemini-4-hydrogen | low / medium / high / xhigh | high | Sí | APIYI, Google oficial |
| gemini-4-carbon | low / medium / high | medium | No | APIYI, Google oficial |
Interpretación de las diferencias entre niveles
Análisis comparativo de Carbon: El nivel predeterminado de Carbon es medium, el máximo es high y no tiene xhigh. Si aplicas directamente a Neon una configuración pensada para Carbon (por ejemplo, «medium por defecto y high para tareas pesadas»), las «tareas pesadas» de Neon solo usarán el nivel intermedio, y las tareas de tipo demostración que realmente necesitan XHIGH no alcanzarán la intensidad máxima. A la inversa, si le pasas el xhigh de Neon a Carbon, tampoco entra dentro de los valores que admite.
Análisis comparativo de Hydrogen: Hydrogen, igual que Neon, tiene cuatro niveles y su nivel predeterminado también es high, así que las configuraciones de niveles de ambos pueden servir de referencia mutua. Pero que los nombres de los niveles coincidan no significa que la profundidad de razonamiento y el coste sean iguales en el mismo nivel; después de cambiar de modelo, sigue siendo necesario volver a evaluar.
El caso de Antigravity: En la interfaz de Antigravity, xhigh aparece como Extra, mientras que en la CLI sigue escribiéndose xhigh. Su límite de contexto es 512K, mientras que la ventana de contexto de la API es de 1,048,576 tokens; no son la misma ventana. Por eso, la experiencia que obtienes en el IDE no sirve directamente para estimar el rendimiento en contextos largos al llamar a la API.
Nota comparativa: Los tres modelos se pueden invocar mediante el mismo endpoint
https://api.apiyi.com/v1, solo hay que cambiar el campomodel. Recomendamos probar cada modelo dentro del rango de niveles que admite, sin copiar configuraciones de niveles entre modelos.
Verificación de precios y endpoints de Gemini 4 Neon
Al elegir un nivel, seguro te importa el precio unitario. La siguiente tabla muestra los precios de APIYI verificados el 20/11/2026, todos en dólares por millón de tokens. Hay dos fuentes: la tabla general de modelos de APIYI apiyi.com docs.apiyi.com/models.md (actualizada el 19/11/2026 10:59, UTC+8) y el endpoint de precios https://api.apiyi.com/api/pricing (versión shell-api-modelmak-v1, donde model_ratio igual a 1 corresponde a una entrada de $2 por millón de tokens).
| ID del modelo | Entrada | Lectura de caché | Salida | Notas |
|---|---|---|---|---|
gemini-4-neon |
$3 |
$0.15 |
$15 |
Endpoint de precios con model_ratio 1.5, completion_ratio 5, cache_ratio 0.05, coincide con el precio de lista de Google |
gemini-4-hydrogen |
$1.5 |
$0.075 |
$7.5 |
También tiene cuatro niveles, con high predeterminado |
gemini-4-carbon |
$2 |
$0.1 |
$10 |
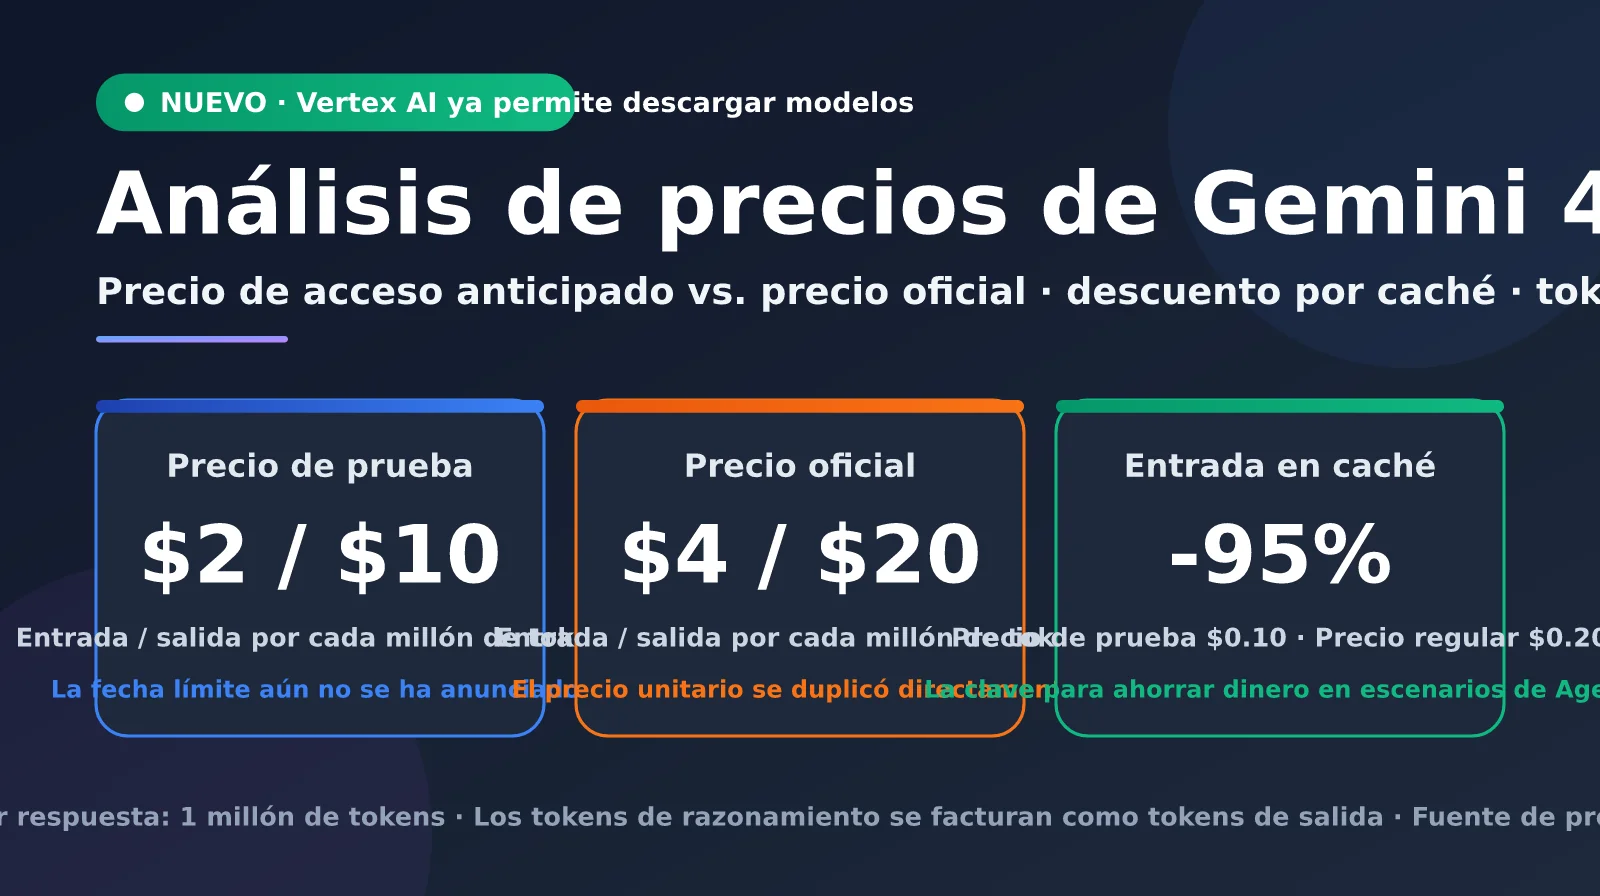
Coincide con el precio introductorio de Google vigente hasta el 30/11/2026; a partir del 1 de diciembre, el precio estándar de Google será entrada $4 y salida $20 |
Ten en cuenta que gemini-4-neon todavía no aparece en esa versión de la tabla general de modelos, pero el endpoint de precios ya tiene una entrada correspondiente, y el precio convertido coincide con el anuncio de Google. Al verificar precios, se recomienda usar el endpoint de precios como referencia. Para Neon, el precio de salida de $15 también se aplica a los tokens de pensamiento, así que cuanto más alto el nivel, mayor será el impacto de esta columna.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es el nivel de razonamiento de Gemini 4 Neon?
El nivel de razonamiento determina cuánta inferencia interna hace el modelo antes de dar la respuesta final. Neon ofrece cuatro niveles: LOW, MEDIUM, HIGH y XHIGH, con HIGH por defecto. Los tokens de razonamiento se facturan al precio de salida, así que el nivel afecta tanto la calidad de la respuesta como el costo.
Q2: ¿En qué se diferencian los niveles de razonamiento de Gemini 4 Neon y Carbon?
Carbon solo tiene tres niveles: low, medium y high, con medium por defecto, y no incluye xhigh; Neon tiene cuatro y usa high por defecto. Los sistemas de niveles de ambos modelos son distintos, así que la configuración no se puede copiar tal cual. Los niveles de Hydrogen son iguales a los de Neon: cuatro, también con high por defecto.
Q3: ¿Por qué mi solicitud a Gemini 4 Neon devuelve HTTP 400?
La causa más habitual es que la solicitud siga usando el parámetro antiguo `thinking_budget`, o que el nivel esté configurado como `MINIMAL`. La documentación oficial indica claramente que ambas formas devuelven HTTP 400 en Neon. Basta con cambiar a alguno de los niveles entre LOW y XHIGH.
Q4: ¿Para qué tipo de tareas sirve cada nivel de razonamiento de Gemini 4 Neon?
– **LOW**: tareas de alto rendimiento como clasificación de tickets, enrutamiento de solicitudes y resúmenes masivos
– **MEDIUM**: programación del día a día y preguntas y respuestas basadas en documentos
– **HIGH**: llamadas a herramientas en varios pasos por parte de agentes y análisis multimodal complejo de imágenes y texto
– **XHIGH**: demostraciones matemáticas, análisis de datos científicos y proyectos de ingeniería con muchos archivos, los más pesados
Q5: ¿Cómo llamar rápidamente a Gemini 4 Neon por API y configurar el nivel de razonamiento?
1. Entra en APIYI apiyi.com, registra una cuenta y obtén una clave API y crédito de prueba gratuito
2. Configura el `base_url` del SDK como `https://api.apiyi.com/v1` y el `model` como `gemini-4-neon`
3. Pasa el nivel de razonamiento según el tipo de tarea, por ejemplo `low` para tareas de clasificación
La misma clave también sirve para llamar a Hydrogen y Carbon, lo que facilita comparar resultados dentro del rango de niveles de cada modelo.
Q6: ¿Qué limitaciones tiene configurar el nivel de razonamiento en Gemini 4 Neon?
– **Costo**: los tokens de razonamiento se facturan al precio de salida de `$15` por millón de tokens, y los niveles altos incrementan notablemente el consumo de salida
– **Parámetros**: no admite `thinking_budget` ni `MINIMAL`
– **Contexto**: el límite de 512K en Antigravity y el `1,048,576` de la API no son la misma ventana
– **Margen de ahorro**: la documentación oficial no publica un porcentaje fijo de consumo de tokens por nivel; hay que medirlo con tus propias muestras de tráfico
Q7: Si no tengo claro lo compleja que es la tarea, ¿qué nivel debería elegir?
Conserva el valor por defecto, HIGH, y registra el consumo de tokens de salida. Cuando los datos muestren que la calidad de cierto tipo de tarea no baja con MEDIUM o LOW, baja el nivel solo para ese tipo de tarea. Por lo general, no tiene sentido poner XHIGH como valor por defecto.
Puntos clave de los niveles de pensamiento de Gemini 4 Neon
- Por defecto es HIGH: si no pasas parámetros, Neon piensa con la intensidad propia de las invocaciones de herramientas de varios pasos
- LOW para clasificación y enrutamiento: en tareas de alto rendimiento como etiquetado, enrutamiento y resumen, la recomendación oficial es LOW
- XHIGH se reserva para las tareas más pesadas: solo para demostraciones, análisis científico e ingeniería con múltiples archivos
- No copies la configuración de Carbon: Carbon solo tiene tres niveles, su valor por defecto es medium y no incluye xhigh
- Los parámetros antiguos devuelven error:
thinking_budgetyMINIMALresponden con HTTP 400 - El pensamiento se factura como salida: cuanto más alto el nivel, más tokens de salida se generan (y los tokens de salida son los más caros)
- Primero prueba, luego decide: compara en APIYI apiyi.com, con la misma clave API, el rendimiento y el consumo de distintos niveles
Resumen
Los puntos clave de los niveles de pensamiento de Gemini 4 Neon:
- Elige el nivel según la tarea: LOW para clasificación, enrutamiento y resumen; MEDIUM para programación y preguntas y respuestas; HIGH para herramientas de varios pasos y multimodal; XHIGH solo para las tareas más pesadas
- Cuidado con los valores por defecto: el valor por defecto es HIGH, así que las tareas de alto rendimiento deben bajar de nivel de forma proactiva
- Los niveles no son universales entre modelos: Neon e Hydrogen tienen cuatro niveles, Carbon tiene tres, y cada uno se configura por separado
«Si alcanza, para» significa: primero pon el negocio en marcha con el nivel por defecto y luego, guiándote por los logs de tokens de salida, baja el nivel categoría por categoría; no pongas todas las solicitudes al máximo desde el principio. Se recomienda usar la cuota gratuita en APIYI apiyi.com para hacer una ronda de comparación entre LOW, MEDIUM y HIGH, y luego definir la configuración en producción.
📚 Referencias
-
Google Cloud: Guía del modelo Gemini 4 Neon: niveles de pensamiento, nivel predeterminado, descripción de errores y casos de uso
- Enlace:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Nota: base principal para la correspondencia de los cuatro niveles y la explicación del HTTP 400 en este artículo (2026-11-19)
- Enlace:
-
Página de modelos más recientes de Google AI Studio: niveles y valores predeterminados de Carbon y Hydrogen
- Enlace:
aistudio.google.com - Nota: sirve para confirmar las diferencias de niveles entre distintos modelos Gemini 4
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: Si tienes problemas al configurar los niveles de pensamiento de Gemini 4 Neon, no dudes en contactarnos desde la página principal del sitio web oficial de APIYI.