Примечание автора: одни и те же китайские открытые модели занимают противоположные места в рейтинге расходов Menlo Ventures и рейтинге запросов OpenRouter. Разберём, что именно измеряют эти рейтинги, и предложим практический метод выбора модели из 5 шагов.
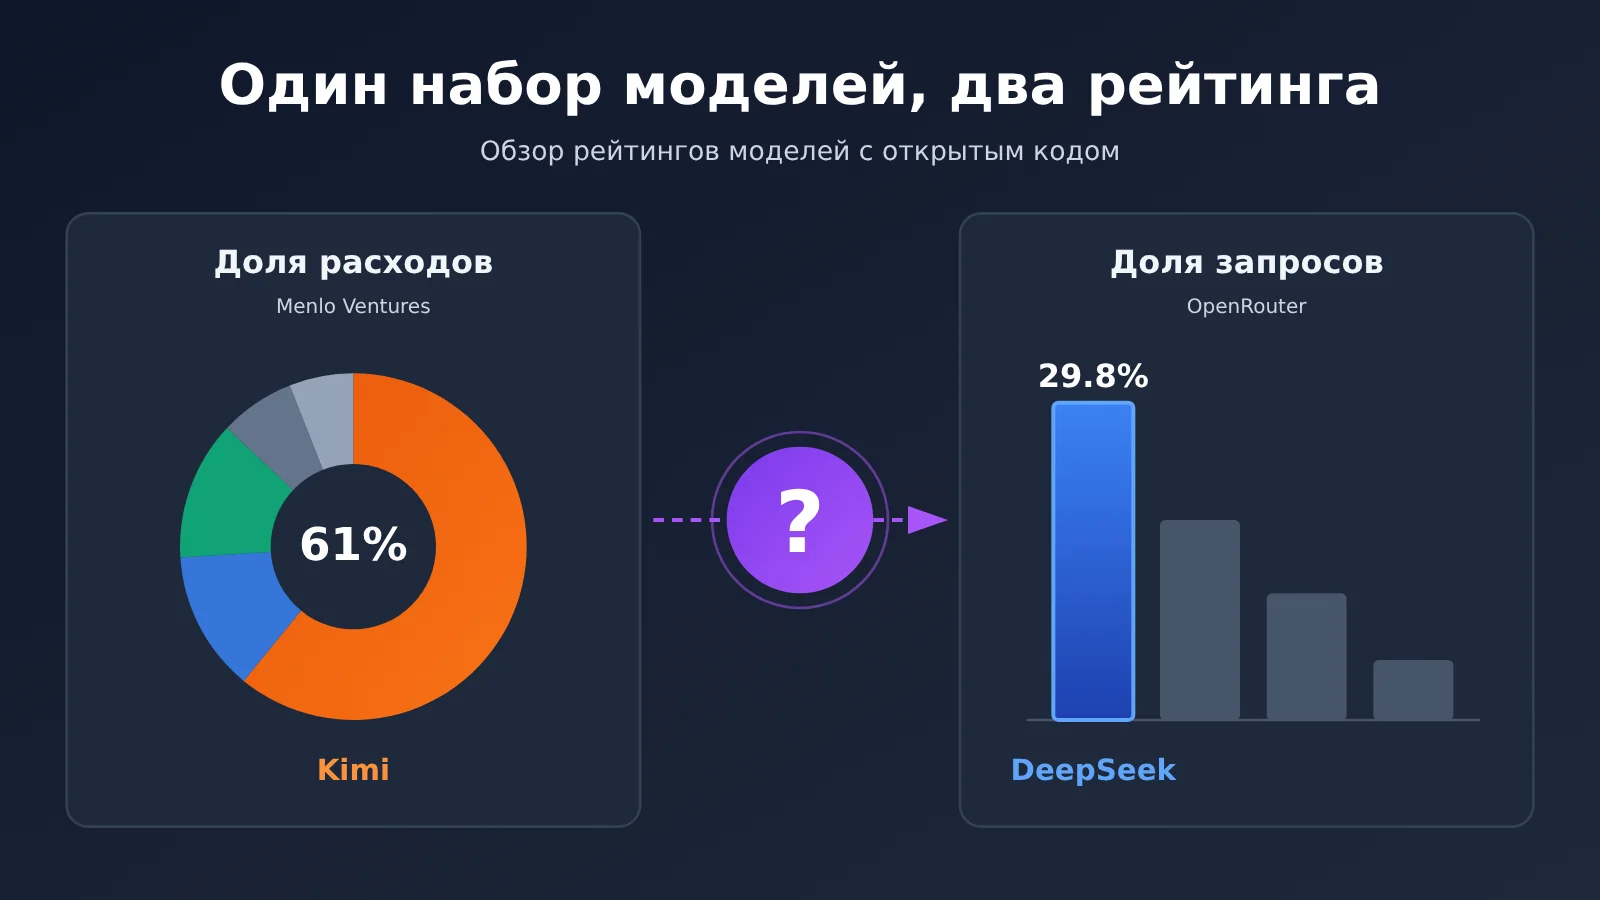
В начале ноября появились два набора данных. Согласно отчёту Menlo Ventures, на Kimi приходится 61% расходов американских компаний на открытые модели. А недельный рейтинг OpenRouter показывает, что на DeepSeek приходится 29.8% текстовых запросов на платформе. Лидеры разные, а порядок моделей в рейтингах почти обратный. Первая реакция многих технических руководителей: какой из них верить?
На самом деле противоречия нет: рейтинги измеряют разные вещи. Рейтинг расходов показывает, «кому компании платят деньги», а рейтинг запросов — «какие модели вызывают разработчики на конкретной платформе». При выборе модели нельзя просто скопировать один из рейтингов: нужно учитывать свои задачи и подход к расчёту затрат. Рейтинг помогает сузить круг кандидатов, но не может выбрать модель за вас.
Это не просто пересказ рейтингов. Мы разберём выборку, временной интервал и границы применимости каждого из них, объясним, как снижение цены при росте использования влияет на структуру затрат, и предложим чек-лист выбора модели из 5 шагов.
Главное об открытых моделях: почему Kimi и DeepSeek возглавили разные рейтинги
Главное: Menlo Ventures измеряет расходы компаний, а OpenRouter — запросы на своей платформе. Выборки, периоды и объекты подсчёта у них разные.
Эти два набора данных часто обсуждают вместе, хотя их «знаменатели» совершенно разные. Данные Menlo Ventures основаны на опросе специалистов, принимающих решения об использовании ИИ в американских компаниях. Это оценка по результатам опроса, а не проверенные счета. Данные OpenRouter основаны на статистике запросов на самой платформе: они отражают поведение её пользователей, но не всего рынка.
| Рейтинг | Что измеряется | Выборка / период | Основные позиции | Для чего полезен |
|---|---|---|---|---|
| Отчёт Menlo Ventures о состоянии корпоративного ИИ в 2026 году | Доля расходов американских компаний на модели с открытым исходным кодом | Около 400 специалистов, принимающих решения об использовании ИИ в американских компаниях; опрос проведён 8–26 сентября 2026 года, отчёт опубликован 3 ноября | Kimi — 61%, DeepSeek — 15%, GLM — 11%, Meta Llama — 7%, Qwen — 3% | Помогает оценить предпочтения корпоративных заказчиков, распределение бюджетов и то, какие модели вошли в официальные контракты |
| Еженедельный рейтинг OpenRouter | Доля текстовых запросов на платформе | Платформа OpenRouter, 26 октября — 1 ноября | DeepSeek — 29,8%, OpenAI — 18,8%, Z.ai — 11,9%, Qwen — 5,6% (шестое место) | Помогает оценить активность разработчиков, вызовы моделей, чувствительные к цене, и популярность в сообществе |
Из таблицы видно, что даже «участники» рейтингов различаются. Menlo учитывает только модели с открытым исходным кодом, а OpenRouter включает и поставщиков закрытых моделей, таких как OpenAI и Google. Сравнивать эти проценты напрямую — значит смешивать разные показатели.
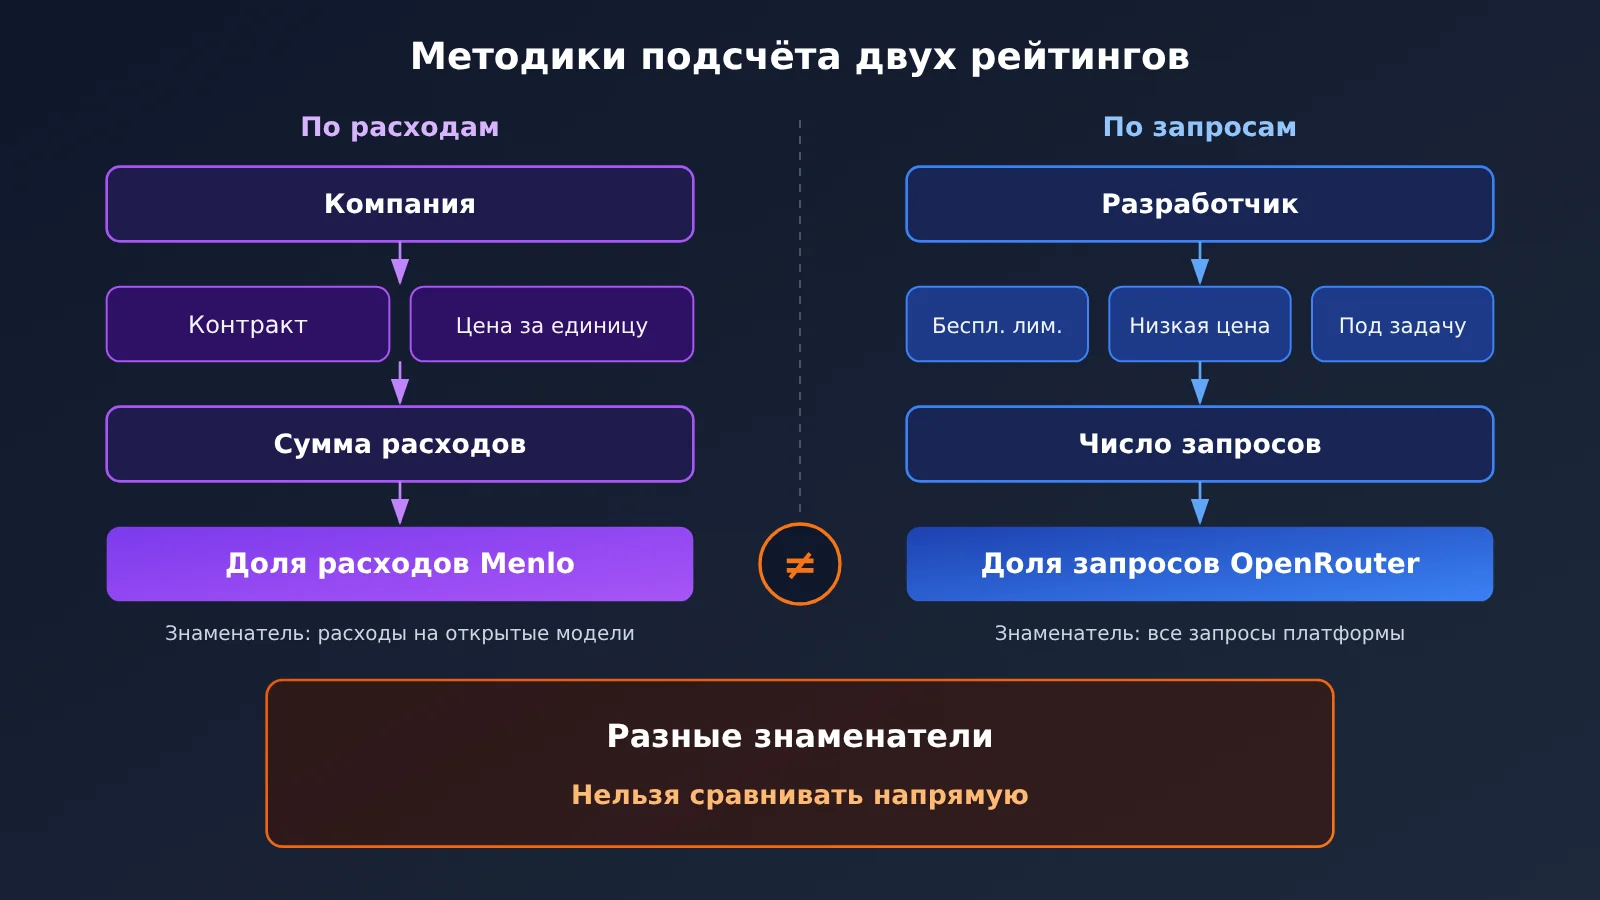
Как читать рейтинг расходов Menlo Ventures: на Kimi приходится 61% затрат на открытые модели
Главный вывод: данные Menlo Ventures показывают, что китайские открытые модели уже вошли в бюджеты американских компаний. Но это оценка на основе опроса, а не рейтинг возможностей моделей.
Самая обсуждаемая цифра отчёта: на китайские модели приходится 89% расходов американских компаний на открытые модели. При этом на одну только Kimi — 61%, на DeepSeek — 15%, на GLM — 11%, на Qwen — 3%. Среди некитайских моделей доля Meta Llama составляет 7%.
| Модель | Доля расходов американских компаний на открытые модели | Что важно знать |
|---|---|---|
| Kimi | 61% | Самая большая доля; возможно, это связано с каналами закупки и ценой |
| DeepSeek | 15% | На втором месте по расходам, но используется активнее |
| GLM | 11% | Уверенно вошла в бюджеты компаний |
| Meta Llama | 7% | Лидер по доле среди некитайских открытых моделей |
| Qwen | 3% | Доля расходов невелика, но модель заметна по числу вызовов |
Чтобы лучше понять эти цифры, стоит взглянуть на общую картину. По оценке отчёта, годовые расходы компаний на внедрение ИИ во всём мире составляют около 176,8 млрд долларов — за три года они выросли более чем в 100 раз. На ведущие исследовательские лаборатории приходится 69% расходов на внедрение, а на открытые модели — лишь 4% общих расходов на модели. Поэтому «61% для Kimi» — это доля в небольшом сегменте открытых моделей, а не на всём корпоративном рынке ИИ.
Кроме того, данные опроса основаны на том, как сами респонденты оценивают бюджеты своих компаний, а выборка из почти 400 участников охватывает только американские компании. Разумнее воспринимать эти данные как указание на общий тренд корпоративных закупок: конкретные доли — лишь оценка на основе опроса, которую ещё предстоит проверить с помощью дополнительных данных.
Как читать рейтинг запросов OpenRouter: на DeepSeek пришлось 29,8% запросов
Главное: недельный рейтинг OpenRouter показывает популярность моделей среди разработчиков на этой платформе. По нему можно отслеживать тенденции, но судить о долях всего рынка нельзя.
За неделю с 26 октября по 1 ноября DeepSeek заняла первое место с долей 29,8% текстовых запросов — на 7% больше, чем неделей ранее. OpenAI оказалась второй с 18,8%, доля Google снизилась с 14,4%, Z.ai заняла четвёртое место с 11,9%, а Qwen — шестое с 5,6%.
| Место | Компания | Доля запросов | Изменение |
|---|---|---|---|
| 1-е | DeepSeek | 29,8% | +7% к предыдущей неделе |
| 2-е | OpenAI | 18,8% | — |
| Снижение | Снизилась с 14,4% | Доля сократилась | |
| 4-е | Z.ai | 11,9% | — |
| 6-е | Qwen | 5,6% | — |
Стоит отметить ещё две тенденции. Уже 27 недель подряд объём токенов при вызовах китайских моделей превышает показатель американских. При этом четыре из пяти моделей с самым высоким недельным объёмом вызовов — китайские. В тот же период DeepSeek обновила модель до DeepSeek V4.1-Flash-1017, не изменив способ вызова API и цены. Поэтому разработчикам, которые уже подключили модель, перейти на новую версию будет просто.
На стабильность тоже стоит обратить внимание. 3 ноября в веб-версии и API DeepSeek произошёл частичный сбой, который длился около часа. Большой объём вызовов не гарантирует постоянной доступности — именно поэтому, как мы расскажем дальше, стоит держать под рукой резервную модель. После выхода новой версии уточняйте ID модели и тарифы в списке моделей консоли APIYI на apiyi.com.
Почему рейтинги расходов и запросов к открытым моделям расходятся
Главный вывод: различия в рейтингах объясняются пятью факторами — ценой, способом закупки, бесплатными лимитами, соответствием задачам и охватом платформ. Это не значит, что какой-то из рейтингов «неправильный».
Доля расходов приблизительно равна «количеству вызовов × цене за вызов», с поправкой на условия контрактов и закупок. Доля запросов учитывает только количество вызовов, независимо от их стоимости. Если модель дороже, а компании готовы заключать контракты на её использование, она окажется выше в рейтинге расходов. Если модель стоит дешевле и пользуется популярностью у разработчиков, она поднимется в рейтинге запросов.
| Фактор | Влияние на долю расходов | Влияние на долю запросов |
|---|---|---|
| Цена за вызов | При более высокой цене тот же объём использования обходится дороже, увеличивая долю расходов | Низкая цена привлекает больше пользователей, которые пробуют модель, и число запросов растёт |
| Корпоративные закупки | Контракты, развёртывание в инфраструктуре компании и соглашения об обслуживании учитываются в расходах | Не обязательно проходят через OpenRouter, поэтому на платформе их не видно |
| Бесплатные лимиты | Бесплатные вызовы не создают расходов | Бесплатные вызовы учитываются в числе запросов |
| Соответствие задачам | Длинные документы, агенты и другие задачи с большим расходом токенов повышают затраты | Короткие диалоги и небольшие пакетные задачи увеличивают число запросов |
| Охват | Учитываются только опрошенные американские компании | Учитываются только пользователи OpenRouter |
Если смотреть на данные через эту призму, Kimi, возможно, выигрывает за счёт каналов корпоративных закупок и более высокой цены, поэтому его доля расходов выше. DeepSeek стоит дешевле, а его сообщество разработчиков активно, поэтому запросов к нему больше. Это обоснованное предположение с учётом охвата исследований: сами отчёты не содержат разбивки по отдельным факторам.
Есть и ещё одна деталь, которую часто упускают: разные версии одной модели, способы доступа и доля попаданий в кэш тоже могут приводить к расхождениям между расходами и числом вызовов. Если команда часто получает ответы из кэша, запросы по-прежнему учитываются, но фактические расходы будут значительно ниже.
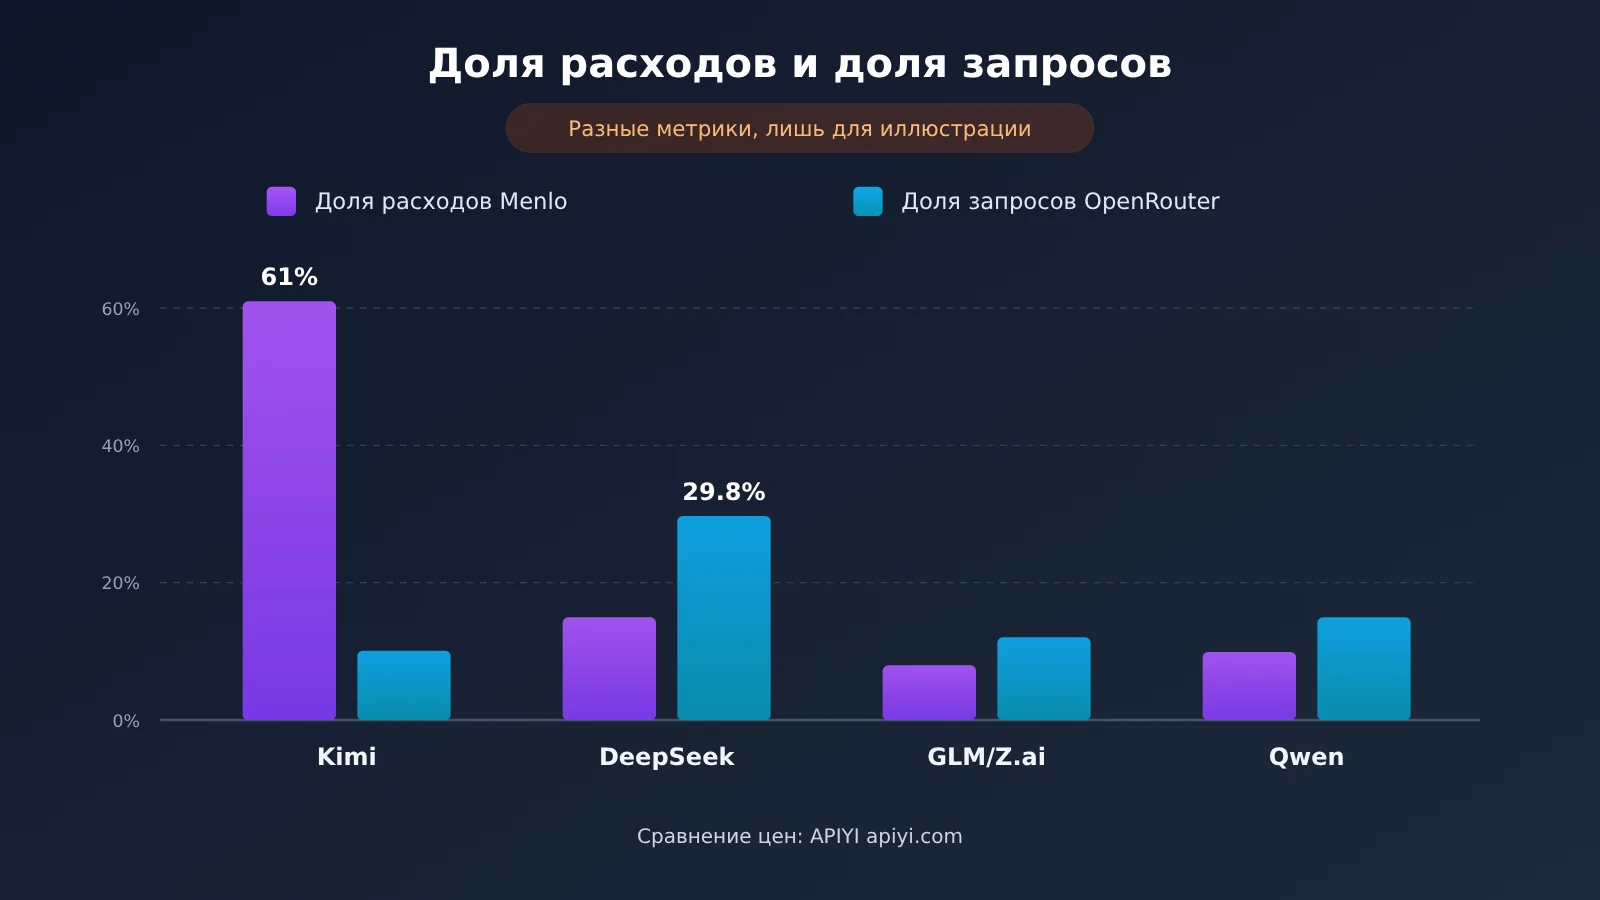
Цены и использование моделей с открытым кодом: что означают снижение цены на 70% и рост объёма в 22,5 раза
Главный вывод: снижение цены за единицу не означает снижения общих затрат. Надёжнее сравнивать стоимость выполнения одной задачи, а не цену за миллион токенов.
В отчёте Menlo приводятся важные цифры: средняя цена токенов снизилась с 0.45 доллара за миллион токенов до 0.13 доллара за миллион токенов — примерно на 70%. При этом объём использования вырос в 22,5 раза. По грубой оценке, основанной на этих цифрах, общие расходы не снизились, а выросли примерно в 6,5 раза. Это лишь расчёт для наглядности по средним значениям из отчёта — у разных команд ситуация может отличаться.
С моделями с открытым кодом ситуация ещё нагляднее. На них приходится 19% корпоративного использования токенов, но всего 4% расходов на модели. Иными словами, большая часть токенов обрабатывается недорогими моделями с открытым кодом, а основные деньги уходят на передовые модели с закрытым кодом.
Для разработчиков снижение цены означает больше вызовов моделей. Особенно это заметно в задачах с агентами и при пакетной обработке. При расчёте реальной стоимости нужно учесть ещё несколько факторов:
- Попадание в кеш: возможность использовать кеш для повторяющихся системных промптов и длинного контекста напрямую влияет на фактическую цену.
- Длина контекста: в задачах с длинными документами входных токенов зачастую намного больше, чем выходных.
- Количество повторных попыток: нестабильный вывод и ошибки формата приводят к повторным запросам, которые могут увеличить расходы в несколько раз.
- Количество обращений к инструментам: при выполнении одной задачи агент может совершить больше десятка циклов обмена — цена за вызов низкая, но вызовов много.
При сравнении цен сначала проверьте в консоли APIYI apiyi.com прайс и способы тарификации подходящих моделей: выясните, как отдельно рассчитывается стоимость входных и выходных токенов, а также использования кеша. Затем обработайте небольшую выборку собственных задач и посчитайте стоимость выполнения одной задачи. Этот показатель полезнее, чем цена из прайса.
Как выбрать открытую модель: сузьте круг по рейтингам, а решение принимайте на основе задач
Главное: рейтинги помогают составить список кандидатов, но окончательный выбор зависит от соответствия задачам, стоимости, стабильности и проверки на небольшой выборке.
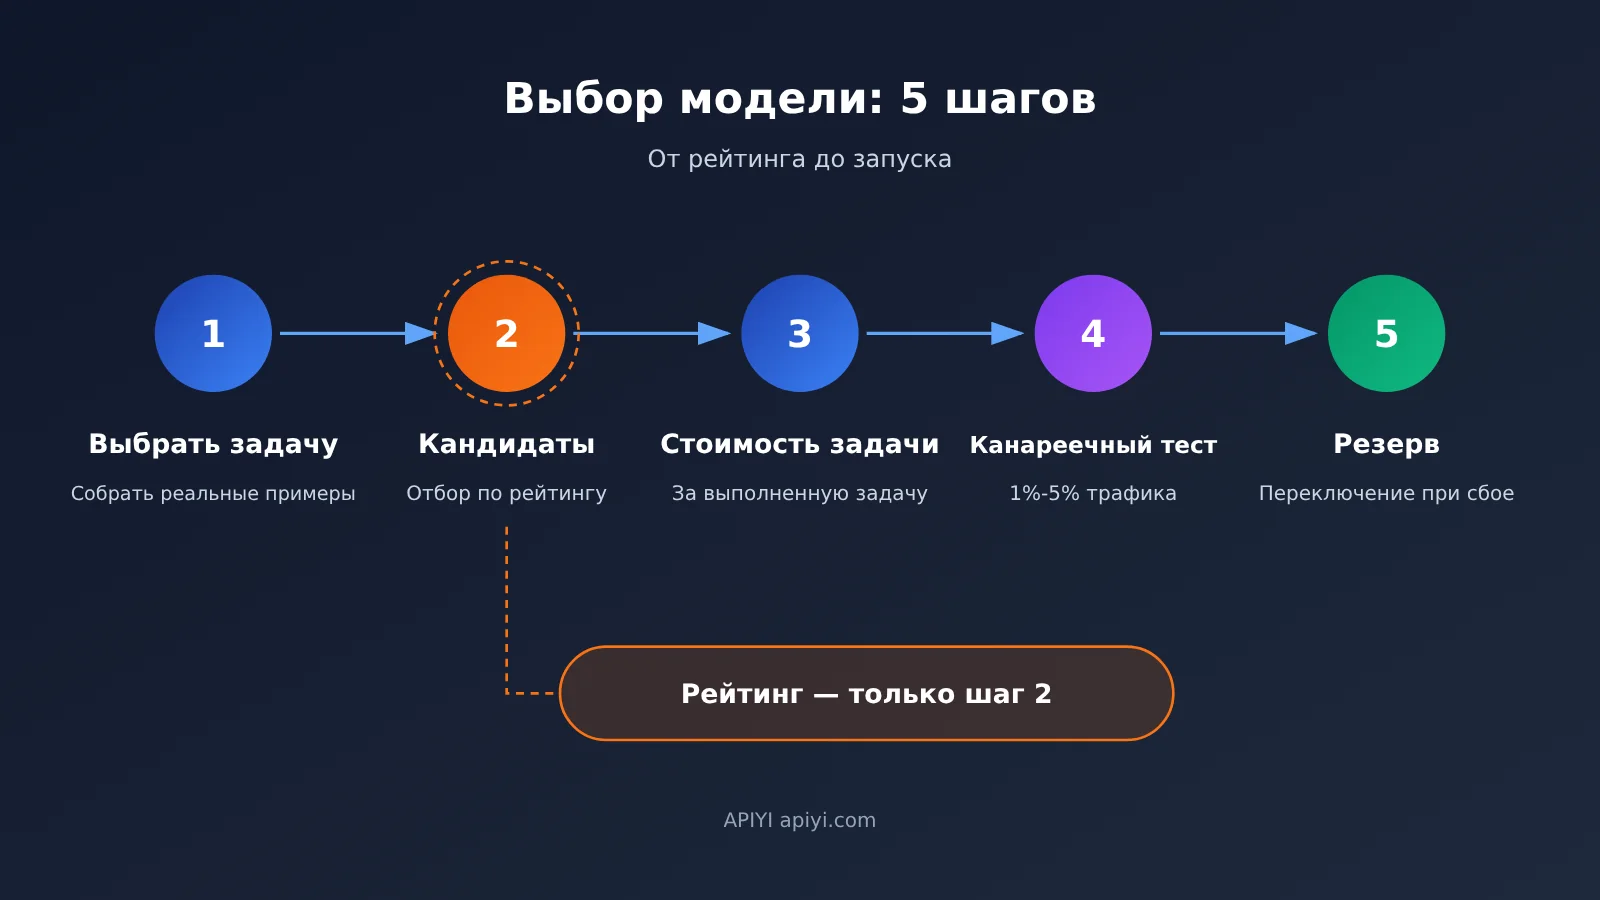
Выбирать модель можно в таком порядке: задача → стоимость → стабильность → проверка → резервный вариант. В таблице собраны вопросы и способы проверки для каждого критерия.
| Критерий | Что выяснить | Как проверить | Влияние на стоимость |
|---|---|---|---|
| Соответствие задачам | Что важнее: программирование, длинные документы, мультимодальные задачи или вызов инструментов агентом? | Подготовить 30–100 реальных задач и вручную оценить ответы | Если модель плохо справляется с задачей, потребуется больше повторных запросов и ручных правок |
| Цена и кэширование | Сколько стоят входные и выходные токены, а также токены при попадании в кэш? | Изучить список моделей и условия тарификации в консоли, посчитать долю попаданий в кэш | Определяют фактическую стоимость миллиона токенов |
| Контекст | Какой максимальный размер входных данных нужен? Падает ли качество при работе с очень длинным контекстом? | Проверить обрезку текста и извлечение нужной информации на самых длинных реальных документах | Длинный контекст напрямую увеличивает расход входных токенов |
| Ограничения запросов | Хватит ли лимитов на параллельные запросы и запросы в минуту? | Провести нагрузочное тестирование с пиковой интенсивностью | При достижении лимита нужны очередь или переключение, что влияет на задержку |
| Доступность по регионам | Можно ли стабильно обращаться к модели из региона развёртывания? | Сделать реальные вызовы из региона, где работает продакшен | При недоступности придётся искать другой канал доступа |
| Стабильность | Были ли недавно сбои? Сколько времени занимает восстановление? | Изучить историю сбоев и журналы ошибок | Сбои приводят к расходам на повторные запросы и потерям для бизнеса |
Сравнение нескольких моделей — самая трудоёмкая часть этого процесса. Если для каждой модели-кандидата нужно отдельно регистрироваться и подключать SDK, одна только интеграция может занять несколько дней. Через APIYI apiyi.com с одним API-ключом можно вызывать модели OpenAI, Claude, Gemini, DeepSeek, Kimi и других поставщиков. Интерфейс совместим с форматом OpenAI: установите base_url в https://api.apiyi.com/v1, а для переключения модели измените параметр model в запросе. Так можно быстро сравнить модели на одной и той же выборке.
При оценке стабильности недостаточно смотреть только на объявления поставщика. Сбой DeepSeek 3 ноября напоминает, что любая отдельная модель может временно стать недоступной. В консоли APIYI apiyi.com можно просматривать использование и журналы вызовов по каждой модели: там записываются частота ошибок, задержка и расход токенов. Это удобно для наблюдения за реальной работой кандидатов на этапе канареечного развёртывания. Платформа использует многосерверное развёртывание и интеллектуальную маршрутизацию, а также поддерживает автоматическое переключение на резервный вариант. Со стороны приложения стоит дополнительно настроить резервную модель: если основная выдаст ошибку, переключение поможет ограничить последствия отказа одной точки.
Начните канареечное развёртывание с 1%–5% реального трафика и в течение нескольких дней следите за частотой ошибок, задержкой и стоимостью одной задачи. Когда показатели стабилизируются, постепенно увеличивайте долю трафика. Не стоит переводить всё сразу только на основании рейтинга.
Частые вопросы о рейтингах моделей с открытым кодом
Коротко: эти 5 вопросов охватывают самые частые заблуждения при изучении рейтингов моделей с открытым кодом.
Q1: Kimi занимает 61% расходов. Значит ли это, что её модели лучше?
Нет. Доля расходов показывает, кому достаются деньги. На неё влияют цена, корпоративные контракты и каналы закупки, поэтому прямой связи с возможностями модели здесь нет. Кроме того, данные Menlo — это оценка на основе опроса, которая охватывает только расходы американских компаний на модели с открытым кодом. «Первое место по расходам» не означает «первое место по возможностям»: их нужно оценивать на собственных задачах.
Q2: Можно ли по рейтингу запросов OpenRouter судить о корпоративных закупках?
Нет. OpenRouter подсчитывает долю запросов только на своей платформе, а её пользователи — преимущественно разработчики и небольшие команды. Прямые корпоративные контракты, развёртывания в собственной инфраструктуре и другие каналы в статистику не входят. Рейтинг подходит для наблюдения за популярностью моделей среди разработчиков и тенденциями в вызовах, чувствительных к цене, но не для выводов о распределении корпоративных бюджетов.
Q3: Если цена модели ниже, будет ли ниже и общая стоимость?
Не обязательно. Если более дешёвой модели нужно больше повторных попыток, более длинные промпты или больше раундов вызова инструментов, она может потратить больше токенов. Лучше считать стоимость выполнения одной задачи: в консоли APIYI apiyi.com можно посмотреть расход токенов и журнал затрат по каждому вызову, а затем сравнить общие расходы разных моделей на выполнение одного и того же набора задач.
Q4: Могут ли модели с открытым кодом полностью заменить закрытые модели?
Зависит от задачи. По данным Menlo, на модели с открытым кодом приходится 19% корпоративного потребления токенов, но лишь 4% расходов. Это говорит о том, что многие команды отдают им массовые и рутинные задачи, а сложные оставляют передовым закрытым моделям. Надёжный подход — использовать оба типа: через APIYI apiyi.com можно подключить модели с открытым кодом и закрытые модели с одним API-ключом, а затем распределять задачи в зависимости от их сложности.
Q5: Как часто стоит проверять рейтинги моделей с открытым кодом?
Недельные рейтинги можно просматривать раз в месяц, обращая внимание на тенденции, а не на колебания отдельной недели. Годовые и квартальные отчёты стоит внимательно читать после публикации и проверять, не изменились ли методика и выборка. На решения действительно влияет постоянный мониторинг показателей вашего бизнеса — например, частоты ошибок, стоимости задачи и отзывов пользователей. Их стоит пересматривать каждую неделю.
Итоги обзора рейтингов открытых моделей: чек-лист выбора из 5 шагов
Главный вывод: два рейтинга измеряют разные вещи. Чтобы правильно их читать, сначала разберитесь с методикой, затем изучите выборку и, наконец, проверьте модели на собственных задачах.
Основные тезисы:
- Расходы ≠ вызовы: Menlo измеряет расходы компаний, OpenRouter — количество запросов на платформе. Базы для расчёта разные, поэтому напрямую сравнивать показатели нельзя.
- Опрос ≠ аудит: данные Menlo — оценка на основе опроса почти 400 лиц, принимающих решения в американских компаниях. Данные OpenRouter отражают ситуацию только на этой платформе.
- Дешевле ≠ экономнее: цена за единицу снизилась примерно на 70%, но объём использования вырос в 22,5 раза, и общие расходы увеличились. Считать нужно стоимость выполнения задачи.
- Популярность ≠ стабильность: даже у модели, которая занимает первое место по числу вызовов, бывают сбои. Резервный вариант нужно подготовить заранее.
- Рейтинги помогают сузить круг кандидатов, но не заменяют выбор модели.
Этот чек-лист можно использовать при следующем выборе модели:
- Определите задачу: запишите основные типы задач — программирование, работа с длинными документами, мультимодальные сценарии, агенты. Соберите 30–100 реальных примеров и определите критерии оценки.
- Составьте список кандидатов: выберите по 2–3 модели из рейтингов расходов и запросов, а для сравнения добавьте одну закрытую модель. Всего оставьте 3–5 кандидатов.
- Рассчитайте стоимость задачи: протестируйте все модели на одной и той же выборке. Запишите расход токенов, частоту попаданий в кэш и число повторных попыток, затем рассчитайте стоимость выполнения одной задачи и оцените качество.
- Проведите канареечное тестирование: направьте на выбранную модель сначала 1%–5% реального трафика. Несколько дней наблюдайте за частотой ошибок, задержкой и стоимостью. Если показатели соответствуют требованиям, увеличивайте долю трафика.
- Подготовьте резерв: настройте как минимум одну резервную модель другого поставщика, определите правила переключения и регулярно проверяйте их на практике.
Если хотите выполнить шаги с 3-го по 5-й в одном интерфейсе, через APIYI apiyi.com можно подключить модели-кандидаты с одним ключом, сравнить цены, расход и логи в консоли, а затем настроить переключение на резервную модель с помощью автоматического перехода на запасной вариант. Новым пользователям доступен бесплатный лимит для тестирования — его хватит, чтобы начать с небольшой выборки.
Источники данных
- Отчёт Menlo Ventures о состоянии корпоративного ИИ в 2026 году: опубликован 3 ноября 2026 года
- Ссылка:
menlovc.com -
Примечание: расходы компаний на ИИ, доля расходов на открытые модели и изменение цен на токены — оценки на основе опроса
-
Рейтинг моделей OpenRouter: недельный рейтинг за 26 октября — 1 ноября 2026 года
- Ссылка:
openrouter.ai/rankings - Примечание: доли текстовых запросов и тенденции использования токенов отражают ситуацию только на этой платформе
Автор: техническая команда APIYI
Технические вопросы: если при выборе модели возникли вопросы о ценах, ограничениях частоты запросов или переключении между моделями, свяжитесь с нами на главной странице APIYI apiyi.com. Дополнительные материалы по подключению доступны в центре документации docs.apiyi.com