Примечание автора: на примере архитектуры суперагента DeepSeek разберём, как распределять модели между router и worker в мультиагентной системе и как токены чтения из кэша влияют на стоимость архитектуры.
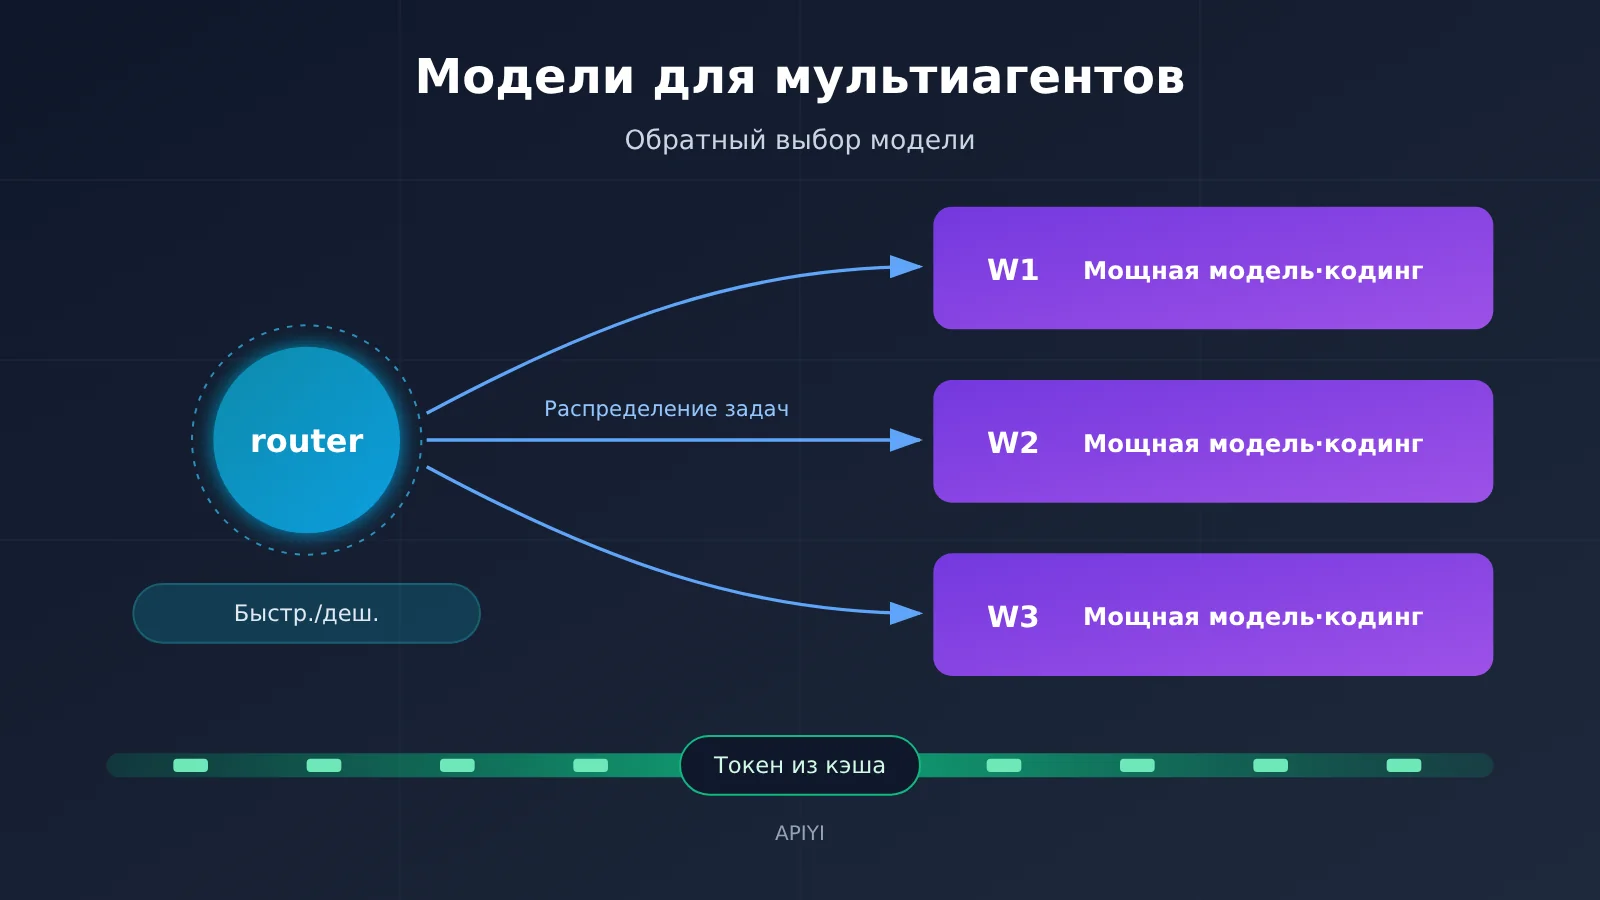
При создании мультиагентной системы для программирования большинство выбирает самую мощную модель для «главнокомандующего», а исполнителям поручает более дешёвые модели. Команда DeepSeek Harness в ноябре 2026 года представила противоположный подход в архитектуре суперагента: для router — дешёвая модель, для worker — мощная. Лёгкая модель в роли router ведёт диалог и распределяет задачи, а самая мощная модель в роли worker непосредственно пишет код.
Это не пересказ новости. Мы превратим эту архитектуру в практические рекомендации по выбору моделей: какие способности нужны router и worker, как оценить число токенов чтения из кэша и когда стоит выбрать недорогую модель. Сам DeepSeek называет результаты тестов, приведённые в статье, лишь «ориентировочными» — мы объясним, какие у них есть ограничения.
Главная польза: после прочтения вы сможете составить план распределения моделей по ролям в своей мультиагентной системе и приблизительно оценить его стоимость по объёму чтения из кэша.
Главное о распределении моделей между агентами
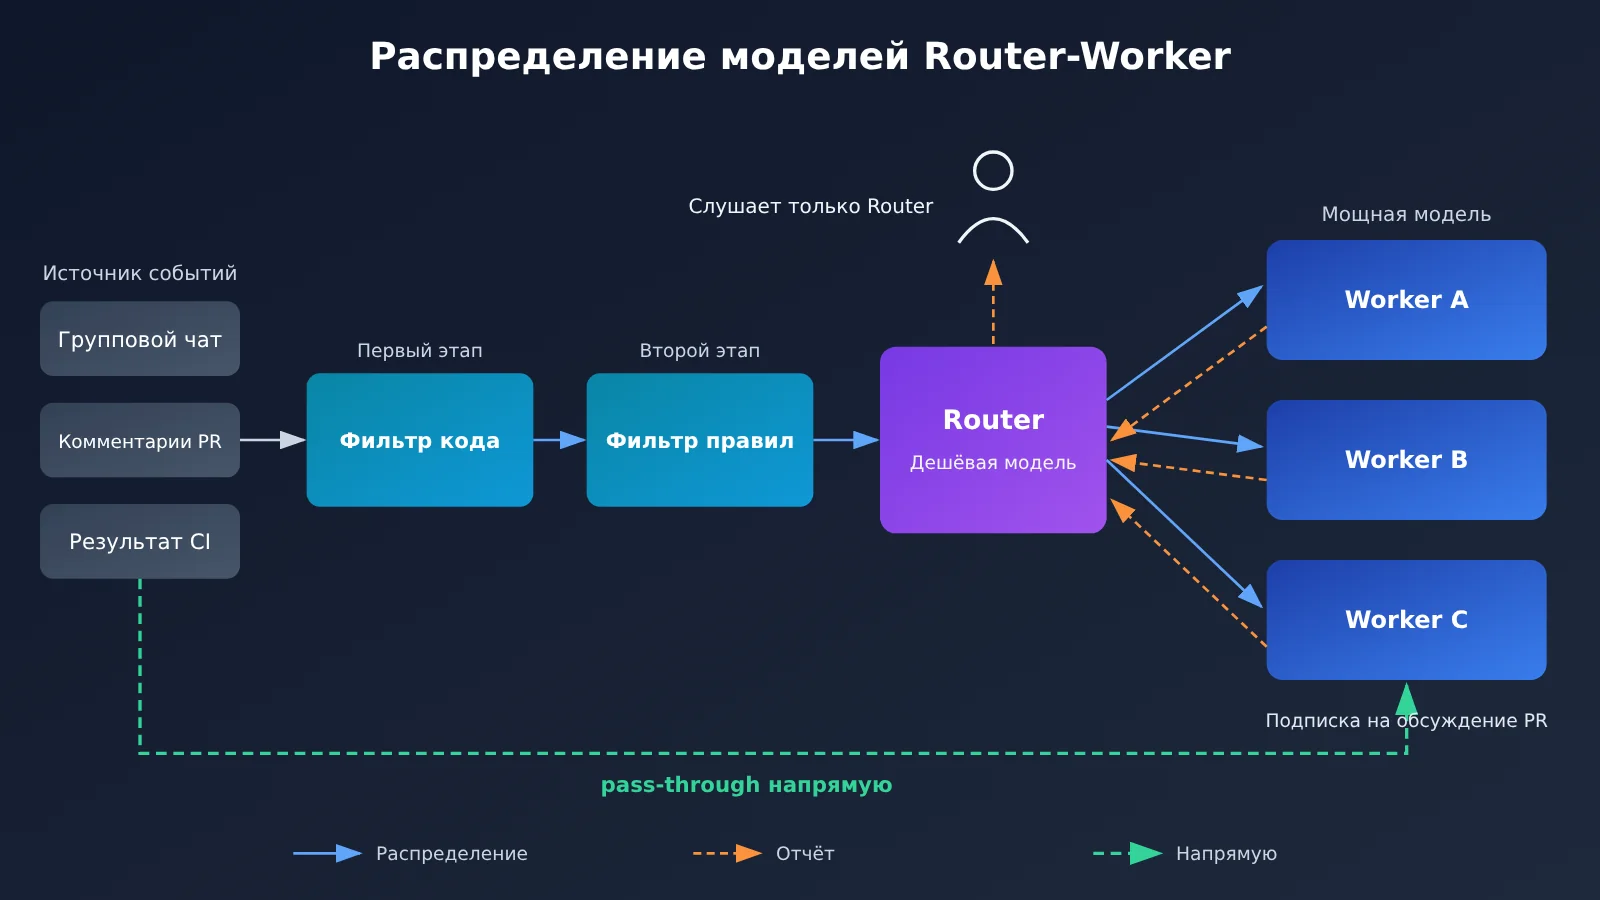
Архитектура DeepSeek состоит из двух уровней. Router — это долгоживущая сессия, которая общается с человеком, распределяет задачи и отслеживает связи между ними. Worker получает по одной задаче за раз, работает в отдельном чистом контексте и никогда не общается с человеком напрямую: о состоянии он сообщает только router. С учётом такого разделения ролей модели можно подобрать по следующей схеме.
| Роль | Основные обязанности | Пишет код | Рекомендуемый класс модели | Почему |
|---|---|---|---|---|
| router | Общение, распределение задач, отслеживание связей между ними | Нет, можно не давать доступ к shell | Лёгкая, недорогая и быстрая | Работа несложная, но вызовы частые, поэтому важнее задержка и цена |
| worker | Получение отдельной задачи и написание кода | Да | Лучшая доступная модель для написания кода | Качество кода напрямую влияет на результат |
| Слой фильтрации триггеров | Отсев шума в групповых чатах и уведомлениях CI | Нет | На первом этапе — обычный код, на втором — небольшая модель | Большинство событий не нужно передавать модели |
Почему распределение моделей между агентами стоит «перевернуть»
По мнению DeepSeek, узким местом в разработке с помощью ИИ стали уже не возможности моделей, а внимание человека. Обычно один человек может одновременно следить лишь за 3–5 активными сессиями агентов. Если их больше, легко запутаться: кто ждёт одобрения, кто застрял, а какие два агента незаметно меняют один и тот же PR. Поэтому ценность router не в «уме», а в способности стабильно распределять задачи и отслеживать их выполнение. Он не разбивает задачи на части, а только назначает их и следит за ними. Это отличает его от распространённой схемы, в которой «главный агент» сам разбивает задачу на шаги.
Поскольку router не нужно глубоко рассуждать или писать код, использовать для него самую дорогую модель — пустая трата ресурсов. Код создают именно worker-агенты, и от его качества зависит успех работы. Поэтому бюджет на сильные модели стоит направить туда. В этом и состоит «перевёрнутый выбор моделей»: чем ближе роль к пользователю, тем легче модель; чем ближе к коду, тем она мощнее.
Какие возможности нужны router и worker
Чтобы выбрать подходящие модели, нужно разложить обязанности каждой роли на конкретные требования. Этот список можно использовать для оценки кандидатов.
| Возможность | Требования к router | Требования к worker | Подсказка при выборе |
|---|---|---|---|
| Следование инструкциям и классификация | Высокие: нужно надёжно определять, кому назначить задачу | Средние | Для router в первую очередь проверяйте точность распределения задач |
| Длинный контекст и восстановление истории | Средние: детали раскрываются постепенно через сводки с ID | Высокие: нужно читать много кода | Для worker оценивайте контекстное окно и возможности поиска по коду |
| Качество генерации кода | Не требуется | Главный приоритет | Не экономьте на бюджете для worker |
| Задержка ответа | Высокий приоритет: решения принимаются часто | Средний: отдельная задача может выполняться дольше | Для router выбирайте быстрые модели класса Flash |
| Чувствительность к цене | Очень высокая: объём чтения из кэша огромен | Средняя | Цена router влияет на общие расходы |
| Вызов инструментов | Редкий, можно обойтись без доступа к shell | Частый: нужно выполнять код и запускать тесты | Ограничивайте роли через права доступа |
Есть ещё одно требование к router, о котором легко забыть: сама система должна исключать возможность «взяться за работу самому». DeepSeek намеренно не дала router доступ к shell, чтобы он не мог выполнять задачи напрямую. Поэтому при выборе модели для router не нужно искать ту, которая «умеет всё». Наоборот, стоит смириться с тем, что она «умеет только раздавать задачи».
Расход токенов на чтение кеша при распределении моделей между агентами
Дешёвого роутера недостаточно: главная статья расходов в этой архитектуре — токены на чтение кеша. Роутер работает в долгой сессии и многократно считывает контекст из кеша. Несколько воркеров запускаются параллельно, и каждый из них тоже считывает большой объём контекста. Результаты тестов DeepSeek наглядно показывают масштаб проблемы.
| Показатель | Значение | Примечание |
|---|---|---|
| Сообщений за раунд | Около 300 | Из них около 20 — реальные рабочие запросы |
| Среднее время выполнения задачи суперагентом | 12,4 минуты | В медленном случае — 15,7 минуты |
| Время в медленном случае при базовом варианте с одной сессией | 29,5 минуты | Используется для сравнения |
| Частота решений роутера | Выросла примерно с 1 до 40 в минуту | Время на одно решение сократилось с 6,4 до 1,6 секунды |
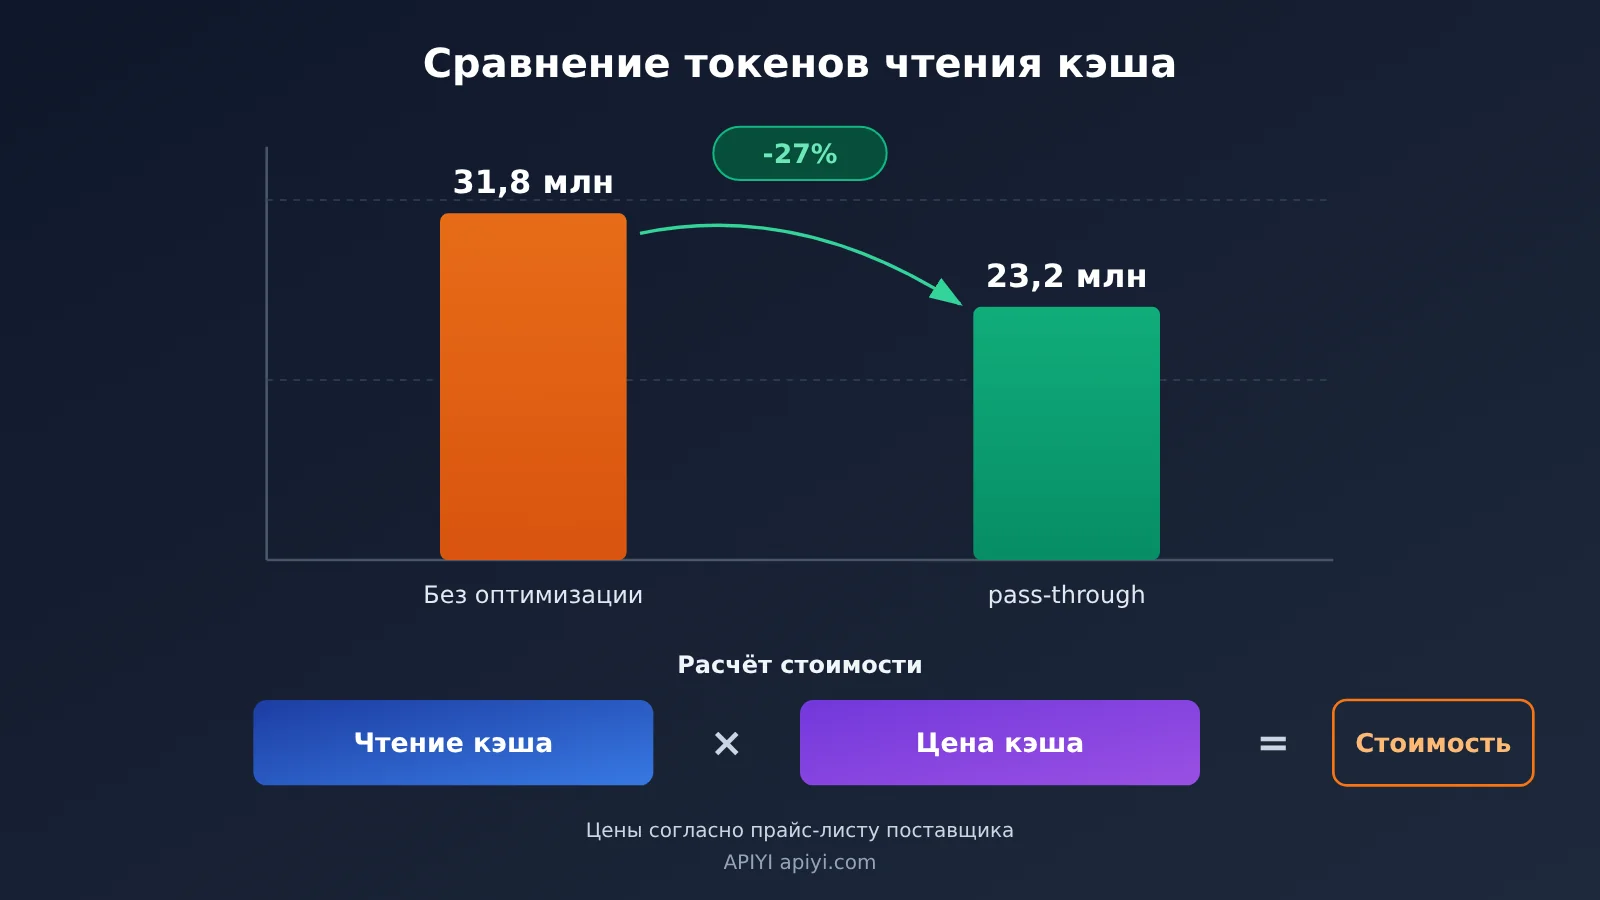
| Токены на чтение кеша | 23,2 млн | С включённой оптимизацией pass-through |
| Токены на чтение кеша без оптимизации | 31,8 млн | Когда воркеры не подписаны на потоки напрямую |
| Стоимость чтения кеша | Около 7 долларов | По тарифу DeepSeek Flash для непиковых часов |
Как оценить стоимость распределения моделей между агентами по объёму чтения из кэша
Стоимость одного запуска можно разбить на три части: количество токенов, прочитанных из кэша, умножить на цену их чтения; добавить стоимость входных токенов, не найденных в кэше; затем прибавить стоимость выходных токенов. В архитектуре router-worker первая составляющая обычно занимает львиную долю, поэтому при выборе модели прежде всего стоит смотреть на цену чтения из кэша.
Рассчитаем её по опубликованным данным: около 7 долларов за 23,2 млн прочитанных из кэша токенов — это примерно 0,3 доллара за миллион токенов. Это лишь приблизительная оценка на основе опубликованных цифр, а не официальный тариф. Актуальные цены нужно смотреть в прайс-листе поставщика модели. Зная порядок цен, можно подставить тарифы на чтение из кэша для других моделей и быстро понять, во сколько раз вырастут расходы при той же нагрузке.
Сама оптимизация pass-through тоже заслуживает внимания. После подписки worker на поток новые события поступают ему напрямую, без пересылки через router. Объём чтения из кэша снизился с 31,8 млн до 23,2 млн токенов — примерно на 27%. Иными словами, оптимизация архитектуры, как и переход на более дешёвую модель, может напрямую снизить расходы.
Три ограничения исходных данных, о которых стоит помнить
- Написание кода было имитацией: в тесте вместо него использовался инструмент, который просто тратил время. Таким образом проверялось распределение задач, а не качество кода. По этим результатам нельзя судить, какая модель лучше подходит для worker.
- Данные носят ориентировочный характер: DeepSeek прямо указывает, что эти цифры — indicative, а не результаты строгого бенчмарка.
- Сравнение стоимости с тарифом Sonnet противоречиво: в кратком изложении стоимость по тарифу Sonnet оценивается примерно в 4,64 доллара, а в основном тексте говорится, что тот же объём использования на более дорогом тарифе обойдётся «заметно дороже». Эти утверждения противоречат друг другу. Пока сравнение не проверено по оригинальной статье DeepSeek, ссылаться на конкретные цифры не стоит.
Быстрый старт: распределение моделей между агентами
Чтобы применить описанный подход в своей системе, действуйте по шагам ниже. Код здесь не приводится: все параметры указаны прямо в тексте, чтобы их было проще сопоставить с настройками вашего фреймворка.
- Сначала определите роли, затем выбирайте модели: перечислите все роли в системе, которые вызывают модели. Как минимум разделите их на router, worker и фильтр триггеров. Для каждой укажите, пишет ли она код и нужны ли ей инструменты.
- Вынесите имена моделей в конфигурацию: настройте для каждой роли отдельные параметры, например
router_model,worker_modelиfilter_model. Не прописывайте имена моделей непосредственно в бизнес-логике. - Обеспечьте делегирование на уровне архитектуры: уберите у router доступ к shell и другим инструментам выполнения. В эксперименте DeepSeek агент с одной сессией при нейтральном промпте ни разу не делегировал задачу за 5 запусков, а самый медленный запуск занял почти полчаса. Даже когда промпт прямо требовал делегирования, в 1 из 5 случаев агент решил, что задача слишком мала, и выполнил её сам.
- Сначала фильтруйте события: обычным кодом отсеивайте шум по источнику события и списку разрешённых источников. Только оставшиеся события передавайте модели для проверки по правилам команды.
- Записывайте объём чтения из кеша: при каждом запуске фиксируйте три категории токенов — прочитанные из кеша, входные без кеширования и выходные. Затем рассчитывайте стоимость запуска по приведённой выше формуле.
- Сравните модели: не меняя набор задач, замените только
router_modelи посмотрите, как изменятся точность распределения задач, задержка и стоимость. После этого решите, стоит ли переходить на более дешёвую модель.
На шагах 2 и 6 способ подключения напрямую влияет на скорость экспериментов. Если router и worker используют модели разных поставщиков, для каждого приходится отдельно поддерживать ключи и настройки SDK, а при переключении — вносить изменения во многих местах. Через платформу с единым интерфейсом, такую как APIYI apiyi.com, можно использовать один API-ключ и один формат запросов, совместимый с OpenAI. Достаточно изменить параметр model, чтобы назначить router и worker модели разных поставщиков, — так сравнительные эксперименты обойдутся заметно дешевле.
🚀 Совет для быстрого старта: при проверке прототипа настройте параметры моделей для router и worker в APIYI apiyi.com с одним ключом, затем выполните один и тот же набор задач и запишите расход токенов. Какие именно модели доступны, например модели DeepSeek уровня Flash, уточняйте в актуальном списке платформы.
Когда выбирать недорогие модели для ролей в мультиагентной системе
Недорогие модели подходят не для всех задач. Таблица ниже поможет решить, где можно использовать модель дешевле.
| Особенности задачи | Рекомендация | Причина | Способ доступа |
|---|---|---|---|
| Роль только распределяет задачи, отслеживает их и проверяет кэшированный контекст | Выбрать недорогую быструю модель | Задачи простые, поэтому стоимость и задержка важнее всего | APIYI apiyi.com или официальный API поставщика |
| Роль отвечает за написание и изменение кода | Выбрать мощную модель | Качество кода определяет результат работы | APIYI apiyi.com или официальный API поставщика |
| Объём чтения кэша достигает десятков миллионов токенов, а задачи выполняются ежедневно | В первую очередь снизить стоимость чтения кэша | Затраты на кэш растут пропорционально числу запусков | Рассчитать по тарифам поставщика |
| Редкие и несложные разовые задачи | Использовать оплату по факту | Объём использования невелик, поэтому усложнять архитектуру не стоит | Любой сервис с оплатой по факту |
| Частые автоматизированные задачи с большим расходом токенов | Рассмотреть месячную подписку или тариф с высокими лимитами | Дополнительная стоимость каждого запуска больше не отражается в счёте | В зависимости от условий подписки |
Для последнего пункта есть ориентир: согласно публикациям того периода, Claude Code Pass стоил 9,99 доллара в месяц и предлагал примерно в 2–5 раз более высокие лимиты частоты запросов для открытых моделей, таких как Kimi K3.1 Pro, GLM 5.3 и DeepSeek V4.1 Flash. При этом действовали три уровня лимитов использования: за 5 часов, за неделю и за месяц. В публикациях также отмечалось, что для маршрутизации или проверки кэшированного контекста быстрая и недорогая модель лучше подходит технически, а не просто помогает сэкономить. Однако такие тарифы ограничивают вас моделями, включёнными в подписку: если рабочему агенту нужна модель вне пакета, для неё потребуется отдельный канал доступа.
Риски и границы распределения моделей между агентами
Распределение моделей решает вопросы стоимости и разделения задач, но не устраняет старые проблемы самой архитектуры. DeepSeek признаёт, что две из них остаются нерешёнными. Первая — долговременная память: после нескольких месяцев работы системы по-прежнему сложно сохранять важную историю, не переполняя контекстное окно. Вторая — инъекции промптов: любой агент, который получает внешние события, например из групповых чатов или комментариев к PR, может подвергнуться манипуляции. При этом router и worker связаны через общий облачный цикл, поэтому взломанный источник событий теоретически может распространить инструкции на все машины, с которыми взаимодействует система.
Это напрямую влияет на распределение моделей. То, что для router используется дешёвая модель, не означает, что его защиту можно ослабить: именно он первым сталкивается с внешними событиями. При внутреннем внедрении DeepSeek сначала запускала проактивные действия в режиме логирования «что система сделала бы», без немедленного выполнения. Например, стратегия «воспроизвести и исправить без лишних сообщений» работает так: когда кто-то сообщает об ошибке, агент пытается воспроизвести её в фоновом режиме. Если это удалось и ошибка исправлена, он отправляет PR прямо во время обсуждения; если нет — ничего не публикует. При запуске новой системы надёжнее сначала изучить логи и лишь затем постепенно расширять полномочия агентов.
Кроме того, в GitHub код прототипа DSH Super Agent прямо обозначен как исследовательский, а не как готовый продукт. Его идеи можно взять на вооружение, но напрямую развёртывать его в продакшене не рекомендуется.
Часто задаваемые вопросы FAQ
Q1: Что такое «инверсия выбора моделей» в мультиагентной системе?
Это подход, при котором для router используется лёгкая и недорогая модель, а для worker — самая мощная. Router только ведёт диалог, распределяет задачи и следит за их выполнением, но не пишет код. Этим занимается worker, поэтому бюджет на мощную модель стоит выделить ему, а не «главнокомандующему».
Q2: Чем архитектура router-worker отличается от подхода, в котором главный агент разбивает задачу на части?
В модели с главным агентом он разбивает задачу на этапы, поэтому от него требуются развитые способности к рассуждению. Router DeepSeek ничего не разбивает: он только распределяет задачи и отслеживает их выполнение, поэтому для него можно использовать более лёгкую модель. Обратная сторона — worker должен уметь самостоятельно выполнять задачу целиком.
Q3: Когда этот подход был представлен публично? Можно ли сразу использовать DSH Super Agent?
Материалы об архитектуре были опубликованы 3 ноября 2026 года. DSH Super Agent — исследовательский прототип, размещённый на GitHub вместе со статьёй об архитектуре. Разработчики прямо указывают, что это не поддерживаемый продукт: он предназначен только для знакомства с архитектурой.
Q4: Можно ли научить одного агента делегировать задачи с помощью промпта?
Тесты DeepSeek показали, что этот способ ненадёжен: с нейтральным промптом агент не делегировал задачи ни разу за пять запусков, а с промптом, подчёркивающим необходимость делегирования, он не сделал этого в одном из запусков. Для надёжного делегирования нужна структурная изоляция — например, разделение сессий и удаление инструментов выполнения, а не более длинный промпт.
Q5: Как удобно настроить модели разных поставщиков для router и worker в одной системе?
Главное — сделать имя модели отдельным параметром для каждой роли и использовать единый способ подключения:
1. Зарегистрируйтесь в APIYI на apiyi.com и получите API-ключ
2. В настройках системы задайте параметр `model` отдельно для router и worker
3. Для сравнительных экспериментов меняйте только имя модели, сохраняя формат запросов
Так не придётся отдельно поддерживать конфигурацию SDK для каждого поставщика. Доступные модели указаны в актуальном списке на платформе.
Q6: Можно ли напрямую использовать данные о стоимости из оригинальной статьи для планирования бюджета?
Напрямую применять их не рекомендуется. Написание кода в эксперименте имитировалось, результаты носят ориентировочный характер, а сравнение цен с моделями уровня Sonnet в разных частях статьи противоречиво. Лучше измерить объём чтения из кеша на собственном наборе задач и умножить его на актуальную цену за единицу. В APIYI на apiyi.com можно выполнить те же задачи с разными моделями и получить данные для своего сценария.
Q7: Какие известные ограничения есть у этой архитектуры?
Основных ограничений три: ухудшение работы памяти при длительной работе; риск инъекции промпта при чтении внешних событий; большой объём токенов, считываемых из кеша, что заметно увеличивает расходы при использовании дорогих моделей. Кроме того, пока нет данных об эффективности router с конкретными моделями — это придётся проверить самостоятельно.
Главное о распределении моделей между агентами
- Выбор моделей наоборот: для router — лёгкая и дешёвая модель, для worker — мощная модель, которая пишет код.
- Узкое место — внимание: человек обычно может следить только за 3–5 сеансами, а router собирает общение в одном месте.
- Делегирование обеспечивается архитектурой: лишить router инструментов выполнения гораздо надёжнее, чем менять промпт.
- Кэш — главная статья расходов: в одном тестовом прогоне на чтение кэша пришлось 23,2 млн токенов, поэтому цена за токен особенно важна.
- Оптимизация архитектуры тоже экономит деньги: прямая передача данных через pass-through сократила объём чтения кэша примерно на 27%.
- К данным стоит относиться осторожно: написание кода моделировалось, поэтому результаты лишь ориентировочные, а сравнение цен требует проверки.
- Экспериментируйте через единый интерфейс: в APIYI apiyi.com достаточно изменить параметр
model, чтобы сравнить разные варианты распределения моделей.
Итоги
Идея использовать дешёвую модель для router и мощную для worker сводится к трём принципам:
- Подбирайте модель по роли: для распределения и отслеживания задач без написания кода используйте быструю недорогую модель, для программирования — мощную.
- Учитывайте стоимость кэша: токены чтения кэша составляют основную часть расходов в такой архитектуре, поэтому при выборе моделей в первую очередь сравнивайте цены на их чтение.
- Решайте по результатам тестов: данные из исходного материала дают лишь ориентир. Чтобы оценить итоговую стоимость и качество, нужно провести тесты на собственном наборе задач.
Для начала соберите прототип router-worker на небольшом наборе задач и настройте выбор модели отдельно для каждой роли. Затем постепенно меняйте модель router и следите за точностью распределения задач и стоимостью. Для сравнения можно использовать APIYI apiyi.com: он позволяет подключать модели разных поставщиков с одним ключом и принимать решение на основе собственных данных.
📚 Источники
- DeepSeek’s Super Agent Harness: Fixing the Attention Bottleneck in AI Coding: разбор архитектуры супер-агента DeepSeek
- Ссылка:
mindstudio.ai/blog/deepseek-super-agent-harness-design -
Описание: архитектура router-worker, эксперименты с делегированием, данные о кэшировании токенов и нерешённые вопросы
-
Claude Code Pass Pricing: What’s in the $9.99/Month Plan: разбор ежемесячного плана с высокими лимитами
- Ссылка:
mindstudio.ai/blog/claude-code-pass-pricing - Описание: сравнение оплаты по мере использования и ежемесячной подписки для мультиагентных рабочих процессов с большим расходом токенов
Автор: техническая команда APIYI
Техническое общение: свяжитесь с нами через главную страницу APIYI apiyi.com, чтобы обсудить распределение моделей между агентами. Больше материалов по подключению — в центре документации docs.apiyi.com