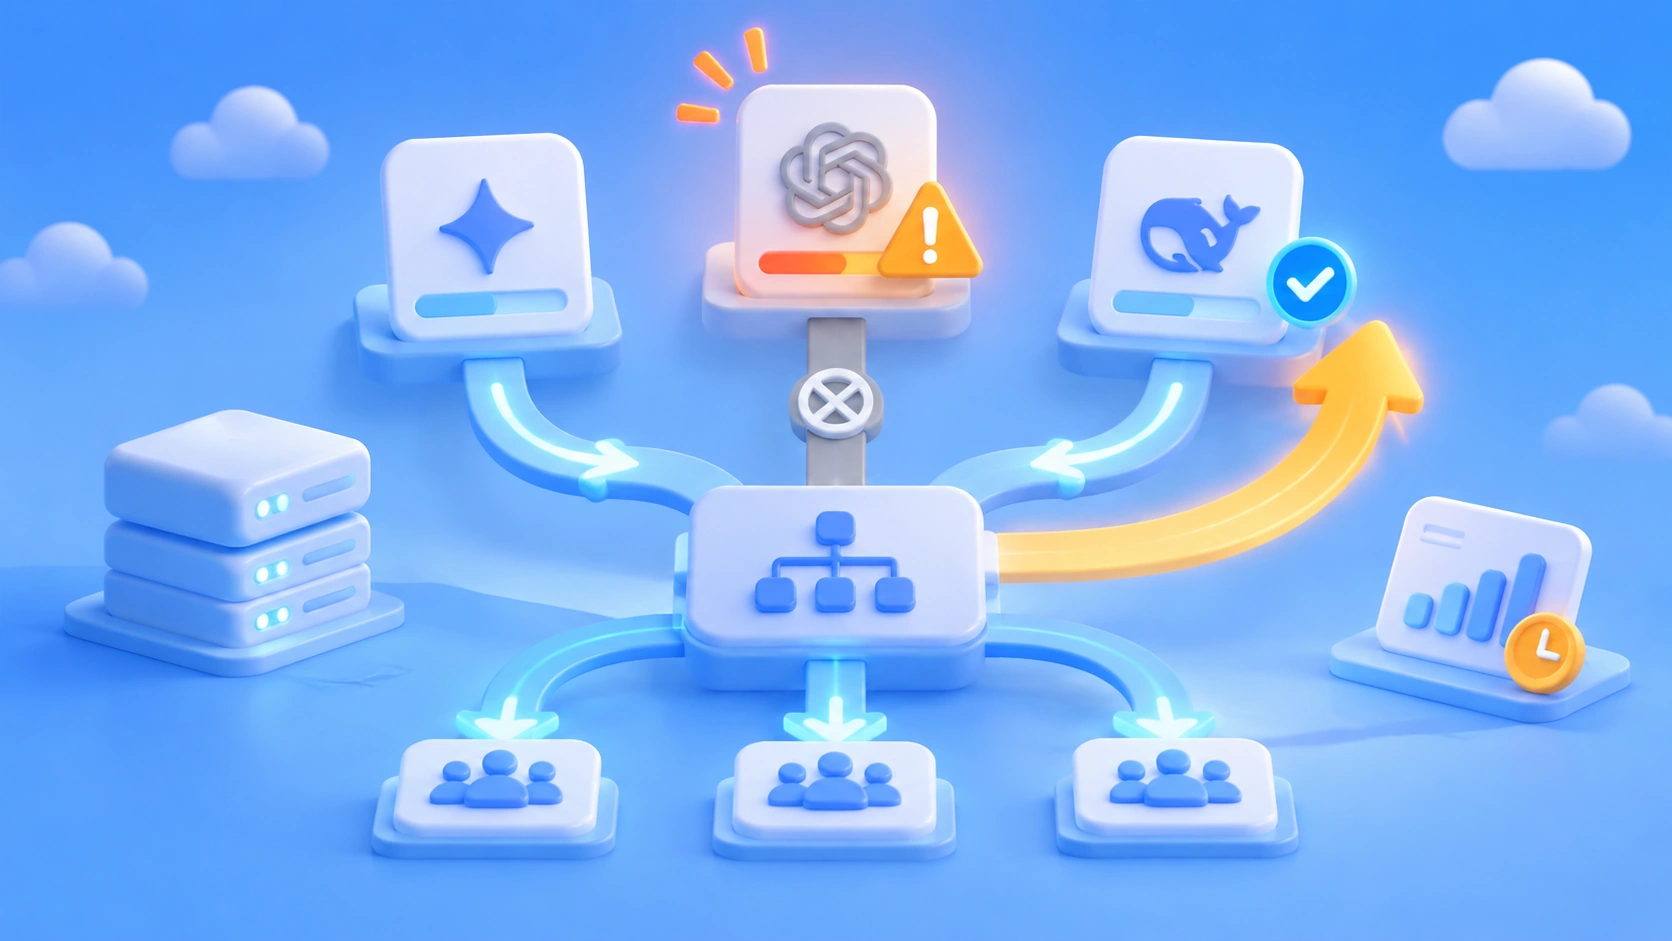
Примечание автора: в день выпуска новой модели вполне ожидаемы исчерпание квот, ограничения частоты запросов и тайм-ауты. В статье разберём пять аспектов проектирования: разделение моделей на уровни, выбор резервных моделей, приоритетные очереди, распределение нагрузки по времени, мониторинг и бюджет. В конце — чек-лист по проверке пропускной способности перед релизом.
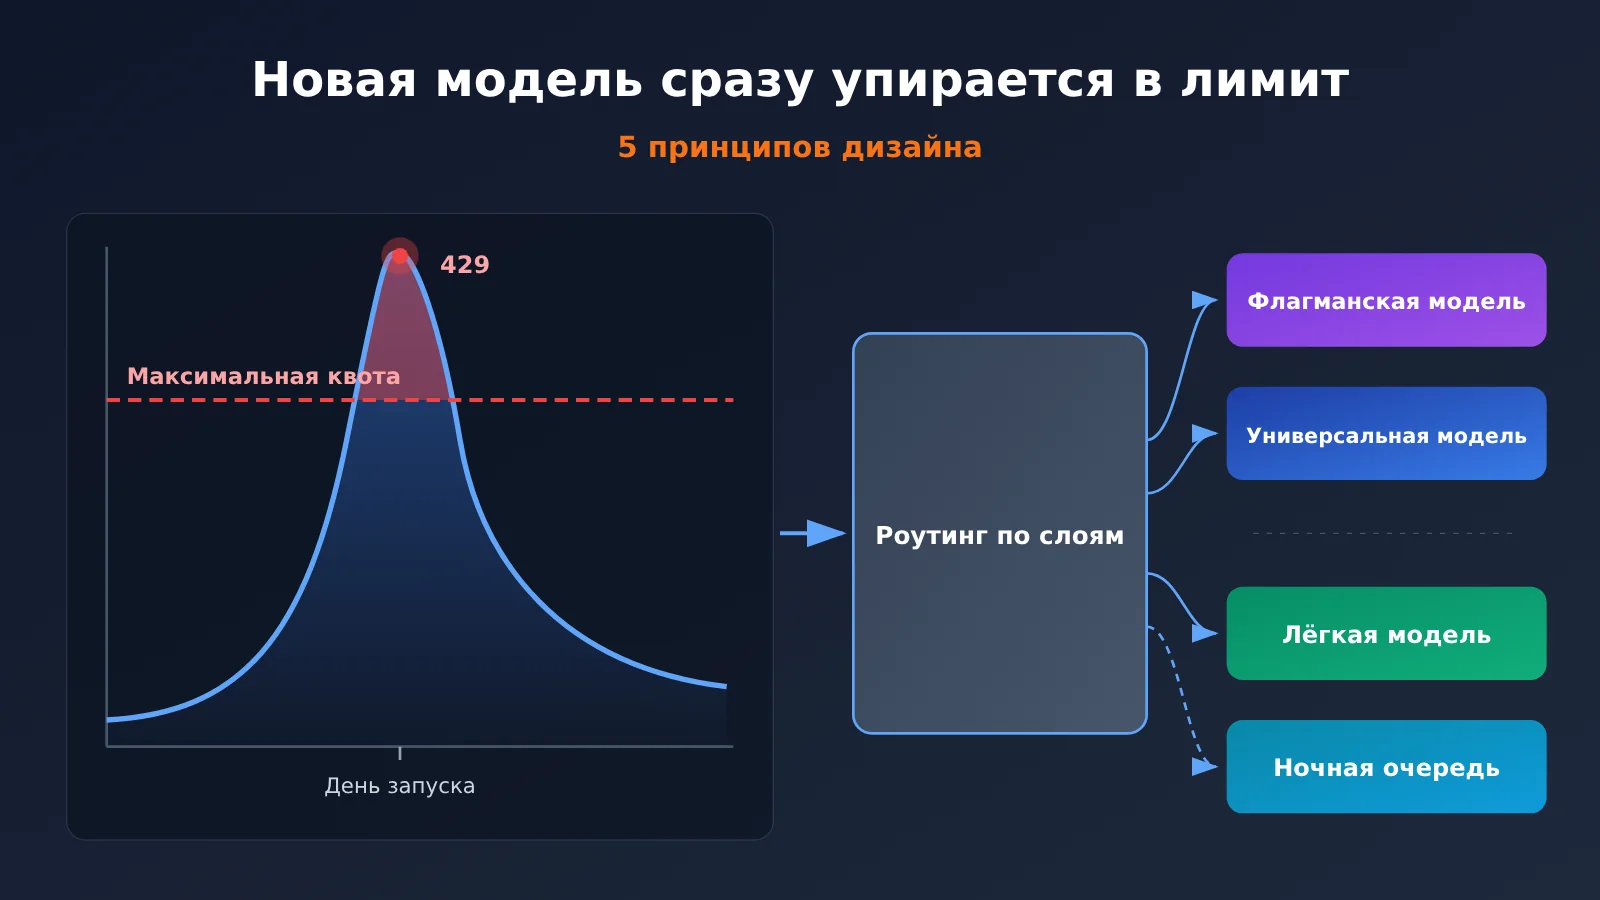
Сразу к главному: исчерпание квоты сразу после запуска новой модели — не неожиданность, а часть жизненного цикла продукта. Бесплатные квоты привлекают множество желающих попробовать новинку, трафик в день релиза резко концентрируется, а поставщику нужно время на расширение мощностей. В сочетании эти факторы почти неизбежно приводят к нехватке ресурсов. Поэтому разработчикам приложений стоит ещё до релиза продумать переключение между моделями и распределение нагрузки по времени, а не ждать появления 429, чтобы снова и снова повторять запросы.
Это не статья о том, как «добавить ещё несколько повторных попыток». Повторы помогают пережить кратковременные сбои, но не решают проблему исчерпанной квоты или перегрузки поставщика. В день релиза важнее не количество повторов, а заранее настроенные уровни моделей и очереди. Из статьи вы узнаете, как на практике спланировать ресурсы к дню запуска: разделить модели на уровни, выбрать резервные варианты, настроить приоритетные очереди и распределение нагрузки по времени, а также организовать мониторинг и контроль бюджета. Вы поймёте, когда переключаться на другую модель, когда ставить запросы в очередь, а когда прекращать работу.
Почему в день запуска новой модели легко столкнуться с лимитами
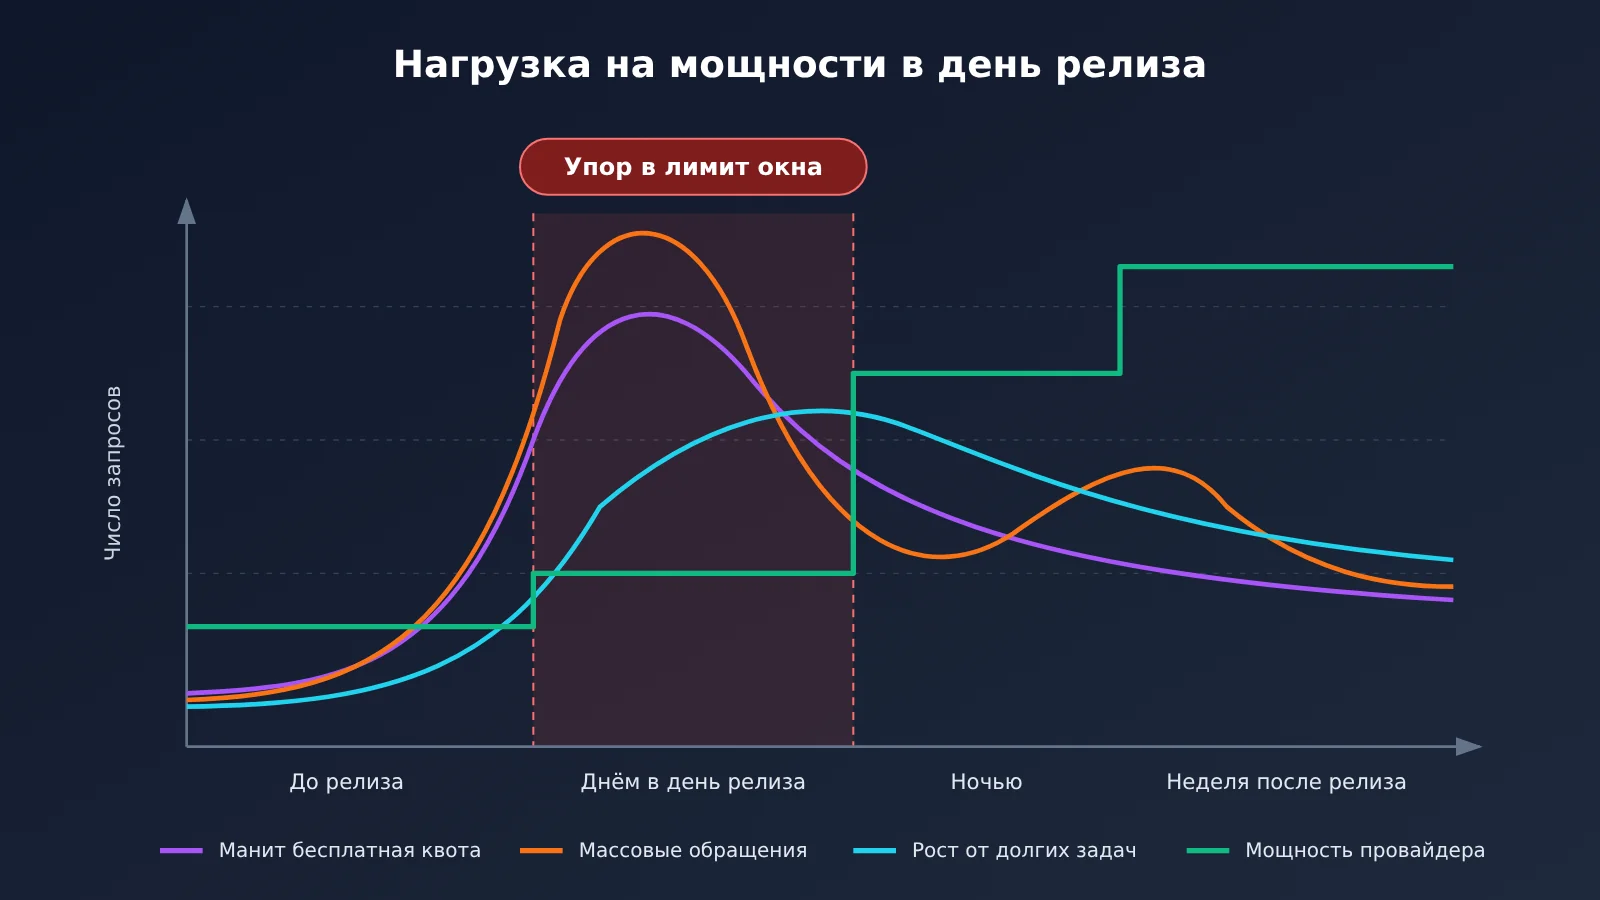
Коротко: в день запуска спрос резко растёт, а расширение мощностей не успевает за ним. Поэтому приложения стоит проектировать с расчётом на такую ситуацию.
Недавний пример — Tencent Hy4. По данным Tencent, модель дебютировала в WorkBuddy 4 ноября. Уже в первый день многие пользователи достигли лимита, после чего компания увеличила вычислительный кластер для инференса в десять раз и повысила бесплатный лимит. Tencent рекомендовала при достижении лимита переключаться на Hy3 или переносить несрочные задачи на вечер. Кроме того, бесплатный доступ к Hy3 продлили до 15 ноября, 23:59.
Важно уточнить: этот случай произошёл на уровне продукта WorkBuddy и касался лимитов конечных пользователей. Напрямую приравнивать его к ограничениям API нельзя. Лимиты продукта обычно зависят от аккаунта или уровня подписки, а ограничения API устанавливаются по скорости запросов и параллельности для ключа, организации или модели. Условия срабатывания и способы решения в этих случаях различаются. Однако общая закономерность очевидна: после запуска новой модели спрос концентрируется за очень короткое время.
Сам масштаб спроса тоже быстро растёт. 4 ноября DeepSeek сообщила, что у Harness около 1,54 млн активных пользователей в день, а суточное потребление составляет около 92 трлн токенов. Это данные самой компании, а не результаты независимого аудита: они помогают оценить порядок величин, но не подходят для точного планирования мощностей. Тем не менее они показывают, что расход токенов в агентных приложениях уже намного выше, чем в обычных чатах.
Четыре причины, по которым новая модель упирается в лимиты
| Причина | Как проявляется | Влияние на приложение |
|---|---|---|
| Бесплатные или пробные лимиты | Новую модель часто предлагают попробовать бесплатно, привлекая множество пользователей одновременно | Лимиты быстро исчерпываются, появляются ошибки 402 или 429 |
| Одновременные обращения | Нагрузка в день запуска, во время акций и в рабочие часы накладывается друг на друга | Пиковая нагрузка может достигать 3–10 обычных значений |
| Длительные задачи | Многошаговая работа агентов, вызовы инструментов, длинный контекст | Каждый запрос расходует много токенов и надолго занимает ресурсы инференса |
| Запаздывание расширения мощностей у поставщика | Увеличение вычислительного кластера для инференса требует времени | Ошибки 5xx, очереди, тайм-ауты и даже колебания качества ответов |
Из этих четырёх факторов разработчики приложения могут напрямую контролировать только характер собственных запросов и их планирование. Поэтому вместо того, чтобы надеяться, что поставщик «выдержит нагрузку», лучше заранее подготовить на своей стороне механизмы распределения нагрузки и буферизации.
Пять типов проблем с доступной ёмкостью новых моделей
Главное: исчерпание лимитов — это не одна ошибка, а пять разных типов проблем с доступной ёмкостью. И обрабатывать их нужно по-разному.
Многие команды обрабатывают все сбои одной и той же логикой повторных попыток. Именно поэтому инциденты в день запуска разрастаются. Если квота исчерпана, повторные запросы так и будут завершаться ошибкой, а при перегрузке провайдера частые повторы только усилят нагрузку. Таблица ниже поможет разобраться в пяти типах проблем и продумать обработку каждого случая.
| Проблема | Типичный код состояния | Причина | Что делать |
|---|---|---|---|
| Квота исчерпана | 402, 429 |
Закончилась бесплатная или пробная квота либо средства на счёте | Прекратить повторные попытки, переключиться на резервную модель или предложить пополнить счёт |
| Ограничение скорости или параллелизма | 429, часто с Retry-After |
Превышен лимит RPM, TPM или параллельных запросов для одного ключа или модели | Подождать согласно Retry-After; если время ожидания превышает порог — переключиться или поставить запрос в очередь |
| Недостаточная ёмкость провайдера | 500, 502, 503, 529 |
Кластер инференса перегружен или частично вышел из строя | Сделать несколько повторных попыток с экспоненциальной задержкой, затем переключиться на резервную модель |
| Длительные задачи | Тайм-аут, разрыв соединения | Многошаговая работа агента, вызовы инструментов или длинный контекст делают отдельный запрос слишком тяжёлым | Разбивать задачи, ограничивать контекст и выделять отдельный пул параллельных запросов для длительных задач |
| Пиковая нагрузка | Сочетание 429 и 5xx |
Трафик накапливается в дневное время, в день запуска или во время мероприятий | Использовать очередь с приоритетами и распределять нагрузку по времени, откладывая несрочные задачи |
В таблице есть две важные детали. Во-первых, код 429 неоднозначен: он может означать как превышение лимита скорости, так и исчерпание квоты. Чтобы разобраться, нужно проверить сообщение об ошибке в теле ответа и заголовок Retry-After. Во-вторых, коды перегрузки вроде 529 означают, что провайдер временно не может обработать запрос. В таком случае снизить частоту запросов эффективнее, чем участить повторные попытки.
Разобравшись с кодами ошибок, можно переходить к пяти следующим аспектам проектирования: когда переключаться на резервную модель, когда ставить запросы в очередь, а когда сразу прекращать попытки.
5 принципов переключения между моделями и распределения нагрузки по времени
Главное: эти пять принципов отвечают на вопросы «какую модель использовать», «чем её заменить», «кто получит доступ первым», «когда выполнять запросы» и «сколько это стоит». Если упустить хотя бы один из них, в день релиза это даст о себе знать.
Принцип 1: разделение моделей на уровни
Как это сделать: разделите модели по возможностям и стоимости на три уровня: флагманский, универсальный и лёгкий. Затем распределите бизнес-задачи по уровням в зависимости от их приоритета и сложности. Для сложных рассуждений и генерации критически важного кода используйте флагманский уровень; для повседневных вопросов, создания кратких сводок и перефразирования — универсальный; для простых задач вроде классификации, извлечения данных и распознавания намерений — лёгкий. Когда выходит новая модель, ей обычно передают лишь часть трафика флагманского уровня, а не заменяют существующую модель целиком.
Когда применяется: разделение на уровни работает постоянно, а не включается только при сбоях. Оно заранее определяет, куда по умолчанию направляется каждый тип задач. В день релиза на этой основе меняют лишь пропорции трафика.
Как проверить: подготовьте для каждого уровня фиксированный набор тестовых заданий и записывайте долю успешно выполненных задач, задержку P95 и стоимость токенов на одну задачу. Убедитесь, что при передаче простых задач на лёгкий уровень качество заметно не снижается.
На практике главное препятствие для разделения на уровни часто состоит в том, что с каждым новым поставщиком приходится добавлять ещё один SDK и API-ключ. Через агрегирующую платформу вроде APIYI apiyi.com можно с одним ключом вызывать модели OpenAI, Claude, Gemini и других поставщиков. Интерфейс совместим с форматом OpenAI, поэтому при настройке уровней достаточно изменить название модели — поддерживать отдельные механизмы авторизации и клиенты для каждого уровня не придётся.
Принцип 2: сопоставление основных и резервных моделей
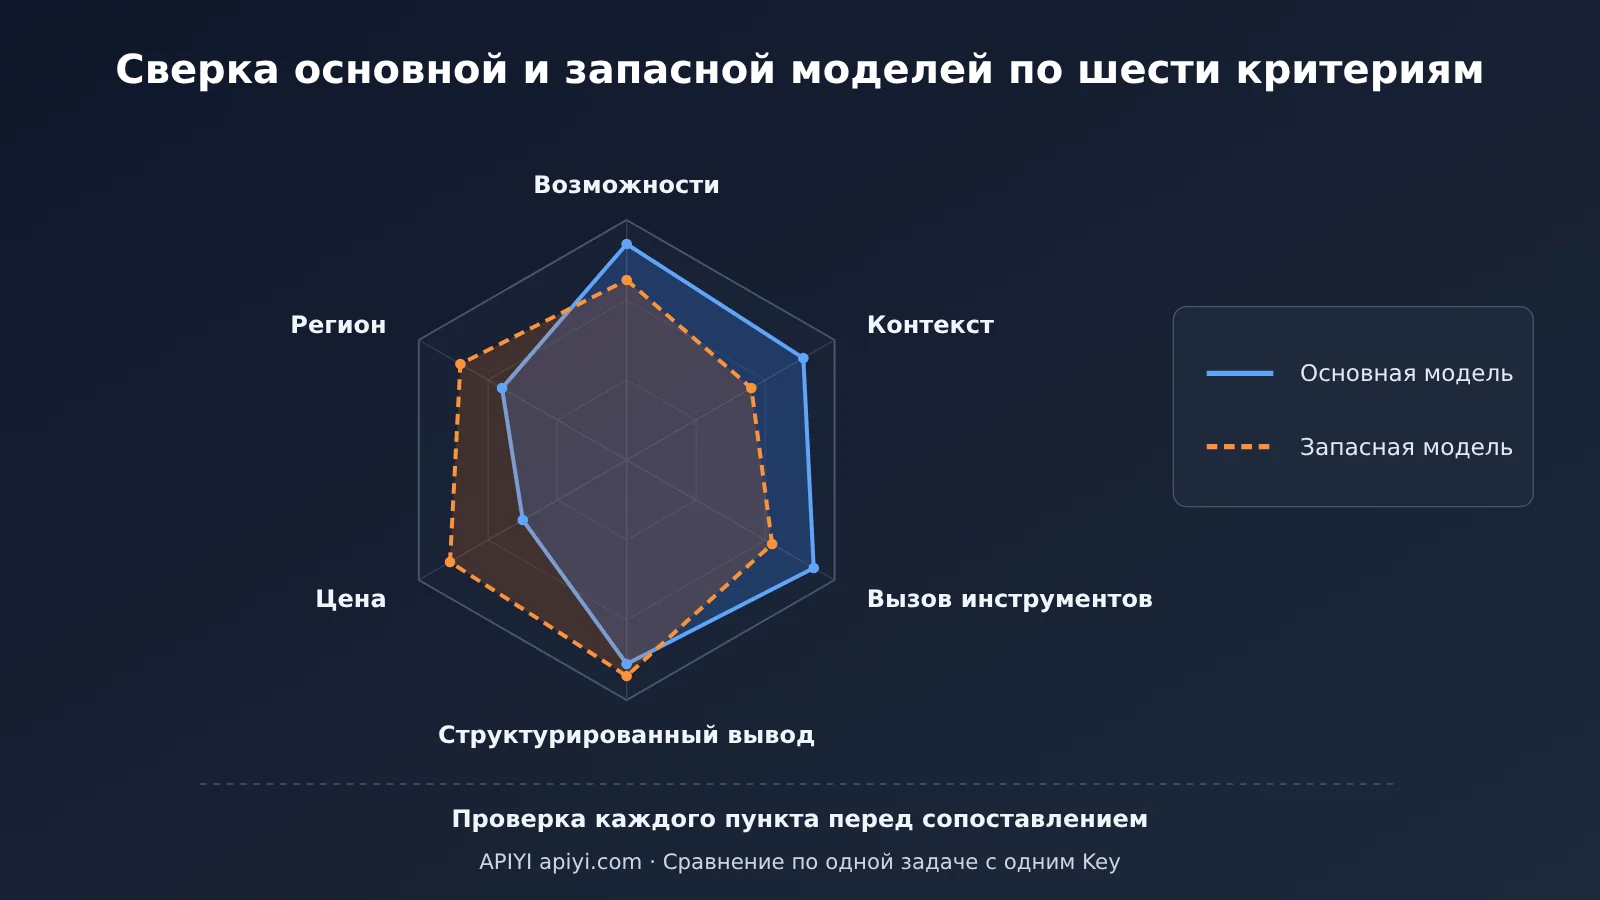
Как настроить: для каждой основной модели назначьте хотя бы одну резервную. При подборе проверьте шесть параметров: уровень возможностей, длину контекста, поддержку вызова инструментов, поддержку структурированного вывода, цену и доступные регионы. Чаще всего забывают о вызове инструментов и структурированном выводе. Если резервная модель не поддерживает тот же формат вызова функций, Agent после переключения просто остановится.
Когда переключаться: задайте конкретные условия. Например, два ответа 5xx подряд, значение Retry-After при ошибке 429 больше допустимого для задачи времени ожидания, задержка P95 длительное время превышает базовый уровень вдвое или явно возвращается сообщение об исчерпании квоты. Не переключайтесь при любой ошибке: иначе даже кратковременные сбои будут вызывать множество переключений.
Как проверить: запустите основной и резервной модели на одном наборе заданий. Сравните долю успешно выполненных заданий, долю корректных структурированных ответов и успешность вызова инструментов. Если разница выходит за допустимые для бизнеса пределы, подберите другую резервную модель.
| Уровень | Подходящие задачи | Основная модель | Резервная модель | Условие переключения |
|---|---|---|---|---|
| Флагманский | Сложные рассуждения, критически важный код, планирование Agent | Флагманская модель нового поколения | Флагман предыдущего поколения или модель другого поставщика того же класса | Два ответа 5xx подряд; Retry-After при ошибке 429 превышает 30 секунд |
| Универсальный | Вопросы и ответы, суммаризация, перефразирование, создание отчётов | Основная универсальная модель | Универсальная модель другого поставщика того же класса | Задержка P95 превышает базовый уровень в 2 раза в течение 5 минут |
| Лёгкий | Классификация, извлечение данных, маршрутизация, распознавание намерений | Лёгкая модель | Лёгкая модель другого поставщика | Доля ошибок 5xx превышает 5%; квота исчерпана |
| Пакетная обработка | Офлайн-анализ, разметка данных, оценка | Любая доступная недорогая модель | Без переключения, задача откладывается | Переключения нет, задача попадает в ночную очередь |
| Доступные платформы | Единое подключение для всех перечисленных уровней | APIYI apiyi.com, официальные API поставщиков | То же | См. консоль и документацию |
Пороговые значения в таблице приведены для примера: настройте их с учётом базовых показателей вашего сервиса.
💡 Рекомендация по резервному переключению: если не хочется самостоятельно поддерживать всю логику переключения в приложении, можно воспользоваться возможностями платформы. Согласно официальному описанию, APIYI apiyi.com использует развёртывание на нескольких узлах, интеллектуальную маршрутизацию, автоматическое резервное переключение и балансировку нагрузки. Это помогает снизить нагрузку при локальных сбоях у вышестоящих поставщиков. Конкретные условия и правила переключения смотрите в официальной документации. При этом на стороне приложения всё же стоит сохранить собственные сопоставления резервных моделей для подстраховки.
Принцип 3: очередь с приоритетами
Как реализовать: разделите запросы на три уровня приоритета: платные или срочные задачи, внутренние задачи и пакетные задачи. Срочные задачи направляйте напрямую к основной модели; внутренние — к резервной, если основная занята; пакетные ставьте в очередь. Для каждой очереди задайте максимальное число параллельных запросов, максимальное время ожидания и стратегию переключения при тайм-ауте. Это не позволит одной долгой задаче занять весь пул параллельных запросов.
Когда включать: очередь начинает работать, когда частота ответов 429 от основной модели или длина очереди превышает заданный порог. Запросы с низким приоритетом перестают занимать слоты параллельных вызовов основной модели.
Как проверить: за очередью нужно наблюдать — как минимум отслеживать её длину, среднее время ожидания и долю отказов от ожидания. При нагрузочном тестировании искусственно вызовите ограничение запросов к основной модели и убедитесь, что задержка срочных задач остаётся стабильной, а низкоприоритетные задачи ждут в очереди, а не завершаются с ошибкой.
Есть одно жёсткое правило: неидемпотентные запросы нельзя повторять автоматически. Если произошла ошибка при оформлении заказа, отправке сообщения, записи в базу данных или вызове внешнего платного инструмента, сначала проверьте статус и выясните, выполнилась ли предыдущая операция. Только после этого решайте, отправлять ли запрос повторно. Для таких запросов можно создавать ключи идемпотентности, по которым сервер будет обнаруживать дубликаты. Автоматический повтор при любой ошибке — частая причина двойных списаний и повторных записей в день запуска.
Принцип проектирования 4: выполнение задач вне пиковых часов
Как реализовать: выделите задачи, которые допускают задержку, например подготовку офлайн-отчётов, пакетное создание кратких сводок, разметку данных и регрессионное тестирование. Запускайте их ночью или в другое время с низкой нагрузкой. Когда пользователи достигали лимита Hy4, Tencent среди прочего рекомендовала переносить несрочные задачи на вечер. Этот подход применим и к вызовам API.
Когда запускать: можно сочетать два способа. Первый — запуск по расписанию: пакетные задачи выполняются каждую ночь в часы низкой нагрузки. Второй — запуск с учётом нагрузки: если днём частота ошибок 429 или задержка P95 превышает допустимый уровень, выполнение очереди пакетных задач автоматически откладывается.
Как проверить: убедитесь, что после переноса задач количество запросов в дневные пиковые часы снизилось, а доля успешно завершённых ночных задач и частота повторных попыток после ошибок остаются в допустимых пределах. Неудачные задачи можно запускать повторно, но при этом нужно соблюдать принцип идемпотентности.
Принцип 5: мониторинг и бюджет
Что делать: разбивайте статистику использования по трём параметрам: ключу, модели и типу задачи. Не смотрите только на общие показатели. Даже если они стабильны, расход токенов на отдельную задачу агента может удвоиться — это будет видно только при разбивке по параметрам. На день релиза установите отдельный бюджет и настройте оповещения. Пороги оповещений можно немного повысить, но лимит бюджета должен оставаться обязательным.
Когда срабатывают оповещения: рекомендуем охватить четыре типа сигналов: резкий рост доли ответов 429, резкий рост доли ответов 5xx, превышение базового расхода токенов на задачу и расход определённой доли дневного бюджета.
Как проверить: перед релизом проведите тест на небольшом объёме трафика. Убедитесь, что дашборд корректно разбивает данные по параметрам, а оповещения приходят вовремя.
| Метрика | Разбивка | Описание |
|---|---|---|
Доля ответов 429 |
Ключ, модель | Различайте превышение лимита запросов и исчерпание квоты |
Доля ответов 5xx |
Модель | Определяйте перегрузку вышестоящего сервиса и запускайте переключение |
| Задержка P95 | Модель, тип задачи | Учитывайте длительные задачи отдельно, чтобы они не повышали общий базовый уровень |
| Длина очереди и время ожидания | Очередь по приоритету | Следите, не накапливаются ли задачи с низким приоритетом |
| Токенов на задачу, стоимость задачи | Тип задачи | Многошаговая работа агента и вызовы инструментов могут значительно увеличить расход |
| Число переключений и доля успешных переключений на резерв | Пары основной и резервной моделей | Проверяйте, действительно ли резервная модель справилась с трафиком |
Для учёта расходов можно использовать возможности платформы. В консоли APIYI apiyi.com доступны список моделей, данные об использовании, счета и журналы. В день релиза с их помощью удобно сверять фактические расходы по ключам и моделям, а собственные метрики по типам задач помогут связать данные о том, сколько потрачено и на что.
Для оценки необходимой мощности рассчитайте пиковый QPS по дневной активной аудитории, числу запросов и среднему расходу токенов, а затем умножьте результат на коэффициент роста нагрузки из-за многошаговой работы агентов и вызовов инструментов. В день релиза пик может в 3–10 раз превышать обычный уровень. Рекомендуем зарезервировать 30–50% дополнительной мощности или подготовить резервную модель, на которую можно переключиться в любой момент. Если оценивать нагрузку только по чат-сценариям, расход из-за длинного контекста и вызовов инструментов будет сильно занижен.
Быстрый старт: как проверить переключение между моделями и резервный сценарий
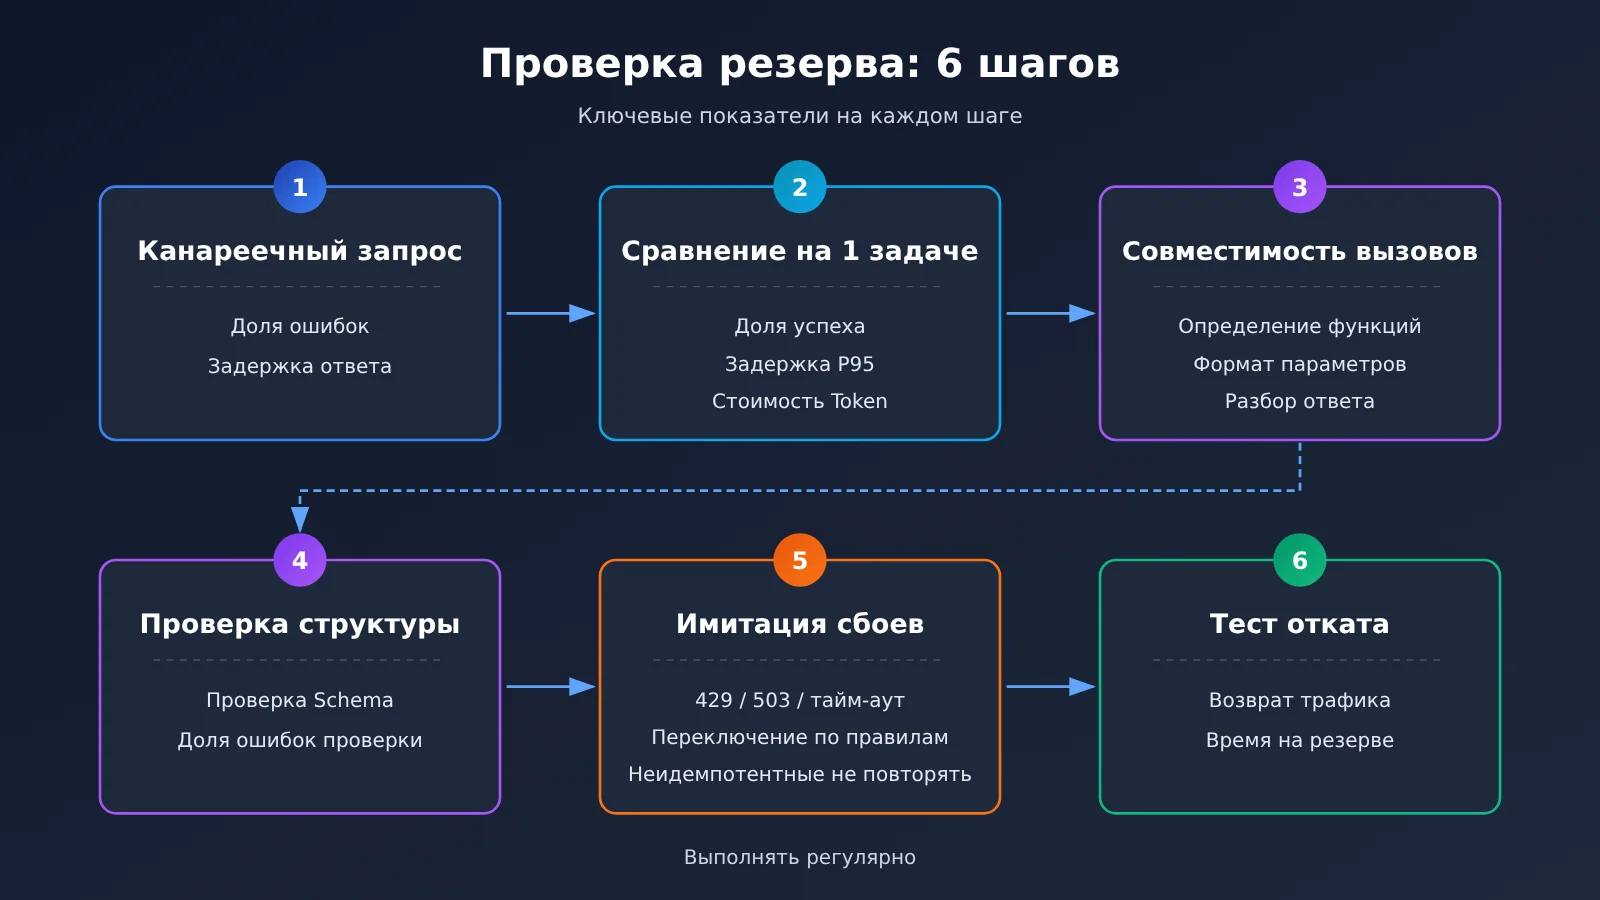
Главное: если резервный сценарий не проверен на практике, считайте, что его нет. Проверку нужно завершить до релиза.
Изменения на уровне интеграции несложны. Если вы уже используете SDK, совместимый с OpenAI, достаточно указать в base_url адрес https://api.apiyi.com/v1, а в api_key — ключ платформы. После этого можно переключаться между основной и резервной моделями через параметр model, не добавляя новый клиент. Основное время стоит потратить на проверку. Рекомендуем такой порядок:
- Канареечные запросы: направьте на резервную модель небольшую часть реального трафика и проследите за частотой ошибок и задержкой.
- Сравнение на одинаковых задачах: запустите основной и резервной модели один и тот же фиксированный набор тестов. Сравните долю успешных проверок, задержку P95 и стоимость токенов.
- Совместимость вызовов инструментов: проверьте для каждой функции, корректно ли резервная модель работает с её определением и форматом аргументов, а также правильно ли разбираются ответы.
- Проверка структурированного вывода: проверьте JSON-ответы по схеме и зафиксируйте долю ошибок валидации.
- Тестирование с имитацией сбоев: искусственно вызовите ошибки
429,503и тайм-ауты. Убедитесь, что переключение срабатывает по заданным правилам, а неидемпотентные запросы не повторяются автоматически. - Проверка обратного переключения: после восстановления основной модели убедитесь, что трафик возвращается на неё в соответствии с настройками и не задерживается надолго на резервной.
Резервный сценарий лучше проверять регулярно, а не только один раз перед релизом. Поставщики обновляют модели, ваши промпты и определения инструментов тоже меняются, поэтому настройки переключения, проверенные три месяца назад, сегодня могут уже не работать.
🚀 Быстрый старт: зарегистрируйтесь на APIYI apiyi.com и получите бесплатные средства для тестирования. С одним и тем же ключом проверьте основную и резервную модели на одинаковых задачах, а затем настройте переключение между ними для релиза. Актуальные цены и доступность моделей смотрите в консоли и документации.
Частые вопросы FAQ
Главное: в день выпуска новой модели большинство вопросов сводится к одному — сначала определите характер ошибки, а затем решите, переключиться, поставить задачу в очередь или остановиться.
Q1: Стоит ли заранее ограничивать частоту запросов на стороне приложения в день выпуска новой модели?
Да, стоит. Заранее настроить максимальное число параллельных запросов и очередь с приоритетами проще, чем полагаться на ограничение со стороны поставщика, которое проявится ошибкой `429`. Вы сами решаете, какие пользователи и задачи важнее, тогда как ограничения поставщика не учитывают приоритеты вашего бизнеса. Порог можно рассчитать на основе обычной пиковой нагрузки с поправкой на её ожидаемый рост.
Q2: Нужно ли сразу переключаться на другую модель при ошибке 429?
Не обязательно. Сначала проверьте `Retry-After`: если время ожидания приемлемо для задачи, дождитесь его окончания и повторите запрос. Если оно превышает допустимый порог или ответ прямо указывает на исчерпание квоты, переключитесь на резервную модель. При вызове моделей разных поставщиков через APIYI apiyi.com с одним API-ключом для переключения достаточно изменить имя модели. Поэтому пороги можно настроить точнее и не переводить все запросы на резервную модель при первом же `429`.
Q3: Как организовать очередь для несрочных задач?
Выделите для них отдельную очередь и пул параллельных запросов, а также установите максимальное время ожидания. По его истечении не отбрасывайте задачу, а перенесите её выполнение на ночь или на период низкой нагрузки. Следите за длиной очереди, временем ожидания и долей отменённых задач. Неудачные задачи можно запускать повторно, но для неидемпотентных задач сначала обязательно проверьте статус.
Q4: Может ли автоматическое переключение на резервную модель снизить качество ответов?
Да, поэтому перед таким переключением обязательно сравните модели на одинаковых заданиях и убедитесь, что разница в качестве приемлема для бизнеса. Согласно официальному описанию, APIYI apiyi.com поддерживает автоматическое переключение на резервную модель и балансировку нагрузки, но правила переключения следует уточнять в официальной документации. Разницу в результатах после переключения нужно проверить на собственном наборе тестов. Если качество задачи критично, лучше подождать в очереди основной модели, чем сразу переходить на резервную.
Q5: Как понять, что произошло: исчерпана квота продукта или сработало ограничение API?
Смотрите на источник и уровень ограничения. Квота продукта действует в приложении для конечных пользователей — например, квота Hy4 в WorkBuddy рассчитывается на аккаунт и обычно отображается уведомлением в интерфейсе. Ограничение API проявляется в ответе интерфейса как ошибка `429`, которая может сопровождаться `Retry-After`, и рассчитывается на API-ключ, организацию или модель. В первом случае можно переключить модель внутри продукта или дождаться восстановления квоты; во втором помогут увеличение интервала между повторами, очередь и переключение на резервную модель.
Переключение между моделями и планирование нагрузки: главное
Вывод: стабильность в день релиза зависит от заранее подготовленной системы уровней, очередей и бюджета.
- Дефицит мощностей предсказуем: в день выхода новой модели лимиты могут быстро исчерпаться — это нужно учитывать заранее.
- Ошибки нужно классифицировать: для
402,429,5xxи тайм-аутов нужны отдельные сценарии обработки, нельзя повторять все запросы одинаково. - Сначала распределение по уровням, потом переключение: распределите задачи между флагманскими, универсальными и лёгкими моделями. Новую модель сначала подключайте к части трафика.
- Резервные модели нужно проверять: сопоставьте их возможности, контекстное окно, вызов инструментов, структурированный вывод, цены и доступность по регионам.
- Не повторяйте неидемпотентные запросы сразу: после сбоя сначала проверьте состояние и только потом решайте, отправлять ли запрос повторно.
- Переносите нагрузку на непиковые часы: задачи, которые могут подождать, выполняйте ночью, а дневной лимит параллельных запросов оставьте для срочных задач.
- Разбивайте мониторинг по параметрам: сверяйте фактическое потребление по API-ключам и моделям с помощью журналов использования APIYI apiyi.com.
Итоги и чек-лист нагрузки в день релиза
Главный вывод: в день релиза важны не повторные попытки, а заранее продуманные маршрутизация и очереди.
Новая модель может столкнуться с ограничениями сразу после запуска: накладываются друг на друга бесплатные квоты, наплыв запросов, длительные задачи и задержки с расширением мощностей у провайдера. На стороне приложения можно распределить модели по уровням, чтобы выбрать маршруты по умолчанию, подготовить резервные модели, защитить критичные задачи очередями с приоритетами и сгладить пики, перенеся часть нагрузки на другое время. Мониторинг и бюджет помогут держать риски и расходы под контролем. Чек-лист ниже разделён на действия до релиза и в день релиза — его можно использовать при проверке готовности к запуску.
| Этап | Проверка | Критерий готовности |
|---|---|---|
| До релиза | Проверка основной и резервной моделей | Обе модели прошли сравнение на одинаковых задачах, проверку вызова инструментов и структурированного вывода |
| До релиза | Разные коды ошибок | Для 402, 429, 500, 503, 529 и тайм-аутов предусмотрены отдельные сценарии обработки |
| До релиза | Запрет повторов для неидемпотентных операций | Автоматический повтор операций записи и вызовов платных инструментов запрещён; после ошибки сначала проверяется статус |
| До релиза | Очередь с приоритетами | Настроены три уровня приоритета, максимальная параллельность, максимальное время ожидания в очереди и переход на упрощённый режим при тайм-ауте |
| До релиза | Список отложенных задач | Составлен список пакетных задач, которые можно перенести на ночь, и настроены правила их запуска в зависимости от нагрузки |
| До релиза | Тестирование | Проведены тесты с имитацией сбоев, переключением и откатом; результаты записаны |
| День релиза | Мониторинг | Отслеживаются доли ошибок 429 и 5xx, задержка P95 и длина очереди в разрезе ключей, моделей и задач |
| День релиза | Бюджет | Установлены временный бюджет и оповещения; пороги повышены, но верхний предел сохранён |
| День релиза | Контроль переключений | Отслеживаются количество переключений и доля успешных переходов на резервную модель; после восстановления основной модели выполняется плановое обратное переключение |
| День релиза | Уведомление бизнес-команд | Заинтересованные команды заранее предупреждены о возможных задержках и ограничениях функциональности |
Если вы готовитесь к следующему релизу модели, рекомендуем через APIYI apiyi.com проверить работу основной и резервной моделей с одним API-ключом, затем настроить бюджет на основе логов использования в консоли и выполнить все пункты этого чек-листа.
📚 Справочные материалы
Вывод: эти материалы помогут проверить способы подключения моделей и возможности платформ. Актуальные параметры уточняйте в официальной документации.
- Центр документации APIYI: список моделей, описание интерфейсов, данные об использовании и счетах
- Ссылка:
docs.apiyi.com -
Описание: доступные модели, использование OpenAI-совместимого интерфейса и автоматическое переключение на резервную модель
-
Коды ошибок OpenAI API: значение ошибок ограничения частоты запросов, таких как
429, и рекомендации по их обработке - Ссылка:
platform.openai.com/docs/guides/error-codes -
Описание: чем ограничение частоты запросов отличается от исчерпания квоты
-
Ошибки Anthropic API: в том числе обработка ошибок перегрузки
- Ссылка:
docs.anthropic.com/en/api/errors - Описание: что означает ошибка перегрузки
529
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через главную страницу сайта APIYI. Дополнительные материалы по подключению доступны в центре документации docs.apiyi.com.