Примечание автора: в статье показано, как переключать большие языковые модели с помощью одного API-ключа и OpenAI-совместимой точки входа, а также подробно разобрано, какие поля, статусы и критерии приёмки требуют отдельной адаптации при кросс-модельной интеграции изображений и Embedding.
В этой статье мы с помощью одного API-ключа и одной OpenAI-совместимой точки входа настроим и проверим переключение чисто текстовых моделей, а затем на двух примерах — с изображениями и с векторами — покажем, какие поля, статусы и критерии приёмки в кросс-модельной интеграции нужно адаптировать отдельно. Но у вывода есть оговорка: если на одном и том же эндпоинте используются только общие параметры, которые поддерживают обе модели, для переключения обычно достаточно изменить поле model. Стоит затронуть проприетарные параметры рассуждений (thinking), вызовы инструментов, размеры изображений или размерность векторов — и всё придётся сверять отдельно для каждой модели.
Это не рекламная статья в духе «поменяйте одну строчку кода — и всё заработает». Мы чётко разграничим части единого интерфейса APIYI, которые можно переиспользовать, и то, что обязательно придётся проверять заново, а заодно разберём и сценарии, в которых переключение сбоит.
Ключевая ценность: дочитав статью, вы сможете переключать текстовые модели с той же аутентификацией и тем же кодом, будете знать, какие параметры менять при смене модели для изображений и Embedding, и получите практическую методику приёмки переключений, которую можно применить сразу.
9 терминов, которые нужно понять перед переключением больших языковых моделей через единый интерфейс APIYI
Большинство проблем при переключении моделей возникает из-за того, что люди по-разному понимают одни и те же термины. Например, пишут Base URL так, что /v1 оказывается в нём дважды, или считают, что векторы одинаковой размерности можно свободно смешивать. Сначала договоримся о понятиях ниже — все дальнейшие шаги опираются именно на эти определения.
| Термин | Что это значит на практике | На что обратить внимание при переключении |
|---|---|---|
| Base URL | Корневой адрес, к которому SDK добавляет путь к API | В OpenAI SDK указывайте адрес вплоть до /v1, избегайте дублирования |
| API-ключ | Учётные данные для аутентификации API-запросов | Храните только в серверной конфигурации или переменных окружения |
| ID модели | Модель, указанная в запросе; может содержать версию или канал | Копируйте оригинальный ID из реестра моделей, не набирайте вручную |
| Группировка токенов | Определяет, какие модели и каналы доступны текущему ключу и на каких условиях идёт тарификация | Если модель не входит в группу, API вернёт 401/403 или 404 |
| Chat Completions | Протокол интерфейса для текстовых диалогов на основе массива сообщений | Основная точка входа при переключении в чисто текстовых задачах |
| Responses | Протокол интерфейса с поддержкой разных типов вывода и вызовов инструментов | Вызовы инструментов в GPT-6.2 идут через него |
| Embedding | Кодирование контента в вектор фиксированной размерности — для поиска и других задач на сходство | Сменили модель — сменилось векторное пространство |
| Векторный индекс | Структура для поиска похожих элементов в заданной размерности и векторном пространстве | При изменении размерности или модели его нужно перестраивать |
| Задержка до первого видимого токена | Время ожидания от отправки запроса до момента, когда пользователь видит первый осмысленный фрагмент сгенерированного контента | «Размышления» reasoning-моделей удлиняют этот показатель |
Самый недооценённый пункт в этой таблице — «группировка токенов». В рамках одного аккаунта ключи из разных групп могут видеть разные списки моделей. Поэтому, разбираясь с ошибкой «модель не найдена», сначала проверьте, к какой группе привязан ваш ключ, и лишь потом подозревайте код.
Ключевые моменты переключения больших языковых моделей через единый интерфейс APIYI
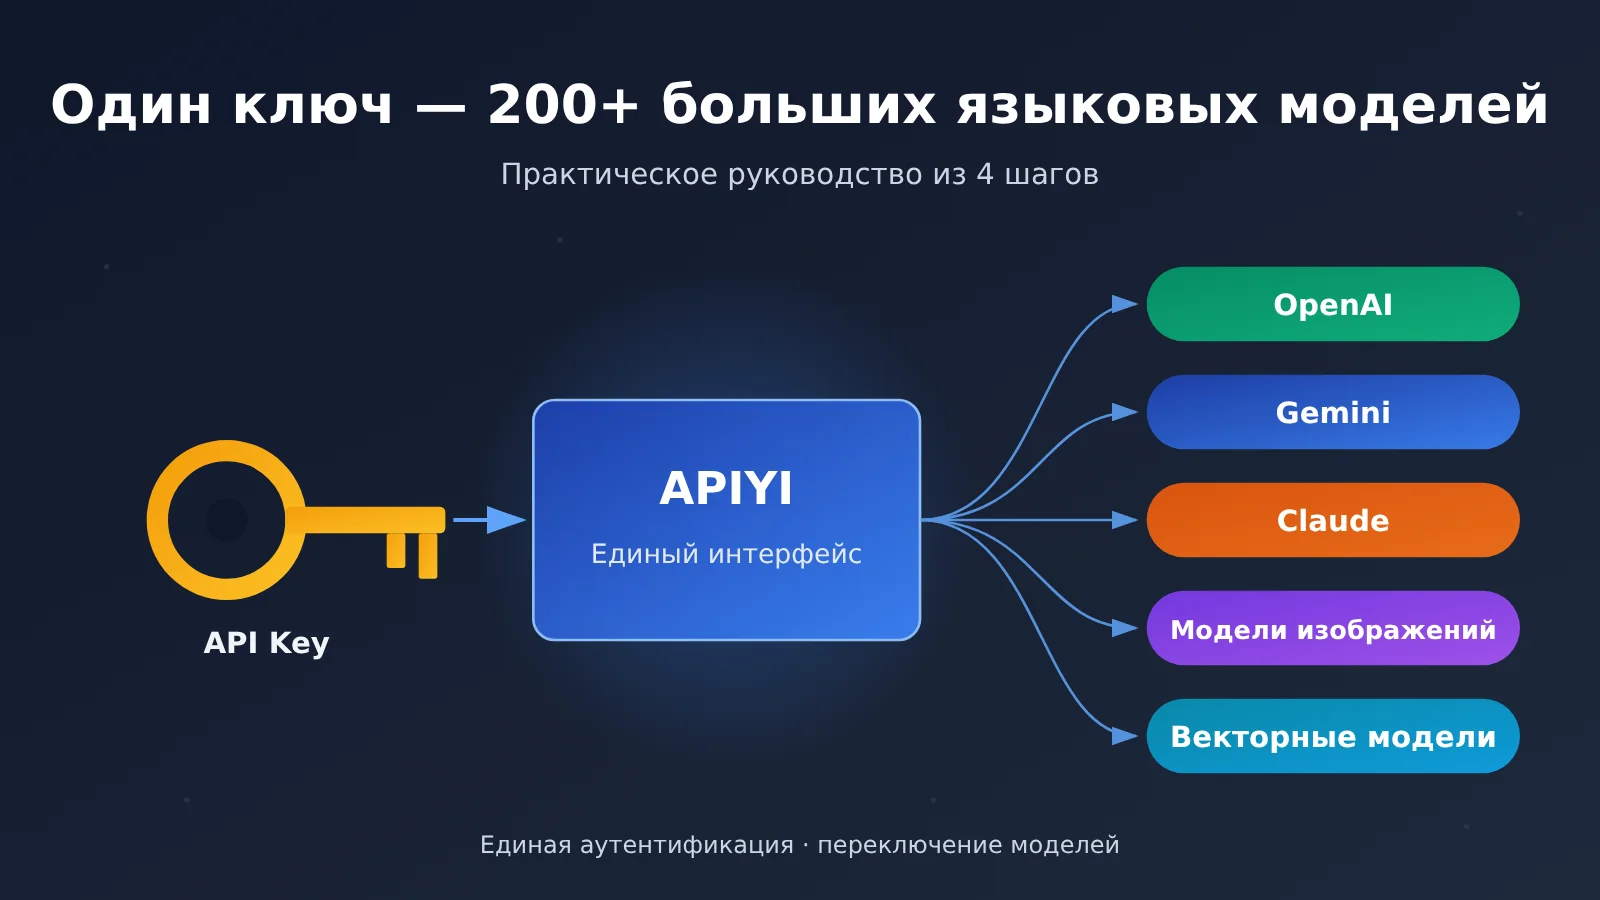
Единое подключение экономит прежде всего на «рутинной работе»: не нужно регистрировать отдельный аккаунт у каждого вендора, управлять несколькими наборами ключей и подстраиваться под разные SDK. Согласно базовому описанию и документации быстрого старта APIYI (apiyi.com), одной конфигурации аутентификации и одного входа, совместимого с OpenAI, достаточно, чтобы получить доступ к доступным моделям разных вендоров.
| Уровень | Можно переиспользовать | Нужно проверять для каждой модели |
|---|---|---|
| Аутентификация | Тот же API-ключ, те же заголовки запросов | Входит ли целевая модель в токен-группу ключа |
| Точка входа | Тот же Base URL | Какие эндпоинты поддерживает целевая модель (чат / Responses / изображения / эмбеддинги) |
| Тело запроса | Общие поля вроде model, базовых messages, input |
Уровни размышления (thinking), инструменты, структурированный вывод, размеры изображений, размерность эмбеддингов |
| Обработка ответа | Логика разбора choices, finish_reason, usage |
Особые ответы: пустое тело, только вызовы инструментов, фильтрация по безопасности и т.п. |
| Биллинг | Единый баланс и счёт одного аккаунта | У каждой модели своя цена за единицу, тарифные ступени и способ тарификации кэша |
200+ и 289: две системы подсчёта моделей в APIYI
В публичном описании APIYI фигурирует 200+ отобранных моделей. А в публичном реестре моделей, сформированном 2026-11-20, поле model_count равно 289. Противоречия здесь нет: подсчёт в реестре включает разные версии одной модели и разные варианты маршрутов, поэтому записей получается больше, чем «отобранных моделей».
Важно учитывать: фактический список моделей, доступных одному токену, ограничен сразу тремя условиями — группой, авторизацией модели и эндпоинтом. Наличие ID в реестре ещё не значит, что ваш ключ сможет его вызвать.
Порядок проверки перед переключением
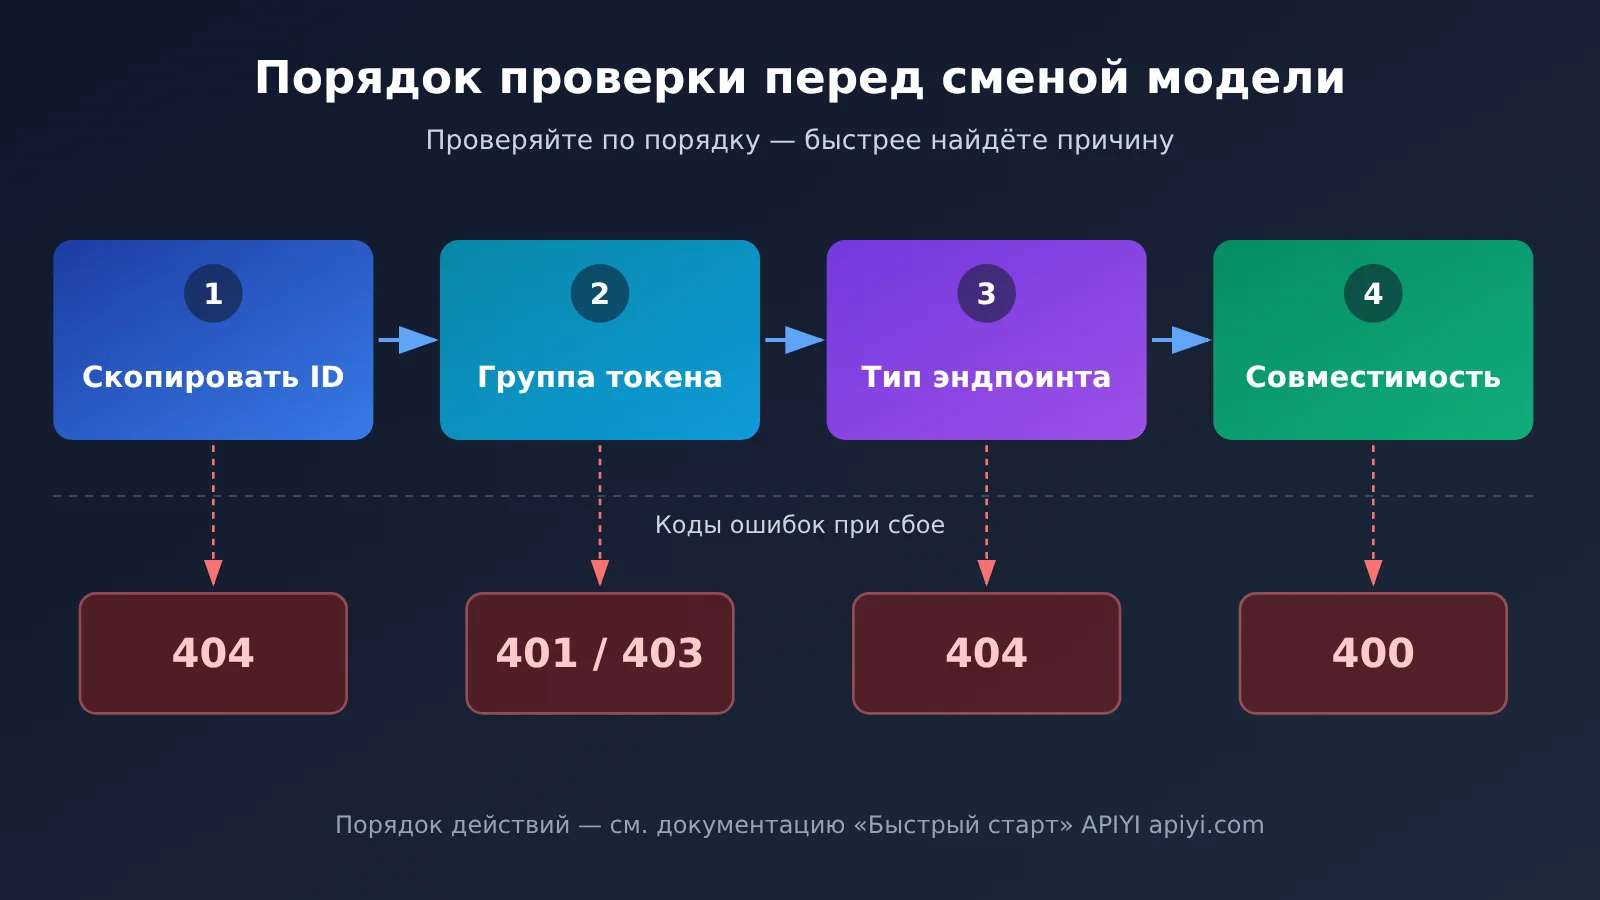
Советуем при каждом добавлении новой модели проходить проверку в фиксированном порядке — тогда после ошибки не придётся искать причину сразу в нескольких направлениях:
- Сверьте ID модели: скопируйте исходный ID из актуального реестра моделей и убедитесь, что регистр букв и дефисы совпадают один в один.
- Сверьте токен-группу: убедитесь, что группа, к которой привязан текущий ключ, открывает доступ к этой модели — некоторые модели появляются только в определённых группах.
- Сверьте эндпоинт: убедитесь, что модель поддерживает нужный вам тип интерфейса — эндпоинты для текста, изображений и эмбеддингов различаются.
- Сверьте параметры: оставьте только общие параметры, которые поддерживают обе модели, а специфичные добавляйте обратно по одному для проверки.
Как быстро переключать большие языковые модели через единый интерфейс APIYI
Возьмём в качестве примера две текстовые модели, доступные через Chat Completions: gemini-4-neon и gpt-6.2-sol. Обе используют POST /v1/chat/completions, поэтому, если вы работаете только с базовым полем messages, для переключения достаточно заменить значение model. Единственное условие — обе модели должны быть видны в группе вашего ключа, так что перед вызовом сверьтесь с реестром моделей.
Минимальный пример: переключаем две модели одним и тем же кодом
Укажите Base URL https://api.apiyi.com/v1, а API-ключ возьмите из переменной окружения:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],     # ключ храним только в переменных окружения на сервере
    base_url="https://api.apiyi.com/v1",     # OpenAI-совместимая точка входа APIYI
)

for model in ["gemini-4-neon", "gpt-6.2-sol"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是向量索引"}],
    )
    choice = resp.choices[0]
    print(model, "| finish_reason:", choice.finish_reason, "| usage:", resp.usage)
    print(choice.message.content or "<空正文>")
Проверяйте поля ответа, не ограничивайтесь HTTP 200
Получив ответ, проверьте как минимум три места: пустой ли choices[0].message.content; чем завершилась генерация в finish_reason — stop или обрезка из-за лимита длины; насколько адекватен расход токенов в usage. У reasoning-моделей процесс размышлений тоже расходует бюджет вывода, поэтому при слишком маленьком бюджете возможна ситуация «HTTP 200, но тело ответа пустое».
И ещё один момент: имя, которым модель представляется в тексте ответа, нельзя считать подтверждением того, какая модель реально работает на бэкенде. Если нужно убедиться, какая модель была вызвана на самом деле, в первую очередь смотрите ID запроса, метаданные ответа и логи биллинга.
Посмотреть полный код реализации: задержка первого токена в стриминге, повторы с экспоненциальной задержкой и запись метрик
import os
import time
import random
from openai import OpenAI, RateLimitError, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",   # Единый интерфейс APIYI
)

def call_once(model: str, prompt: str, max_retries: int = 3) -> dict:
    """Один стриминговый вызов: фиксирует задержку первого видимого токена, общее время выполнения и причину завершения"""
    for attempt in range(max_retries + 1):
        start = time.perf_counter()
        first_token_at = None
        parts, finish_reason, usage = [], None, None
        try:
            stream = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
                stream=True,
                stream_options={"include_usage": True},
            )
            for chunk in stream:
                if chunk.usage:
                    usage = chunk.usage
                if not chunk.choices:
                    continue
                delta = chunk.choices[0].delta
                if delta and delta.content:
                    if first_token_at is None:
                        first_token_at = time.perf_counter()
                    parts.append(delta.content)
                if chunk.choices[0].finish_reason:
                    finish_reason = chunk.choices[0].finish_reason
            end = time.perf_counter()
            return {
                "model": model,
                "ok": bool(parts),
                "ttft_s": round(first_token_at - start, 3) if first_token_at else None,
                "total_s": round(end - start, 3),
                "finish_reason": finish_reason,
                "usage": usage,
                "text": "".join(parts),
            }
        except RateLimitError:
            # Ограниченное число повторов с экспоненциальной задержкой и джиттером — только для краткосрочных rate limit'ов
            if attempt == max_retries:
                raise
            time.sleep((2 ** attempt) + random.uniform(0, 0.5))
        except APIStatusError as e:
            # 400/401/403/404 — это проблемы конфигурации или параметров, повторять бессмысленно
            return {"model": model, "ok": False, "status": e.status_code,
                    "error": str(e)[:300]}

if __name__ == "__main__":
    prompt = "用三句话说明向量索引为什么要和 Embedding 模型绑定"
    for m in ["gemini-4-neon", "gpt-6.2-sol"]:
        r = call_once(m, prompt)
        print({k: v for k, v in r.items() if k != "text"})
🚀 Быстрый старт: советуем сначала прогнать приведённый выше минимальный пример на APIYI (apiyi.com) с бесплатным тестовым лимитом для новых пользователей — убедитесь, что оба ID моделей возвращают текст ответа в рамках группы вашего токена, и только после этого подключайте рабочий код.
Проприетарные параметры нужно проверять отдельно
В примерах выше намеренно использовались только общие поля. Но как только в дело идут перечисленные ниже параметры, рассчитывать на то, что «достаточно поменять model», уже нельзя:
- Серия GPT-6.2: в OpenAI API модели
gpt-6.2-astraиgpt-6.2-solподдерживают одновременно и Chat Completions, и Responses. Поле уровня рассуждений в Chat Completions называетсяreasoning_effort, а в Responses —reasoning.effort; при этом обе модели отклоняют значениеnone. Если нужны вызовы инструментов, придётся переходить на Responses. - Серия Gemini 4:
gemini-4-neonработает и с нативной схемой Gemini от APIYI, и с OpenAI-совместимыми диалогами. В нативном REST запрос идёт на/v1beta/models/{id}:generateContent, а уровень рассуждений задаётся вgenerationConfig.thinkingConfig.thinkingLevel— на выборlow,medium,highиxhigh, по умолчаниюhigh. Старые параметрыthinkingBudgetи значениеminimalв Gemini 4 не работают; в документации Google также отмечено, что Gemini 4 игнорируетtemperatureиtopP. - Структурированный вывод и инструменты: ограничения JSON Schema и форматы описания инструментов с двух сторон могут не совпадать, поэтому каждый пункт нужно сверять с документацией целевой модели.
Важный нюанс: в анонсе запуска Neon на APIYI сказано, что при запуске проверили только эндпоинты тарификации, а реальными вызовами ничего не тестировали. Так что поддержка двух эндпоинтов и вызовов инструментов, описанная выше, — это заявленное в документации поведение. Перед использованием в продакшене лучше самостоятельно прогнать минимальные запросы и убедиться, что всё работает как ожидается.
Единый интерфейс APIYI: переключение между возможностями — сравнение генерации изображений и Embedding
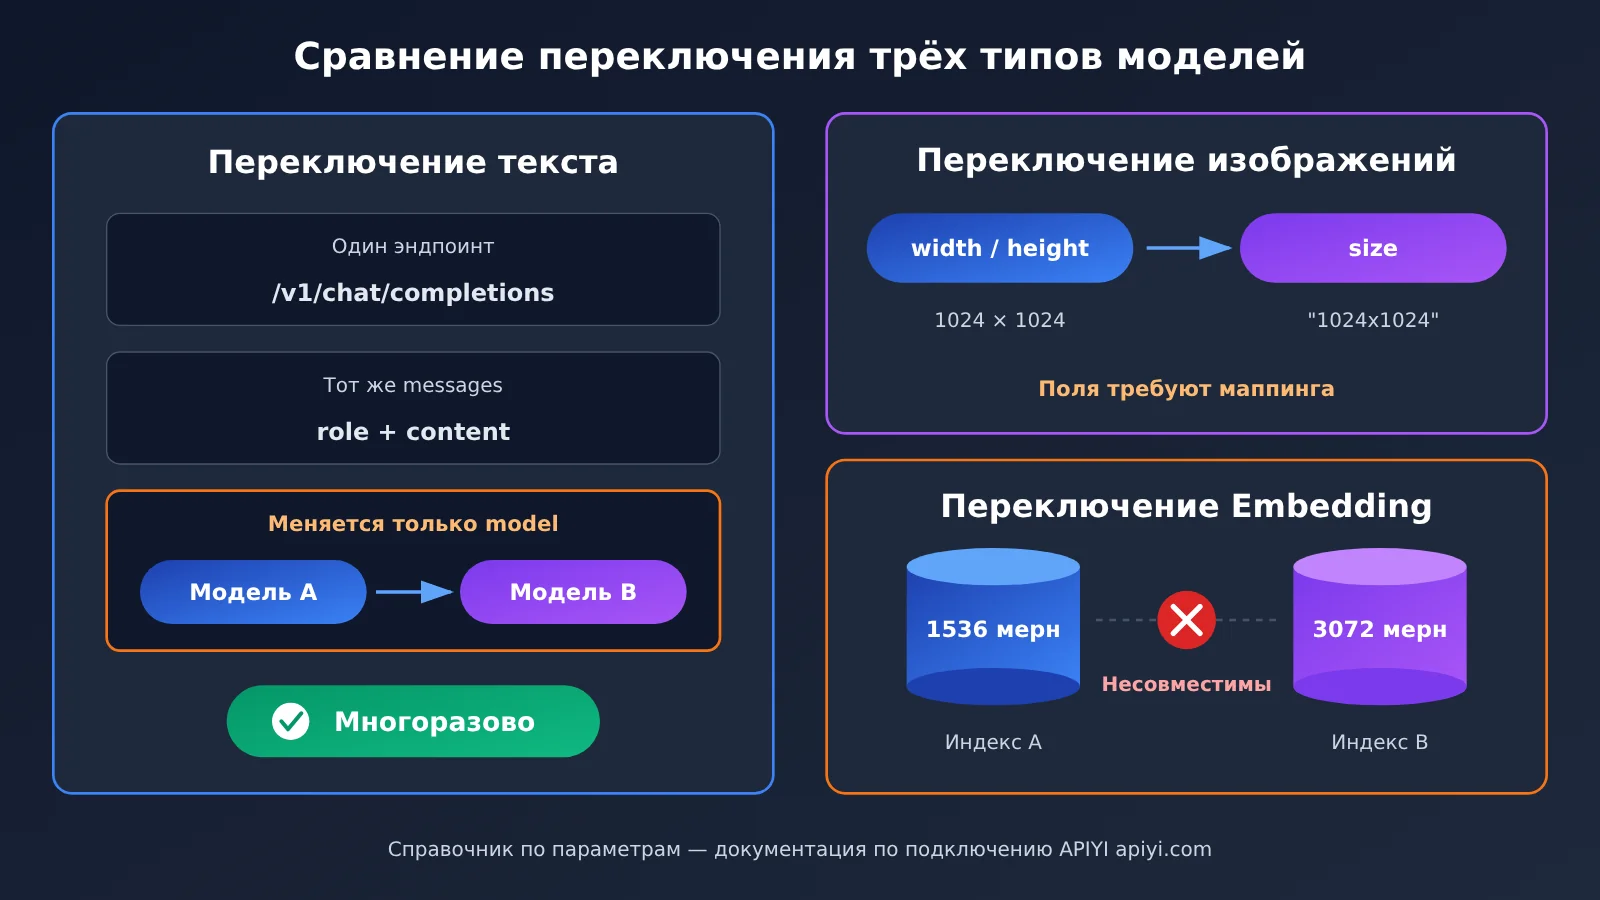
Помимо текстового диалога, самые частые сценарии, где приходится переключаться между моделями, — это генерация изображений и векторные представления (embedding), и именно здесь подход «меняем только model» чаще всего ломается. Два примера ниже соответствуют двум типам проблем: «разная структура параметров» и «разное пространство результатов».
Переключение между моделями генерации изображений: MAI-Image-2.7 и Seedream 5.5
Обе модели можно вызывать через возможность Images с одним и тем же API-ключом, но способы задания размеров, эталонных изображений и прозрачного вывода совершенно разные:
| Аспект | MAI-Image-2.7 | Seedream 5.5 |
|---|---|---|
| Эндпоинт | генерация — через generations, редактирование — через edits |
и чистый текст, и эталонные изображения — через generations |
| Параметры размера | width и height задают общее количество пикселей, заявленный максимум — 4 194 304 пикселя |
size выбирает ценовой уровень; если опустить, применяется уровень 2K |
| Эталонные изображения | при редактировании — до 5 эталонных изображений | эталонное изображение передаётся в поле image |
| Прозрачный вывод | background: "transparent", возвращается PNG с альфа-каналом |
нужно одновременно указать background: "transparent" и output_format: "png" |
| Тарификация | отдельная тарификация | отдельная тарификация по уровню size |
| Доступные платформы | APIYI apiyi.com (актуальный список смотрите в реестре моделей и группах) | APIYI (актуальный список смотрите в реестре моделей и группах) |
При вызове лучше завести для каждой модели отдельную функцию маппинга параметров, а не собирать поля прямо на уровне бизнес-логики:
# Используем client из предыдущих примеров; ID модели скопируйте из актуального реестра
def build_image_kwargs(model: str, prompt: str, transparent: bool = False) -> dict:
    if model.startswith("MAI-Image"):
        body = {"width": 1024, "height": 1024}
        if transparent:
            body["background"] = "transparent"
        return {"model": model, "prompt": prompt, "extra_body": body}
    # Seedream 5.5: параметр size определяет ценовой уровень; допустимые значения смотрите в документации по подключению
    body = {"size": "2K"}
    if transparent:
        body.update({"background": "transparent", "output_format": "png"})
    return {"model": model, "prompt": prompt, "extra_body": body}

img = client.images.generate(**build_image_kwargs("MAI-Image-2.7", "扁平风格的钥匙图标", True))
Прозрачный вывод, работу с эталонными изображениями, формат ответа и стоимость нужно проверять для каждой модели отдельно — результат приёмочного тестирования одной модели нельзя засчитывать за другую.
Переключение Embedding-моделей: small и large нельзя смешивать напрямую
Сама форма вызова для векторизации действительно единая: всё идёт через POST /v1/embeddings, достаточно передать model и input.
for m in ["text-embedding-3-small", "text-embedding-3-large"]:
    e = client.embeddings.create(model=m, input=["统一接口切换模型"])
    print(m, "维度:", len(e.data[0].embedding))   # по умолчанию 1536 и 3072 соответственно
Проблема — в самих результатах. У text-embedding-3-small по умолчанию 1536 измерений, у text-embedding-3-large — 3072, а векторы разной размерности не поместить в один индекс. Даже если параметром dimensions ужать large до 1536 измерений, векторные пространства двух моделей всё равно не пересекаются: сходство между векторами старых документов и векторами новых запросов попросту не имеет смысла.
Поэтому правильная последовательность действий при смене Embedding-модели такая: создать новый векторный индекс, заново векторизовать все старые документы, синхронно переключить модель на стороне запросов, а затем повторно откалибровать порог сходства на наборе размеченных примеров. Эти затраты куда больше, чем правка одной строки model, — учитывать их стоит уже на этапе выбора модели.
Как провести приёмку переключения моделей через единый интерфейс APIYI
Прежде чем переводить переключение в продакшен, нужно поднять планку с «запросы проходят» до «результат можно принять». Приёмка состоит из двух частей: диагностика кодов ошибок и сверка метрик.
Таблица для диагностики кодов ошибок
Прежде всего зафиксируйте минимальный запрос и стабильно воспроизводите его с одним и тем же Key, на одном узле, через один эндпоинт и с одним и тем же ID модели:
| Симптом | Частая причина | Проверка и исправление |
|---|---|---|
| 400 | Несовместимые поля старой модели, параметры инструментов, структурированный вывод или формат изображений | Уберите необязательные поля, затем добавляйте их обратно по одному, чтобы найти виновника |
| 401/403 | Неверный формат токена, в группе нет этой модели, модель не в белом списке | Сверьте Key, группу токена и белый список моделей |
| 404 | SDK повторно добавляет /v1 в адрес, либо модель не относится к этому типу интерфейса |
У OpenAI SDK Base URL должен содержать /v1; Google GenAI SDK использует корневой адрес без /v1 и конфигурацию v1beta; скопируйте оригинальный ID модели |
| 429 | Краткосрочный рейт-лимит, превышение лимита параллелизма или нехватка квоты | Сначала прочитайте тело ошибки; при краткосрочном лимите используйте ограниченное число повторов с экспоненциальной задержкой и джиттером, при проблемах с квотой сначала исправьте её, потом отправляйте повторно |
| 200, но пустое тело ответа | Бюджет вывода целиком ушёл на размышления, сработал защитный фильтр или вернулись только вызовы инструментов | Проверьте причину завершения и тип ответа, увеличьте бюджет вывода; для сравнения отправьте минимальный запрос без инструментов |
В многошаговых сценариях с инструментами у Gemini 4 дополнительно проверьте, что thoughtSignature из ответа передаётся обратно в неизменном виде, а вызовы инструментов и их результаты соответствуют друг другу один к одному.
Записываем метрики: отличаем различия моделей от накладных расходов канала
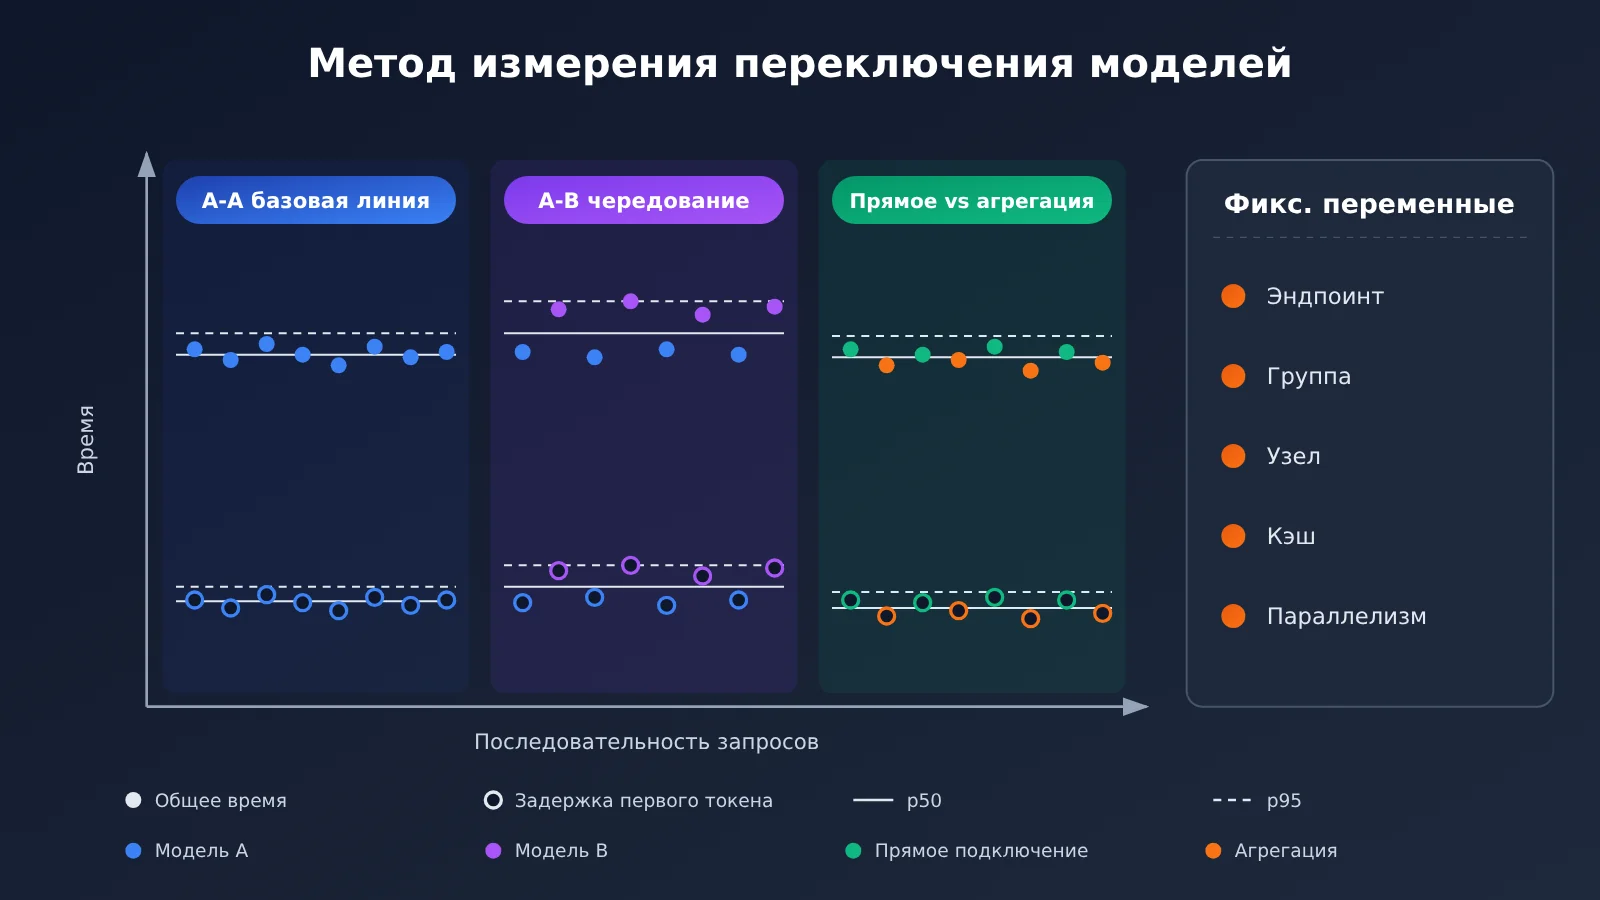
В открытых источниках пока нет сгруппированных данных, которые позволяли бы при одинаковом ключе, в той же группе и регионе, с теми же входными данными и нагрузкой изолировать по отдельности потери, вносимые «сменой модели» или «проксированием через шлюз». Сторонние бенчмарки умеют сравнивать разные модели или разных поставщиков, но разницу между ними нельзя напрямую относить на счёт того, что вы сменили модель на APIYI. Поэтому вместо цитирования чужих цифр проще померить самому — по методике ниже:
| Метрика | Как фиксировать | Зачем |
|---|---|---|
| Причина завершения | Считайте распределение finish_reason по всем запросам |
Заметить обрезку, фильтрацию, прерывание вызова инструментов |
| Задержка до первого видимого токена | Время до первого непустого фрагмента контента в стриминговом запросе | Оценивает, как долго ждёт пользователь |
| Общее время p50/p95 | Перцентили времени каждого полного запроса | Оценивает стабильность и длинный хвост |
| Доля сбоев | Подсчёт с разбивкой по кодам ошибок | Отделяет ошибки конфигурации от временных сбоев |
| Фактические токены и списания | Сверяйте поле usage со счётом по каждой записи |
Считает реальную стоимость |
| Доля прохождения бизнес-приёмки | Оценка фиксированной выборки вручную или по правилам | Показывает, соответствует ли качество требованиям |
Порядок измерений лучше выстроить так: сначала зафиксируйте эндпоинт, группу, узел и параметры запросов; повторными запросами A-A к одной и той же модели постройте базовую линию; затем чередуйте A-B, меняя за раз только модель; если нужно оценить накладные расходы канала, отдельно сравните для одной и той же модели прямое подключение с агрегированным каналом. Параллельно контролируйте состояние кэша (холодный/тёплый), лимит вывода и число параллельных запросов — иначе скорость модели, промахи кэша и накладные расходы канала перемешаются, и разобрать их по отдельности не получится.
Дополнительные риски для stateful-сценариев с инструментами
Если вы используете Responses для многошаговых вызовов инструментов, смена модели в середине сессии добавляет ещё и проблемы с состоянием. В документации OpenAI по миграции на GPT-6.2 прямо сказано: переключение посреди сессии на некоторые модели (включая даунгрейд) может привести к удалению прежних reasoning-элементов, и при восстановлении контекста модели, возможно, придётся рассуждать заново. Это значит, что нельзя гарантировать «отсутствие потерь состояния» после переключения, а изменение стоимости не поддаётся какому-то фиксированному коэффициенту.
При приёмке таких сценариев проверяйте, сможет ли новая модель корректно переиспользовать элементы истории и контекст, а кейс «смена модели посреди одной сессии» вынесите в отдельный тест-кейс.
Часто задаваемые вопросы (FAQ)
Q1: Что такое единый интерфейс APIYI?
Это OpenAI-совместимая точка входа в API: с одним API-ключом и одним и тем же Base URL можно вызывать модели разных вендоров — OpenAI, Claude, Gemini и других. Не нужно заводить отдельные аккаунты и хранить ключи для каждого вендора: при смене модели в основном меняется поле `model` в запросе, а специфичные для модели параметры проверяются отдельно.
Q2: Чем переключение моделей через единый интерфейс отличается от интеграции с официальными SDK каждого вендора?
Официальные SDK полнее всего покрывают специфичные возможности, но при работе с несколькими вендорами придётся поддерживать несколько наборов авторизации, SDK и биллинговых аккаунтов. Единый интерфейс объединяет авторизацию, точку входа и биллинг в один набор, поэтому в сценариях с общими параметрами стоимость переключения минимальна. Плата за это — необходимость отдельно проверять совместимость специфичных параметров: например, маппинг нативного поля размышлений (thinking) Gemini в совместимом интерфейсе требует отдельной приёмки.
Q3: Когда модели, упомянутые в статье, станут доступны в APIYI?
По данным архива обновлений APIYI в реальном времени: GPT-6.2 Astra и Sol вышли 18 ноября 2026 года и открыты в трёх группах; Gemini 4 Neon был анонсирован Google 18 ноября, а APIYI подключила его 20 ноября в группах `default` и `svip`; Seedream 5.5 вышел 13 ноября. Список моделей меняется довольно быстро, поэтому ориентируйтесь на реестр актуального дня.
Q4: В каких сценариях единый интерфейс для переключения моделей наиболее удобен?
— **A/B-сравнение нескольких моделей**: один и тот же промпт сравнивается между разными моделями по качеству и стоимости.
— **Фолбэк при сбоях**: если у какой-то модели или линии закончились ресурсы, переключаетесь на запасную модель.
— **Разделение задач по сложности**: простые вопросы — экономичной модели, сложные рассуждения — флагманской.
— **Генерация изображений в разных стилях**: выбор между несколькими моделями генерации изображений под задачу, с учётом маппинга параметров.
Q5: Как быстрее всего начать вызывать несколько моделей через единый интерфейс?
1. Зайдите на APIYI (apiyi.com) и зарегистрируйте аккаунт — новым пользователям доступен бесплатный тестовый лимит.
2. Создайте API-ключ и убедитесь, что группа вашего токена включает нужные модели.
3. Запустите минимальный пример из статьи и проверьте его, подставив поле `model` согласно реестру.
Постоплата по объёму позволяет сначала сравнить несколько моделей на небольшом трафике и только потом выбирать основное решение.
Q6: Каковы цена и контекст у gemini-4-neon?
Согласно реестру моделей APIYI, сформированному 20.11.2026, у `gemini-4-neon` цена за миллион токенов: вход — $3, выход — $15, чтение кэша — $0.15; в ленте обновлений APIYI указано, что цена совпадает с официальной, а фактические списания определяются по счетам вашего аккаунта. И Artificial Analysis, и анонс Google указывают контекст 1M — это общее окно, которое делят вход, размышления (thinking) и выход; в документации APIYI по запуску модели максимальный объём синхронной генерации — около 64K.
Q7: Какие известные ограничения есть у переключения через единый интерфейс?
- Проприетарные параметры не универсальны: уровни режима рассуждений, вызов инструментов и структурированный вывод нужно проверять под каждую модель отдельно.
- Векторы нельзя смешивать: при смене Embedding-модели придётся заново векторизовать данные и перестроить индекс.
- Stateful-сценарии теряют данные: если сменить модель посреди Responses, элементы рассуждений (reasoning items) могут пропасть.
- Видимость ограничена: список моделей зависит от групп токенов, авторизации и эндпоинта; если что-то не работает, загляните в документацию по кодам ошибок на APIYI (apiyi.com).
Ключевые выводы: переключение больших языковых моделей через единый интерфейс APIYI
- Смена только model — с оговорками: работает лишь при том же эндпоинте и только с общими параметрами, которые поддерживают обе модели.
- Два способа подсчёта: «200+» — это число отобранных моделей, а в реестре 289 записей с учётом версий и вариантов маршрутов.
- Проверяйте по порядку: ID модели → группа токенов → эндпоинт → параметры, исключая проблемы по одному.
- Параметры изображений нужно маппить: MAI использует
width/height, Seedream —size, а прозрачность задаётся по-разному. - Сменили embedding-модель — пересоберите всё заново: у small и large разные размерности по умолчанию, и даже при совпадающей размерности векторы не взаимозаменяемы.
- HTTP 200 не значит успех: проверяйте причину завершения, пустые тела ответов и ответы, содержащие только вызовы инструментов.
- Производительность тестируйте сами: базовая линия A-A плюс чередующиеся замеры A-B; на APIYI apiyi.com сравнение можно провести с одним и тем же ключом.
Итоги
Ключевые моменты при переключении между большими языковыми моделями через единый интерфейс APIYI:
- Переиспользуйте аутентификацию и точку входа: один API-ключ и один Base URL покрывают текст, изображения, векторные представления и другие типы возможностей.
- Различайте общие и специфичные параметры: общие переключаются напрямую, специфичные подключайте после пошаговой проверки каждого.
- Превратите переключение в проверяемую операцию: разбирайте проблемы по таблице соответствия кодов ошибок, а задержку, долю сбоев и списания фиксируйте единой методикой.
Рекомендуем сначала прогнать обе модели на самом коротком текстовом запросе, а затем постепенно расширять до бизнес-сценариев в таком порядке: «маппинг параметров для изображений» → «перестройка векторного индекса» → «сценарии с инструментами и сохранением состояния». Советуем сперва выполнить все эти проверки через APIYI (apiyi.com) на бесплатном тестовом лимите — и только потом выбирать основную модель и запасной вариант.
📚 Полезные материалы
-
Центр документации APIYI: базовое описание, быстрый старт, реестр моделей, векторизация текста, пояснения по версиям моделей
- Ссылка:
docs.apiyi.com - Примечание: первоисточник по ID моделей, группам, эндпоинтам и тарифам; реестр берите в версии, сгенерированной на текущий день
- Ссылка:
-
OpenAI Using GPT-6.2: миграция на GPT-6.2 и описание параметров
- Ссылка:
developers.openai.com/api/docs/guides/latest-model - Примечание: вызов инструментов в Responses, поля уровней размышления и жизненный цикл reasoning-элементов
- Ссылка:
-
Google Gemini API: устранение неполадок и сигнатуры размышлений: диагностика проблем при вызовах Gemini 4
- Ссылка:
aistudio.google.com/docs/troubleshooting - Примечание: уровни размышления, возврат
thoughtSignatureи типичные ошибки
- Ссылка:
-
Начало работы с Gemini 4 в Google Cloud: длинный декодинг и версии API для Gemini 4
- Ссылка:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 - Примечание: какие версии API поддерживают длинный декодинг и при каких условиях возможно продолжение генерации
- Ссылка:
-
Страница сравнения моделей на Artificial Analysis: сторонние бенчмарки моделей и методики замера задержек
- Ссылка:
artificialanalysis.ai/models/comparisons/gemini-4-neon-vs-gpt-6-2-sol - Примечание: подходит для сравнения моделей между собой, но не для атрибуции накладных расходов конкретного канала
- Ссылка:
Автор: техническая команда APIYI
Технический обмен: свяжитесь с нами на главной странице сайта APIYI, дополнительные материалы по подключению — в центре документации docs.apiyi.com