Резюме: в этой статье на основе открытого отчёта независимого тестирования разбирается, как Qwen4-Max-Preview справляется с задачами — автомат с клешнёй, исправление Python-сервиса, поиск по 1 600 тикетам — и где проходят границы его возможностей по времени выполнения и по научным суждениям.
Сначала вывод: главное о навыках программирования Qwen4-Max-Preview
Открытый отчёт о тестировании показывает: Qwen4-Max-Preview умеет вести многошаговую разработку, дописывать тесты и выдавать проект, который можно перепроверить. Самый весомый аргумент — задача на исправление кода: модель сначала воспроизводит дефект, потом добавляет тесты, отправляет настоящие HTTP-запросы и проверяет целостность данных, и в итоге все 57 тестов проходят. Слабые места тоже видны невооружённым глазом: сложные задачи занимают много времени — на автомат с клешнёй ушло около 75 минут; а в научной задаче модель в объяснении результатов вычислений вышла за рамки того, что подтверждают данные. Поэтому и сложные результаты работы, и научные выводы требуют проверки разработчиком.
Дальше сначала разберём задачу с автоматом с клешнёй, потом отчёт по 12 задачам, и отдельно остановимся на двух группах проверяемых доказательств: исправление кода и поиск по тикетам. Затем на примере неотрицательного матричного разложения покажем границы рассуждений модели, обсудим эффективность в сравнении с другими инструментами на том же испытании с клешнёй и в конце перечислим типы задач, которые ей можно поручать. Это разбор открытого отчёта: мы не перезапускали проект автора, все цифры приводятся с указанием источника и условий тестирования.
To Know: 9 терминов для понимания оценки Qwen4-Max-Preview
| Термин | Объяснение |
|---|---|
| Агент (Agent) | Способ работы, при котором модель сама планирует шаги, вызывает инструменты и постепенно продвигает выполнение задачи. |
| Конечный автомат | Управление поведением программы с помощью набора состояний и правил перехода между ними — как у автомата для захвата игрушек: «перемещение — захват — подъём — расчёт». |
| Регрессионное тестирование | Повторная проверка уже существующего функционала после изменения кода, чтобы убедиться, что старое поведение не сломалось. |
| HTTP-запрос | Запрос, который клиент отправляет серверу, чтобы проверить, какие результаты возвращает интерфейс при реальной работе. |
| Проверка хеша | Вычисление контрольной суммы содержимого файла: сравнив значения до и после, можно понять, были ли изменены исходные данные или тестовый файл. |
| Пропускная способность по токенам | Количество токенов, обрабатываемых или генерируемых в единицу времени; значение зависит от инструментов, сети и условий запуска. |
| Поиск по контексту | Поиск и связывание нужной информации в большом объёме материалов, передаваемых в одном запросе. |
| Неотрицательная матричная факторизация | Алгоритм, который приближённо раскладывает неотрицательную матрицу данных на произведение двух неотрицательных факторных матриц. |
| Локально оптимальное решение | Решение, которое нельзя улучшить в пределах окрестности; чтобы определить, является ли решение локально оптимальным, нужны дополнительные математические условия или анализ. |
1. Автомат для захвата игрушек за 75 минут: сложная задача по программированию для Qwen4-Max-Preview
1.1. Что проверяет задача с автоматом для захвата игрушек
12 ноября 2026 года китайское издание «人人都是产品经理» опубликовало отчёт о практическом тестировании Qwen4-Max-Preview в Qoder. Самым сложным пунктом в нём была интерактивная система автомата для захвата игрушек. В одном проекте эта задача объединила несколько типичных сложностей программирования: механическое взаимодействие и обратную связь по усилию, раскачивание захвата на подвесном тросе, столкновения между игрушками, конечный автомат управления процессом и финальную логику подсчёта очков.
Такие задачи редко получается выполнить за одну генерацию. Физика, переключение состояний и правила подсчёта очков зависят друг от друга, поэтому модели приходится снова и снова писать код, запускать его, смотреть на результат и исправлять. Именно так проверяется агентная способность продвигаться по задаче шаг за шагом.
1.2. Время, скорость и расход по записям автора
| Показатель | Что записал автор | Условия теста и пояснения |
|---|---|---|
| Общее время | Около 75 минут | Среда Qoder, одна задача |
| Скорость вывода | Около 33 токенов/с | Наблюдалась в этой задаче |
| Расход Credits | Около 65 | Оценка автора, тарификация Token Plan |
| Качество результата | Довольно основательное | Субъективная оценка автора: в целом на уровне Kimi K3.1 |
Эти цифры относятся только к той задаче. Credits — единица учёта подписки Token Plan; на фактический расход влияют входные данные, попадания в кэш, вывод, токены размышления и вызовы инструментов. 65 Credits говорят лишь о порядке затрат на эту задачу. 33 токена/с — тоже результат наблюдения в конкретной среде.
В том же отчёте описаны ещё несколько задач. В задаче с живописью тушью, где были доступны только NumPy и PIL, модель сгенерировала более 1 000 строк кода, нарисовала около 4 019 мазков и проверила результат с помощью статистики яркости пикселей и ASCII-сканирования контуров. Обнаружив, что ласточка пересекается с чёрным пятном оконного проёма, она сама поправила координаты. Автор считает, что организация кода и самопроверка у модели довольно сильные, а вот эстетике ещё есть куда расти.
Что охватывают двенадцать реальных задач Qwen4-Max-Preview
2.1 Более полный тестовый отчёт
16 ноября издание «人人都是产品经理» опубликовало тестовый отчёт Z Finance: автор заявил, что выполнил 12 задач, а ключевые результаты выборочно проверил и перепроверил. В таблице ниже задачи сгруппированы по тому, как их описывает отчёт:
| Категория | Тестовая задача | Что в первую очередь проверяется |
|---|---|---|
| Визуальная генерация | SVG «пеликан на велосипеде» | Визуальное понимание, генерация кода |
| Финансовый анализ | Совместный анализ трёх финансовых отчётов | Понимание длинных документов, финансовая методология |
| Распознавание диаграмм | Столбчатая диаграмма выручки Apple по продуктам | Чтение диаграмм, оценка числовых значений |
| Офисная работа | Три раунда правок протокола встречи | Удержание контекста, согласованность правок |
| Обработка данных | Очистка 44 строк данных о продажах | Удаление дубликатов, преобразование единиц, формулы |
| Презентации | PPT о выходе Pingtouge на биржу | Поиск в реальном времени, генерация файлов |
| Поиск по длинному тексту | 1600 заявок в поддержку | Связи между записями, фильтрация по условиям |
| Поддержка кода | Исправление Python-сервиса заявок | Поиск дефектов, тестирование и регрессия |
| Воспроизведение исследования | Алгоритм неотрицательной матричной факторизации | Реализация алгоритма, численная проверка |
| Веб-разработка | Страница с материалами проспекта эмиссии | HTML, офлайн-поставка, интерактивность |
| Симуляция | Модель дождевого сада | Интерактивный дизайн, численные расчёты |
| Разработка игр | 3D-мини-игра на тему четырёх сезонов | 3D-сцены, управление состоянием, взаимодействие |
2.2 Пять кейсов, на которые стоит обратить внимание
Из этих 12 задач следующие пять лучше всего показывают, насколько модель умеет выдавать «работоспособный результат»:
- Анализ финансовых отчётов: на входе — годовые отчёты Apple и Costco за FY2026 и вторая версия проспекта эмиссии Anthropic, около 8 минут на выполнение. Все 6 выборочно проверенных ключевых цифр оказались верными: модель различила операционный убыток и чистое убывание, указала, как изменение справедливой стоимости конвертируемых облигаций повлияло на чистый убыток, и не стала выдумывать нераскрытые прогнозы на будущее.
- Очистка Excel: в 44 строках детализации продаж нашлись дублирующиеся записи, дубликаты, отличающиеся только пробелами, две единицы измерения — юани и десятки тысяч юаней, три формата даты и 5 отсутствующих заказов. После очистки осталось 35 строк, сумма по четырём регионам — 215 700 юаней, все 5 сводных ячеек используют настоящие формулы, и при правке детализации сводные значения обновляются автоматически.
- Генерация PPT: модель через поиск в реальном времени нашла информацию об объявлении о разделении бизнеса, сделала редактируемый PPT и развела прогноз оценки и цену размещения; после второго раунда настройки под аудиторию исходные 20 ключевых цифр, даты и названия остались неизменными. Автор также отметил, что одна продуктовая линейка была упущена.
- Поиск по заявкам и исправление Python: эти два свидетельства самые конкретные, о них подробнее в разделах 4 и 3 соответственно.
Общее у всех этих задач одно: результат можно проверить — связываются ли формулы, совпадают ли цифры с оригиналом, проходят ли тесты. Такие свидетельства убедительнее, чем «сгенерировал кусок кода, который выглядит правильным».
3. 57 тестов пройдено: самое убедительное инженерное доказательство Qwen4-Max-Preview
3.1 Полная реконструкция процесса исправления
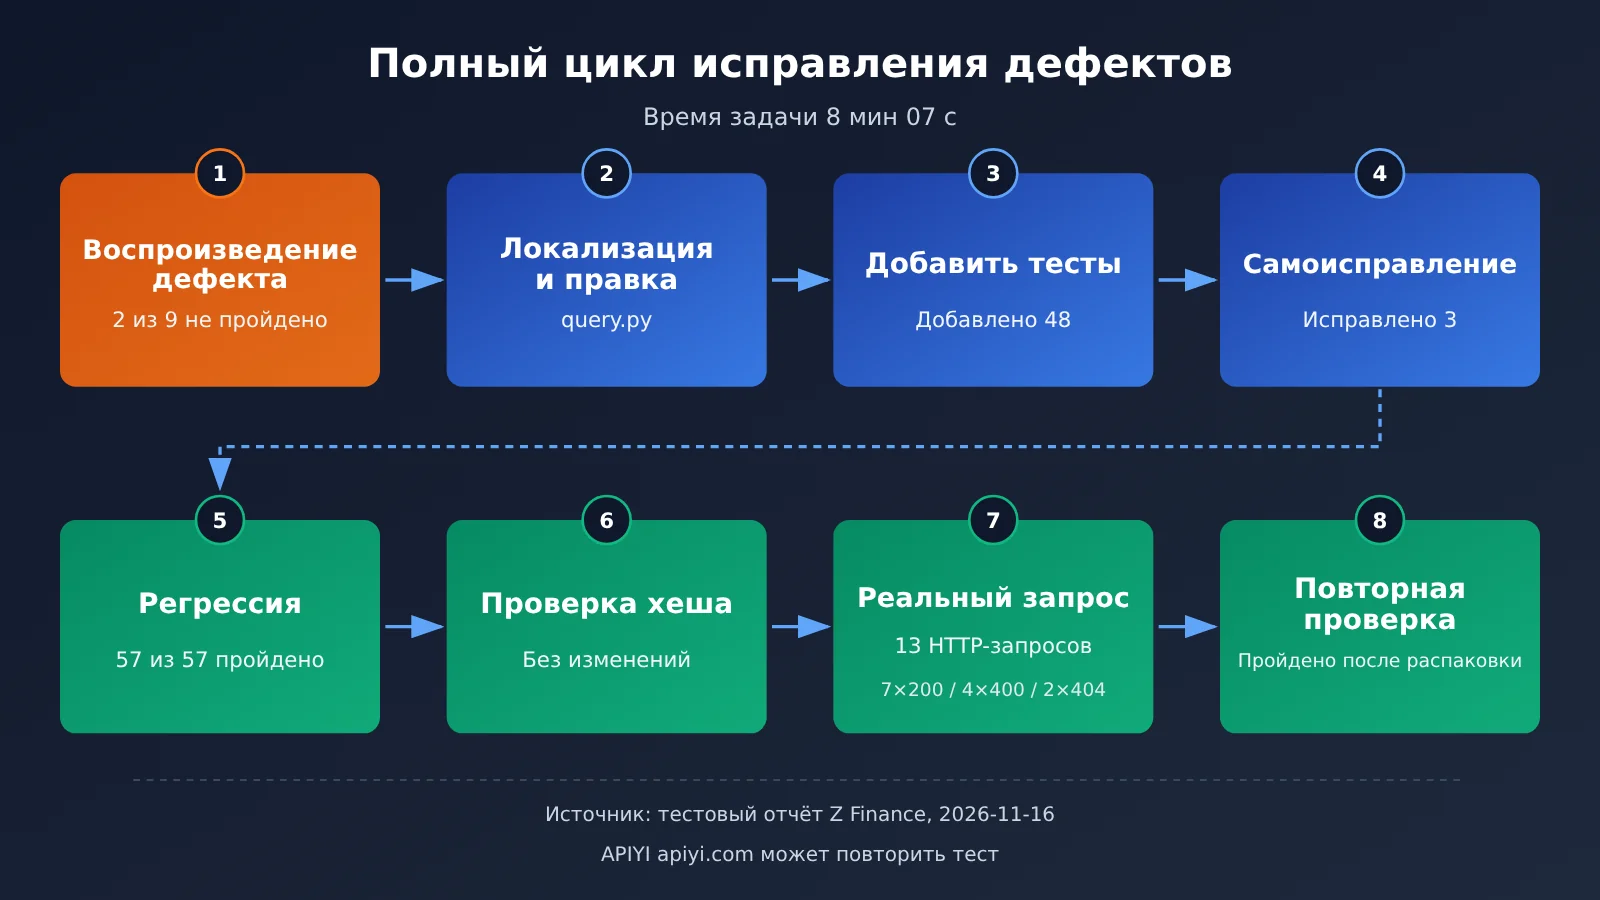
Тестируемый объект — сервис запросов по тикетам, написанный на стандартной библиотеке Python. Дефекты касались комбинированной фильтрации, сортировки, пагинации и валидации параметров. Задача требовала исправить дефекты, сохранив интерфейс, исходные данные и исходные тесты. В отчёте указано, что задача заняла 8 минут 07 секунд. Вот как шёл процесс:
| Шаг | Действия модели | Инженерный смысл |
|---|---|---|
| Воспроизведение дефекта | Сначала запускает исходные 9 тестов и воспроизводит 2 падения | Сначала убедиться, что проблема есть, и только потом править |
| Локализация изменений | Основные правки сосредоточены в query.py | Правки локализованы, меньше побочных эффектов |
| Дополнение тестов | Добавляет 48 тестов | Покрывает граничные случаи, которых не было в исходных тестах |
| Самоисправление | Исправляет 3 проблемы в собственных тестах | Замечает ошибки в самих тестах и своевременно их исправляет |
| Регрессионная проверка | В итоге все 57 тестов проходят | 9 исходных тестов плюс 48 новых |
| Проверка целостности | Выполняет хеш-проверку исходных данных и исходных тестов — хеши не меняются | Доказывает, что прохождение не было достигнуто подменой данных или тестов |
| Реальные запросы | Запускает локальный сервис и отправляет 13 HTTP-запросов: 7 ответов 200, 4 — 400, 2 — 404 | Проверяет нормальные ответы и обработку ошибок в работающем интерфейсе |
| Повторная проверка поставки | Распаковывает финальный пакет поставки и запускает его ещё раз — тесты проходят | Подтверждает, что сам поставочный артефакт может работать независимо |
3.2 Почему это говорит о большем, чем генерация кода
В программировании с ИИ есть два распространённых сценария провала. Первый — изменить тесты или данные, чтобы тесты «позеленели». Второй — код проходит тесты, но ломается при реальном запуске. Хеш-проверка в этой задаче закрывает первый риск, а реальные HTTP-запросы и повторная проверка пакета поставки — второй. 4 ответа 400 и 2 ответа 404 показывают, что модель проверила и сценарии ошибок: валидация параметров и обработка несуществующих ресурсов прошли реальную проверку.
Этот процесс совпадает с тем, как зрелые инженеры обычно исправляют баги: воспроизвести, исправить, дописать тесты, проверить регрессию, поставить. Он доказывает, что Qwen4-Max-Preview в сервисе с чёткими правилами и контролируемым масштабом способен пройти полный замкнутый цикл сопровождения. Но это всё ещё запись одной задачи, и её нельзя пересчитать в универсальный процент успешных исправлений кода.
4. Практическая ценность контекста в миллион токенов: находим подсказку через 741 строку среди 1 600 тикетов
4.1. Дизайн теста и результаты
Официально заявленное контекстное окно Qwen4-Max-Preview — 1 000 000 токенов. Размер окна — это лишь верхняя граница ёмкости. Практическую ценность определяет то, умеет ли модель выстраивать правильные связи в большом объёме материала. Ответ на этот вопрос даёт тест на тикетах из отчёта Z Finance.
Тестовые данные — 1 600 тикетов службы поддержки, объём около 500 000 байт. Ключевые сведения находятся в двух записях, между которыми 741 строка. Всего было 5 вопросов. В отчёте указано, что на все 5 вопросов получены правильные ответы. Конкретно это выглядит так:
- Связать два разрозненных тикета и найти сумму возврата 1 386 юаней и ответственного сотрудника.
- По дате утверждения определить, применяется ли к этому случаю новая политика компенсационных ваучеров.
- Посчитать 62 тикета, подходящих под заданные условия, — результат совпал с подсчётом скрипта.
- Найти две группы дублирующихся номеров заказов и понять, где нормальный поток, а где конфликт клиентских данных.
4.2. Байты и токены — две разные единицы
Около 500 000 байт — это размер файла, а количество токенов зависит от способа токенизации и доли китайского и английского текста. Это разные величины, и считать их нужно отдельно. Тест подтверждает умение связывать данные между записями и фильтровать по условиям в материале среднего размера. По масштабу он намного меньше предельного окна в 1 000 000 токенов, поэтому его нельзя считать стресс-тестом на предельную ёмкость.
Ценность третьего результата в том, что его можно проверить: 62 тикета совпали с результатом скрипта. Значит, подсчёт модели можно перепроверить детерминированной программой. На практике советую делать так же: сверять статистику от модели скриптом, а модель подключать там, где нужно связывать и объяснять — то, что скрипту даётся плохо.
5 Слабое место, которое нельзя игнорировать: Qwen4-Max-Preview делает избыточные выводы в научных рассуждениях
5.1 Вычисления верны, но интерпретация выходит за рамки доказательств
Задача воспроизведения научного исследования требовала реализовать по указанной статье мультипликативный алгоритм обновления для неотрицательного матричного разложения. Входная матрица — 48×36, использовались три разных начальных приближения, по 500 итераций в каждом. В отчёте указано, что модель работала 10 минут 06 секунд и выдала код, численные результаты, графики и журналы; по каждой из трёх групп было предложено 52 контрольные точки, ключевые контрольные точки группы A совпали с публичным эталонным результатом, а также имелось 63 записи самопроверки.
Проблема возникла на этапе выводов. Модель, опираясь лишь на то, что целевая функция продолжала убывать, интерпретировала результат как сходимость к локально оптимальному решению. Автор указывает, что это избыточное умозаключение.
5.2 Три понятия, которые нужно оценивать по отдельности
Этот случай затрагивает три уровня суждений, и каждому следующему требуется более сильное доказательство, чем предыдущему:
- Убывание целевой функции: характерное свойство самого правила мультипликативного обновления, его можно напрямую наблюдать по журналам и графикам.
- Численная сходимость итераций: нужно проверить, стабилизируется ли изменение итерационных величин, и задать явный критерий остановки.
- Сходимость к локально оптимальному решению: нужно проверить условия оптимальности, например условия KKT; одного лишь убывания значения функции для этого недостаточно.
Это показывает, что способность модели выполнять вычисления и строгость её аргументации нужно оценивать по отдельности. Численные расчёты можно проверить по контрольным точкам, а научные выводы требуют проверки человеком с соответствующей подготовкой. В сценариях исследований, воспроизведения статей или технических отчётов «блок выводов» из ответа модели стоит воспринимать как черновик.
6 Qwen4-Max-Preview и другие инструменты для программирования: сравнение на одной задаче
6.1 Данные сравнения по испытанию с автоматом-клешнёй
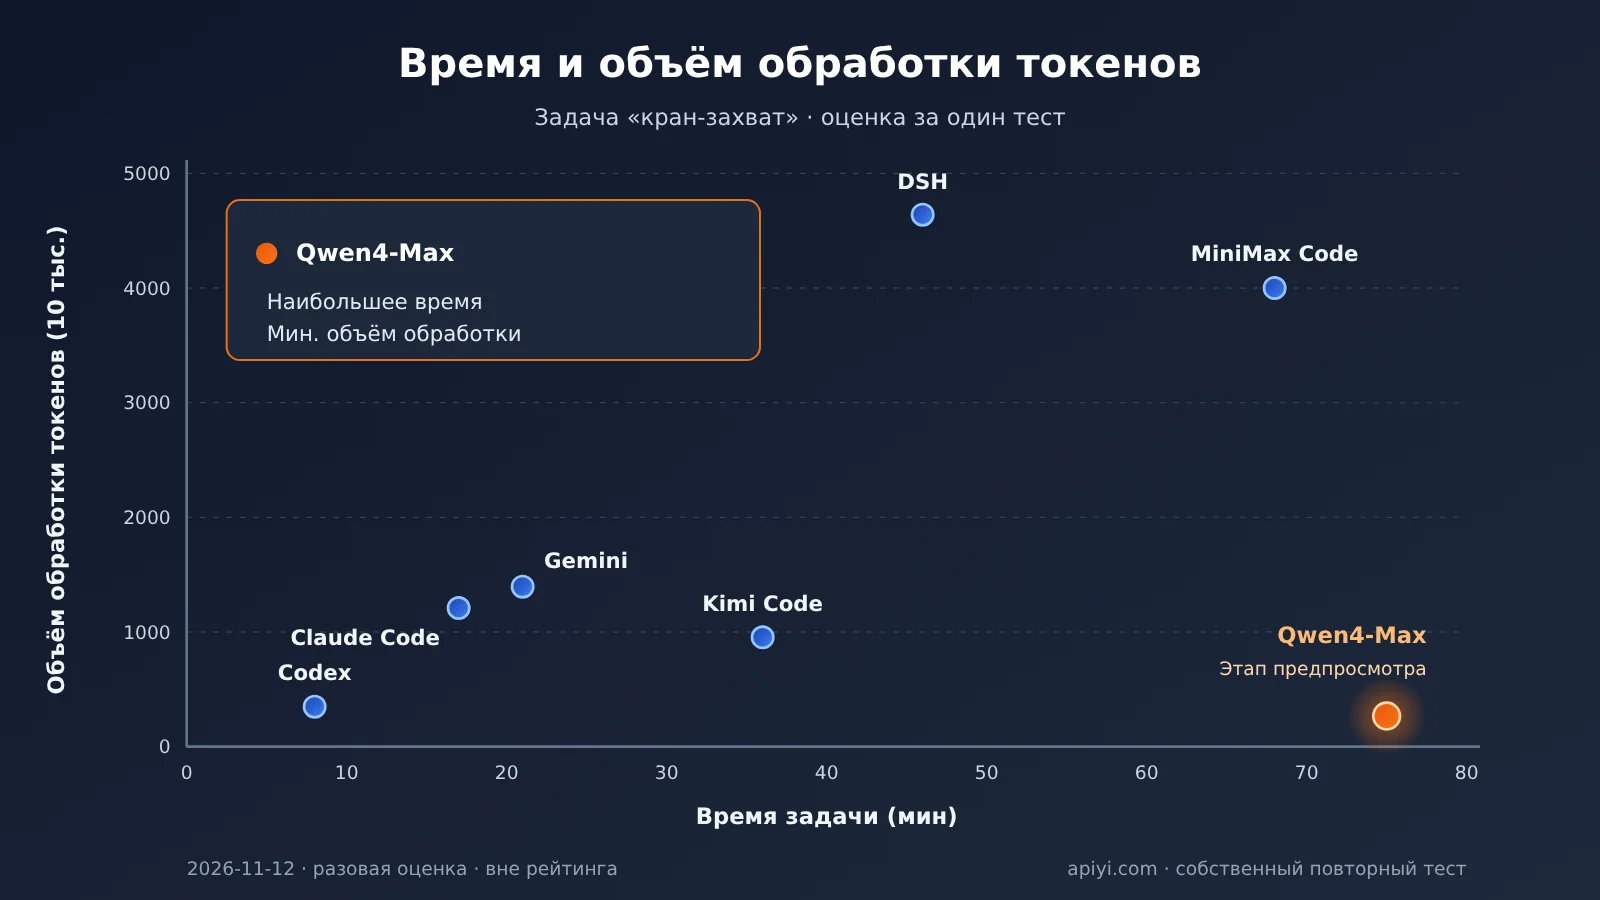
В отчёте от 12 ноября также приведены записи по одному и тому же испытанию с автоматом-клешнёй для разных инструментов. В исходной таблице строка Qwen помечена как Qwen4-Max, время теста — 12 ноября, то есть раньше выхода официальной версии 16 ноября, а значит, речь о модели на этапе превью.
| Инструмент/модель | Время | Всего обработано токенов (оценка) | Выходных токенов | Где повторить тест |
|---|---|---|---|---|
| Codex | 8 минут | 3,5 млн | 28 тыс. | Соответствующий официальный инструмент |
| Claude Code | 17 минут | 12,15 млн | 130 тыс. | Официальный инструмент; модель Claude можно вызывать через APIYI apiyi.com |
| Gemini | 21 минута | 13,94 млн | 81 тыс. | Официальный инструмент; модель Gemini можно вызывать через APIYI |
| Kimi Code | 36 минут | 9,5 млн | 59 тыс. | Соответствующий официальный инструмент |
| DSH | 46 минут | 46,44 млн | 281 тыс. | Соответствующий официальный инструмент |
| MiniMax Code | 68 минут | 40 млн | 198 тыс. | Соответствующий официальный инструмент |
| Qwen4-Max (этап превью) | 75 минут | 2,69 млн | 55 тыс. | Token Plan (Qoder) |
6.2 Как читать эти данные
Цифры дают заметный контраст: у Qwen4-Max-Preview в этой задаче самый низкий общий объём обработанных токенов — около 2,69 млн, а времени при этом ушло больше всех — около 75 минут. Если учесть наблюдавшуюся скорость около 33 токенов/с, становится видно, что узкое место здесь — скорость генерации, а сам объём потребляемых токенов невелик.
Для рейтинга эти данные не годятся, и причин три: общий объём токенов — оценка автора; доля контекстного кэша, стратегии вызова и способ выполнения у инструментов разные; конкретные версии моделей в таблице тоже никак не оговорены. Низкий объём обработки токенов может объясняться меньшим числом повторных чтений, а может — разницей в политике кэширования на уровне инструмента; по имеющимся материалам их не различить. Что действительно следует из таблицы: в такой инструментальной среде Qwen4-Max-Preview подходит для задач, где время ожидания некритично, а важнее полнота результата.
7 Каким разработчикам стоит попробовать Qwen4-Max-Preview
7.1 Где модель подходит, а где нужна осторожность
Если обобщить оба отчёта, Qwen4-Max-Preview показывает себя достаточно стабильно в следующих задачах:
- Обслуживание кода с чёткими правилами: исправления и дополнение тестов, когда уже есть готовые тесты и понятны границы проблемы.
- Поиск и связывание информации в длинных документах: поиск по разным записям в тикетах, логах, договорах и финансовых отчётах, а статистику результатов лучше перепроверять скриптом.
- Автоматизация офисной работы: очистка данных, Excel с формулами, редактируемые PPT и многократные правки.
- Разработка интерактивных прототипов: одностраничные сайты, имитационные системы и прототипы небольших игр — например, упомянутая в отчёте офлайн-страница размером около 46 КБ без внешних зависимостей.
Осторожность нужна в трёх типах задач: интерактивная разработка, чувствительная ко времени отклика (одна задача может занимать больше часа), выводы, требующие строгих математических или научных обоснований, и производственные изменения с высокими требованиями к надёжности. Авторы отчёта также отмечают, что «в задачах с широким охватом часть информации теряется» и что «итоговые результаты всё равно требуют проверки человеком».
Перед использованием стоит учитывать официальные ограничения: Preview доступна только через Alibaba Cloud Token Plan в интерактивном режиме в таких инструментах, как Claude Code, Cursor и Qoder, оплата по факту использования не поддерживается, а период предварительного просмотра заканчивается 25 ноября 2026 года в 24:00 (по пекинскому времени), после чего модель будет выведена из эксплуатации. Официальная версия Qwen4-Max вышла 16 ноября, и официально рекомендуется перейти на неё. Параметры у них различаются: максимальный вывод в режиме размышления у официальной версии — 262 144 токена, у Preview — 393 216 токенов, поэтому при миграции нужно заново настроить бюджет вывода.
7.2. Проведите собственное повторное тестирование на своих задачах
Отчёты из вторых рук в лучшем случае говорят лишь о том, что «модель это умеет». Самый прямой способ понять, подходит ли она вашей команде, — провести сравнение на собственном реальном коде и тестах. В примере ниже задача исправления кода отправляется через OpenAI-совместимый интерфейс, а время выполнения и расход токенов записываются. Названия моделей указывайте так, как они указаны в списке моделей платформы.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Унифицированный интерфейс APIYI, совместимый с OpenAI
)

resp = client.chat.completions.create(
    model="qwen4-max",  # Ориентируйтесь на фактическое название в списке моделей APIYI
    messages=[{"role": "user", "content": "阅读以下代码与失败的测试,给出最小修复补丁:..."}]
)
print(resp.choices[0].message.content)
Посмотреть скрипт сравнительного повторного тестирования нескольких моделей
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Один ключ для вызова нескольких моделей
)

# Замените на фактические названия из списка моделей платформы
MODELS = ["qwen4-max", "claude-sonnet-model-name", "gpt-model-name"]

TASK = """你将收到一个 Python 服务的源码和测试结果。
要求:1) 先说明复现到的失败原因;2) 只修改必要文件;
3) 补充覆盖边界条件的测试;4) 不得修改原始数据和已有测试。
--- 源码与测试输出 ---
{payload}
"""

def run_case(model: str, payload: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": TASK.format(payload=payload)}],
        max_tokens=32000,  # Токены размышления у reasoning-моделей также входят в бюджет вывода — нужно предусмотреть запас
    )
    usage = resp.usage
    return {
        "model": model,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    payload = open("bug_context.txt", encoding="utf-8").read()
    for m in MODELS:
        r = run_case(m, payload)
        print(f"{r['model']}: {r['seconds']}s, "
              f"in={r['prompt_tokens']}, out={r['completion_tokens']}")
        # Примените патч в изолированном каталоге, запустите тесты, проверьте исходные данные по хешу и только затем оценивайте
Скрипт только собирает решения и данные о расходе; на этапе оценки нужно повторить подход из отчёта: применить патч в изолированном каталоге, запустить исходные и новые тесты и с помощью хешей убедиться, что данные и старые тесты не изменены. Только такие выводы будут справедливы для вашей кодовой базы.
🚀 Быстрый старт: если нужно сравнить несколько моделей на одном наборе задач, можно получить бесплатный тестовый лимит через APIYI apiyi.com. Платформа предоставляет OpenAI-совместимый интерфейс: с одним API-ключом можно переключаться между OpenAI, Claude, Gemini и другими популярными моделями, так что скрипт повторного тестирования легко запустить в рамках одного и того же процесса оценки.
8. Частые вопросы по тестированию Qwen4-Max-Preview
Вопрос 1: задача с кран-машиной заняла 75 минут — значит, модель медленная?
В той задаче Qoder время выполнения оказалось самым большим в сравнительной таблице, а наблюдаемая скорость вывода — около 33 токенов/с. Это лишь запись из одного окружения: на результат влияют и планирование инструментов, и сетевые условия. Если в вашем сценарии важна скорость ожидания, лучше проверить на собственной реальной задаче.
Вопрос 2: 57 пройденных тестов — это показатель успешности исправления кода?
Это отражает один полный, проверяемый процесс исправления, но не пересчитывается в процент успеха. Чтобы оценить работу в своём проекте, можно через APIYI apiyi.com сравнить несколько моделей на одном наборе дефектов и оценить их по прохождению тестов и результатам проверки хешей.
Вопрос 3: тест с тикетами подтвердил контекстное окно в 1 млн токенов?
Нет. Объём этого теста — около 500 тысяч байт, количество токенов зависит от способа токенизации, и масштаб намного меньше предела окна. Он проверял умение связывать данные между записями и фильтровать по условиям.
Вопрос 4: что делать после завершения Preview?
Официально уже выпущена стабильная версия Qwen4-Max, и рекомендуется использовать именно её. Стабильная версия поддерживает API с оплатой по факту использования, максимальный вывод в режиме размышления — 262 144 токена, так что при миграции нужно пересмотреть бюджет вывода. На сторонних платформах наличие моделей и цены меняются быстро — можно проверить актуальные названия доступных моделей в списке моделей APIYI apiyi.com и только потом подключаться.
Вопрос 5: можно ли поместить ключ Token Plan в бэкенд собственного приложения?
Нет. По официальным правилам Token Plan разрешён только для интерактивного использования в разрешённых инструментах программирования и агентных инструментах; массовые вызовы из автоматизированных скриптов и бэкенды собственных приложений в разрешённую область не входят. Нарушение может привести к приостановке подписки или блокировке ключа. Для собственных приложений стоит выбирать API-продукты, соответствующие области использования.
9 Ключевые выводы из тестирования Qwen4-Max-Preview
- Замкнутый цикл поставки: задача исправления кода охватывала воспроизведение, исправление, дополнительные тесты, проверку хешей, реальные запросы и приёмочную проверку поставки; пройдено 57 тестов.
- Связи в длинных текстах: в 1 600 заявках удалось найти связи, охватывающие 741 строку; все 5 вопросов отвечены верно; 62 статистических показателя совпали со скриптом.
- Поставка офисных документов: формулы Excel сохраняют взаимосвязи; после нескольких правок PPT 20 ключевых фактов остались неизменными.
- Слабое место — скорость: задача с автоматом для захвата игрушек заняла около 75 минут; объём обработки токенов низкий, а времени уходит много.
- Границы рассуждений: расчёты при воспроизведении научного исследования совпали с эталонными результатами, но выводы содержат чрезмерные допущения и требуют проверки человеком.
- Характер доказательств: всё выше — практические тесты задач, выполненные одним автором; это не стандартизированный рейтинг.
- Как начать: проведите контрольное повторное тестирование на своём коде и тестах; с APIYI apiyi.com можно переключать несколько моделей в рамках одного интерфейса.
10 Итоги: где разработчикам применять Qwen4-Max-Preview
Публичный отчёт даёт достаточно чёткую картину. Qwen4-Max-Preview хорошо справляется с работой, где есть понятные правила и проверяемые результаты: поддержка кода с тестами, поиск связей между записями в длинных материалах, обработка данных с формулами и редактируемые офисные файлы, а также разработка интерактивных прототипов. В таких задачах она умеет сама дописывать тесты, искать ошибки и выдавать результаты, которые можно перепроверить.
Ограничения тоже конкретны: сложные задачи занимают много времени, поэтому их лучше запускать в фоне; научные выводы легко выходят за рамки доказательств и требуют экспертной проверки; Preview доступна только через Token Plan в интерактивном режиме в указанных инструментах и будет отключена 25 ноября — для долгосрочного использования стоит перейти на официальную версию.
Самый практичный подход — воспринимать её как инженерного помощника, который самостоятельно закрывает цикл поддержки, а разработчик отвечает за проверку выводов и финальное слияние. Перед запуском в продакшен рекомендуется провести сравнение нескольких моделей на собственных реальных задачах: через единый интерфейс APIYI apiyi.com можно выполнить тестирование и сравнение в одном процессе.
📚 Справочные материалы
-
人人都是产品经理: вышла предварительная версия Qwen4-Max! Тестируем и делимся впечатлениями: практический тест Qoder на «захвате игрушек» и сравнение с другими инструментами, 2026-11-12
- Ссылка:
woshipm.com/ai/6492544.html - Описание: источник данных по 75 минутам работы, 33 Tokens/s, 65 Credits и сравнительной таблице
- Ссылка:
-
人人都是产品经理: практический тест Qwen4-Max-Preview (отчёт Z Finance): комплексное тестирование по 12 задачам, 2026-11-16
- Ссылка:
woshipm.com/evaluating/6494229.html - Описание: источник данных по исправлению кода, поиску по тикетам, воспроизведению научных результатов и офисным задачам
- Ссылка:
-
Alibaba Cloud Model Studio: документация Qwen4-Max-Preview: официальные спецификации и инструкция по использованию
- Ссылка:
help.aliyun.com/zh/model-studio/qwen4-max-preview - Описание: контекстное окно, максимальный объём вывода, сроки предварительной версии и способы подключения
- Ссылка:
-
Alibaba Cloud Model Studio: документация Qwen4-Max: параметры и тарификация релизной версии
- Ссылка:
help.aliyun.com/zh/model-studio/qwen4-max - Описание: бюджет вывода и информация об оплате по факту использования в релизной версии
- Ссылка:
-
Alibaba Cloud: права и правила использования Token Plan: ограничения по области применения
- Ссылка:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - Описание: требования к интерактивному использованию и запрещённые сценарии
- Ссылка:
Автор: техническая команда APIYI
Техническая поддержка: будем рады обратной связи — напишите нам на главной странице сайта APIYI apiyi.com, а больше материалов по подключению найдёте в центре документации docs.apiyi.com