Резюме: при выборе модели для разработки игр стоит смотреть на успешность выполнения одной и той же задачи, время работы, стоимость API и затраты на ручные исправления. Таблицы цен и общие бенчмарки для кода — лишь вспомогательные ориентиры.
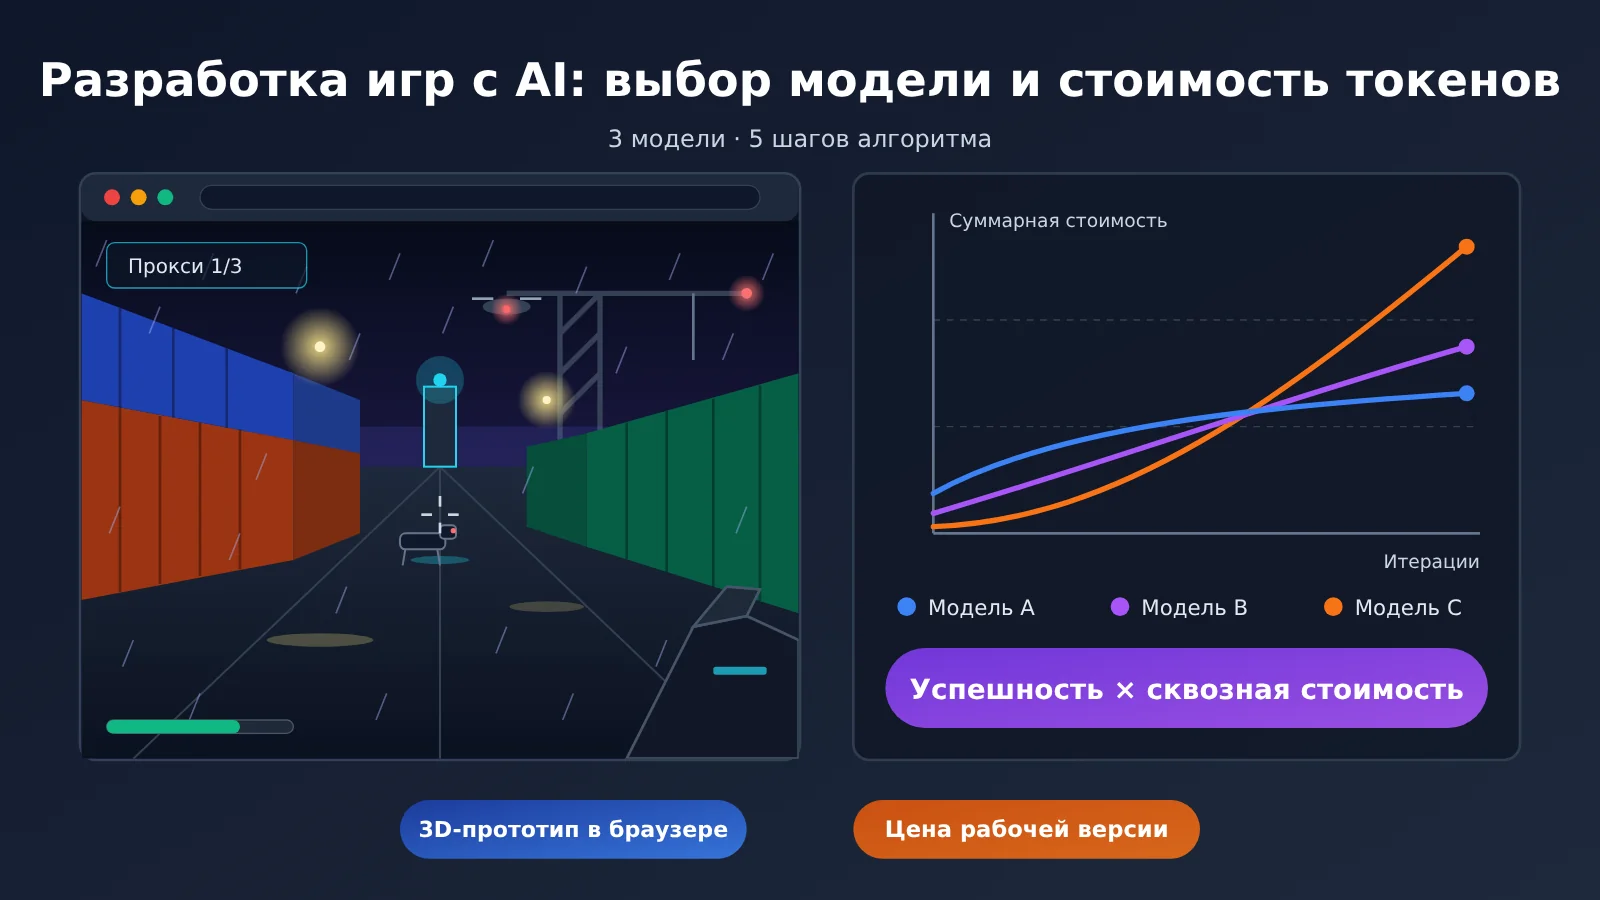
Сначала главное: если AI самостоятельно разрабатывает игру, в итоге нужно сравнивать сквозную стоимость готовой к поставке версии, а не цену за миллион токенов. В кейсе Saltline Claude Fable 5.2 примерно за 8 часов, около 445 млн входных токенов и около 2,7 млн выходных токенов создал прототип 3D-шутера, который запускается в браузере. Разработчик по ценам API оценил расходы примерно в 550 долларов, причём большая часть входных данных шла через кэш. По состоянию на 16 ноября 2026 года стандартные цены API у трёх моделей различаются максимум примерно в 5 раз, но если более дешёвая модель требует больше раундов, суммарная стоимость может оказаться выше. Поэтому надёжный способ выбора такой: дать одну и ту же игровую задачу моделям-кандидатам, запустить несколько раз, собрать статистику по успешности, токенам, времени и объёму ручных исправлений, а затем посчитать «стоимость каждого годного варианта».
Что будет дальше: в разделе 1 на примере Saltline разбирается структура счёта за токены в одном эксперименте по разработке игры с AI. В разделе 2 сравниваются официальные цены трёх моделей и объясняется, как кэш влияет на итоговые расходы. В разделе 3 рассказывается, что именно показывают SWE-bench Verified, Aider Polyglot и исторические оценки NIST. В разделе 4 приводится воспроизводимая методика и код для отдельного бенчмарка по разработке игр. В разделе 5 результаты превращаются в стратегию выбора модели.
Для справки: термины для выбора моделей в AI-разработке игр
| Термин | Объяснение |
|---|---|
| Входные токены | Объём контента, передаваемого модели на обработку: промпты, файлы кода, результаты работы инструментов и т. д. |
| Выходные токены | Объём контента, который генерирует модель: код, пояснения, параметры вызова инструментов. |
| Чтение из кэша | Повторное использование уже закэшированного контекста; тарифицируется значительно ниже обычного ввода. |
| Запись в кэш | Плата за первичное сохранение контекста в кэш; обычно немного выше обычного ввода. |
| SWE-bench Verified | Бенчмарк из 500 вручную проверенных задач программной инженерии на реальных open-source проектах. |
| Aider Polyglot | Оценка изменения кода на 6 языках программирования, включающая 225 упражнений. |
| Harness | Среда выполнения, которая организует цикл работы модели, инструментов и задач, например каркас агента. |
| Доля успешно выполненных задач | Доля задач, выполненных по заранее заданным критериям приёмки. |
| Стоимость полного цикла | Сумма затрат на вызовы модели, выполнение инструментов и ручной труд за весь цикл задачи. |
| Ручные исправления | Правки вручную, чтобы результат соответствовал критериям приёмки. |
| Процедурная генерация | Создание геометрии, текстур и звука кодом и математическими функциями, а не импортом файлов ресурсов. |
| Шейдер | Программа, выполняемая на GPU для расчёта цвета, освещения, материалов и других визуальных эффектов. |
1. Сколько токенов стоила разработка игры силами ИИ: кейс Saltline
1.1. Что за игра Saltline и какого она масштаба
9 ноября 2026 года инженер Anthropic Felix Rieseberg публично представил эксперимент по программированию с Claude Fable 5.2. Он дал модели всего один промпт — сделать небольшую игру в жанре шутера от первого лица, визуально максимально близкую к AAA-проектам, — и на всём протяжении работы не давал никакой обратной связи от человека. Результатом стал Saltline: 3D-шутер, который запускается прямо в браузере. Действие разворачивается в контейнерном порту дождливой ночью: игроку нужно отключить три ретранслятора сигнала и эвакуироваться, а враги — это патрульные дроны в воздухе и механические псы-охотники на земле.
По масштабу Saltline — играбельный прототип для одного игрока с одним уровнем. «AAA» здесь — это цель эксперимента и визуальная аналогия для описания стиля картинки; по объёму он сильно уступает коммерческим AAA-продуктам. Ходившая по Китаю версия «几猫·国产3A大作» — это китайский вариант Saltline или его переупаковка; название появилось в процессе распространения и не говорит о том, кто на самом деле разработчик.
1.2 Разработчик о времени, токенах и затратах
Все данные ниже взяты из публикации самого разработчика в X. Это его собственные оценки, не проходившие независимый аудит:
- Время разработки: около 8 часов
- Входные токены: около 445 млн, причём значительная часть — из кэша
- Выходные токены: около 2,7 млн
- Оценка стоимости по ценам API: около 550 долларов
- Подход к разработке: один промпт, без итераций с обратной связью от человека
Это разовые затраты на генерацию. После создания файлов игра запускается локально в браузере игрока, и во время игры Claude API не вызывается. Поэтому 550 долларов нельзя распределить как «AI-стоимость на каждого игрока».
1.3 Разбираем эту сумму по официальным ценам
По официальной стандартной цене Claude Fable 5.2 (выход — $40 за миллион токенов) 2,7 млн выходных токенов стоят около 108 долларов. Оставшиеся примерно 440 долларов относятся к входной стороне: запись в кэш, чтение из кэша и обычный ввод. Разработчик не раскрыл количество токенов по каждому из этих трёх пунктов, поэтому дальше сумму не разбить.
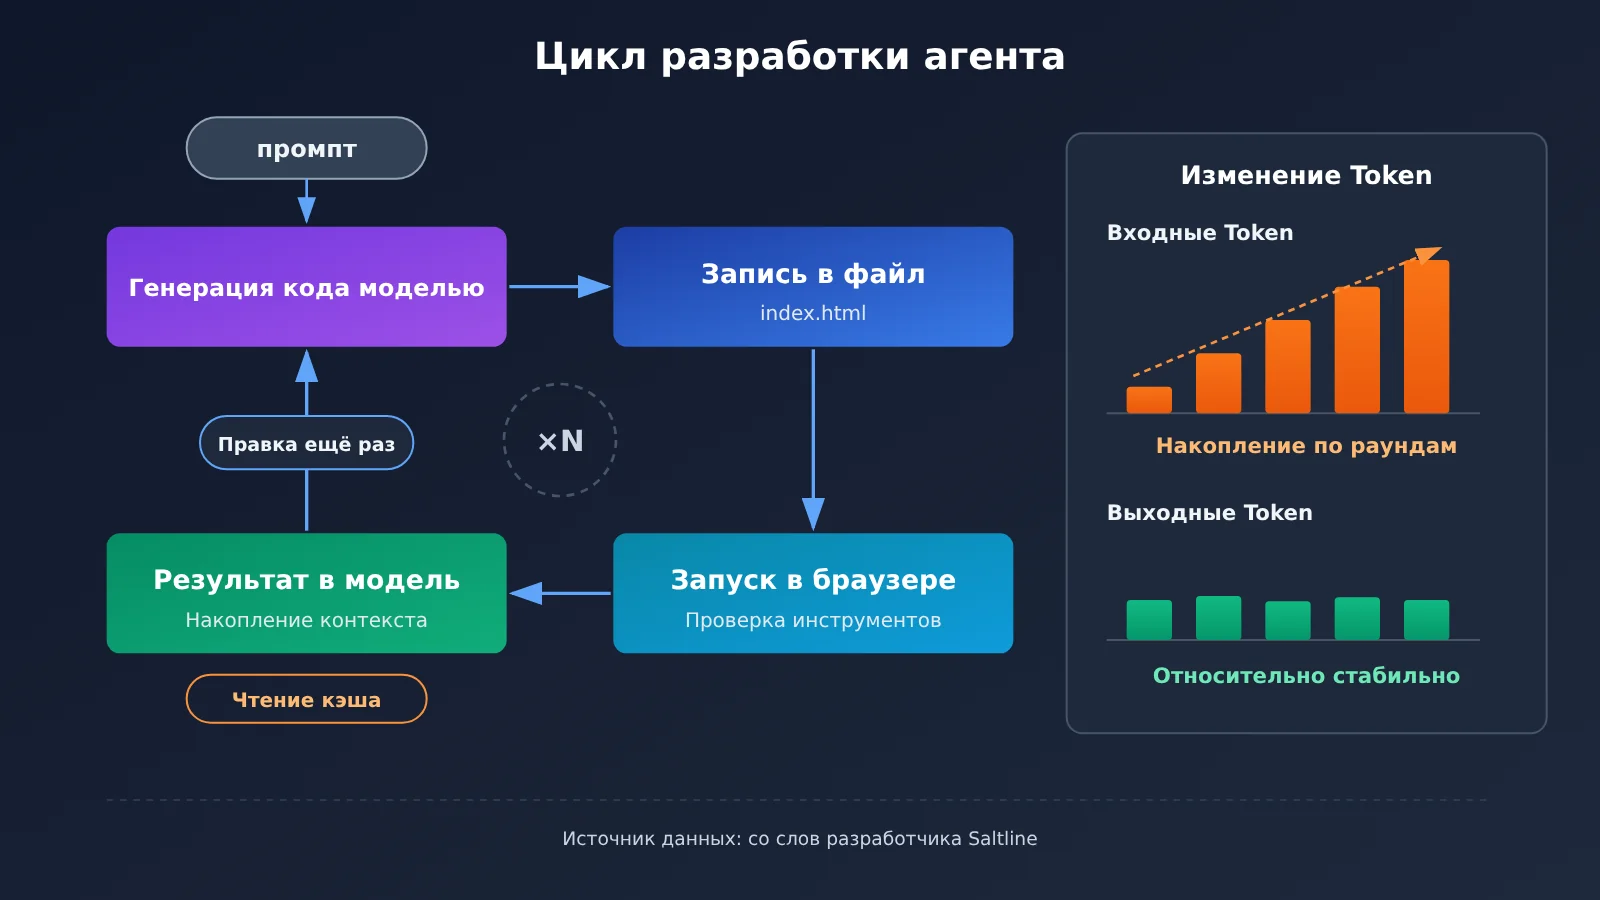
Достаточно сравнить два граничных значения, чтобы увидеть эффект кэша: если бы все 445 млн входных токенов тарифицировались как обычный ввод по $8, это составило бы около 3 560 долларов; если бы все шли по цене чтения из кэша $0.20 — около 89 долларов. Фактическая оценка лежит между ними и заметно ближе к нижней границе. Это показывает: в длительных задачах разработки с агентом доля попаданий в кэш на входной стороне определяет порядок суммы в счёте, а цена выходных токенов влияет относительно слабо.
1.4 Почему файл размером 1,4 МБ может израсходовать 445 млн токенов
Независимая HTML-версия Saltline занимает около 1,43 МБ (1 425 707 байт). Разработчик рассказывает, что модели и текстуры в игре — это код: геометрия строится программно, вид поверхности вычисляется шейдерами, звук тоже генерируется программой. Отдельных файлов изображений или 3D-моделей там нет.
Результат получился компактным, а вот процесс — долгим. За 8 часов агент многократно перечитывал растущий файл с кодом, запускал инструменты, смотрел на результат и снова вносил правки. На каждом таком витке ему приходилось заново отправлять в модель большой объём контекста. В итоге основные затраты токенов дал именно этот цикл, а не длина финального файла. Именно поэтому, оценивая модели для разработки игр, нужно измерять «стоимость процесса».
2 Сравнение цен на модели для разработки игр: различия в тарификации токенов у трёх API
2.1 Официальные стандартные цены трёх моделей
Все цены в таблице ниже взяты с официальных страниц вендоров по состоянию на 16 ноября 2026 года, указаны в долларах США за миллион токенов, соответствуют стандартному тарифу API и не учитывают скидки других каналов и региональные надбавки.
| Модель | Обычный ввод | Вывод | Чтение кэша | Примечание |
|---|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | $0.20 | Запись в кэш на 5 минут — $10, на 1 час — $16; контекст 1M, максимальный вывод 128K |
| GPT-6 Astra | $10 | $50 | $1 | Стандартный тариф обработки; цены для других скоростных режимов, пакетной обработки и региональных опций могут отличаться |
| Gemini 4 Argon | $2 | $10 | $0.10 | Цена действует до 30 ноября 2026 года; с 1 декабря планируется изменение: ввод $4, вывод $20 |
У Claude Fable 5.2 есть ещё Fast Mode: ввод $16, вывод $80 — по заявлению вендора, скорость вывода можно поднять до 2,5 раза. Для длинных задач, которые нужно уложить в фиксированное время, скоростной режим меняет и время выполнения, и стоимость, поэтому при оценке его стоит записывать как отдельную конфигурацию.
💡 Совет по сравнению: у трёх моделей разные интерфейсы и поля тарификации, поэтому при сборке собственного стенда для оценки к каждой нужно подключаться отдельно. APIYI apiyi.com предлагает единый интерфейс, совместимый с OpenAI: с одним API-ключом можно вызывать Claude, GPT, Gemini и другие модели, что удобно для переключения моделей в рамках одного набора оценочных скриптов. Актуальный список доступных моделей и цены смотрите в каталоге платформы.
2.2 Разница в ценах при одинаковом объёме токенов
Чтобы наглядно почувствовать разницу в цене за единицу, можно подставить объём вывода Saltline (2,7 млн токенов) в цены всех трёх: Claude Fable 5.2 — около $108, GPT-6 Astra — около $135, Gemini 4 Argon — около $27. Если все 445 млн входных токенов попадут в чтение кэша, получится примерно $89, $445 и $45 соответственно.
Эти цифры говорят только о структуре тарификации и предполагают, что все три модели расходуют совершенно одинаковое число токенов, — а на практике это условие почти никогда не выполняется. Разным моделям нужно разное число раундов на одну и ту же задачу, разный объём контекста на каждом раунде и разная длина генерируемого кода, а повторные запуски после неудач ещё и умножают расходы.
2.3 Цена кэша важнее цены ввода
При агентной разработке большая часть ввода — это повторяющийся контекст. У GPT-6 Astra цена чтения кэша составляет 1/10 от обычного ввода, у Claude Fable 5.2 — 1/40, у Gemini 4 Argon — 1/20. Чем ниже отношение цены чтения кэша к цене обычного ввода, тем легче сжать стоимость ввода в длинных задачах.
У кэша есть ещё стоимость записи и срок действия. У Claude запись в 5-минутный и 1-часовой кэш стоит по-разному, и если интервал между двумя вызовами агента превышает срок жизни кэша, запись придётся делать заново. При оценке стоимости длинных задач нужно учитывать вместе число записей в кэш, долю попаданий и срок действия.
3 Что могут показать бенчмарки по программированию: ориентир возможностей моделей для разработки игр
3.1 SWE-bench Verified: задачи по программной инженерии на реальных репозиториях
SWE-bench Verified включает 500 задач, отобранных и проверенных вручную, из реальных open-source проектов. Модели нужно понять контекст репозитория и выполнить исправление багов, изменение существующего кода, устранение падений тестов и правки в нескольких файлах — это ближе к реальной инженерии, чем просто автодополнение кода.
При использовании стоит учитывать влияние Harness. Официально указано, что общий лидерборд смешивает разные агентные системы, а для сравнения самих моделей нужно использовать единую конфигурацию mini-SWE-agent. Конфигурация агента, инструменты, промпты и версии влияют на оценку, поэтому результаты разных конфигураций стоит рассматривать отдельно.
3.2 Aider Polyglot: фиксирует и точность, и стоимость
Aider Polyglot использует 225 задач по программированию на C++, Go, Java, JavaScript, Python и Rust — с помощью тестовых примеров проверяется, правильно ли модель изменила код. В открытых результатах помимо доли правильных ответов также фиксируются расход токенов, стоимость запуска, ошибочный вывод, ошибки форматирования и время выполнения каждой задачи.
Для выбора модели такой формат «точность + стоимость» очень ценен: он совпадает с подходом к оценке, о котором пойдёт речь дальше в статье. Сами задачи — отдельные учебные упражнения; по масштабу и формату они заметно отличаются от полноценного проекта 3D-игры.
3.3 Исторические оценки NIST: обращайте внимание на версии моделей и даты
В опубликованном в 2025 году отчёте об оценке моделей подразделения CAISI Национального института стандартов и технологий США (NIST) проверялись результаты группы моделей по SWE-bench Verified. Все приведённые ниже данные относятся к историческим моделям и экспериментальным конфигурациям из этого отчёта и не отражают рейтинг самых актуальных моделей по состоянию на ноябрь 2026 года.
| Модель (тестируемая версия в отчёте 2025 года) | Результат SWE-bench Verified |
|---|---|
| Anthropic Opus 4 | 66,7% |
| GPT-5 | 63,0% |
| DeepSeek V3.1 | 54,8% |
| DeepSeek R1-0528 | 44,6% |
| gpt-oss | 42,6% |
| DeepSeek R1 | 25,4% |
В отчёте также приводится стандартная ошибка — это говорит о том, что оценки в рамках одного и того же бенчмарка сами по себе подвержены статистическим колебаниям. Разница в несколько процентных пунктов в пределах погрешности может не давать реального различения. Сравниваемые в этой статье Claude Fable 5.2, GPT-6 Astra и Gemini 4 Argon в этот отчёт не попали. При выборе модели нужно искать свежие оценки именно для текущих версий с явно указанной конфигурацией — или проводить собственное тестирование.
3.4 Разрыв между универсальными навыками программирования и возможностями в разработке игр
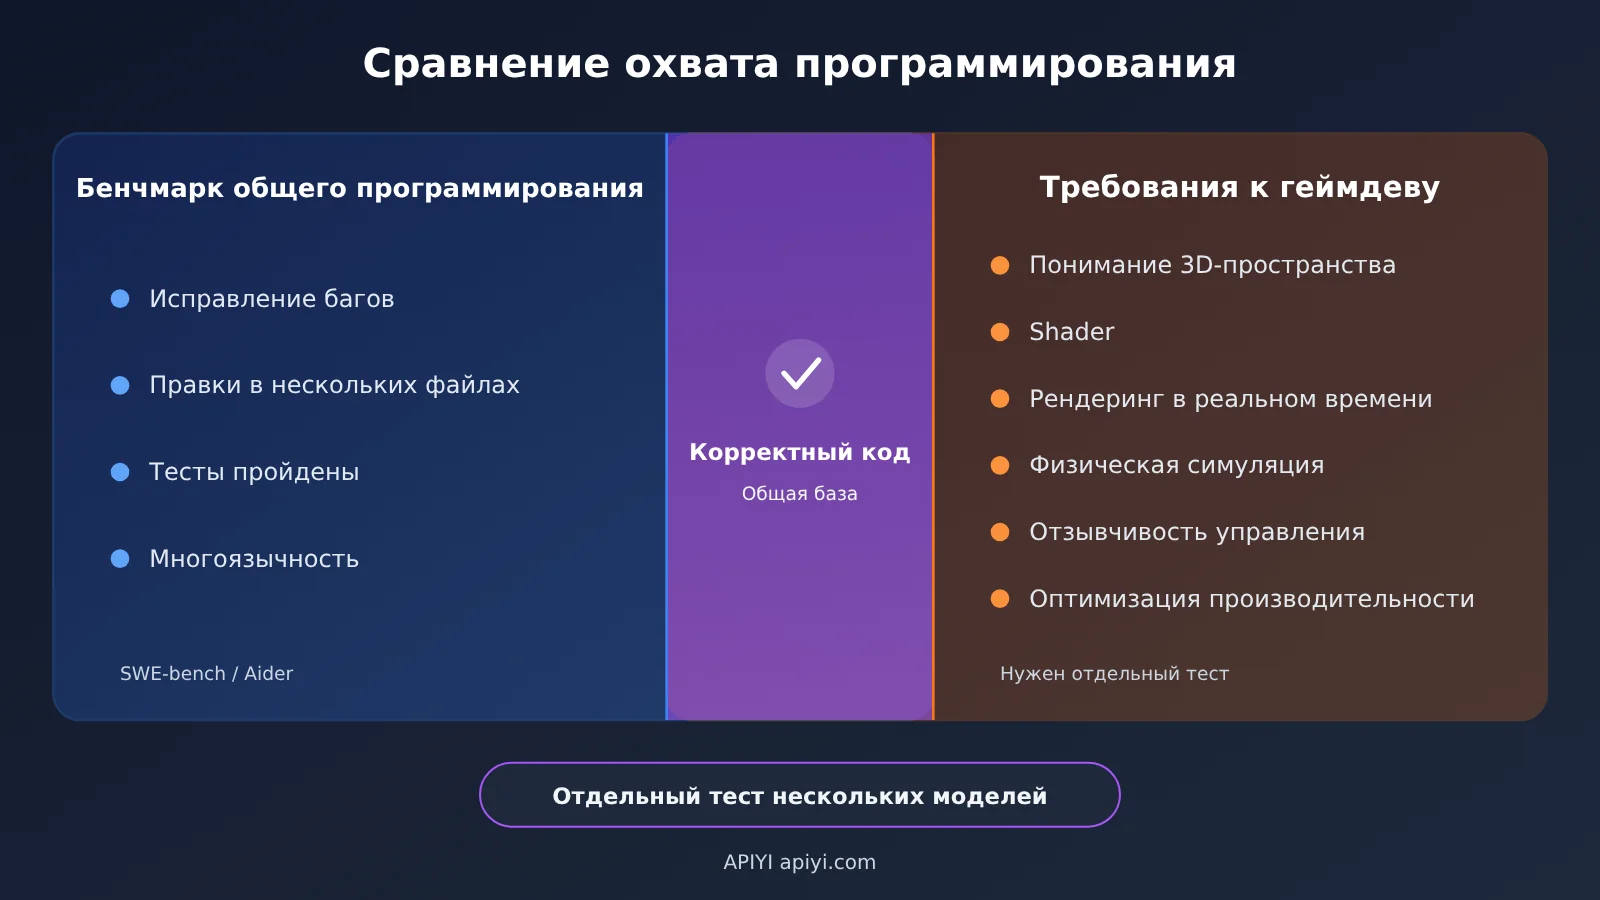
Разработка игр включает массу задач, которые общие инженерные бенчмарки几乎 не покрывают: понимание 3D-пространства, написание шейдеров, рендеринг в реальном времени, анимационные системы, физическая симуляция, ощущение управления и оптимизация производительности. В проектах вроде Saltline от модели ещё требуется генерировать визуальные ассеты кодом — а это уже зависит от понимания графики и визуальных эффектов.
Модель может отлично ловить баги в Python-репозиториях, но на сложных сценах WebGL показывать средний результат. SWE-bench и Aider хорошо подходят для того, чтобы отсеять кандидатов с явно недостаточными навыками написания кода; итоговый же рейтинг требует отдельной оценки именно по разработке игр.
4 Как сравнивать модели для разработки игр с помощью ИИ: специализированный план оценки на одной задаче
4.1 Разрабатываем единую задачу: 3D-игра для браузера
Опираясь на подход Saltline, задачу можно определить так: по одному промпту сгенерировать прототип 3D-игры, который запускается в браузере. Все модели-кандидаты получают абсолютно одинаковые требования:
- Сгенерировать полноценный проект, который можно сразу открыть и запустить в браузере
- Включить управляемого персонажа и 3D-окружение
- Включить столкновения или базовую физику
- Включить чёткую цель задания и условия победы/поражения
- Во время оценки запрещено вручную править ключевой код
Сложность задачи должна соответствовать твоим реальным потребностям. Команда, которая делает казуальные мини-игры, при тестировании на прототипе FPS завысит нужный класс модели; команда, которая делает сложные 3D-проекты, на простой 2D-задаче, наоборот, занизит его.
4.2 Десять критериев оценки
| Критерий | Что оценивается | Как рекомендуется фиксировать |
|---|---|---|
| Полнота функций | Реализованы ли ключевые игровые функции | Отмечать пункты по списку функций |
| Визуальное качество | Сцены, материалы, освещение, анимация | Слепое оценивание несколькими оценщиками |
| Возможность запуска | Запускается ли нормально | Да / Нет |
| Полнота взаимодействия | Корректны ли ввод и обратная связь | Тестировать по чек-листу действий |
| Стабильность | Есть ли явные падения | Играть фиксированное время и записывать число падений |
| Производительность | FPS, время запуска, память | Измерять на фиксированном оборудовании |
| Качество кода | Читаемость, модульность, обработка ошибок | Оценка по результатам код-ревью |
| Стоимость токенов | Ввод, вывод, кеш | Суммировать по полю API usage |
| Общее время | От начала до работоспособной версии | Замерять время |
| Ручные исправления | Ручное вмешательство, необходимое для соответствия критериям | Записывать человеко-часы |
При этом «возможность запуска», «полнота функций» и «полнота взаимодействия» должны быть жёсткими критериями приёмки, определяющими успешность прогона; визуальное качество, производительность и качество кода используются для ранжирования успешных результатов.
4.3 Контроль тестовой среды
Сопоставимость результатов оценки зависит от того, все ли переменные под контролем. Согласовать нужно целый набор условий: один и тот же браузер, одно и то же устройство, одинаковые промпты, одинаковый порядок тестирования, одинаковый лимит времени, а также одинаковое разрешение или запрет на выход в сеть. Если модели разрешено самостоятельно вызывать инструменты, искать материалы или создавать файлы, то и права доступа к инструментам у всех моделей должны быть одинаковыми.
Тестовый стенд (harness) тоже нужно фиксировать. Если взять одну и ту же модель, но другой Agent-фреймворк, доля успешных прогонов и расход токенов могут заметно измениться. Поэтому в отчёте об оценке нужно указывать использованный фреймворк, его версию и параметры — например, температуру, максимальную длину вывода и скоростной режим.
4.4 Каждую модель прогоняйте несколько раз
Генерация большой языковой модели имеет случайный характер: один успех может оказаться везением, а одна неудача — случайностью. Каждую модель стоит запускать в одинаковых условиях несколько раз (скажем, от 5 до 10), а затем считать долю успешных прогонов, а также средние токены, время и оценку качества по успешным примерам. Saltline сам по себе — единичный эксперимент: он доказывает, что задача в принципе решаема, но не даёт доли успеха этой модели на подобных задачах.
Скрипт ниже вызывает модель через OpenAI-совместимый интерфейс и по полю usage считает стоимость одного вызова согласно ценам из раздела 2:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI: чтобы сменить модель, достаточно изменить model
)

# Единица: доллары за миллион токенов, официальные стандартные цены на 2026-11-16
PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

def call_and_price(model: str, messages: list) -> tuple[str, float]:
    resp = client.chat.completions.create(model=model, messages=messages)
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    cost = ((u.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + u.completion_tokens * p["output"]) / 1_000_000
    return resp.choices[0].message.content, cost
Названия моделей стоит брать из списка моделей той платформы, через которую вы на самом деле вызываете модель. Стоимость записи в кеш и надбавки за скоростной режим нужно добавлять в расчёт отдельно — по правилам каждого провайдера.
Посмотреть скрипт многократного прогона и сводки затрат
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # через APIYI вызываем несколько моделей-кандидатов
)

PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

TASK_PROMPT = "生成一个可在浏览器运行的单文件 3D 游戏原型……(所有模型使用同一提示词)"

def price(model, usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    return ((usage.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + usage.completion_tokens * p["output"]) / 1_000_000

def run_once(model, max_rounds=30):
    """Упрощённый цикл агента: генерация → проверка → возврат результата → доработка"""
    messages = [{"role": "user", "content": TASK_PROMPT}]
    total_cost, start = 0.0, time.time()
    for _ in range(max_rounds):
        resp = client.chat.completions.create(model=model, messages=messages)
        total_cost += price(model, resp.usage)
        code = resp.choices[0].message.content
        report = check_game(code)  # реализуйте сами: запись в файл, запуск headless-браузера, прогон чек-листа функций
        if report["passed"]:
            return True, total_cost, time.time() - start
        messages += [{"role": "assistant", "content": code},
                     {"role": "user", "content": f"检查结果:{report['log']},请修复"}]
    return False, total_cost, time.time() - start

def evaluate(model, trials=5, human_fix_cost=0.0):
    results = [run_once(model) for _ in range(trials)]
    successes = sum(r[0] for r in results)
    api_cost = sum(r[1] for r in results)
    rate = successes / trials
    per_success = (api_cost + human_fix_cost) / successes if successes else float("inf")
    print(f"{model}: 成功率 {rate:.0%},API 总费用 ${api_cost:.2f},"
          f"每个合格版本成本 ${per_success:.2f}")

for m in PRICES:
    evaluate(m)
🚀 Быстрый старт: когда будете собирать такой бенчмарк, сначала прогоните скрипт на маленькой задаче и только потом переключайтесь на полноценную игровую задачу. APIYI apiyi.com выдаёт новым пользователям бесплатный тестовый лимит — на нём удобно сначала проверить Harness и логику подсчёта расходов, а уже потом выделять бюджет на серьёзный прогон.
5 Как выбирать модель для AI-разработки игр: контроль расходов на токены в сложных задачах
5.1 Успешность определяет общую стоимость
Полная стоимость разработки складывается из трёх частей:
Общая стоимость задачи = стоимость вызова модели + стоимость работы инструментов + стоимость ручных доработок
Если учитывать успешность, практичнее сравнивать «стоимость одного годного результата»: все затраты на попытки делятся на число успешных. Допустим, модель A стоит 100 долларов за попытку при успешности 80% — выходит около 125 долларов за годный результат. Модель B стоит 30 долларов за попытку при успешности 20% — это примерно 150 долларов за годный результат, да ещё плюс время на разбор неудачных вариантов. В этом примере модель с низкой ценой за вызов в итоге выходит дороже.
Самая крупная статья расходов — часто именно ручные доработки. Если инженер тратит несколько часов на правку сгенерированного результата, стоимость его времени может превысить весь счёт за API. Поэтому при оценке честно фиксируйте часы ручного вмешательства и пересчитывайте их в общую стоимость по реальной ставке вашей команды.
5.2 Три стратегии выбора модели
| Стратегия | Когда подходит | Плюсы | На что смотреть по расходам |
|---|---|---|---|
| Модель высокой мощности | Сложная архитектура, разработка с длинным контекстом, взаимодействие нескольких модулей, поиск сложных багов | Высокая доля успешных выполнений, меньше повторных прогонов и ручных исправлений | Высокая цена за вызов; входные расходы нужно сдерживать за счёт кэширования |
| Недорогая модель | Простые функции, объяснение кода, рутинные правки, помощь с тестами | Низкая цена за вызов, подходит для частых обращений | На сложных задачах возможны несколько неудачных попыток, и итоговая стоимость может вырасти |
| Совместная работа нескольких моделей | Одна модель отвечает за архитектуру, другая — за реализацию, независимая модель делает ревью кода | Возможности и цена подбираются под каждый этап | При передаче между моделями контекст пересылается повторно, растут расходы на токены и координацию |
Экономия от совместной работы нескольких моделей зависит от стоимости передач между ними. При каждой передаче контекст проекта приходится заново отправлять другой модели, а кэш между разными моделями не разделяется. Схема сотрудничества окупается только тогда, когда недорогая модель берёт на себя достаточно много этапов, а передач немного — и это тоже стоит подтвердить практическими замерами.
💰 Совет по затратам: для совместной работы нескольких моделей приходится в одном проекте обращаться к моделям разных провайдеров. Если подключаться через APIYI apiyi.com с одним ключом и одним набором кода, меньше возни с несколькими аккаунтами и адаптацией интерфейсов, а после распределения архитектуры, реализации и ревью между разными моделями проще сводить расходы в одном месте.
5.3 Практический пятишаговый процесс выбора
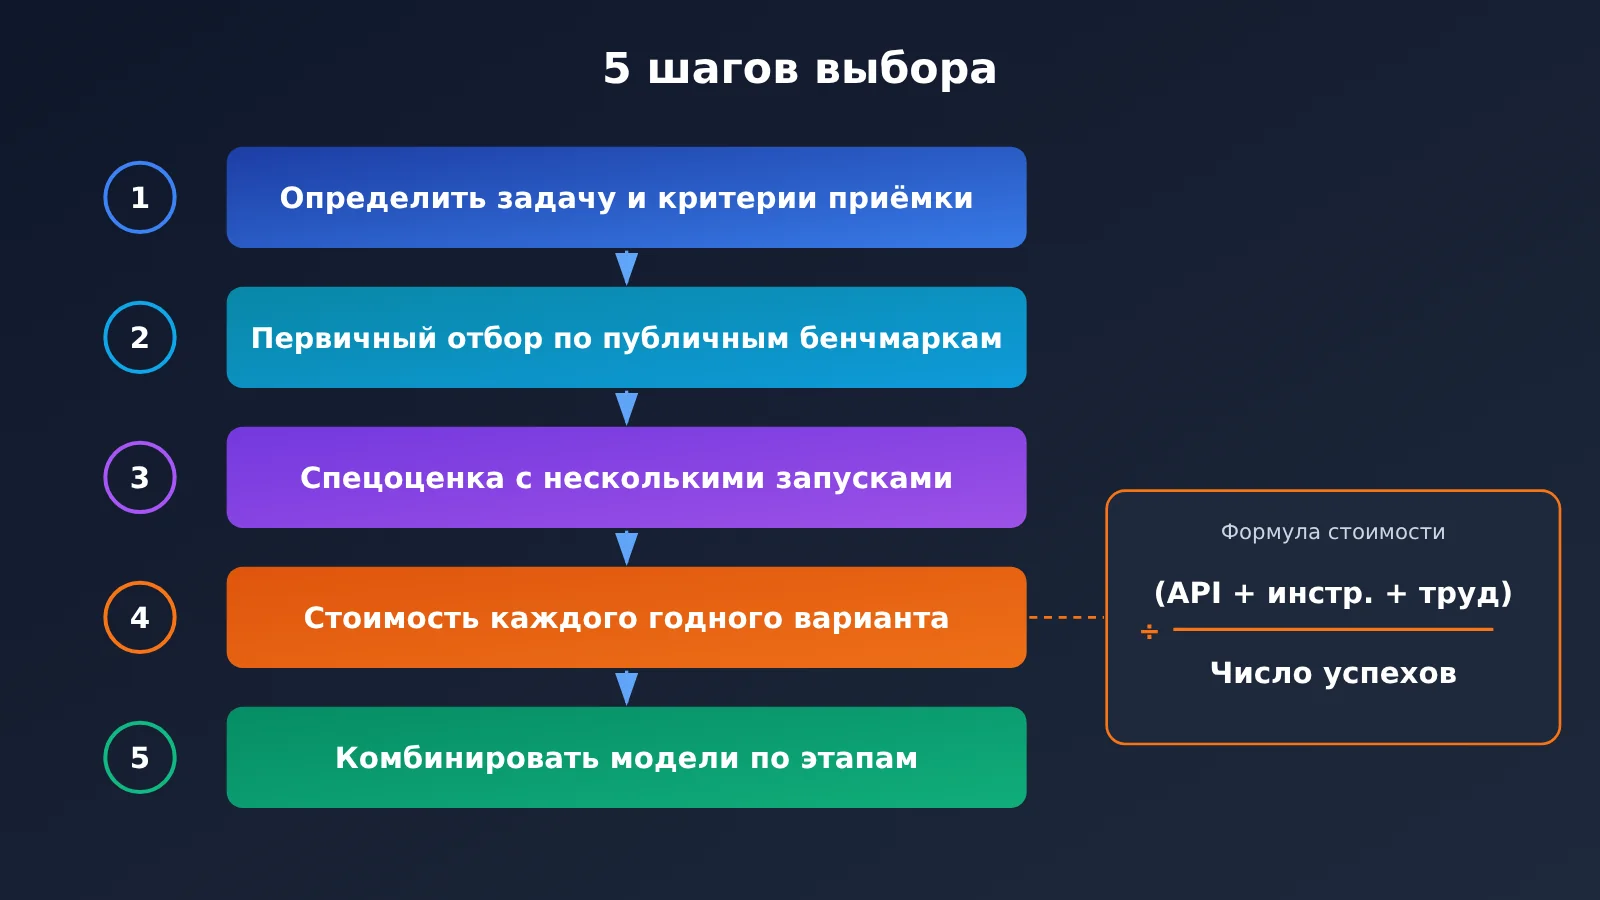
- Определите задачу и критерии приёмки: чётко пропишите список функций, целевые платформы и минимальные требования к производительности — это станет основой для оценки успеха.
- Сделайте первичный отсев по публичным бенчмаркам: опирайтесь на актуальные результаты SWE-bench Verified и Aider Polyglot с явно указанной конфигурацией и отсекайте модели с очевидно недостаточными способностями к программированию.
- Проведите специализированное тестирование: в одинаковых условиях прогоните одну и ту же игровую задачу 5–10 раз для каждой модели-кандидата и зафиксируйте десять метрик из раздела 4.2.
- Посчитайте стоимость каждого подходящего варианта: расходы на API плюс расходы на инструменты плюс расходы на ручные исправления, разделить на число успешных прогонов.
- Комбинируйте модели по этапам: сложные этапы поручайте моделям с высокой долей успеха, повторяющиеся — малозатратным моделям, а затем проверьте на практике, действительно ли комбинация экономичнее.
Цены меняются: например, для Gemini 4 Argon уже объявлен пересмотр тарифов с 1 декабря. В результатах тестирования сохраняйте исходные данные по токенам — при изменении цен достаточно подставить новые цены за единицу, чтобы обновить выводы.
6. Частые вопросы (FAQ) о выборе моделей ИИ для разработки игр
Вопрос 1: 550 долларов в Saltline — это реальный счёт?
Это не аудированный счёт. 550 долларов — оценка разработчика Felix Rieseberg по ценам API; сопутствующие данные (около 8 часов, около 445 млн входных токенов, около 2,7 млн выходных токенов) тоже взяты из его собственных слов. Во входных данных активно использовался кэш, но точное соотношение записи в кэш и чтения из кэша не раскрыто.
Вопрос 2: Модель с минимальной ценой за токен — значит, самая выгодная?
Всё решает успешность. Цена за токен определяет только стоимость одного токена; сколько токенов модели нужно на задачу, сколько раз её перезапускать и сколько потом править руками — всё это зависит от способностей модели. Сравнивать имеет смысл по формуле «общие затраты ÷ число успехов».
Вопрос 3: Модель №1 в рейтинге SWE-bench лучше всего подходит для игр?
SWE-bench Verified измеряет навыки программирования в реальных открытых репозиториях и слабо покрывает шейдеры, понимание 3D-пространства, рендеринг в реальном времени и ощущение управления. Он годится для первичного отбора, а финальный рейтинг для разработки игр требует отдельных специализированных тестов.
Вопрос 4: Могут ли оценки из отчёта NIST отражать сегодняшние модели?
Нет. Отчёт NIST CAISI вышел в 2025 году и тестировал модели прошлых поколений вроде GPT-5, Opus 4, DeepSeek V3.1 и конкретные экспериментальные конфигурации. Для новых моделей ноября 2026 года нужно искать свежие оценки именно под их версии.
Вопрос 5: Как быстро собрать сравнительный тест нескольких моделей?
Проще всего взять агрегатор с OpenAI-совместимым интерфейсом. Зарегистрируйтесь на APIYI apiyi.com, получите API-ключ, укажите в скрипте из этой статьи `base_url` как `https://api.apiyi.com/v1` и меняйте параметр `model` — так можно тестировать несколько моделей в одном и том же скрипте. Новичкам можно сначала проверить скрипт на бесплатной квоте.
Вопрос 6: Как точнее всего считать стоимость токенов при тестировании?
Ориентируйтесь на поле usage в ответе API: суммируйте по каждому вызову обычные входные токены, чтение из кэша и выходные токены, а потом считайте по официальным ценам и тарифным уровням на день вызова. Дополнительные сборы за запись в кэш, уровни скорости и т.п. нужно добавлять отдельно по правилам каждого провайдера. При вызовах через APIYI apiyi.com можно также сверять результаты подсчёта с историей расходов в панели платформы.
Вопрос 7: Можно ли сразу выпустить в релиз прототип игры, созданный ИИ?
Прототипы вроде Saltline доказывают, что модель может без обратной связи от человека выдавать играбельную версию. Но коммерческий релиз — это ещё совместимость с разными браузерами, адаптация под мобильные устройства, оптимизация производительности и долгосрочная поддержка. Браузерные игры ограничены локальным железом и возможностями браузера; страница Saltline тоже предупреждает о медленной инициализации, необходимости переключаться на низкое качество графики при подтормаживаниях и т.п. Затраты на тестирование и оптимизацию перед релизом стоит включать в полную стоимость разработки.
7 Ключевые выводы о выборе модели для AI-разработки игр
- Главная метрика: сравнивайте сквозную стоимость каждого годного релиза, а не цену за миллион токенов.
- Счёт Saltline: около 550 долларов — это оценка самих разработчиков, на выход приходится примерно 108 долларов, остальное — на вход.
- Кэш решает порядок величин: в длинных задачах почти всё приходится на вход, поэтому сильнее всего влияют цена чтения из кэша и доля попаданий.
- Цены меняются: цены в статье актуальны на 2026-11-16, у Gemini 4 Argon с 1 декабря планируется изменение тарифов.
- Бенчмарки — для первичного отсева: SWE-bench и Aider измеряют общее программирование, а игровые способности нужно оценивать отдельно.
- Несколько прогонов: запускайте каждую модель 5–10 раз в одинаковых условиях и делайте выводы по доле успешных попыток, а не по одному результату.
- Как начать: переключайте модели через единый интерфейс APIYI apiyi.com — так удобно сравнивать стоимость в одном и том же скрипте.
8 Итог: как выбрать модель, чтобы AI самостоятельно разработал игру
Если вы хотите, чтобы AI самостоятельно сделал игру, в выборе модели есть три главных момента:
- Считать всё целиком: общая стоимость задачи включает вызовы модели, работу инструментов и ручные правки — расходы на API лишь одна из статей.
- Способности нужно проверять на практике: публичные бенчмарки нужны для первичного отсева, а итоговый рейтинг для разработки игр получается из нескольких специализированных прогонов в одинаковых условиях.
- Комбинировать по этапам: на сложных участках берите модель с высокой долей успеха, на рутинных — недорогую; комбинированный вариант тоже нужно проверять на практике.
Saltline даёт ориентир порядка величин: один промпт, около 8 часов, примерно 550 долларов оценочных расходов — и на выходе играбельный 3D-прототип для браузера. Сколько уйдёт у вашего проекта, зависит от сложности задачи и доли успешных попыток выбранных моделей; надёжнее всего — прогнать собственный цикл оценки по методике из этой статьи.
Рекомендуем быстро собрать среду для сравнения нескольких моделей через APIYI apiyi.com: платформа предоставляет совместимый с OpenAI интерфейс и бесплатный лимит для новых пользователей, так что цены и долю успешных попыток удобно проверять в одном наборе скриптов.
Справочные материалы
- Отдельная страница демо-версии Saltline: описание игрового процесса и часто задаваемых вопросов
- Ссылка:
saltline.games -
Описание: содержит информацию о запуске, переключении качества графики, управлении и т. д.
-
Зеркало кода Saltline и README: указание авторства данных разработчика
- Ссылка:
github.com/realcodebear/saltline-fable-5.2 -
Описание: фиксирует источники данных о времени генерации, токенах и расчётной стоимости
-
Репозиторий китайской версии Jimao: архив Saltline в китайской обёртке
- Ссылка:
github.com/Megasu/jimao-3a-game -
Описание: содержит данные о размере файла index.html и т. п.
-
Спецификации и цены модели Claude Fable 5.2: официальная документация Anthropic
- Ссылка:
platform.claude.com/docs/en/models/fable-5-2/overview -
Описание: цены за входные и выходные данные, кэширование и Fast Mode
-
Документация модели GPT-6 Astra: официальные цены OpenAI
- Ссылка:
developers.openai.com/api/docs/models/gpt-6-astra -
Описание: здесь указаны цены для стандартного уровня обработки
-
SWE-bench Verified: официальная страница бенчмарка по разработке ПО
- Ссылка:
swebench.com/verified.html -
Описание: 500 задач, проверенных вручную, и описание единой конфигурации mini-SWE-agent
-
Aider Leaderboards: результаты оценки Aider Polyglot
- Ссылка:
aider.chat/docs/leaderboards -
Описание: одновременно фиксирует точность, расход токенов и стоимость запуска
-
Отчёт об оценке NIST CAISI (2025 г.): независимая оценка прошлых моделей
- Ссылка:
nist.gov/system/files/documents/2025/09/30/CAISI_Evaluation_of_DeepSeek_AI_Models.pdf - Описание: содержит исторические результаты SWE-bench Verified и стандартные ошибки
Автор: техническая команда APIYI
Обратная связь: рады общению — пишите нам на главной странице сайта APIYI apiyi.com, а больше материалов по подключению найдёте в центре документации docs.apiyi.com