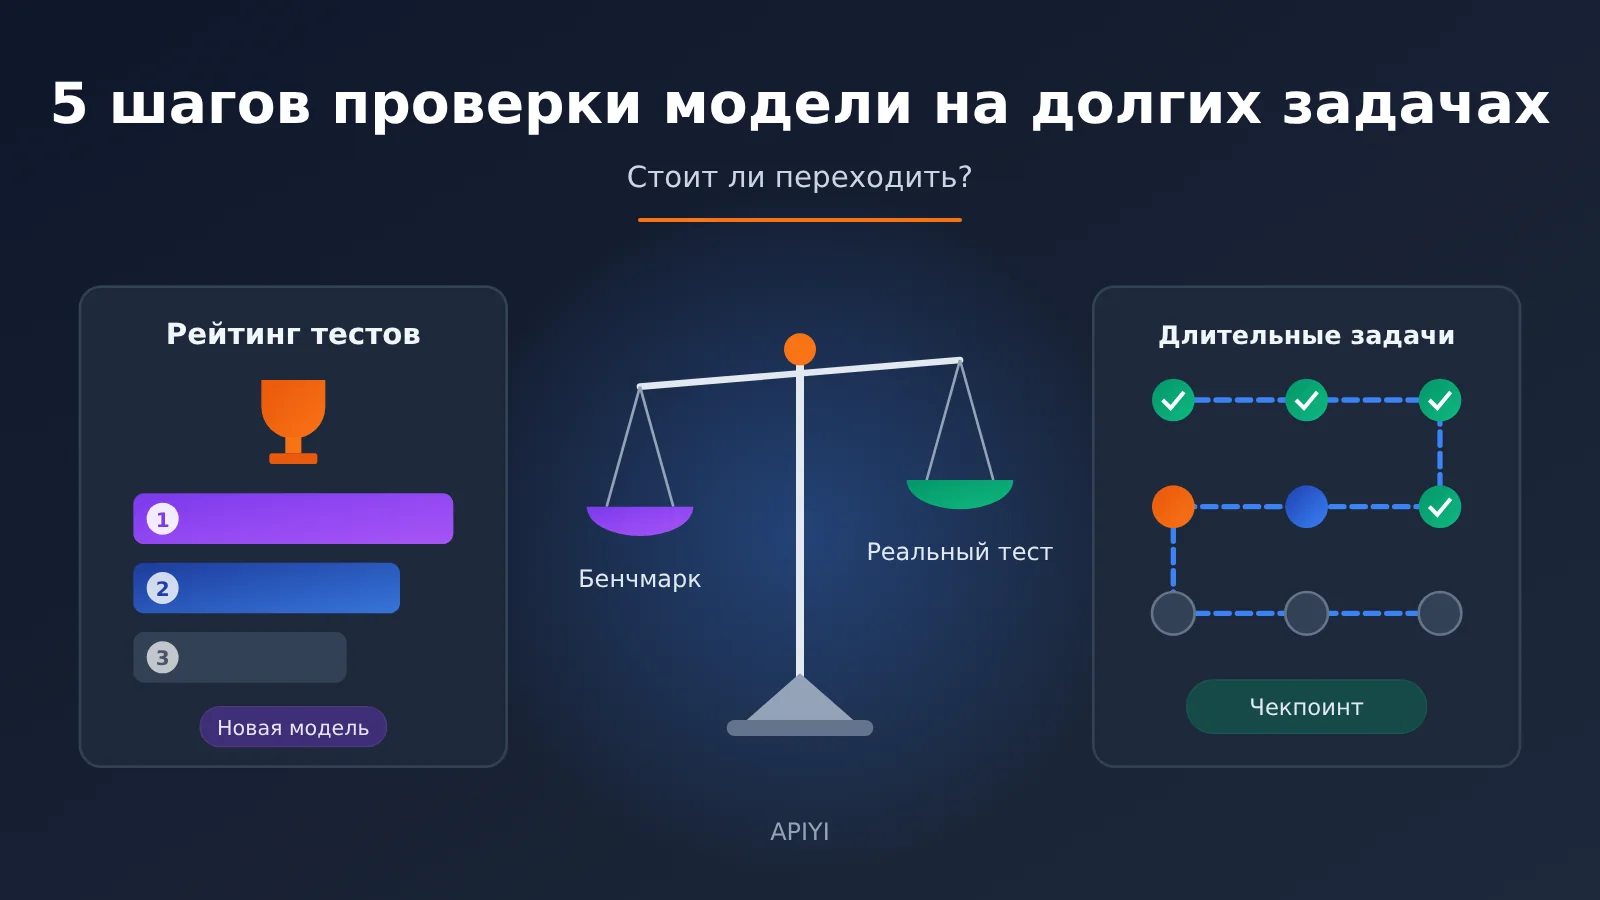
Примечание автора: как после выхода новой модели проверить на собственных длинных задачах, стоит ли на неё переходить? В этой статье вопрос разложен на выполнимый процесс из 5 шагов.
Новые модели выходят почти каждый месяц, а таблицы лидербордов обновляются непрерывно. Возьмём для примера Tencent Hunyuan Hy4, официально выпущенную в ноябре 2026 года: по заявлению разработчиков, по сравнению с preview-версией в ней целенаправленно доработали агентные возможности и работу на длинных задачах, а по ряду бенчмарков она вошла в число лидеров среди open-source моделей. Но для разработчика реальный вопрос только один: на моих задачах она лучше той модели, которой я пользуюсь сейчас? В этой статье описан метод сравнительной проверки новой модели на собственных длинных задачах, который поможет за день-два получить вывод, подкреплённый данными.
Это не очередной разбор бенчмарков. Лидерборды измеряют общие способности, а ваш бизнес измеряет другое: может ли модель довести многошаговое дело от начала до конца, умеет ли сама исправить ошибку, и сколько стоит каждая успешно закрытая задача.
Главная ценность: дочитав статью, вы научитесь собирать небольшой, но точный набор проверочных длинных задач, сравнивать старую и новую модель по 6 метрикам, считать на основе реального биллинга «стоимость одной успешной сдачи» и в итоге принять решение — переходить или нет.
Ключевые моменты проверки новой модели на длительных задачах
Прежде чем начинать, стоит чётко понять разницу между проверкой на длительных задачах и обычным одношаговым тестом. Одношаговый тест оценивает, «насколько красивым получился один ответ», а проверка на длительных задачах — «сохранилась ли цель после нескольких десятков шагов».
| Ключевой момент | Описание | Ценность |
|---|---|---|
| Свои задачи | Взять 3–5 многошаговых задач из реального бизнеса, а не публичные примеры | Выводы напрямую связаны с бизнес-эффектом |
| Фиксированная контрольная группа | Текущая и новая модели запускаются на одной задаче и с одинаковым набором инструментов | Исключает различия в промптах и окружении |
| Сначала процессные метрики | Фиксировать удержание цели, самокоррекцию и число ручных вмешательств | Позволяет увидеть проблемы стабильности, которых не видно по бенчмаркам |
| Считать стоимость по результату | Считать расходы на токены в расчёте на «каждую успешную сдачу» | Не даёт ошибиться, глядя только на цену за токен |
| Заранее задать порог замены | Заранее написать критерий «насколько лучше должно стать, чтобы менять модель» | Защищает от смещения из-за одного яркого кейса |
Почему проверка на длительных задачах надёжнее бенчмарков
Задачи в открытых рейтингах обычно закрытые и короткие, а реальная работа агента устроена ровно наоборот. В одном из тестовых обзоров Hy4 получила длительную задачу: пройти путь от исследования, разработки, проверки и доработок до играбельной 3D-игры, причём по ходу к задаче добавляли референсное видео и новые требования. Такие задачи проверяют, может ли модель по мере роста числа шагов помнить исходный план, различать сделанное и несделанное и менять план, когда промежуточный результат не соответствует ожиданиям.
Ещё один заметный эффект — синергия «модель + инструменты». В том же обзоре Hy4 за полчаса сгенерировала в WorkBuddy 14 презентаций PowerPoint, один файл Excel и документ Word на 19 страниц. Авторы обзора также прямо отмечают: модель отвечает за понимание, планирование и суждения, а инструменты — за чтение, вычисления, рендеринг и запись. Это значит, что при проверке новой модели её нужно запускать в своём наборе инструментов: выводы в отрыве от окружения имеют ограниченную ценность.
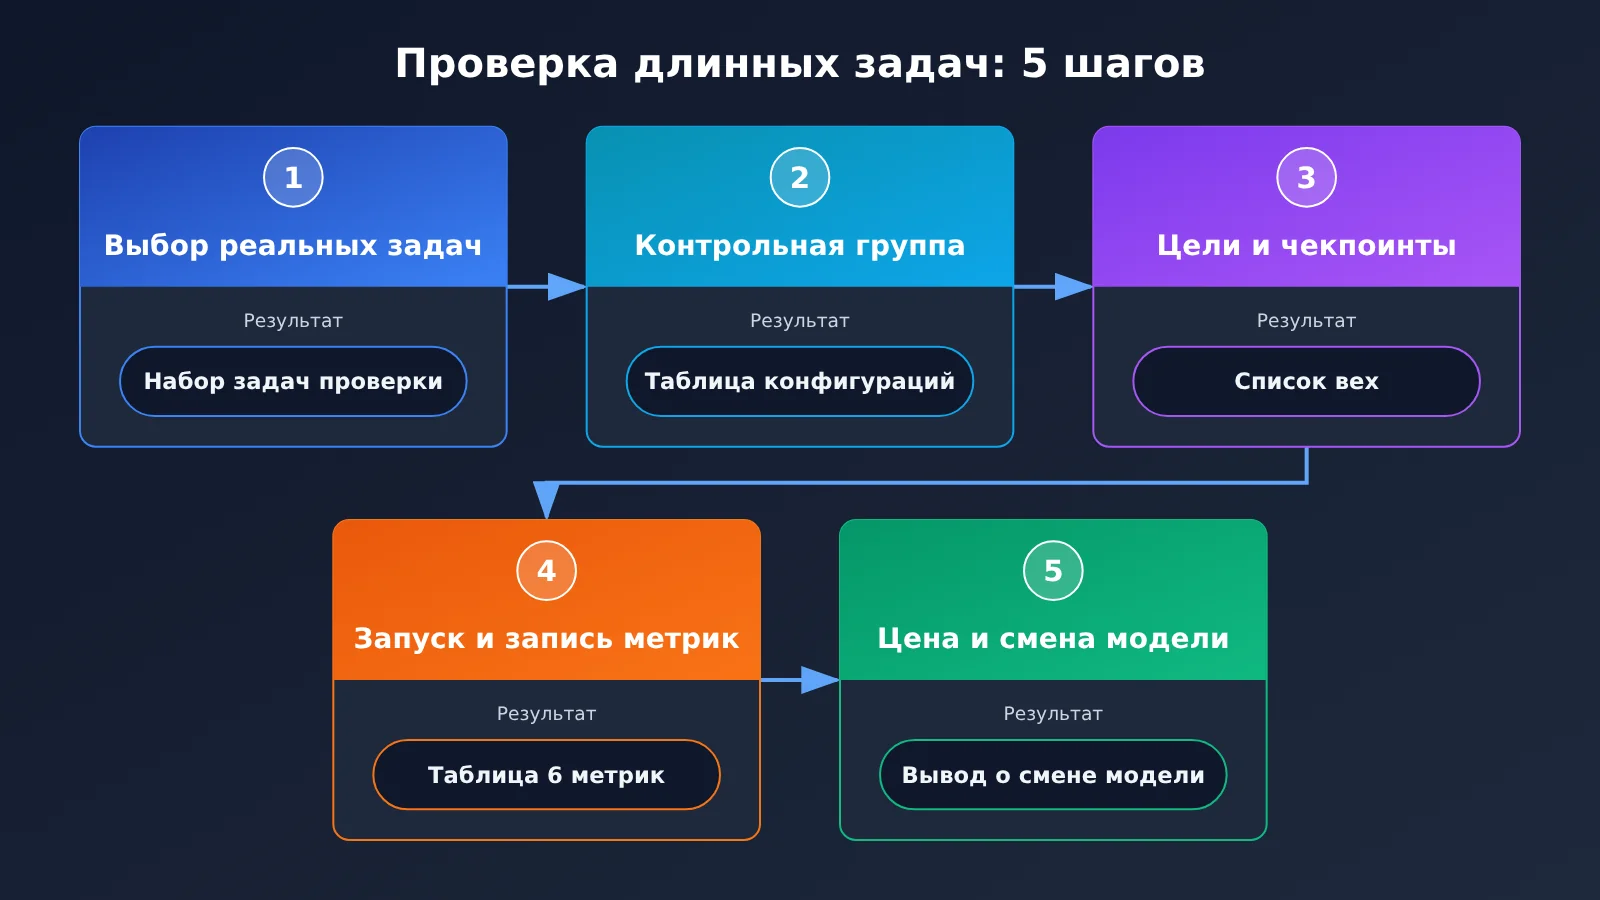
Быстрый старт проверки новых моделей на многошаговых задачах: процесс из 5 шагов
Этот процесс не зависит от какого-либо конкретного фреймворка. Если вызовы моделей у вас идут через единый интерфейс, можно с небольшими затратами переключать модели и сравнивать их.
Шаг 1. Выделите многошаговые задачи из реального бизнеса
Валидационный набор важен не размером, а тем, насколько он «похож» на реальность. Рекомендую выбрать 3–5 задач, покрывающих три типа сценариев, которые чаще всего встречаются в вашем бизнесе, требуют больше всего ручного труда и чаще всего дают сбои. Лучше, чтобы каждая задача удовлетворяла трём условиям: «не менее 10 шагов, нужно вызывать инструменты, есть чёткий результат».
Для своих версий можно ориентироваться на несколько типичных классов многошаговых задач:
- Пакетная обработка документов: даёте папку с десятком с лишним материалов и просите по каждому сделать краткое резюме, подготовить материалы для отчёта, а затем свести всё в таблицу и отчёт.
- Разработка приложений: начиная с описания требований, пройти разработку, самопроверку, доработку и в итоге выдать работающий продукт.
- Мультимодальное воспроизведение: загружаете скриншот или запись экрана и просите модель понять содержимое и воспроизвести соответствующий интерфейс или взаимодействие.
- Работа с компьютером: модель смотрит на экран, находит кнопки, кликает и вводит данные, выполняя межпрограммный сценарий.
Шаг 2: Зафиксируйте контрольную группу и среду выполнения
Ключ к сравнительному эксперименту — «менять только одну переменную». Старая и новая модели должны использовать один и тот же системный промпт, одинаковый набор определений инструментов и одни и те же входные материалы. Рекомендуется запускать каждую задачу не менее 3 раз и брать среднее и худшее значения, поскольку случайность в многошаговых задачах гораздо выше, чем в одиночных вопросах-ответах.
| Параметр конфигурации | Рекомендуемая настройка | Пояснение |
|---|---|---|
model |
Текущая модель vs новая модель | Единственный параметр, который разрешено менять |
temperature |
Одинаковое в обеих группах, рекомендуется пониже | Снижает влияние случайности на выводы |
max_tokens |
Оставить запас под самый длинный вывод по задаче | Чтобы из-за обрезки не сделать ложный вывод о возможностях модели |
Определение инструментов tools |
Абсолютно одинаковый список функций и описаний | Различия в описаниях инструментов заметно влияют на то, как модель вызывает инструменты |
| Системный промпт | Одна и та же версия, без оптимизации под новую модель | Сначала тестируем «из коробки», затем — после настройки |
| Число повторов | Не менее 3 раз на задачу | Оцениваем стабильность, а не лучший результат |
Если в вашем проекте одновременно используются интерфейсы в стиле OpenAI и Anthropic, переключение модели часто означает смену SDK, изменение аутентификации и формата запросов — из-за этого сравнительный эксперимент становится очень неудобным. Если вызывать модели через единую платформу-агрегатор API, для переключения достаточно изменить только поле model.
🚀 Совет для быстрого старта: APIYI apiyi.com предоставляет доступ к API основных моделей, упомянутых в статье, и одновременно совместим с форматами интерфейсов OpenAI и Anthropic. Для сравнительного эксперимента достаточно заменить параметр
model, чтобы переключаться между старой и новой моделями. Способ подключения,base_urlи настройку аутентификации смотрите в центре документации APIYI docs.apiyi.com.
Шаг 3: Задайте целевые ориентиры и контрольные точки
Самая частая причина провала длинных задач — вовсе не «не умеет делать», а «делал-делал и забыл, что нужно было сделать». В референсном тестировании использовалась команда /goal, чтобы модель постоянно держала в голове конкретную цель, — этот подход можно перенести в любое окружение проверки. В начале задачи чётко опишите конечную цель и разбейте результат на несколько проверяемых этапов.
Возьмём для примера задачу «реалистичная 3D мини-игра»: тестировщики разбили цель на 5 пунктов — игровая сцена, визуал и ощущение управления, звук и геймплей, рабочий процесс, финальная сдача. Вашу задачу стоит разбивать так же: каждый этап — это контрольная точка, по которой можно объективно судить «сделано / не сделано». Тогда и последующая оценка станет намного проще.
Шаг 4: Запустите и зафиксируйте 6 метрик
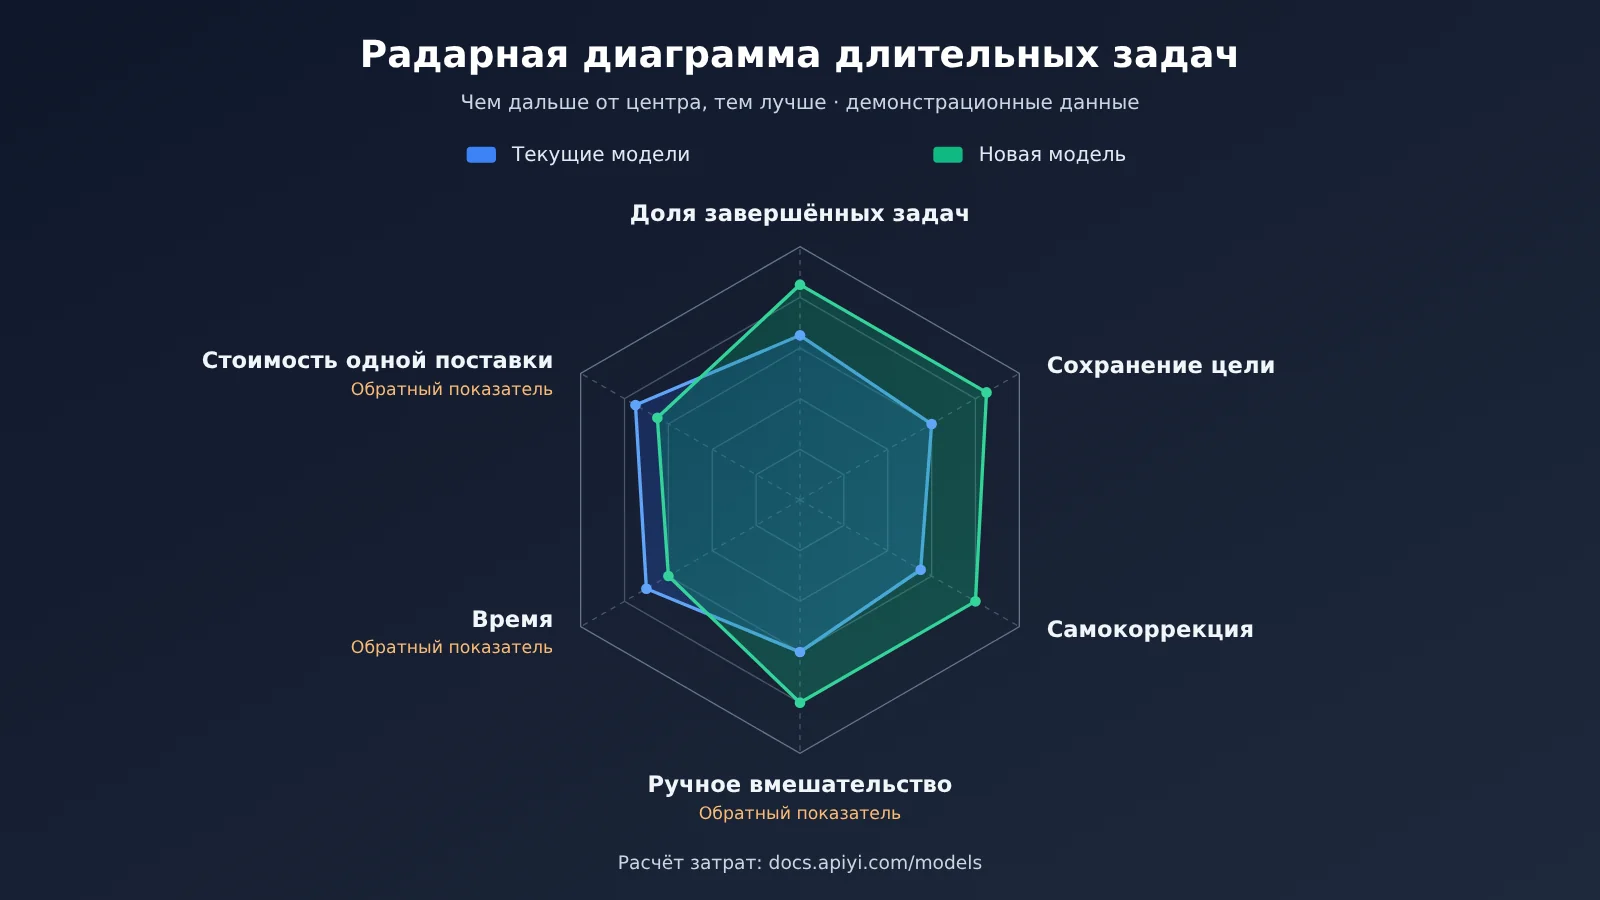
При каждом запуске сохраняйте полные логи диалога и вызовов инструментов, а затем оценивайте по таблице ниже. Первые 4 пункта показывают, «можно ли довести до конца», последние 2 — «выгодно ли это».
| Метрика | Как измерять | Как оценивать |
|---|---|---|
| Доля выполненных задач | Число пройденных контрольных точек / общее число контрольных точек | В процентах, среднее по 3 запускам |
| Удержание цели | Продвигается ли модель во второй половине работы к изначальной цели, нет ли пропусков и ухода в сторону | Ручная оценка от 1 до 5 |
| Способность к самокоррекции | Может ли модель сама исправить ошибку (сбой, провал теста) по ходу работы | Записывать «число ошибок / число самовосстановлений» |
| Число вмешательств человека | Сколько раундов потребовалось на ручные пояснения или корректировку | Чем меньше, тем лучше |
| Затраченное время | Фактическое время от постановки задачи до сдачи | В минутах, включая время работы инструментов |
| Стоимость одной сдачи | Общая стоимость в токенах / число успешных сдач | Считать по фактическому тарифу |
На «число вмешательств человека» стоит обратить особое внимание. Вывод референсного тестирования таков: Hy4 в большинстве повседневных офисных и творческих задач справляется практически с первого раза, но в работе с большим объёмом операций на компьютере и в сложных процессах всё ещё нужны несколько раундов взаимодействия, чтобы модель поняла замысел. Именно эту разницу вам и нужно измерить в своей задаче: одно вмешательство — это одна единица человеческих затрат.
Шаг 5: Считаем затраты и принимаем решение о смене модели
Считать затраты нужно в пересчёте на «одну успешную сдачу», а не просто сравнивать цену входных и выходных токенов. Модель, у которой цена за токен ниже, но которую приходится перезапускать дважды, на деле может обойтись дороже. У длинных задач есть ещё одна особенность: контекст раз за разом тащит за собой историю, поэтому доля попаданий в кэш сильно влияет на итоговый счёт.
Логика расчёта такая: стоимость одной задачи = входные токены без попадания в кэш × цена входных токенов + входные токены с попаданием в кэш × цена кэша + выходные токены × цена выходных токенов; затем суммарную стоимость нескольких прогонов делим на число успешных сдач. Цены на входные и выходные токены, стоимость кэша и правила тарификации по каждой модели сверяйте с фактическими данными на странице цен APIYI docs.apiyi.com/models — в этой статье мы не приводим конкретные цифры, чтобы изменения цен никого не ввели в заблуждение.
💰 Подсказка по расчёту затрат: при сравнении лучше вызывать обе модели — старую и новую — на одной платформе: тогда статистика расхода и правила тарификации совпадают, и полученная «стоимость одной сдачи» будет действительно сопоставимой. На странице цен APIYI docs.apiyi.com/models перечислены цены на входные, выходные токены и кэш для каждой модели — их можно брать за основу расчёта.
Критерии принятия решений при валидации новых моделей на длительных задачах
Когда данные собраны, самое неприятное — это «у каждого свои плюсы, и непонятно, что выбрать». Поэтому правила принятия решения лучше написать ещё до начала эксперимента. Таблица ниже — отправная точка, пороги можно подкрутить под чувствительность вашего бизнеса.
| Результат сравнения | Рекомендуемое решение | Причина |
|---|---|---|
| Доля выполненных задач заметно выросла, стоимость одной поставки не изменилась или снизилась | Переключиться сразу | Выигрыш и по качеству, и по стоимости |
| Доля выполненных задач заметно выросла, стоимость выросла | Переключать по сценариям | Новую модель использовать только на дорогих и сложных задачах |
| Доля выполненных задач не изменилась, стоимость заметно снизилась | Поэтапное (канареечное) переключение | Сначала заменить на низкорисковых задачах и понаблюдать |
| Доля выполненных задач не изменилась, число вмешательств сократилось | Скорее переключиться | Сэкономленный человеческий труд обычно дороже расходов на токены |
| Доля выполненных задач упала или стабильность ухудшилась | Пока не переключаться | Дождаться следующей версии или перепроверить после доработки промпта |
Есть ещё одно измерение, которое легко упустить, — перестройка задач благодаря новым возможностям. Например, у Hy4 в этот раз появилось визуальное понимание: модель может напрямую читать запись экрана и анализировать её покадрово, а ещё — постоянно делать скриншоты собственных результатов и дорабатывать их по обратной связи. Если в вашем старом процессе человек вручную превращал скриншоты в текстовые описания, новая модель может дать не «та же задача, но лучше», а «весь процесс стал на шаг короче». Такую выгоду стоит фиксировать отдельно и не мерить только оценками на старых задачах.
Как выбирать при сравнении с популярными моделями
При сравнении обычно прогоняют новую модель, текущую рабочую модель и других кандидатов того же уровня. В таблице ниже — подход к выбору; конкретные возможности проверяйте на своих длительных задачах.
| Тип кандидата | Какие длительные задачи подходят | На что смотреть при проверке | Доступная платформа |
|---|---|---|---|
| Недавно выпущенная открытая или китайская модель | Пакетная обработка офисных документов, агент для китайскоязычных сценариев | Удержание цели, соотношение цены и качества | APIYI apiyi.com и др. |
| Текущая основная проприетарная модель | Сложное программирование, трудные задачи на рассуждение | Как базовая линия качества | APIYI apiyi.com и др. |
| Модель с мультимодальными возможностями | Воспроизведение по скриншотам/записи экрана, понимание интерфейсов | Точность визуального понимания, самокоррекция | APIYI apiyi.com и др. |
| Лёгкая быстрая модель | Раздача подзадач, приведение формата | Время выполнения и стоимость | APIYI apiyi.com и др. |
💡 Совет по выбору: не сравнивайте с текущей моделью только одного кандидата. Если через единый интерфейс добавить в один и тот же набор проверок два-три кандидата, часто находится лучшее решение — «комбинировать модели по сценариям». APIYI поддерживает единый вызов множества популярных моделей, так что такую комбинацию легко внедрить.
Частые вопросы (FAQ)
В1: Что такое проверка новой модели на длинных задачах?
Проверка на длинных задачах — это тестирование модели на реальных сценариях, где есть несколько шагов, требуется вызывать инструменты и на выходе получается конкретный результат. Здесь важно не качество ответа в одном ходе, а способность модели удерживать цель на протяжении всей цепочки шагов, самостоятельно исправлять ошибки и то, во сколько в итоге обходится финальный результат.
В2: Чем проверка на длинных задачах отличается от публичных Benchmark?
Benchmark хорошо подходит для сравнения моделей по общим способностям, но задачи в нём далеки от вашего бизнеса и чаще всего представляют собой короткие цепочки. Проверка на длинных задачах проходит прямо на вашем наборе инструментов и данных и вскрывает такие проблемы, как потеря цели, неправильное использование инструментов и необходимость снова и снова поправлять модель вручную. Надёжнее всего сочетать оба подхода: сначала отобрать кандидатов по рейтингам, а окончательное решение принимать по своим задачам.
В3: Когда лучше начинать проверку после выхода новой модели?
Лучше как можно скорее прогнать тест «из коробки» — многие новые модели на старте доступны бесплатно или в ознакомительный период. В материалах, на которые мы ссылаемся, у Hy4 в WorkBuddy был бесплатный период с 4 по 15 ноября. Если первый прогон дал хорошие результаты, стоит потратить время на второй этап — подстроить промпты под новую модель.
В4: Сколько задач нужно в проверочном наборе?
Обычно достаточно 3–5 задач, максимально близких к бизнесу, причём каждую стоит повторить 3 раза, чтобы увидеть стабильность. Лучше не набирать количество, а покрыть самые частые, самые трудозатратные и самые подверженные ошибкам сценарии, а для каждой задачи продумать понятные контрольные точки.
В5: Как с минимальными затратами переключаться между моделями для сравнения?
Проще всего вызывать модели через единую платформу с общим интерфейсом. APIYI apiyi.com поддерживает оба формата — OpenAI и Anthropic, поэтому для смены модели достаточно поменять параметр `model`, а описание инструментов и промпты остаются прежними. Подробные шаги подключения есть в центре документации docs.apiyi.com.
В6: Как правильно считать стоимость длинных задач?
Считать нужно по «стоимости одного успешного результата»: общую стоимость токенов за все прогоны делим на число успешных выполнений, отдельно выделяя входные токены с попаданием в кэш и без него. Цены за токены и за кэш у конкретных моделей смотрите на странице цен APIYI docs.apiyi.com/models — единая тарификация на одной платформе делает сравнение честнее.
В7: Какие ограничения есть у проверки на длинных задачах?
Во-первых, выборка маленькая: и блестящий результат, и провал могут оказаться случайностью, поэтому прогоны нужно повторять. Во-вторых, ручная оценка субъективна — лучше, чтобы двое независимо выставили баллы, а потом усреднить. В-третьих, результат сильно зависит от цепочки инструментов: после смены фреймворка Agent тестирование придётся повторить. Кроме того, потолок возможностей модели часто определяется сложностью тестовых задач, поэтому проверочный набор стоит регулярно пополнять более трудными задачами.
Ключевые выводы: проверка новых моделей на длительных задачах
- Опирайтесь на собственные задачи: 3–5 реальных многошаговых задач покажут выгоду от смены модели точнее любого лидерборда.
- Меняйте только одну переменную: у старой и новой модели должны быть одинаковые промпты, инструменты и входные данные; каждую задачу прогоняйте минимум 3 раза.
- Без целевых ориентиров не обойтись: разбивайте задачу на этапы по логике
/goal; чем объективнее контрольные точки, тем точнее оценка. - Смотрите на 6 метрик целиком: доля выполненных задач, удержание цели, самокоррекция, число вмешательств, затраченное время, стоимость выполнения.
- Считайте стоимость по результату: учитывайте попадания в кэш, а за основу тарификации берите страницу цен APIYI docs.apiyi.com/models.
- Следите за перестройкой процесса: новые возможности вроде понимания изображений могут сразу убрать ручные этапы из старого процесса.
Итого
Ключевые моменты проверки новых моделей на длительных задачах:
- Реальные задачи: валидационная выборка берётся из бизнеса и покрывает частые, длительные и подверженные ошибкам сценарии.
- Строгое сравнение: фиксированная среда, повторные прогоны и заранее заданные критерии перехода на новую модель.
- Честный расчёт: реальную выгоду измеряйте стоимостью одного успешного выполнения и количеством ручных вмешательств.
Каждый релиз новой модели — это повод ещё раз пересмотреть рабочий процесс. Вместо того чтобы слепо следовать лидербордам и демо-видео, лучше потратить день-два и получить однозначный ответ на своих длительных задачах. Рекомендую через APIYI apiyi.com быстро сравнить старую и новую модели в одном наборе интерфейсов: инструкция по подключению — на docs.apiyi.com, данные по тарификации — на docs.apiyi.com/models.
📚 Справочные материалы
- 爱范儿 — практическое тестирование Tencent Hy4: реальные кейсы использования Hy4 для длительных задач, мультимодальности и работы с компьютером.
- Ссылка:
ifanr.com/1687613 -
Описание: содержит примеры дизайна тестов, которые можно взять на вооружение, — ограничение цели через
/goal, разработка игры в рамках длительной задачи, пакетная обработка документов и т. д. -
Центр документации APIYI: описание подключения моделей и форматов интерфейсов.
- Ссылка:
docs.apiyi.com -
Описание: узнайте, как настроить интерфейсы, совместимые с OpenAI и Anthropic.
-
Страница цен на модели APIYI: цены на вход, выход и кэширование для каждой модели.
- Ссылка:
docs.apiyi.com/models - Описание: единственный источник ценовых данных для расчёта затрат.
Автор: техническая команда APIYI
Обратная связь: будем рады вашему сообщению — свяжитесь с нами на главной странице APIYI apiyi.com. Больше материалов по подключению моделей — в центре документации docs.apiyi.com.