Примечание автора: отталкиваясь от метафоры Лай Цзе из «Синчэнь Чжинэн» — «не взимайте с меня плату за токены за каждый вкрученный винт», — разбираемся, какие этапы AI-воркфлоу стоит поручить фиксированным программам, а где действительно нужны решения большой языковой модели.
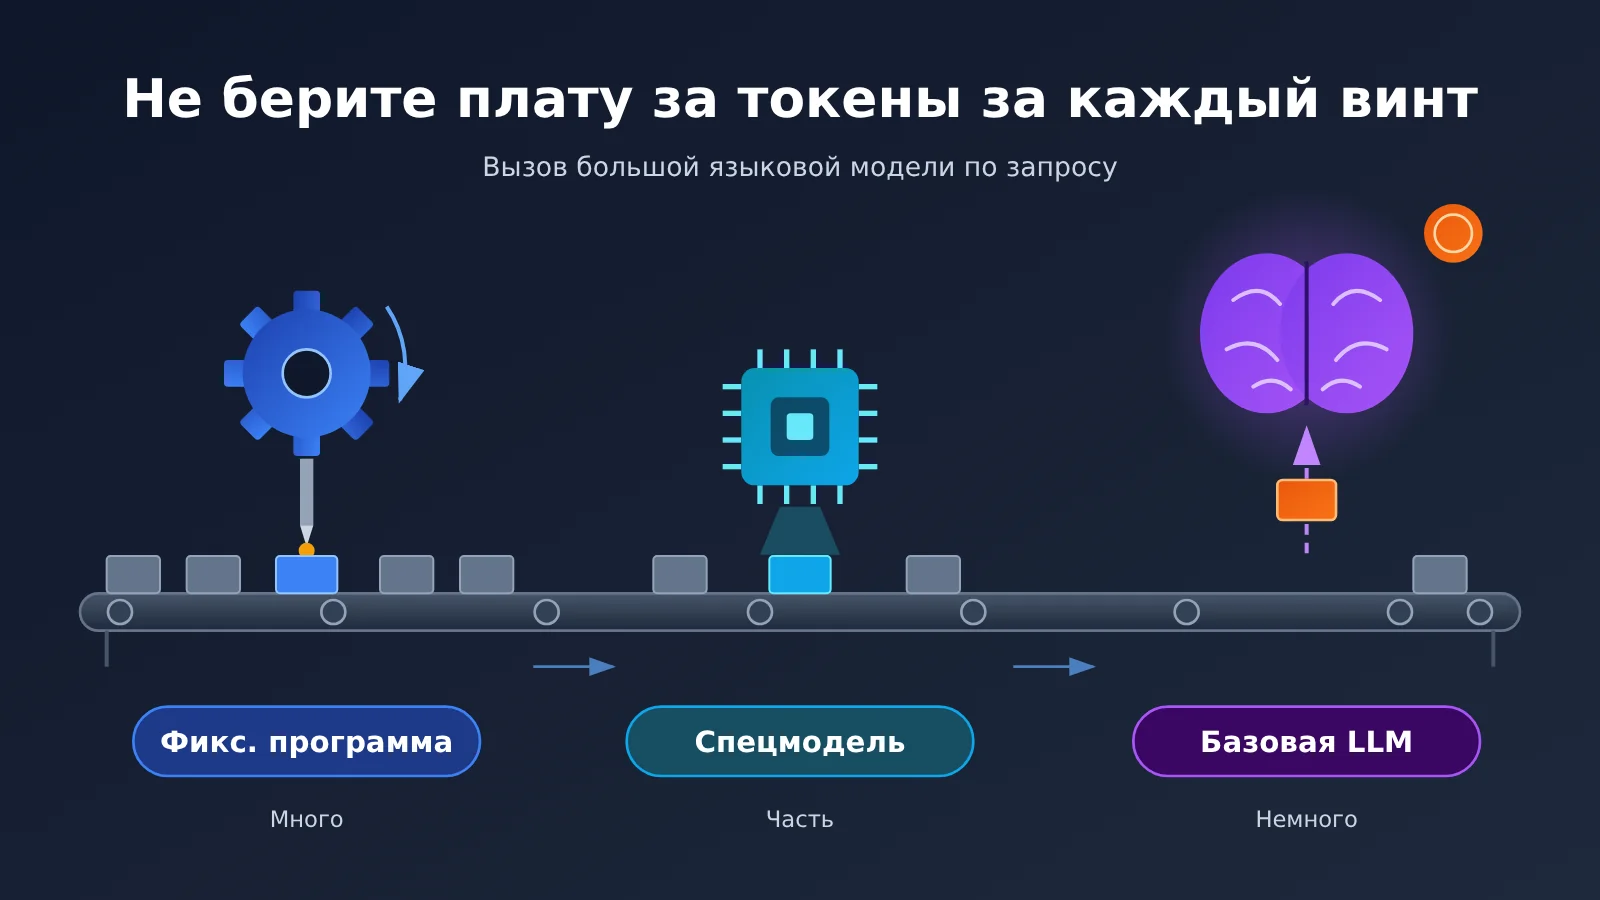
5 ноября 2026 года рубрика «Многообразие компаний» издания «Айфаньэр» опубликовала интервью с основателем и CEO «Синчэнь Чжинэн» Лай Цзе. Одну его фразу разработчики AI-приложений цитировали особенно часто: «Я хочу, чтобы винты вкручивала фиксированная программа, которая работает 24 часа в сутки, — не взимайте с меня плату за токены за каждый винт».
Это не просто шутка. В интервью Лай Цзе говорил о разделении задач в робототехнике: модель воплощённого ИИ отвечает за физические действия, а при возникновении проблем обращается к базовой большой языковой модели на естественном языке. Если перенести эту идею на программные воркфлоу, получится вполне практический вопрос: на каких этапах AI-приложения вообще не стоит вызывать большую языковую модель?
Главное в статье: мы переносим взгляд на работу роботов из интервью на проектирование границ вызова моделей в программных воркфлоу. Рассмотрим 5 типов задач, для которых не нужна большая языковая модель, набор критериев для выбора подходящего уровня и пример кода маршрутизации, который можно адаптировать под свои задачи. Сразу оговоримся: роботы и программное обеспечение — разные системы, поэтому дальше речь пойдёт об аналогии. Её эффективность нужно проверять на собственных сценариях и объёмах использования.
«Не берите с меня плату за токены за каждый закрученный винт»: главное вкратце
Эта фраза прозвучала в ответе на последний вопрос интервью. Когда Лай Цзе спросили, от чего роботы должны помочь избавить людей, он ясно дал понять: он не хочет, чтобы роботов отправляли «на завод закручивать винты». С одной стороны, он считает, что ценность роботов — в разнообразии их возможностей. С другой — с точки зрения затрат при выполнении повторяющейся работы не стоит платить за токены при каждом действии.
| Пункт | Подробности |
|---|---|
| Источник | 15-е интервью в рубрике «多样性公司» издания 爱范儿 |
| Дата публикации | 5 ноября 2026 года |
| Собеседник | Лай Цзе, основатель и CEO 星尘智能, ранее — первый сотрудник лаборатории робототехники Tencent Robotics X |
| Главная мысль | Повторяющиеся действия стоит поручать фиксированным программам, а не платить за токены каждый раз |
| Распределение задач | Модель для управления роботом выполняет физические действия, а при возникновении проблем обращается к базовой большой языковой модели на естественном языке |
| Вывод для программного обеспечения | В AI-процессах нужно разграничить, когда используются фиксированные программы, специализированные модели и базовые большие языковые модели |
Важно подчеркнуть: в интервью изложена точка зрения основателя, но нет ни результатов измерения затрат, ни данных, подтверждённых третьими сторонами. Мы заимствуем саму логику разделения задач, а не какие-либо конкретные выводы.
Сравнение Лай Цзе со звонком маме: большая языковая модель лишь дополняет контекст
В интервью есть сравнение, которое объясняет распределение задач лучше, чем пример с «закручиванием винтов». Лай Цзе говорит: если он не умеет готовить, но хочет попробовать, то звонит маме по видеосвязи. Мама скажет: «Сначала налей немного масла на горячую сковороду», но ей не нужно объяснять, в какой бутылке находится масло. А если возникнут вопросы, можно переспросить. Главное: мама помогает недостающими знаниями, но наливать масло нужно уметь самому — она на другом конце провода и не может сделать это за тебя.
В случае с роботом модель воплощённого интеллекта должна сама воспринимать физические параметры: вес предмета, силу захвата и то, насколько надёжно он удерживается. К базовой большой языковой модели она обращается только с вопросами вроде «Предмет выскальзывает, захват ненадёжный — что делать?». По мнению Лай Цзе, обучить базовую большую языковую модель работать с тактильными данными «не то чтобы невозможно, но это неоправданно дорого, к тому же возникнут проблемы с пропускной способностью канала связи». Он также добавляет, что речь не просто о разделении на уровни, а скорее об организации агентов по принципу муравьиной колонии: каждый агент по отдельности может быть не слишком силён, но вместе они способны на многое.
| Роль в системе робота | Задача по версии интервью | Аналог в программном рабочем процессе |
|---|---|---|
| Фиксированная программа | Круглосуточно повторяет закручивание винтов | Движок правил, регулярные выражения, скрипты, запросы к базе данных |
| Модель воплощённого интеллекта | Выполняет физические действия, воспринимает параметры, переводит состояние на естественный язык | Специализированные малые модели для классификации, извлечения данных, векторного поиска и других задач |
| Базовая большая языковая модель | Дополняет контекст знаниями, предлагает решения сложных проблем | Сложные рассуждения, открытая генерация, принятие решений в нештатных ситуациях |
| Операционная система AOS | Оформляет возможности в модули навыков и обеспечивает их совместимость с большой языковой моделью и агентами | Слой оркестрации рабочих процессов, слой вызова инструментов, маршрутизатор |
Эта таблица — наша интерпретация, а не цитата из интервью. Роботам приходится управлять действиями в физическом мире в реальном времени и учитывать ограничения пропускной способности связи. В программных рабочих процессах важнее стоимость токенов, задержка и стабильность. Так что узкие места в этих двух случаях не вполне совпадают.
На каких этапах AI-приложению не нужна большая языковая модель: 5 критериев
Создавая первую версию агента, многие команды поручают большой языковой модели каждый шаг: проверку формата, преобразование дат и даже «проверку, не пусто ли поле». На этапе прототипа это быстро и удобно. Но после запуска приходится платить за детерминированные операции при каждом запросе, к тому же в процесс добавляется ненужная случайность.
Если смотреть на рутинные операции как на «закручивание винтов», можно выделить пять критериев, которые помогут решить, стоит ли вызывать большую языковую модель на том или ином этапе.
| Критерий | Фиксированная программа | Специализированная модель | Базовая большая языковая модель |
|---|---|---|---|
| Структура входных данных | Фиксированные поля, чёткий формат | Полуструктурированный текст | Произвольный текст на естественном языке |
| Однозначность результата | Есть единственный правильный ответ | Ограниченное число категорий | Возможны разные разумные ответы |
| Можно ли перечислить все правила | Можно записать через if/else | Правил много, но закономерности стабильны | Все правила перечислить невозможно |
| Цена ошибки | Ошибки недопустимы | Небольшое число ошибок допустимо при последующей проверке | Нужно учитывать разные факторы |
| Частота вызовов | Очень высокая, выполняется при каждом запросе | Высокая | Низкая, по необходимости |
Рутинные операции, которые лучше поручить программе
Следующие задачи обычно похожи на «закручивание винтов»: они детерминированные и часто повторяются. Использование большой языковой модели для них, напротив, снижает стабильность:
- Проверка и очистка данных: проверку электронной почты, номера телефона, структуры JSON и обязательных полей можно выполнить с помощью регулярных выражений и проверки по схеме.
- Запросы к данным и вычисления: статус заказа, количество товара на складе и итоговые суммы следует получать напрямую из базы данных или через бизнес-API, а не просить большую языковую модель их «вычислить».
- Вывод по фиксированному шаблону: для SMS-уведомлений, стандартных подтверждений и заголовков отчётов достаточно подставить переменные с помощью шаблонизатора.
- Управление процессом и повторные попытки: переходы между ветками, повторы при тайм-аутах, ограничение частоты запросов и очереди относятся к логике оркестрации и не требуют участия модели.
- Часто повторяющиеся запросы: если один и тот же вопрос задают многократно, сначала проверьте кеш или базу FAQ и при совпадении сразу верните ответ.
Когда действительно нужна большая языковая модель
Базовую большую языковую модель стоит вызывать для «вопросов, на которые может ответить только мама на другом конце телефона»: когда намерение пользователя неясно и его нужно уточнить, когда требуется обобщить несколько источников и сделать вывод, возникла не предусмотренная правилами ситуация или нужно создать что-то оригинальное. У таких задач есть общие черты: ответ не единственный, все правила перечислить невозможно, а возникают они относительно редко.
Специализированные модели занимают промежуточное место. С классификацией намерений, извлечением сущностей, определением тональности и векторизацией текста часто справляются модели меньшего размера. Их можно представить как программный аналог «воплощённой модели»: она самостоятельно выполняет то, что ей по силам, а случаи, с которыми не справилась, передаёт на следующий уровень в виде чётко сформулированного вопроса.
Пример многоуровневого AI-воркфлоу: отсеиваем этапы, где большая языковая модель не нужна
На примере типичного процесса автоматической обработки обращений в поддержку разберём, как определить границы вызова модели на каждом этапе. Это пример проектирования, а не результаты тестирования реального проекта.
| Этап воркфлоу | Ответственный уровень | Способ обработки | Расход токенов |
|---|---|---|---|
| Проверка полей обращения | Обычная программа | Проверка по схеме; при отсутствии полей обращение сразу возвращается | Нет |
| Запрос статуса заказа и доставки | Обычная программа | Вызов интерфейса базы данных | Нет |
| Поиск ответа на частый вопрос | Обычная программа / специализированная модель | Сначала правила по ключевым словам, затем векторный поиск, если совпадений нет | Небольшой |
| Классификация намерения | Специализированная модель | Небольшая модель выбирает категорию из ограниченного набора | Небольшой |
| Обработка сложных жалоб и нештатных ситуаций | Базовая большая языковая модель | Генерация рекомендаций с учётом контекста заказа | Да |
| Заполнение шаблона ответа | Обычная программа | Шаблонизатор формирует итоговый текст | Нет |
Как видите, из шести этапов только на одном обязательно нужна базовая большая языковая модель. Сколько именно токенов удастся сэкономить, снизится ли доля успешных обработок и как изменится задержка — зависит от структуры обращений и охвата правил. Оценить это можно только по реальным логам.
Минимальный пример: сначала правила, затем модели
Этот код показывает простейший вариант многоуровневой маршрутизации: сначала правила обрабатывают рутинные запросы, затем небольшая модель классифицирует остальные, и только в сложных случаях вызывается большая языковая модель. Названия моделей приведены для примера — сверяйтесь со списком моделей, доступных на платформе.
import re
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

def handle(query: str) -> str:
    # Первый уровень: если задачу можно решить правилами, модель не вызывается
    if re.search(r"(订单号|单号)\s*[::]?\s*\d{8,}", query):
        return "已为您查询订单状态(走业务接口,不消耗 token)"
    # Второй уровень: небольшая модель классифицирует намерение
    intent = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": f"只输出类别(咨询/投诉/其他):{query}"}],
        max_tokens=5,
    ).choices[0].message.content.strip()
    if intent != "投诉":
        return f"已归类为:{intent},转入标准流程"
    # Третий уровень: большая языковая модель вызывается только для сложных жалоб
    return client.chat.completions.create(
        model="claude-sonnet-4",
        messages=[{"role": "user", "content": f"请给出投诉处理建议:{query}"}],
    ).choices[0].message.content
Посмотреть полный код с учётом использования
import re
import time
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SMALL_MODEL = "gpt-4o-mini"       # Пример: небольшая модель для классификации и извлечения данных
LARGE_MODEL = "claude-sonnet-4"   # Пример: большая языковая модель для сложных рассуждений

@dataclass
class UsageLog:
    records: list = field(default_factory=list)

    def add(self, layer: str, tokens: int, latency: float):
        self.records.append({"layer": layer, "tokens": tokens, "latency": latency})

    def summary(self):
        result = {}
        for r in self.records:
            s = result.setdefault(r["layer"], {"count": 0, "tokens": 0, "latency": 0.0})
            s["count"] += 1
            s["tokens"] += r["tokens"]
            s["latency"] += r["latency"]
        return result

log = UsageLog()

RULES = [
    (re.compile(r"(订单号|单号)\s*[::]?\s*\d{8,}"), "order_lookup"),
    (re.compile(r"(营业时间|几点开门)"), "faq_hours"),
]

def rule_layer(query: str):
    for pattern, action in RULES:
        if pattern.search(query):
            return action
    return None

def call_model(model: str, prompt: str, layer: str, max_tokens: int = 512) -> str:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    tokens = resp.usage.total_tokens if resp.usage else 0
    log.add(layer, tokens, time.time() - start)
    return resp.choices[0].message.content.strip()

def handle(query: str) -> str:
    start = time.time()
    action = rule_layer(query)
    if action:
        log.add("rule", 0, time.time() - start)
        return f"[规则层] 执行动作:{action}"

    intent = call_model(
        SMALL_MODEL,
        f"只输出一个类别(咨询/投诉/其他),不要解释:{query}",
        layer="small",
        max_tokens=5,
    )
    if "投诉" not in intent:
        return f"[专用模型层] 归类为:{intent}"

    return call_model(
        LARGE_MODEL,
        f"你是资深客服主管,请针对以下投诉给出处理建议:{query}",
        layer="large",
    )

if __name__ == "__main__":
    for q in ["订单号:2026110612345 到哪了", "你们营业时间是?", "收到的商品破损,客服一直不回复"]:
        print(handle(q))
    print(log.summary())
🚀 Совет для быстрого старта: чтобы получить достоверные результаты при многоуровневой маршрутизации, важно переключать модели на разных уровнях через один и тот же интерфейс и отслеживать расход. Через APIYI apiyi.com можно вызывать небольшие и большие модели с одним API-ключом, а затем сравнивать расход токенов на каждом уровне с помощью статистики платформы. Новые пользователи могут проверить прототип, используя бесплатный тестовый лимит.
Что меняет подход «не взимайте плату за токены за каждый закрученный винт»
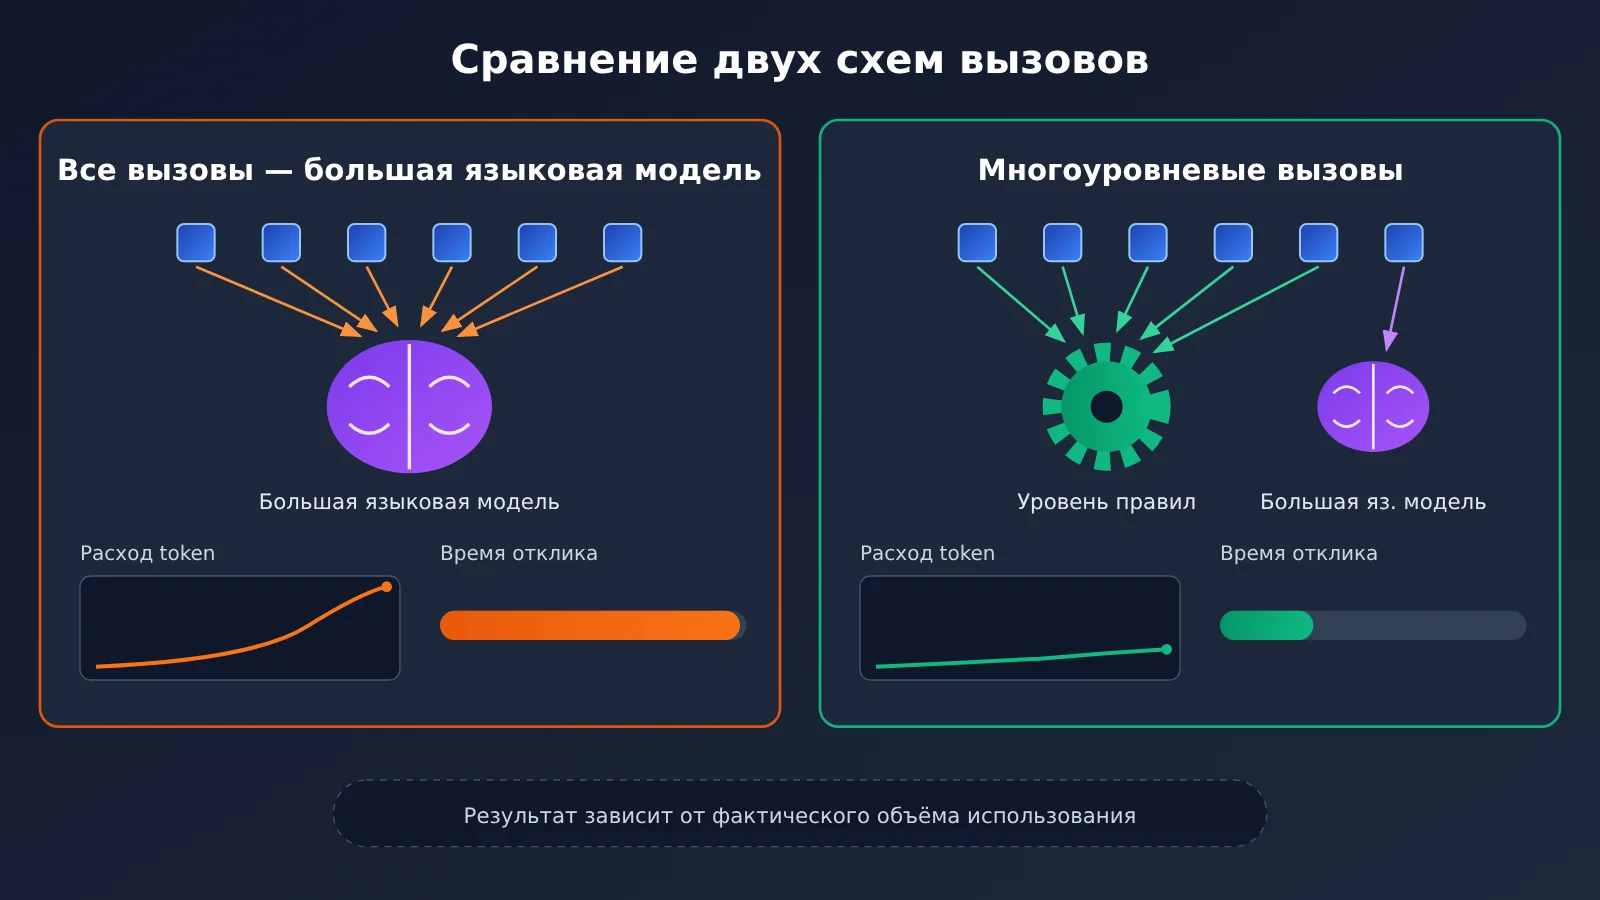
На диаграмме показана разница между двумя подходами, а не результаты замеров. Чтобы получить конкретные данные для сравнения, стоит запустить оба варианта на APIYI apiyi.com с одним и тем же набором запросов, а затем изучить статистику использования.
| Критерий | Вызов большой языковой модели на каждом этапе | Многоуровневая обработка | Доступные платформы |
|---|---|---|---|
| Скорость разработки | Быстрее всего создать прототип: достаточно написать промпт | Нужно дополнительно продумать правила и маршрутизацию | APIYI apiyi.com, официальные API разных провайдеров |
| Расход токенов | Оплачивается каждый этап | Оплачиваются в основном только сложные этапы | Те же |
| Предсказуемость результата | Даже в детерминированных задачах возможны случайные отклонения | Результаты на уровне правил предсказуемы | Те же |
| Задержка ответа | На каждом шаге нужно ждать генерации модели | Уровень правил отвечает почти мгновенно | Те же |
| Затраты на поддержку | Промпты становятся всё длиннее | Правила нужно обновлять по мере изменения бизнес-процессов | Те же |
Как это повлияет на разработчиков и создателей рабочих процессов
- Порядок проектирования изменится: вместо подхода «сначала подключим большую языковую модель, а потом подумаем, как сэкономить» нужно сначала перечислить все шаги, отметить среди них «винты» и только потом решить, где использовать модель.
- Роль специализированных моделей станет важнее: подобно тому как модель для управления роботом переводит физическое состояние на естественный язык, промежуточный уровень превращает расплывчатый ввод в структурированную задачу. Благодаря этому каждый вызов большой языковой модели становится более целевым.
- Наблюдаемость станет необходимостью: после разделения на уровни нужно отдельно отслеживать число вызовов, расход токенов и задержку на каждом из них. Иначе не получится понять, какие задачи стоит передать на более высокий или более низкий уровень.
Как это повлияет на руководителей продуктов
- Затраты станут предсказуемее: на детерминированных этапах токены не расходуются, а основная часть расходов приходится на сложные запросы, объём которых можно оценить.
- Придётся принять, что «умнее» — не всегда лучше: поиск заказа с помощью большой языковой модели может выглядеть технологичнее, но пользователю на самом деле нужны точность и скорость.
- Метрики проверки нужно определить заранее: расход токенов, доля успешно выполненных задач и сквозная задержка должны стать тремя базовыми показателями для сравнения до и после внедрения многоуровневого подхода.
Как это повлияет на отрасль
Позиция Лай Цзе отражает один из возможных подходов: хотя базовые большие языковые модели становятся всё мощнее, это не значит, что все функции нужно объединять в одной модели. Вместо этого «агенты» с разными способностями могут заниматься каждый своим делом. В программном обеспечении этот подход соответствует развитию вызова инструментов и оркестрации агентов. Однако в интервью речь шла о робототехнике. Насколько такой подход полезен для программных рабочих процессов, пока неясно: публичных данных о реальных проектах недостаточно, и проверить его на практике предстоит большему числу команд.
Частые вопросы FAQ
Q1: Что означает фраза «Не берите с меня плату за токены за каждый закрученный винт»?
Так выразился основатель Stardust Intelligence Лай Цзе в интервью изданию Aifanr в ноябре 2026 года. По его мнению, повторяющуюся работу вроде закручивания винтов на заводе робот должен выполнять по фиксированной программе круглосуточно, а не вызывать модель и платить за токены при каждом действии. В AI-приложениях действует тот же принцип: для предсказуемых и часто повторяющихся операций не стоит вызывать большую языковую модель.
Q2: Можно ли напрямую перенести многоуровневый подход из робототехники в программные процессы?
Напрямую отождествлять их нельзя. В робототехнике важны управление в реальном времени, тактильное восприятие и пропускная способность связи, а программные процессы ограничены в основном стоимостью токенов, задержкой и стабильностью. Но можно позаимствовать принцип разделения задач: «уровень исполнения справляется сам, а сложные вопросы передаются выше». Конкретную выгоду нужно проверять на практике.
Q3: Как понять, на каком этапе использовать малую модель, а на каком — большую?
Посмотрите, ограничен ли набор возможных результатов и стабильны ли правила. Для задач с ограниченным числом категорий и устойчивыми шаблонами, например классификации намерений или извлечения полей, сначала попробуйте малую модель. Задачи, требующие комплексных рассуждений, генерации произвольного текста или обработки исключений, передавайте большой языковой модели. Рекомендуем протестировать разные модели на одной и той же выборке через APIYI apiyi.com и принять решение, сравнив точность и расход токенов.
Q4: Всегда ли многоуровневая схема снижает расходы?
Не всегда. Если большинство запросов сами по себе сложные и уровень правил может обработать лишь небольшую их часть, выгода будет ограниченной. А слишком широкие правила могут ошибочно перехватывать запросы и снижать долю успешно выполненных задач. Сначала зафиксируйте текущие показатели, а затем сравните расход токенов, долю успешных выполнений и задержку до и после внедрения уровней.
Q5: Как быстро собрать прототип с многоуровневым вызовом моделей?
Можно действовать так:
1. Перечислите все шаги процесса, отметьте однотипные операции вроде «закручивания винтов» и реализуйте их с помощью правил
2. Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ, затем подключите малую и большую модели через OpenAI-совместимый интерфейс
3. Реализуйте маршрутизацию по примеру кода в этой статье и записывайте расход токенов и задержку для каждого уровня
Преимущество единого интерфейса в том, что для переключения модели достаточно изменить параметр `model` — это удобно для многократных сравнений.
Q6: Какие ошибки часто встречаются при многоуровневом проектировании?
— **Разрастание правил**: правил становится всё больше, и в итоге поддерживать их сложнее, чем промпты. Их нужно регулярно пересматривать и удалять лишние.
— **Потеря информации между уровнями**: после классификации малой моделью контекст не передаётся большой, и ей приходится разбираться в задаче заново.
— **Отсутствие запасного варианта**: если ни правила, ни малая модель не смогли принять решение, нужно предусмотреть передачу задачи большой модели или человеку.
«Не берите с меня плату за токены за каждый закрученный винт»: главное
- Источник идеи: интервью основателя Stardust Intelligence Лай Цзе изданию 爱范儿 в ноябре 2026 года.
- Распределение задач: исполнительный уровень выполняет действия самостоятельно и обращается к базовой большой языковой модели за дополнительным контекстом только в сложных случаях.
- 5 типов «винтов»: проверка формата, запросы к данным, вывод по шаблону, управление процессом и попадание в кеш — для этих задач вызывать большую языковую модель не нужно.
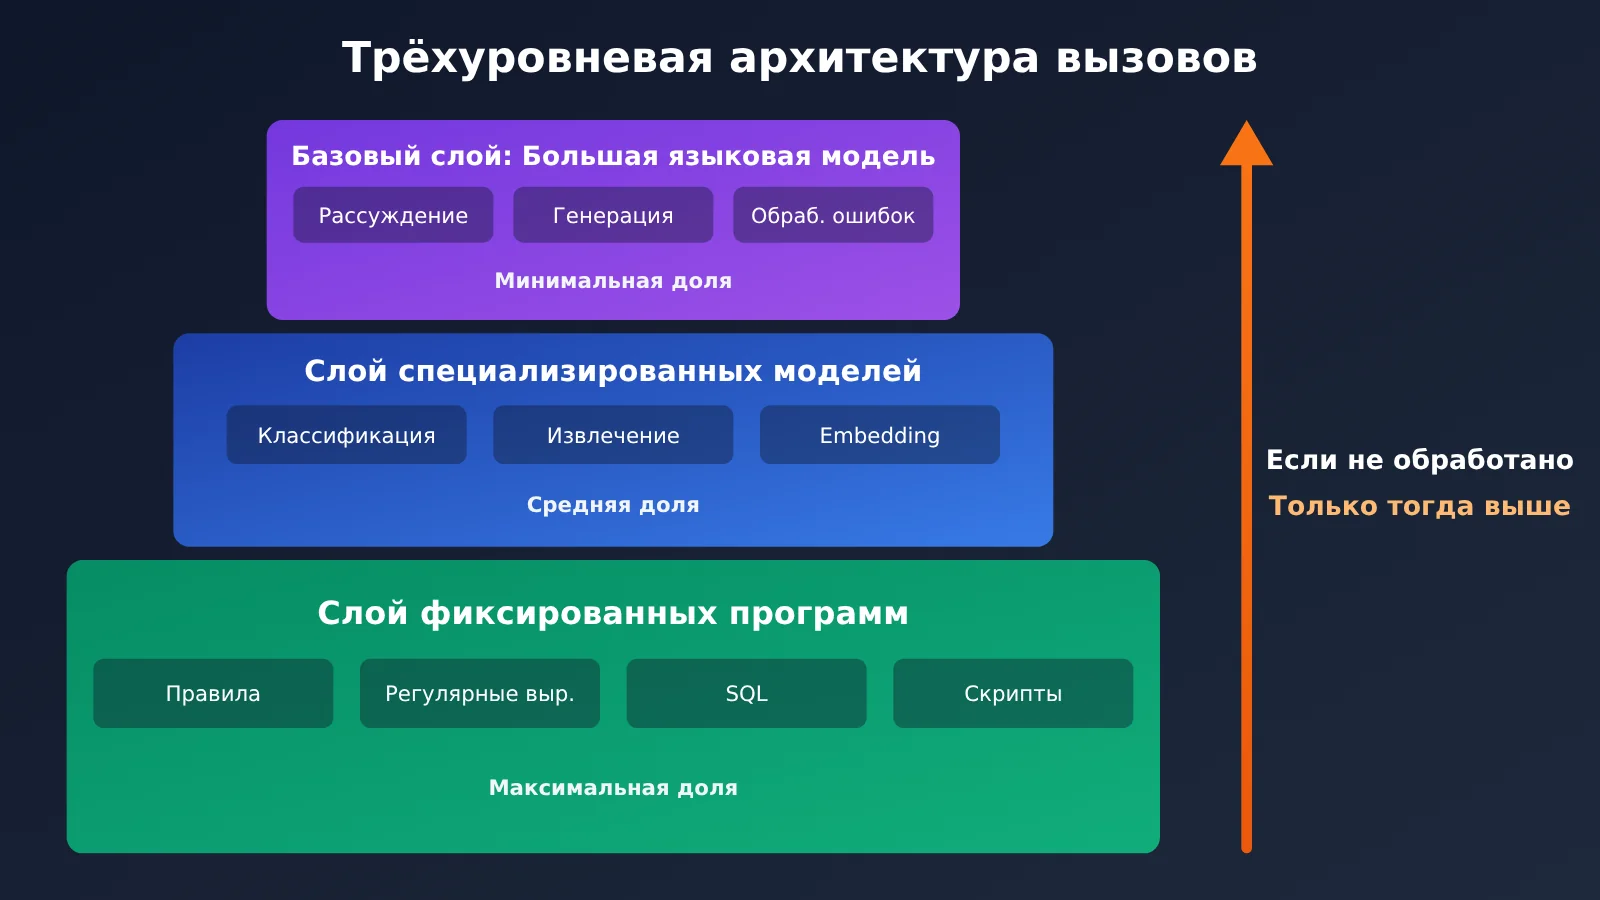
- Трёхуровневая структура: фиксированные программы составляют основу, специализированные модели занимают средний уровень, а базовая большая языковая модель решает только открытые и нештатные задачи.
- У аналогии есть границы: выводы из робототехники нельзя напрямую переносить на программное обеспечение — выгоду нужно проверять на собственных данных.
- Три показателя для проверки: сравните расход токенов, долю успешных задач и сквозную задержку до и после разделения на уровни.
- С чего начать: через единый интерфейс APIYI apiyi.com можно переключаться между моделями на разных уровнях и отслеживать их использование.
Итоги
Фраза «Не берите с меня плату за токены за каждый закрученный винт» по сути призывает пересмотреть границы вызовов в рабочих процессах с ИИ:
- Сначала найдите «винты»: частые, предсказуемые задачи с единственным правильным ответом поручите фиксированным программам.
- Затем подключите специализированные модели: небольшие модели подойдут для задач со стабильными шаблонами и ограниченным набором категорий, а также для подготовки запросов.
- И только потом обращайтесь к большой языковой модели: платить за токены стоит ради открытых рассуждений, решений в нештатных ситуациях и творческой генерации.
Этот подход не зависит от конкретной модели или отдельного релиза и может надолго стать чек-листом при проектировании агентов. На практике обязательно проверяйте разницу до и после разделения на уровни по собственным бизнес-логам, а не исходите из того, что расходы обязательно снизятся.
Если вы разрабатываете многоуровневый рабочий процесс, через APIYI apiyi.com можно с одним API-ключом подключать модели разных размеров, гибко переключать их на каждом уровне и сравнивать статистику использования. Так вы сможете на основе данных решить, кто должен закручивать каждый «винт».
📚 Источники
- Aifanr — интервью с Лай Цзе из Stardust Intelligence: 15-е интервью в рубрике «Компании, создающие разнообразие»
- Ссылка:
ifanr.com/1687805 -
Описание: источник аналогии «закручивание винтов и плата за токены» и идеи разделения задач между воплощёнными моделями и базовыми большими языковыми моделями
-
Документация API OpenAI Chat Completions: описание параметров OpenAI-совместимого интерфейса
- Ссылка:
platform.openai.com/docs/api-reference/chat - Описание: помогает разобраться в полях
model,max_tokens,usageи других, чтобы реализовать учёт использования по уровням
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через главную страницу сайта APIYI. Подробнее о подключении моделей и учёте использования читайте в центре документации APIYI.