Nota do autor: Depois que um novo modelo é lançado, como validar com suas próprias tarefas de longa duração se vale a pena trocar? Este artigo divide essa pergunta em um fluxo executável de 5 etapas.
Novos modelos são lançados quase todo mês, e os rankings de benchmark não param de ser atualizados. Pegue o Hunyuan Hy4, da Tencent, lançado oficialmente em novembro de 2026: a empresa afirma que, em comparação com a versão de pré-visualização, ele recebeu otimizações específicas em capacidades de agente e tarefas de longa duração, além de figurar entre os primeiros colocados entre os modelos de código aberto em vários benchmarks. Mas, para quem desenvolve, só existe uma pergunta que importa: ele é melhor do que o modelo que eu uso hoje nas minhas tarefas? Este artigo apresenta um método de validação comparativa de novos modelos baseado nas suas próprias tarefas de longa duração, para ajudar você a chegar a uma conclusão com dados em um ou dois dias.
Este não é mais um artigo de interpretação de pontuações de benchmark. Os rankings medem capacidade genérica; o seu negócio mede se você consegue levar uma tarefa de várias etapas do começo ao fim, se consegue se recuperar sozinho depois de um erro e quanto custa concluir cada entrega.
Valor central: ao terminar a leitura, você vai aprender a montar um conjunto de validação pequeno e preciso para tarefas de longa duração, comparar o modelo novo com o antigo usando 6 métricas e calcular o “custo por entrega bem-sucedida” com base na cobrança real. No fim, vai conseguir decidir se troca ou não de modelo.
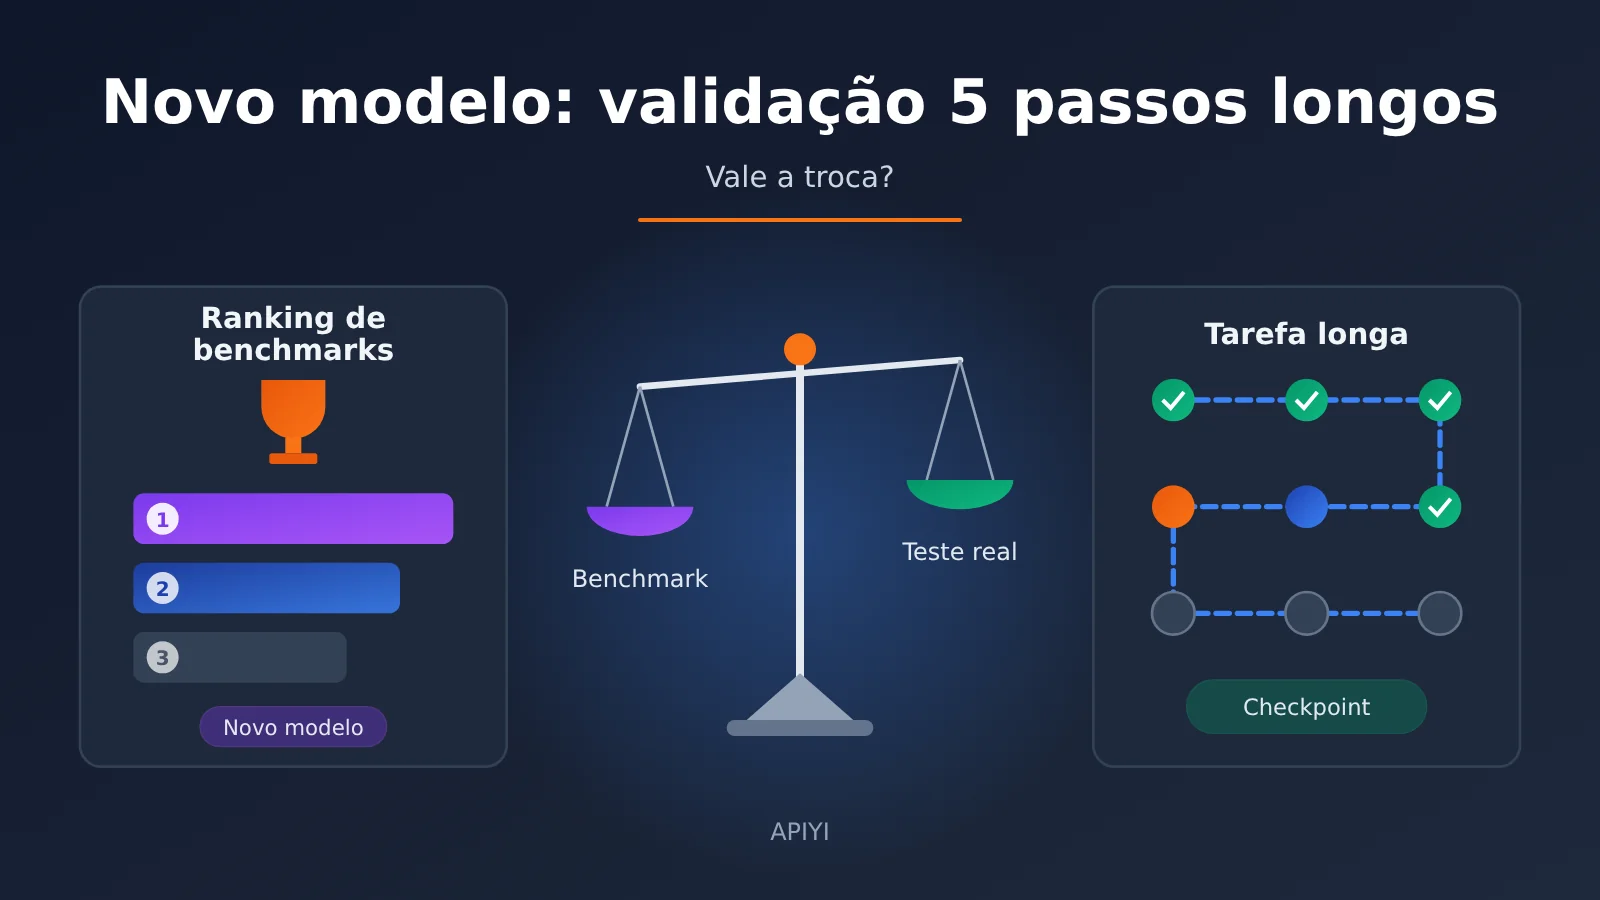
Pontos-chave da validação de tarefas de longo prazo com novos modelos
Antes de começar, é importante deixar clara a diferença entre validar tarefas de longo prazo e fazer um teste comum de turno único. O teste de turno único avalia “quão bonita é uma resposta”; a validação de tarefas de longo prazo avalia “se o objetivo ainda está lá depois de dezenas de etapas consecutivas”.
| Ponto-chave | Descrição | Valor |
|---|---|---|
| Usar suas próprias tarefas | Extraia 3 a 5 tarefas de múltiplas etapas do negócio real, em vez de usar problemas públicos | As conclusões correspondem diretamente ao retorno do negócio |
| Grupo de controle fixo | Rodar o modelo atual e o novo modelo na mesma tarefa e na mesma cadeia de ferramentas | Eliminar diferenças de comando e ambiente |
| Priorizar métricas de processo | Registrar manutenção do objetivo, autocorreção e número de intervenções humanas | Descobrir problemas de estabilidade que os benchmarks não mostram |
| Calcular custo por entrega | Calcular o custo de tokens por “entrega bem-sucedida” | Evitar julgamentos errados por olhar apenas o preço unitário |
| Definir critério para troca de modelo | Escrever antecipadamente o padrão de “quanto de melhoria justifica a troca” | Evitar se deixar levar por um único caso impressionante |
Por que a validação de tarefas de longo prazo é mais confiável que os benchmarks
Os problemas dos rankings públicos geralmente são fechados e de cadeia curta, enquanto o trabalho real de um Agent é exatamente o oposto. Na avaliação de referência, uma tarefa de longo prazo dada ao Hy4 exigia ir da pesquisa, desenvolvimento, revisão e retrabalho até chegar a um jogo 3D jogável, com a adição de vídeos de referência e novos requisitos no meio do caminho. Esse tipo de tarefa testa se o modelo, à medida que as etapas aumentam, consegue lembrar do plano inicial, distinguir o que já foi concluído do que ainda falta e ajustar o plano quando os resultados intermediários não correspondem ao esperado.
Outro fenômeno que vale a pena observar é o efeito de sinergia entre “modelo + cadeia de ferramentas”. Na mesma avaliação, o Hy4 gerou 14 PPTs, uma planilha Excel e um documento Word de 19 páginas em meia hora dentro do WorkBuddy. Os avaliadores também deixaram claro que o modelo é responsável por compreender, planejar e julgar, enquanto a cadeia de ferramentas é responsável por ler, calcular, renderizar e escrever. Isso significa que, ao validar um novo modelo, você precisa rodá-lo dentro da sua própria cadeia de ferramentas; conclusões obtidas fora do ambiente têm valor de referência limitado.
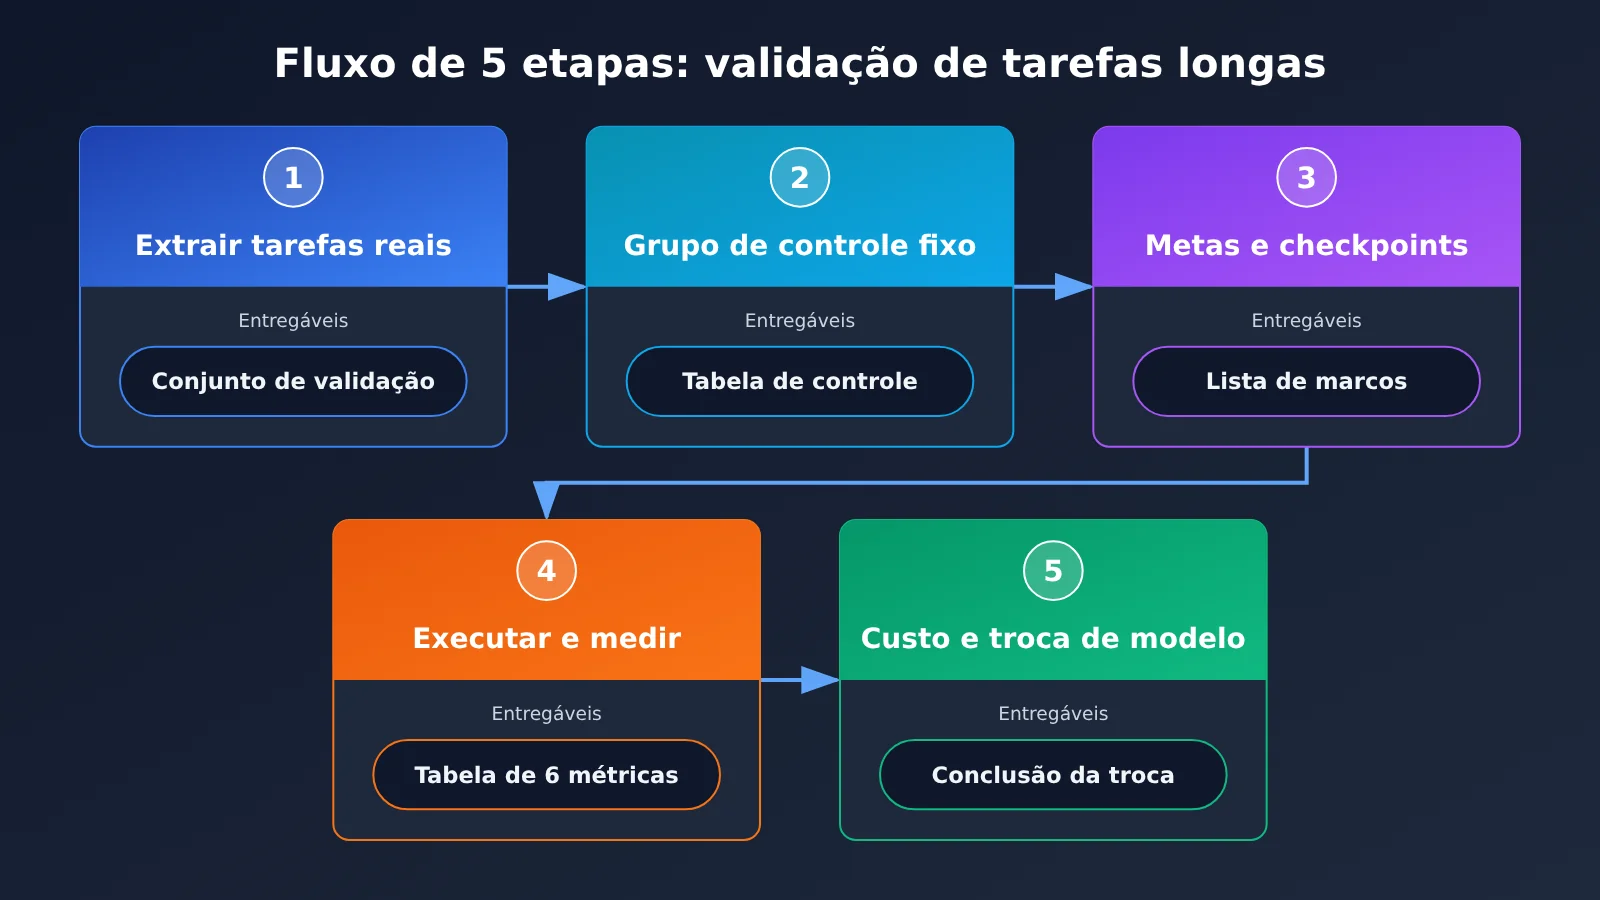
Validação rápida de tarefas de longo prazo em novos modelos: fluxo em 5 etapas
O fluxo abaixo não depende de nenhum framework específico; desde que as invocações do modelo passem por uma interface unificada, você pode alternar entre modelos para comparação com baixo custo.
Etapa 1: extraia tarefas de longo prazo do negócio real
O conjunto de validação não precisa ser grande; precisa ser “parecido” com a realidade. Recomenda-se selecionar de 3 a 5 tarefas, cobrindo os três tipos de cenário mais comuns, mais trabalhosos e mais sujeitos a erro no seu negócio. Cada tarefa deve, de preferência, atender a três condições: “ter pelo menos 10 etapas, exigir chamadas de ferramentas e ter entregáveis claros”.
Você pode se inspirar nas seguintes categorias típicas de tarefas de longo prazo para criar suas próprias versões:
- Processamento em lote de documentos: dada uma pasta com uma dúzia de materiais, pedir ao modelo que resuma cada um, gere material de apresentação e consolide tudo em uma tabela e um relatório.
- Desenvolvimento de aplicações: a partir da descrição de requisitos, concluir desenvolvimento, autoteste, correções e, por fim, entregar um artefato executável.
- Replicação multimodal: enviar capturas de tela ou gravações de tela e pedir ao modelo que entenda o conteúdo e reproduza a interface ou interação correspondente.
- Operação de computador: fazer o modelo olhar para a tela, encontrar botões, clicar e digitar para concluir um fluxo de operação entre softwares.
Etapa 2: Fixar o grupo de controle e o ambiente de execução
O ponto central de um experimento controlado é “mudar apenas uma variável”. Modelos antigos e novos devem usar o mesmo comando de sistema, o mesmo conjunto de definições de ferramentas e o mesmo material de entrada. Recomenda-se executar cada tarefa pelo menos 3 vezes, usando a média e o pior resultado, porque a aleatoriedade em tarefas de longa duração é muito maior do que em perguntas e respostas de turno único.
| Item de configuração | Configuração sugerida | Observação |
|---|---|---|
model |
modelo atual vs novo modelo | único parâmetro que pode variar |
temperature |
manter igual nos dois grupos, de preferência baixo | reduzir a interferência da aleatoriedade nas conclusões |
max_tokens |
reservar folga conforme a saída mais longa da tarefa | evitar julgar mal a capacidade do modelo por causa de truncamento |
Definição de ferramentas tools |
lista de funções e descrições totalmente idênticas | diferenças na descrição das ferramentas afetam significativamente o comportamento de chamada |
| Comando de sistema | mesma versão, sem ajuste específico para o novo modelo | testar primeiro o “pronto para uso” e depois o desempenho após ajuste |
| Número de repetições | pelo menos 3 vezes por tarefa | observar a estabilidade, não o melhor resultado |
Se o seu projeto usa ao mesmo tempo interfaces no estilo OpenAI e Anthropic, trocar de modelo muitas vezes significa mudar o SDK, a autenticação e o formato da requisição, o que torna o experimento controlado bem trabalhoso. Ao chamar por uma plataforma unificada de agregação de API, você pode trocar apenas o campo model para concluir a mudança.
🚀 Sugestão para começar rápido: APIYI apiyi.com oferece chamadas de API dos principais modelos abordados neste artigo e é compatível com os formatos de interface da OpenAI e da Anthropic. Em experimentos controlados, basta substituir o parâmetro
modelpara alternar entre modelos antigos e novos. Para formas de integração,base_urle configuração de autenticação, consulte o centro de documentação da APIYI em docs.apiyi.com.
Passo 3: definir âncoras de objetivo e checkpoints para a tarefa
O modo de falha mais comum em tarefas de longa duração não é “não saber fazer”, mas sim “esquecer o que era preciso fazer no meio do caminho”. Na avaliação de referência, foi usada a instrução /goal para obrigar o modelo a manter sempre objetivos concretos, e essa ideia pode ser transportada para qualquer ambiente de validação. Você pode escrever com clareza o objetivo final no início da tarefa e dividir as entregas em vários marcos verificáveis.
Tomando como exemplo a tarefa do “minijogo 3D realista”, os avaliadores dividiram o objetivo em 5 itens: cenário do jogo, visual e sensação de jogabilidade, som e mecânicas, fluxo de trabalho e entrega final. Suas próprias tarefas também devem ser divididas assim, com cada marco correspondendo a um checkpoint que permita julgar objetivamente “concluído/não concluído” — assim a pontuação posterior fica muito mais simples.
Passo 4: executar e registrar as 6 métricas
A cada execução, guarde o log completo da conversa e das chamadas de ferramentas, e depois pontue conforme a tabela abaixo. As 4 primeiras medem “se dá para terminar”; as 2 últimas medem “se vale a pena”.
| Métrica | Como medir | Forma de pontuação |
|---|---|---|
| Taxa de conclusão da tarefa | checkpoints concluídos / total de checkpoints | percentual, média de 3 execuções |
| Manutenção do objetivo | se na segunda metade a tarefa ainda avança em torno do objetivo inicial, se há omissões ou desvios | avaliação humana de 1 a 5 pontos |
| Capacidade de autocorreção | se, após um erro no meio do processo (erro de execução, falha em teste), o modelo consegue corrigir sozinho | registrar “número de erros / número de recuperações” |
| Número de intervenções humanas | quantidade de rodadas em que foi necessário complementar instruções ou corrigir o rumo manualmente | quanto menos, melhor |
| Tempo gasto | tempo de relógio de parede desde o início até a entrega | em minutos, incluindo o tempo de execução das ferramentas |
| Custo por entrega | custo total de tokens / número de entregas bem-sucedidas | calculado conforme a base de cobrança real |
O “número de intervenções humanas” merece atenção especial. A conclusão da avaliação de referência é que o Hy4 consegue, na maioria das tarefas cotidianas de escritório e criativas, entregar basicamente de uma só vez, mas em trabalhos com muitas operações de computador e fluxos complexos ainda são necessárias várias rodadas de interação para ajudá-lo a entender a intenção. É exatamente essa diferença que você precisa quantificar nas suas próprias tarefas: cada intervenção representa um custo de mão de obra.
Etapa 5: Calcular custos e tomar a decisão de trocar de modelo
A apuração de custos deve ser feita por “entrega bem-sucedida”, e não apenas pela comparação dos preços unitários de entrada e saída. Um modelo com preço unitário mais baixo, mas que precisa ser executado de novo duas vezes, pode acabar custando mais na prática. Tarefas de longa duração têm outra particularidade: o contexto carrega o histórico repetidamente, e a taxa de acerto do cache impacta bastante o custo total.
O raciocínio é: custo por tarefa = tokens de entrada sem acerto no cache × preço unitário de entrada + tokens de entrada com acerto no cache × preço unitário de cache + tokens de saída × preço unitário de saída; depois, divide-se o custo total de várias execuções pelo número de entregas bem-sucedidas. Os preços unitários de entrada, saída e cache, assim como os critérios de cobrança de cada modelo, devem ser consultados nos dados reais da página de preços da APIYI em docs.apiyi.com/models; este artigo não traz números específicos para evitar informações equivocadas devido a mudanças de preço.
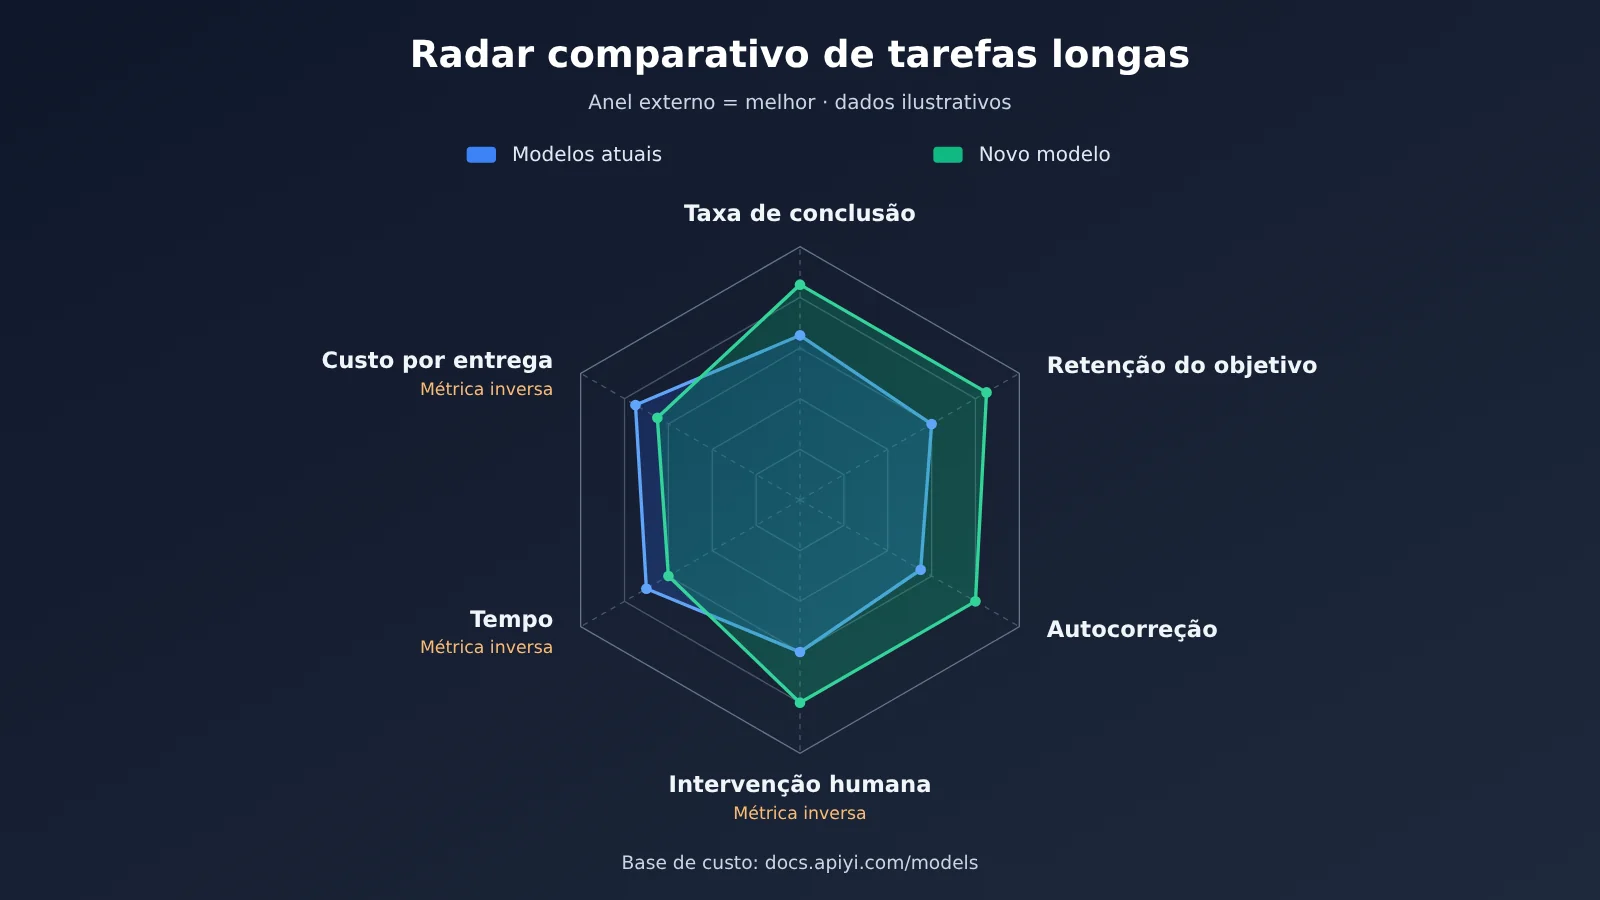
💰 Dica para o cálculo de custos: ao fazer a comparação, vale a pena invocar os modelos antigo e novo na mesma plataforma, para que as estatísticas de uso e os critérios de cobrança sejam os mesmos e o “custo por entrega” calculado seja realmente comparável. A página de preços da APIYI em docs.apiyi.com/models lista os preços de entrada, saída e cache de cada modelo, e pode ser usada diretamente como base para o cálculo.
Critérios de decisão para validar novos modelos em tarefas de longa duração
Depois de rodar os dados, o pior cenário é aquele em que “cada um tem seus pontos fortes e não dá para decidir”. A recomendação é definir as regras de decisão antes de começar o experimento; a tabela abaixo pode servir de ponto de partida, e você ajusta os limiares conforme a sensibilidade do negócio.
| Resultado da comparação | Decisão recomendada | Motivo |
|---|---|---|
| Taxa de conclusão aumenta claramente e o custo por entrega fica estável ou cai | Trocar direto | Qualidade e custo se beneficiam ao mesmo tempo |
| A taxa de conclusão aumenta claramente, mas o custo sobe | Trocar por cenário | Usar o novo modelo apenas em tarefas de alto valor e alta dificuldade |
| Taxa de conclusão estável e custo cai claramente | Troca gradual | Começar substituindo em tarefas de baixo risco e observar por um tempo |
| Taxa de conclusão estável e menos intervenções | Priorizar a troca | A mão de obra economizada costuma valer mais do que o custo de tokens |
| Taxa de conclusão cai ou a estabilidade piora | Não trocar por enquanto | Esperar a próxima versão ou ajustar o comando e testar novamente |
Há também uma dimensão fácil de passar despercebida: a reestruturação de tarefas trazida pelas novas capacidades. Por exemplo, o Hy4 ganhou compreensão visual nesta versão: ele consegue ler gravações de tela e analisar quadro a quadro, além de tirar capturas contínuas dos próprios resultados e usar esse feedback para se otimizar. Se o seu fluxo antigo exige que uma pessoa transforme capturas de tela em descrições textuais, o novo modelo pode não trazer apenas “fazer a mesma tarefa melhor”, mas sim “eliminar uma etapa do fluxo inteiro”. Esse tipo de ganho deve ser registrado separadamente; não o meça apenas pela pontuação nas tarefas antigas.
Referência de seleção ao comparar modelos populares
Na comparação, normalmente colocamos o modelo novo para rodar junto com o modelo em produção e com outros candidatos do mesmo nível. A tabela abaixo mostra a linha de raciocínio para a escolha; para capacidades específicas, considere seus próprios testes em tarefas de longa duração.
| Tipo de candidato | Tarefas de longa duração adequadas | Foco da validação | Plataforma disponível |
|---|---|---|---|
| Modelo open source/chinês recém-lançado | Processamento em lote de documentos de escritório, agentes para cenários em chinês | Manutenção do objetivo, custo-benefício | APIYI (apiyi.com), entre outras |
| Modelo proprietário principal em produção | Programação complexa, raciocínio de alta dificuldade | Servir como linha de base de qualidade | APIYI (apiyi.com), entre outras |
| Modelo com capacidade multimodal | Reprodução de capturas/gravações de tela, compreensão de interfaces | Precisão da compreensão visual, autocorreção | APIYI (apiyi.com), entre outras |
| Modelo leve e rápido | Distribuição de subtarefas, organização de formatos | Tempo gasto e custo | APIYI (apiyi.com), entre outras |
💡 Sugestão de escolha: não compare apenas um candidato com o modelo em produção. Coloque mais dois ou três candidatos na mesma suíte de validação, usando uma interface unificada, e muitas vezes você encontra uma solução melhor: “combinar modelos por cenário”. A APIYI oferece invocação unificada de vários modelos populares, o que facilita implementar esse tipo de combinação rapidamente.
Perguntas frequentes (FAQ)
Q1: O que é a validação de tarefas de longo horizonte para novos modelos?
Validação de tarefas de longo horizonte significa testar o modelo com tarefas reais que envolvem várias etapas, exigem chamadas de ferramentas e têm entregáveis bem definidos. O foco está em saber se o modelo consegue manter o objetivo ao longo de passos consecutivos, se consegue se autocorrigir depois de um erro e qual é o custo da entrega final — e não a qualidade de uma resposta isolada.
Q2: Qual é a diferença entre a validação de tarefas de longo horizonte e olhar Benchmarks públicos?
Benchmarks são muito valiosos para comparar capacidades gerais de forma transversal, mas as questões têm muita diferença em relação ao seu negócio e, em sua maioria, são tarefas de cadeia curta. Já a validação de tarefas de longo horizonte roda diretamente na sua cadeia de ferramentas e nos seus dados, e consegue expor problemas como esquecimento do objetivo, uso incorreto de ferramentas e necessidade de correções manuais repetidas. O mais seguro é combinar os dois: primeiro usar os rankings para filtrar candidatos, depois usar suas próprias tarefas para decidir.
Q3: Quanto tempo depois do lançamento de um novo modelo é adequado começar a validação?
Recomendo rodar uma primeira rodada de testes “fora da caixa” o quanto antes após o lançamento, porque muitos modelos novos oferecem período gratuito por tempo limitado ou uma fase de experimentação. No material de referência, o Hy4 no WorkBuddy teve um período gratuito de 4 a 15 de novembro. Se o resultado da primeira rodada for bom, vale investir tempo ajustando os comandos para o novo modelo e fazer uma segunda rodada de testes.
Q4: Quantas tarefas são necessárias para o conjunto de validação?
Normalmente, 3 a 5 tarefas bem próximas do seu negócio já bastam para chegar a uma conclusão de direção, repetindo cada tarefa 3 vezes para observar a estabilidade. Em vez de empilhar quantidade, garanta que as tarefas cubram os cenários mais comuns, os que mais consomem mão de obra e os que mais dão erro, além de desenhar checkpoints claros para cada tarefa.
Q5: Como alternar entre vários modelos para comparação com baixo custo?
O jeito mais prático é chamar por meio de uma plataforma de interface unificada. A APIYI apiyi.com é compatível com os dois formatos de interface, OpenAI e Anthropic, e para trocar de modelo basta alterar o parâmetro `model` — a definição das ferramentas e os comandos não precisam mudar. Os passos de integração estão disponíveis no centro de documentação docs.apiyi.com.
Q6: Como calcular o custo de tarefas de longo horizonte de forma precisa?
É preciso calcular pelo “custo por entrega bem-sucedida”, ou seja, o custo total de tokens de várias execuções dividido pelo número de entregas bem-sucedidas, separando a parte da entrada que acertou o cache da que não acertou. Os preços unitários e de cache de cada modelo devem seguir os dados reais da página de preços da APIYI em docs.apiyi.com/models; usar a mesma base de cobrança dentro da mesma plataforma deixa a comparação mais justa.
Q7: Quais são as limitações da validação de tarefas de longo horizonte?
Primeiro, a amostra é pequena: um acerto impressionante ou uma falha isolada pode ser coincidência, por isso é preciso repetir a execução. Segundo, a avaliação humana tem subjetividade; recomendo que duas pessoas pontuem de forma independente e se tire a média. Terceiro, o resultado depende fortemente da cadeia de ferramentas: ao trocar o framework de Agent, é preciso retestar. Além disso, o teto de capacidade do modelo costuma depender da dificuldade das tarefas de teste, então o conjunto de validação deve receber periodicamente tarefas mais difíceis.
Verificação de tarefas de longo prazo com novos modelos: principais conclusões
- Deixe suas próprias tarefas falarem: 3 a 5 tarefas reais de múltiplas etapas dizem muito mais sobre o ganho de trocar de modelo do que qualquer ranking.
- Mude apenas uma variável: modelo antigo e novo devem usar o mesmo comando, as mesmas ferramentas e as mesmas entradas, com pelo menos 3 execuções por tarefa.
- Âncoras de objetivo são indispensáveis: inspire-se na ideia do
/goalpara dividir marcos; quanto mais objetivos forem os checkpoints, mais precisa será a avaliação. - 6 métricas para ver o quadro completo: taxa de conclusão, manutenção do objetivo, autocorreção, número de intervenções, tempo gasto e custo de entrega.
- Calcule o custo pela entrega: diferencie acertos de cache e use a página de preços da APIYI, docs.apiyi.com/models, como base de cobrança.
- Fique de olho na reestruturação de processos: novas capacidades, como compreensão visual, podem eliminar diretamente etapas manuais do fluxo antigo.
Resumo
Os pontos centrais da verificação de tarefas de longo prazo com novos modelos:
- Tarefas reais: o conjunto de validação vem do negócio e cobre cenários de alta frequência, alto consumo de tempo e propensos a erro.
- Comparação rigorosa: ambiente fixo, execuções repetidas e critérios de troca de modelo definidos com antecedência.
- Contas bem feitas: meça o ganho real pelo custo de uma entrega bem-sucedida e pelo número de intervenções manuais.
Cada lançamento de novo modelo é uma oportunidade de reavaliar o fluxo de trabalho. Em vez de se deixar levar por rankings e vídeos de demonstração, vale gastar um ou dois dias e obter uma resposta concreta com suas próprias tarefas de longo prazo. Recomendamos usar a APIYI, em apiyi.com, para colocar modelos antigos e novos sob a mesma interface e comparar rapidamente; as instruções de integração estão em docs.apiyi.com e os dados de cobrança têm como base docs.apiyi.com/models.
📚 Referências
- 爱范儿 – Teste prático do Tencent Hy4: Casos de teste reais do Hy4 em tarefas de longa duração, multimodalidade e operação de computador
- Link:
ifanr.com/1687613 -
Descrição: Traz designs de teste que podem ser reaproveitados, como restrições de objetivo via
/goal, desenvolvimento de jogos de longa duração e processamento em lote de documentos -
Central de Documentação do APIYI: Instruções de integração de modelos e formato de interface
- Link:
docs.apiyi.com -
Descrição: Veja como configurar as interfaces compatíveis com OpenAI e Anthropic
-
Página de Preços de Modelos do APIYI: Preços de entrada, saída e cache de cada modelo
- Link:
docs.apiyi.com/models - Descrição: A única fonte de referência de preços para cálculo de custos
Autor: Equipe Técnica do APIYI
Contato técnico: Fique à vontade para nos contatar na página inicial do APIYI apiyi.com. Mais materiais de integração de modelos estão disponíveis na central de documentação docs.apiyi.com