著者注:新モデルがリリースされた後、自分の長期的なタスクで乗り換える価値があるかどうかをどう検証するか。本記事ではこの問いを実行可能な5ステップのプロセスに分解します。
新しいモデルはほぼ毎月リリースされており、ベンチマークのランキングも絶えず更新されています。2026年11月に正式リリースされたテンセントの混元 Hy4 を例に挙げましょう。公式によると、プレビュー版と比較して Agent 能力と長期的タスクにおいて的を絞った最適化が施され、複数の Benchmark でオープンソースモデルの上位に入ったとのことです。しかし開発者にとって、本当の問いはただ一つです:それは私のタスクにおいて、今使っているモデルより優れているのか? 本記事では、自社の長期的タスクに基づく新モデルの比較検証手法を紹介し、1〜2日でデータに裏付けられた結論を出せるようにします。
これはまたしてもベンチマークスコアの解説ではありません。リーダーボードが測るのは汎用能力ですが、あなたのビジネスが測るのは、多段階の物事を最初から最後までやり遂げられるか、エラーが起きた後に自分で修復できるか、1件完了させるのにいくらかかるか、です。
コアバリュー:本記事を読み終えると、小さくて精度の高い長期的タスクの検証セットを構築し、6つの指標で新旧モデルを比較し、実際の課金と組み合わせて「成功納品あたりのコスト」を算出し、最終的に乗り換えるかどうかの意思決定ができるようになります。
新モデルの長期的タスク検証における核心ポイント
作業を始める前に、長期的タスク検証と通常の単発テストの違いをはっきりさせておきましょう。単発テストが見るのは「1回の回答がどれだけ美しいか」ですが、長期的タスク検証が見るのは「何十ステップも連続した後で、目標がまだ残っているか」です。
| ポイント | 説明 | 価値 |
|---|---|---|
| 自社のタスクを使う | 公開問題ではなく、実際の業務から3〜5個の多ステップタスクを抽出する | 結論がそのまま業務上のリターンに対応する |
| 対照群を固定する | 現行モデルと新モデルを同一タスク・同一ツールチェーンで実行する | プロンプトや環境の差異を排除できる |
| プロセス指標を優先する | 目標の維持、自己修正、人手介入の回数を記録する | ベンチマークスコアでは見えない安定性の問題を発見できる |
| 納品単位でコストを計算する | 「成功した納品1回あたり」を単位としてトークン費用を算出する | 単価だけを見て誤判断するのを避けられる |
| モデル切り替えの基準を設定する | 「どれだけ向上すれば切り替える価値があるか」をあらかじめ決めておく | 1つの印象的な事例に引っ張られるのを防げる |
なぜ長期的タスク検証はベンチマークスコアより信頼できるのか
公開ベンチマークの問題は通常、閉じた短いステップ数のものですが、実際のエージェント作業はまったく逆です。参考評価では、Hy4 に与えられた長期的タスクとして、調査、開発、レビュー、修正を経て遊べる3Dゲームに仕上げるというものがあり、途中で参考動画や新しい要件も追加されました。こうしたタスクで試されるのは、ステップが増え続けてもモデルが最初の計画を覚えているか、完了済みと未完了の項目を区別できるか、中間結果が想定と異なる場合に計画を調整できるか、という点です。
もう1つ注目すべき現象は「モデル+ツールチェーン」の相乗効果です。同じ評価記事の中で、Hy4 は WorkBuddy 上で30分以内に14個のPPT、1つのExcel、そして19ページのWord文書を生成しました。評価者はまた、モデルは理解・計画・判断を担い、ツールチェーンは読み取り・計算・レンダリング・書き込みを担うと明確に指摘しています。つまり、新しいモデルを検証する際は必ず自社のツールチェーンの中で実行する必要があり、環境から切り離した結論は参考価値が限定的だということです。
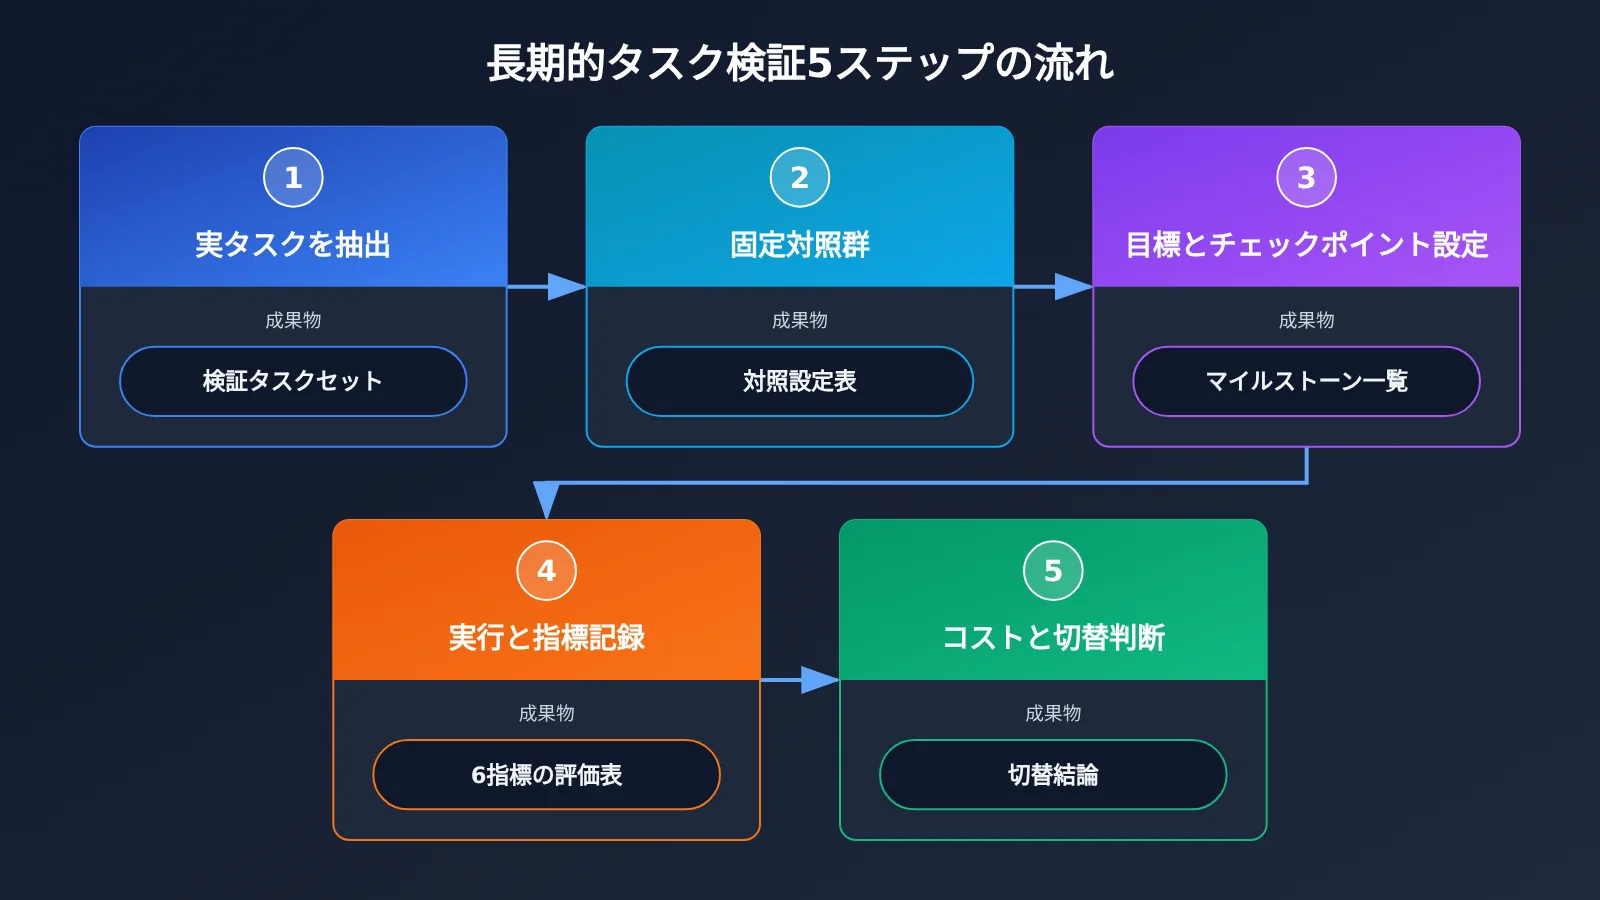
新モデルの長行程タスク検証を素早く始める:5ステップの流れ
以下の手順は特定のフレームワークに依存しません。モデル呼び出しが統一インターフェース経由であれば、低コストでモデルを切り替えて比較できます。
ステップ1:実際の業務から長行程タスクを抽出する
検証セットは数より「リアルさ」が大切です。3〜5個のタスクを選び、業務で最もよくある、最も人手がかかる、最もミスしやすい3種類のシナリオをカバーすることをおすすめします。各タスクは「少なくとも10ステップ以上」「ツール呼び出しが必要」「明確な成果物がある」という3つの条件を満たすと理想的です。
以下のような典型的な長行程タスクを参考に、自社版を設計してみてください。
- 文書バッチ処理型:10数本の資料が入ったフォルダを渡し、1本ずつ要約して報告資料を作成させ、表とレポートにまとめさせる。
- アプリ開発型:要件記述から出発し、開発、自己テスト、修正を経て、最終的に動作する成果物を納品する。
- マルチモーダル再現型:スクリーンショットや画面録画をアップロードし、内容を理解した上で対応するUIやインタラクションを再現させる。
- PC操作型:モデルに画面を見させ、ボタンを探させ、クリックや入力を行わせて、ソフトウェアをまたぐ操作フローを完遂させる。
ステップ2:対照群と実行環境を固定する
比較実験の鍵は「変数を1つだけ変える」ことです。新旧モデルは、まったく同じシステムプロンプト、同じツール定義、同じ入力素材を使用しなければなりません。長距離タスクのランダム性は単発のQ&Aよりもはるかに高いため、各タスクは最低3回実行し、平均値と最悪値の両方を記録することをおすすめします。
| 設定項目 | 推奨設定 | 説明 |
|---|---|---|
model |
現行モデル vs 新モデル | 唯一変更が許されるパラメータ |
temperature |
両グループで統一、低めを推奨 | ランダム性が結論に与える影響を抑える |
max_tokens |
タスクの最長出力に余裕を持たせて確保 | 打ち切りによる能力の誤判定を防ぐ |
ツール定義 tools |
完全に同一の関数リストと説明 | ツール説明の違いは呼び出し行動に大きく影響する |
| システムプロンプト | 同一バージョン、新モデル向けにチューニングしない | まず「すぐ使える」状態をテストし、その後チューニング後の性能をテストする |
| 繰り返し回数 | 各タスク最低3回 | 最高スコアではなく安定性を観察する |
プロジェクトでOpenAI形式とAnthropic形式の両方のインターフェースを使っている場合、モデルの切り替えはSDKの変更、認証の変更、リクエスト形式の変更を伴うことが多く、比較実験がとても面倒になります。統一されたAPIアグリゲーションプラットフォーム経由で呼び出せば、model フィールドを変更するだけで切り替えが完了します。
🚀 クイックスタートのヒント:APIYI apiyi.com は本記事で扱う主要モデルのAPI呼び出しを提供しており、OpenAIとAnthropicの両方のインターフェース形式に対応しています。比較実験の際は
modelパラメータを置き換えるだけで、新旧モデルを切り替えられます。接続方法、base_url、認証設定については、APIYI ドキュメントセンター docs.apiyi.com を参照してください。
ステップ3:タスクに目標アンカーとチェックポイントを設定する
長距離タスクで最もよくある失敗パターンは、「やり方がわからない」ことではなく、「やっているうちに何をすべきかを忘れてしまう」ことです。参考評価では /goal 指令を使ってモデルが常に具体的な目標を維持するよう制約しており、この考え方はどんな検証環境にも応用できます。タスクの冒頭で最終目標を明確に書き、成果物をいくつかのチェック可能なマイルストーンに分解するとよいでしょう。
「リアルな3Dミニゲーム」タスクを例にすると、評価者は目標を5つの項目に分解しました。すなわち、ゲームシーン、ビジュアルと操作感、サウンドとゲームプレイ、ワークフロー、最終納品です。あなた自身のタスクも同じように分解すべきで、各マイルストーンを「完了/未完了」を客観的に判断できるチェックポイントに対応させれば、その後の採点はずっと簡単になります。
ステップ4:実行して6項目の指標を記録する
毎回の実行で、会話とツール呼び出しのログを完全に保存し、以下の表に従って採点します。最初の4項目は「やり遂げられるか」を、後の2項目は「コストに見合うか」を測ります。
| 指標 | 測定方法 | 評価方法 |
|---|---|---|
| タスク完了率 | チェックポイントの完了数 / チェックポイントの総数 | パーセンテージ、3回の平均を取る |
| 目標維持度 | 後半でも初期目標を中心に進められているか、漏れや脱線がないか | 1〜5点の人手評価 |
| 自己修正能力 | 途中でエラー(エラー発生、テスト失敗)が起きた後に自力で修復できるか | 「エラー回数 / 自己修復回数」を記録 |
| 人手介入回数 | 人的な補足説明や軌道修正が必要だったターン数 | 回数が少ないほど良い |
| 所要時間 | 開始から納品までの実時間 | 分単位、ツール実行時間を含む |
| 1回あたりの納品コスト | 総トークン費用 / 成功納品回数 | 実際の課金基準で算出 |
「人手介入回数」は特に重視する価値があります。参考評価の結論は、Hy4はほとんどの日常業務や創作タスクではほぼ一発で納品できるものの、大量のパソコン操作や複雑なフローの作業では、意図を理解させるために依然として複数回のやり取りが必要だというものでした。これはまさに、あなたが自分のタスクで定量化すべき差異です。1回介入するということは、1人分の人件費を意味します。
ステップ5:コストを試算し、モデル切り替えの判断を行う
コスト試算は「成功した納品1回あたり」を単位に行います。入力・出力の単価だけを比較するのでは不十分です。単価は安くても2回再実行が必要なモデルは、実際のコストがかえって高くなる可能性があります。長距離タスクにはもう一つ特徴があります。コンテキストが履歴を繰り返し持ち運ぶため、キャッシュヒット率が総コストに大きく影響するのです。
計算の考え方は次のとおりです。1タスクあたりの費用 = キャッシュ未ヒットの入力 token × 入力単価 + キャッシュヒットした入力 token × キャッシュ単価 + 出力 token × 出力単価。そのうえで、複数回実行した総費用を成功納品回数で割ります。各モデルの入力単価・出力単価・キャッシュ価格および課金基準については、APIYI の料金ページ docs.apiyi.com/models の実際のデータを基準にしてください。本記事では具体的な数字を挙げません。価格変動による誤解を避けるためです。
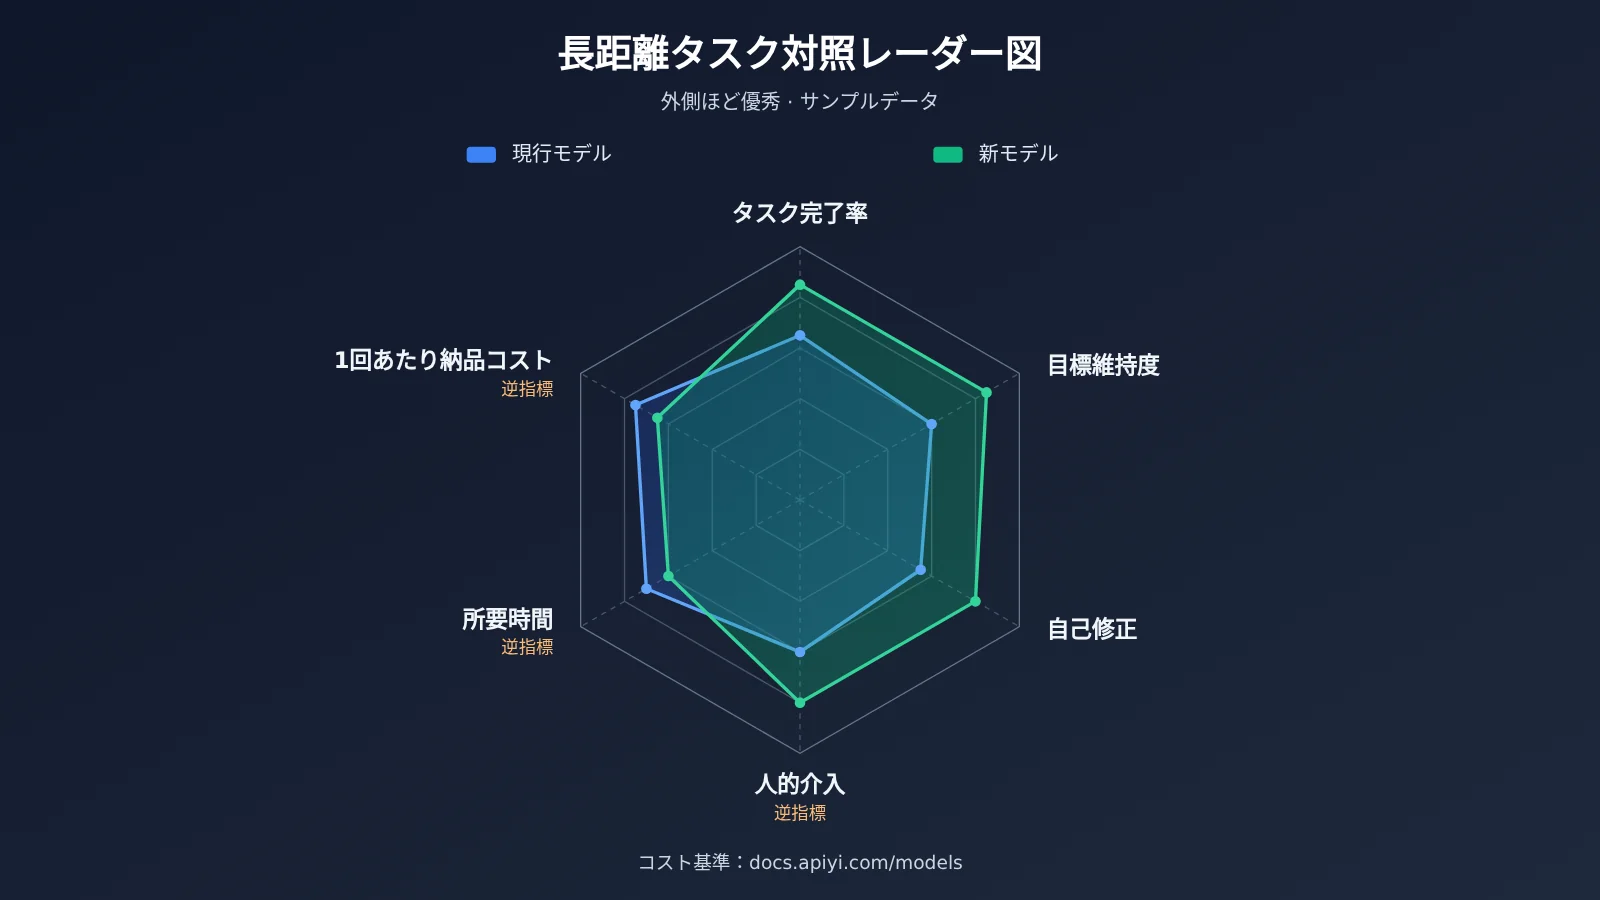
💰 コスト試算のヒント:比較する際は、新旧モデルを同じプラットフォームで呼び出すことをおすすめします。利用量の統計と課金基準が揃うため、算出した「1回あたりの納品コスト」に比較可能性が生まれます。APIYI の料金ページ docs.apiyi.com/models には各モデルの入力・出力・キャッシュ価格が掲載されており、そのまま試算の根拠として使えます。
新モデルの長期的タスク検証における意思決定基準
データを回し終えたあとに一番怖いのは、「それぞれに良さがあって決められない」という状況です。実験を始める前に意思決定ルールを書き留めておくことをおすすめします。以下の表を出発点にして、業務の重要度と敏感さに応じてしきい値を調整してください。
| 比較結果 | 推奨する意思決定 | 理由 |
|---|---|---|
| 完了率が明確に向上し、1回あたりの納品コストが横ばいまたは低下 | 直接切り替え | 品質とコストの両方でメリットがある |
| 完了率が明確に向上し、コストが上昇 | シーン別に切り替え | 高価値・高難度のタスクでのみ新モデルを使う |
| 完了率が横ばいで、コストが明確に低下 | 段階的切り替え | 低リスクのタスクから置き換え、しばらく観察する |
| 完了率が横ばいで、介入回数が減少 | 切り替えを優先検討 | 節約できる人件費はトークン費用よりも価値があることが多い |
| 完了率が低下、または安定性が悪化 | 切り替えを見送る | 次のバージョンを待つか、プロンプトを調整して再テストする |
もう一つ見落としやすい観点が、新機能によるタスクの再構成です。たとえば Hy4 では今回、視覚理解が新たに追加され、画面録画を読み取ってフレームごとに分析できるようになりました。さらに、自身が生成した成果物を継続的にスクリーンショットし、自己フィードバックで最適化することもできます。従来のフローで、人間がスクリーンショットを文字起こしする必要がある場合、新モデルがもたらすのは「同じタスクをより良くこなす」ことではなく、「プロセス全体が1ステップ減る」ことかもしれません。こうしたメリットは別途記録し、旧タスクのスコアだけで評価しないでください。
主要モデル比較時の選定ガイド
比較検証を行うときは、通常、新モデルと現行モデル、さらに同レベルの他の候補を一緒に実行します。以下の表は選定の考え方を示したものです。具体的な能力は、ご自身の長期的タスクでの実測結果を基準にしてください。
| 候補の種類 | 担当に適した長期的タスク | 検証のポイント | 利用可能なプラットフォーム |
|---|---|---|---|
| 新リリースのオープンソース/中国製モデル | オフィス文書のバッチ処理、中国語シーンのエージェント | 目標維持度、コストパフォーマンス | APIYI(apiyi.com)など |
| 現行の主力クローズドソースモデル | 複雑なプログラミング、高難度の推論 | 品質ベースラインとして | APIYI(apiyi.com)など |
| マルチモーダルモデル | スクリーンショット/画面録画の再現、インターフェース理解 | 視覚理解の正確さ、自己修正 | APIYI(apiyi.com)など |
| 軽量・高速モデル | サブタスクの分配、フォーマット整形 | 所要時間とコスト | APIYI(apiyi.com)など |
💡 選択のヒント:候補を1つだけ現行モデルと比較するのはやめましょう。統一インターフェースの下で、2〜3の候補を同じ検証セットに入れると、「シーン別の組み合わせ利用」という、より良い解が見つかることがよくあります。APIYI は複数の主要モデルを統一して呼び出せるため、こうした組み合わせ案を素早く実装できます。
よくある質問 FAQ
Q1:新しいモデルの長距離タスク検証とは何ですか?
長距離タスク検証とは、複数のステップを含み、ツール呼び出しが必要で、明確な成果物のある実タスクを使ってモデルをテストすることです。注目するのは、連続するステップの中でモデルが目標を維持できるか、エラー発生後に自己修復できるか、そして最終的な納品コストであり、単一ターンの回答品質ではありません。
Q2:長距離タスク検証と公開 Benchmark を見ることは何が違うのですか?
Benchmark は汎用能力を横並びで比較する上で非常に価値がありますが、問題があなたの業務と大きく異なり、しかも短いリンクのタスクがほとんどです。一方、長距離タスク検証はあなたのツールチェーンとデータ上で直接実行されるため、目標の忘却、ツールの誤用、人手による繰り返しの軌道修正が必要になるといった問題を明らかにできます。両者を組み合わせて使うのが最も堅実です。まずランキングで候補を絞り、次に自社タスクで判断します。
Q3:新しいモデルがリリースされてから、どのくらいで検証を始めるのが適切ですか?
リリース後はできるだけ早く「すぐに使える」テストを一通り実行することをおすすめします。多くの新モデルには期間限定の無料枠や体験期間があるからです。参考資料では、Hy4 は WorkBuddy で 11 月 4 日から 15 日まで期間限定無料となっています。第一ラウンドの結果が良ければ、さらに時間をかけて新モデル向けにプロンプトを調整し、第二ラウンドのテストを行います。
Q4:検証セットにはタスクがいくつあれば十分ですか?
業務に非常に近いタスクが 3〜5 個あれば、方向性のある結論を出すのに通常十分です。各タスクは 3 回繰り返して安定性を観察します。数を積み上げるよりも、最もよくある、最も人手を要する、最もエラーが出やすいシナリオをタスクがカバーしていることを確保し、各タスクに明確なチェックポイントを設計する方が大切です。
Q5:複数のモデルを切り替えて低コストで比較するにはどうすればよいですか?
最も手軽な方法は、統一インターフェースのプラットフォーム経由で呼び出すことです。APIYI apiyi.com は OpenAI と Anthropic の 2 種類のインターフェース形式に対応しており、モデルを切り替えるときは `model` パラメータを変更するだけで、ツール定義やプロンプトを変更する必要はありません。具体的な接続手順はドキュメントセンター docs.apiyi.com をご覧ください。
Q6:長距離タスクのコストはどう計算すれば正確ですか?
「1 回の成功納品あたりのコスト」で計算します。つまり、複数回実行した総トークン費用を成功納品回数で割り、さらにキャッシュヒットした入力部分と未ヒットの入力部分を区別します。各モデルの単価とキャッシュ価格は、APIYI の価格ページ docs.apiyi.com/models の実際のデータを基準にしてください。同一プラットフォームでの統一された課金基準により、比較がより公平になります。
Q7:長距離タスク検証にはどのような限界がありますか?
第一にサンプルが少ないため、1 回の驚くような成功や失敗は偶然である可能性があり、繰り返し実行する必要があります。第二に人手による採点には主観性があるため、2 人が独立して採点し平均を取ることをおすすめします。第三に結果はツールチェーンに強く依存するため、Agent フレームワークを変えたら再テストが必要です。さらに、モデル能力の上限はテストタスクの難易度に左右されることが多いため、検証セットには定期的により難しいタスクを加える必要があります。
新モデルにおける長期的タスク検証のKey Takeaways
- 自分のタスクで語る:3〜5個のリアルな多段階タスクは、どのランキングよりもモデル乗り換えの効果を如実に示します。
- 変えるのは1つだけ:新旧モデルでプロンプト・ツール・入力を共通にし、各タスクを最低3回は実行します。
- 目標アンカーは欠かせない:
/goalの考え方を参考にマイルストーンを分割し、チェックポイントが客観的であるほど評価も正確になります。 - 6つの指標で全体像を把握:完了率、目標保持、自己修正、介入回数、所要時間、納品コスト。
- 納品ベースでコストを計算:キャッシュヒットを区別し、APIYI の価格ページ docs.apiyi.com/models を課金の基準にします。
- プロセスの再構築に注目:視覚理解などの新機能によって、旧プロセス内の人手作業を直接省ける可能性があります。
まとめ
新モデルの長期的タスク検証における核心的なポイント:
- タスクがリアル:検証セットは業務から取得し、高頻度・高コスト・エラーが起きやすいシーンをカバーします。
- 比較が厳密:環境を固定し、実行を繰り返し、モデル乗り換えの基準を事前に決めておきます。
- コスト計算が的確:1回の成功納品あたりのコストと人手介入の回数で、実際の利益を測ります。
新しいモデルがリリースされるたびに、ワークフローを見直すチャンスが訪れます。ランキングやデモ動画に振り回されるのではなく、1〜2日かけて自分の長期的タスクで確実な答えを出してみましょう。APIYI apiyi.com を使えば、新旧モデルを同じAPIインターフェースに載せて素早く比較できます。接続方法は docs.apiyi.com、課金データは docs.apiyi.com/models を参照してください。
📚 参考資料
- 爱范儿 – Tencent Hy4を実測:Hy4の長距離タスク、マルチモーダル、コンピュータ操作に関する実測事例
- リンク:
ifanr.com/1687613 -
説明:
/goalによる目標制約、長距離ゲーム開発、ドキュメントのバッチ処理など、参考になるテスト設計を提供しています -
APIYI ドキュメントセンター:モデル接続とインターフェース形式の説明
- リンク:
docs.apiyi.com -
説明: OpenAIおよびAnthropic互換インターフェースの設定方法を確認できます
-
APIYI モデル価格ページ:各モデルの入力・出力・キャッシュ価格
- リンク:
docs.apiyi.com/models - 説明: コスト計算における唯一の価格根拠です
著者: APIYI 技術チーム
技術交流: APIYI apiyi.com のトップページからお気軽にお問い合わせください。モデル接続に関する詳細資料は docs.apiyi.com のドキュメントセンターをご覧ください