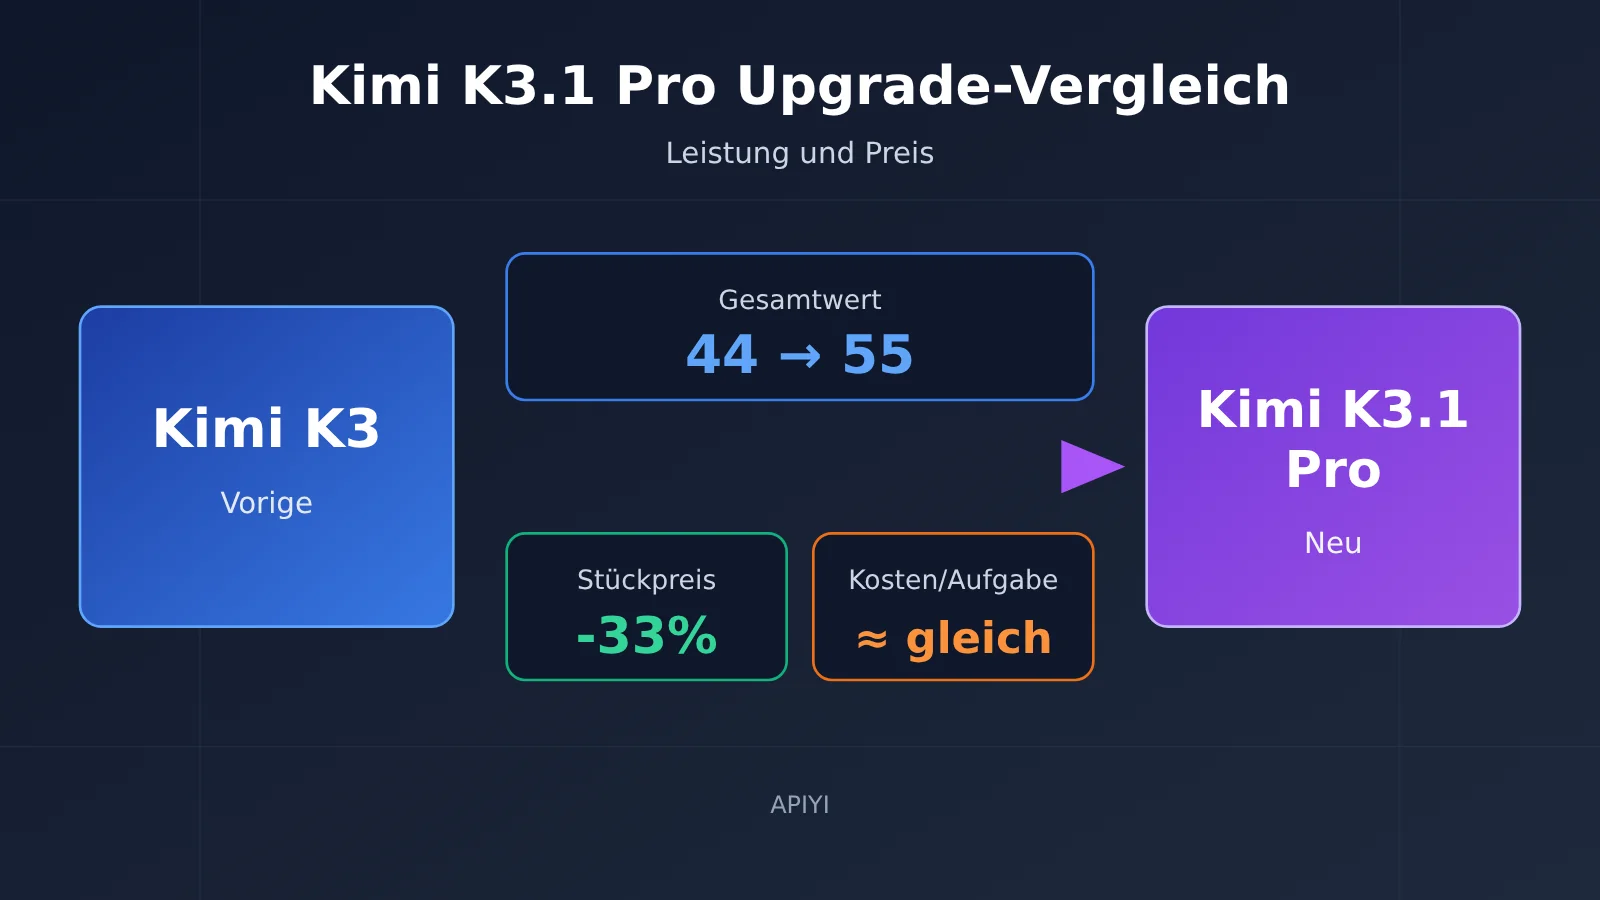
Bei den Fähigkeiten legt Kimi K3.1 Pro gegenüber K3 deutlich zu: Der Gesamtwert von Artificial Analysis steigt von 44 auf 55. Im Terminal-Benchmark Terminal-Bench 4.0 für Coding-Agenten geht es von 13 % auf 67 % nach oben. Gleichzeitig sinken die Preise um ein Drittel: Alle drei Einheitspreise für Eingabe, Ausgabe und Cache liegen 33 % unter denen von K3. Allerdings gibt das Modell längere Antworten aus und denkt immer nach. Deshalb sind die tatsächlichen Kosten pro Aufgabe ungefähr so hoch wie bei K3.
Im Folgenden finden Sie die Belege. Jede Information ist einer von drei Kategorien zugeordnet: „offizielle Angaben“, „Drittanbieter“ oder „nicht verifiziert“. Dieser Artikel ist keine bloße Zusammenfassung der Produktvorstellung und soll auch niemanden zum sofortigen Wechsel bewegen. Er soll Entwicklerinnen und Entwicklern, die derzeit K3 nutzen, dabei helfen zu entscheiden, ob und wann sich ein Wechsel für ihre Anwendungen lohnt und worauf sie dabei achten sollten.
1. Die 5 wichtigsten Unterschiede zwischen Kimi K3.1 Pro und der Vorgängerversion
K3.1 Pro ist kein von Grund auf neu trainiertes Modell, sondern wurde auf Basis von K3 umfassend nachtrainiert. Beim Nachtraining wird ein bereits trainiertes Basismodell mithilfe zusätzlicher Daten und Rückmeldungen darauf abgestimmt, wie es Aufgaben erledigt. Laut Anbieter ist es das „erste Modell der K3.1-Serie“ und das „leistungsstärkste Open-Weight-Modell der 3T-Klasse“. Open Weight bedeutet, dass die Modellgewichte öffentlich zugänglich sind und heruntergeladen sowie selbst bereitgestellt werden können. Artificial Analysis gibt die Gesamtzahl der Parameter mit 2,8 T an. Bei einer einzelnen Berechnung sind davon jeweils 104 B aktive Parameter beteiligt.
| Dimension | Kimi K3 | Kimi K3.1 Pro | Quelle |
|---|---|---|---|
| Trainingsmethode | Basismodell | Auf Basis von K3 nachtrainiert, mit deutlich höherem Rechenaufwand für das Nachtraining | Offizielle Angaben |
| Gesamtleistung | Intelligence Index: 44 | 55, Platz 4 im Gesamtranking | Drittanbieter (AA, 23.10.2026) |
| Preis | Eingabe: 3 $ / Ausgabe: 15 $ | Eingabe: 2 $ / Ausgabe: 10 $, 33 % günstiger | Offizielle Preisangaben |
| Ausgabemenge pro Aufgabe | Durchschnittlich 48K Tokens | Durchschnittlich 55K Tokens, 14 % mehr | Drittanbieter (AA) |
| Kontext / Modalitäten | 1M / Text + Bild | 1M / Text + Bild, unverändert | Offizielle Angaben |
Tokens sind die grundlegende Einheit für Abrechnung und Messung bei Modellen. Grob gesagt handelt es sich um Wortfragmente; ein chinesisches Schriftzeichen entspricht in der Regel ein bis zwei Tokens. Achten Sie beim Lesen der Tabelle zunächst auf zwei Veränderungen: Der Leistungswert ist gestiegen, der Preis pro Einheit gesunken. Die dritte Spalte, „Ausgabemenge pro Aufgabe“, bestimmt, wie viel Sie nach der Preissenkung tatsächlich sparen. Darauf geht Abschnitt 4 näher ein.
Zu den Modellgewichten hat der Anbieter zugesagt, sie bis zum 04.11.2026 vollständig zu veröffentlichen. Zum aktuellen Zeitpunkt (24.10.2026) ist das noch ein Versprechen und wurde nicht umgesetzt. Der Status lautet daher „nicht verifiziert“. Artificial Analysis geht davon aus, dass K3.1 Pro nach der Veröffentlichung der Gewichte das bestplatzierte Open-Weight-Modell im eigenen Ranking sein wird. Der Abstand zwischen dem bestplatzierten Open-Weight-Modell und dem bestplatzierten proprietären Modell würde sich demnach von 12 auf 3 Punkte verringern.
2. Benchmark-Vergleich von Kimi K3.1 Pro: zwei unterschiedliche Maßstäbe – Herstellerangaben und unabhängige Tests
Vorweg ein wichtiger Hinweis: Die beiden folgenden Tabellen stammen von unterschiedlichen Organisationen und wurden unter verschiedenen Testbedingungen erstellt. Die Ergebnisse lassen sich daher nicht direkt miteinander vergleichen. Besonders deutlich wird das bei Terminal-Bench 4.0: Moonshot gibt 65,7 % an, während Artificial Analysis unabhängig 67 % gemessen hat. Das sind die Ergebnisse zweier separater Tests – nicht zwei leicht voneinander abweichende Angaben zu ein und demselben Ergebnis. Für K3 hat der Hersteller kein Ergebnis für Terminal-Bench 4.0 veröffentlicht. Die 13 % für K3 stammen ausschließlich von Artificial Analysis.
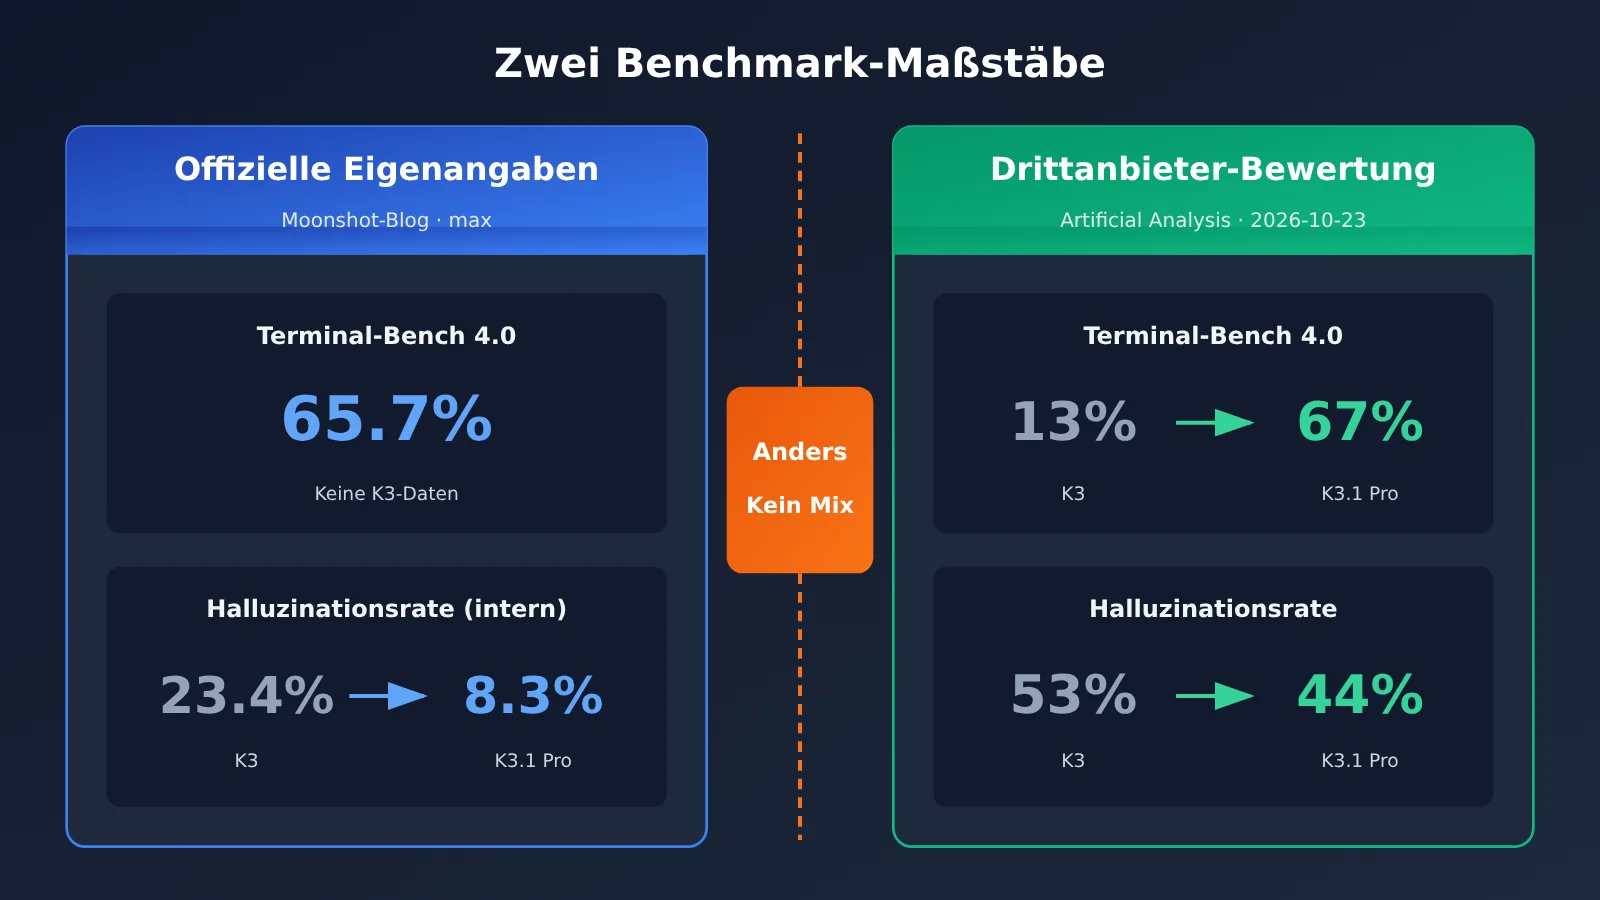
2.1 Vom Hersteller veröffentlichte Benchmark-Ergebnisse für Kimi K3.1 Pro
Quelle: offizieller Moonshot-Blog. Testbedingungen: Sofern nicht anders angegeben, wurde mit reasoning_effort=max (maximale Schlussfolgerungsintensität), temperature=1.0 und top_p=0.95 getestet. Als „intern“ gekennzeichnete Testsätze wurden von Moonshot selbst erstellt und lassen sich extern nicht reproduzieren.
| Benchmark | K3.1 Pro | Vergleichswerte | Anmerkungen |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7 % | GPT-6 Astra: 58,2 %, Claude Opus 5.5: 66,4 % | Opus 5.5 wurde mit dem Claude-Code-Harness getestet |
| Kimi Code Bench 3.0 Long-horizon | 61,2 % | K3: 55,95 % | Intern; Programmieraufgaben mit langen Ausführungsketten |
| BenchCAD | 92,7 % (mit Tools) | Opus 5.5: 96,2 %, GPT-6 Astra: 95,9 % | Mehransichten-Zeichnungen werden in CAD-Code umgewandelt |
| OfficeQA Pro v2 | 64,4 | Höher als K3 | Analyse realer Finanzberichte; laut Hersteller auf dem Stand der Technik (SOTA) |
| Financial Modeling / Research | 7,2 / 11,6 Punkte höher als K3 | K3 | Intern |
| Business Operation | Etwa 4,2-mal so hoch wie bei K3 | K3 | Interne Simulation von Geschäftsvorgängen |
| Kimi Hallu Bench Hard | Halluzinationsrate auf Claim-Ebene: 8,3 % | K3: 23,4 % | Interner Stresstest zur Faktentreue |
| xdev-bench-hard (pass@3) | 81,0 % | 90,5 % in der Vergleichsversion ohne Sicherheitsfilter | Aufspüren von Sicherheitslücken |
Einige Begriffe zur Einordnung: Ein Harness ist das „Steuerungsgerüst“, das beim Test um das Modell herum eingesetzt wird. Es ruft Tools auf und führt Befehle aus. Da sich die Ergebnisse je nach Harness unterscheiden können, sollte der Wert für Opus 5.5 separat betrachtet werden. pass@3 bedeutet, dass das Modell drei Versuche für dieselbe Aufgabe erhält. Ein einziger richtiger Versuch genügt, damit die Aufgabe als bestanden gilt. Die letzte Zeile besagt, dass der Hersteller die Fähigkeit des Modells, Sicherheitslücken aufzuspüren, aus Sicherheitsgründen bewusst begrenzt hat. Die offizielle Version liegt rund 9,5 Prozentpunkte unter der internen Version ohne diese Einschränkungen.
2.2 Kimi K3.1 Pro: Benchmarks von Drittanbietern (Artificial Analysis)
Quelle: Artificial Analysis, Datenstand 2026-10-23. Die Tests wurden von der Organisation nach einem einheitlichen Verfahren durchgeführt; für K3 und K3.1 Pro kam dieselbe Methodik zum Einsatz.
| Kennzahl | K3.1 Pro | K3 | Veränderung |
|---|---|---|---|
| Intelligence Index | 55 (Platz 4) | 44 | +11 |
| GDPval-AA (Elo-Wertung für reale Arbeitsaufgaben) | 1846 (Platz 3) | 1534 | +312 |
| Terminal-Bench 4.0 | 67 % | 13 % | +54 Prozentpunkte |
| AutomationBench-AA (SaaS-Workflows) | 73 % | 58 % | +15 |
| Humanity’s Last Exam | 52 % | 47 % | +5 |
| CritPt / SciCode | 25 % / 61 % | 23 % / 59 % | +2 / +2 |
| AA-Omniscience Index | 30 | 20 | +10 |
| Halluzinationsrate / Genauigkeit | 44 % / 51 % | 53 % / 48 % | Halluzinationen −9 |
| Durchschnittliche Ausgabetokens pro Aufgabe | 55K | 48K | +14 % |
Im Ranking von Artificial Analysis belegt K3.1 Pro Platz 4. Davor liegen Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) und Muse Wonder Full (56). Mit 67 % erzielt K3.1 Pro bei Terminal-Bench 4.0 den höchsten Wert aller von der Organisation getesteten Modelle; Sonnet 5.5 kommt auf 64 %.
Beide Testreihen zeigen bei Halluzinationen denselben Trend, die konkreten Werte unterscheiden sich jedoch deutlich: Im internen Stresstest des Herstellers sank die Rate von 23,4 % auf 8,3 %, bei AA von 53 % auf 44 %. Die Tests basieren nicht auf denselben Aufgaben; auch Schwierigkeitsgrad und Auswertungsmethoden unterscheiden sich. Geben Sie bei Zitaten daher immer die Quelle an und fassen Sie die Ergebnisse nicht zu einer Aussage wie „Die Halluzinationsrate sank auf 8 %“ zusammen.
3. In diesen 5 Bereichen ist Kimi K3.1 Pro deutlich besser geworden
In diesem Abschnitt geht es nur um Bereiche, in denen beide Datensätze eine Verbesserung zeigen oder der Fortschritt besonders groß ist.
- Programmier-Agenten und Terminalaufgaben. Ein Agent ist ein KI-Assistent, der Aufgaben selbstständig in Teilschritte zerlegen, Tools aufrufen und mehrere Schritte ausführen kann. AA misst bei Terminal-Bench 4.0 einen Anstieg von 13 % auf 67 %. In einem offiziellen internen Test zu mehrstufigen Programmieraufgaben stieg der Wert von 55,95 % auf 61,2 %. Wenn K3 bei Code-Agenten häufig an der Ausführung von Befehlen, Dateioperationen oder der Fehlersuche über mehrere Schritte hinweg scheitert, ist dies die deutlichste Verbesserung.
- Aufgaben aus dem Arbeitsalltag. GDPval-AA bewertet mit einem Elo-Wert, wie gut ein Modell reale berufliche Aufgaben bewältigt. Elo ist ein Ranglistensystem, das etwa beim Schach verwendet wird. Je größer der Punkteunterschied, desto größer ist auch der Unterschied bei der Gewinnwahrscheinlichkeit. K3.1 Pro liegt 312 Punkte vor K3 und auf Platz 3. Das spricht für deutliche Fortschritte bei alltäglichen Aufgaben wie dem Verfassen von Konzepten, dem Erstellen von Tabellen und dem Aufbereiten von Unterlagen.
- Automatisierung von SaaS-Workflows. AutomationBench-AA misst, wie gut ein Modell automatisierte Abläufe über verschiedene Online-Programme hinweg ausführt – etwa E-Mails lesen, Support-Tickets bearbeiten oder Tabellen synchronisieren. Der Wert stieg von 58 % auf 73 %. In einem offiziellen internen Simulationstest für Geschäftsabläufe (Business Operation) erreichte das Modell etwa das 4,2-Fache des K3-Werts. Auch das deutet auf bessere Fähigkeiten bei längeren Abläufen hin. Diese Angabe stammt jedoch aus internen Daten und ist daher mit Vorsicht zu betrachten.
- Faktentreue und Halluzinationen. Von Halluzinationen spricht man, wenn ein Modell mit großer Überzeugung Fakten erfindet, die nicht existieren. In einem offiziellen internen Test sank die Halluzinationsrate auf Ebene einzelner Aussagen von 23,4 % auf 8,3 %. Die Zahl der Antworten mit mindestens einem Faktenfehler fiel auf 42,4 % des K3-Werts. Bei AA sank die Halluzinationsrate von 53 % auf 44 %, während die Genauigkeit von 48 % auf 51 % stieg.
- Finanzmodellierung und Research-Berichte. Laut Hersteller erzielte das Modell bei OfficeQA Pro v2 mit 64,4 Punkten einen SOTA-Wert (die derzeit beste Leistung). In den internen Tests Financial Modeling und Financial Research lag es um 7,2 beziehungsweise 11,6 Punkte vor K3. Diese Ergebnisse wurden von unabhängigen Dritten bislang nicht erneut geprüft und sind daher als „vom Hersteller selbst berichtet“ einzuordnen.
Auch bei Kennzahlen zum wissenschaftlichen Denken (Humanity’s Last Exam, CritPt und SciCode) gab es Verbesserungen, allerdings nur um 2 bis 5 Prozentpunkte. Wenn sich Ihre Arbeit vor allem um akademische Fragen und Forschungscode dreht, fällt der Fortschritt bei K3.1 Pro geringer aus als bei Agent-Aufgaben. Ein Wechsel ist für diese Nutzergruppe allein wegen dieser Ergebnisse nicht dringend.
4. Was sich bei Kimi K3.1 Pro kaum geändert hat – und welche Kosten tatsächlich anfallen
4.1 Drei Dinge, die bei Kimi K3.1 Pro unverändert geblieben sind
- Das Kontextfenster umfasst weiterhin 1M Tokens: 1.048.576 Tokens, genauso viel wie bei K3. Das Kontextfenster gibt an, wie viel Inhalt das Modell auf einmal „sehen“ kann.
- Die Modalitäten bleiben Text und Bild: Audio, Video oder andere Eingabearten sind nicht hinzugekommen.
- Der Anbieter hat keine offiziellen Geschwindigkeitsbenchmarks veröffentlicht: AA hat eine Ausgabegeschwindigkeit von 80,7 Tokens pro Sekunde gemessen. In der vierstufigen Geschwindigkeitsskala der Organisation entspricht das der zweiten Stufe. Laut Anbieter ist die highspeed-Version zwei- bis dreimal schneller. Da jedoch keine reproduzierbaren Testbedingungen angegeben wurden, gilt diese Aussage vorerst als „nicht verifiziert“.
4.2 Preisvergleich der fünf Abrechnungsarten von Kimi K3.1 Pro
Die folgenden Preise stammen vom Anbieter. Abgerufen am 24.10.2026, US-Dollar pro Million Tokens, ohne Steuern.
| Modell | Eingabe | Ausgabe | Cache-Treffer | Schreibvorgang für 5 Minuten | Schreibvorgang für 1 Stunde |
|---|---|---|---|---|---|
kimi-k3.1-pro |
$2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
kimi-k3 |
$3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
Ein Cache-Treffer bedeutet, dass identische Inhalte am Anfang einer wiederholten Anfrage – zum Beispiel eine feste System-Eingabeaufforderung oder dasselbe lange Dokument – ab dem zweiten Mal günstiger abgerechnet werden. Die Schreibvorgänge für 5 Minuten und 1 Stunde beziehen sich auf die Kosten, wenn Inhalte im Cache gespeichert werden. Je länger die Speicherung, desto höher der Preis. Bei Agenten oder Fragen zu langen Dokumenten kann Caching viel ausmachen: Wenn die Struktur der Eingabeaufforderung stabil ist, lassen sich bei den Eingabekosten oft deutliche Einsparungen erzielen.
4.3 Die tatsächlichen Kosten von Kimi K3.1 Pro: Ein niedrigerer Preis bedeutet nicht automatisch geringere Kosten
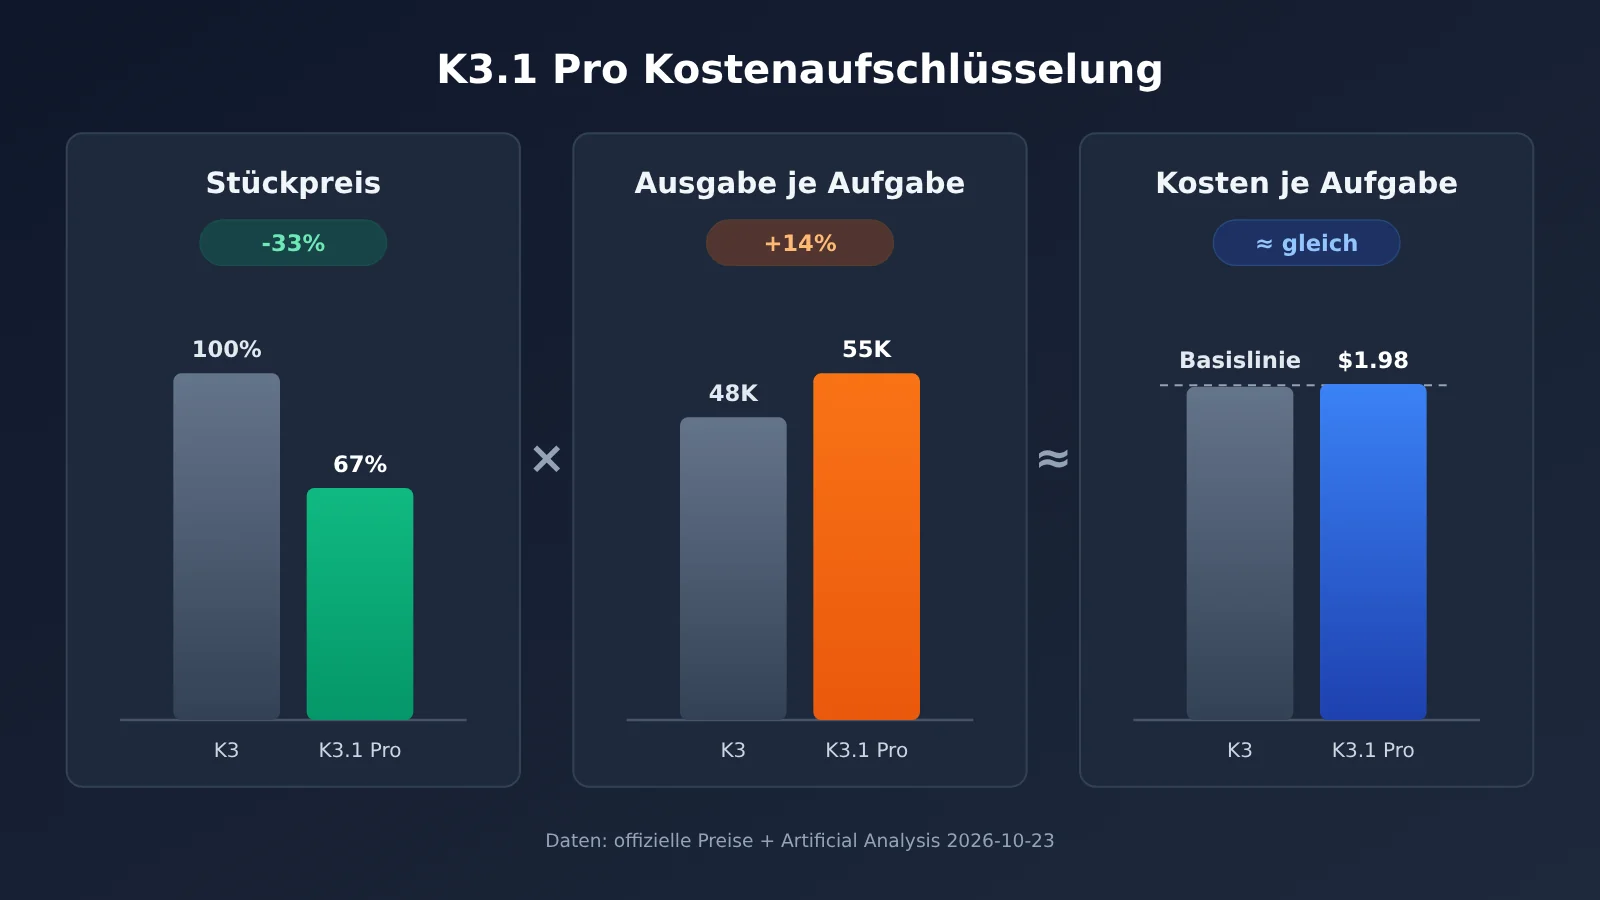
K3.1 Pro denkt immer: Vor jeder Antwort führt das Modell zunächst interne Schlussfolgerungen durch, die als Ausgabe-Tokens abgerechnet werden. AA hat pro Aufgabe durchschnittlich 55K ausgegebene Tokens gemessen – 14 % mehr als bei K3 mit 48K.
Beim Stückpreis müsste die Senkung um 33 % eigentlich zu deutlichen Einsparungen führen. In den Messungen von AA lagen die Kosten pro Aufgabe jedoch bei etwa $1.98 (auf der Modell-Detailseite werden $2.11 angegeben) und damit ungefähr auf dem Niveau von K3. Die Organisation hat keine Aufschlüsselung der Kosten veröffentlicht. Warum die Einsparungen ausbleiben, ist daher bislang nicht offiziell erklärt. Eine mögliche Erklärung ist, dass bei mehrstufigen Agentenaufrufen auch die Zahl der Eingabe-Tokens steigt. Das ist jedoch nur eine Vermutung und gilt als „nicht verifiziert“.
Die highspeed-Version kostet außerdem doppelt so viel wie die Standardversion. Teams, für die die Kosten eine wichtige Rolle spielen, sollten vor einem Wechsel eine Stichprobe ihrer tatsächlichen Aufgaben ausführen und die Gesamtkosten vergleichen, statt nur die Stückpreise gegenüberzustellen.
Wenn Sie die tatsächlichen Kosten von K3 und K3.1 Pro mit demselben Code vergleichen möchten, können Sie zunächst die OpenAI-kompatible API von APIYI auf apiyi.com anbinden und mit kimi-k3 einen Basiswert ermitteln. Modellname und Preis von K3.1 Pro auf der Plattform entnehmen Sie bitte der dortigen Modellliste. Wir werden dieses Modell so bald wie möglich bereitstellen.
5. Empfehlungen für den Einsatz von Kimi K3.1 Pro: Wann sich der Wechsel lohnt – und wann nicht
Die Einschätzungen nach Aufgabentyp richten sich an Nutzer, die bereits K3 einsetzen.
| Aufgabentyp | Empfehlung | Begründung |
|---|---|---|
| Coding-Agenten und Terminal-Automatisierung | Möglichst bald wechseln | Terminal-Bench 4.0 stieg laut Drittanbieter-Benchmark von 13 % auf 67 %. Bei komplexen Programmieraufgaben über mehrere Schritte hinweg liegt das Modell laut Hersteller um mehr als 5 Punkte vorn. |
| Dokumentenanalyse, Research-Berichte und Finanzmodellierung | Wechseln | GDPval Elo: +312. Bei Tests des Herstellers zu Geschäftsberichten und Research-Berichten liegt das Modell durchgehend vor K3. Außerdem treten deutlich weniger Halluzinationen auf. |
| SaaS-Workflows und mehrstufige Geschäftsprozesse | Wechseln | AutomationBench-AA stieg von 58 % auf 73 %. |
| Viele kleine Aufgaben (Klassifizierung, Extraktion, Umformulierung) | Kein dringender Wechsel nötig | Die Kosten pro Aufgabe entsprechen denen von K3. Der durchgehende Denkmodus führt zu mehr Ausgabetokens; bei einfachen Aufgaben bringt die höhere Leistungsfähigkeit kaum Vorteile. |
| Latenzempfindliche Einsatzbereiche (Echtzeitdialoge, Online-Kundenservice) | Erst testen, dann entscheiden | Der Hersteller macht keine Angaben zur Geschwindigkeit. Der durchgehende Denkmodus kann die Zeit bis zum ersten Token verlängern; im Modus „highspeed“ verdoppelt sich der Preis. |
„Kein dringender Wechsel nötig“ bedeutet nicht, dass K3 ungeeignet ist. Für einfache Aufgaben reicht K3 bereits aus; außerdem lassen sich Latenz und Kosten besser abschätzen. Es gibt keinen Grund, die gesamte Batch-Pipeline nur wegen eines höheren Gesamtscores umzubauen. Sobald die Gewichte von K3.1 Pro verfügbar sind und umfassendere Geschwindigkeitsdaten von Drittanbietern vorliegen, können Sie die Lage neu bewerten. Bis dahin ist noch genug Zeit.
5.1 Typische Einsatzbereiche für Kimi K3.1 Pro
- Fehler in einem Code-Repository beheben, Code umstrukturieren oder Tests schreiben – insbesondere, wenn das Modell selbst Befehle ausführen, Fehlermeldungen prüfen und den Code anschließend anpassen soll.
- Fragen zu umfangreichen Geschäftsberichten, Verträgen und Research-Berichten beantworten und diese zusammenfassen, wenn es besonders auf Faktenrichtigkeit ankommt.
- Automatisierte Abläufe über mehrere Online-Tools hinweg, bei denen eine einzelne Aufgabe mehr als zehn Schritte umfasst.
5.2 Typische Einsatzbereiche, in denen Sie Kimi K3 vorerst beibehalten können
- Klassifizierung von Labels und Extraktion von Feldern bei Hunderttausenden Datensätzen pro Tag, wenn die Kosten pro Eintrag berechnet werden.
- Echtzeitinteraktionen mit stabil niedriger Latenz, für die Timeout- und Wiederholungsparameter bereits auf K3 abgestimmt sind.
Empfehlung: Am zuverlässigsten ist ein Test mit 50 bis 100 realen Beispielen aus Ihrem eigenen Anwendungsfall. Führen Sie diese mit beiden Modellen aus und vergleichen Sie die Erfolgsquote sowie die Gesamtkosten. Über APIYI auf apiyi.com können Sie mit einem einzigen API-Schlüssel zwischen verschiedenen Modellen wechseln – ideal für solche Vergleichstests. Bis K3.1 Pro verfügbar ist, können Sie mit
kimi-k3eine Baseline erstellen. Modellbezeichnung und Preis von K3.1 Pro entnehmen Sie bitte der Modellliste der Plattform. Wir werden dieses Modell so bald wie möglich anbieten.
6. Empfehlungen und Hinweise zur Migration auf Kimi K3.1 Pro
6.1 Zeitplan für die Abschaltung der Kimi-K2-Serie
Falls du noch Aufrufe der K2-Serie verwendest, solltest du diese zuerst umstellen. Laut offizieller Dokumentation ist die K2-Serie ab dem 31.10.2026 für neu registrierte Nutzer nicht mehr verfügbar. Bis Ende 2026 wird sie vollständig abgeschaltet. Bestandsnutzer können sie zwar vorerst weiterverwenden, sollten die Migration aber in den nächsten zwei Monaten abschließen und direkt zu K3 oder K3.1 Pro wechseln, statt bis kurz vor der Abschaltung zu warten.
6.2 Drei wichtige Punkte beim Wechsel zu Kimi K3.1 Pro
- Eine neue Sitzung starten und das Modell nicht mitten im Gespräch wechseln. Laut offizieller Empfehlung solltest du K3.1 Pro in einer neuen Sitzung verwenden. Wenn du den bisherigen Gesprächsverlauf mit K3 an K3.1 Pro übergibst und dort fortsetzt, kann es zu Inkompatibilitäten beim Kontextformat oder bei den Denkinhalten kommen.
- Möglichst die nativen Schnittstellen verwenden. Laut offizieller Empfehlung sind die nativen Schnittstellen Responses, Chat Completions und Messages am zuverlässigsten.
- Den Modellnamen genau angeben. Wenn du in einem Drittanbieter-Tool
kimi-k3.1-profalsch eingibst, wird die Anfrage auf K2.8 Preview zurückgesetzt, das nicht nachdenkt. Dabei wird kein Fehler ausgegeben, sondern lediglich ein schlechteres Ergebnis geliefert – die Fehlersuche kann deshalb viel Zeit in Anspruch nehmen. Prüfe vor dem Produktivstart das Modellfeld in der Antwort.
6.3 Unterschiede zwischen den Mitgliedschaftsstufen bei Kimi Code
Für die Nutzung des neuen Modells in Kimi Code gelten bestimmte Voraussetzungen für die Mitgliedschaft:
k3.1-proerfordert eine Plus-Mitgliedschaft oder höher.- Ein Kontextfenster von 1M erfordert eine Pro-Mitgliedschaft oder höher.
- Die Highspeed-Version erfordert eine Pro-Mitgliedschaft oder höher und verbraucht ungefähr die doppelte Kontingentmenge.
Mit einer Plus-Mitgliedschaft kannst du K3.1 Pro nutzen, erhältst aber nicht das vollständige Kontextfenster von 1M. Wenn du vor allem ein sehr großes Kontextfenster benötigst, um ein ganzes Code-Repository zu analysieren, solltest du vor einem Upgrade prüfen, welche Mitgliedschaftsstufe dafür erforderlich ist.
6.4 Checkliste für die API-Anbindung
- Setze
base_urlaufhttps://api.apiyi.com/v1. Das ist die OpenAI-kompatible Adresse von APIYI auf apiyi.com. In deinem bestehenden OpenAI-SDK-Code musst du dann nur diesen Wert und den Schlüssel ändern. - Verwende für
modelzunächstkimi-k3, um den Ablauf zu testen. Trage anschließend anhand der Modellliste der Plattform die genaue Modellbezeichnung für K3.1 Pro ein. Maßgeblich für Modellbezeichnung und Preis von K3.1 Pro ist die Modellliste der Plattform. Wir werden dieses Modell so bald wie möglich anbieten. - Setze das Timeout großzügiger, da das kontinuierliche Nachdenken die Antwortzeit einzelner Anfragen verlängert.
- Wähle
max_tokensnicht zu knapp, damit die Denkinhalte nicht den Platz für die eigentliche Antwort verdrängen.
Häufige Fragen (FAQ)
F1: Was ist Kimi K3.1 Pro und in welchem Verhältnis steht es zu K3?
K3.1 Pro ist eine neue Version von Moonshot, die durch zusätzlichen Rechenaufwand beim Post-Training auf Basis von K3 entstanden ist. Laut offizieller Aussage ist es das erste Modell der K3.1-Serie. Kontextfenster und Eingabemodalitäten sind dieselben wie bei K3. Die wichtigsten Verbesserungen betreffen Coding-Agenten, reale Arbeitsaufgaben und die Faktengenauigkeit.
F2: Liegt Kimi K3.1 Pro bei Terminal-Bench nun bei 65,7 % oder bei 67 %?
Beide Werte stimmen, stammen aber aus unterschiedlichen Quellen: 65,7 % ist die vom Hersteller angegebene Punktzahl, 67 % wurde von Artificial Analysis unabhängig gemessen. Da Testumgebung und Harness voneinander abweichen, sind die Werte nicht direkt vergleichbar. Geben Sie bei Zitaten bitte die jeweilige Quelle an.
F3: Warum spart Kimi K3.1 Pro trotz eines um 33 % niedrigeren Preises pro Einheit kein Geld?
Das Modell denkt immer nach und gibt pro Aufgabe durchschnittlich 14 % mehr aus als K3. Laut Messungen von AA liegen die Kosten pro Aufgabe bei etwa 1,98 US-Dollar (auf der Modellseite werden 2,11 US-Dollar angegeben) und damit ungefähr auf dem Niveau von K3. Die genaue Ursache hat die Organisation nicht aufgeschlüsselt. Am besten testen Sie Ihre eigenen Aufgaben.
F4: Wann werden die Gewichte von Kimi K3.1 Pro veröffentlicht?
Der Hersteller hat zugesagt, die vollständigen Gewichte bis zum 04.11.2026 zu veröffentlichen. Zum Stand vom 24.10.2026 ist dies weiterhin nur eine Zusage und noch nicht umgesetzt. Richten Sie Pläne zur Selbstbereitstellung nach der tatsächlichen Veröffentlichung durch den Hersteller aus.
F5: Wie kann ich Kimi K3.1 Pro und K3 schnell per API vergleichen?
Registrieren Sie sich bei APIYI unter apiyi.com, um einen API-Schlüssel und ein kostenloses Testkontingent zu erhalten. Über die OpenAI-kompatible Schnittstelle können Sie zunächst `kimi-k3` als Basis verwenden. Modellname und Preis von K3.1 Pro auf der Plattform entnehmen Sie bitte der Modellliste. Wir werden das Modell so bald wie möglich anbieten. Sobald es verfügbar ist, können Sie einfach den Parameter `model` ändern und die Modelle vergleichen.
F6: Welche bekannten Einschränkungen hat Kimi K3.1 Pro?
– Der Hersteller hat keine Geschwindigkeitsbenchmarks veröffentlicht. Die Highspeed-Version kostet doppelt so viel.
– Das Modell denkt immer nach und eignet sich daher nicht für Anwendungsfälle mit extrem niedriger Latenz.
– Einige beeindruckende Ergebnisse stammen aus internen Testsätzen und lassen sich extern nicht reproduzieren.
– Die Fähigkeiten zur Schwachstellensuche sind aus Sicherheitsgründen eingeschränkt und fallen geringer aus als bei der ungefilterten Version.
F7: Ich verwende noch K2. Sollte ich direkt auf K3.1 Pro migrieren?
Die K2-Serie wird ab dem 31.10.2026 für neue Nutzer geschlossen und bis Ende des Jahres eingestellt. Eine Migration ist daher erforderlich. Anwendungen mit Coding-Agenten und Dokumentenverarbeitung können direkt auf K3.1 Pro migriert werden. Für viele kleine Aufgaben ist K3 die unkompliziertere und günstigere Wahl. Auf APIYI unter apiyi.com können Sie die Migration zunächst mit `kimi-k3` durchführen. Modellname und Preis von K3.1 Pro entnehmen Sie bitte der Modellliste. Wir werden das Modell so bald wie möglich anbieten.
Kimi K3.1 Pro: Die wichtigsten Erkenntnisse
- Deutlich leistungsfähiger: Der AA-Gesamtwert steigt von 44 auf 55. Damit liegt das Modell auf Platz 4 – nur drei geschlossene Modelle schneiden besser ab.
- Größter Fortschritt bei Coding-Agenten: Im Praxistest eines Drittanbieters auf Terminal-Bench 4.0 steigt der Wert von 13 % auf 67 %.
- Zwei Datensätze getrennt betrachten: Die Selbstauskunft des Anbieters und die AA-Bewertung basieren auf unterschiedlichen Maßstäben. Bei Zitaten muss die Quelle angegeben werden.
- Niedrigerer Preis bedeutet nicht automatisch geringere Kosten: Der Preis pro Einheit sinkt um 33 %, die Kosten pro Aufgabe bleiben jedoch in etwa auf dem Niveau von K3.
- Grundlegende Spezifikationen unverändert: 1M Kontextfenster, Text und Bild; der Anbieter macht keine Angaben zur Geschwindigkeit.
- Beim Wechsel den Modellnamen exakt angeben: Bei einem Schreibfehler wird stattdessen K2.8 Preview verwendet, das nicht im Denkmodus arbeitet.
- Anbindung: Sie können zunächst mit APIYI auf apiyi.com eine K3-Baseline ermitteln. Modellname und Preis für K3.1 Pro entnehmen Sie bitte der Modellliste der Plattform. Wir werden dieses Modell so bald wie möglich anbieten.
Fazit: Lohnt sich der Wechsel von K3 zu Kimi K3.1 Pro?
Die Änderungen gegenüber der Vorgängerversion lassen sich in drei Punkten zusammenfassen:
- Leistungsfähigkeit: Coding-Agenten, Terminal-Aufgaben, Aufgaben aus der Praxis, SaaS-Automatisierung und Faktentreue verbessern sich deutlich. Die Daten von Drittanbietern und des Anbieters weisen in dieselbe Richtung.
- Preis: Der Preis pro Einheit ist in allen fünf Stufen um 33 % niedriger als bei K3. Da das Modell jedoch durchgehend im Denkmodus arbeitet und dadurch längere Ausgaben erzeugt, sinken die Kosten pro Aufgabe kaum.
- Migration: Für Anwendungen mit Coding-Agenten sowie für Dokumente und Rechercheberichte empfiehlt sich ein zeitnaher Wechsel. Bei vielen kleinen Aufgaben und in latenzsensiblen Szenarien sollten Sie zuerst testen und dann entscheiden. Wer K2 nutzt, sollte die Migration bis Ende des Jahres abschließen.
APIYI auf apiyi.com bietet derzeit bereits Kimi-Modelle wie kimi-k3 (Eingabe: 3 $, Ausgabe: 15 $) an. Über denselben Key und eine OpenAI-kompatible Schnittstelle können Sie zunächst eine Kosten- und Leistungsbaseline erstellen. Modellname und Preis für Kimi K3.1 Pro auf der Plattform entnehmen Sie bitte der Modellliste. Wir werden dieses Modell so bald wie möglich anbieten. Nach dem Start können Sie einfach den Modellnamen austauschen und die Ergebnisse vergleichen.
Referenzen
- Offizieller Moonshot-Blog: Ankündigung zur Veröffentlichung von Kimi K3.1 Pro und vom Unternehmen veröffentlichte Benchmark-Ergebnisse
- Hinweis: Diese Quelle liefert die Daten für die Kategorie „vom Anbieter selbst veröffentlicht“. Die Testbedingungen waren
reasoning_effort=max,temperature=1.0undtop_p=0.95. - Offizielle Moonshot-Dokumentation: Preise, Zeitplan für die Abschaltung von K2, Empfehlungen zum Modellwechsel und Informationen zur Kimi-Code-Mitgliedschaft
- Hinweis: Die Preise wurden am 24.10.2026 erfasst. Sie verstehen sich in US-Dollar pro Million Tokens und ohne Steuern.
- Artificial Analysis: Unabhängige Bewertung durch Dritte
- Link:
artificialanalysis.ai - Hinweis: Diese Quelle liefert die Daten für die Kategorie „Drittanbieter“. Die Daten stammen vom 23.10.2026.
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite der APIYI-Website. Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com. Modellbezeichnung und Preis von Kimi K3.1 Pro richten sich nach der Modellliste der Plattform. Wir werden dieses Modell so bald wie möglich anbieten.