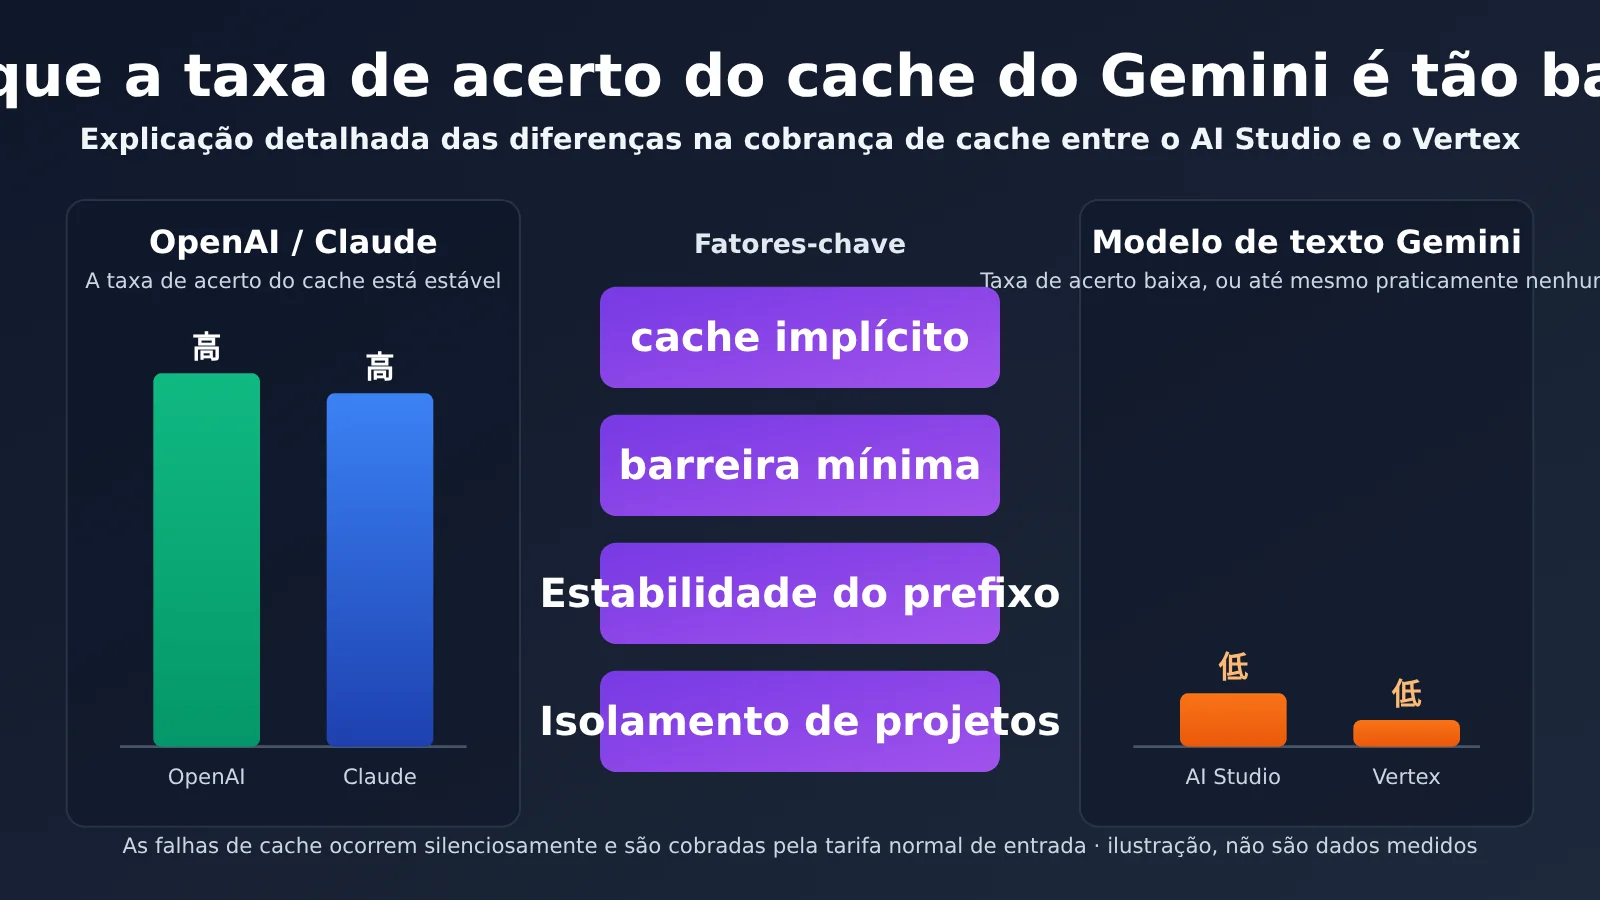
No uso real da APIYI, o armazenamento e a recuperação de cache funcionam normalmente nas séries OpenAI e Claude, com taxas de acerto altas. Os modelos de texto do Gemini são diferentes: a taxa de acerto do cache é baixa ou quase nula. Esse é um fato que pode ser reproduzido nas faturas e nos detalhes de uso, e também é um dos pontos que mais confundem os desenvolvedores na hora de conferir as cobranças.
Com base na documentação oficial do Google, atualizada até 20 de outubro de 2026, este artigo analisa 5 categorias de motivos para a baixa taxa de acerto do cache do Gemini e explica como funcionam as regras de cobrança de cache no AI Studio (Gemini Developer API) e no Vertex AI.
Este não é um artigo para “culpar terceiros”. O Google não tem nenhuma regra oficial dizendo que “usar um intermediário reduz a taxa de acerto do cache do Gemini”, e também não podemos afirmar que um motivo específico seja necessariamente responsável sem ter acesso aos registros das solicitações enviadas ao provedor. A proposta deste artigo é apresentar primeiro as regras oficiais, depois explicar quais condições podem fazer com que elas não se apliquem e, por fim, mostrar um método de investigação e conferência de cobranças que você pode executar por conta própria.
O que você vai aprender: ao terminar a leitura, você saberá quando o cache do Gemini é acionado e quando não é, entenderá o ponto essencial de cobrança — “a entrada total inclui a parte armazenada em cache” — e poderá conferir as cobranças de forma independente usando os campos da resposta oficial.
Pontos principais sobre a taxa de acerto do cache do Gemini
Vamos direto às conclusões. Para entender o cache do Gemini, primeiro é preciso distinguir dois mecanismos: o cache implícito e o cache explícito. A forma de acionamento e a cobrança são bem diferentes em cada um.
| Tipo | Como usar | Como obter o desconto de cache | Há taxa de armazenamento? |
|---|---|---|---|
| Cache implícito (Implicit caching) | Ativado automaticamente nos modelos compatíveis; não é necessário criar um objeto de cache | Quando a solicitação realmente acerta o cache, a parte correspondente é cobrada pelo preço de cache; não há garantia de acerto em todas as solicitações | Não |
| Cache explícito (Explicit caching) | Crie um objeto de cache e referencie-o nas solicitações seguintes | As entradas do cache referenciadas enquanto ele estiver válido recebem o preço de cache | Sim |
A documentação oficial do Developer API faz uma observação importante sobre o cache implícito: ele não garante economia. O cache explícito oferece mais previsibilidade, mas exige trabalho adicional de desenvolvimento, como criar o objeto de cache, gerenciar seu prazo de validade e referenciá-lo nas solicitações seguintes.
Por que a experiência com o Gemini é diferente da experiência com OpenAI e Claude
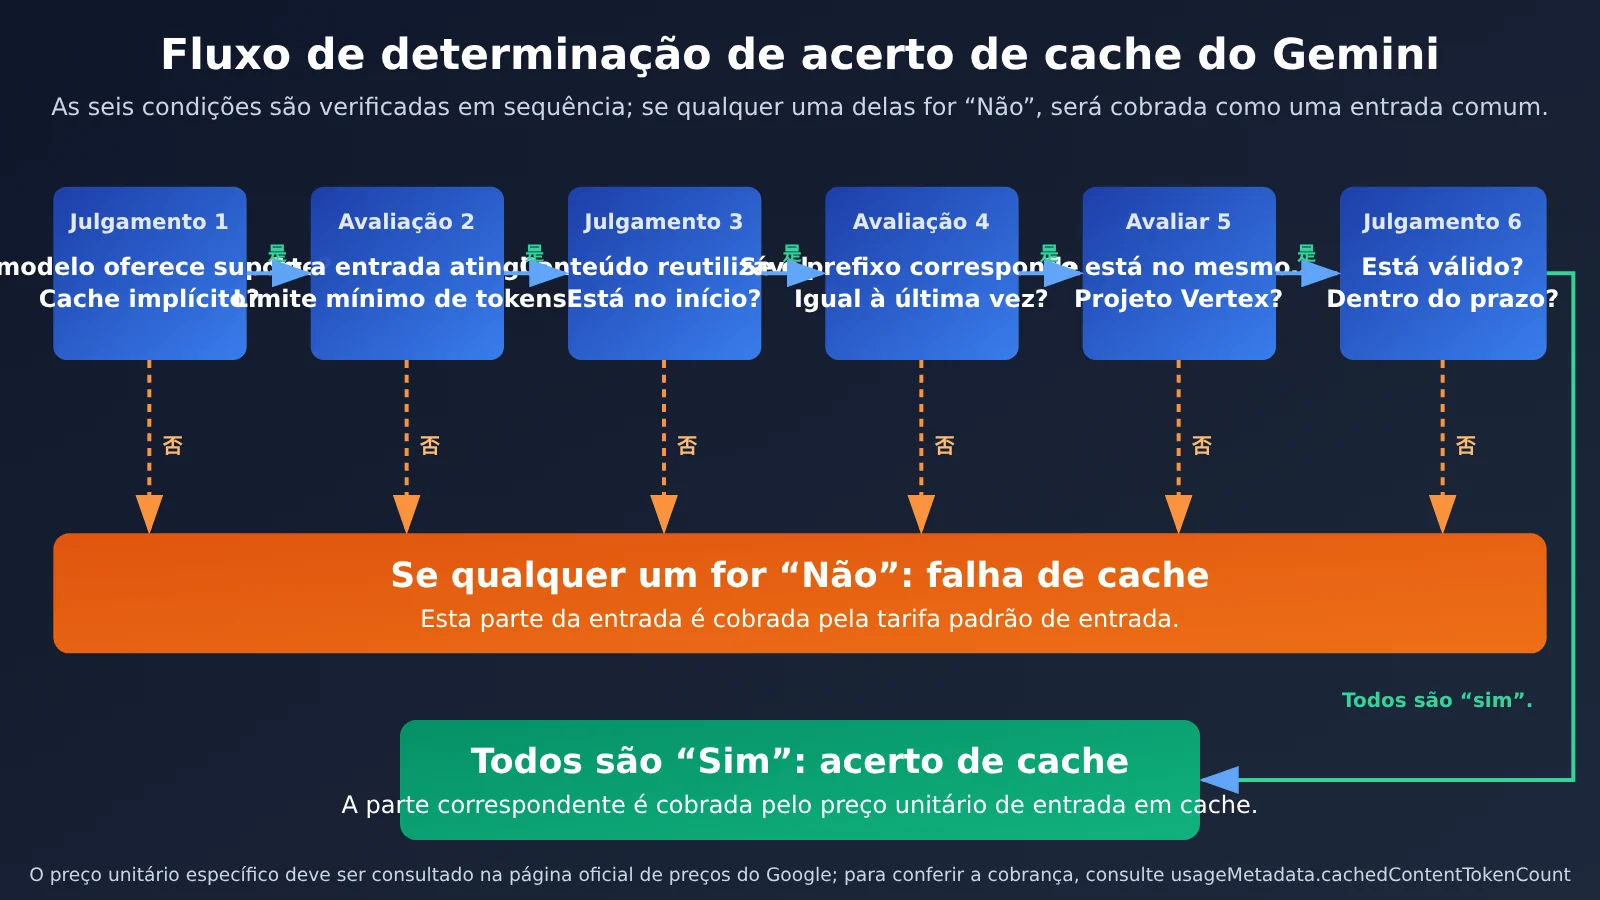
Do ponto de vista de quem usa, as séries OpenAI e Claude na APIYI dão a impressão de que “basta enviar o mesmo prefixo longo para ver o cache ser gravado e acionado de forma consistente”. No Gemini, vários requisitos precisam ser atendidos ao mesmo tempo: o modelo deve ser compatível com o cache implícito; a solicitação precisa atingir o limite mínimo de tokens daquele modelo; o conteúdo que pode ser reutilizado deve estar no início do comando; solicitações semelhantes precisam ser enviadas em um intervalo curto; e, no Vertex AI, elas também precisam pertencer ao mesmo projeto do Google Cloud.
Se qualquer uma dessas condições não for atendida, a solicitação será cobrada pelo preço normal de entrada. Não haverá erro nem aviso. É por isso que a “baixa taxa de acerto” muitas vezes passa despercebida: quando o cache não é acionado, isso acontece silenciosamente.
Primeiro, vamos definir um conceito: o que significa AI Studio
Neste artigo, “canal do AI Studio” se refere ao Gemini Developer API, ou seja, ao caminho usado quando se chama a API com uma chave gerada no AI Studio. Ele será comparado ao Vertex AI, disponível no Google Cloud. A lógica dos mecanismos de cache é semelhante nos dois casos, mas há diferenças no valor do limite mínimo, no escopo de isolamento e nas regras de taxa de armazenamento. Vamos detalhar cada uma delas a seguir.
5 motivos para a baixa taxa de acerto do cache do Gemini
A análise a seguir tem duas partes: os dois primeiros motivos são regras explicitadas na documentação oficial; os três últimos são explicações condicionais sobre situações em que essas regras podem ser violadas por um serviço proxy ou pela implementação. Não dá para determinar qual é o motivo apenas com a informação de que você “usou um proxy”. Para identificar a causa, é preciso consultar o projeto upstream e os registros das requisições.
Motivo 1: a requisição não atinge o número mínimo de tokens exigido para o cache
O cache implícito tem um limite mínimo de tokens. Requisições com entradas muito curtas não são armazenadas em cache. Além disso, os limites não são exatamente iguais nas duas plataformas. Veja alguns valores indicados na documentação atual:
| Modelo | Limite do cache implícito na Developer API | Limite do cache implícito no Vertex |
|---|---|---|
| Gemini 3.8 Flash | 4.096 | 6.144 |
| Gemini 3.1 Pro Preview | 4.096 | 6.144 |
| Gemini 2.5 Pro (geração anterior, para comparação) | 2.048 | 2.048 |
Há duas armadilhas comuns aqui. Primeiro, os modelos mais novos, como o Gemini 3.8 Flash, têm um limite maior que o da série 2.5. Usar os 2.048 tokens das versões anteriores como referência pode levar a uma conclusão errada. Segundo, o limite para o mesmo modelo pode ser maior no Vertex: uma requisição de 5.000 tokens atende ao requisito na Developer API, mas não no Vertex.
Requisições de conversa do dia a dia costumam ter apenas algumas centenas ou entre mil e dois mil tokens, ficando naturalmente abaixo do limite. Esse é um dos motivos mais diretos para a baixa taxa de acerto do cache do Gemini em cenários de chat. Vale lembrar: atingir o limite é uma condição necessária, mas não garante que o cache será usado.
Motivo 2: o conteúdo reutilizável não está no início do comando
O Google recomenda o mesmo para as duas plataformas: coloque o conteúdo mais longo e reutilizado com frequência no início do comando e envie, em um intervalo curto, requisições com prefixos semelhantes. O cache depende de um prefixo em comum, não apenas de “a requisição conter o mesmo documento”.
Em outras palavras, incluir o mesmo documento em duas requisições não basta para garantir que o cache será usado. Também importa onde ele aparece e se o conteúdo que vem antes permanece estável. Um formato como este pode facilmente quebrar o prefixo:
# 反例:变化内容放在最前面
[当前时间:2026-10-20 10:31:07]
[请求 ID:a8f3...]
{system 指令}
{长文档}
{用户问题}
Se até mesmo um caractere no início for diferente, o documento longo que vem depois não formará um prefixo em comum com o da requisição anterior. Essa conclusão é uma inferência baseada nas recomendações oficiais, mas é uma situação bastante comum na prática.
Motivo 3: a camada de proxy altera o prefixo (condicional)
Se a camada de proxy inserir no início do comando um horário, identificador ou campo de rastreamento variável, ou se reorganizar, comprimir ou truncar o contexto de várias interações, o prefixo em comum será alterado e a chance de acerto diminuirá. Esta é uma análise condicional: não é possível afirmar diretamente que um serviço específico tenha esse comportamento.
Na hora de investigar, diferencie dois níveis: o prefixo da requisição enviada por você ao proxy permanece estável? E o prefixo da requisição encaminhada pelo proxy ao Google também permanece estável? Você pode controlar o primeiro; para verificar o segundo, é preciso consultar os registros das requisições upstream.
Motivo 4: as requisições são distribuídas entre diferentes projetos do Vertex (condicional)
O Vertex especifica claramente que o cache é isolado por projeto do Google Cloud e não é compartilhado entre projetos. Se várias requisições da mesma sessão forem distribuídas entre projetos diferentes do Vertex, o projeto B não poderá usar o cache criado pelo projeto A.
É importante ter cautela: perder o cache ao “trocar a chave” depende de o projeto também mudar. Não dá para concluir que toda troca de chave causa perda do cache sem antes confirmar a relação entre as chaves e os projetos.
Motivo 5: as requisições de geração são apenas encaminhadas, sem uso do cache explícito
Se o fluxo de chamadas apenas encaminhar requisições generateContent, sem criar um objeto de cache nem fazer referência a ele nas requisições seguintes, todo o fluxo dependerá do cache implícito. Como o cache implícito não oferece garantia de funcionamento, não é possível obter o benefício estável do cache explícito, no qual o objeto é “criado uma vez e referenciado repetidamente”.
A tabela abaixo relaciona esses cenários de proxy às regras oficiais:
| Comportamento observado | Possível impacto | Regra oficial relacionada |
|---|---|---|
| A mesma sessão é distribuída entre diferentes projetos do Vertex | O cache existente em outro projeto não pode ser reutilizado | O cache é isolado por projeto |
| Um horário ou identificador variável é inserido no início, ou o contexto é reorganizado | O prefixo em comum é quebrado, reduzindo a chance de acerto | Conteúdo longo no início e prefixos semelhantes |
| A requisição é curta e há pouco conteúdo fixo reutilizável | O limite mínimo de cache não é atingido | Limite mínimo de tokens |
| As requisições de geração são apenas encaminhadas, sem criar nem referenciar objetos de cache explícito | Só é possível depender do cache implícito, que não oferece garantia | O cache explícito exige a criação e a referência do objeto |
🎯 Recomendação técnica: ao investigar problemas com o cache do Gemini, experimente enviar várias requisições seguidas com o mesmo prefixo longo e fixo pela APIYI, em apiyi.com, e compare os campos de tokens em cache retornados em cada resposta. Primeiro, use requisições controladas para descartar problemas de prefixo e de limite; depois, verifique se a causa está relacionada ao fluxo de chamadas.
Sem acesso ao projeto upstream e aos registros das requisições, não é possível determinar a causa apenas com a informação de que foi usado um proxy. Também não há base oficial para afirmar que a taxa de acerto do cache no Vertex seja necessariamente maior que na Developer API.
Como funciona a cobrança de cache no AI Studio e no Vertex
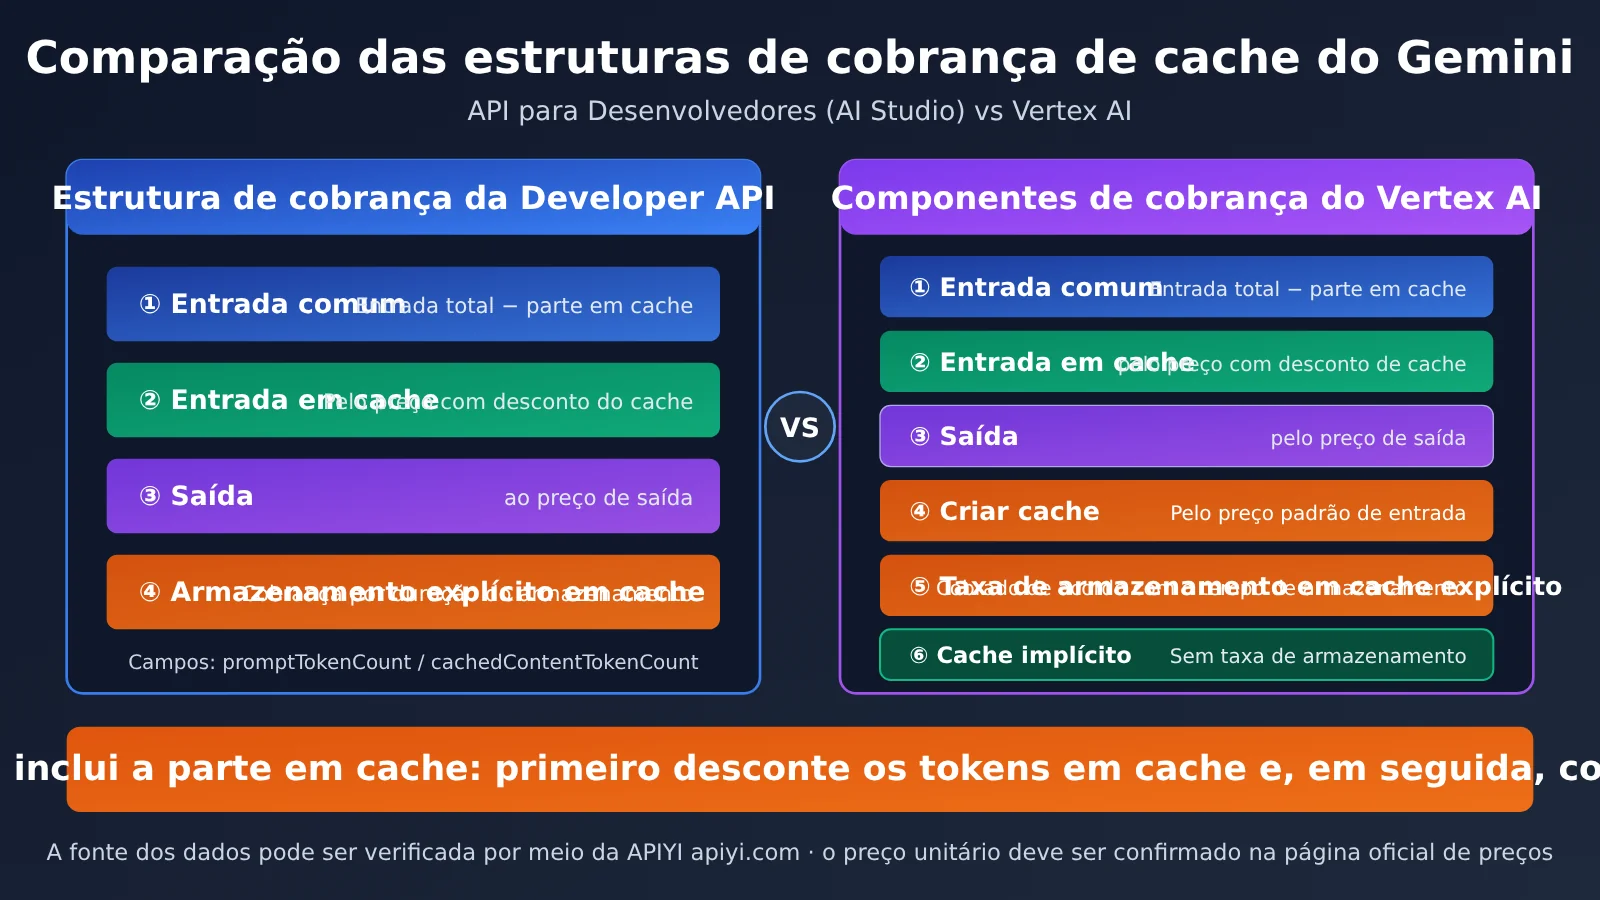
Muita gente entende que “acerto de cache” significa gratuidade ou desconto em toda a solicitação. Não é assim. Nos dois serviços, é preciso separar quatro itens: entrada comum, entrada em cache, saída e custo de armazenamento do cache explícito.
Comparação das regras de cobrança
| Item cobrado | Developer API (AI Studio) | Vertex AI |
|---|---|---|
| Entrada comum (parte sem acerto) | Cobrança pelo preço padrão de entrada | Cobrança pelo preço padrão de entrada |
| Entrada em cache (parte com acerto) | Cobrança pelo preço de entrada em cache, indicado separadamente na página de preços | Cobrança pelo preço de entrada em cache, indicado separadamente na página de preços |
| Saída | Cobrança à parte | Cobrança à parte |
| Entrada usada para criar o cache | Incluída na cobrança de uso de tokens em cache | Cobrada pelo preço padrão de entrada |
| Armazenamento de cache implícito | Sem cobrança | Sem cobrança |
| Armazenamento de cache explícito | Cobrança pelo tempo de armazenamento | Há cobrança de armazenamento |
A documentação da Developer API lista como fatores de cobrança o uso de tokens em cache, o tempo de armazenamento, a entrada que não está em cache e a saída. O Vertex também esclarece dois pontos: a entrada usada para criar o cache é cobrada pelo preço padrão de entrada; o cache implícito não tem custo de armazenamento, mas o explícito tem. Consulte as páginas oficiais de preços de cada serviço para ver os valores atuais, pois eles variam conforme o modelo e a versão.
Fórmula para calcular o custo de entrada
Para uma solicitação comum de geração de texto, o custo de entrada pode ser entendido assim:
输入费用 =
(总输入 tokens − 缓存命中 tokens)× 普通输入单价
+ 缓存命中 tokens × 缓存输入单价
A saída é cobrada à parte. No caso de cache explícito, também há o custo de armazenamento. Por exemplo, suponha que uma solicitação tenha 10.000 tokens de entrada, dos quais 8.000 sejam acertos de cache. Nesse caso, 2.000 tokens são cobrados pelo preço padrão e 8.000 pelo preço de entrada em cache.
Um detalhe que costuma causar erros: a entrada total já inclui a parte em cache
Ao conferir os valores, consulte a resposta original do Google, em vez de se basear apenas na “taxa de acerto de cache” exibida pelo painel do serviço proxy de API. Na resposta de generateContent, há dois campos importantes em usageMetadata:
| Campo | Significado | O que observar na conferência |
|---|---|---|
usageMetadata.promptTokenCount |
Total de tokens de entrada | Inclui a parte em cache |
usageMetadata.cachedContentTokenCount |
Tokens da parte em cache | Quantidade de tokens com acerto de cache |
Por isso, não calcule primeiro o custo de todos os tokens de promptTokenCount pelo preço padrão e depois some outra cobrança pela entrada em cache: isso resultaria em cobrança duplicada. O correto é subtrair do total de entrada a parte em cache para obter a quantidade cobrada pelo preço padrão. Se você usa a nova Interactions API, o campo oficial para consultar as estatísticas de cache é usage.total_cached_tokens.
Dois aspectos que precisam ser analisados separadamente
Também é importante distinguir duas coisas: quantos tokens realmente tiveram acerto de cache no serviço do Google e como o serviço proxy de API aplica esse desconto à sua fatura. O primeiro aspecto pode ser medido pelos campos oficiais. O segundo depende das regras de cobrança do próprio serviço proxy de API, e a documentação oficial do Google não pode confirmá-las. Por isso, ao conferir os valores, compare os campos de cache retornados pelo serviço upstream com os critérios de cobrança detalhados na fatura.
💡 Dica para escolher: ao conferir os valores, comece pelos campos de tokens em cache de cada solicitação e depois consulte o resumo da fatura. Se quiser comparar OpenAI, Claude e Gemini usando os mesmos critérios, você pode fazer chamadas com o mesmo comando por meio da APIYI apiyi.com e alternar rapidamente entre os modelos.
Diferenças na cobrança de cache entre Gemini, Claude e OpenAI
As três empresas adotam estratégias diferentes para o cache, e também usam critérios distintos para conferir a cobrança. A tabela compara como o cache é acionado e cobrado. As taxas de desconto e os períodos de validade variam conforme a versão do modelo. A tabela apresenta valores aproximados na data de publicação; consulte as páginas oficiais de preços de cada empresa para ver os valores exatos:
| Item de comparação | Gemini | Claude | OpenAI |
|---|---|---|---|
| Como é acionado | Dois mecanismos: cache implícito automático e objetos de cache explícito | Explícito: use cache_control na solicitação para marcar o ponto de interrupção do cache |
Automático, sem necessidade de alterar o código |
| Custo de gravação no cache | Não há no cache implícito; ao criar um cache explícito, a entrada é cobrada e há também custo de armazenamento | Há cobrança, e o preço de gravação é maior que o da entrada comum (os preços variam conforme a validade de 5 minutos ou 1 hora) | Não há uma cobrança separada pela gravação |
| Preço de leitura do cache (acerto) | Menor que o da entrada comum; o desconto varia conforme o modelo | Cerca de 1/10 do preço da entrada comum | Menor que o da entrada comum; o desconto varia conforme o modelo |
| Custo de armazenamento | Apenas para cache explícito, cobrado pelo tempo de armazenamento | Não há cobrança separada; o período de validade é escolhido na gravação | Não há cobrança |
| Limite mínimo | Varia conforme o modelo e o canal; no Vertex, pode ser maior que na Developer API | Varia conforme o modelo; frequentemente é de 1.024 tokens ou mais | Em geral, a partir de 1.024 tokens |
| Garantia de acerto | Não há garantia para cache implícito; o explícito é mais previsível | Depois de marcar o ponto de interrupção, os acertos costumam ser estáveis durante o período de validade | Correspondência automática de prefixo, sem garantia |
| Campos de uso | cachedContentTokenCount (incluído em promptTokenCount) |
cache_creation_input_tokens, cache_read_input_tokens, informados separadamente dos tokens de entrada comuns |
prompt_tokens_details.cached_tokens (incluído em prompt_tokens) |
Há três pontos nesta tabela que costumam gerar confusão:
- Custo de gravação: no Claude, gravar no cache custa mais; só a leitura sai mais barata. Por isso, “gravar muito e ler pouco” pode custar mais do que não usar cache. A OpenAI não cobra pela gravação, então um cache que não dá acerto não gera custo adicional. O cache implícito do Gemini também não tem custo de gravação; apenas o cache explícito gera custos de criação e armazenamento.
- Quem decide usar o cache: no Claude, quem faz a solicitação marca explicitamente o ponto de interrupção, tornando os acertos mais previsíveis. Já os caches implícitos da OpenAI e do Gemini são determinados automaticamente pela plataforma. Os desenvolvedores só podem aumentar as chances mantendo o prefixo estável. Esse é um dos motivos pelos quais os usuários sentem que os acertos do Claude e da OpenAI são mais estáveis, enquanto os do Gemini variam: no Gemini, eles também dependem do limite mínimo, do prefixo e do isolamento entre canais.
- Critério para o total de entrada: no Gemini e na OpenAI, o total de entrada já inclui a parte em cache, que deve ser subtraída antes do cálculo. No Claude,
input_tokensnão inclui as partes lidas ou gravadas no cache, então é preciso calcular os três itens separadamente e somá-los. Aplicar a fórmula de um serviço a outro leva a erros na conferência. Para comparar cobranças entre modelos por meio da APIYI apiyi.com, confirme primeiro como cada serviço define os campos retornados.
Guia rápido para testar a taxa de acertos do cache do Gemini
Depois da teoria, nada é mais confiável do que testar na prática. A ideia é criar um prefixo fixo e longo, acima do limite mínimo, deixar a pergunta variável no final e fazer várias solicitações seguidas. Depois, observe como os campos de tokens em cache mudam.
Exemplo simples
O código abaixo usa o formato compatível com a OpenAI e imprime as informações de uso retornadas. Os nomes dos campos podem variar conforme a integração; use como referência os campos presentes na resposta:
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

# 固定的长前缀:务必超过目标模型的最低缓存门槛
LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800

for i in range(3):
    resp = client.chat.completions.create(
        model="gemini-3.8-flash",
        messages=[
            {"role": "system", "content": LONG_PREFIX},
            {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
        ],
    )
    print(i, resp.usage)
    time.sleep(2)
Ver o código completo de teste e conferência dos custos
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800


def extract_cached_tokens(usage) -> int:
    """尝试从 usage 中读取缓存 token 数,字段名以实际返回为准"""
    details = getattr(usage, "prompt_tokens_details", None)
    if details is not None:
        cached = getattr(details, "cached_tokens", None)
        if cached is not None:
            return cached
    return 0


def estimate_input_cost(total_in: int, cached: int,
                        normal_price: float, cached_price: float) -> float:
    """
    按官方口径估算输入费用:
    总输入已包含缓存部分,所以普通部分 = 总输入 - 缓存部分
    单价请填入官方定价页当前数值(每百万 token)
    """
    normal_part = total_in - cached
    return (normal_part * normal_price + cached * cached_price) / 1_000_000


def run_test(model: str, rounds: int = 3):
    results = []
    for i in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": LONG_PREFIX},
                {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
            ],
        )
        usage = resp.usage
        cached = extract_cached_tokens(usage)
        results.append((i, usage.prompt_tokens, cached))
        print(f"第 {i} 次:总输入={usage.prompt_tokens},缓存命中={cached}")
        time.sleep(2)
    return results


if __name__ == "__main__":
    for m in ["gemini-3.8-flash"]:
        print("模型:", m)
        run_test(m)
🚀 Comece rápido: recomendamos usar APIYI apiyi.com para montar esse teste comparativo. Basta trocar o parâmetro
modelno mesmo script para testar, em sequência, Gemini, OpenAI e Claude e comparar visualmente o desempenho de cache de cada modelo.
Variáveis que você deve controlar durante o teste
Ao executar o teste, confira cada item da lista para não confundir um problema na sua configuração com um problema na cadeia de integração:
| Item a verificar | Como fazer | Objetivo |
|---|---|---|
| Tamanho do prefixo | Garanta que ultrapasse o limite mínimo atual do modelo | Descartar problemas relacionados ao limite |
| Estabilidade do prefixo | Não coloque timestamps nem IDs de solicitação no início | Evitar alterações no prefixo |
| Posição do conteúdo variável | Deixe a pergunta do usuário no final | Manter o prefixo em comum o mais longo possível |
| Intervalo entre solicitações | Envie as solicitações em sequência, num intervalo curto | Seguir as recomendações oficiais |
| Grupo de controle | Teste o mesmo comando com OpenAI ou Claude | Identificar se a diferença está no mecanismo do modelo ou na cadeia de integração |
Como interpretar os resultados do teste
Se o prefixo for longo o suficiente, a estrutura estiver estável e o intervalo entre solicitações for curto, mas o Gemini ainda quase não apresentar acertos de cache — enquanto o mesmo comando funcionar normalmente com OpenAI ou Claude —, a diferença provavelmente vem do mecanismo de cache do próprio Gemini e das condições da cadeia upstream, não da forma como você escreveu o comando. Nesse caso, considere usar o cache explícito: fixe o conteúdo longo que precisa ser reutilizado, crie um objeto de cache e faça referência a ele nas solicitações.
Se o seu caso de uso envolver conversas curtas, em vez de tentar aumentar a taxa de acertos, vale aceitar que o cache do Gemini traz poucos benefícios nesse cenário e concentrar a otimização de custos na escolha do modelo e no controle do tamanho das respostas.
Perguntas frequentes
P1: Por que a taxa de acertos do cache do Gemini é muito menor que a da OpenAI e da Claude?
O cache implícito do Gemini depende de várias condições: o modelo precisa oferecer suporte ao recurso, o conteúdo deve atingir o limite mínimo de tokens, o prefixo precisa permanecer estável e as solicitações devem ocorrer em intervalos próximos. No Vertex, também há isolamento por projeto, e a documentação oficial deixa claro que não há garantia de acerto. Se qualquer uma dessas condições não for atendida, a cobrança é feita silenciosamente como entrada normal. Para identificar a causa em uma cadeia específica, é preciso analisar os registros das solicitações upstream.
P2: O Google já afirmou oficialmente que usar um serviço intermediário reduz a taxa de acertos do cache?
Não. A documentação oficial só informa as condições das quais o cache depende: um prefixo reutilizável, um limite mínimo de tokens e um escopo de aplicação. Se a cadeia de integração alterar essas condições, a taxa de acertos poderá cair. Para comparar o desempenho de cache entre modelos, você pode usar APIYI apiyi.com e testar o mesmo comando em condições controladas.
P3: A parte que acerta o cache é gratuita?
Não. Os tokens que acertam o cache são cobrados pela tarifa de entrada em cache. O preço é menor que o da entrada normal, mas não é zero. As páginas de preços dos dois serviços apresentam tarifas separadas para entrada normal e entrada em cache; o cache explícito também tem uma taxa de armazenamento.
P4: Preciso somar os tokens em cache separadamente aos tokens de entrada da fatura?
Não. `promptTokenCount` representa o total de tokens de entrada e já inclui a parte em cache. Subtraia `cachedContentTokenCount` do total para obter a parte cobrada pelo preço normal; depois, calcule separadamente a parte em cache.
P5: Os limites de cache do AI Studio e do Vertex são iguais?
Não exatamente. De acordo com a documentação atual, o Gemini 3.1 Pro Preview e o Gemini 3.8 Flash têm um limite de 4.096 tokens na Developer API e de 6.144 no Vertex. Para a geração anterior, o Gemini 2.5 Pro tem um limite de 2.048 nos dois serviços. Como os limites podem mudar conforme a versão do modelo, consulte os valores atuais na documentação oficial.
P6: Se eu trocar a chave API, o cache será perdido?
Depende de você também trocar de projeto. No Vertex, o cache é isolado por projeto do Google Cloud e não é compartilhado entre projetos. Portanto, trocar para uma chave de outro projeto faz com que o cache deixe de estar disponível. Já trocar de chave dentro do mesmo projeto não significa necessariamente que o cache será perdido.
P7: Devo usar cache implícito ou explícito?
Se você precisa reutilizar repetidamente um grande volume de conteúdo fixo, como documentos extensos ou instruções longas do sistema, o cache explícito oferece mais previsibilidade, mas exige esforço de desenvolvimento e tem custo de armazenamento. Se o conteúdo for reutilizado apenas ocasionalmente, o cache implícito não tem custo adicional, mas seus benefícios são imprevisíveis. Você pode começar com um teste comparativo em pequena escala usando APIYI apiyi.com e decidir depois se vale a pena investir no desenvolvimento do cache explícito.
P8: Posso usar diretamente a taxa de acertos exibida pelo painel do serviço proxy como base para conferir a cobrança?
Não é recomendável. Use como referência os campos de cache da resposta original oficial. Além disso, o acerto real no serviço upstream do Google e a forma como o serviço proxy calcula a cobrança são coisas diferentes; para conferir os valores cobrados por este último, é preciso verificar as regras de faturamento do próprio serviço.
Principais conclusões sobre a taxa de acerto do cache
- O comportamento é real: o cache das séries OpenAI e Claude apresenta resultados consistentes. Já no Gemini, a taxa de acerto é baixa ou quase nula, e o caso precisa ser analisado separadamente.
- A plataforma não garante acertos: o cache implícito do Gemini não garante economia. Para usar o cache explícito, é preciso criar e referenciar o objeto de cache manualmente.
- Os limites variam conforme o modelo: modelos mais recentes têm limites mais altos, e os valores podem ser diferentes no Vertex e na Developer API.
- O prefixo determina o acerto: coloque conteúdos longos no início e evite inserir informações variáveis, como data e ID, no começo. Isso pode quebrar o prefixo compartilhado.
- No Vertex, o cache é isolado por projeto: o cache não é compartilhado entre projetos. Se as solicitações forem distribuídas entre projetos diferentes, o cache será perdido.
- O total de tokens de entrada inclui o cache:
promptTokenCountjá inclui a parte armazenada em cache. Para conferir a cobrança, desconte esse valor antes de calcular os custos de cada categoria. - Confira os campos da resposta: use os campos de cache da resposta oficial como referência e compare os modelos usando o mesmo comando pela APIYI (apiyi.com).
Resumo
A baixa taxa de acerto do cache do Gemini resulta da combinação de vários fatores: o cache implícito não garante acertos, o limite mínimo de tokens aumenta conforme o modelo, o prefixo precisa permanecer estável, o cache do Vertex é isolado por projeto e o cache explícito precisa ser criado manualmente. Quando os últimos fatores mudam no fluxo de solicitações, a taxa de acerto pode cair. Ainda assim, para identificar a causa específica, é preciso analisar o projeto upstream e o histórico de solicitações.
Sobre a cobrança, lembre-se de três pontos: um acerto no cache não é gratuito; o total de tokens de entrada já inclui a parte armazenada em cache, que não deve ser cobrada duas vezes; e o cache explícito tem uma tarifa de armazenamento, enquanto o implícito não. Use os campos da resposta oficial para conferir os valores e verifique separadamente os critérios de cobrança do serviço proxy de API.
Como próximo passo, use o script de teste deste artigo para comparar Gemini, OpenAI e Claude com um prefixo longo fixo. Depois, decida se vale a pena adotar o cache explícito. A APIYI (apiyi.com) permite validar os resultados rapidamente e comparar vários modelos usando a mesma interface, com baixo custo.
Referências
- Documentação de cache da API Gemini: explicação oficial sobre cache implícito e explícito
- Link:
ai.google.dev/gemini-api/docs/caching -
Observação: inclui o limite mínimo de tokens e os fatores de cobrança
-
Página de preços da API Gemini: preços de entrada comum, entrada em cache, saída e armazenamento
- Link:
ai.google.dev/gemini-api/docs/pricing -
Observação: referência para conferir os preços atuais
-
Visão geral do cache de contexto no Vertex AI: isolamento entre projetos e regras de cobrança do cache
- Link:
docs.cloud.google.com/vertex-ai/generative-ai/docs/context-cache/context-cache-overview -
Observação: explica que o cache do Vertex não é compartilhado entre projetos
-
Referência da API Gemini
generateContent: campousageMetadatana resposta - Link:
ai.google.dev/api/generate-content - Observação: campos de tokens em cache usados na conferência da cobrança
Autor: equipe APIYI
Discussão técnica: compartilhe nos comentários suas experiências ao investigar problemas com o cache do Gemini. Para consultar mais materiais, acesse o centro de documentação da APIYI em docs.apiyi.com.