gemini-4-argon foi lançado em 13 de outubro de 2026 e, logo após integrá-lo, muitos desenvolvedores se depararam com erros 429: basta aumentar um pouco a concorrência para começar a receber erros, e às vezes até uma única solicitação falha. A primeira reação de muita gente é pensar que “o limite de concorrência do AI Studio é baixo”, mas essa conclusão provavelmente está errada. Neste artigo, vamos explicar como funciona de verdade o controle de taxa do gemini-4-argon no AI Studio e apresentar soluções práticas para os erros 429.
Este não é mais um daqueles tutoriais genéricos que dizem “é só adicionar novas tentativas”. Primeiro, vamos esclarecer um ponto importante: atualmente, o Google não publicou um limite fixo e unificado de concorrência para o gemini-4-argon. Portanto, os números que circulam na internet, como “concorrência de 10” ou “concorrência de 50”, não têm fundamento.
O que você vai aprender: ao terminar a leitura, você saberá diferenciar quatro causas de erros 429 — RPM, TPM, velocidade de consumo e capacidade do serviço upstream —, aplicar recuo exponencial e controle de taxa na prática e entender como contornar o gargalo da cota de um único projeto no AI Studio usando o canal de alta concorrência da APIYI, em apiyi.com.
Principais pontos sobre o gemini-4-argon
A tabela abaixo resume as conclusões do artigo. Nos próximos tópicos, vamos detalhar cada uma delas.
| Ponto | Explicação | Benefício |
|---|---|---|
| Não há um limite fixo de concorrência divulgado publicamente | O Google não publicou um limite único de concorrência para o gemini-4-argon. A limitação é definida por métricas como RPM, TPM e RPD | Evita planejar a capacidade com base em números incorretos |
| RPM não é o mesmo que concorrência | O número de solicitações em andamento depende do tempo médio de resposta, e não apenas da quantidade de solicitações por minuto | Ajuda a estimar corretamente a necessidade de concorrência |
| Os limites são calculados por projeto | Criar várias chaves no mesmo projeto não multiplica a cota | Evita perder tempo alternando entre chaves |
| Limite de consumo em 10 minutos | Tier 1 tem limite de US$ 10, Tier 2, de US$ 50, e Tier 3, de US$ 200 | Explica por que pode ocorrer um erro 429 mesmo sem ultrapassar o RPM |
| O erro 429 exige uma análise por etapas | Primeiro, confira a resposta original; depois, reduza a taxa, aplique backoff, troque de canal ou solicite um aumento de cota | Permite resolver o problema passo a passo, por ordem de prioridade |
| Canal de alta concorrência da APIYI | APIYI, em apiyi.com, oferece suporte a alta concorrência para o gemini-4-argon. Com RPM abaixo de 500, não é preciso se preocupar com limitação de taxa | Uma opção prática para operações de pequeno e médio porte |
Por que um erro 429 nem sempre significa concorrência excessiva
Muitos desenvolvedores associam o erro 429 a “concorrência alta”, mas, no sistema de limitação do Google, a concorrência não é uma métrica independente. O erro 429 RESOURCE_EXHAUSTED pode ser causado pelo número de solicitações por minuto, pela quantidade de tokens de entrada por minuto, pelo número de solicitações por dia, pelo valor consumido em uma janela móvel de 10 minutos ou até pela falta de capacidade do serviço durante o período inicial de lançamento de um modelo.
O gemini-4-argon foi lançado há menos de uma semana, e os recursos do serviço ainda estão sendo ampliados. Por isso, mesmo que sua cota seja suficiente, uma solicitação pode ser recusada temporariamente devido à falta de capacidade. Ao investigar um erro 429, o primeiro passo é identificar a causa específica — não reduzir a concorrência às cegas.
Qual é o limite de concorrência do gemini-4-argon no AI Studio?
Resposta direta: não há um valor fixo único divulgado publicamente. No AI Studio, cada projeto tem cotas próprias e efetivas de RPM, TPM e RPD para o gemini-4-argon. Os valores variam conforme o nível do Tier e o estado do projeto; consulte-os no painel.
Cinco tipos de limites no AI Studio
O mecanismo oficial de limitação do Google pode ser resumido na tabela abaixo. Atingir qualquer um desses limites pode resultar em um erro 429.
| Métrica de limite | Significado | Pode causar um erro 429? |
|---|---|---|
| RPM | Número de solicitações por minuto | Sim |
| TPM | Número de tokens de entrada por minuto | Sim |
| RPD | Número de solicitações por dia | Sim |
| Taxa de consumo | Valor consumido pela API em uma janela móvel de 10 minutos | Sim |
| Capacidade real do serviço | Recursos disponíveis no serviço upstream do Google | Pode causar |
A última linha merece atenção: quando o problema é falta de capacidade, não há ajuste de parâmetros que resolva a situação. As únicas alternativas são reduzir o tráfego, tentar novamente mais tarde ou trocar de canal.
Como converter RPM em concorrência
RPM é o total de solicitações em um minuto; concorrência é o número de solicitações em andamento ao mesmo tempo. A relação entre as duas métricas depende do tempo de resposta. Por exemplo, em um projeto limitado a 60 RPM — apenas um exemplo de cálculo, não a cota real do Argon —, teríamos:
- Com tempo médio de resposta de 5 segundos, a média teórica seria de cerca de 5 solicitações em andamento.
- Com tempo médio de resposta de 30 segundos, a média teórica seria de cerca de 30 solicitações em andamento.
- Enviar 60 solicitações de uma só vez pode causar limitação momentânea ou problemas de capacidade, mesmo que o total em um minuto não ultrapasse a cota.
O terceiro caso é o mais fácil de ignorar. Muitos scripts de teste de carga enviam todas as solicitações em paralelo de uma só vez. Esse pico de tráfego tende a acionar a limitação com mais facilidade do que um fluxo constante, mesmo quando o volume total está dentro dos limites.
Como consultar a cota real do gemini-4-argon no painel
Acesse a página Rate Limits do Google AI Studio pelo endereço aistudio.google.com/usage e selecione a aba rate-limit. Você também pode chegar lá pela documentação oficial de limites de taxa, em ai.google.dev/gemini-api/docs/rate-limits. Selecione o projeto correspondente e o gemini-4-argon para consultar os valores efetivos de RPM, TPM e RPD, além do Tier atual.
O Google informa claramente que os limites são calculados por projeto, e não por chave API. Isso significa que criar várias chaves no mesmo projeto não aumenta sua cota. Portanto, a estratégia de “alternar entre várias chaves” para ampliar a capacidade não funciona no AI Studio.
5 causas comuns de erros 429 no gemini-4-argon
Agora que você já conhece os indicadores de limite, vamos ver as situações que costumam causar problemas na prática. Estas cinco causas explicam a maioria dos relatos de erro 429 no gemini-4-argon.
- Taxa instantânea de solicitações muito alta: tarefas em lote ou scripts de teste de carga enviam muitas solicitações de uma só vez, criando um pico que ultrapassa a capacidade instantânea de RPM.
- TPM no limite: entradas com contexto longo ou documentos extensos consomem tokens rapidamente. Mesmo com poucas solicitações, o limite de TPM pode ser atingido primeiro.
- Limite de consumo em 10 minutos atingido: este é o limite mais fácil de passar despercebido; vamos explicá-lo em detalhes a seguir.
- RPD diário esgotado: se os erros 429 só começam depois de algum tempo de execução, isso geralmente indica que a cota diária foi consumida.
- Capacidade insuficiente no provedor: quando um modelo novo é lançado, os recursos podem estar escassos. Nesse caso, as solicitações podem ser recusadas mesmo que ainda haja cota disponível.
Uma causa fácil de ignorar: o limite de consumo em 10 minutos
De acordo com a documentação oficial do Google, atualizada em 15 de outubro de 2026, cada nível de conta tem um limite de consumo em uma janela móvel de 10 minutos.
| Nível da conta | Limite de consumo a cada 10 minutos |
|---|---|
| Tier 1 | $10 |
| Tier 2 | $50 |
| Tier 3 | $200 |
Por exemplo: se uma conta Tier 1 acumular $10 em consumo ao longo de 10 minutos, poderá receber o erro 429 RESOURCE_EXHAUSTED, mesmo sem ultrapassar os limites de RPM e TPM. Como modelo de nova geração, o gemini-4-argon pode custar mais por chamada do que os modelos anteriores. Solicitações com contexto longo também podem fazer o consumo aumentar rapidamente — um motivo comum para sofrer limitação mesmo sem enviar muitas solicitações.
Vale lembrar também que a cota do Argon Batch API indicada na documentação do Google corresponde aos tokens disponíveis na fila de processamento em lote. Ela não deve ser usada como referência para a concorrência da API em tempo real.
Como identificar a origem do erro 429 no gemini-4-argon?
Cada tipo de ocorrência aponta para causas diferentes. Investigar o problema certo é muito mais eficiente do que ajustar parâmetros às cegas.
| Sintoma | O que verificar primeiro | Como resolver |
|---|---|---|
| Os erros 429 aparecem com frequência assim que a concorrência aumenta | Taxa instantânea de solicitações, RPM e capacidade do provedor | Faça um teste de carga gradual, enviando solicitações em intervalos regulares. Manter a concorrência fixa não significa manter o RPM fixo. |
| Os erros 429 começam depois de algum tempo de execução | Limite de consumo em 10 minutos, RPD e acúmulo de TPM | Confira a curva de consumo e o uso da cota diária. |
| Os erros 429 ocorrem até com uma única solicitação ou concorrência muito baixa | Capacidade insuficiente no provedor, ou conta ou projeto com restrições | Confira a resposta original e considere trocar de canal. |
| Várias chaves API apresentam erros 429 ao mesmo tempo | As chaves pertencem ao mesmo projeto e compartilham a cota | Reduza o tráfego total do projeto ou use um canal com cota independente. |
Durante a investigação, duas informações são essenciais: primeiro, se sua conta do AI Studio está no Tier 1, 2 ou 3; segundo, o conteúdo original do erro 429, especialmente error.message, error.details e o cabeçalho de resposta Retry-After. Com esses dados, geralmente é possível identificar se o problema é uma cota baixa da conta, um volume de solicitações excessivo ou uma oferta insuficiente do novo modelo Argon do Google. Cada uma dessas situações exige uma solução diferente.
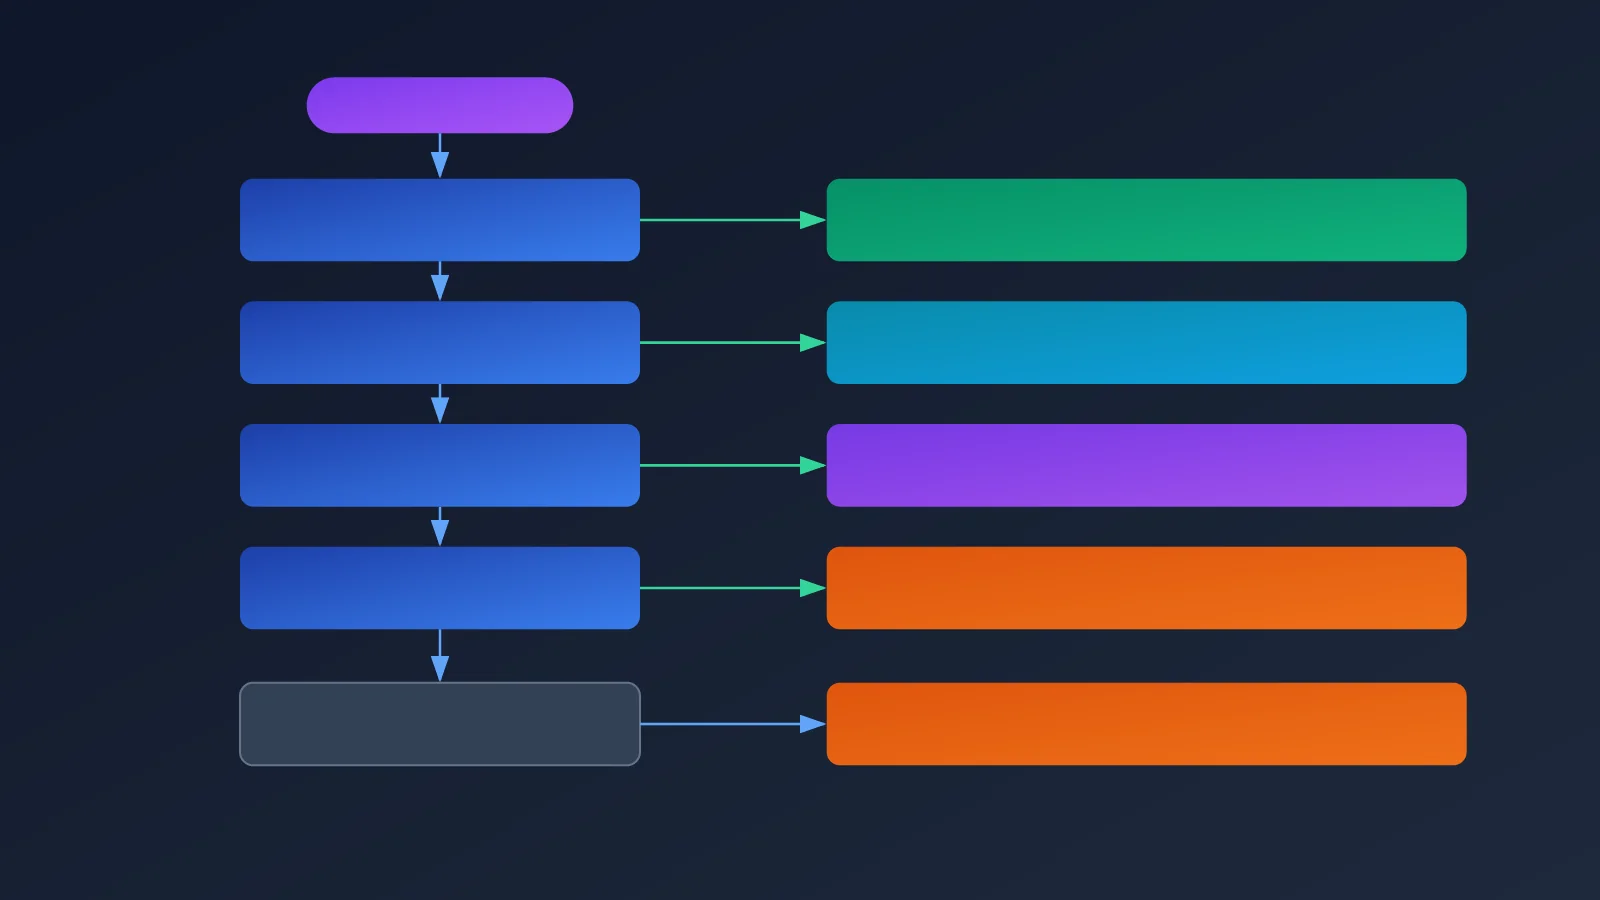
6 passos para resolver o erro 429 no gemini-4-argon
A seguir, veja as medidas em ordem de prioridade prática. P0 indica o que precisa ser feito primeiro; P2 é voltado ao planejamento de longo prazo.
| Prioridade | Medida | Objetivo |
|---|---|---|
| P0 | Verificar a resposta bruta do erro 429 e o cabeçalho Retry-After |
Identificar o motivo específico da limitação |
| P0 | Configurar limites de RPM, TPM e ritmo de consumo por projeto | Evitar que a cota seja excedida continuamente |
| P0 | Tentar novamente após erros 429 com backoff exponencial e jitter aleatório | Reduzir o impacto de limitações repentinas |
| P1 | Em caso de erro 429, alternar automaticamente para um canal saudável com cota independente | Aumentar a taxa de sucesso |
| P1 | Fazer upgrade de Tier ou solicitar aumento de cota ao Google | Ampliar a capacidade no longo prazo |
| P2 | Avaliar o Vertex AI ou outros canais com autorização oficial | Ampliar a oferta de recursos |
Passo 1: entenda a resposta bruta do erro 429
Não tente novamente só porque recebeu um código de status. Primeiro, exiba o corpo completo do erro e os cabeçalhos da resposta. Dê atenção especial a error.message, error.details e Retry-After. Se o provedor já informar quanto tempo você deve esperar, siga esse intervalo em vez de definir um tempo por conta própria.
Passo 2: limite a velocidade no cliente
Mantenha o RPM entre 70% e 80% do limite visível no painel, gerencie o TPM separadamente e monitore também o valor consumido em intervalos de 10 minutos. Essa margem serve para absorver picos de tráfego e oscilações do provedor. Muitas equipes limitam apenas o número de solicitações e ignoram os tokens e os custos. O resultado é receber erros mesmo quando o RPM aparentemente não foi excedido.
Passo 3: use backoff exponencial com jitter aleatório
O Google recomenda usar backoff exponencial para erros 429, com esperas de 1, 2, 4 e 8 segundos, por exemplo, além de adicionar jitter aleatório. Assim, muitas solicitações não tentam novamente ao mesmo tempo e causam um novo congestionamento. Faça no máximo 2 ou 3 tentativas e, sempre que possível, respeite o tempo de espera informado pelo provedor.
Passo 4: alterne de canal se os erros 429 persistirem
Se o mesmo projeto continuar retornando erros 429, pare de enviar novas tentativas para ele: isso só vai agravar a limitação. O melhor é reduzir o tráfego ou alternar para um canal saudável com cota independente. É aí que um serviço agregador faz diferença: ao chamar o modelo pela APIYI apiyi.com, as solicitações podem ser distribuídas entre canais com cotas independentes, sem sobrecarregar um único projeto do AI Studio.
Passo 5: faça upgrade de Tier ou solicite aumento de cota
No longo prazo, a falta de capacidade precisa ser resolvida com um upgrade do nível da conta ou com um pedido de aumento de cota ao Google. Com a mudança de Tier, os limites de RPM e TPM aumentam, assim como o limite de consumo em 10 minutos, que passa de US$ 10 para US$ 50 ou até US$ 200. Mas esse processo leva tempo e depende do histórico de consumo — normalmente, não fica pronto a tempo de acompanhar o cronograma de lançamento do produto.
Passo 6: avalie outros canais com autorização oficial
Se o negócio continuar crescendo, avalie o Vertex AI ou outros canais com autorização oficial para ampliar a oferta de recursos. Operar com vários canais em paralelo também é uma forma segura de reduzir o risco de depender de um único ponto.
Recomendações de teste de carga para novos canais
Ao integrar um novo canal do Argon, comece os testes de carga com a concorrência entre 5 e 10. Esse é apenas um parâmetro inicial de teste, não um limite oficial de concorrência. Depois, aumente o volume gradualmente, em etapas. Envie as solicitações de maneira uniforme em cada etapa e acompanhe, separadamente por provedor, projeto do Google e modelo, a taxa de erros 429, o RPM real, o TPM, o consumo em 10 minutos e o tempo das solicitações. Só avance para a próxima etapa depois de confirmar que tudo está estável.
Comece rápido com o gemini-4-argon: faça chamadas pela APIYI
Agora que já explicamos a teoria, vamos ao código. A APIYI oferece uma interface compatível com OpenAI: basta substituir o base_url para chamar o gemini-4-argon.
Exemplo mínimo
Com pouco mais de 10 linhas de código, você já consegue fazer uma chamada:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

response = client.chat.completions.create(
    model="gemini-4-argon",
    messages=[{"role": "user", "content": "用一句话解释什么是 429 限流"}]
)
print(response.choices[0].message.content)
Ver o código completo: chamadas concorrentes com backoff exponencial, jitter aleatório e Retry-After
import random
import time
from concurrent.futures import ThreadPoolExecutor

import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

MAX_RETRIES = 3       # 最多重试 2-3 次
BASE_DELAY = 1.0      # 指数退避起点:1、2、4、8 秒


def call_argon(prompt: str) -> str:
    """调用 gemini-4-argon,429 时指数退避并优先遵循 Retry-After"""
    for attempt in range(MAX_RETRIES + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-argon",
                messages=[{"role": "user", "content": prompt}],
                max_tokens=512,
            )
            return resp.choices[0].message.content
        except openai.RateLimitError as e:
            if attempt == MAX_RETRIES:
                return f"Error after retries: {e}"
            # 优先使用上游返回的 Retry-After
            retry_after = None
            try:
                retry_after = float(e.response.headers.get("Retry-After"))
            except (AttributeError, TypeError, ValueError):
                pass
            delay = retry_after if retry_after else BASE_DELAY * (2 ** attempt)
            delay += random.uniform(0, 0.5)  # 随机抖动,避免集体重试
            print(f"429,第 {attempt + 1} 次重试,等待 {delay:.1f}s")
            time.sleep(delay)
        except Exception as e:
            return f"Error: {e}"


if __name__ == "__main__":
    prompts = [f"请用一句话介绍第 {i} 种限流策略" for i in range(10)]
    # 并发度从 5 起步压测,不是官方上限
    with ThreadPoolExecutor(max_workers=5) as pool:
        for result in pool.map(call_argon, prompts):
            print(result)
Comece agora: recomendamos se cadastrar na APIYI apiyi.com e obter uma chave API para testar diretamente as chamadas ao gemini-4-argon com o código acima. A plataforma oferece uma interface unificada compatível com OpenAI, sem que você precise solicitar e manter vários projetos do Google.
Implementação simples de limitação de velocidade no cliente
Além de tentar novamente, o mais importante é evitar bater de frente com os limites. Abaixo está um limitador mínimo baseado na ideia de token bucket. Ele ajuda a distribuir as solicitações e evitar picos:
import threading
import time


class RateLimiter:
    """按目标 RPM 匀速放行请求,避免瞬时尖峰"""

    def __init__(self, rpm: int):
        self.interval = 60.0 / rpm
        self.lock = threading.Lock()
        self.next_time = time.monotonic()

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
            self.next_time = max(now, self.next_time) + self.interval


limiter = RateLimiter(rpm=300)  # 按后台限额的 70%-80% 设置

# 在每次调用前执行:
# limiter.wait()
Coloque o limitador no início da função de chamada e combine-o com a estratégia de backoff apresentada anteriormente. Assim, você terá uma proteção em duas camadas: limitação proativa de velocidade e backoff reativo.
Canal de alta concorrência do gemini-4-argon da APIYI
O gargalo de uma conexão direta com o AI Studio é que a cota de cada projeto é fixa. Além disso, contas Tier 1 estão sujeitas a um limite de consumo de US$ 10 a cada 10 minutos. Já um serviço agregador pode distribuir o tráfego entre canais com cotas independentes e alternar automaticamente para um canal saudável quando um deles começa a apresentar erros 429 de forma contínua.
A APIYI, em apiyi.com, já oferece suporte ao gemini-4-argon com alta concorrência. Com menos de 500 RPM, você não precisa se preocupar com limites de taxa. Fique à vontade para usar. Para a maioria das aplicações de pequeno e médio porte, ferramentas internas, fluxos de trabalho automatizados e testes de carga, essa capacidade já atende às necessidades do dia a dia. Assim, você não precisa perder tempo com níveis Tier, cotas de projeto ou janelas de consumo de 10 minutos.
| Critério de comparação | Conexão direta com o AI Studio | Chamada pela APIYI |
|---|---|---|
| A quem pertence a cota | Um único projeto, com várias chaves compartilhando a cota | Cotas independentes em vários canais, gerenciadas pela plataforma |
| Tratamento de erros 429 | É preciso implementar o recuo e a alternância por conta própria | A plataforma prioriza a alternância para canais saudáveis; no cliente, basta manter uma lógica básica de novas tentativas |
| Limites de consumo | Sujeito ao limite de consumo de 10 minutos do Tier | Não é preciso gerenciar o nível da conta Google |
| Forma de integração | É preciso solicitar um projeto e configurar o Tier | Interface compatível com OpenAI; basta substituir base_url |
| Escala indicada | Baixo tráfego ou contas com Tier mais alto | Com menos de 500 RPM, não é preciso se preocupar com limites de taxa |
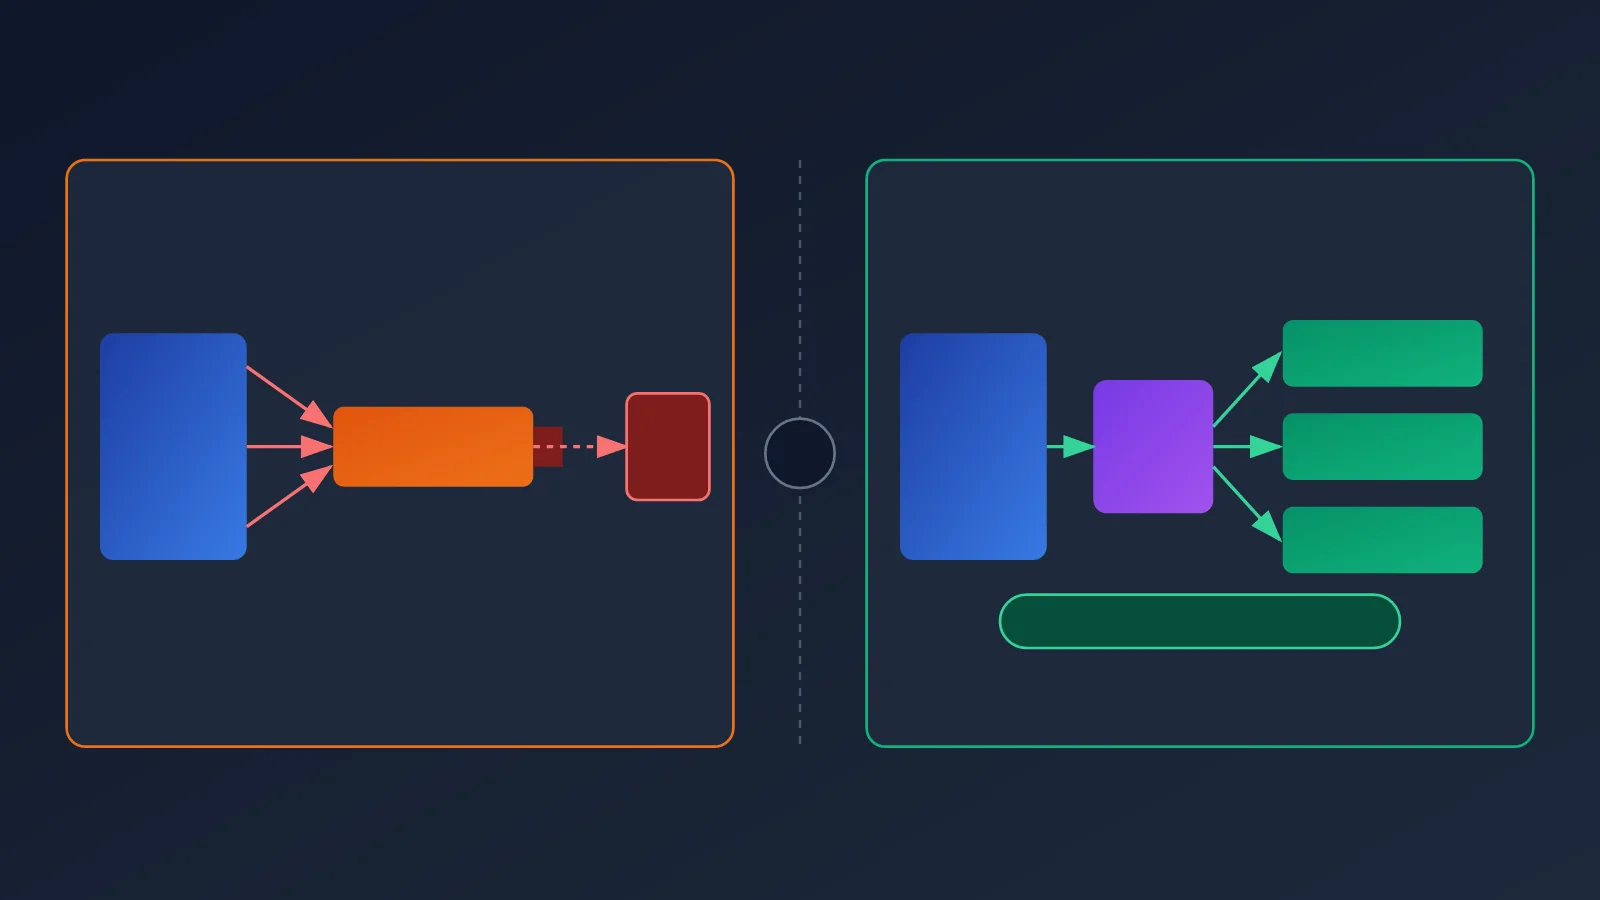
🎯 Recomendação técnica: se o pico de demanda do seu negócio ficar abaixo de 500 RPM, você pode chamar o gemini-4-argon diretamente pela APIYI, em apiyi.com, e concentrar seus esforços na lógica de negócio. Se espera um volume acima desse limite, faça testes de carga progressivos e converse com a plataforma com antecedência para planejar a capacidade.
Mesmo usando um canal de alta concorrência, é uma boa prática manter no cliente o recuo exponencial e configurações razoáveis de timeout. Podem ocorrer instabilidades na rede e oscilações breves no serviço upstream. Uma boa lógica de novas tentativas ajuda a manter seu serviço estável mesmo em situações extremas.
Perguntas frequentes (FAQ)
Q1: Qual é, afinal, o limite de concorrência do gemini-4-argon no AI Studio?
O Google não divulgou um limite fixo e universal de concorrência. Na prática, as restrições dependem dos limites de RPM, TPM e RPD do projeto, além do limite de consumo de 10 minutos. Para consultar os valores, acesse a página Rate Limits no AI Studio e selecione o projeto e o modelo correspondentes. Os números específicos que circulam na internet não têm respaldo oficial e não devem ser usados como referência para planejar a capacidade.
Q2: Criar mais chaves API aumenta a cota do gemini-4-argon?
Não. O Google deixa claro que os limites são calculados por projeto, não por chave API. Todas as chaves do mesmo projeto compartilham a mesma cota. Para ter cotas realmente independentes, você precisa usar projetos diferentes do Google ou um serviço de agregação multicanal, como o APIYI apiyi.com.
Q3: Por que recebo um erro 429 mesmo sem ultrapassar os limites de RPM e TPM?
O motivo mais comum é atingir o limite de consumo de 10 minutos: US$ 10 no Tier 1, US$ 50 no Tier 2 e US$ 200 no Tier 3. Além disso, a capacidade upstream pode ser insuficiente durante o período inicial de lançamento de um modelo, fazendo com que solicitações sejam rejeitadas mesmo dentro da cota. Consulte também `error.details` no corpo da resposta original para confirmar a causa.
Q4: Qual é a forma adequada de repetir uma solicitação após um erro 429?
Use recuo exponencial, por exemplo, 1, 2, 4 e 8 segundos, com uma pequena variação aleatória. Faça no máximo 2 ou 3 novas tentativas e, sempre que possível, siga o valor de `Retry-After` no cabeçalho da resposta. Se os erros 429 continuarem no mesmo projeto, reduza o tráfego ou mude para um canal com cota independente, em vez de continuar tentando.
Q5: Como começar a usar rapidamente o gemini-4-argon pela APIYI?
1. Acesse APIYI apiyi.com, crie uma conta e obtenha uma chave API.
2. Defina `base_url` no código como `https://api.apiyi.com/v1`.
3. Configure o nome do modelo como `gemini-4-argon` para executar os exemplos de código deste artigo.
A APIYI oferece suporte a chamadas de alta concorrência do gemini-4-argon. Com menos de 500 RPM, você não precisa se preocupar com limitação de taxa, o que torna a plataforma adequada para testes rápidos e implantações de pequeno e médio porte.
Q6: Ainda posso receber erros 429 depois de começar a usar a APIYI?
Em condições normais de uso, abaixo de 500 RPM, você praticamente não precisa se preocupar com limitação de taxa. Ainda assim, qualquer serviço upstream pode apresentar instabilidades temporárias, por isso recomendamos manter uma estratégia básica de novas tentativas com recuo exponencial. Se o tráfego da sua aplicação puder ultrapassar esse patamar, faça testes de carga graduais e confirme a capacidade com a APIYI apiyi.com.
Q7: A cota da Batch API serve como referência para a concorrência em tempo real?
Não. A cota da Argon Batch API indicada na documentação do Google é uma cota de tokens para a fila de processamento em lote, voltada a tarefas offline. Ela pertence a um sistema diferente dos limites de concorrência e RPM da API em tempo real, portanto não se aplica a eles.
Principais pontos sobre erros 429 no gemini-4-argon
- Não há um limite fixo de concorrência: o Google não divulgou um limite universal para o gemini-4-argon. Consulte a cota disponível no painel.
- RPM não é o mesmo que concorrência: a concorrência depende do tempo de resposta. Picos de tráfego têm mais chances de acionar a limitação de taxa do que um fluxo constante.
- Os limites são calculados por projeto: criar mais chaves API não aumenta a capacidade; as chaves do mesmo projeto compartilham a cota.
- Fique atento ao limite de consumo de 10 minutos: os valores vão de US$ 10 a US$ 200, conforme o Tier. É possível receber um erro 429 mesmo sem ultrapassar o limite de RPM.
- Combine recuo, limitação de taxa e troca de canal: use recuo exponencial com variação aleatória. Se os erros 429 persistirem, mude para um canal com cota independente.
- Mais tranquilidade para alta concorrência: a APIYI oferece suporte a chamadas de alta concorrência do gemini-4-argon. Com menos de 500 RPM, você não precisa se preocupar com limitação de taxa.
Resumo
O gemini-4-argon apresenta erros 429 com frequência no AI Studio, e a causa principal não é simplesmente “concorrência baixa”. O problema resulta da combinação de vários limites: RPM, TPM, RPD, taxa de consumo em 10 minutos e capacidade limitada dos provedores upstream para modelos novos. A solução também deve ser aplicada em etapas: primeiro, entender a resposta original; depois, limitar a taxa de forma proativa e usar recuo exponencial com jitter aleatório. Se os erros 429 persistirem, troque de canal. No longo prazo, amplie a capacidade subindo de Tier ou expandindo os canais autorizados.
Para desenvolvedores que querem evitar complicações com cotas, uma opção mais prática é usar um canal agregador. Recomendamos testar rapidamente pelo APIYI apiyi.com. A plataforma oferece suporte a chamadas de alta concorrência do gemini-4-argon, e é possível usar com tranquilidade abaixo de 500 RPM. Fique à vontade para testar.
Referências
- Página de uso e limites de taxa do Google AI Studio: consulte o RPM, TPM, RPD e o nível de Tier do projeto.
- Link:
aistudio.google.com/usage -
Observação: selecione o projeto e o gemini-4-argon para consultar as cotas reais.
-
Documentação sobre limites de taxa da Gemini API: mecanismos oficiais de limitação de taxa e recomendações para lidar com erros 429.
- Link:
ai.google.dev/gemini-api/docs/rate-limits - Observação: inclui limites de consumo em 10 minutos e recomendações de recuo exponencial.
Autor: APIYI Team
Discussão técnica: compartilhe nos comentários suas experiências ao investigar erros 429 no gemini-4-argon. Para mais informações sobre integração, acesse a central de documentação da APIYI em docs.apiyi.com.