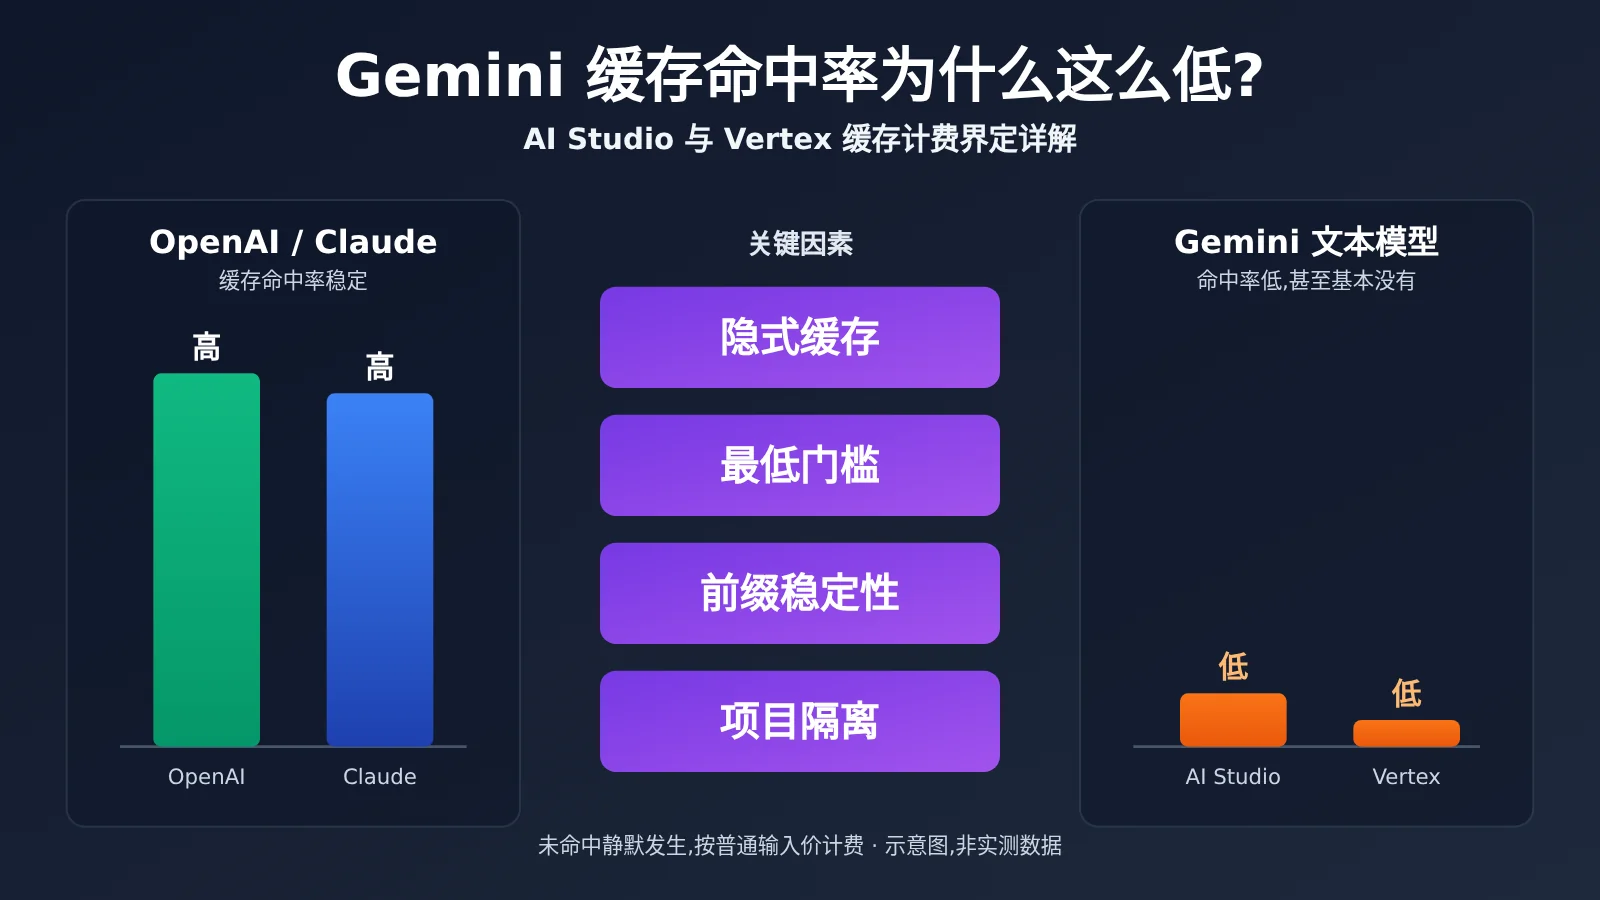
在 API易 的实际使用中,OpenAI 和 Claude 系列的缓存写入与命中都很正常,命中率也很高。Gemini 文本模型却不一样:缓存命中率很低,甚至基本没有。这是一个可以在账单和用量明细里复现的事实,也是不少开发者在对账时最困惑的地方。
本文基于 Google 官方文档(截至 2026 年 10 月 20 日),拆解 Gemini 缓存命中率低的 5 类原因,并讲清 AI Studio(Gemini Developer API)与 Vertex AI 的缓存计费是怎么界定的。
这不是一篇“甩锅式”分析。Google 官方并没有“使用中转会降低 Gemini 缓存命中率”的规则,我们也无法在没有上游请求记录的情况下,断言某个具体原因一定成立。本文的做法是:先讲官方规则,再列出哪些条件会让规则“失效”,最后给出一套你自己就能跑的排查与核账方法。
核心价值:读完本文,你将理解 Gemini 缓存何时命中、何时不命中,掌握“总输入包含缓存部分”这一计费要点,并能用官方响应字段独立核对账单。
Gemini 缓存命中率核心要点
先把结论摆在前面。理解 Gemini 缓存,需要先分清“隐式缓存”和“显式缓存”两种机制,两者的触发方式和计费方式完全不同。
| 类型 | 如何使用 | 如何获得缓存优惠 | 是否有存储费 |
|---|---|---|---|
| 隐式缓存 Implicit caching | 支持的模型自动启用,无须创建缓存对象 | 请求实际命中后,命中部分按缓存价格收费,不保证每次命中 | 没有 |
| 显式缓存 Explicit caching | 主动创建缓存对象,后续请求引用该对象 | 有效引用的缓存输入享受缓存价格 | 有 |
官方文档对 Developer API 的隐式缓存有一句关键表述:它不保证节省费用。显式缓存虽然确定性更高,但需要额外的开发工作,包括创建缓存对象、管理有效期、在后续请求中引用该对象。
为什么 Gemini 的体验和 OpenAI、Claude 不一样
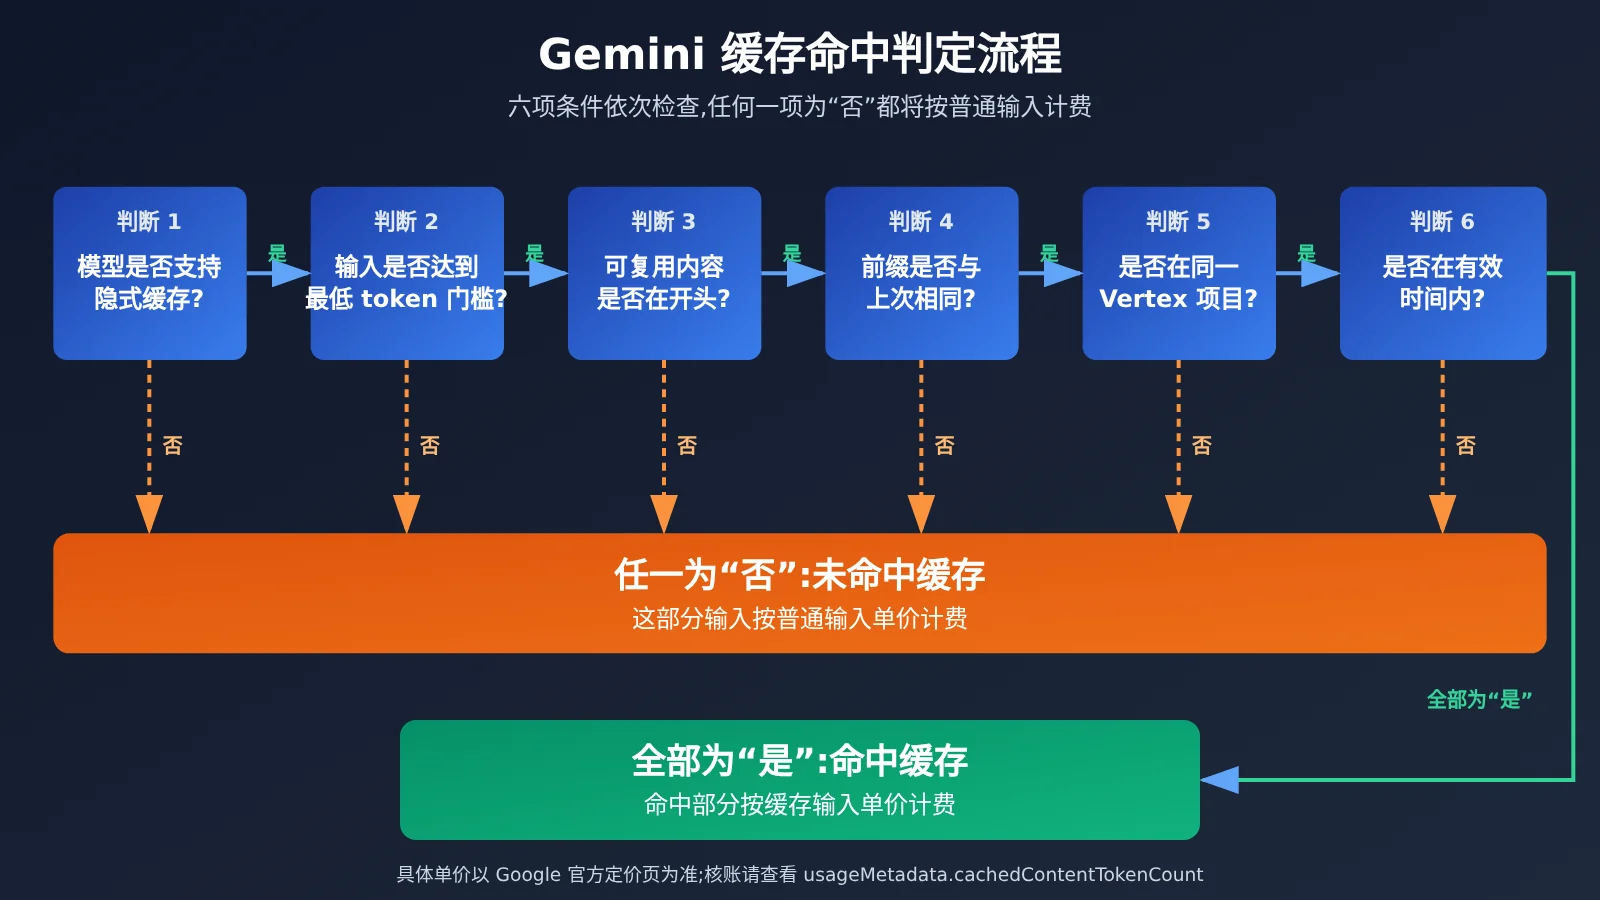
从使用者视角看,OpenAI 和 Claude 系列在 API易 上表现为“发同样的长前缀,就能稳定看到缓存写入与命中”。Gemini 则要同时满足几个条件:模型支持隐式缓存、请求达到该模型的最低 token 门槛、可复用内容位于提示词开头、相似请求在较短时间内发出,而且在 Vertex 侧还要落在同一个 Google Cloud 项目里。
任何一个条件不满足,请求都会按普通输入价格计费,不会报错,也不会有任何提示。这正是“命中率低”常常不被发现的原因:缓存没命中是静默发生的。
先界定一个概念:AI Studio 指什么
本文把“AI Studio 渠道”理解为 Gemini Developer API,也就是用 AI Studio 生成的 API Key 调用的那条路径,与 Google Cloud 上的 Vertex AI 对比。两者的缓存机制思路一致,但最低门槛数值、隔离范围和存储费规则存在差异,后文逐项展开。
Gemini 缓存命中率低的 5 类原因
下面的分析分两层:前两类是官方文档明确的规则,后三类是“规则在中转或工程实践中被打破”的条件性解释。我们无法仅凭“用了中转”确定具体是哪一条,需要上游项目和请求记录才能定位。
原因 1:请求没有达到最低缓存 token 门槛
隐式缓存有最低 token 门槛,输入太短的请求不会进入缓存。而且两端的门槛并不完全一致。以下是当前文档列出的部分模型数值:
| 模型 | Developer API 隐式缓存门槛 | Vertex 隐式缓存门槛 |
|---|---|---|
| Gemini 3.8 Flash | 4,096 | 6,144 |
| Gemini 3.1 Pro Preview | 4,096 | 6,144 |
| Gemini 2.5 Pro(旧一代,对照用) | 2,048 | 2,048 |
这里有两个容易踩的坑。第一,新一代模型(如 Gemini 3.8 Flash)的门槛比 2.5 系列更高,用早期版本的 2,048 去估算会误判。第二,同一个模型在 Vertex 上的门槛可能更高,一个 5,000 token 的请求在 Developer API 上够格,在 Vertex 上就不够。
日常对话类请求通常只有几百到一两千 token,天然低于门槛,这是 Gemini 在聊天场景下命中率很低的最直接原因之一。需要强调的是,达到门槛只是必要条件,不代表必然命中。
原因 2:可复用内容不在提示词开头
Google 对两端给出的建议一致:把较长、重复使用的内容放在提示词开头,并在较短时间内发送具有相似前缀的请求。缓存依赖的是共同前缀,而不是“请求里包含同一份文档”。
换句话说,两次请求都带了同一份文档,并不足以保证命中。还要看它在请求中的位置,以及它前面的内容是否稳定。下面这种写法就很容易破坏前缀:
# 反例:变化内容放在最前面
[当前时间:2026-10-20 10:31:07]
[请求 ID:a8f3...]
{system 指令}
{长文档}
{用户问题}
只要开头有一个字符不同,后面的长文档就无法与上一次请求形成共同前缀。这一点是依据官方建议做出的推断,但在工程上非常常见。
原因 3:中转层改变了前缀(条件性)
如果中转层在提示词开头插入变化的时间、标识、追踪字段,或者对多轮上下文做了重排、压缩、截断,就会改变共同前缀,降低命中机会。这是一种条件性分析,不能直接认定某家服务存在这些行为。
排查时要区分两个层面:你发给中转的请求前缀是否稳定,以及中转发给 Google 的请求前缀是否稳定。前者你可以自己控制,后者需要看上游请求记录。
原因 4:请求被分散到不同的 Vertex 项目(条件性)
Vertex 明确规定:缓存按 Google Cloud 项目隔离,不跨项目共享。如果同一个会话的多次请求被轮询到不同的 Vertex 项目,那么项目 A 建立的缓存,项目 B 无法使用。
这里要谨慎:“换 Key”是否丢缓存,取决于是否同时换了项目。不能直接认定每次换 Key 都会丢缓存,需要进一步确认 Key 与项目的对应关系。
原因 5:只转发了生成请求,没有使用显式缓存
如果调用链路只是转发 generateContent 请求,没有创建缓存对象,也没有在后续请求里引用它,那么整条链路只依赖隐式缓存。隐式缓存没有确定性保证,无法获得显式缓存那样“创建一次,反复引用”的稳定收益。
下表把这几类中转场景与官方规则对应起来:
| 实际行为 | 可能影响 | 对应的官方规则 |
|---|---|---|
| 同一会话轮询到不同 Vertex 项目 | 无法复用另一个项目已有的缓存 | 缓存按项目隔离 |
| 开头插入变化的时间、标识,或重排上下文 | 共同前缀被破坏,命中机会下降 | 长内容置于开头、前缀相似 |
| 请求较短,固定可复用内容不足 | 达不到缓存门槛 | 最低 token 门槛 |
| 只转发生成请求,没有创建、引用显式缓存对象 | 只能依赖隐式缓存,没有确定性 | 显式缓存须创建并引用对象 |
🎯 技术建议:在排查 Gemini 缓存问题时,建议先通过 API易 apiyi.com 用同一份固定长前缀连续发起多次请求,再对比各次返回的缓存 token 字段。用受控的请求先排除前缀和门槛问题,再判断是否与链路有关。
没有上游项目和请求记录,就无法仅凭“用了中转”确定原因,也没有官方依据认定 Vertex 的命中率必然高于 Developer API。
AI Studio 与 Vertex 缓存计费如何界定
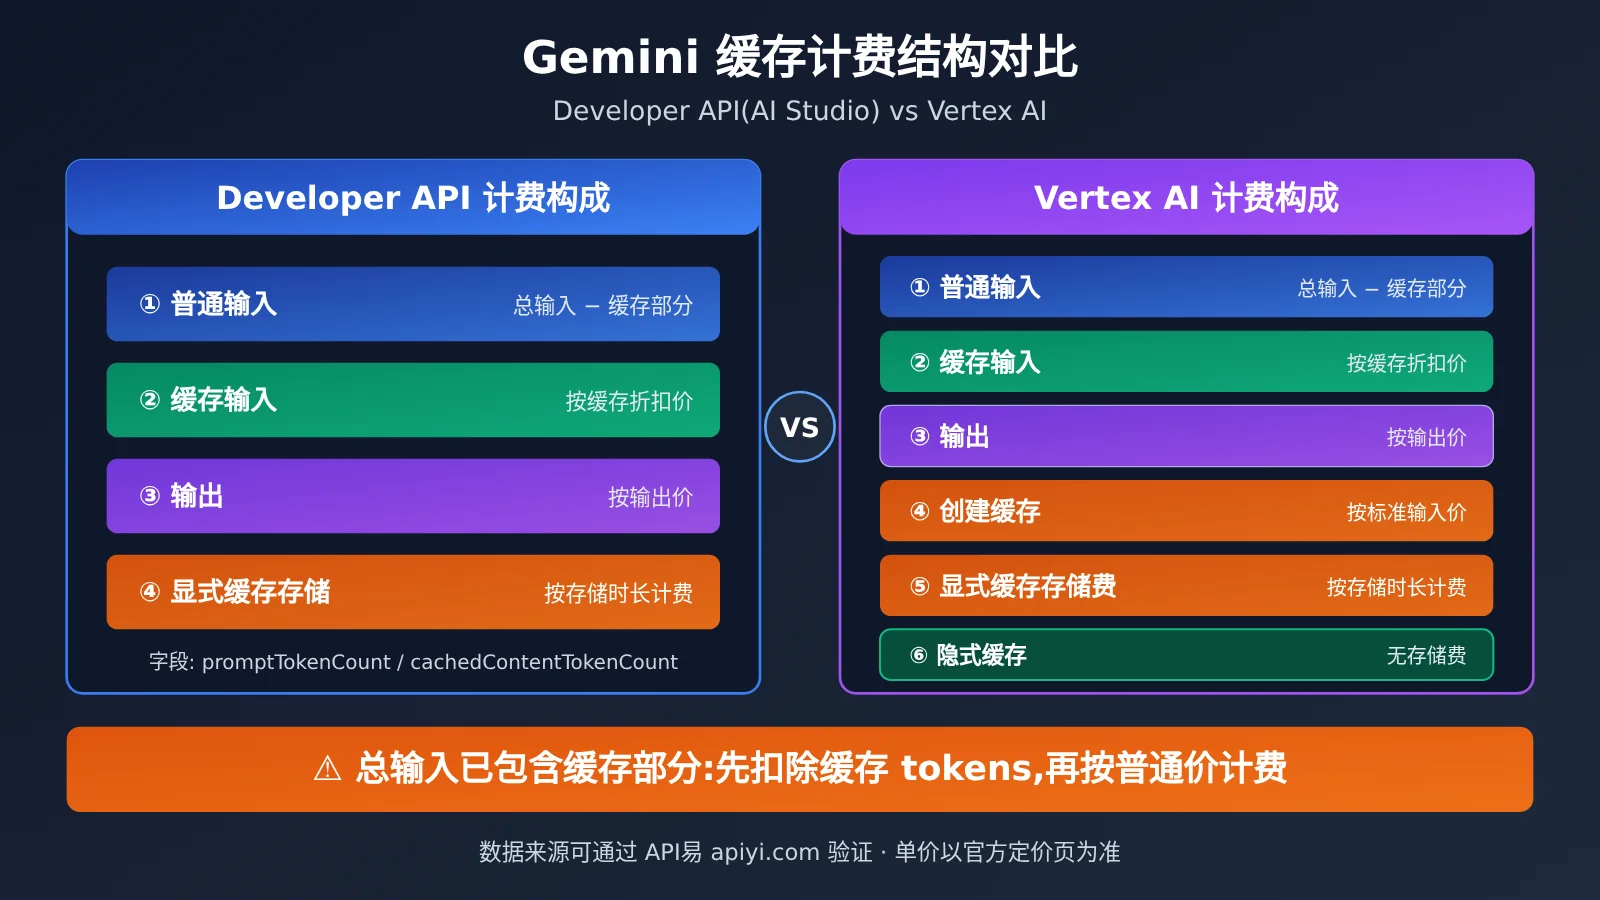
很多人把“缓存命中”理解成免费或者整条请求统一打折,这是不对的。两端的计费都要区分四类项目:普通输入、缓存输入、输出,以及显式缓存的存储费。
两端计费规则对照
| 计费项 | Developer API(AI Studio) | Vertex AI |
|---|---|---|
| 普通输入(未命中部分) | 按普通输入单价 | 按普通输入单价 |
| 缓存输入(命中部分) | 按缓存输入单价,定价页单独列出 | 按缓存输入单价,定价页单独列出 |
| 输出 | 另计 | 另计 |
| 创建缓存使用的输入 | 计入缓存 token 使用费 | 按标准输入价格收费 |
| 隐式缓存存储费 | 没有 | 没有 |
| 显式缓存存储费 | 按存储时长计费 | 有存储费 |
Developer API 文档把缓存 token 使用费、存储时长、非缓存输入和输出都列为计费因素。Vertex 则另外明确了两点:创建缓存所用的输入按标准输入价格收费,隐式缓存没有存储费,显式缓存有存储费。具体单价请以两端当前的官方定价页为准,不同模型和版本会变化。
输入费用的计算公式
对于普通文本生成请求,可以按下面的结构理解输入费用:
输入费用 =
(总输入 tokens − 缓存命中 tokens)× 普通输入单价
+ 缓存命中 tokens × 缓存输入单价
输出费用另算,显式缓存还要另加存储费。举一个假设的例子:某次请求总输入为 10,000 tokens,其中缓存命中 8,000 tokens,那么按普通价格计费的是 2,000 tokens,按缓存价格计费的是 8,000 tokens。
一个最容易算错的点:总输入已包含缓存部分
核账时要看 Google 的原始响应,而不是只看中转后台显示的“缓存命中率”。在 generateContent 响应的 usageMetadata 中,有两个关键字段:
| 字段 | 含义 | 核账注意点 |
|---|---|---|
usageMetadata.promptTokenCount |
总输入 tokens | 包含缓存部分 |
usageMetadata.cachedContentTokenCount |
缓存部分的 tokens | 命中缓存的数量 |
因此,不能把 promptTokenCount 全部按普通价格算完,再额外加一笔缓存输入费,那样会重复计费。正确做法是先用总输入减去缓存部分,得到按普通价格计费的部分。如果你使用的是新的 Interactions API,官方给出的缓存统计字段是 usage.total_cached_tokens。
两件必须分开的事
还需要区分两件事:Google 上游实际命中了多少缓存,以及中转如何把这部分优惠计入你的账单。前者可以用官方字段衡量,后者取决于中转自身的计费规则,Google 官方文档无法替其证明。所以对账时,建议同时核对上游返回的缓存字段和账单明细的计费口径。
💡 选择建议:对账时先看请求级别的缓存 token 字段,再看账单汇总。如果需要在 OpenAI、Claude 和 Gemini 之间做同口径对比,可以通过 API易 apiyi.com 用同一份提示词分别调用,便于快速切换模型。
Gemini 与 Claude、OpenAI 的缓存计费差异
三家的缓存思路不同,对账口径也不同。下表按“怎么触发、怎么计费”对比,折扣比例和时长会随模型版本调整,下表为写作时的大致口径,具体数值请以各家官方定价页为准:
| 对比项 | Gemini | Claude | OpenAI |
|---|---|---|---|
| 触发方式 | 隐式自动 + 显式缓存对象两套机制 | 显式:请求里用 cache_control 标记缓存断点 |
自动,无需改代码 |
| 缓存写入费 | 隐式无;显式创建时按输入计费,另有存储费 | 有,写入单价高于普通输入(5 分钟与 1 小时有效期单价不同) | 没有单独的写入费 |
| 缓存读取(命中)价 | 低于普通输入,折扣随模型而定 | 约为普通输入的 1/10 | 低于普通输入,折扣随模型而定 |
| 存储费 | 仅显式缓存,按存储时长计费 | 无,按写入时选择的有效期计 | 无 |
| 最低门槛 | 随模型和渠道不同,Vertex 可能高于 Developer API | 随模型不同,常见为 1,024 或更高 | 通常 1,024 tokens 起 |
| 命中保证 | 隐式不保证,显式较确定 | 标记断点后,在有效期内通常稳定命中 | 自动前缀匹配,不保证 |
| 用量字段 | cachedContentTokenCount(含在 promptTokenCount 内) |
cache_creation_input_tokens、cache_read_input_tokens,与普通输入 tokens 分开列出 |
prompt_tokens_details.cached_tokens(含在 prompt_tokens 内) |
这张表里有三处最容易混淆:
- 写入费:Claude 写缓存要多付钱,读缓存才便宜,所以“写得多、读得少”会比不用缓存更贵;OpenAI 没有写入费,不命中也不会多花钱;Gemini 隐式缓存同样没有写入费,只有显式缓存会产生创建与存储成本。
- 谁来决定缓存:Claude 由请求方明确标记断点,所以命中表现最可预期;OpenAI 与 Gemini 隐式缓存都由平台自动判断,开发者只能靠稳定前缀提高概率。这也是用户感觉 Claude、OpenAI “命中稳定”而 Gemini 不稳定的原因之一:Gemini 要同时受门槛、前缀、渠道隔离几项影响。
- 总输入口径:Gemini 与 OpenAI 的总输入已包含缓存部分,要先扣除再计价;Claude 的
input_tokens不含缓存读写部分,三项要分别计价后相加。把一家的公式套到另一家,账会算错。通过 API易 apiyi.com 做跨模型对账时,请先确认各家返回的字段口径。
Gemini 缓存命中率快速上手:自己跑一次测试
理论说完,动手验证最可靠。下面的思路是:构造一段超过最低门槛的固定长前缀,把变化的问题放在最后,连续请求几次,观察缓存 token 字段的变化。
极简示例
以下代码使用 OpenAI 兼容格式调用,并打印返回的用量信息。字段名以实际返回为准,不同接入方式下缓存相关字段的命名可能不同:
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 API易 统一接口
)

# 固定的长前缀:务必超过目标模型的最低缓存门槛
LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800

for i in range(3):
    resp = client.chat.completions.create(
        model="gemini-3.8-flash",
        messages=[
            {"role": "system", "content": LONG_PREFIX},
            {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
        ],
    )
    print(i, resp.usage)
    time.sleep(2)
查看完整测试与核账代码
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 API易 统一接口
)

LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800


def extract_cached_tokens(usage) -> int:
    """尝试从 usage 中读取缓存 token 数,字段名以实际返回为准"""
    details = getattr(usage, "prompt_tokens_details", None)
    if details is not None:
        cached = getattr(details, "cached_tokens", None)
        if cached is not None:
            return cached
    return 0


def estimate_input_cost(total_in: int, cached: int,
                        normal_price: float, cached_price: float) -> float:
    """
    按官方口径估算输入费用:
    总输入已包含缓存部分,所以普通部分 = 总输入 - 缓存部分
    单价请填入官方定价页当前数值(每百万 token)
    """
    normal_part = total_in - cached
    return (normal_part * normal_price + cached * cached_price) / 1_000_000


def run_test(model: str, rounds: int = 3):
    results = []
    for i in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": LONG_PREFIX},
                {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
            ],
        )
        usage = resp.usage
        cached = extract_cached_tokens(usage)
        results.append((i, usage.prompt_tokens, cached))
        print(f"第 {i} 次:总输入={usage.prompt_tokens},缓存命中={cached}")
        time.sleep(2)
    return results


if __name__ == "__main__":
    for m in ["gemini-3.8-flash"]:
        print("模型:", m)
        run_test(m)
🚀 快速开始:推荐使用 API易 apiyi.com 搭建这个对比测试。同一份脚本只需替换 model 参数,就能依次测 Gemini、OpenAI 和 Claude 系列,直观看到不同模型的缓存表现差异。
测试时要控制的变量
跑测试时,建议逐条检查下面这份清单,避免把“自己的问题”误判成“链路的问题”:
| 检查项 | 做法 | 目的 |
|---|---|---|
| 前缀长度 | 确保大于目标模型当前的最低门槛 | 排除门槛问题 |
| 前缀稳定性 | 不在开头放时间戳、请求 ID | 排除前缀被破坏 |
| 变化内容位置 | 用户问题放在最后 | 保证共同前缀最长 |
| 请求间隔 | 在较短时间内连续发送 | 符合官方建议 |
| 对照组 | 同一提示词测 OpenAI 或 Claude | 判断是模型机制还是链路问题 |
如何解读测试结果
如果前缀足够长、结构稳定、间隔很短,但 Gemini 仍然几乎没有缓存命中,而同样的提示词在 OpenAI 或 Claude 上命中正常,就说明差异来自 Gemini 自身的缓存机制和上游链路条件,而不是你的提示词写法。这时可以考虑改用显式缓存,把需要复用的长内容固定下来,主动创建缓存对象并在请求中引用。
如果你的业务本来就是短对话,那么与其追求命中率,不如接受 Gemini 在这类场景下缓存收益有限,把成本优化的重点放在模型选择和输出长度控制上。
常见问题
Q1: 为什么 Gemini 的缓存命中率明显低于 OpenAI 和 Claude?
Gemini 的隐式缓存需要同时满足模型支持、达到最低 token 门槛、前缀稳定、时间相近,Vertex 侧还受项目隔离限制,并且官方明确不保证命中。任何一环不满足,都会静默按普通输入计费。具体到某条链路的原因,需要结合上游请求记录判断。
Q2: Google 官方是否说过使用中转会降低缓存命中率?
没有。官方只给出了缓存依赖的条件:可复用的前缀、最低 token 门槛和作用范围。如果链路改变了这些条件,命中率就可能下降。想对比不同模型的缓存表现,可以通过 API易 apiyi.com 用同一份提示词做受控测试。
Q3: 缓存命中的部分是免费的吗?
不是。命中部分按缓存输入单价收费,价格低于普通输入但并非为零。两端的定价页都分别列出普通输入与缓存输入价格,显式缓存另外还有存储费。
Q4: 账单上的输入 token 要不要再单独加缓存部分?
不要。`promptTokenCount` 是总输入,已经包含缓存部分。应当用总输入减去 `cachedContentTokenCount`,得到按普通价格计费的部分,再单独计算缓存部分。
Q5: AI Studio 和 Vertex 的缓存门槛一样吗?
不完全一样。按当前文档,Gemini 3.1 Pro Preview 与 Gemini 3.8 Flash 在 Developer API 为 4,096,在 Vertex 为 6,144;旧一代的 Gemini 2.5 Pro 两端都是 2,048。门槛会随模型版本调整,建议以官方文档当前数值为准。
Q6: 换了 API Key,缓存会丢吗?
要看是否换了项目。Vertex 的缓存按 Google Cloud 项目隔离,不跨项目共享,所以换到不同项目的 Key 会丢缓存;同一项目下的不同 Key 则不能直接认定丢失。
Q7: 我该用隐式缓存还是显式缓存?
如果你有固定的大段内容(长文档、长系统指令)需要被反复引用,显式缓存的确定性更好,但要承担开发成本和存储费。如果只是偶尔复用,隐式缓存零成本,但收益不可预期。可以先通过 API易 apiyi.com 做小规模对比,再决定是否投入显式缓存的开发。
Q8: 中转后台显示的命中率可以直接作为对账依据吗?
不建议。应以官方原始响应的缓存字段为准。另外,Google 上游的实际命中与中转如何计入你的账单是两件事,后者需要核对中转自身的计费规则。
缓存命中率 Key Takeaways
- 现象是事实:OpenAI 与 Claude 系列缓存命中稳定,Gemini 命中率低甚至接近没有,需要单独分析。
- 官方不保证命中:Gemini 隐式缓存不保证节省费用,显式缓存需要主动创建并引用缓存对象。
- 门槛因模型而异:新一代模型门槛更高,且 Vertex 与 Developer API 的数值可能不同。
- 前缀决定命中:长内容放开头,开头不要插入时间、ID 等变化内容,否则共同前缀被破坏。
- Vertex 按项目隔离:缓存不跨项目共享,请求分散到不同项目会丢失缓存。
- 总输入含缓存:
promptTokenCount已包含缓存部分,核账时要先扣除再分别计价。 - 用字段对账:以官方响应的缓存字段为准,并通过 API易 apiyi.com 做同提示词的跨模型对比。
总结
Gemini 缓存命中率低,是由多个条件叠加造成的:隐式缓存不保证命中、最低 token 门槛随模型升高、前缀必须稳定、Vertex 缓存按项目隔离,以及显式缓存需要主动创建。其中后几项在链路层面被改变时,命中率就会下降,但具体原因必须结合上游项目和请求记录才能确定。
计费方面,记住三点:缓存命中不是免费;总输入包含缓存部分,不能重复计费;显式缓存另有存储费,隐式缓存没有。核账以官方响应字段为准,同时单独核对中转的计费口径。
下一步建议:用本文的测试脚本,在固定长前缀下对 Gemini 与 OpenAI、Claude 做一次对照测试,再决定是否引入显式缓存。推荐通过 API易 apiyi.com 快速验证效果,多个模型共用同一套接口,对比成本低。
参考资料
- Gemini API 缓存文档:隐式缓存与显式缓存的官方说明
- 链接:
ai.google.dev/gemini-api/docs/caching -
说明: 包含最低 token 门槛与计费因素
-
Gemini API 定价页:普通输入、缓存输入、输出与存储价格
- 链接:
ai.google.dev/gemini-api/docs/pricing -
说明: 核对当前单价的依据
-
Vertex AI 上下文缓存概览:缓存的项目隔离与计费规则
- 链接:
docs.cloud.google.com/vertex-ai/generative-ai/docs/context-cache/context-cache-overview -
说明: 说明 Vertex 缓存不跨项目共享
-
Gemini API generateContent 参考:响应中的 usageMetadata 字段
- 链接:
ai.google.dev/api/generate-content - 说明: 核账时使用的缓存 token 字段
作者:APIYI Team
技术交流:欢迎在评论区讨论 Gemini 缓存的排查经验,更多资料可访问 API易 docs.apiyi.com 文档中心