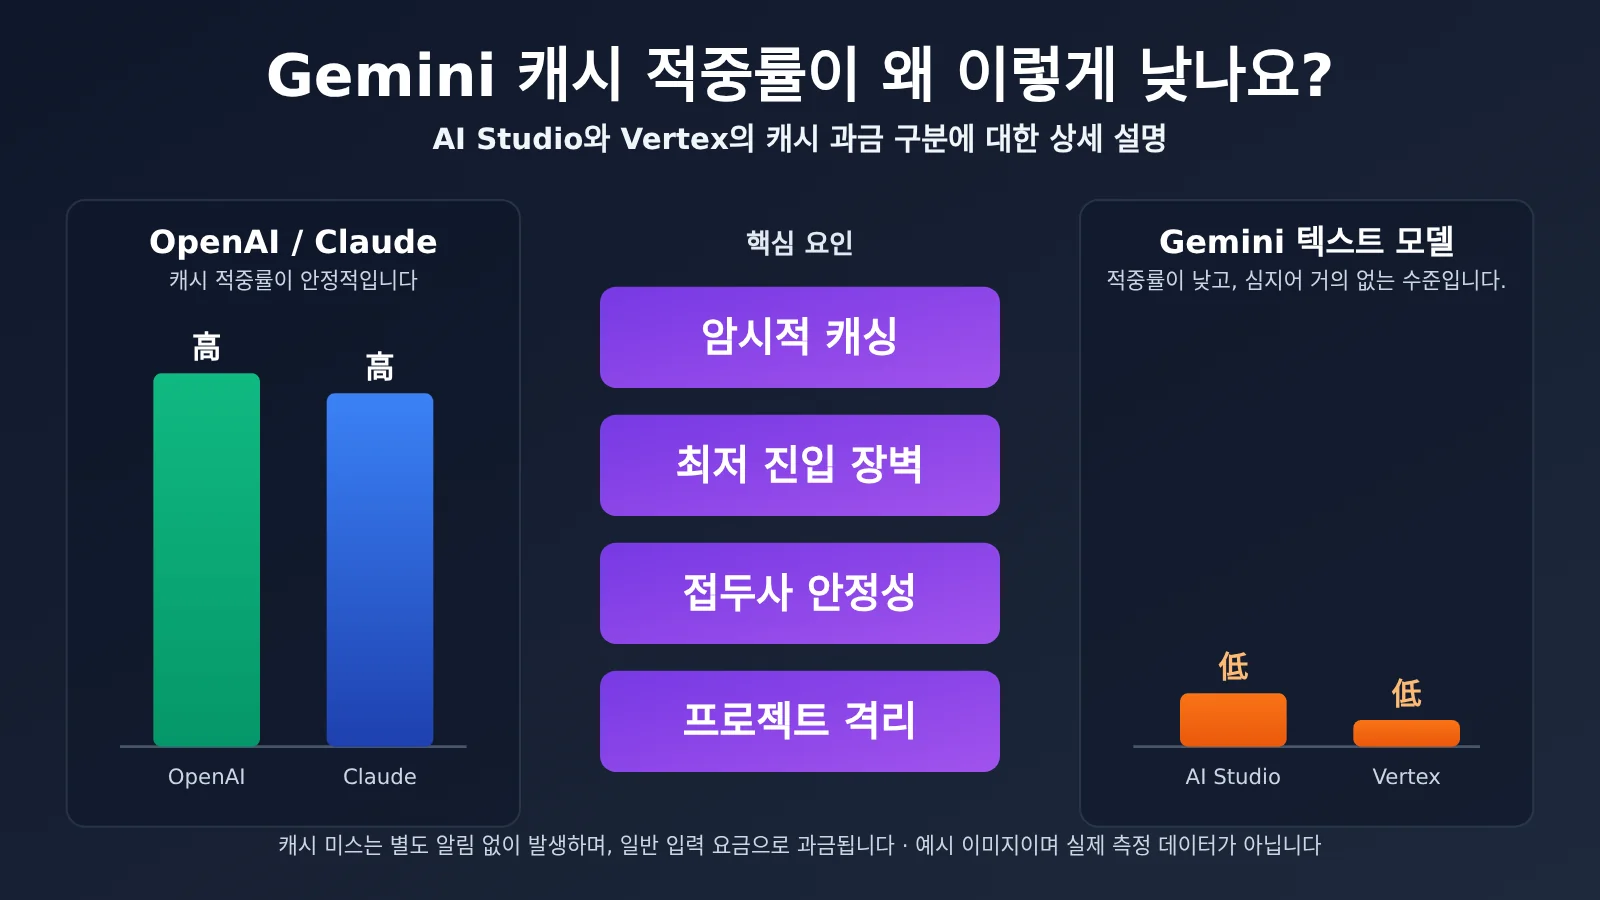
APIYI를 실제로 사용할 때 OpenAI와 Claude 계열은 캐시 쓰기와 적중이 모두 정상적으로 이뤄지고 적중률도 높아요. 하지만 Gemini 텍스트 모델은 다릅니다. 캐시 적중률이 낮고, 거의 적중하지 않는 경우도 있어요. 이는 청구서와 사용량 상세 내역에서 확인할 수 있는 사실이며, 많은 개발자가 비용을 대조할 때 가장 혼란스러워하는 부분이기도 합니다.
이 글은 2026년 10월 20일 기준 Google 공식 문서를 바탕으로 Gemini 캐시 적중률이 낮은 5가지 원인을 살펴보고, AI Studio(Gemini Developer API)와 Vertex AI의 캐시 과금 기준을 설명해요.
책임을 돌리는 식의 분석은 하지 않겠습니다. Google 공식 문서에는 “API 중계 서비스를 사용하면 Gemini 캐시 적중률이 낮아진다”는 규칙이 없어요. 또한 상위 서비스의 요청 기록이 없는 상황에서 특정 원인이 반드시 성립한다고 단정할 수도 없습니다. 이 글에서는 먼저 공식 규칙을 설명하고, 어떤 조건에서 규칙이 적용되지 않는지 살펴본 뒤, 직접 실행해 볼 수 있는 점검 및 비용 대조 방법을 안내해요.
핵심 가치: 이 글을 읽고 나면 Gemini 캐시가 언제 적중하고 적중하지 않는지 이해하고, “전체 입력에 캐시된 부분이 포함된다”는 과금의 핵심을 파악할 수 있어요. 또한 공식 응답 필드로 청구 내역을 직접 대조할 수 있습니다.
Gemini 캐시 적중률의 핵심
먼저 결론부터 말씀드릴게요. Gemini 캐시를 이해하려면 ‘암시적 캐싱’과 ‘명시적 캐싱’을 구분해야 합니다. 두 방식은 작동 조건과 과금 방식이 완전히 달라요.
| 유형 | 사용 방법 | 캐시 할인을 받는 방법 | 저장 비용 |
|---|---|---|---|
| 암시적 캐싱(Implicit caching) | 지원 모델에서 자동으로 활성화되며, 캐시 객체를 만들 필요가 없음 | 요청이 실제로 캐시에 적중하면 적중한 부분에 캐시 가격이 적용됨. 매번 적중하는 것은 아님 | 없음 |
| 명시적 캐싱(Explicit caching) | 캐시 객체를 직접 만든 뒤, 이후 요청에서 해당 객체를 참조 | 유효한 캐시 참조의 입력에 캐시 가격이 적용됨 | 있음 |
Developer API의 암시적 캐싱에 관해 공식 문서에는 중요한 설명이 나와 있어요. 비용 절감을 보장하지 않는다는 내용입니다. 명시적 캐싱은 더 확실하게 동작하지만, 캐시 객체를 만들고 유효 기간을 관리하며 이후 요청에서 해당 객체를 참조하는 등 추가 개발 작업이 필요해요.
Gemini는 왜 OpenAI, Claude와 사용 경험이 다를까요?
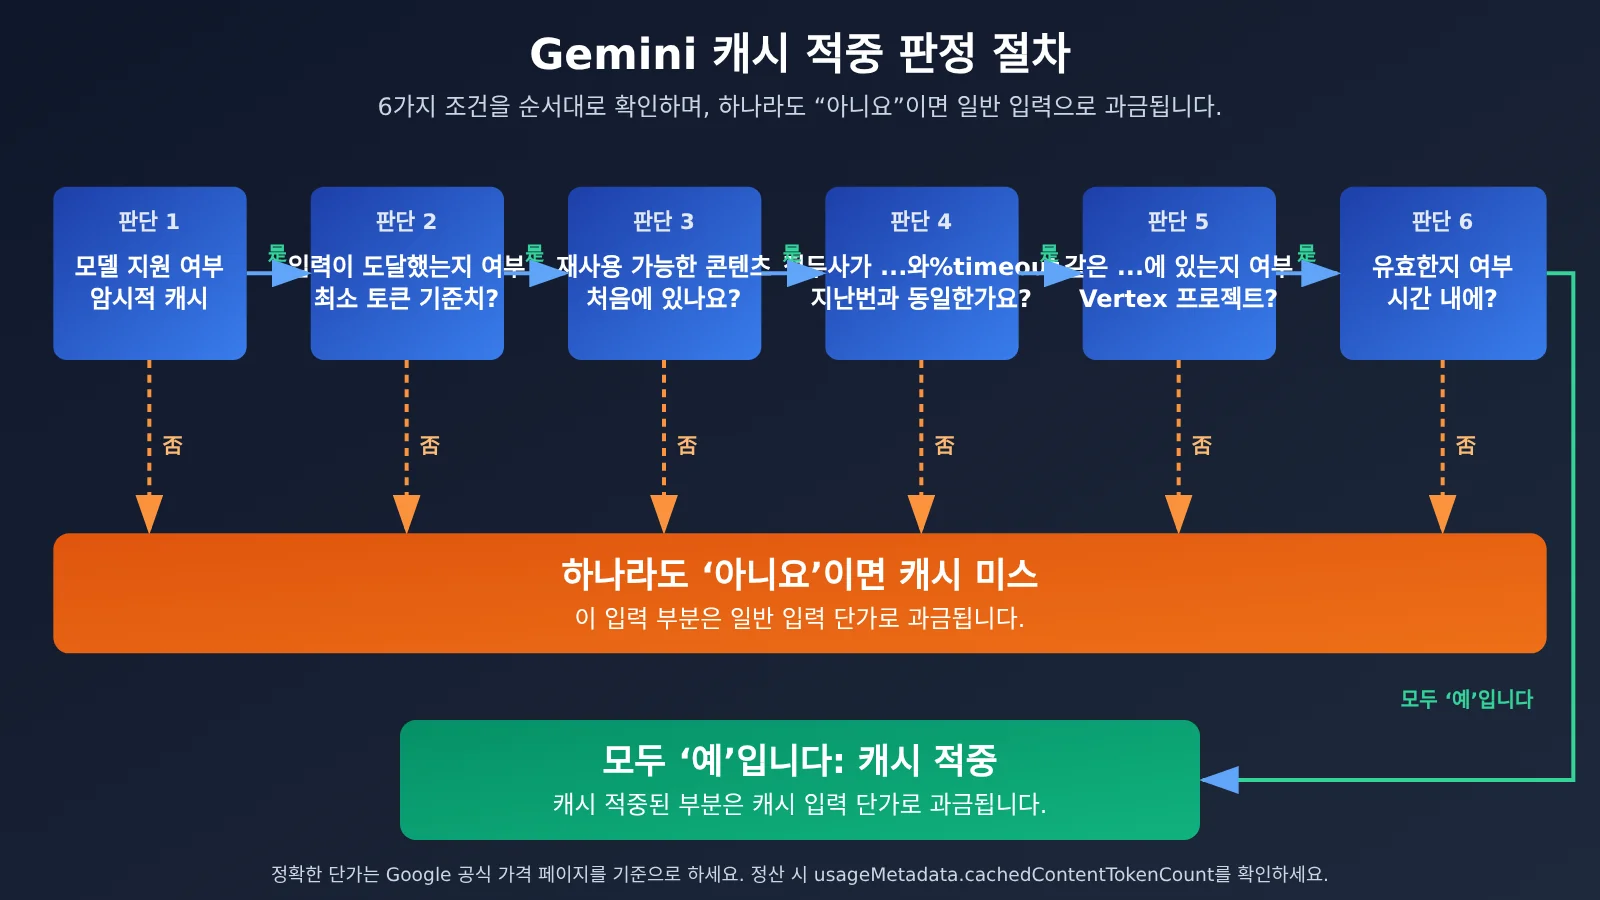
사용자 입장에서는 APIYI에서 OpenAI와 Claude 계열에 “동일한 긴 접두사를 보내면 캐시 쓰기와 적중이 안정적으로 확인된다”고 느낄 수 있어요. 하지만 Gemini는 여러 조건을 동시에 충족해야 합니다. 모델이 암시적 캐싱을 지원해야 하고, 요청이 해당 모델의 최소 토큰 기준을 넘어야 하며, 재사용할 콘텐츠가 프롬프트 앞부분에 있어야 합니다. 또한 유사한 요청을 짧은 시간 안에 보내야 하고, Vertex에서는 동일한 Google Cloud 프로젝트 안에서 요청을 처리해야 해요.
이 조건 중 하나라도 충족하지 못하면 요청은 일반 입력 가격으로 과금됩니다. 오류가 발생하거나 별도 안내가 표시되는 것도 아니에요. 그래서 캐시 적중률이 낮은 상황을 알아차리기 어려운 경우가 많습니다. 캐시가 적중하지 않아도 조용히 지나가기 때문이죠.
먼저 개념부터 정리해 볼게요: AI Studio란?
이 글에서 ‘AI Studio 채널’은 Gemini Developer API를 의미해요. 즉, AI Studio에서 발급한 API 키로 호출하는 경로를 말하며, Google Cloud의 Vertex AI와 비교합니다. 두 서비스의 캐싱 방식은 기본적으로 비슷하지만, 최소 기준 토큰 수와 격리 범위, 저장 비용 규칙에는 차이가 있어요. 뒤에서 하나씩 살펴보겠습니다.
Gemini 캐시 적중률이 낮은 5가지 원인
아래 분석은 두 부분으로 나뉘어요. 앞의 두 가지는 공식 문서에 명시된 규칙이고, 나머지 세 가지는 ‘중계 과정이나 엔지니어링 실무에서 규칙이 지켜지지 않는’ 상황을 가정한 설명이에요. 중계 서비스를 사용한다는 사실만으로 구체적인 원인을 단정할 수는 없어요. 원인을 파악하려면 상위 프로젝트와 요청 기록이 필요해요.
원인 1: 요청이 캐시 생성에 필요한 최소 토큰 수에 미달함
암묵적 캐시에는 최소 토큰 수 기준이 있어 입력이 너무 짧으면 캐시에 들어가지 않아요. 또한 Developer API와 Vertex의 기준이 완전히 같지는 않아요. 현재 문서에 나와 있는 모델별 수치는 다음과 같아요.
| 모델 | Developer API 암묵적 캐시 기준 | Vertex 암묵적 캐시 기준 |
|---|---|---|
| Gemini 3.8 Flash | 4,096 | 6,144 |
| Gemini 3.1 Pro Preview | 4,096 | 6,144 |
| Gemini 2.5 Pro(이전 세대, 비교용) | 2,048 | 2,048 |
여기서 주의할 점은 두 가지예요. 첫째, Gemini 3.8 Flash 같은 차세대 모델은 Gemini 2.5 시리즈보다 기준이 높아요. 이전 버전의 기준인 2,048을 적용해 계산하면 잘못 판단할 수 있어요. 둘째, 같은 모델이라도 Vertex의 기준이 더 높을 수 있어요. 예를 들어 5,000토큰 요청은 Developer API에서는 기준을 충족하지만 Vertex에서는 충족하지 못해요.
일상적인 대화 요청은 보통 수백~1,000~2,000토큰에 불과해 기준보다 짧아요. 따라서 Gemini가 채팅 상황에서 캐시 적중률이 낮은 직접적인 원인 중 하나가 될 수 있어요. 다만 기준을 충족하는 것은 필요조건일 뿐, 반드시 적중한다는 뜻은 아니에요.
원인 2: 재사용할 내용이 프롬프트 앞부분에 없음
Google은 두 API 모두 긴 반복 사용 콘텐츠를 프롬프트 앞부분에 두고, 짧은 시간 간격으로 유사한 접두부를 가진 요청을 보내라고 안내해요. 캐시는 요청에 같은 문서가 포함되어 있는지가 아니라 공통 접두부를 기준으로 작동해요.
즉, 두 요청에 같은 문서가 포함되어 있다고 해서 적중이 보장되는 건 아니에요. 문서가 요청의 어느 위치에 있는지, 문서 앞부분의 내용이 안정적인지도 중요해요. 다음과 같은 방식은 접두부를 쉽게 깨뜨릴 수 있어요.
# 반례: 변경되는 내용을 맨 앞에 배치
[현재 시간: 2026-10-20 10:31:07]
[요청 ID: a8f3...]
{system 지시}
{긴 문서}
{사용자 질문}
앞부분에서 한 글자라도 달라지면 뒤에 있는 긴 문서는 이전 요청과 공통 접두부를 형성할 수 없어요. 이는 공식 안내를 바탕으로 한 추론이지만, 엔지니어링 현장에서 흔히 볼 수 있는 문제예요.
원인 3: 중계 계층이 접두부를 변경함(조건부)
중계 계층이 프롬프트 앞에 매번 달라지는 시간, 식별자, 추적 필드를 추가하거나 여러 턴의 컨텍스트를 재배열·압축·잘라내면 공통 접두부가 달라져 적중 가능성이 낮아질 수 있어요. 다만 이는 특정 조건을 가정한 분석일 뿐, 어떤 서비스가 실제로 이런 동작을 한다고 단정할 수는 없어요.
문제를 조사할 때는 두 가지를 구분해야 해요. 중계 서비스에 보내는 요청의 접두부가 안정적인지, 그리고 중계 서비스가 Google에 보내는 요청의 접두부가 안정적인지 확인해야 해요. 첫 번째는 직접 제어할 수 있지만, 두 번째는 상위 요청 기록을 확인해야 해요.
원인 4: 요청이 여러 Vertex 프로젝트로 분산됨(조건부)
Vertex에는 캐시가 Google Cloud 프로젝트별로 격리되며 프로젝트 간에 공유되지 않는다는 규칙이 있어요. 같은 세션의 요청이 여러 Vertex 프로젝트로 번갈아 전달되면 프로젝트 A에서 만든 캐시를 프로젝트 B에서 사용할 수 없어요.
다만 ‘키를 바꾸면’ 캐시가 사라지는지는 프로젝트도 함께 바뀌는지에 달려 있어요. 키를 바꿀 때마다 캐시가 사라진다고 단정할 수는 없으므로, 키와 프로젝트의 연결 관계를 확인해야 해요.
원인 5: 생성 요청만 전달하고 명시적 캐시는 사용하지 않음
호출 경로에서 generateContent 요청만 전달하고 캐시 객체를 생성하지 않거나 후속 요청에서 해당 객체를 참조하지 않는다면, 전체 경로는 암묵적 캐시에만 의존하게 돼요. 암묵적 캐시는 확정적으로 보장되지 않으므로, 명시적 캐시처럼 ‘한 번 생성한 뒤 반복해서 참조’하는 안정적인 효과를 얻을 수 없어요.
아래 표는 이런 중계 상황을 공식 규칙과 연결해 정리한 내용이에요.
| 실제 동작 | 발생할 수 있는 영향 | 관련 공식 규칙 |
|---|---|---|
| 같은 세션의 요청이 여러 Vertex 프로젝트로 번갈아 전달됨 | 다른 프로젝트에 이미 생성된 캐시를 재사용할 수 없음 | 캐시는 프로젝트별로 격리됨 |
| 앞부분에 변경되는 시간이나 식별자를 삽입하거나 컨텍스트를 재배열함 | 공통 접두부가 깨져 적중 가능성이 낮아짐 | 긴 콘텐츠는 앞부분에 배치하고 접두부를 유사하게 유지 |
| 요청이 짧아 재사용할 고정 콘텐츠가 부족함 | 캐시 기준에 미달함 | 최소 토큰 수 기준 |
| 생성 요청만 전달하고 명시적 캐시 객체를 생성·참조하지 않음 | 암묵적 캐시에만 의존하므로 적중이 보장되지 않음 | 명시적 캐시는 객체를 생성하고 참조해야 함 |
🎯 기술 제안: Gemini 캐시 문제를 조사할 때는 먼저 APIYI apiyi.com에서 동일한 고정 접두부를 사용해 여러 요청을 연속으로 보내고, 각 응답의 캐시 토큰 필드를 비교해 보세요. 통제된 요청으로 접두부와 기준 문제를 먼저 배제한 다음, 호출 경로가 원인인지 판단할 수 있어요.
상위 프로젝트와 요청 기록이 없다면 중계 서비스를 사용했다는 사실만으로 원인을 특정할 수 없으며, Vertex의 적중률이 Developer API보다 반드시 높다는 공식 근거도 없어요.
AI Studio와 Vertex의 캐시 과금 기준
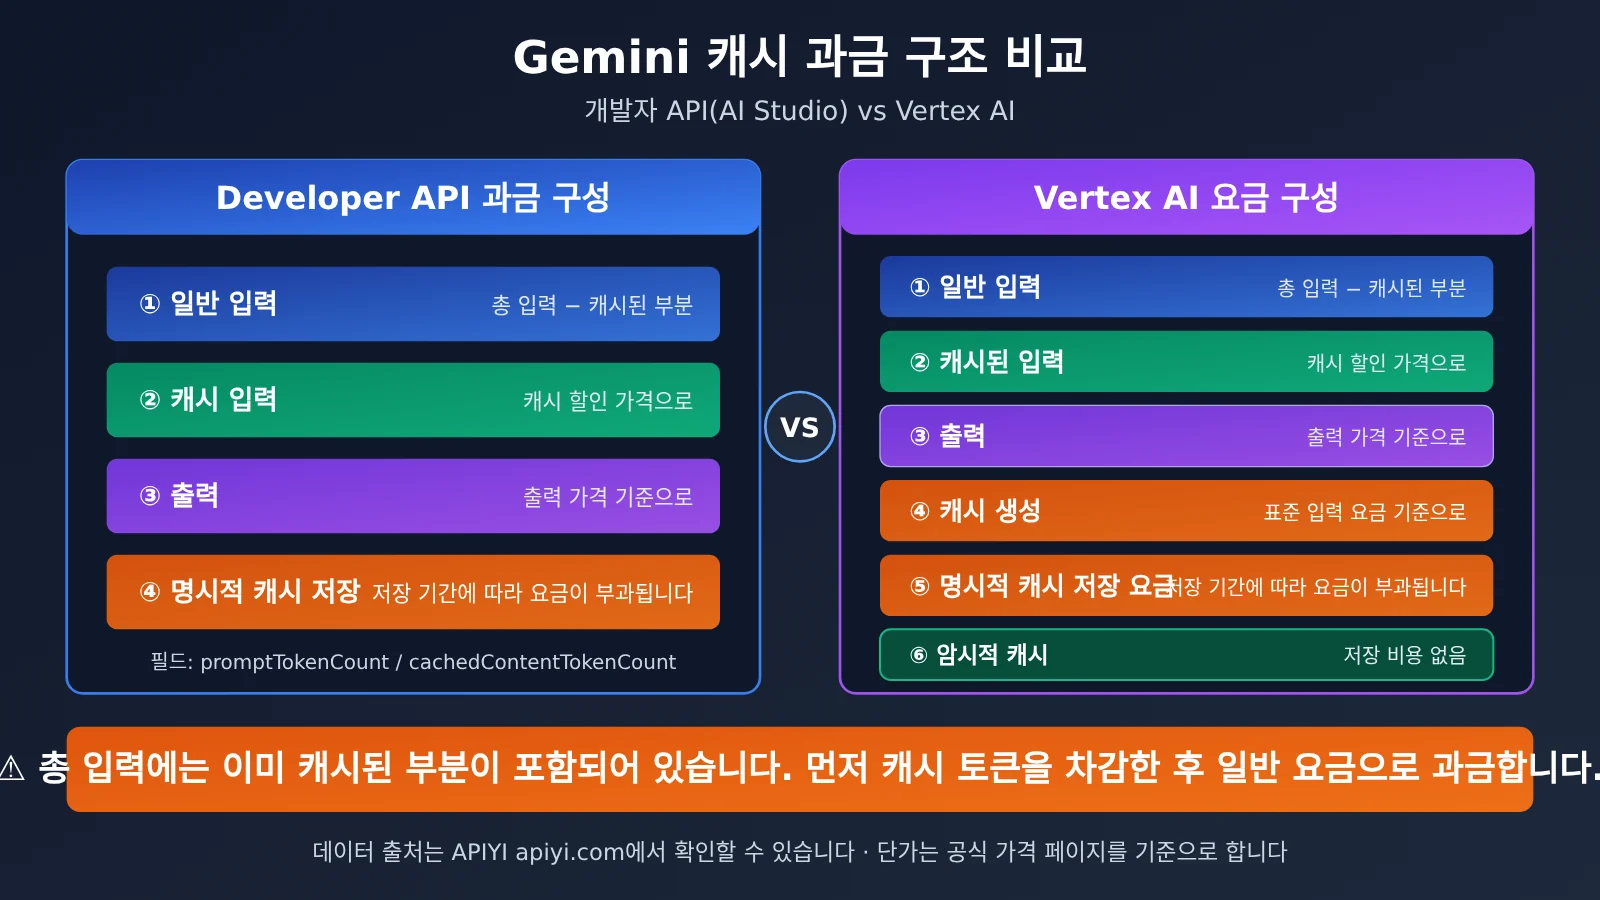
많은 사람이 ‘캐시 적중’을 무료이거나 요청 전체에 일괄 할인이 적용되는 것으로 이해하지만, 이는 사실이 아니에요. 두 서비스 모두 과금 항목을 일반 입력, 캐시 입력, 출력, 명시적 캐시 저장 비용으로 구분해야 해요.
두 서비스의 과금 규칙 비교
| 과금 항목 | Developer API(AI Studio) | Vertex AI |
|---|---|---|
| 일반 입력(캐시 미적중 부분) | 일반 입력 단가 적용 | 일반 입력 단가 적용 |
| 캐시 입력(캐시 적중 부분) | 캐시 입력 단가 적용, 가격 페이지에 별도 표기 | 캐시 입력 단가 적용, 가격 페이지에 별도 표기 |
| 출력 | 별도 과금 | 별도 과금 |
| 캐시 생성에 사용하는 입력 | 캐시 토큰 사용료에 포함 | 표준 입력 가격으로 과금 |
| 암시적 캐시 저장 비용 | 없음 | 없음 |
| 명시적 캐시 저장 비용 | 저장 시간에 따라 과금 | 저장 비용 발생 |
Developer API 문서에는 캐시 토큰 사용료, 저장 시간, 캐시되지 않은 입력, 출력이 과금 요소로 명시되어 있어요. Vertex는 여기에 두 가지를 더 분명히 안내해요. 캐시 생성에 사용된 입력은 표준 입력 가격으로 과금되고, 암시적 캐시는 저장 비용이 없지만 명시적 캐시는 저장 비용이 발생해요. 구체적인 단가는 모델과 버전에 따라 달라지므로, 두 서비스의 최신 공식 가격 페이지를 확인하세요.
입력 비용 계산 공식
일반 텍스트 생성 요청의 입력 비용은 다음과 같이 계산할 수 있어요.
输入费用 =
(总输入 tokens − 缓存命中 tokens)× 普通输入单价
+ 缓存命中 tokens × 缓存输入单价
출력 비용은 별도로 계산하고, 명시적 캐시를 사용하면 저장 비용도 추가해야 해요. 예를 들어 어떤 요청의 총 입력이 10,000 tokens이고 그중 캐시 적중이 8,000 tokens라면, 일반 가격으로 과금되는 양은 2,000 tokens이고 캐시 가격으로 과금되는 양은 8,000 tokens예요.
가장 자주 틀리는 부분: 총 입력에 캐시 입력이 포함돼요
비용을 대조할 때는 중계 서비스 대시보드의 ‘캐시 적중률’만 보지 말고 Google의 원본 응답을 확인해야 해요. generateContent 응답의 usageMetadata에서 확인할 수 있는 주요 필드는 두 가지예요.
| 필드 | 의미 | 비용 대조 시 유의 사항 |
|---|---|---|
usageMetadata.promptTokenCount |
총 입력 tokens | 캐시 입력을 포함해요 |
usageMetadata.cachedContentTokenCount |
캐시 입력 tokens | 캐시 적중 수량이에요 |
따라서 promptTokenCount 전체를 일반 가격으로 계산한 뒤 캐시 입력 비용을 추가하면 중복 과금이 돼요. 먼저 총 입력에서 캐시 입력을 빼서 일반 가격이 적용되는 양을 구해야 해요. 새로운 Interactions API를 사용한다면, 공식 캐시 통계 필드는 usage.total_cached_tokens예요.
반드시 구분해야 할 두 가지
또한 Google 상류 서비스에서 실제로 캐시가 얼마나 적중했는지와 중계 서비스가 해당 할인분을 청구서에 어떻게 반영하는지는 구분해야 해요. 전자는 공식 필드로 확인할 수 있지만, 후자는 중계 서비스 자체의 과금 규칙에 달려 있어요. Google 공식 문서만으로는 중계 서비스의 과금 방식을 확인할 수 없죠. 따라서 비용을 대조할 때는 상류 서비스가 반환한 캐시 필드와 청구서의 과금 기준을 함께 확인하는 것이 좋아요.
💡 선택 팁: 비용을 대조할 때는 먼저 요청별 캐시 토큰 필드를 확인한 다음, 청구서 합계를 살펴보세요. OpenAI, Claude, Gemini를 같은 기준으로 비교하고 싶다면 APIYI apiyi.com에서 동일한 프롬프트로 각각 호출해 모델을 빠르게 전환할 수 있어요.
Gemini와 Claude, OpenAI의 캐시 과금 차이
세 서비스는 캐시를 활용하는 방식이 다르기 때문에 비용 대조 기준도 달라요. 아래 표는 ‘어떻게 작동하고 어떻게 과금되는지’를 비교한 것으로, 할인율과 유효 시간은 모델 버전에 따라 달라질 수 있어요. 표의 내용은 작성 시점의 대략적인 기준이며, 구체적인 수치는 각 서비스의 공식 가격 페이지를 확인하세요.
| 비교 항목 | Gemini | Claude | OpenAI |
|---|---|---|---|
| 작동 방식 | 암시적 자동 캐시 + 명시적 캐시 객체, 두 가지 방식 | 명시적 방식: 요청에서 cache_control로 캐시 중단점을 지정 |
자동 적용, 코드 변경 불필요 |
| 캐시 쓰기 비용 | 암시적 캐시는 없음. 명시적 캐시는 생성 시 입력 비용이 발생하고 별도의 저장 비용도 부과 | 발생. 쓰기 단가가 일반 입력보다 높음(5분 및 1시간 유효 기간별 단가 상이) | 별도의 쓰기 비용 없음 |
| 캐시 읽기(적중) 가격 | 일반 입력보다 낮으며 할인율은 모델에 따라 다름 | 일반 입력의 약 1/10 | 일반 입력보다 낮으며 할인율은 모델에 따라 다름 |
| 저장 비용 | 명시적 캐시에만 발생하며 저장 시간에 따라 과금 | 없음. 쓰기 시 선택한 유효 기간에 따라 과금 | 없음 |
| 최소 기준 | 모델과 채널에 따라 다름. Vertex는 Developer API보다 높을 수 있음 | 모델에 따라 다르며, 일반적으로 1,024 이상 | 보통 1,024 tokens부터 |
| 적중 보장 | 암시적 캐시는 보장되지 않으며, 명시적 캐시는 비교적 예측 가능 | 중단점을 표시하면 유효 기간 동안 대체로 안정적으로 적중 | 자동 접두사 매칭이며 보장되지 않음 |
| 사용량 필드 | cachedContentTokenCount (promptTokenCount에 포함) |
cache_creation_input_tokens, cache_read_input_tokens. 일반 입력 tokens와 별도로 표시 |
prompt_tokens_details.cached_tokens (prompt_tokens에 포함) |
이 표에서 특히 혼동하기 쉬운 점은 세 가지예요.
- 쓰기 비용: Claude는 캐시를 쓸 때 비용이 더 들고, 캐시를 읽을 때 비용이 줄어요. 따라서 ‘많이 쓰고 적게 읽으면’ 캐시를 사용하지 않을 때보다 비용이 더 커질 수 있어요. OpenAI는 쓰기 비용이 없어서 캐시가 적중하지 않아도 추가 비용이 들지 않아요. Gemini의 암시적 캐시도 쓰기 비용은 없지만, 명시적 캐시는 생성 및 저장 비용이 발생해요.
- 캐시를 결정하는 주체: Claude는 요청한 쪽에서 중단점을 직접 지정하므로 적중 여부를 가장 예측하기 쉬워요. OpenAI와 Gemini의 암시적 캐시는 플랫폼이 자동으로 판단하기 때문에, 개발자는 접두사를 일관되게 유지해 적중 가능성을 높일 수 있을 뿐이에요. Claude와 OpenAI의 캐시가 Gemini보다 안정적으로 적중한다고 느끼는 이유 중 하나도 여기에 있어요. Gemini는 최소 기준, 접두사, 채널 분리의 영향을 모두 받아요.
- 총 입력 기준: Gemini와 OpenAI는 총 입력에 캐시 입력이 포함되므로, 캐시 입력을 먼저 빼고 비용을 계산해야 해요. 반면 Claude의
input_tokens에는 캐시 읽기 및 쓰기 부분이 포함되지 않으므로, 세 항목을 각각 계산한 뒤 더해야 해요. 한 서비스의 계산식을 다른 서비스에 적용하면 비용을 잘못 계산하게 돼요. APIYI apiyi.com을 통해 여러 모델의 비용을 비교할 때는 각 서비스에서 반환하는 필드의 기준을 먼저 확인하세요.
Gemini 캐시 적중률 빠르게 확인하기: 직접 테스트해 보기
이론을 살펴봤다면 직접 검증해 보는 게 가장 확실해요. 기본 방법은 최소 기준을 넘는 고정된 긴 접두부를 만들고, 달라지는 질문은 맨 뒤에 넣은 다음 연속으로 요청해 캐시 토큰 필드가 어떻게 바뀌는지 확인하는 거예요.
최소 예제
아래 코드는 OpenAI 호환 형식으로 호출하고 반환된 사용량 정보를 출력해요. 필드명은 실제 반환값을 기준으로 확인하세요. 캐시 관련 필드는 연동 방식에 따라 이름이 다를 수 있어요.
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

# 固定的长前缀:务必超过目标模型的最低缓存门槛
LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800

for i in range(3):
    resp = client.chat.completions.create(
        model="gemini-3.8-flash",
        messages=[
            {"role": "system", "content": LONG_PREFIX},
            {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
        ],
    )
    print(i, resp.usage)
    time.sleep(2)
전체 테스트 및 비용 확인 코드 보기
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800


def extract_cached_tokens(usage) -> int:
    """尝试从 usage 中读取缓存 token 数,字段名以实际返回为准"""
    details = getattr(usage, "prompt_tokens_details", None)
    if details is not None:
        cached = getattr(details, "cached_tokens", None)
        if cached is not None:
            return cached
    return 0


def estimate_input_cost(total_in: int, cached: int,
                        normal_price: float, cached_price: float) -> float:
    """
    按官方口径估算输入费用:
    总输入已包含缓存部分,所以普通部分 = 总输入 - 缓存部分
    单价请填入官方定价页当前数值(每百万 token)
    """
    normal_part = total_in - cached
    return (normal_part * normal_price + cached * cached_price) / 1_000_000


def run_test(model: str, rounds: int = 3):
    results = []
    for i in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": LONG_PREFIX},
                {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
            ],
        )
        usage = resp.usage
        cached = extract_cached_tokens(usage)
        results.append((i, usage.prompt_tokens, cached))
        print(f"第 {i} 次:总输入={usage.prompt_tokens},缓存命中={cached}")
        time.sleep(2)
    return results


if __name__ == "__main__":
    for m in ["gemini-3.8-flash"]:
        print("模型:", m)
        run_test(m)
🚀 빠르게 시작하기: APIYI apiyi.com을 이용해 비교 테스트를 구성해 보세요. 같은 스크립트에서
model매개변수만 바꾸면 Gemini, OpenAI, Claude 계열 모델을 차례로 테스트하고 캐시 성능 차이를 직접 확인할 수 있어요.
테스트할 때 통제해야 하는 변수
테스트를 실행할 때는 아래 항목을 하나씩 확인해 보세요. 그래야 내 설정의 문제를 API 경로의 문제로 잘못 판단하지 않을 수 있어요.
| 확인 항목 | 방법 | 목적 |
|---|---|---|
| 접두부 길이 | 대상 모델의 현재 최소 기준보다 길게 설정 | 최소 기준 미달 문제 배제 |
| 접두부 안정성 | 맨 앞에 타임스탬프나 요청 ID를 넣지 않기 | 접두부가 달라지는 문제 방지 |
| 변경 내용의 위치 | 사용자 질문을 맨 뒤에 배치 | 공통 접두부를 최대한 길게 유지 |
| 요청 간격 | 짧은 시간 안에 연속으로 전송 | 공식 권장 조건 충족 |
| 비교 그룹 | 같은 프롬프트로 OpenAI 또는 Claude 테스트 | 모델 메커니즘과 API 경로 문제 구분 |
테스트 결과 해석하기
접두부가 충분히 길고 구조가 안정적이며 요청 간격도 짧은데 Gemini에서 캐시 적중이 거의 없고, 같은 프롬프트가 OpenAI나 Claude에서는 정상적으로 적중한다면 차이는 Gemini 자체의 캐시 메커니즘과 상위 API 경로 조건에서 비롯됐을 가능성이 커요. 이 경우 명시적 캐시를 사용해 재사용할 긴 콘텐츠를 고정하고, 캐시 객체를 직접 만든 뒤 요청에서 참조하는 방법을 고려해 볼 수 있어요.
원래 짧은 대화가 중심인 서비스라면 적중률을 높이는 데 집중하기보다, 이런 상황에서 Gemini의 캐시 효과가 제한적이라는 점을 받아들이는 편이 나을 수 있어요. 비용 최적화는 모델 선택과 출력 길이 제어에 집중해 보세요.
자주 묻는 질문
Q1: Gemini의 캐시 적중률이 OpenAI와 Claude보다 눈에 띄게 낮은 이유는 무엇인가요?
Gemini의 암시적 캐시는 모델 지원 여부, 최소 토큰 기준 충족, 접두부의 안정성, 요청 간격 등 여러 조건을 함께 만족해야 해요. Vertex에서는 프로젝트별 격리 조건도 적용되고, 공식 문서에서도 캐시 적중을 보장하지 않는다고 명시하고 있어요. 조건 중 하나라도 충족하지 않으면 별도 안내 없이 일반 입력 요금이 적용돼요. 특정 API 경로에서 문제가 발생한 원인은 상위 요청 기록을 함께 확인해야 해요.
Q2: Google은 API 중계 서비스를 사용하면 캐시 적중률이 낮아진다고 공식적으로 밝힌 적이 있나요?
아니요. 공식 문서에서는 재사용 가능한 접두부, 최소 토큰 기준, 적용 범위 등 캐시 조건만 안내하고 있어요. API 경로에서 이러한 조건이 달라지면 적중률이 낮아질 수 있어요. 모델별 캐시 성능을 비교하려면 APIYI apiyi.com에서 같은 프롬프트로 통제된 테스트를 진행해 보세요.
Q3: 캐시 적중된 부분은 무료인가요?
아니요. 캐시 적중 부분에는 캐시 입력 단가가 적용돼요. 일반 입력보다 저렴하지만 무료는 아니에요. 각 서비스의 가격 페이지에서 일반 입력과 캐시 입력 가격을 따로 확인할 수 있고, 명시적 캐시에는 별도의 저장 비용도 발생해요.
Q4: 청구서의 입력 토큰에 캐시 토큰을 따로 더해야 하나요?
아니요. `promptTokenCount`는 캐시된 부분을 포함한 전체 입력 토큰 수예요. 전체 입력에서 `cachedContentTokenCount`를 빼면 일반 입력 단가가 적용되는 토큰 수를 구할 수 있고, 캐시 부분은 별도로 계산하면 돼요.
Q5: AI Studio와 Vertex의 캐시 기준은 같나요?
완전히 같지는 않아요. 현재 문서 기준으로 Gemini 3.1 Pro Preview와 Gemini 3.8 Flash의 최소 기준은 Developer API에서 4,096, Vertex에서 6,144예요. 이전 세대 모델인 Gemini 2.5 Pro는 두 서비스 모두 2,048이에요. 기준은 모델 버전에 따라 바뀔 수 있으니 공식 문서의 최신 수치를 확인하세요.
Q6: API 키를 바꾸면 캐시가 사라지나요?
프로젝트를 바꾸는지에 따라 달라요. Vertex 캐시는 Google Cloud 프로젝트별로 격리되므로 서로 다른 프로젝트 간에는 공유되지 않아요. 따라서 다른 프로젝트의 키로 바꾸면 캐시를 사용할 수 없어요. 같은 프로젝트 안에서 키만 바꾼 경우에는 캐시가 사라진다고 단정할 수 없어요.
Q7: 암시적 캐시와 명시적 캐시 중 어떤 것을 사용해야 하나요?
긴 문서나 긴 시스템 지침처럼 고정된 콘텐츠를 반복해서 참조해야 한다면 명시적 캐시가 더 확실하지만, 개발 비용과 저장 비용이 들어요. 가끔 재사용하는 정도라면 비용이 들지 않는 암시적 캐시를 쓸 수 있지만, 효과를 예측하기는 어려워요. 먼저 APIYI apiyi.com에서 소규모 비교 테스트를 진행한 뒤 명시적 캐시 개발 여부를 결정해 보세요.
Q8: API 중계 서비스 대시보드에 표시된 적중률을 정산 기준으로 사용해도 되나요?
권장하지 않아요. 공식 응답의 원본 캐시 필드를 기준으로 확인하세요. 또한 Google 상위 API에서 실제로 캐시가 적중했는지와 API 중계 서비스가 이를 요금에 어떻게 반영하는지는 별개의 문제예요. 후자는 해당 서비스의 과금 규칙을 확인해야 해요.
캐시 적중률 핵심 요약
- 관찰된 현상은 사실이에요: OpenAI와 Claude 계열은 캐시 적중률이 안정적이지만, Gemini는 적중률이 낮거나 거의 적중하지 않는 경우도 있어 별도로 분석해야 해요.
- 공식적으로 적중을 보장하지 않아요: Gemini의 암시적 캐시는 비용 절감을 보장하지 않아요. 명시적 캐시를 사용하려면 직접 캐시 객체를 만들고 참조해야 해요.
- 최소 기준은 모델마다 달라요: 최신 세대 모델일수록 기준이 더 높고, Vertex와 Developer API의 기준값도 다를 수 있어요.
- 접두부가 적중 여부를 좌우해요: 긴 내용을 앞에 배치하고, 시작 부분에 시간이나 ID처럼 계속 바뀌는 내용을 넣지 마세요. 공통 접두부가 달라지면 캐시 적중이 깨질 수 있어요.
- Vertex 캐시는 프로젝트별로 격리돼요: 캐시는 프로젝트 간에 공유되지 않아요. 요청이 여러 프로젝트로 분산되면 캐시를 사용할 수 없어요.
- 전체 입력 토큰에 캐시 토큰이 포함돼요:
promptTokenCount에는 캐시된 부분도 포함돼요. 비용을 대조할 때는 먼저 캐시된 부분을 제외한 뒤 각각 요금을 계산해야 해요. - 응답 필드로 비용을 대조하세요: 공식 응답의 캐시 관련 필드를 기준으로 확인하고, APIYI apiyi.com을 통해 같은 프롬프트로 여러 모델을 비교해 보세요.
요약
Gemini의 캐시 적중률이 낮은 데에는 여러 조건이 함께 작용해요. 암시적 캐시는 적중을 보장하지 않고, 모델에 따라 최소 토큰 기준이 높아지며, 접두부가 안정적으로 유지돼야 해요. Vertex 캐시는 프로젝트별로 격리되고, 명시적 캐시는 직접 만들어야 해요. 특히 요청 흐름에서 후자의 조건이 바뀌면 적중률이 낮아질 수 있지만, 구체적인 원인은 상위 프로젝트 설정과 요청 기록을 함께 확인해야 해요.
과금과 관련해서는 세 가지를 기억하세요. 캐시 적중이 무료를 뜻하지는 않아요. 전체 입력에 캐시된 부분이 포함되므로 중복 과금하면 안 돼요. 명시적 캐시에는 별도의 저장 비용이 있지만, 암시적 캐시에는 없어요. 비용 대조는 공식 응답 필드를 기준으로 하고, API 중계 서비스의 과금 기준도 따로 확인하세요.
다음 단계로는 이 글의 테스트 스크립트를 사용해 긴 접두부를 고정한 상태에서 Gemini와 OpenAI, Claude를 비교 테스트해 보세요. 그 결과를 바탕으로 명시적 캐시 도입 여부를 결정하면 돼요. APIYI apiyi.com을 이용하면 여러 모델에서 같은 인터페이스로 효과를 빠르게 검증할 수 있어 비교 비용도 낮아요.
참고 자료
- Gemini API 캐싱 문서: 암시적 캐싱과 명시적 캐싱에 관한 공식 안내
- 링크:
ai.google.dev/gemini-api/docs/caching -
설명: 최소 토큰 기준과 과금 요소를 확인할 수 있어요.
-
Gemini API 가격 페이지: 일반 입력, 캐시 입력, 출력 및 저장 가격
- 링크:
ai.google.dev/gemini-api/docs/pricing -
설명: 최신 단가를 확인할 때 참고하세요.
-
Vertex AI 컨텍스트 캐싱 개요: 캐시의 프로젝트 격리 및 과금 규칙
- 링크:
docs.cloud.google.com/vertex-ai/generative-ai/docs/context-cache/context-cache-overview -
설명: Vertex 캐시는 프로젝트 간에 공유되지 않는다는 점을 설명해요.
-
Gemini API generateContent 레퍼런스: 응답의 usageMetadata 필드
- 링크:
ai.google.dev/api/generate-content - 설명: 과금을 대조할 때 사용하는 캐시 토큰 필드를 확인할 수 있어요.
작성자: APIYI Team
기술 토론: 댓글에서 Gemini 캐시 문제를 해결한 경험을 나눠 주세요. 더 많은 자료는 APIYI docs(apiyi.com) 문서 센터에서 확인할 수 있어요.