Nota do autor: partindo de testes públicos com três Agents pessoais, este artigo destrincha os problemas da camada de interface que estão por trás das deficiências de execução dos Agents e entrega uma checklist de correções para chamada de ferramentas, tolerância a falhas com retentativas, compatibilidade de formatos e controle de custos.
O 36Kr publicou, em 4 de novembro de 2026, a matéria《Agents pessoais sentam à mesa: quem mostrou fraqueza primeiro?》, colocando três Agents pessoais na mesma mesa para um teste prático. As conclusões desse tipo de comparativo costumam ser bem consistentes: o Agent não carece de “saber falar”, ele carece de “conseguir terminar”. A questão central deste artigo é que as deficiências de execução dos Agents vêm, em grande parte, da camada de interface, e não apenas do modelo em si.
Este não é mais um artigo de ranking sobre “qual Agent é mais inteligente”. Não vamos repetir as notas específicas do texto original: pegamos as falhas de execução mais comuns nesse tipo de teste, agrupamos em 5 categorias e mapeamos cada uma para pontos que dá para mudar no design da interface do Agent.
Valor central: ao terminar a leitura, você vai saber quais parâmetros de interface checar primeiro quando montar seu próprio Agent, como tratar falhas e como alternar com tranquilidade entre os formatos de interface da OpenAI e da Anthropic.
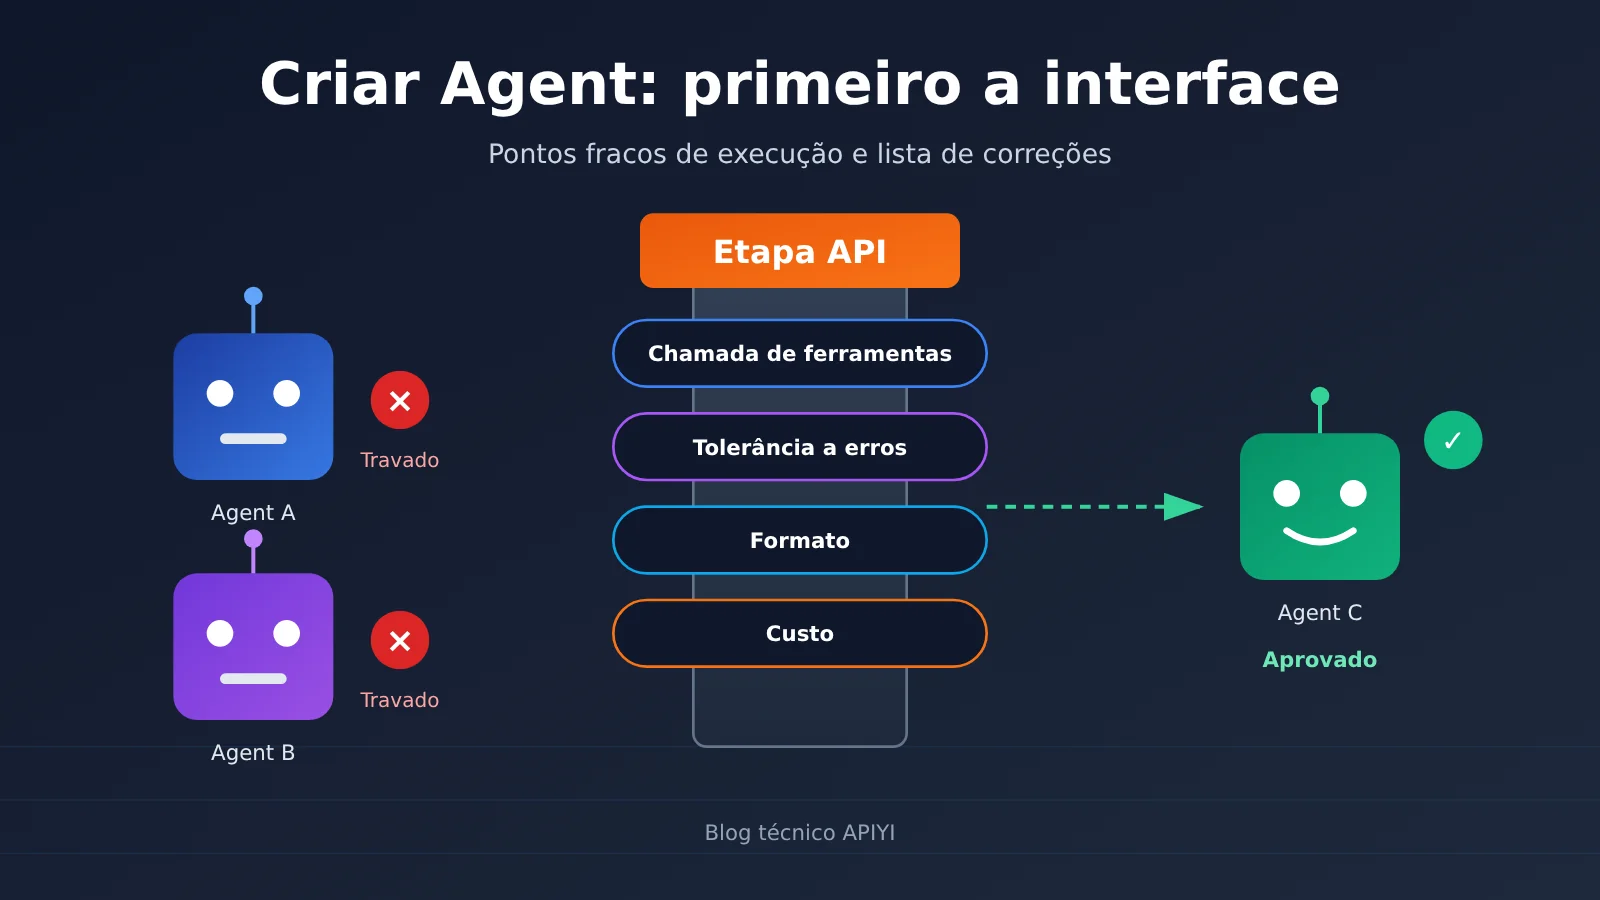
Pontos centrais das deficiências de execução na interface do Agent
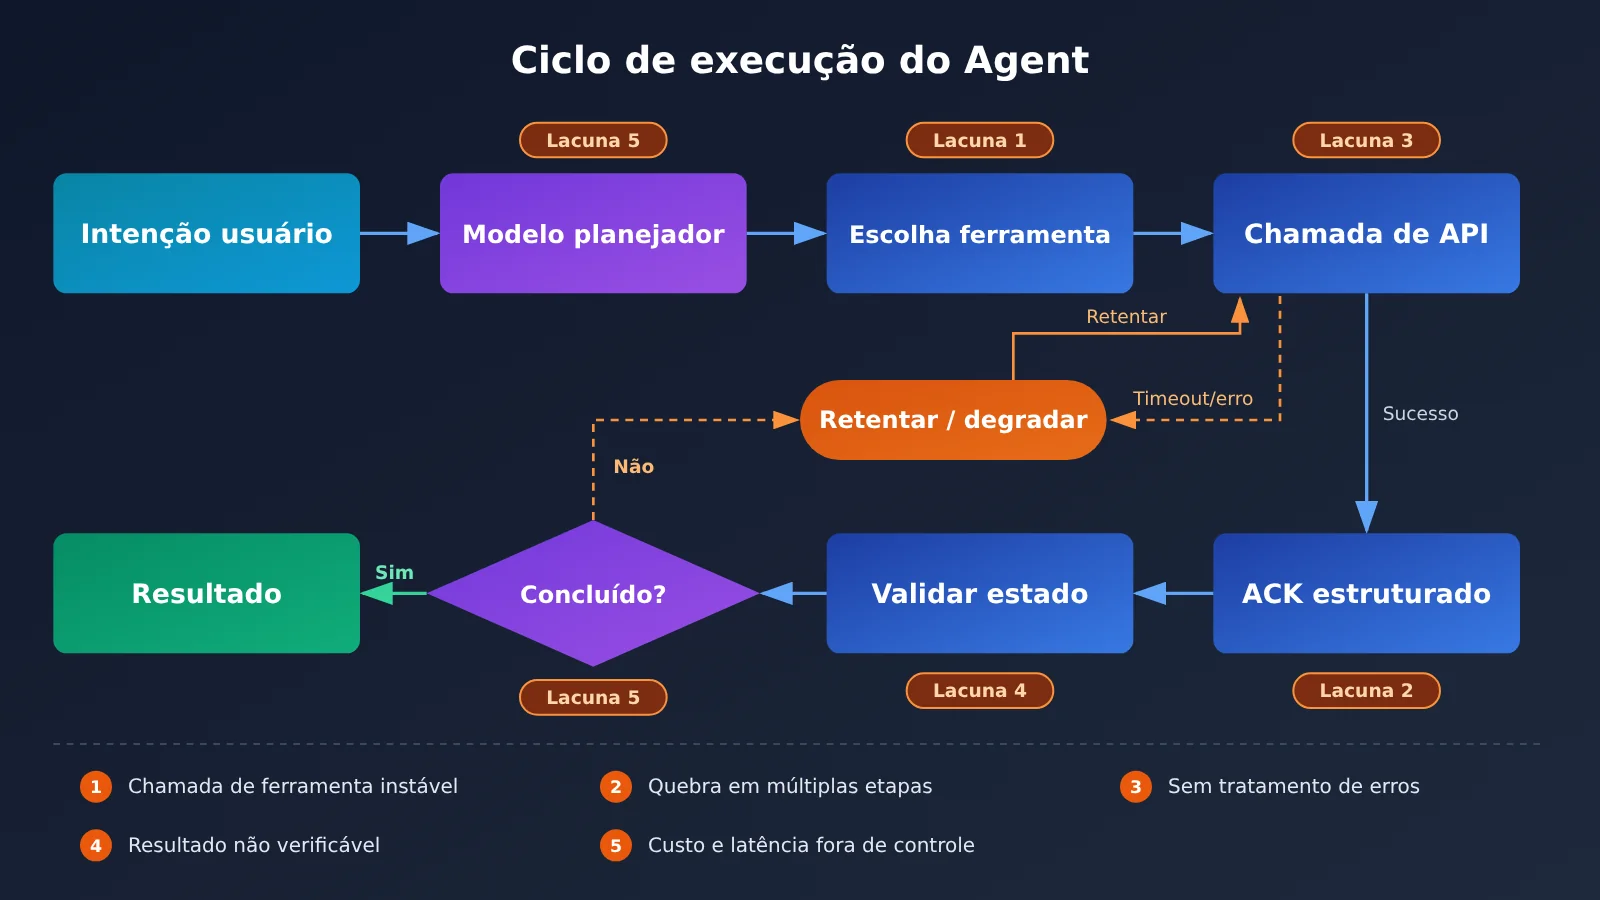
O objetivo de um Agent pessoal é concluir a tarefa inteira pelo usuário: reservar passagens, organizar e-mails, consolidar materiais, operar páginas web. Basta uma etapa falhar no meio do caminho para que a percepção do usuário seja “ele não terminou”. Se acompanharmos de baixo para cima os fenômenos de falha mais comuns nos testes reais, quase todos acabam recaindo sobre as 5 categorias de problemas de interface listadas abaixo.
| Deficiência de execução | Manifestação típica | Causa raiz na camada de interface | Direção de correção |
|---|---|---|---|
| Chamada de ferramentas instável | Escolhe a ferramenta errada, parâmetros com campos faltando, formato inválido | Descrição da ferramenta vaga, schema sem restrições | Enxugar o conjunto de ferramentas, escrever um schema de parâmetros rigoroso |
| Tarefa de várias etapas quebra a cadeia | Chega ao terceiro ou quarto passo e esquece o objetivo | Gestão de contexto frouxa, resultado da ferramenta não retorna corretamente | Normalizar o histórico de mensagens, comprimir resultados intermediários |
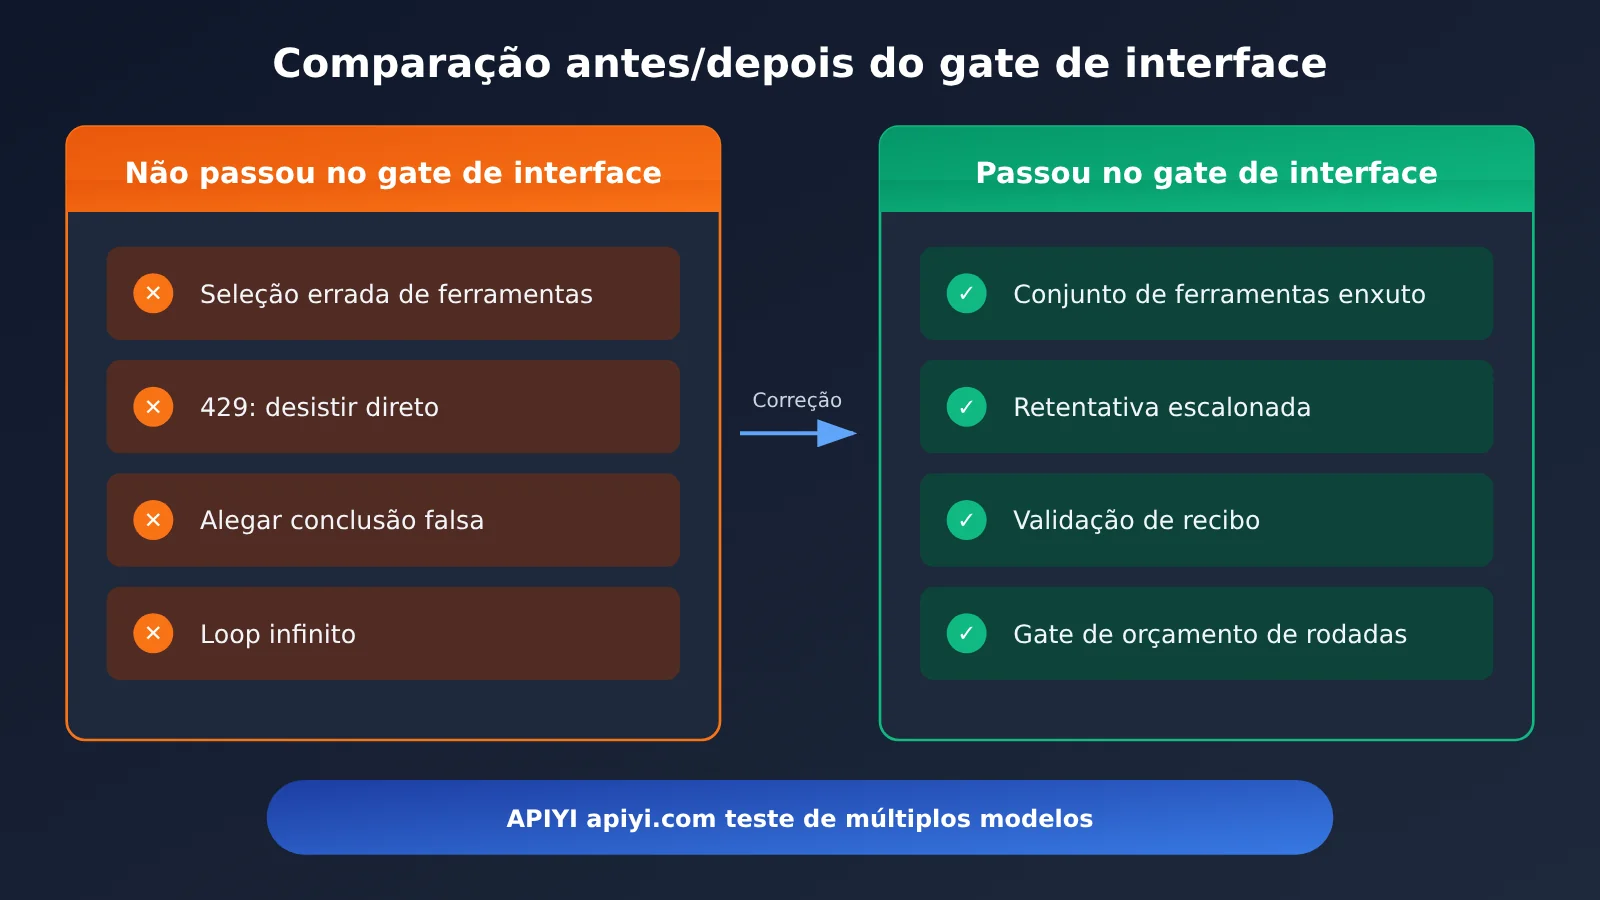
| Falha externa sem fallback | Encontra rate limit ou timeout e desiste na hora, ou mente dizendo que concluiu | Não distingue os tipos de erro, nem tem estratégia de retry | Retry escalonado por código de status, com timeout e degradação |
| Resultado não verificável | Responde “concluído”, mas na verdade não fez nada | Falta de recibo de execução e de validação de estado | Exigir recibo estruturado em cada etapa |
| Custo e latência fora de controle | Chamadas em loop, uma única tarefa consome muitos tokens | Sem limite de passos, sem uso de cache | Definir número máximo de rodadas, usar modelos em camadas, aproveitar o cache |
Detalhamento dos pontos principais das deficiências de interface do Agent
As duas primeiras categorias parecem um problema de capacidade do modelo, mas na verdade boa parte se resolve com engenharia. A causa mais comum da chamada de ferramentas instável é entregar dezenas de ferramentas ao modelo de uma só vez, com descrições que se sobrepõem — naturalmente ele vai errar na escolha. Reduzir o conjunto ao que a tarefa atual realmente precisa e escrever, para cada parâmetro, o tipo, os valores de enum e se é obrigatório costuma derrubar bastante a taxa de erro. Já a quebra de cadeia em várias etapas costuma estar no retorno do resultado da ferramenta: se o resultado não for vinculado ao ID da chamada correspondente conforme o protocolo, o modelo não consegue confirmar se a etapa anterior realmente deu certo.
As três últimas categorias são problemas puramente de engenharia. Um Agent que se preze precisa saber “o que fazer quando falha” e “como provar que terminou”. Nos testes reais, o que mais decepciona o usuário não é a falha em si, e sim fingir sucesso depois de falhar. Por isso, o mecanismo de recibo na camada de interface e a classificação de erros são mais úteis do que trocar por um modelo maior.
Início rápido da interface Agent: checklist de 5 etapas
Os passos abaixo não dependem de nenhum framework específico — funcionam tanto para quem escreve o loop do Agent na mão quanto para quem usa um framework pronto. Conforme as diretrizes deste artigo, não vamos colar código aqui: todas as configurações críticas ficam explicadas nas tabelas.
Etapa 1: unificar o ponto de entrada da interface Agent
Um Agent normalmente precisa da combinação “modelo forte para planejar, modelo rápido para executar”. Se cada modelo for integrado a um fornecedor diferente, autenticação, formato de erro e critério de cobrança ficam todos distintos, e o custo de diagnóstico sobe bastante. O caminho mais prático é usar um ponto de entrada unificado, compatível ao mesmo tempo com os formatos de interface da OpenAI e da Anthropic: basta alterar base_url, api_key e model para trocar de modelo.
| Item de configuração | Função | Valor sugerido |
|---|---|---|
base_url |
Endereço da interface | Conforme a documentação do provedor, por exemplo o endereço informado na documentação do APIYI em docs.apiyi.com |
api_key |
Credencial de autenticação | Mantenha em variável de ambiente; não escreva no comando nem nos logs |
model |
Nome do modelo | Configure planejamento e execução separadamente, para facilitar substituições pontuais |
timeout |
Timeout de uma requisição | Defina conforme o tipo de tarefa; em tarefas com saídas longas, relaxe um pouco |
max_retries |
Número de tentativas automáticas do SDK | Mantenha um valor pequeno; deixe as retentativas escalonadas para a camada de negócio |
🚀 Início rápido: o APIYI oferece chamadas de API dos principais Modelos de Linguagem Grande abordados neste artigo e é compatível com os dois formatos de interface, OpenAI e Anthropic — basta alterar o
base_urlno SDK que você já usa para integrar. Instruções de integração no centro de documentação do APIYI: docs.apiyi.com.
Etapa 2: definir com rigor os parâmetros de chamada de ferramentas do Agent
A chamada de ferramentas é a primeira barreira da capacidade de execução de um Agent. Quanto mais rigorosos forem os parâmetros, menor o espaço para o modelo “improvisar” e menor a taxa de erros.
| Parâmetro | Significado | Recomendação prática |
|---|---|---|
tools |
Lista de ferramentas que podem ser chamadas | Exponha em cada turno apenas as ferramentas necessárias para a etapa atual, e descreva com clareza “quando usar e quando não usar” |
tool_choice |
Estratégia de seleção de ferramentas | Especifique a ferramenta quando for preciso forçar uma ação; em perguntas abertas, deixe no automático |
| Schema de parâmetros | Estrutura de entrada da ferramenta | Coloque os campos obrigatórios em required; se puder usar enumeração, não use texto livre |
response_format |
Saída estruturada | Exija estrutura JSON no retorno final, para facilitar a validação pelo programa |
max_tokens |
Limite de saída | Obrigatório no formato Anthropic; estime conforme a tarefa |
temperature |
Aleatoriedade | Reduza nas etapas de execução, para diminuir a chance de ações diferentes para a mesma entrada |
Etapa 3: lidar com as diferenças entre os formatos OpenAI e Anthropic
Muitos Agents “ficam de repente mais burros” depois de trocar de modelo — e a causa não está no modelo, mas no fato de os protocolos de ferramentas dos dois formatos serem diferentes, o que faz o resultado voltar desalinhado. A tabela abaixo lista os pontos de divergência mais propensos a erro.
| Item comparado | Formato OpenAI Chat Completions | Formato Anthropic Messages |
|---|---|---|
| Posição do system prompt | Dentro de messages, com role system |
Uso do parâmetro de nível superior system |
| Definição de ferramenta | type: function mais o objeto function |
name, description, input_schema |
| Chamada iniciada pelo modelo | tool_calls na mensagem do assistente |
Bloco de conteúdo do tipo tool_use |
| Retorno do resultado da ferramenta | Mensagem com role tool, acompanhada de tool_call_id |
Bloco de conteúdo tool_result dentro de uma mensagem de user, correspondendo a tool_use_id |
| Limite de saída | max_tokens opcional |
max_tokens obrigatório |
Não há superioridade de um formato sobre o outro; o importante é manter dentro do Agent uma única representação intermediária e convertê-la para o formato correspondente no momento da requisição. Se você usa um ponto de entrada compatível com os dois formatos ao mesmo tempo, como a APIYI, pode fazer a série Claude usar o formato Anthropic nativo e os demais modelos usar o formato OpenAI, preservando em cada caso a capacidade mais completa de chamada de ferramentas.
Passo 4: Projetar fallback para falhas na interface do Agent
“Se falhar, desiste” e “se falhar, finge que deu certo” são os dois comportamentos que mais destroem a experiência do usuário nos testes reais. A abordagem correta é classificar por tipo de erro e só então decidir entre tentar de novo, degradar ou avisar o usuário com honestidade.
| Tipo de erro | Causa comum | Estratégia do Agent |
|---|---|---|
| 400 erro de parâmetro | Parâmetros de ferramenta inválidos, formato de mensagem desalinhado | Não tente de novo às cegas: devolva a mensagem de erro ao modelo para que ele corrija uma vez |
| 401 / 403 autenticação | Chave inválida ou permissão insuficiente | Encerre imediatamente e peça ao usuário para verificar a configuração |
| 429 rate limit | Concorrência alta demais ou cota esgotada | Retry com backoff exponencial e, se necessário, troque para um modelo reserva |
| 5xx erro no servidor | Oscilação do serviço upstream | Retry limitado; ao passar do limite, degrade |
| Timeout | Saída longa ou instabilidade de rede | Mude para saída em streaming ou quebre a tarefa em partes menores e tente de novo |
Tem um detalhe que costuma passar batido: ferramentas com efeitos colaterais precisam ser idempotentes. Operações como enviar e-mail, fazer pedido ou gravar no banco de dados exigem que, antes de tentar de novo, você confirme se a tentativa anterior já teve efeito — caso contrário, o Agent fará a mesma coisa duas vezes.
Passo 5: Adicionar recibos e limites de custo ao Agent
Toda execução de ferramenta deve retornar um recibo estruturado, contendo pelo menos três campos: “se deu certo, o que foi feito e o identificador do resultado principal”. Antes de o Agent declarar a tarefa concluída, quem deve conferir o recibo é o programa, não o modelo — assim você elimina estruturalmente o “fingir que terminou”.
No lado do custo, recomendo três travas: número máximo de rodadas do loop, orçamento de tokens por tarefa e detecção de chamadas repetidas. Tarefas de planejamento, execução e classificação podem ser distribuídas entre modelos de níveis diferentes; mantenha os system prompts longos e as definições de ferramentas o mais estáveis possível para aproveitar o cache de prompts. Sobre os preços unitários de entrada, saída e cache, bem como a regra de cobrança, consulte os dados reais da página de preços da APIYI em https://docs.apiyi.com/models — este artigo não traz nenhum número de preço não verificado.
💡 Dica: na fase de montagem, rode todo o ciclo fechado com pouco tráfego e só depois vá adicionando ferramentas. Com a APIYI apiyi.com você compara rapidamente, sob a mesma chave API, a estabilidade de diferentes modelos em chamadas de ferramentas — trocar é só alterar o campo
model.
Referência de seleção de camadas de interface para Agentes
Agentes com forte capacidade de execução raramente usam um único modelo. Dividir por responsabilidade em camadas aumenta a estabilidade e facilita o controle de custos.
| Camada de responsabilidade | Requisitos de capacidade | Critério de escolha | Plataformas disponíveis | Referência de preço |
|---|---|---|---|---|
| Camada de planejamento | Janela de contexto longa, raciocínio complexo, decomposição de tarefas | Escolha um modelo de topo com forte capacidade de raciocínio | APIYI apiyi.com, API oficial | Conforme a página de preços da APIYI |
| Camada de execução | Invocação de ferramentas estável, resposta rápida | Escolha um modelo intermediário com bom desempenho em invocação de ferramentas | APIYI apiyi.com, API oficial | Conforme a página de preços da APIYI |
| Camada leve | Classificação de intenção, validação de formato, compressão de resumos | Escolha um modelo pequeno, de baixa latência e baixo custo | APIYI apiyi.com, API oficial | Conforme a página de preços da APIYI |
Para saber quais modelos estão disponíveis e quais são os nomes mais recentes, consulte a documentação da APIYI em docs.apiyi.com. A recomendação é rodar um lote de amostras com suas próprias tarefas reais em cada modelo, medir a taxa de sucesso das invocações de ferramentas, o número médio de turnos e o consumo por tarefa, e só então decidir qual modelo usar em cada camada — não se guie apenas por rankings públicos.
Perguntas frequentes (FAQ)
Q1: O que é o “gargalo da interface” de um Agent?
Refere-se à camada de engenharia que um Agent precisa atravessar entre “pensar claramente” e “concluir a tarefa”, incluindo definição de ferramentas, protocolo de invocação, tratamento de erros, retorno de resultados e controle de custos. O modelo é responsável pela decisão; a camada de interface é responsável por colocar essa decisão em prática de forma confiável. Se esse gargalo não for resolvido, mesmo o modelo mais forte vai parecer ter pouca capacidade de execução.
Q2: A baixa capacidade de execução é problema do modelo ou da interface?
É dos dois, mas o problema da interface costuma ser subestimado. Escolher a ferramenta errada, errar o formato dos parâmetros, quebrar a cadeia de chamadas e alegar que concluiu depois de uma falha — boa parte disso pode ser mitigada ao endurecer o schema, padronizar o retorno de resultados e adicionar validação de recibo. A recomendação é primeiro deixar a camada de interface sólida e só então avaliar se realmente é preciso trocar de modelo.
Q3: O que o teste real de três agentes pessoais revela como tendência?
Essa reportagem de teste prático do 36Kr, de novembro de 2026, mostra que os agentes pessoais já entraram na fase de “quem consegue de fato terminar a tarefa”, e o foco da disputa saiu da qualidade da conversa para o ciclo fechado de execução. Para o desempenho específico de cada produto, consulte o texto original; aqui extraímos apenas as lições de engenharia que são universais.
Q4: Devo escolher o formato OpenAI ou o formato Anthropic?
Escolha de acordo com o modelo. A família Claude usa o formato nativo Anthropic e permite aproveitar integralmente recursos como invocação de ferramentas e cache; para a maioria dos outros modelos, o formato OpenAI é mais universal. A APIYI é compatível com os dois formatos, então você pode manter uma representação intermediária unificada dentro do Agent e converter conforme o modelo na hora da requisição.
Q5: Como conectar vários modelos ao meu Agent de forma rápida?
1. Registre-se na APIYI apiyi.com e obtenha a API Key;
2. Configure o `base_url` conforme a documentação em docs.apiyi.com;
3. Preencha o `model` separadamente na camada de planejamento e na camada de execução, e faça testes comparativos com o mesmo lote de tarefas.
Todo o processo não exige alterar o SDK, apenas ajustar itens de configuração.
Q6: Como estimar o custo de um Agent e onde consultar os preços?
Primeiro levante a média de turnos por tarefa, os tokens de entrada e os tokens de saída; depois multiplique pelo preço unitário do modelo correspondente. Os preços de entrada, saída e cache, bem como os critérios de cobrança, devem seguir os dados reais da página de preços da APIYI https://docs.apiyi.com/models. As diferenças entre modelos são grandes, então confira sempre com base na página real.
Q7: Com muitas ferramentas o Agent fica cada vez mais instável. O que fazer?
Exponha as ferramentas dinamicamente conforme a etapa da tarefa, oferecendo ao modelo apenas algumas ferramentas relevantes por rodada. Também é possível usar um modelo leve para fazer a classificação de roteamento e então entregar o subconjunto de ferramentas correspondente ao modelo executante. Descrever claramente os limites de aplicabilidade nos textos das ferramentas é mais eficaz do que empilhar mais exemplos.
Q8: Depois de fazer bem a camada de interface, quais limitações permanecem?
A camada de interface aumenta bastante a estabilidade, mas não resolve o teto de raciocínio do próprio modelo, nem mudanças em sites ou serviços de terceiros. Em tarefas de cadeia longa, ainda vale a pena manter pontos de confirmação humana, especialmente em operações irreversíveis como pagamentos, exclusões e envios externos.
Principais aprendizados sobre a execução de interfaces do Agent
- As deficiências de execução estão quase sempre na camada de interface: escolher a ferramenta errada, quebrar a cadeia, alegar conclusão — a maioria tem solução de engenharia
- Conjunto de ferramentas: menos é mais: exponha as ferramentas em fases, quanto mais rígido o schema de parâmetros, mais estável
- Diferenças de formato precisam ser isoladas: representação unificada interna, converta para o formato OpenAI ou Anthropic só na hora da requisição
- Erros precisam ser classificados: 400 corrige, 429 faz backoff, 5xx faz degradação; operações com efeitos colaterais precisam ser idempotentes
- A conclusão é determinada pelo programa: recibo estruturado mais validação de estado, para eliminar a “falsa conclusão”
- Estabeleça limites de custo: limite de rodadas, orçamento de tokens, uso de modelos em camadas; os preços seguem a página de preços da APIYI
- Caminho para começar: acesse vários modelos pelo ponto de entrada unificado da APIYI, basta alterar
base_urlemodelpara comparar
Resumo
O teste prático de três Agents pessoais dá um alerta aos desenvolvedores: o foco da competição entre Agents está migrando de “saber conversar” para “saber concluir”. Para completar a capacidade de execução, o investimento mais vantajoso é primeiro passar pela barreira da interface:
- Invocação de ferramentas: enxugar ferramentas, apertar o schema, padronizar o retorno dos resultados;
- Tolerância a falhas e proteção: classificação de erros, retry limitado, proteção de idempotência;
- Verificável e controlável: recibo estruturado, validação por programa, limites de custo.
Sugerimos primeiro rodar um ciclo completo com uma tarefa real e depois expandir as capacidades aos poucos. Recomendamos integrar via APIYI apiyi.com, que é compatível com os formatos de interface OpenAI e Anthropic, facilitando a comparação da estabilidade de execução entre diferentes modelos. A documentação está em docs.apiyi.com e os preços seguem https://docs.apiyi.com/models.
📚 Referências
- 36Kr: Agentes pessoais chegam à mesa — quem mostrou fraqueza primeiro?: Reportagem com testes práticos de três agentes pessoais
- Link:
36kr.com/p/4055385191224452 -
Descrição: Fonte do tema deste artigo; para detalhes sobre produtos específicos e desempenho nos testes, consulte o texto original
-
Central de Documentação APIYI: Instruções de configuração de integração e modelos disponíveis
- Link:
docs.apiyi.com -
Descrição: configuração de
base_url, formas de integração nos formatos OpenAI e Anthropic -
Página de Preços de Modelos APIYI: Preço unitário dos modelos e critérios de cobrança
- Link:
docs.apiyi.com/models - Descrição: Todo o conteúdo relacionado a preços neste artigo tem como base os dados reais desta página
Autor: Equipe técnica APIYI
Contato técnico: Fique à vontade para nos contatar no site oficial da APIYI, apiyi.com. Mais materiais de integração estão disponíveis na central de documentação docs.apiyi.com