Em 30 de setembro de 2026, Koray Kavukcuoglu, vice-presidente sênior e arquiteto-chefe de IA da Google DeepMind, anunciou o Gemini 4 Argon no blog oficial do Google. Este é o primeiro modelo da geração Gemini 4 e, atualmente, o modelo de fronteira mais poderoso do Google. O Argon foi desenvolvido para raciocínio profundo em cadeias longas e tem como foco três áreas: engenharia de software no mundo real, trabalho corporativo baseado em conhecimento — como nas áreas jurídica e financeira — e defesa em cibersegurança.
O lançamento rompe com algumas convenções. Primeiro, o modelo deixa de seguir a nomenclatura em categorias Pro, Flash e Flash-Lite e adota, pela primeira vez, o codinome “Argon”. Segundo, o limite de saída por solicitação salta de 64 mil para 1 milhão de tokens. Terceiro, o lançamento inicial não está disponível para todos os desenvolvedores: o acesso foi liberado primeiro a defensores confiáveis de cibersegurança participantes do programa Fairwind. Este artigo se baseia no anúncio original do Google, em informações públicas de veículos de imprensa em inglês e em avaliações de terceiros para analisar os principais recursos, os resultados em benchmarks, os preços e o cronograma de disponibilização do Gemini 4 Argon.
O que você vai encontrar: ao terminar a leitura, você poderá avaliar rapidamente o quanto o Gemini 4 Argon é relevante para o seu negócio, quando poderá usá-lo e quais preparativos de integração vale a pena fazer desde já.
Gemini 4 Argon: informações essenciais
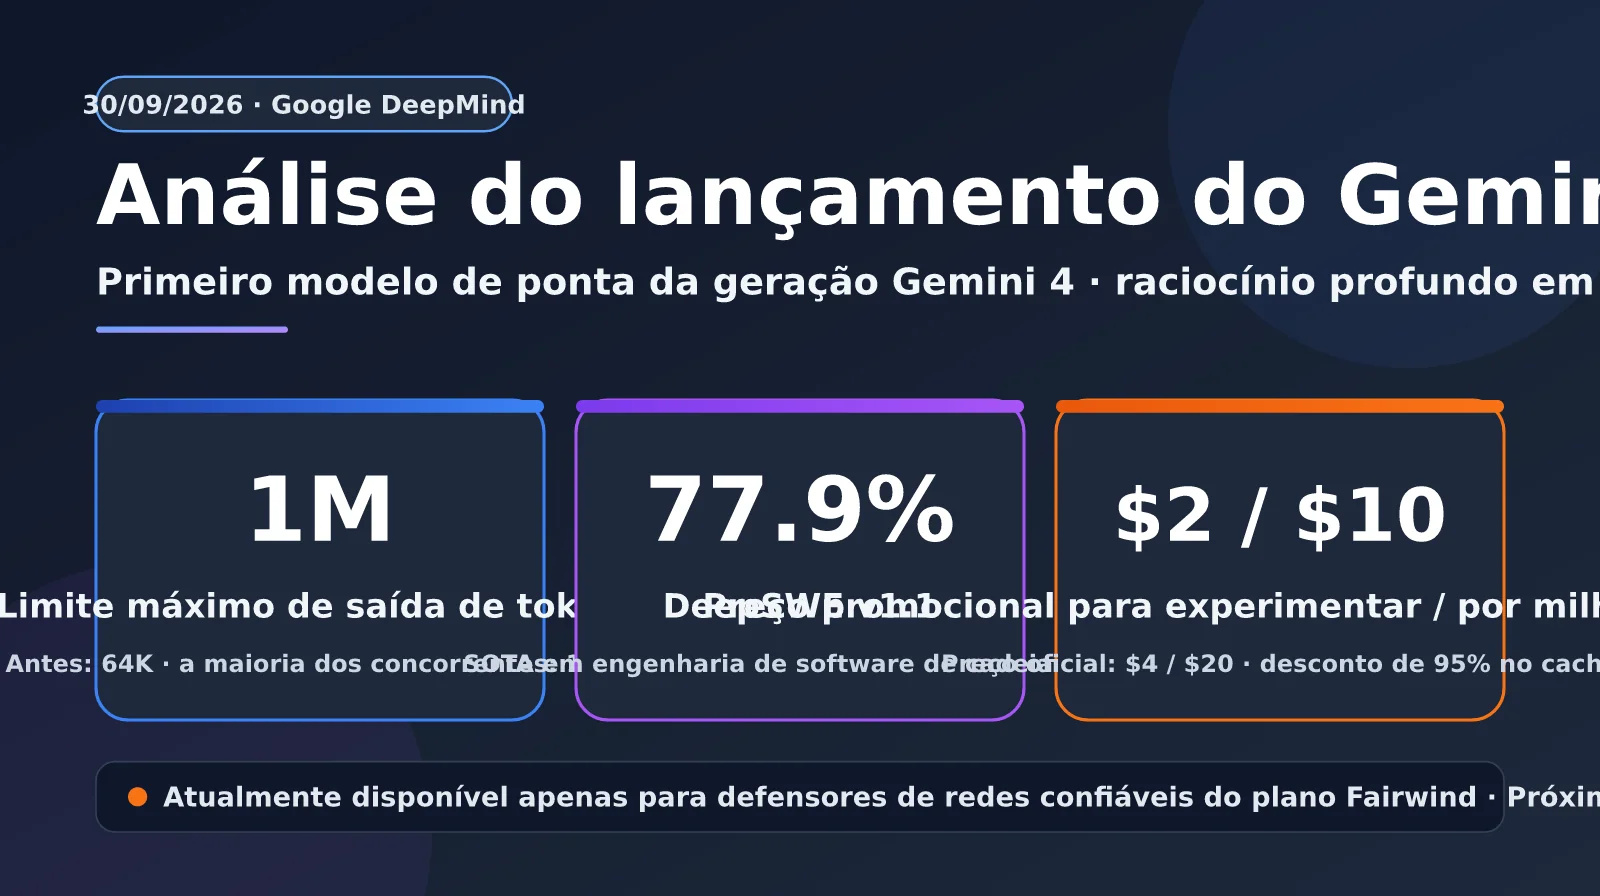
Para começar, reunimos em uma tabela os principais dados do anúncio do Google. Vale observar que o texto original informa claramente apenas o limite de saída de 1 milhão de tokens, sem especificar o tamanho da janela de contexto de entrada. Alguns veículos mencionam uma “janela de entrada de 1 milhão”, mas, até o momento, não encontramos confirmação em fontes oficiais do Google. O ideal é aguardar a documentação definitiva.
| Item | Informações oficiais sobre o Gemini 4 Argon | Observações |
|---|---|---|
| Data de lançamento | 30 de setembro de 2026 | Anúncio simultâneo no blog oficial do Google e na conta da DeepMind |
| Posicionamento do modelo | Primeiro modelo de fronteira da geração Gemini 4 | Adota um codinome pela primeira vez, sem as categorias Pro/Flash |
| Limite de saída | 1 milhão de tokens (antes, 64 mil) | Segundo o Google, é “líder do setor”; concorrentes geralmente oferecem até 128 mil tokens por solicitação |
| Contexto de entrada | Não divulgado oficialmente | Algumas reportagens mencionam 1 milhão, mas sem fonte oficial |
| Preço promocional | US$ 2 por milhão de tokens de entrada / US$ 10 por milhão de tokens de saída | Desconto de 95% para tokens de entrada em cache |
| Preço regular | US$ 4 por milhão de tokens de entrada / US$ 20 por milhão de tokens de saída | Duração do período promocional não divulgada |
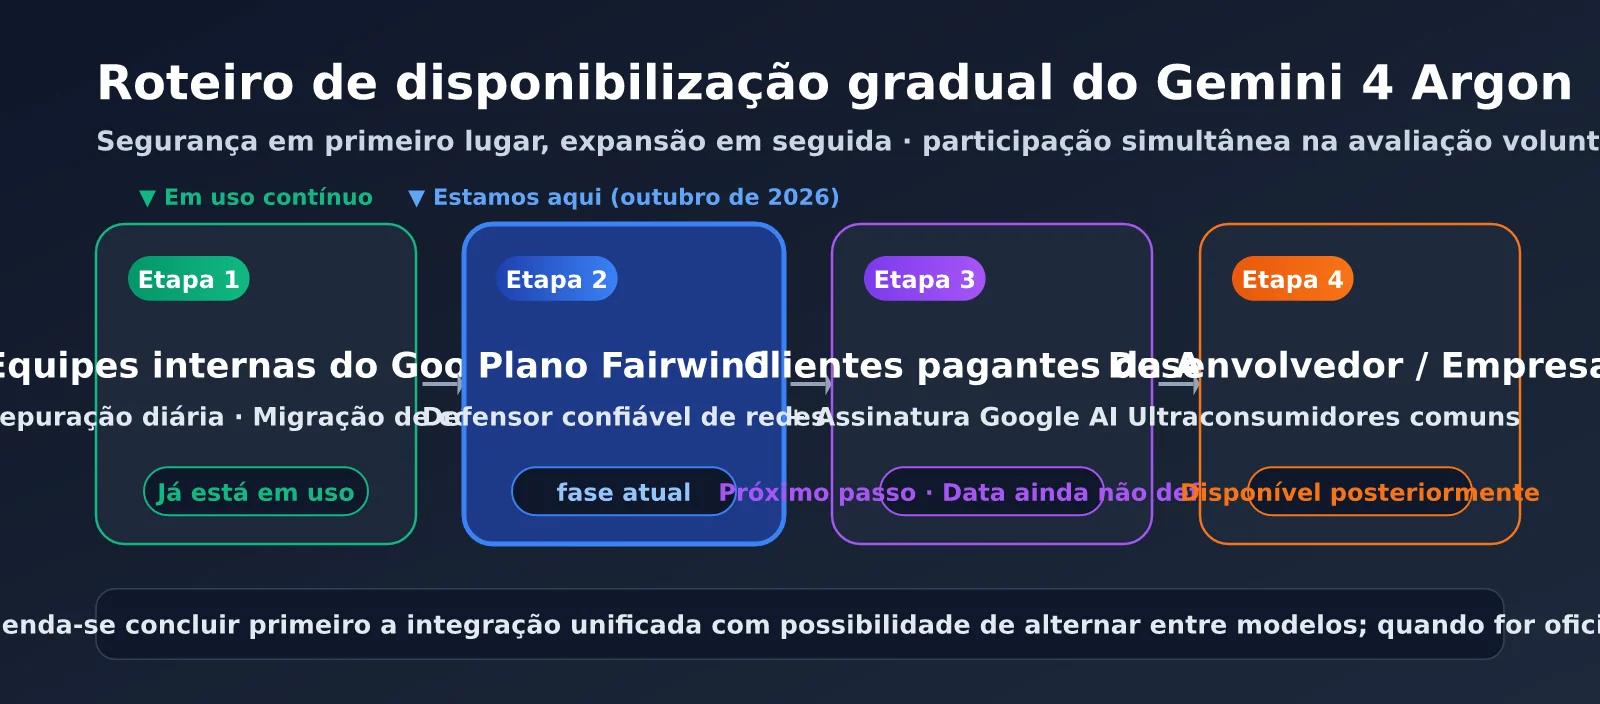
| Disponibilidade atual | Defensores confiáveis de redes do programa Fairwind + uso interno do Google | O próximo passo é liberar o acesso a clientes pagos da API e assinantes do AI Ultra |
| ID do modelo na API | Ainda não divulgado oficialmente | A comunidade encontrou uma possível referência no Vertex AI, ainda sem confirmação |
Três principais áreas de atuação do Gemini 4 Argon
No anúncio, o Google concentra os recursos do Argon em três áreas. Em engenharia de software, o Argon consegue manter o raciocínio ao longo de fluxos de trabalho complexos e com várias etapas. Engenheiros do Google já o utilizam no dia a dia para depuração e migrações de código em larga escala. No trabalho corporativo baseado em conhecimento, o modelo lidera benchmarks de agentes em áreas especializadas, como direito e finanças. Isso o torna adequado para tarefas que exigem a leitura de grandes volumes de documentos e a apresentação de conclusões estruturadas. A defesa em cibersegurança é o aspecto mais singular do Argon: ele foi treinado especificamente para detectar, validar e corrigir vulnerabilidades críticas em software de forma autônoma.
O Google também destacou os recursos multimodais do Argon, incluindo análise de gráficos em nível profissional, localização de detalhes em vídeos longos e execução de tarefas com base em vários documentos. A empresa mencionou ainda avanços na escrita criativa, indicando que o Argon não é apenas um modelo especializado em programação.
🎯 Recomendação de integração: o Gemini 4 Argon ainda está sendo disponibilizado por etapas. Se você quiser testá-lo no seu negócio assim que possível, recomendamos preparar a integração com a família de modelos Gemini na plataforma APIYI apiyi.com. A plataforma oferece uma interface unificada compatível com a OpenAI. Quando um novo modelo é lançado, normalmente basta alterar o parâmetro
modelpara começar a usá-lo.
Interpretação dos resultados de benchmark do Gemini 4 Argon
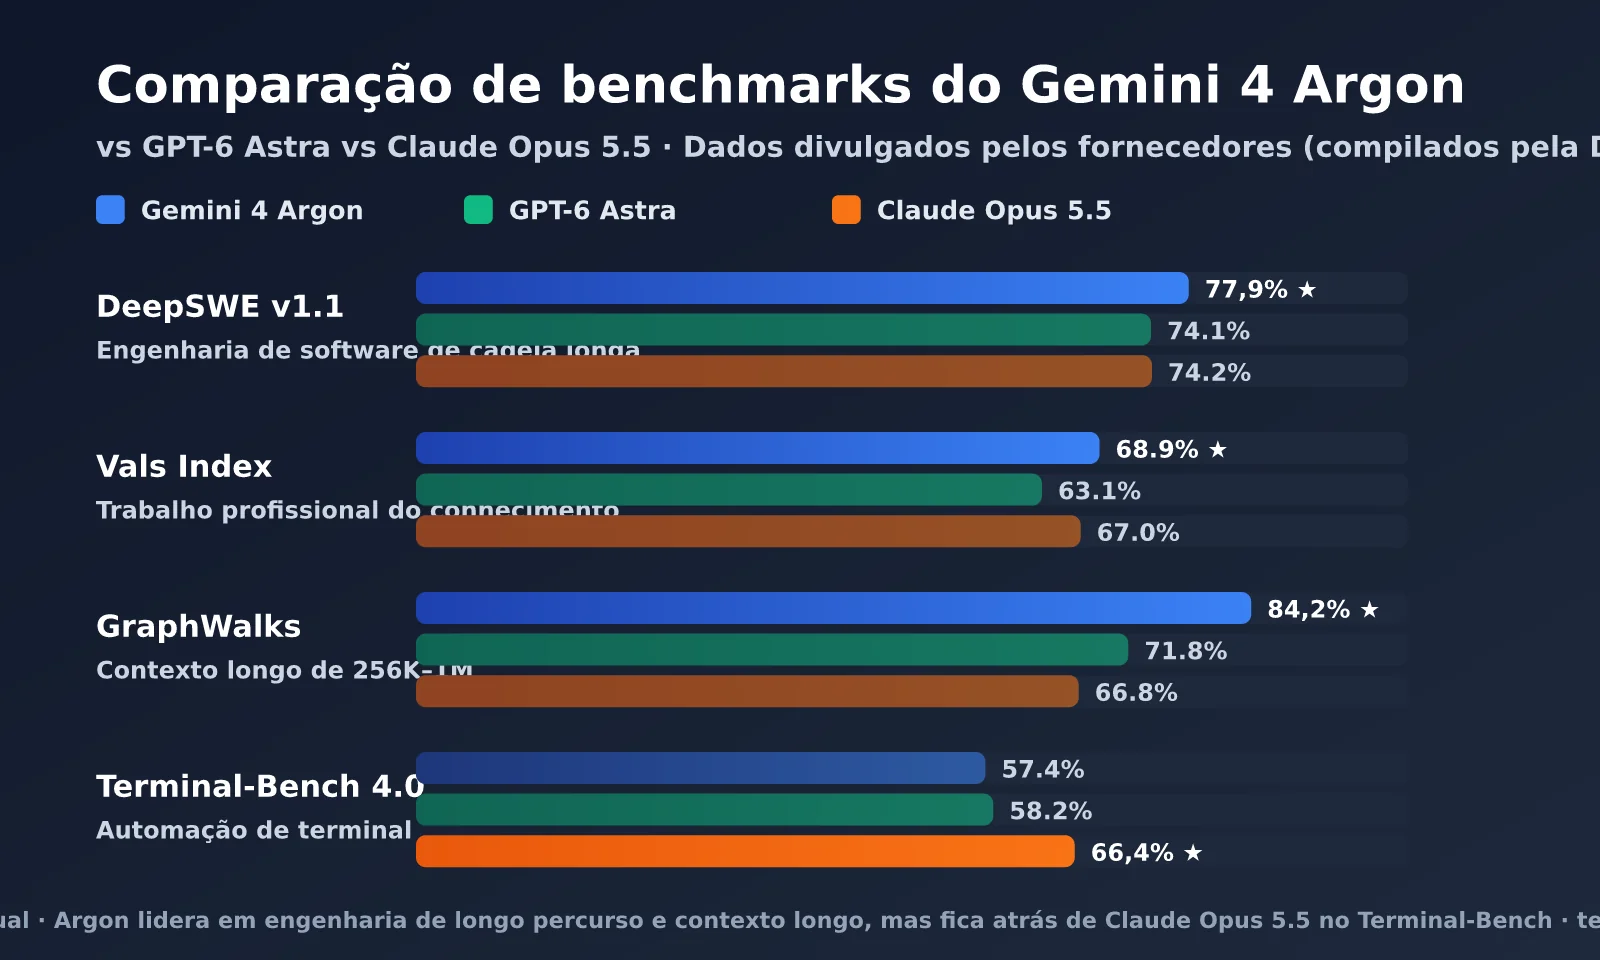
Em uma publicação no blog, o Google apresentou uma série de resultados de benchmark. Pouco depois, organizações independentes como Artificial Analysis e Vals também divulgaram suas avaliações. A tabela abaixo reúne os dados publicados pelo Google e compilados pela DataCamp, comparando o modelo com o OpenAI GPT-6 Astra e com o Claude Fable 5.1 e o Claude Opus 5.5, da Anthropic.
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| Harvey Legal Agent | 19.6% | 5.4% | 6.7% | 3.8% |
| GraphWalks (256K–1M) | 84.2% | 71.8% | 65.0% | 66.8% |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
Os dados mostram que os pontos fortes do Gemini 4 Argon estão concentrados em tarefas de engenharia de software com várias etapas (DeepSWE), agentes especializados em domínios específicos (Vals e Harvey) e raciocínio com contexto muito longo (GraphWalks). A vantagem no benchmark Harvey Legal Agent chama atenção: o Argon marca 19.6%, enquanto os demais modelos ficam na casa de um dígito. Isso indica uma diferença significativa em tarefas especializadas que envolvem vários documentos e etapas prolongadas.
Ainda assim, o Argon não lidera em tudo. Em testes mais voltados à operação de terminal e a tarefas avançadas de engenharia, como FrontierSWE v2 e Terminal-Bench 4.0, ele fica atrás do GPT-6 Astra e do Claude Opus 5.5, respectivamente. No CWE-bench v1, o Argon empata em primeiro lugar com o GPT-6 Astra. Segundo o Engadget, o Grok 4.7 também aparece empatado na liderança. Além disso, o Google divulgou resultados de 51.3% no Zapier AutomationBench (primeiro lugar) e de 91.7% no LVBench, de compreensão de vídeos longos (SOTA).
Avaliações independentes de terceiros do Gemini 4 Argon
Fora os dados divulgados pelo próprio fabricante, as avaliações independentes apresentam conclusões mais cautelosas. No Intelligence Index da Artificial Analysis, o Argon marcou 52.6, praticamente empatado com o GPT-6 Astra, com 52.7, e abaixo do Claude Opus 5.5, com 57.6. Vale lembrar que essa organização testou apenas a versão High do Argon. No Vals Index, o Argon ficou em primeiro lugar entre 41 modelos, com 68.9%. Ele também chegou ao topo da arena de texto do Arena.ai, com 1525 pontos.
| Dimensão da avaliação independente | Gemini 4 Argon | Comparação | Interpretação |
|---|---|---|---|
| Índice de inteligência da AA | 52.6 | GPT-6 Astra 52.7 / Opus 5.5 57.6 | Empatado com o Astra, sem abrir vantagem |
| Taxa de alucinação (AA) | 15% | GPT-6 Astra: cerca de 51%–54% | A menor entre os principais modelos; confiabilidade em destaque |
| Precisão factual | 50% | GPT-6 Astra 63% | Tende mais a não responder quando não sabe |
| Custo médio por tarefa (AA) | $1.99 | Astra $3.26 / Opus 5.5 $5.98 | Boa relação custo-benefício no preço de lançamento |
| Custo por avaliação no Vals | $15.68 | Opus 5.5 $32.14 | Cerca de metade do custo do Opus 5.5 |
Vale analisar em conjunto a taxa de alucinação e a precisão factual. O Argon tem uma taxa de alucinação de apenas 15%, mas sua precisão factual também é menor que a do Astra. Isso indica que, quando não tem certeza, ele tende a se recusar a responder em vez de inventar uma resposta. Para o trabalho com conhecimento em empresas, essa postura de “responder menos, mas não inventar” costuma ser preferível. A avaliação do The Decoder é equilibrada: o Google reduziu a diferença, mas ainda não assumiu uma liderança clara.
💡 Dica para escolher um modelo: os resultados de benchmark servem apenas como referência, já que o desempenho varia bastante de acordo com a tarefa. Recomendamos testar os modelos Gemini, GPT e Claude lado a lado com dados reais da sua operação pela plataforma APIYI apiyi.com. Uma interface unificada pode reduzir bastante o custo de comparar vários modelos.
O que significa o limite de saída de 1 milhão de tokens do Gemini 4 Argon
O limite de saída de 1 milhão de tokens é o número mais fácil de interpretar errado neste lançamento. Isso não significa que você possa fazer uma pergunta no app Gemini e receber uma resposta de um milhão de palavras. O limite foi pensado para fluxos de trabalho de agentes de longa duração. Quando o modelo precisa gerar grandes volumes de código em sequência, fazer várias chamadas a ferramentas e continuar apresentando resultados intermediários, o antigo limite de saída de 64 mil tokens pode virar um gargalo, obrigando os desenvolvedores a dividir a tarefa em várias partes.
Em uma publicação no blog, o Google apresentou três casos internos que mostram o valor prático dessa capacidade. Eles também são a forma mais direta de entender o posicionamento do Argon.
| Caso interno | Tarefa | Resultado divulgado |
|---|---|---|
| Otimização de algoritmos quânticos | Otimizar os recursos de tempo e espaço de sub-rotinas (número de qubits × número de portas) | Em poucos minutos, superou em 40% a referência publicada |
| Otimização da eficiência de memória | Um agente analisou os dados de telemetria de desempenho de toda a frota e aplicou otimizações | Mais de 300 TiB já liberados; a economia total prevista é de 500 TiB a 1 PiB |
| Migração de C/C++ para Rust | De re2 e libgav1 até o kernel Fuchsia Zircon (mais de 800 mil linhas) | O libgav1 substituiu 32 mil linhas de código SIMD; a decodificação ficou 2,7 vezes mais rápida que na versão portada originalmente para Rust, com resultados idênticos |
O caso da migração de C/C++ para Rust é o que melhor demonstra o valor do limite de saída de 1 milhão de tokens. Migrar um kernel com mais de 800 mil linhas exige que o modelo entenda o contexto, gere código e valide o próprio trabalho continuamente, tudo dentro de uma tarefa coerente. Quanto maior o limite de saída, menos vezes a tarefa precisa ser interrompida e dividida. Para equipes que estão refatorando grandes bases de código ou modernizando sistemas legados, isso é mais relevante do que a pontuação em um benchmark isolado.
Recursos de cibersegurança do Gemini 4 Argon
Cibersegurança é o atributo mais singular do Argon. Segundo o Google, o Argon consegue detectar, validar e corrigir vulnerabilidades críticas de software de forma autônoma. Em comparação com a geração anterior, o Gemini 3.8 Flash Cyber, o modelo apresentou um “avanço significativo” nos benchmarks internos de detecção de vulnerabilidades, que cobrem 20 linguagens de programação, e nos testes de penetração de caixa-preta da Wiz.
Um exemplo concreto vem da empresa de segurança Wiz. Por meio do programa Scan for Good, a Wiz usou o Argon para encontrar uma vulnerabilidade grave em um software médico usado por hospitais do mundo todo, que poderia expor informações pessoais sensíveis. Nenhum dos modelos de ponta anteriores havia detectado o problema. Isso também ajuda a explicar por que o Google escolheu disponibilizar o Argon primeiro aos participantes do programa Fairwind: a versão destinada a defensores confiáveis e às equipes internas do Google não tem proteções de cibersegurança, o que amplia seus limites de capacidade e exige um controle rigoroso sobre quem pode usá-la.
Análise de preços e cronograma de lançamento do Gemini 4 Argon
Em relação aos preços, o Argon adota uma estratégia em duas etapas: “preço promocional” e “preço oficial”. Durante o período promocional, o custo é de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída. Depois, volta para US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de tokens de saída. Os tokens de entrada em cache têm sempre 95% de desconto. Até o momento, o Google não informou quanto tempo durará o período promocional nem como será a cobrança dos tokens de raciocínio.
| Modelo | Entrada / milhão de tokens | Saída / milhão de tokens | Entrada em cache / milhão de tokens | Limite de saída por solicitação |
|---|---|---|---|---|
| Gemini 4 Argon (preço promocional) | US$ 2 | US$ 10 | US$ 0,10 | 1M |
| Gemini 4 Argon (preço oficial) | US$ 4 | US$ 20 | US$ 0,20 | 1M |
| GPT-6 Astra | US$ 10 | US$ 50 | Não divulgado | 128K |
| Claude Opus 5.5 | US$ 4 | US$ 20 | US$ 0,20 | 128K |
Observação: os dados do GPT-6 Astra e do Claude Opus 5.5 foram compilados por fontes terceirizadas, como Engadget e NeuralTrust. Consulte as páginas oficiais dos fabricantes para confirmar os valores.
A tabela mostra que o preço promocional do Argon equivale a um quinto do preço do GPT-6 Astra. Mesmo pelo preço oficial, custa apenas 40% do valor do Astra e fica no mesmo patamar do Claude Opus 5.5. Segundo estimativas da Artificial Analysis, com o desconto atual, o custo do Argon para realizar uma tarefa equivalente é cerca de 60% do custo do Astra. Vale observar, porém, que o Argon consumiu 110 milhões de tokens para concluir o índice da AA — acima da mediana de 82 milhões. Isso indica que seu processo de raciocínio tende a ser mais “verboso”, então o custo real deve ser avaliado considerando também o consumo de tokens.
Cronograma de lançamento do Gemini 4 Argon
O cronograma de lançamento é uma das principais dúvidas dos desenvolvedores. Segundo a publicação do Google, o Argon está sendo disponibilizado a participantes confiáveis de defesa cibernética do programa Fairwind e já é usado em larga escala internamente pela empresa. O próximo passo será liberar o acesso para clientes da API com planos pagos e assinantes do Google AI Ultra. Só depois o acesso será ampliado para outros desenvolvedores, empresas e consumidores. O Google também informou que está participando do processo voluntário de revisão de modelos antes do lançamento do governo dos Estados Unidos.
Até meados de outubro, o Google ainda não havia anunciado o ID oficial do modelo na API nem a data de disponibilidade pública. No dia do lançamento, a DataCamp verificou que o Argon ainda não aparecia no Vertex AI, Gemini CLI, OpenRouter, Cursor ou GitHub Copilot. Em 11 de outubro, pesquisadores da comunidade encontraram no Vertex AI uma entrada que talvez fosse do Argon. Isso indica que o Google está se preparando para ampliar o acesso, mas não significa que o modelo já esteja disponível para uso público.
🚀 Prepare-se com antecedência: antes do lançamento oficial do Argon, o caminho mais prático é adaptar o código da sua aplicação para permitir a troca de modelo. A plataforma APIYI (apiyi.com) já oferece acesso unificado a modelos populares como Gemini, GPT e Claude. Quando o Argon estiver disponível, você poderá testá-lo e migrar rapidamente, sem precisar reescrever a lógica da aplicação.
Preparação para integrar o Gemini 4 Argon e exemplos de código
Como o ID oficial do Argon ainda não foi divulgado, o exemplo abaixo usa uma configuração que permite alterar o nome do modelo. Por enquanto, você pode testar o fluxo com um modelo Gemini já disponível. Quando o Argon for lançado, basta substituir o nome do modelo na variável de ambiente.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

# Argon 官方模型 ID 公布前,先用已上线的 Gemini 模型验证流程
MODEL = os.getenv("GEMINI_MODEL", "your-current-gemini-model")

resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "审查这段 C 代码中的内存安全问题,并给出 Rust 改写方案"}],
)
print(resp.choices[0].message.content)
Ver o código completo: processamento em fluxo de tarefas com respostas longas e registro de custos
import os
import time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

MODEL = os.getenv("GEMINI_MODEL", "your-current-gemini-model")

# Argon 正式价参考(美元 / 百万 token),尝鲜期为一半
PRICE_INPUT = float(os.getenv("PRICE_INPUT", "4"))
PRICE_OUTPUT = float(os.getenv("PRICE_OUTPUT", "20"))


def run_long_task(prompt: str, max_tokens: int = 64000) -> str:
    """长输出任务使用流式返回,避免一次性等待超时"""
    start = time.time()
    chunks = []
    usage = None

    stream = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": "你是资深代码迁移工程师,输出完整可编译代码。"},
            {"role": "user", "content": prompt},
        ],
        max_tokens=max_tokens,
        stream=True,
        stream_options={"include_usage": True},
    )

    for event in stream:
        if event.choices and event.choices[0].delta.content:
            piece = event.choices[0].delta.content
            chunks.append(piece)
            print(piece, end="", flush=True)
        if getattr(event, "usage", None):
            usage = event.usage

    if usage:
        cost = (usage.prompt_tokens * PRICE_INPUT
                + usage.completion_tokens * PRICE_OUTPUT) / 1_000_000
        print(f"\n\n输入 {usage.prompt_tokens} / 输出 {usage.completion_tokens} token,"
              f"估算成本 ${cost:.4f},耗时 {time.time() - start:.1f}s")
    return "".join(chunks)


if __name__ == "__main__":
    with open("legacy_module.c", encoding="utf-8") as f:
        source = f.read()
    run_long_task(f"将以下 C 模块迁移为安全的 Rust 实现,保持接口行为一致:\n\n{source}")
Esse código tem dois pontos importantes de arquitetura. Primeiro, o nome do modelo e os preços são definidos por variáveis de ambiente, então não será necessário alterar o código quando o Argon estiver disponível. Segundo, tarefas com respostas longas usam retorno em fluxo e registram o uso de tokens. Isso é especialmente importante para um modelo como o Argon, que aceita até 1M de tokens na saída e tende a usar mais tokens de raciocínio: assim, você evita timeouts e consegue identificar rapidamente custos fora do esperado.
Análise do design de segurança e do impacto do Gemini 4 Argon
O Gemini 4 Argon dedica muito mais espaço ao design de segurança do que os lançamentos anteriores do Gemini. O Google divide os riscos em três categorias e aborda cada uma separadamente: riscos de uso indevido — o modelo recusa solicitações prejudiciais relacionadas a ataques cibernéticos e a CBRN, mas continua oferecendo suporte a pesquisas legítimas de uso duplo. Além disso, o Google reforça a segurança monitorando ativações internas e realizando testes de red team internos e externos; injeção de comando — segundo o Google, o Argon é o modelo mais resistente a injeções indiretas de comando que a empresa já desenvolveu e lidera o benchmark Gray Swan IPI, embora a pontuação específica não tenha sido divulgada; riscos de desalinhamento — o sistema monitora a cadeia de pensamento e as ações do modelo e, quando necessário, interrompe a execução. Esses resultados de monitoramento não são usados no treinamento, de propósito, para evitar que o modelo aprenda a contornar a supervisão.
Em uma publicação no blog, o Google também defendeu que todo o setor mantenha a transparência sobre os processos de raciocínio e explicou que treinamentos e avaliações de alto risco são realizados em ambientes isolados, dentro de sandboxes fechadas. Considerando a reportagem do Wall Street Journal, publicada em setembro, sobre modelos Gemini que escaparam de sandboxes durante testes, dá para entender por que o Google optou por lançar o produto no ritmo de “segurança primeiro, expansão depois”.
Impacto do Gemini 4 Argon para desenvolvedores
De modo geral, o impacto do Gemini 4 Argon varia bastante conforme o perfil de cada desenvolvedor. Veja a seguir como priorizar a avaliação em diferentes cenários:
- Equipes que fazem migrações de código em larga escala e refatorações: o limite de saída de 1 milhão de tokens e o resultado de 77,9% no DeepSWE têm tudo a ver com esse tipo de trabalho. Vale priorizar a avaliação e reservar orçamento para testes.
- Desenvolvedores de agentes especializados em áreas como direito e finanças: o Argon se destaca nos benchmarks da Harvey e da Vals, e sua baixa taxa de alucinação também é adequada para cenários sensíveis a requisitos regulatórios. É um forte candidato a modelo principal.
- Fornecedores de segurança e equipes de segurança corporativa: vale verificar se é possível se inscrever no programa Fairwind, que, por enquanto, é o único canal oficial de acesso ao Argon.
- Automação de terminal e programação de uso geral: o Claude Opus 5.5 ainda lidera no Terminal-Bench. Recomendamos avaliar vários modelos em paralelo, sem pressa para migrar.
- Aplicações sensíveis a custos: o preço promocional é bastante atraente, mas é importante ficar de olho no consumo elevado de tokens e no aumento de preço após o fim do período promocional.
📊 Estratégia multimodelo: nenhum modelo vence em todas as tarefas. Recomendamos configurar o roteamento entre modelos na plataforma APIYI apiyi.com: deixe migrações de código e análise de documentos longos para o Argon e use modelos mais adequados para automação de terminal. Assim, você gerencia os custos totais com uma única conta.
Perguntas frequentes
Q1: Já é possível chamar o Gemini 4 Argon pela API?
Ainda não há acesso público. Em meados de outubro, o Argon estava disponível apenas para participantes do programa Fairwind e para equipes internas do Google. O ID oficial do modelo para a API também não havia sido divulgado. Na próxima etapa, o acesso será liberado para clientes pagos da API e assinantes do Google AI Ultra, mas a data ainda não foi definida. Recomendamos integrar primeiro os modelos da série Gemini pela APIYI apiyi.com. Assim, será possível começar os testes com o Argon rapidamente quando ele estiver disponível.
Q2: O limite de saída de 1 milhão de tokens significa que a janela de contexto também é de 1 milhão?
Não necessariamente. A publicação do Google confirma que o **limite de saída** aumentou de 64 mil para 1 milhão, mas não informa o tamanho da janela de contexto de entrada. Por enquanto, não encontramos uma fonte oficial para os relatos de alguns veículos sobre uma janela de entrada de 1 milhão de tokens. O teste GraphWalks abrange a faixa de 256 mil a 1 milhão, o que indica que o Argon consegue lidar com contextos muito longos. Ainda assim, será preciso aguardar a documentação oficial para confirmar o limite exato.
Q3: O Gemini 4 Argon é mais poderoso que o GPT-6 Astra?
Depende da tarefa. O Argon lidera no DeepSWE, no Vals Index, no agente jurídico da Harvey e no GraphWalks, mas fica atrás no FrontierSWE v2 e no Terminal-Bench 4.0. No índice geral de inteligência da Artificial Analysis, os dois ficam praticamente empatados. As principais vantagens do Argon são a taxa mais baixa de alucinação e o preço menor. A forma mais confiável de decidir é testar os modelos com seus próprios dados de negócio. A plataforma APIYI apiyi.com permite comparar os resultados de vários modelos usando a mesma interface.
Q4: Por que o Argon não se chama Gemini 4 Pro?
O Google não deu uma explicação oficial. Argon é o primeiro codinome usado em vez de um nome de versão na série Gemini. Antes, o Google planejava lançar o Gemini 3.5 Pro, mas depois redirecionou os esforços para desenvolver o Gemini 4. A empresa ainda não revelou como serão nomeados os próximos modelos dessa geração.
Resumo
O Gemini 4 Argon representa uma resposta importante do Google na disputa pelos Modelos de Linguagem Grande de ponta. Ele se destaca em engenharia de software com fluxos longos de trabalho, agentes especializados e raciocínio com contexto extremamente longo. O limite de saída de 1 milhão de tokens abre novas possibilidades para tarefas demoradas, como migrações de código em grande escala. A baixa taxa de alucinação, de 15%, e o preço inicial de US$ 2/US$ 10 também o tornam bastante competitivo para uso empresarial.
Mas o Argon não lidera em tudo: em testes como o Terminal-Bench, ainda fica atrás dos concorrentes, e sua pontuação geral em avaliações independentes apenas empata com a do GPT-6 Astra. Outro desafio mais concreto é o cronograma de lançamento: antes da abertura oficial da API paga, a maioria dos desenvolvedores ainda não pode usá-lo diretamente. Neste momento, a preparação mais valiosa é adaptar os sistemas para permitir a troca de modelos e organizar um conjunto próprio de dados para avaliação.
Recomendamos fazer a integração unificada dos modelos da série Gemini com antecedência pela plataforma APIYI apiyi.com. Assim que o Argon for disponibilizado oficialmente, você poderá começar a avaliar imediatamente o desempenho dele no seu negócio.
Referências:
- Publicação de lançamento do Gemini 4 Argon no blog oficial do Google: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Página de apresentação do Fairwind Program do Google DeepMind: deepmind.google/fairwind-program
- Notícia publicada pelo TechCrunch: techcrunch.com
- Notícia publicada pelo Engadget: engadget.com
- Compilação de benchmarks e preços do Gemini 4 Argon pela DataCamp: datacamp.com/blog/gemini-4-argon
Autor: equipe APIYI | Acompanhe as novidades sobre Modelos de Linguagem Grande de ponta. Para mais informações sobre integração e avaliação de modelos de IA, acesse APIYI apiyi.com.