11 月 1 日,DeepSeek Harness 團隊在 X 發佈長文《探索超級智能體設計》,討論超級智能體(Super-agent)架構。發佈約 15 小時後,這篇文章已有約 130 萬瀏覽、9.4K 贊。這是架構理念文章,不是產品功能介紹。
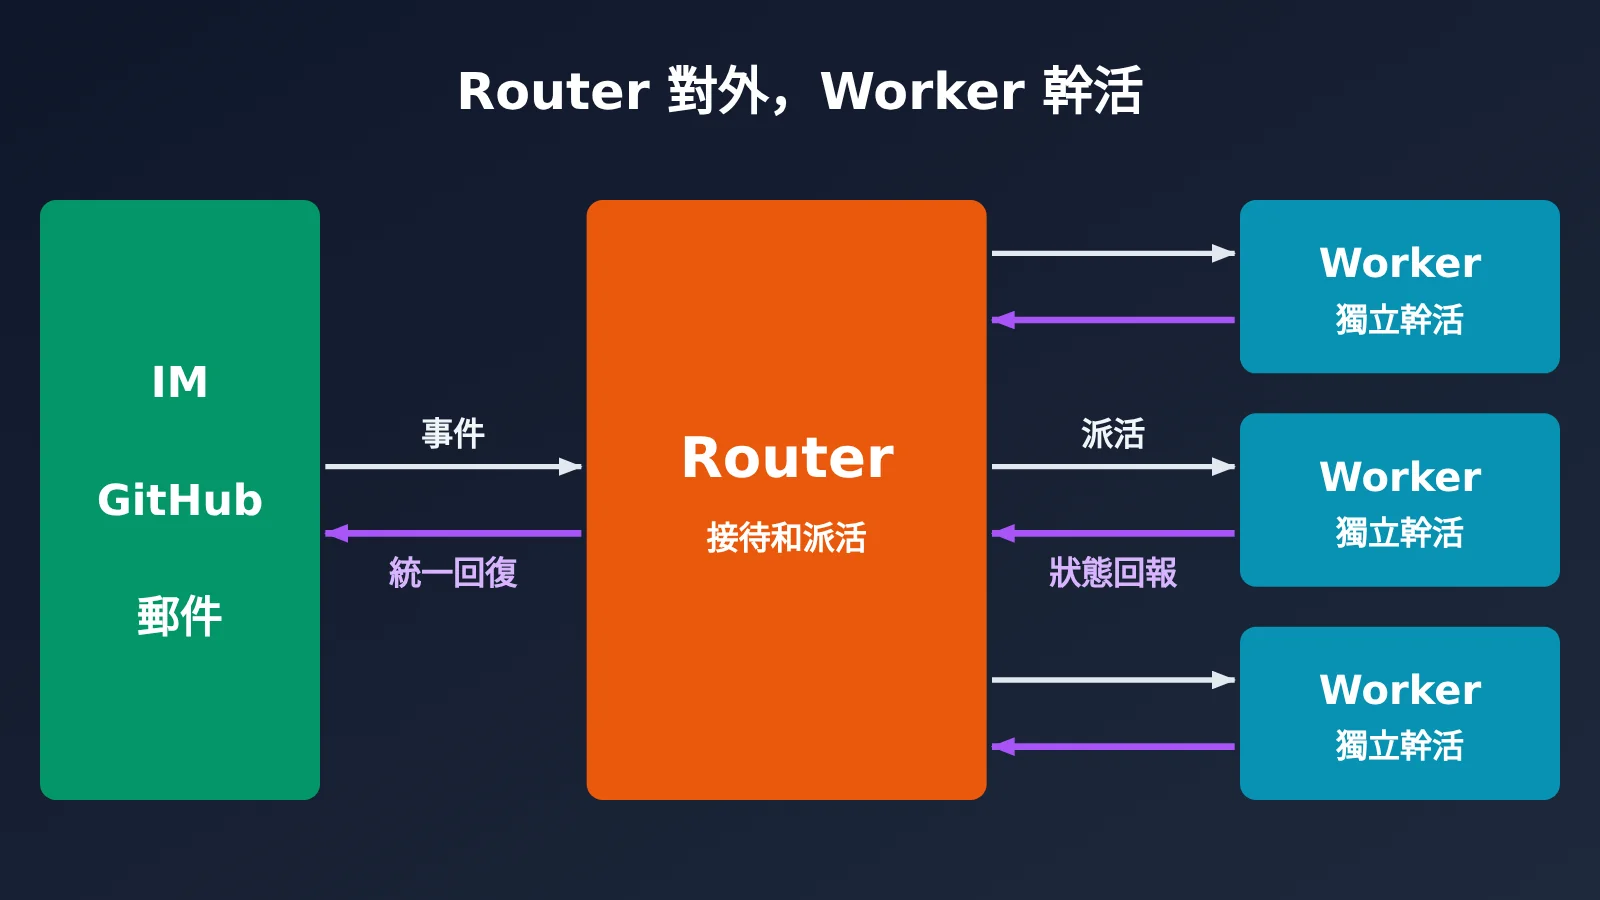
一句話結論: 這套設計讓系統接管會話管理,用戶只面對一個入口。Router(前臺調度)負責接待和派活,Worker(後臺幹活的會話)並行執行任務,人只做高層決策和最終籤核。
DeepSeek 超級智能體爲什麼要跳出單會話
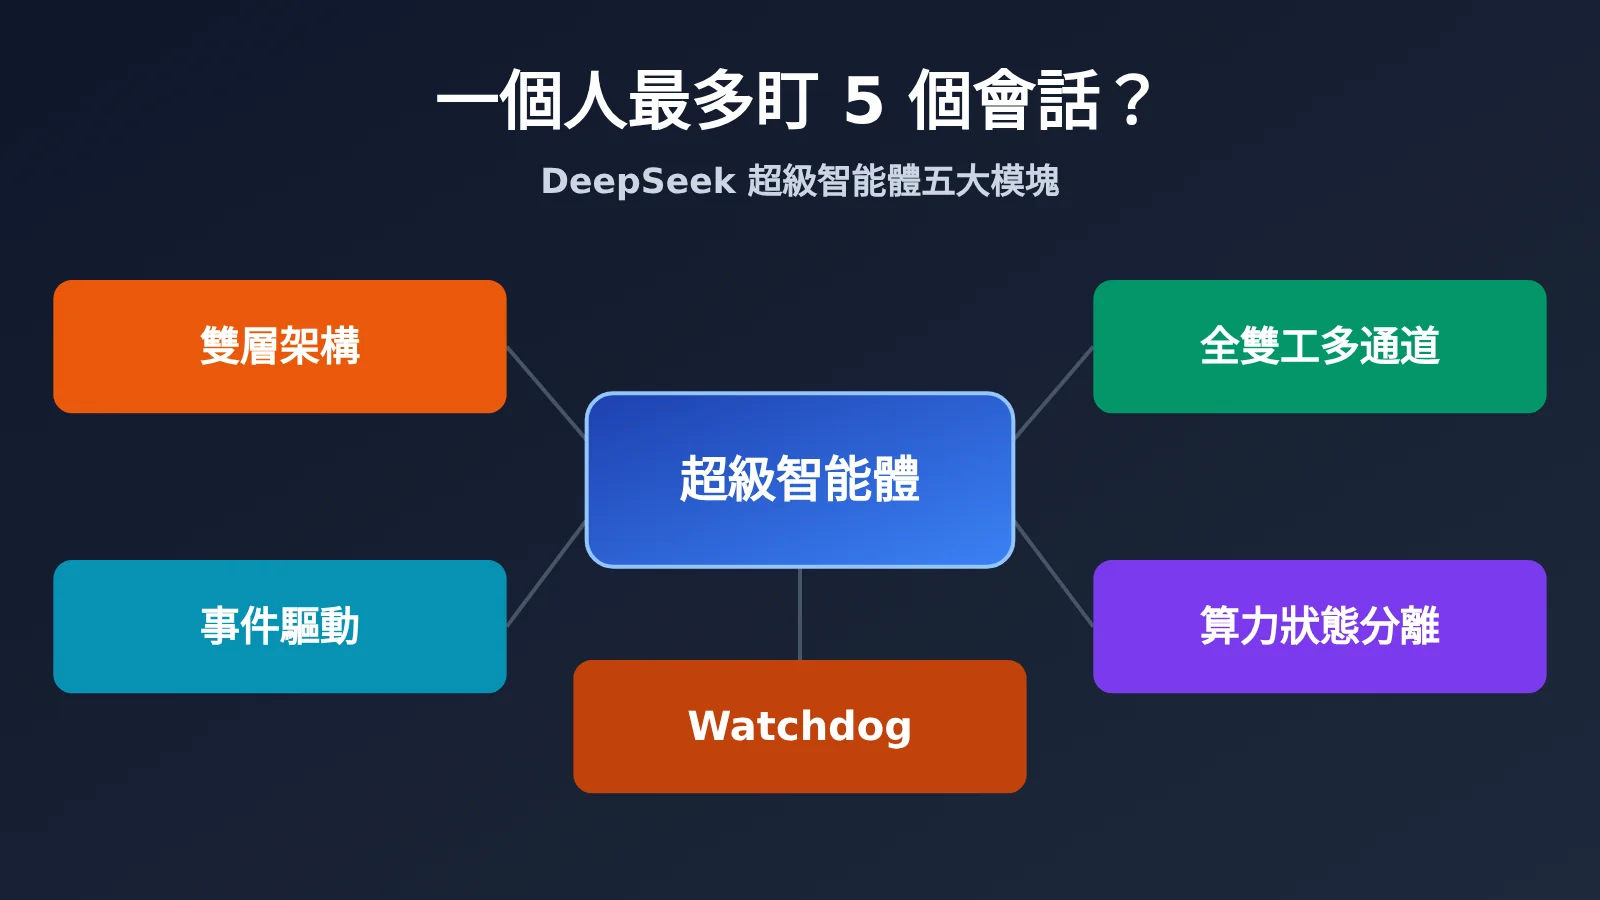
現在的主流 Agent 仍以單個會話爲工作單位。用戶同時跑多個任務時,要手動切會話、記上下文。DeepSeek Harness 團隊的經驗是,一個人通常一次只能處理 3 到 5 個活躍會話。這個數字是團隊經驗,不是普遍統計,但它指出了一個瓶頸:單個任務受模型能力限制,多任務受人的注意力限制。
給本地 Agent 加命令行工具和外部連接器,只能讓它收到外部消息,三個限制依然存在:
- 同步阻塞: 經典 ReAct(邊想邊調工具的循環)遇到耗時操作會等待,期間無法響應新消息。
- 上下文串味: 不同任務的中間細節混在同一個窗口裏,互相干擾。
- 設備綁定: 本地設備一旦休眠或離線,Agent 就停止工作。
文章因此提出,把 Agent 與任何單個手動驅動的會話解耦,讓它成爲一個連續實體。它要同時具備下面四個特徵,而單個 ReAct 循環做不到,必須依靠外圍系統架構。
| 超級智能體特徵 | 大白話 | 主要靠哪個模塊 |
|---|---|---|
| 連續 | 在 IM、GitHub 裏交流,始終像同一個 Agent | 雙層架構、多通道交互 |
| 高效 | 上一條命令沒結束也能接新指令,多任務並行 | 雙層架構、全雙工交互 |
| 主動 | 監聽環境事件,值得處理纔行動 | 事件驅動 |
| 持久 | 始終在線,出異常能自動恢復 | 算力與狀態分離、Watchdog |
DeepSeek 超級智能體五大模塊逐個拆
先看總表。“現在能不能用”這一列最值得注意,因爲文章講的是設計方向,不等於現成功能。
| 模塊 | 解決什麼問題 | 關鍵做法 | 現在能不能用 |
|---|---|---|---|
| 雙層架構 | 連續性和併發難以兼顧 | Router 只交互和派活,Worker 隔離執行 | 原型有相近流程,完整設計需自建 |
| 事件驅動 | Agent 只能等指令,事件噪聲大 | 代碼快篩,模型慢判,Thread 訂閱直通 | 原型可監聽 GitHub,可選飛書 |
| 全雙工多通道 | 長任務阻塞對話,日誌打擾人 | 異步工具調用,按渠道定回覆規範 | DeepSeek Harness 已實現異步任務,默認未開啓 |
| 算力、狀態與環境分離 | 設備離線就停,夠不到其他環境 | 雲上跑循環,數據庫存狀態,端點留原地 | 原文未說明已對外提供,需自建 |
| Watchdog | 進程還在,任務卻卡住或跑偏 | 主系統外的獨立會話定時巡檢 | 原文未說明已對外提供,需自建 |
模塊一:DeepSeek 超級智能體的 Router/Worker 雙層架構
類比: Router 像餐廳前臺,只接待和傳單;Worker 像後廚,每個竈臺只做一道菜。
所有事件都進一個會話,上下文最連續,但吞吐低;每個事件都開新會話,併發高,卻缺少全局上下文,還會出現多個會話分別回覆用戶的混亂。雙層架構把這兩件事拆開:長期在線的 Router 負責人類交互和全局協調,甚至可以完全沒有 Bash 工具;Worker 上下文隔離,每個只管一個任務,不直接對外發言,狀態統一報給 Router。原文的意思是,會話應該成爲系統的實現細節,而不是用戶的心智負擔。
Router 看起來容易成爲瓶頸,但一個推理輪次內到達的 Trigger(環境裏的事件)會排隊,並在下一輪合併處理。它的請求通常輸入長、輸出短,合併後的事件在 Prefill(模型處理輸入的前半段)階段並行計算,所以單請求時間增長得比批量慢。團隊經驗是,Router 的工作往往比想象中簡單,輕量模型通常就夠用。落地時可以先通過 API易 · apiyi.com 接入 deepseek-v4.1-flash 試跑 Router,觀察它的派發準確度。
Worker 直接決定任務結果和代碼質量,所以原文認爲通常要用最強的模型。可以在 API易 · apiyi.com 上用同一批任務對比 deepseek-v4-pro 和 claude-opus-5-5,再決定默認模型。
模塊二:DeepSeek 超級智能體的 Trigger 事件驅動
類比: 門衛先按名單攔人,拿不準的再請經理判斷;老客戶的後續事項直接轉給原來的負責人。
Agent 要主動工作,主要輸入就得從人工 prompt 變成環境事件,比如羣聊消息、CI 結果和代碼 review 評論。真實事件流噪聲很大,每條都交給大模型判斷,延遲和算力都受不了。文章因此設計了兩層過濾:
- Fast Path(代碼快篩): 按來源、羣、用戶或機器人白名單做確定性檢查,每個來源可設“只響應明確請求”“當作候選事件”或“忽略”。
- Slow Path(模型慢判): 通過快篩的候選事件才交給 LLM,由它結合上下文和用 prompt 寫的策略決定是否行動。
路由也分快慢。同一個 PR、IM 話題或郵件鏈上的連續事件構成一個 Thread,Worker 訂閱後,後續事件由代碼直接透傳,不必再經 Router 決策。多個 Worker 訂閱同一 Thread 時,會收到相同通知,有機會自行發現並解決衝突。
上下文則按緩存來管理。很快要用的信息直接放進窗口(Inline),很少用的完整信息留在窗口外,只留引用或摘要(Spill)。文章還提到提前行動:在後臺先查日曆、復現 issue,有用的結果才交付,其餘丟棄,用額外算力換取人的等待和介入減少。
模塊三:DeepSeek 超級智能體的全雙工多通道交互
類比: 燒水時不用站在壺邊,水開了會有提示,這期間你可以繼續和別人說話。
異步 ReAct 把耗時調用換成 start() 和 stop()。start() 立即返回,工具在後臺運行,完成後結果作爲新事件送回會話;模型也可以用 stop() 結束跑得太久的命令。這樣,用戶的新輸入在當前推理步驟結束後就能處理。原文明確說,DeepSeek Harness 已經實現這種異步任務機制,但尚未默認開啓。
多通道解決的是“怎麼說話”。IM 上要輕量、少打擾,只在需要決策或籤核時通知,團隊驗證過的一條硬規則是每條回覆不超過 100 詞。GitHub、郵件和文檔則需要結構化、高信息密度的輸出,比如在 PR 中寫清問題背景、改動說明和驗證結果。
模塊四:DeepSeek 超級智能體的算力、狀態與環境分離
類比: 檔案放進公司的檔案室,員工換工位也能接着幹;需要用哪臺機器上的工具,就派人去那臺機器上操作。
文章分兩步解耦。第一步,Agent 循環跑在無狀態的雲容器裏,會話狀態存數據庫,容器重啓或替換都不影響任務連續。第二步,執行環境留在原地,每個端點只裝一個輕量 daemon(常駐後臺的小程序),它不保存會話狀態,只負責執行命令和返回結果。
這一設計還支持 BYOM(Bring Your Own Machine,把自己的電腦接到雲端 Agent)。這樣不必把未提交改動和本地憑據全部同步到雲上,設備重新上線後,雲端 Agent 還能繼續完成需要在那臺設備上跑的任務。Anthropic 的 “Decoupling the brain from the hands” 也採用了類似的解耦思路,可以對照閱讀。
模塊五:DeepSeek 超級智能體的 Watchdog 外部巡檢
類比: 值班主管不參與具體工作,定時巡查誰停工了、誰跑偏了。
很多 Agent 異常並不是崩潰,而是進程還在,模型卻卡在無產出的循環裏,傳統存活探針發現不了。Watchdog 是跑在主系統之外的獨立會話,由定時消息驅動。它既處理 API 錯誤、狀態恢復失敗等基礎設施故障,也用模型判斷每個 Worker 是否在實質推進。維護人員可以用自然語言問它“爲什麼失敗”,也可以讓它在系統運行時調整 prompt 和觸發規則。
DeepSeek 超級智能體原型現在能試到什麼程度
配套倉庫是 github.com/deepseek-ai/dsh-superagent-prototype,採用 MIT 協議,2026-11-02 抓取時有 8,636 stars、863 forks。它是研究原型,不是 DeepSeek 官方產品,也不等同於團隊內部版本或文章描述的完整實現,文中部分設計屬於未來方向,原型並未實現。
原型是一個面向單個 GitHub 倉庫的主動式編程 Agent,打包成 DeepSeek Harness 的 bundle。它監聽 GitHub,也可選接飛書;有人派活時就開工作項,在自己的會話和目錄中完成,最後回到原對話回覆,比如提交 PR。另有網頁面板顯示需要人處理的事項。
DeepSeek 超級智能體的兩組實驗數據說明了什麼
以下數據均爲官方文章自報,實驗採用合成負載、簡化環境,作者說結果僅供參考。第一組實驗的每次運行約 300 條消息,其中約 20 個工作請求,每種設計重複 5 次。編碼工作用只消耗時間的工具模擬,所以它測的是調度和協調,不是任務執行質量。
表中的 p50 指一半任務在該時間內完成,p95 指 95% 的任務在該時間內完成。cache-read tokens 是緩存讀(直接複用已緩存上下文,不重新處理)的 token 數,這裏是所有會話的合計。
| 設計 | p50(分鐘) | p95(分鐘) | cache-read tokens / 次 |
|---|---|---|---|
| Super-agent | 12.4 | 15.7 | 23.2M |
| 去掉 Pass-through(訂閱直通) | 12.6 | 15.5 | 31.8M |
| 單會話 + 子 Agent(中性提示) | 20.4 | 29.5 | 6.1M |
| 單會話 + 子 Agent(委派優先提示) | 13.8 | 29.0 | 10.8M |
中性提示下,模型 5 次運行都沒有調用子 Agent。委派優先提示下,5 次中有 4 次委派,另一次模型認爲活小而自己做了。這說明在這個負載下,單會話的表現高度依賴 prompt 和模型的臨場判斷,而雙層架構把委派固化到了系統層。代價也很清楚:Super-agent 的緩存讀消耗明顯更高,是用 token 換更短、更穩定的完成時間。
去掉直通後,完成時間幾乎不變,但 Router 決策數多約 30%,cache-read tokens 多約 37%。所以在這個負載下,直通沒有提速,主要作用是降低 Router 的開銷。
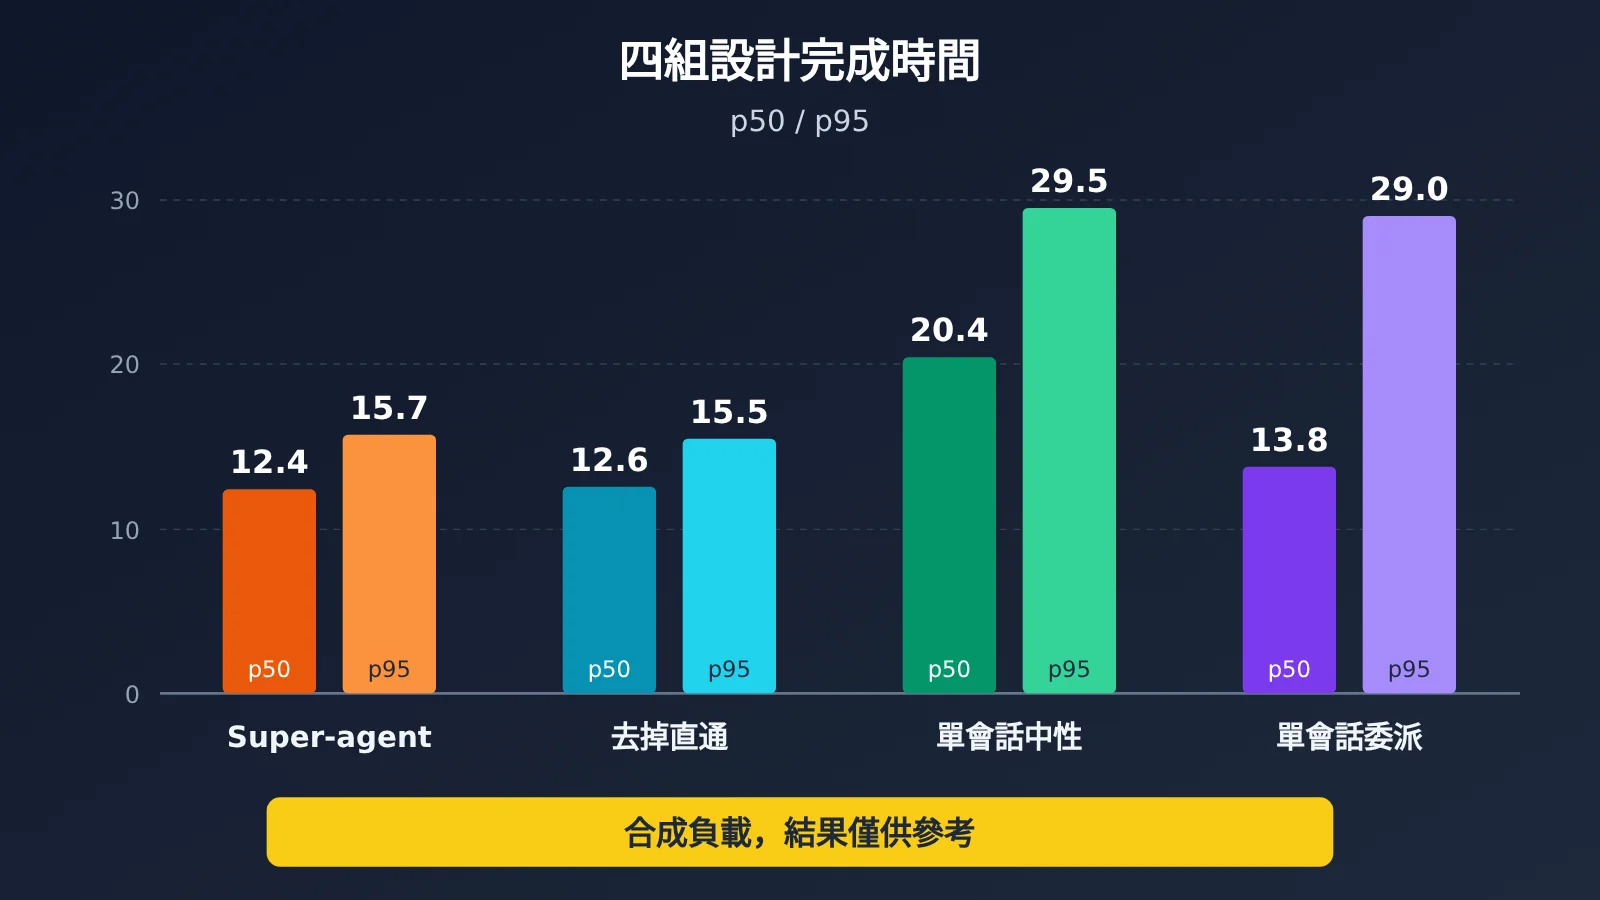
第二組實驗單獨壓測 Router 層:Router 調真實模型,Worker 用模擬模型,逐步提高需要 Router 決策的 Trigger 到達率。
| 到達率(次/分鐘) | 平均批大小 | 單請求時間 | 每決策分攤推理時間 |
|---|---|---|---|
| 約 1 | 1.0 | 2.5 秒 | 6.4 秒 |
| 約 40 | 2.8 | 3.9 秒 | 1.6 秒 |
一個決策可能包含多次 LLM 請求,所以分攤時間可能大於單請求時間。這組數據支持的結論是:事件突發時,自動合併能提高 Router 的有效吞吐。但它不能證明真實生產環境也有同樣的結果,也無法說明任務質量和不同代碼庫下的表現。
DeepSeek 超級智能體的四個開放問題
文章明確承認以下問題尚未解決,評估落地方案時應當把它們算進去:
- 架構如何擴展: 任務更大、耦合更緊時,Router 該不該分片、分多細,Worker 何時該直接通信,都沒有定論。分片越細,併發越高,但共享記憶和上下文越少,長期記憶也是主要瓶頸。
- 沒有會話後怎麼用: 任務如何呈現、人如何在不打斷後臺工作的前提下干預關鍵細節,還需要新的交互方式。
- 上下文邊界與 A2A: A2A(agent-to-agent)泛指不同 Agent 之間的溝通協作。組織變大後,配置 Super-agent 實際上是在決定哪些上下文共享、哪些隔離,跨權限邊界如何安全協作尚無答案。
- 安全與隱私: 這是最需要優先評估的一項。雲端循環持續接收外部事件,端點又持有私有代碼和本地憑據;服務端被入侵或循環被 prompt injection(藏在輸入裏的惡意指令)攻破時,連着的端點都可能被接管。文章認爲,Agent 需要一種“用得到憑據但看不見憑據”的方式。
DeepSeek 超級智能體小團隊最小落地清單
下面的順序是我們基於原文思路給出的建議,並非官方路線。先在單個倉庫、可信範圍內試點,暫時不做 Router 分片。
第一步:先拆 Router/Worker
- 代碼: 建一個長期在線的 Router 入口,不給它 Bash 工具;每個任務開獨立 Worker,配獨立上下文和工作目錄;Worker 的結果只報給 Router。
- 模型: Router 用輕模型,Worker 用能力更強的模型,兩者分開配置,便於單獨替換。
- 人: 只和 Router 對話,負責定義任務邊界、處理決策請求和最終籤核。
第二步:再加 Trigger 過濾
- 代碼: 配置來源白名單和三檔策略,把 PR、IM 話題映射爲 Thread,已訂閱的後續事件直接透傳給 Worker。
- 模型: 只對候選事件做語義判斷,判斷是否行動、是否新開 Worker。
- 人: 用 prompt 寫清行動條件,定期抽查誤觸發和漏觸發,再調整白名單和策略。
第三步:最後加 Watchdog
- 代碼: 把它部署在主系統之外,用定時消息驅動,檢查 API 錯誤、狀態恢復失敗等基礎設施問題。
- 模型: 讀取 Worker 的進展記錄,判斷它是在實質推進、卡住還是偏離目標。
- 人: 設定 Watchdog 的修復權限,審批它對 prompt 和觸發規則的修改,並覆盤失敗原因。
從第一天起就應避免把生產憑據直接放進模型上下文,權限也要按最小範圍配置。異步工具調用和算力分離可以等前三步跑穩,並確實遇到阻塞或設備離線問題時再做。
DeepSeek 超級智能體的模型搭配與成本估算
下表是 2026-11-02 查詢的 API易 · apiyi.com 型號表,單位爲 $/1M tokens。型號與價格以平臺型號列表爲準,實際扣費以控制檯爲準。
| 型號 | 輸入 | 輸出 | 緩存讀 |
|---|---|---|---|
| deepseek-v4.1-flash | 0.3 | 1.2 | 0.006 |
| deepseek-v4-flash | 0.44 | 1.32 | 0.01408 |
| deepseek-v4-pro | 1.32 | 3.96 | 0.043996 |
| claude-opus-5-5 | 4 | 20 | 0.2 |
以下均爲按公開價計算的估算,不是實測。假設一次調用消耗輸入 2 萬 tokens、輸出 2 千 tokens,暫不計緩存:
deepseek-v4.1-flash約 $0.0084,deepseek-v4-pro約 $0.0343,claude-opus-5-5約 $0.12。- Router 用
deepseek-v4.1-flash、Worker 用deepseek-v4-pro各跑一次,合計約 $0.0427;兩邊都用claude-opus-5-5約 $0.24,約爲前者的 5.6 倍。 - 如果每天按這個用量跑 20 組,混合搭配約 $0.85,全用
claude-opus-5-5約 $4.8。真實 Worker 往往不止一輪調用,應換成自己日誌裏的 token 數重算。
長跑系統還要單獨算緩存讀。按實驗中的 23.2M cache-read tokens 估算,全部按 deepseek-v4.1-flash 計約 $0.14,按 deepseek-v4-pro 計約 $1.02,按 claude-opus-5-5 計約 $4.64。這只是量級參考,實驗並未公開各層 token 分佈,也不包含輸入和輸出費用。
Router 和 Worker 的模型最好做成配置項。通過 API易 · apiyi.com,可以用一個 API Key 切換這些模型,OpenAI 兼容接口的 base_url 爲 https://api.apiyi.com/v1,切換時主要改模型名,便於用同一批任務比較質量和成本。價格只是選型的一半,Worker 的默認模型仍要看任務成功率和返工量。
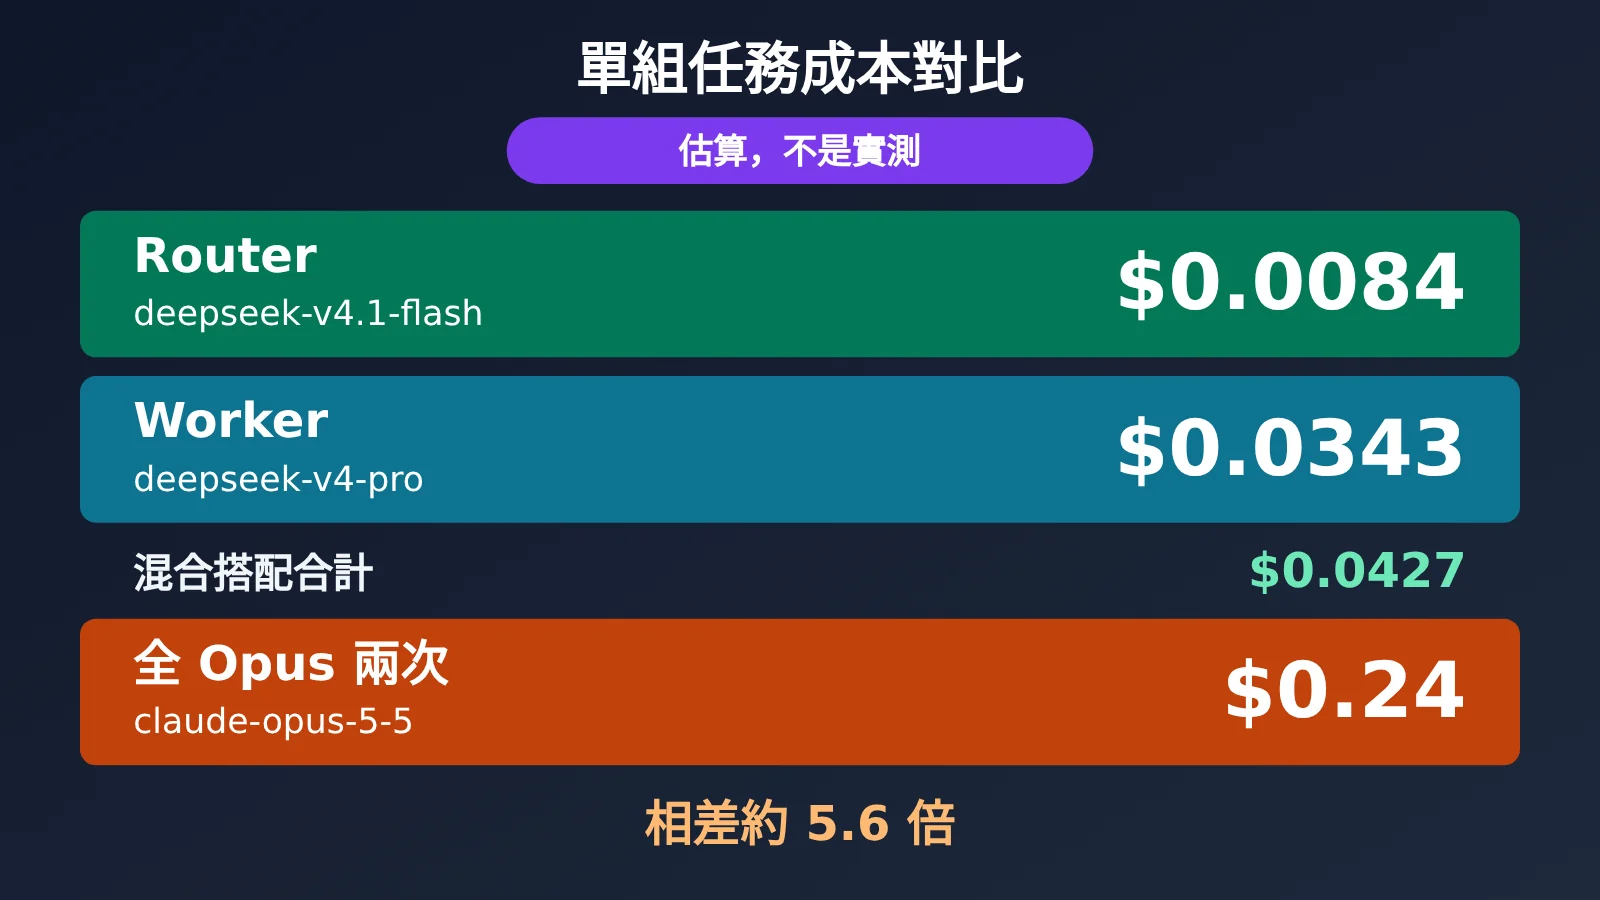
上圖按 API易 · apiyi.com 型號表的默認標價估算,請替換爲自己的 token 用量後再做預算。
DeepSeek 超級智能體常見問題 FAQ
Q1:這是新模型嗎?
不是。這是一篇討論 Agent 系統架構的文章,重點在外圍系統如何組織會話、事件、狀態和監控,並未發佈新模型。
Q2:普通開發者能直接用嗎?
不能把五個模塊當作開箱即用的功能。目前可以試研究原型,或按文中思路自建;原文唯一明確提到的現有實現,是 DeepSeek Harness 的異步任務機制,且默認未開啓。
Q3:dsh-superagent-prototype 是官方產品嗎?
不是。它的 README 寫明僅供研究參考,不是 DeepSeek 官方產品,也不等同於內部版本或文章描述的完整實現。
Q4:多 Agent 會更貴嗎?
在這組實驗裏,緩存讀 token 確實更多:Super-agent 是 23.2M,單會話方案是 6.1M 到 10.8M,換來的是更短、更穩定的完成時間。實際總成本還取決於模型搭配和任務規模,Router 用輕模型、開啓 Thread 直通都有助於控制開銷。
Q5:國內怎麼接這些模型?
可以通過 API易 · apiyi.com 註冊並獲取 API Key,新用戶有免費測試額度。然後把客戶端的 base_url 改成上文地址,並在模型參數中填寫表內型號。這些 DeepSeek 和 Claude 型號都支持 chat、messages 端點,上線前建議先用小流量驗證。
總結
DeepSeek 超級智能體這篇文章的價值,在於把經典系統工程思路用到了 Agent 上。讀完可以帶走這幾點:
- 問題定位: 在單任務上,模型需要的人越來越少,多任務的瓶頸正在轉向人的注意力。
- 五個模塊: 雙層架構、事件驅動、全雙工多通道、算力狀態環境分離和 Watchdog,分別對應連續、高效、主動和持久四個特徵。
- 證據邊界: 兩組實驗都是作者自報的合成負載結果,只能作爲設計參考。
- 落地順序: 先拆 Router/Worker,再加 Trigger 過濾,最後加 Watchdog,全程把安全邊界放在前面。
模型搭配不必一次定死,可以通過 API易 · apiyi.com 用同一批任務先跑小規模對比,再根據成功率和賬單確定配置。
先把自己從“人肉 Router”的位置上換下來,再考慮加更多 Agent。
作者:API易 技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,更多資料可訪問 docs.apiyi.com 文檔中心