Am 1. November veröffentlichte das DeepSeek-Harness-Team auf X den ausführlichen Beitrag „Exploring Super-agent Design“ über die Architektur eines Super-Agenten. Rund 15 Stunden später hatte der Beitrag etwa 1,3 Millionen Aufrufe und 9.400 Likes. Der Artikel beschreibt ein Architekturkonzept, keine Produktfunktionen.
Das Fazit in einem Satz: Das System übernimmt die Sitzungsverwaltung, während Nutzer nur einen einzigen Zugangspunkt haben. Der Router nimmt Anfragen entgegen und verteilt Aufgaben, Worker führen sie als Sitzungen im Hintergrund parallel aus. Der Mensch trifft übergeordnete Entscheidungen und gibt die Ergebnisse abschließend frei.
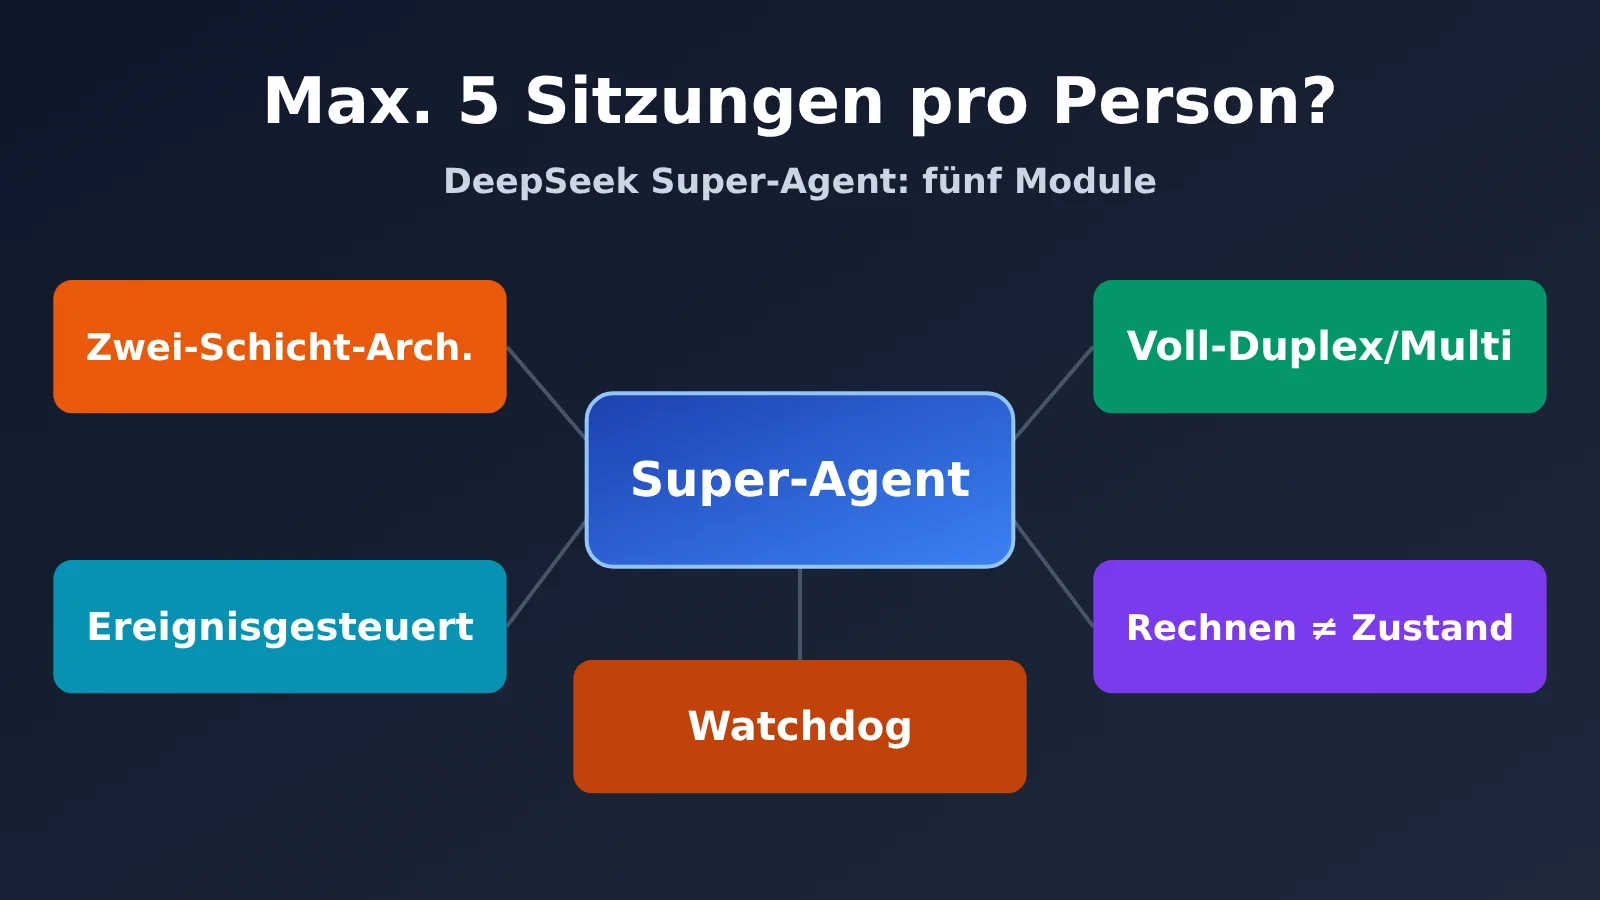
Warum DeepSeeks Super-Agent über einzelne Sitzungen hinausgehen soll
Heute arbeiten die meisten Agents innerhalb einzelner Sitzungen. Wer mehrere Aufgaben gleichzeitig ausführt, muss manuell zwischen Sitzungen wechseln und den jeweiligen Kontext im Blick behalten. Nach Erfahrung des DeepSeek-Harness-Teams kann eine Person meist nur drei bis fünf aktive Sitzungen gleichzeitig betreuen. Das ist ein Erfahrungswert des Teams und keine allgemeingültige Statistik. Er zeigt aber einen Engpass: Bei einer einzelnen Aufgabe setzt die Modellleistung Grenzen, bei mehreren Aufgaben die menschliche Aufmerksamkeit.
Kommandozeilenwerkzeuge und externe Konnektoren ermöglichen es einem lokalen Agent zwar, externe Nachrichten zu empfangen. Drei Einschränkungen bleiben aber bestehen:
- Synchrone Blockierung: Das klassische ReAct-Muster, eine Schleife aus Nachdenken und Werkzeugaufrufen, wartet bei zeitaufwendigen Vorgängen auf deren Abschluss und kann in dieser Zeit nicht auf neue Nachrichten reagieren.
- Vermischung des Kontexts: Zwischenschritte verschiedener Aufgaben landen im selben Fenster und stören sich gegenseitig.
- Gerätebindung: Geht das lokale Gerät in den Ruhemodus oder offline, stellt der Agent seine Arbeit ein.
Der Artikel schlägt deshalb vor, den Agent von jeder einzelnen manuell gesteuerten Sitzung zu entkoppeln und ihn zu einer kontinuierlich verfügbaren Einheit zu machen. Dafür soll er die folgenden vier Eigenschaften zugleich erfüllen. Eine einzelne ReAct-Schleife reicht dazu nicht aus; nötig ist eine entsprechende Systemarchitektur.
| Eigenschaft des Super-Agenten | Einfach erklärt | Wichtigste Module |
|---|---|---|
| Kontinuierlich | Ob im Messenger oder auf GitHub: Es wirkt immer wie derselbe Agent | Zweistufige Architektur, Interaktion über mehrere Kanäle |
| Effizient | Nimmt neue Anweisungen an, während ein früherer Befehl noch läuft, und bearbeitet Aufgaben parallel | Zweistufige Architektur, Vollduplex-Interaktion |
| Proaktiv | Beobachtet Ereignisse in der Umgebung und handelt, wenn es sinnvoll ist | Ereignissteuerung |
| Dauerhaft | Ist ständig online und kann sich nach Fehlern automatisch wiederherstellen | Trennung von Rechenleistung und Zustand, Watchdog |
Die fünf Module des DeepSeek-Superagenten im Überblick
Werfen wir zuerst einen Blick auf die Übersicht. Besonders wichtig ist die Spalte „Heute nutzbar?“. Der Artikel beschreibt nämlich eine Designrichtung – nicht unbedingt bereits verfügbare Funktionen.
| Modul | Welches Problem wird gelöst? | Zentrale Vorgehensweise | Heute nutzbar? |
|---|---|---|---|
| Zweistufige Architektur | Kontinuität und parallele Ausführung sind schwer zu vereinbaren | Der Router übernimmt nur die Kommunikation und Aufgabenverteilung; Worker führen Aufgaben isoliert aus | Der Prototyp bietet einen ähnlichen Ablauf; das vollständige Design muss selbst umgesetzt werden |
| Ereignissteuerung | Der Agent wartet auf Anweisungen, während viele irrelevante Ereignisse anfallen | Code filtert schnell vor, das Modell prüft gründlicher; Thread-Abonnements werden direkt durchgeleitet | Der Prototyp kann GitHub überwachen, optional auch Feishu |
| Vollduplex über mehrere Kanäle | Lange Aufgaben blockieren den Dialog, Logs stören die Nutzer | Asynchrone Tool-Aufrufe und kanalabhängige Antwortregeln | DeepSeek Harness unterstützt bereits asynchrone Aufgaben, sie sind standardmässig nicht aktiviert |
| Trennung von Rechenleistung, Zustand und Umgebung | Geht ein Gerät offline, stoppt die Ausführung; andere Umgebungen sind nicht erreichbar | Die Schleife läuft in der Cloud, eine Datenbank speichert den Zustand, Endpunkte bleiben an ihrem jeweiligen Ort | Der Originaltext nennt keine öffentliche Verfügbarkeit; muss selbst umgesetzt werden |
| Watchdog | Der Prozess läuft noch, aber die Aufgabe hängt oder gerät vom Kurs ab | Eine unabhängige Sitzung ausserhalb des Hauptsystems führt regelmässige Kontrollen durch | Der Originaltext nennt keine öffentliche Verfügbarkeit; muss selbst umgesetzt werden |
Modul 1: Die zweistufige Router/Worker-Architektur des DeepSeek-Superagenten
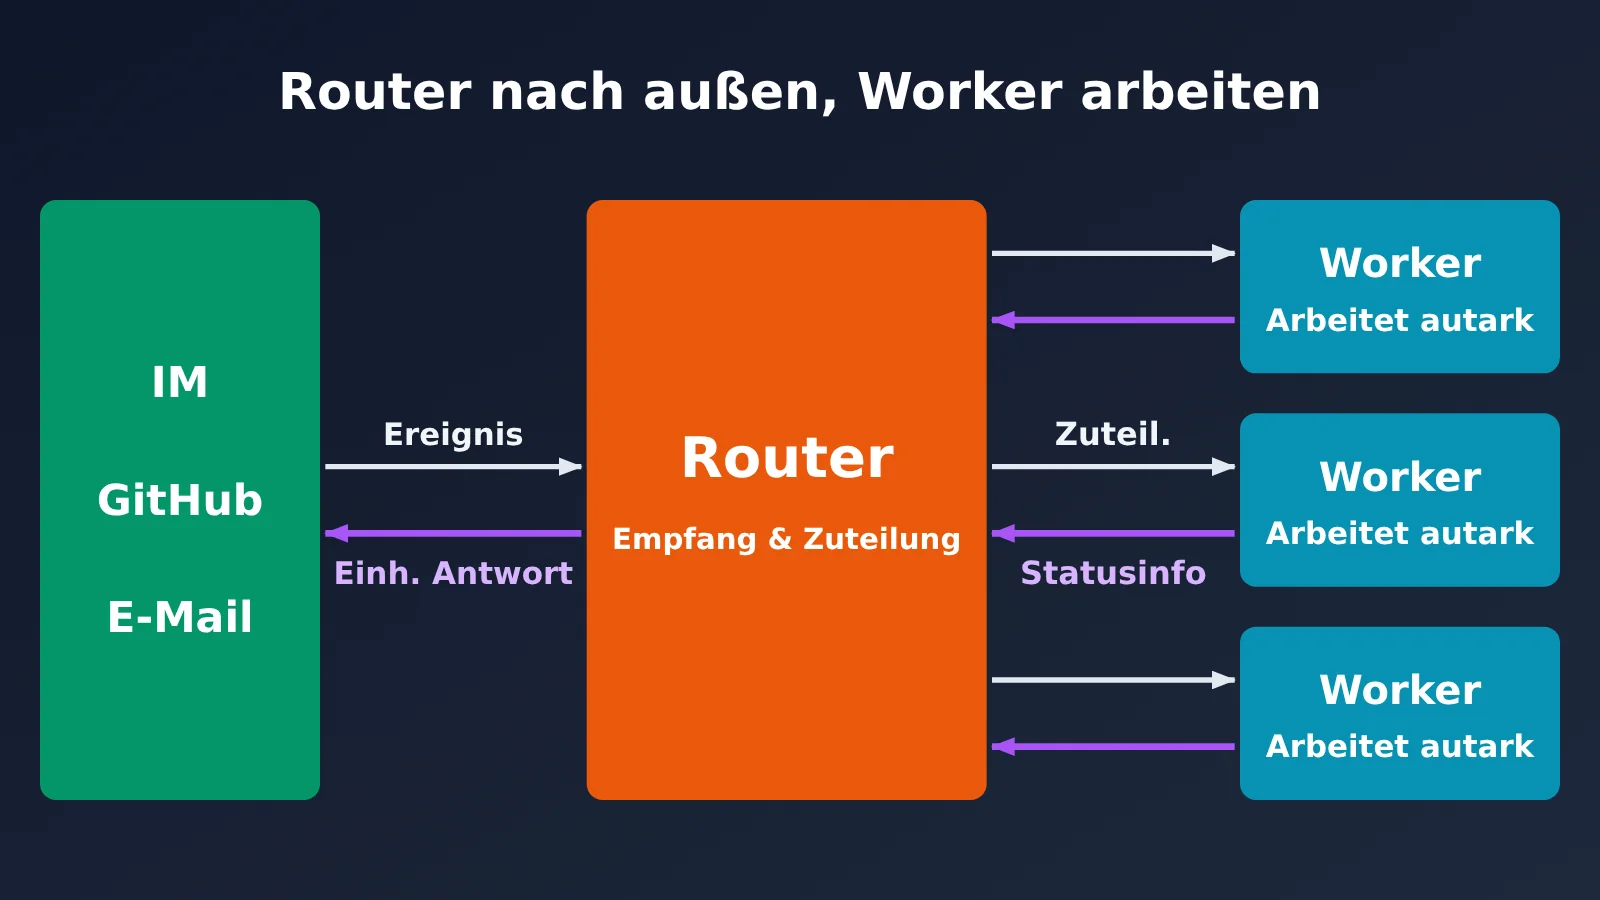
Vergleich: Der Router ist wie der Empfang eines Restaurants: Er begrüßt Gäste und leitet Bestellungen weiter. Die Worker sind wie die Küche: Jeder Arbeitsplatz kümmert sich um genau ein Gericht.
Laufen alle Ereignisse in einer Sitzung zusammen, bleibt der Kontext zwar durchgehend erhalten, aber der Durchsatz ist gering. Eröffnet man dagegen für jedes Ereignis eine neue Sitzung, steigt die Parallelität, doch der globale Kontext fehlt. Außerdem können mehrere Sitzungen unabhängig voneinander dem Nutzer antworten und so für Verwirrung sorgen. Die zweistufige Architektur trennt diese Aufgaben: Der dauerhaft aktive Router übernimmt die Interaktion mit Menschen und die globale Koordination. Er kann sogar ganz ohne Bash-Tool auskommen. Die Worker arbeiten mit voneinander isolierten Kontexten. Jeder bearbeitet nur eine Aufgabe, kommuniziert nicht direkt nach außen und meldet seinen Status an den Router. Der Grundgedanke des Originaltextes: Sitzungen sollten ein Implementierungsdetail des Systems sein und nicht etwas, womit sich Nutzer befassen müssen.
Der Router scheint zunächst ein möglicher Engpass zu sein. Doch Trigger – also Ereignisse aus der Umgebung –, die während eines Inferenzdurchlaufs eintreffen, werden in eine Warteschlange gestellt und im nächsten Durchlauf gemeinsam verarbeitet. Seine Anfragen haben typischerweise lange Eingaben und kurze Ausgaben. Die zusammengeführten Ereignisse werden in der Prefill-Phase, in der das Modell die Eingabe verarbeitet, parallel berechnet. Dadurch wächst die Bearbeitungszeit einer Anfrage langsamer als die Zahl der gebündelten Ereignisse. Nach Erfahrung des Teams ist die Arbeit des Routers oft einfacher als gedacht; meist reicht ein schlankes Modell aus. Für einen ersten Praxistest lässt sich über APIYI · apiyi.com deepseek-v4.1-flash als Router anbinden. So können Sie beobachten, wie zuverlässig es Aufgaben zuweist.
Die Worker bestimmen unmittelbar das Aufgabenergebnis und die Codequalität. Deshalb empfiehlt der Originaltext, für sie in der Regel das stärkste Modell einzusetzen. Auf APIYI · apiyi.com können Sie deepseek-v4-pro und claude-opus-5-5 mit denselben Aufgaben vergleichen und anschließend ein Standardmodell auswählen.
Modul zwei: Ereignisgesteuerte Trigger für den DeepSeek-Superagenten
Vergleich: Ein Pförtner prüft zuerst eine Liste und fragt nur bei unklaren Fällen den Manager. Anliegen bestehender Kunden gehen direkt an die Person, die bereits für sie zuständig ist.
Damit ein Agent selbstständig arbeiten kann, muss er seine Eingaben hauptsächlich aus Ereignissen in seiner Umgebung beziehen statt aus manuellen Eingabeaufforderungen – etwa aus Gruppenchats, CI-Ergebnissen oder Kommentaren zu Code-Reviews. Reale Ereignisströme enthalten viel Rauschen. Würde ein Großes Sprachmodell jedes einzelne Ereignis prüfen, wären Latenz und Rechenaufwand zu hoch. Deshalb sieht der Artikel zwei Filterstufen vor:
- Fast Path (schnelle Prüfung per Code): Deterministische Prüfung anhand von Positivlisten für Quellen, Gruppen, Benutzer oder Bots. Für jede Quelle lässt sich festlegen, ob nur auf ausdrückliche Anfragen reagiert wird, ob Ereignisse als Kandidaten gelten oder ob sie ignoriert werden.
- Slow Path (gründliche Prüfung durch das Modell): Nur Ereignisse, die den Schnellfilter passieren, werden an ein LLM übergeben. Es entscheidet anhand des Kontexts und einer als Eingabeaufforderung formulierten Richtlinie, ob es handeln soll.
Auch beim Routing gibt es einen schnellen und einen langsamen Weg. Aufeinanderfolgende Ereignisse zu demselben PR, IM-Thema oder derselben E-Mail-Kette bilden einen Thread. Sobald ein Worker diesen Thread abonniert hat, werden spätere Ereignisse per Code direkt an ihn weitergeleitet, ohne dass der Router erneut entscheiden muss. Abonnieren mehrere Worker denselben Thread, erhalten sie dieselben Benachrichtigungen und können Konflikte selbst erkennen und lösen.
Der Kontext wird ähnlich wie ein Cache verwaltet. Informationen, die bald benötigt werden, kommen direkt ins Kontextfenster (Inline). Selten benötigte vollständige Informationen bleiben ausserhalb des Fensters; darin stehen nur Verweise oder Zusammenfassungen (Spill). Der Artikel beschreibt ausserdem vorausschauendes Handeln: Der Agent prüft beispielsweise im Hintergrund den Kalender oder reproduziert ein Issue. Nur nützliche Ergebnisse werden weitergegeben, der Rest wird verworfen. So wird zusätzliche Rechenleistung eingesetzt, um Wartezeiten und menschliche Eingriffe zu reduzieren.
Modul drei: Vollduplex- und Mehrkanalinteraktion des DeepSeek-Superagenten
Vergleich: Beim Wasserkochen müssen Sie nicht neben dem Wasserkocher stehen. Sobald das Wasser kocht, gibt es ein Signal – und bis dahin können Sie sich mit anderen unterhalten.
Asynchrones ReAct ersetzt zeitaufwendige Aufrufe durch start() und stop(). start() kehrt sofort zurück, während das Tool im Hintergrund läuft. Nach Abschluss wird das Ergebnis als neues Ereignis an die Sitzung zurückgesendet. Das Modell kann mit stop() auch Befehle beenden, die zu lange laufen. Neue Eingaben lassen sich so bearbeiten, sobald der aktuelle Inferenzschritt abgeschlossen ist. Der Originaltext stellt klar: DeepSeek Harness hat diesen Mechanismus für asynchrone Aufgaben bereits implementiert, standardmässig aktiviert ist er aber noch nicht.
Mehrkanalinteraktion löst die Frage, wie kommuniziert wird. Im Instant Messenger sollten Nachrichten kurz und unaufdringlich sein; Benachrichtigungen gibt es nur, wenn eine Entscheidung oder Freigabe nötig ist. Eine vom Team erprobte feste Regel lautet: höchstens 100 Wörter pro Antwort. Auf GitHub, in E-Mails und Dokumenten sind dagegen strukturierte, informationsreiche Ausgaben gefragt – etwa eine klare Beschreibung von Hintergrund, Änderungen und Prüfergebnissen in einem PR.
Modul vier: Trennung von Rechenleistung, Zustand und Umgebung beim DeepSeek-Superagenten
Vergleich: Akten liegen im Firmenarchiv, sodass Mitarbeitende auch nach einem Arbeitsplatzwechsel weiterarbeiten können. Wird ein Tool auf einem bestimmten Rechner benötigt, schickt man jemanden dorthin, um es zu bedienen.
Der Artikel beschreibt die Entkopplung in zwei Schritten. Erstens läuft die Agentenschleife in zustandslosen Cloud-Containern, während der Sitzungszustand in einer Datenbank gespeichert wird. Ein Neustart oder Austausch des Containers unterbricht die Aufgabe dadurch nicht. Zweitens bleibt die Ausführungsumgebung an ihrem bisherigen Ort. Auf jedem Endpunkt läuft lediglich ein schlanker Daemon – ein kleines Hintergrundprogramm. Er speichert keinen Sitzungszustand, sondern führt nur Befehle aus und liefert die Ergebnisse zurück.
Dieses Design unterstützt auch BYOM („Bring Your Own Machine“): den Anschluss des eigenen Rechners an den Cloud-Agenten. So müssen nicht alle noch nicht committeten Änderungen und lokalen Zugangsdaten in die Cloud synchronisiert werden. Sobald das Gerät wieder online ist, kann der Cloud-Agent Aufgaben fortsetzen, die auf genau diesem Gerät ausgeführt werden müssen. Anthropics „Decoupling the brain from the hands“ verfolgt einen ähnlichen Ansatz und eignet sich als ergänzende Lektüre.
Modul fünf: Externe Überwachung des DeepSeek Super Agent durch den Watchdog
Vergleich: Eine Schichtleitung arbeitet nicht selbst mit, sondern prüft regelmässig, wer nicht weiterkommt und wer vom Kurs abweicht.
Viele Agent-Probleme äussern sich nicht als Absturz: Der Prozess läuft weiter, aber das Modell steckt in einer Schleife fest und liefert keine Ergebnisse. Herkömmliche Liveness-Probes erkennen das nicht. Der Watchdog ist eine unabhängige Sitzung ausserhalb des Hauptsystems, die durch zeitgesteuerte Nachrichten aktiviert wird. Er kümmert sich sowohl um Infrastrukturprobleme wie API-Fehler und fehlgeschlagene Zustandswiederherstellungen als auch um die Frage, ob die einzelnen Worker tatsächlich Fortschritte machen. Dafür nutzt er ein Modell. Verantwortliche können ihn in natürlicher Sprache fragen, warum etwas fehlgeschlagen ist, oder während des laufenden Betriebs Eingabeaufforderungen und Auslöseregeln anpassen lassen.
Wie weit lässt sich der Prototyp des DeepSeek Super Agent bereits ausprobieren?
Das zugehörige Repository github.com/deepseek-ai/dsh-superagent-prototype steht unter der MIT-Lizenz und hatte zum Abrufzeitpunkt am 2026-11-02 8.636 Stars und 863 Forks. Es handelt sich um einen Forschungsprototyp, nicht um ein offizielles DeepSeek-Produkt. Er entspricht weder der teaminternen Version noch der vollständigen, im Artikel beschriebenen Implementierung. Einige der beschriebenen Ansätze sind Zukunftspläne und im Prototyp noch nicht umgesetzt.
Der Prototyp ist ein proaktiver Programmier-Agent für ein einzelnes GitHub-Repository und als Bundle für DeepSeek Harness verpackt. Er überwacht GitHub und lässt sich optional mit Feishu verbinden. Wenn jemand ihm eine Aufgabe zuweist, legt er ein Arbeitselement an und bearbeitet es in einer eigenen Sitzung und einem eigenen Verzeichnis. Anschliessend antwortet er in der ursprünglichen Unterhaltung und reicht beispielsweise einen PR ein. Ein Web-Dashboard zeigt ausserdem Aufgaben an, die menschliche Aufmerksamkeit erfordern.
Was zeigen die beiden Experimente zum DeepSeek Super-Agent?
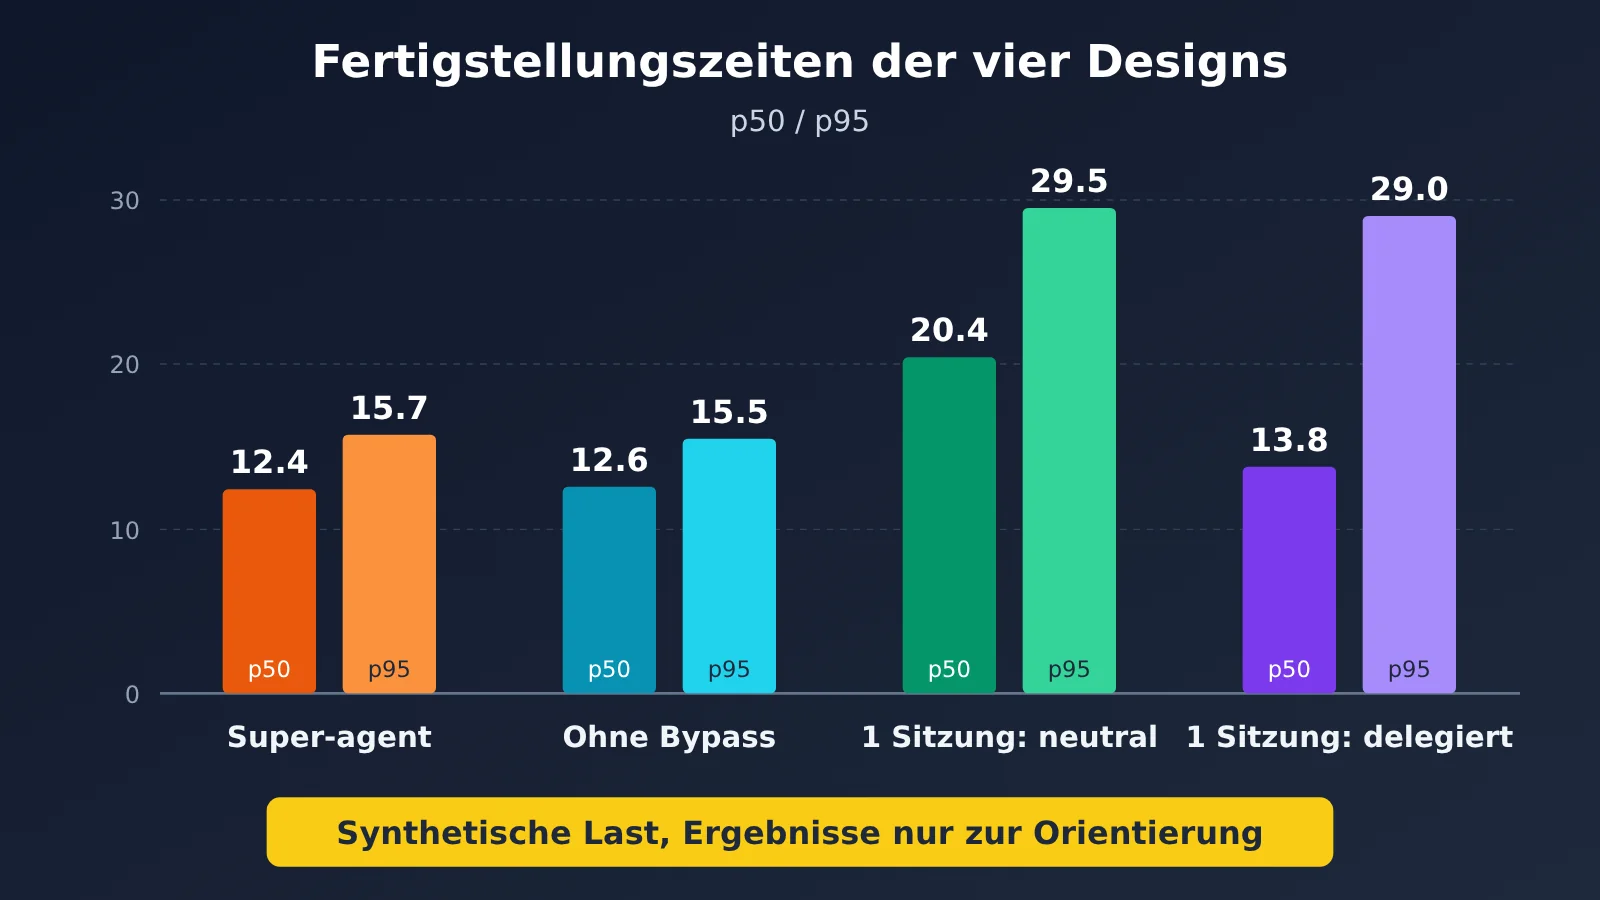
Die folgenden Daten stammen aus dem offiziellen Artikel. Die Experimente nutzen eine synthetische Arbeitslast und eine vereinfachte Umgebung. Laut den Autoren dienen die Ergebnisse nur zur Orientierung. Im ersten Experiment umfasste jeder Durchlauf etwa 300 Nachrichten, darunter rund 20 Arbeitsaufträge. Jede Architektur wurde fünfmal getestet. Die Programmierarbeit wurde mit Tools simuliert, die lediglich Zeit verbrauchten. Gemessen wurden also Planung und Koordination, nicht die Qualität der Aufgabenausführung.
In der Tabelle bedeutet p50, dass die Hälfte der Aufgaben innerhalb dieser Zeit abgeschlossen wurde. Bei p95 sind es 95 %. Cache-Read-Tokens sind Tokens, die aus dem Cache gelesen werden: Bereits gespeicherter Kontext wird direkt wiederverwendet, statt erneut verarbeitet zu werden. Angegeben ist jeweils die Summe über alle Sitzungen.
| Architektur | p50 (Minuten) | p95 (Minuten) | Cache-Read-Tokens / Durchlauf |
|---|---|---|---|
| Super-Agent | 12,4 | 15,7 | 23,2 Mio. |
| Ohne Pass-through (direkte Weiterleitung von Abonnements) | 12,6 | 15,5 | 31,8 Mio. |
| Einzelsitzung + Sub-Agent (neutrale Eingabeaufforderung) | 20,4 | 29,5 | 6,1 Mio. |
| Einzelsitzung + Sub-Agent (Eingabeaufforderung mit Delegationsvorrang) | 13,8 | 29,0 | 10,8 Mio. |
Mit der neutralen Eingabeaufforderung rief das Modell in keinem der fünf Durchläufe einen Sub-Agent auf. Mit der Eingabeaufforderung, die Delegation bevorzugte, delegierte es in vier von fünf Fällen. Im fünften hielt das Modell die Aufgabe für klein genug, um sie selbst zu erledigen. Bei dieser Arbeitslast hängt die Leistung einer Einzelsitzung also stark von der Eingabeaufforderung und der situativen Einschätzung des Modells ab. Die zweistufige Architektur verankert die Delegation dagegen auf Systemebene. Der Preis dafür ist ebenfalls klar: Der Super-Agent verbraucht deutlich mehr Cache-Read-Tokens und tauscht damit Tokens gegen kürzere und stabilere Abschlusszeiten.
Ohne direkte Weiterleitung blieb die Abschlusszeit nahezu unverändert, aber die Zahl der Router-Entscheidungen stieg um rund 30 %, die der Cache-Read-Tokens um rund 37 %. Bei dieser Arbeitslast sorgte die direkte Weiterleitung also nicht für mehr Tempo; ihr Hauptnutzen lag darin, den Router zu entlasten.
Im zweiten Experiment wurde die Router-Ebene separat einem Lasttest unterzogen: Der Router nutzte ein echtes Modell, die Worker ein simuliertes Modell. Dabei wurde die Ankunftsrate der Trigger, die eine Router-Entscheidung erfordern, schrittweise erhöht.
| Ankunftsrate (pro Minute) | Durchschnittliche Batch-Größe | Zeit pro Anfrage | Umgelegte Inferenzzeit pro Entscheidung |
|---|---|---|---|
| ca. 1 | 1,0 | 2,5 Sekunden | 6,4 Sekunden |
| ca. 40 | 2,8 | 3,9 Sekunden | 1,6 Sekunden |
Eine Entscheidung kann mehrere LLM-Anfragen umfassen. Deshalb kann die umgelegte Zeit größer sein als die Zeit pro einzelner Anfrage. Die Daten stützen folgende Schlussfolgerung: Wenn viele Ereignisse gleichzeitig eintreffen, kann die automatische Zusammenfassung den effektiven Durchsatz des Routers erhöhen. Sie belegen aber weder, dass die Ergebnisse in einer echten Produktionsumgebung gleich ausfallen, noch geben sie Aufschluss über die Aufgabenqualität oder die Leistung bei unterschiedlichen Codebasen.
Vier offene Fragen zum Super-Agent von DeepSeek
Der Artikel räumt ausdrücklich ein, dass die folgenden Fragen noch ungeklärt sind. Bei der Bewertung konkreter Umsetzungslösungen sollten sie deshalb berücksichtigt werden:
- Wie lässt sich die Architektur skalieren? Bei größeren, enger gekoppelten Aufgaben ist offen, ob und wie fein der Router aufgeteilt werden sollte und wann Worker direkt miteinander kommunizieren sollten. Je feiner die Aufteilung, desto mehr Aufgaben lassen sich parallel bearbeiten – allerdings stehen dann weniger gemeinsamer Speicher und Kontext zur Verfügung. Auch das Langzeitgedächtnis ist ein wesentlicher Engpass.
- Wie funktioniert die Nutzung ohne Sitzungen? Wie Aufgaben dargestellt werden und wie Menschen bei wichtigen Details eingreifen können, ohne die Arbeit im Hintergrund zu unterbrechen, erfordert neue Formen der Interaktion.
- Kontextgrenzen und A2A: A2A (Agent-to-Agent) bezeichnet allgemein die Kommunikation und Zusammenarbeit zwischen verschiedenen Agents. Wenn eine Organisation wächst, legt die Konfiguration eines Super-Agents im Grunde fest, welche Kontexte geteilt und welche voneinander getrennt werden. Wie eine sichere Zusammenarbeit über Berechtigungsgrenzen hinweg gelingt, ist noch ungeklärt.
- Sicherheit und Datenschutz: Dieser Punkt sollte vorrangig geprüft werden. Die Cloud-Schleife empfängt fortlaufend externe Ereignisse, während die Endgeräte privaten Code und lokale Zugangsdaten vorhalten. Wird der Server kompromittiert oder die Schleife durch Prompt Injection – also in Eingaben versteckte bösartige Anweisungen – angegriffen, könnten alle verbundenen Endgeräte übernommen werden. Laut Artikel brauchen Agents eine Möglichkeit, Zugangsdaten zu verwenden, ohne sie einsehen zu können.
Minimale Umsetzungsliste für DeepSeek-Superagenten in kleinen Teams
Die folgende Reihenfolge ist unsere Empfehlung auf Grundlage des Originalartikels, kein offizieller Fahrplan. Starten Sie mit einem Pilotprojekt in einem einzelnen Repository und innerhalb eines vertrauenswürdigen Umfelds. Auf Router-Sharding können Sie zunächst verzichten.
Schritt 1: Router und Worker trennen
- Code: Richten Sie einen dauerhaft verfügbaren Router als Einstiegspunkt ein, ohne ihm ein Bash-Tool zu geben. Starten Sie für jede Aufgabe einen eigenen Worker mit separatem Kontext und Arbeitsverzeichnis. Worker melden ihre Ergebnisse nur an den Router.
- Modelle: Verwenden Sie für den Router ein leichtgewichtiges und für die Worker ein leistungsfähigeres Modell. Konfigurieren Sie beide getrennt, damit sie sich unabhängig voneinander austauschen lassen.
- Menschen: Kommunizieren Sie nur mit dem Router. Sie legen die Grenzen der Aufgaben fest, treffen angeforderte Entscheidungen und erteilen die endgültige Freigabe.
Schritt 2: Trigger-Filter hinzufügen
- Code: Konfigurieren Sie eine Quellen-Allowlist und eine Richtlinie mit drei Stufen. Ordnen Sie PRs und IM-Themen jeweils einem Thread zu. Folgeereignisse aus bereits abonnierten Threads werden direkt an den Worker weitergeleitet.
- Modelle: Lassen Sie nur Kandidatenereignisse semantisch prüfen: Muss gehandelt werden und ist ein neuer Worker nötig?
- Menschen: Legen Sie in einer Eingabeaufforderung klar fest, wann gehandelt werden soll. Prüfen Sie regelmässig stichprobenartig auf Fehlauslösungen und übersehene Ereignisse und passen Sie Allowlist und Richtlinie entsprechend an.
Schritt 3: Watchdog hinzufügen
- Code: Betreiben Sie ihn ausserhalb des Hauptsystems und steuern Sie ihn über zeitgesteuerte Nachrichten. Er prüft Infrastrukturprobleme wie API-Fehler oder eine fehlgeschlagene Wiederherstellung des Zustands.
- Modelle: Lassen Sie die Fortschrittsprotokolle der Worker auswerten, um zu erkennen, ob sie tatsächlich vorankommen, feststecken oder vom Ziel abweichen.
- Menschen: Legen Sie die Reparaturberechtigungen des Watchdogs fest, genehmigen Sie seine Änderungen an Eingabeaufforderungen und Trigger-Regeln und analysieren Sie die Ursachen von Fehlern.
Vermeiden Sie von Anfang an, Zugangsdaten für die Produktionsumgebung direkt in den Modellkontext zu übernehmen, und vergeben Sie nur die unbedingt nötigen Berechtigungen. Mit asynchronen Tool-Aufrufen und der Trennung von Rechenressourcen können Sie warten, bis die ersten drei Schritte stabil laufen und tatsächlich Blockaden oder Offline-Geräte zum Problem werden.
Modellkombination und Kostenschätzung für einen DeepSeek-Superagenten
Die folgende Tabelle zeigt die am 02.11.2026 abgefragten Modelle von APIYI · apiyi.com. Die Preise gelten in $/1 Mio. Tokens. Maßgeblich für Modelle und Preise ist die Modellliste der Plattform; die tatsächliche Abrechnung ist in der Konsole einsehbar.
| Modell | Eingabe | Ausgabe | Cache-Lesezugriffe |
|---|---|---|---|
| deepseek-v4.1-flash | 0,3 | 1,2 | 0,006 |
| deepseek-v4-flash | 0,44 | 1,32 | 0,01408 |
| deepseek-v4-pro | 1,32 | 3,96 | 0,043996 |
| claude-opus-5-5 | 4 | 20 | 0,2 |
Alle folgenden Angaben sind Schätzungen auf Basis der veröffentlichten Preise, keine Messwerte. Angenommen, ein Aufruf verbraucht 20.000 Eingabe- und 2.000 Ausgabe-Tokens; Cache-Zugriffe bleiben zunächst unberücksichtigt:
deepseek-v4.1-flashkostet etwa $0,0084,deepseek-v4-proetwa $0,0343 undclaude-opus-5-5etwa $0,12.- Je ein Aufruf mit
deepseek-v4.1-flashals Router unddeepseek-v4-proals Worker kostet zusammen etwa $0,0427. Mitclaude-opus-5-5für beide sind es etwa $0,24 – rund das 5,6-Fache. - Bei 20 solchen Durchläufen pro Tag kostet die Kombination etwa $0,85, der ausschliessliche Einsatz von
claude-opus-5-5etwa $4,8. In der Praxis benötigt ein Worker oft mehr als eine Aufrufrunde. Rechnen Sie deshalb mit den Token-Zahlen aus Ihren eigenen Logs nach.
Bei Systemen mit langer Laufzeit müssen Sie auch Cache-Lesezugriffe separat einrechnen. Bei den im Experiment angefallenen 23,2 Mio. Cache-Read-Tokens ergäben sich ausschliesslich mit deepseek-v4.1-flash etwa $0,14, mit deepseek-v4-pro etwa $1,02 und mit claude-opus-5-5 etwa $4,64. Das dient nur zur Orientierung: Das Experiment hat weder die Token-Verteilung auf die einzelnen Ebenen veröffentlicht, noch sind hier Eingabe- und Ausgabekosten enthalten.
Die Modelle für Router und Worker sollten sich am besten konfigurieren lassen. Über APIYI · apiyi.com können Sie mit einem API-Schlüssel zwischen diesen Modellen wechseln. Die base_url der OpenAI-kompatiblen Schnittstelle lautet https://api.apiyi.com/v1. Beim Wechsel passen Sie hauptsächlich den Modellnamen an und können so Qualität und Kosten mit denselben Aufgaben vergleichen. Der Preis ist aber nur ein Teil der Modellauswahl: Für das Standardmodell des Workers zählen auch die Erfolgsquote und der Nachbearbeitungsaufwand.
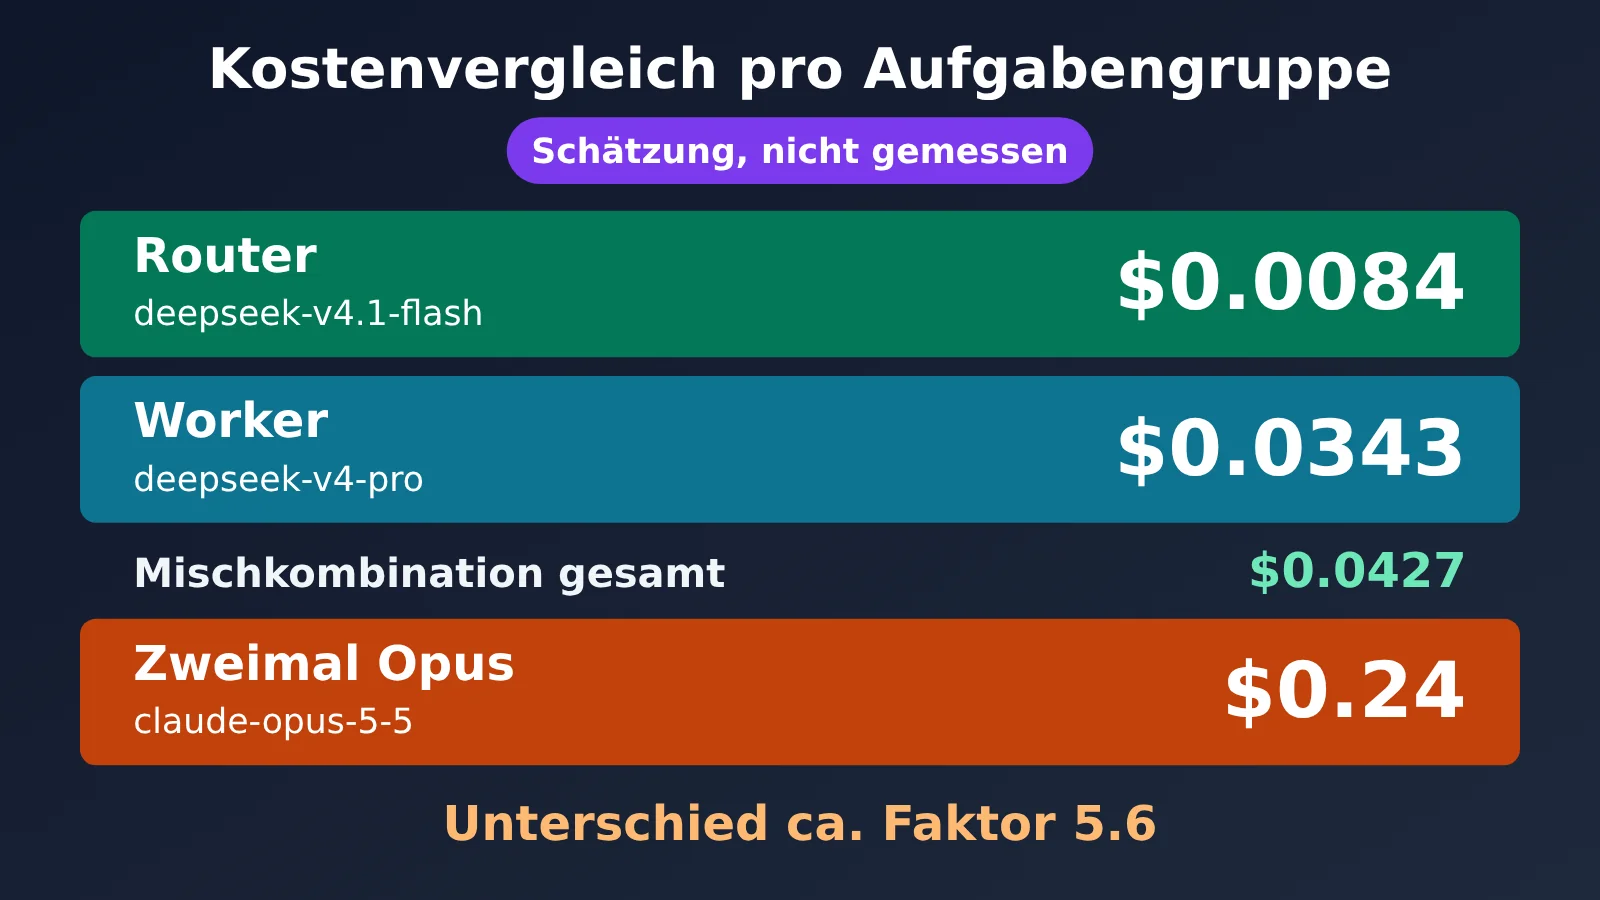
Die Grafik basiert auf den Standardpreisen der Modellliste von APIYI · apiyi.com. Ersetzen Sie die Token-Mengen durch Ihren eigenen Verbrauch, bevor Sie Ihr Budget planen.
Häufige Fragen zum DeepSeek Super-Agent
F1: Ist das ein neues Modell?
Nein. Der Artikel behandelt die Architektur eines Agent-Systems. Im Mittelpunkt steht, wie das umgebende System Sitzungen, Ereignisse, Zustände und Monitoring organisiert. Ein neues Modell wurde nicht veröffentlicht.
F2: Können Entwickler das direkt nutzen?
Die fünf Module sind keine sofort nutzbaren Funktionen. Derzeit können Entwickler den Forschungsprototyp ausprobieren oder anhand der Ideen aus dem Artikel selbst ein System aufbauen. Die einzige im Original ausdrücklich erwähnte bestehende Implementierung ist der Mechanismus für asynchrone Aufgaben in DeepSeek Harness – und der ist standardmässig nicht aktiviert.
F3: Ist dsh-superagent-prototype ein offizielles Produkt?
Nein. Laut README dient es ausschliesslich als Forschungsreferenz. Es ist weder ein offizielles DeepSeek-Produkt noch entspricht es der internen Version oder der im Artikel beschriebenen vollständigen Implementierung.
F4: Sind mehrere Agents teurer?
In dieser Versuchsreihe wurden tatsächlich mehr Token aus dem Cache gelesen: 23,2 Millionen beim Super-Agent gegenüber 6,1 bis 10,8 Millionen bei der Lösung mit einer einzigen Sitzung. Dafür waren die Bearbeitungszeiten kürzer und stabiler. Die tatsächlichen Gesamtkosten hängen auch von der Modellkombination und dem Umfang der Aufgabe ab. Ein leichtgewichtiges Modell für den Router und die direkte Thread-Durchleitung helfen, die Kosten zu begrenzen.
F5: Wie lassen sich diese Modelle in China anbinden?
Sie können sich bei APIYI · apiyi.com registrieren und einen API-Schlüssel erhalten. Neue Nutzer bekommen ein kostenloses Testguthaben. Ändern Sie anschliessend die `base_url` des Clients auf die oben genannte Adresse und tragen Sie die Modellbezeichnung aus der Tabelle im Modellparameter ein. Diese DeepSeek- und Claude-Modelle unterstützen die Endpunkte `chat` und `messages`. Vor dem Produktivbetrieb empfiehlt sich ein Test mit geringem Anfragevolumen.
Zusammenfassung
Der Wert des Artikels über DeepSeek Super Agent liegt darin, dass er klassische Ansätze des Systems Engineering auf Agenten überträgt. Die wichtigsten Erkenntnisse:
- Problemstellung: Bei einzelnen Aufgaben benötigen Modelle immer weniger menschliche Unterstützung. Bei mehreren Aufgaben gleichzeitig wird zunehmend die menschliche Aufmerksamkeit zum Engpass.
- Fünf Module: Eine zweistufige Architektur, Ereignissteuerung, mehrere Vollduplex-Kanäle, die Trennung von Rechenleistung, Zustand und Umgebung sowie ein Watchdog sollen vier Eigenschaften ermöglichen: Kontinuität, Effizienz, Eigeninitiative und Dauerhaftigkeit.
- Grenzen der Ergebnisse: Beide Versuchsreihen beruhen auf synthetischen Lasttests, deren Ergebnisse die Autoren selbst berichtet haben. Sie eignen sich daher nur als Orientierung für das Design.
- Reihenfolge bei der Umsetzung: Zuerst Router und Worker trennen, dann Trigger zur Filterung ergänzen und zuletzt einen Watchdog hinzufügen. Sicherheitsgrenzen haben dabei von Anfang an Vorrang.
Die Modellkombination muss nicht von Anfang an feststehen. Über APIYI · apiyi.com lassen sich verschiedene Konfigurationen zunächst mit denselben Aufgaben im kleinen Rahmen vergleichen. Anschliessend kann die Wahl anhand von Erfolgsquote und Kosten fallen.
Ersetzen Sie sich zuerst selbst als „menschlichen Router“, bevor Sie weitere Agenten hinzufügen.
Autor: APIYI Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Weitere Informationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.