11 月 1 日,DeepSeek Harness 团队在 X 发布长文《探索超级智能体设计》,讨论超级智能体(Super-agent)架构。发布约 15 小时后,这篇文章已有约 130 万浏览、9.4K 赞。这是架构理念文章,不是产品功能介绍。
一句话结论: 这套设计让系统接管会话管理,用户只面对一个入口。Router(前台调度)负责接待和派活,Worker(后台干活的会话)并行执行任务,人只做高层决策和最终签核。
DeepSeek 超级智能体为什么要跳出单会话
现在的主流 Agent 仍以单个会话为工作单位。用户同时跑多个任务时,要手动切会话、记上下文。DeepSeek Harness 团队的经验是,一个人通常一次只能处理 3 到 5 个活跃会话。这个数字是团队经验,不是普遍统计,但它指出了一个瓶颈:单个任务受模型能力限制,多任务受人的注意力限制。
给本地 Agent 加命令行工具和外部连接器,只能让它收到外部消息,三个限制依然存在:
- 同步阻塞: 经典 ReAct(边想边调工具的循环)遇到耗时操作会等待,期间无法响应新消息。
- 上下文串味: 不同任务的中间细节混在同一个窗口里,互相干扰。
- 设备绑定: 本地设备一旦休眠或离线,Agent 就停止工作。
文章因此提出,把 Agent 与任何单个手动驱动的会话解耦,让它成为一个连续实体。它要同时具备下面四个特征,而单个 ReAct 循环做不到,必须依靠外围系统架构。
| 超级智能体特征 | 大白话 | 主要靠哪个模块 |
|---|---|---|
| 连续 | 在 IM、GitHub 里交流,始终像同一个 Agent | 双层架构、多通道交互 |
| 高效 | 上一条命令没结束也能接新指令,多任务并行 | 双层架构、全双工交互 |
| 主动 | 监听环境事件,值得处理才行动 | 事件驱动 |
| 持久 | 始终在线,出异常能自动恢复 | 算力与状态分离、Watchdog |
DeepSeek 超级智能体五大模块逐个拆
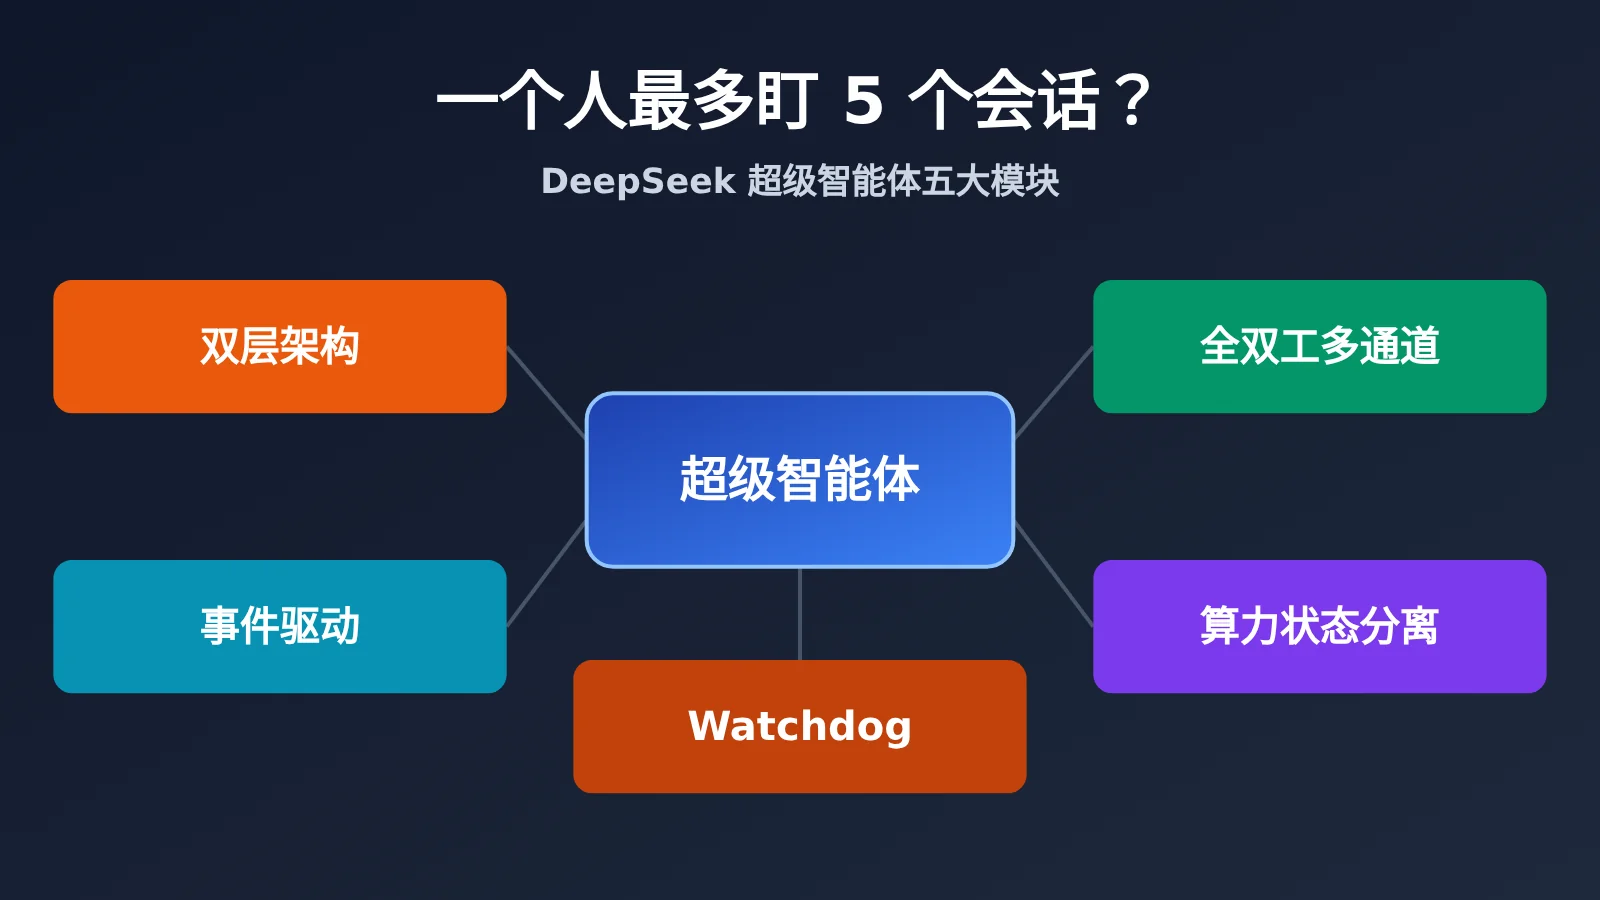
先看总表。“现在能不能用”这一列最值得注意,因为文章讲的是设计方向,不等于现成功能。
| 模块 | 解决什么问题 | 关键做法 | 现在能不能用 |
|---|---|---|---|
| 双层架构 | 连续性和并发难以兼顾 | Router 只交互和派活,Worker 隔离执行 | 原型有相近流程,完整设计需自建 |
| 事件驱动 | Agent 只能等指令,事件噪声大 | 代码快筛,模型慢判,Thread 订阅直通 | 原型可监听 GitHub,可选飞书 |
| 全双工多通道 | 长任务阻塞对话,日志打扰人 | 异步工具调用,按渠道定回复规范 | DeepSeek Harness 已实现异步任务,默认未开启 |
| 算力、状态与环境分离 | 设备离线就停,够不到其他环境 | 云上跑循环,数据库存状态,端点留原地 | 原文未说明已对外提供,需自建 |
| Watchdog | 进程还在,任务却卡住或跑偏 | 主系统外的独立会话定时巡检 | 原文未说明已对外提供,需自建 |
模块一:DeepSeek 超级智能体的 Router/Worker 双层架构
类比: Router 像餐厅前台,只接待和传单;Worker 像后厨,每个灶台只做一道菜。
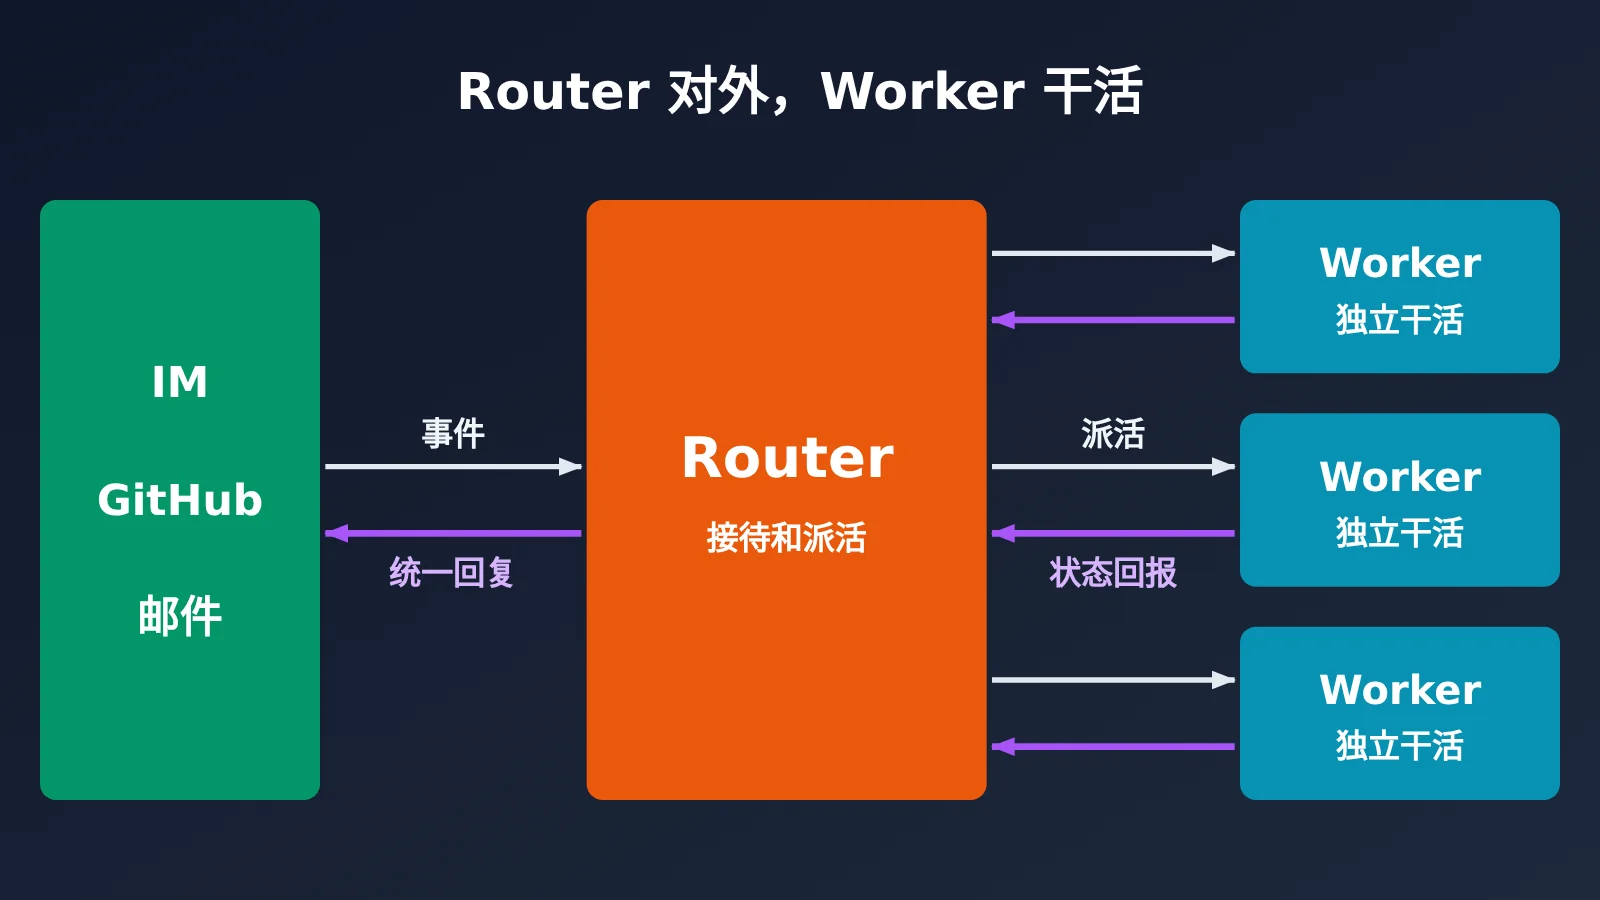
所有事件都进一个会话,上下文最连续,但吞吐低;每个事件都开新会话,并发高,却缺少全局上下文,还会出现多个会话分别回复用户的混乱。双层架构把这两件事拆开:长期在线的 Router 负责人类交互和全局协调,甚至可以完全没有 Bash 工具;Worker 上下文隔离,每个只管一个任务,不直接对外发言,状态统一报给 Router。原文的意思是,会话应该成为系统的实现细节,而不是用户的心智负担。
Router 看起来容易成为瓶颈,但一个推理轮次内到达的 Trigger(环境里的事件)会排队,并在下一轮合并处理。它的请求通常输入长、输出短,合并后的事件在 Prefill(模型处理输入的前半段)阶段并行计算,所以单请求时间增长得比批量慢。团队经验是,Router 的工作往往比想象中简单,轻量模型通常就够用。落地时可以先通过 API易 · apiyi.com 接入 deepseek-v4.1-flash 试跑 Router,观察它的派发准确度。
Worker 直接决定任务结果和代码质量,所以原文认为通常要用最强的模型。可以在 API易 · apiyi.com 上用同一批任务对比 deepseek-v4-pro 和 claude-opus-5-5,再决定默认模型。
模块二:DeepSeek 超级智能体的 Trigger 事件驱动
类比: 门卫先按名单拦人,拿不准的再请经理判断;老客户的后续事项直接转给原来的负责人。
Agent 要主动工作,主要输入就得从人工 prompt 变成环境事件,比如群聊消息、CI 结果和代码 review 评论。真实事件流噪声很大,每条都交给大模型判断,延迟和算力都受不了。文章因此设计了两层过滤:
- Fast Path(代码快筛): 按来源、群、用户或机器人白名单做确定性检查,每个来源可设“只响应明确请求”“当作候选事件”或“忽略”。
- Slow Path(模型慢判): 通过快筛的候选事件才交给 LLM,由它结合上下文和用 prompt 写的策略决定是否行动。
路由也分快慢。同一个 PR、IM 话题或邮件链上的连续事件构成一个 Thread,Worker 订阅后,后续事件由代码直接透传,不必再经 Router 决策。多个 Worker 订阅同一 Thread 时,会收到相同通知,有机会自行发现并解决冲突。
上下文则按缓存来管理。很快要用的信息直接放进窗口(Inline),很少用的完整信息留在窗口外,只留引用或摘要(Spill)。文章还提到提前行动:在后台先查日历、复现 issue,有用的结果才交付,其余丢弃,用额外算力换取人的等待和介入减少。
模块三:DeepSeek 超级智能体的全双工多通道交互
类比: 烧水时不用站在壶边,水开了会有提示,这期间你可以继续和别人说话。
异步 ReAct 把耗时调用换成 start() 和 stop()。start() 立即返回,工具在后台运行,完成后结果作为新事件送回会话;模型也可以用 stop() 结束跑得太久的命令。这样,用户的新输入在当前推理步骤结束后就能处理。原文明确说,DeepSeek Harness 已经实现这种异步任务机制,但尚未默认开启。
多通道解决的是“怎么说话”。IM 上要轻量、少打扰,只在需要决策或签核时通知,团队验证过的一条硬规则是每条回复不超过 100 词。GitHub、邮件和文档则需要结构化、高信息密度的输出,比如在 PR 中写清问题背景、改动说明和验证结果。
模块四:DeepSeek 超级智能体的算力、状态与环境分离
类比: 档案放进公司的档案室,员工换工位也能接着干;需要用哪台机器上的工具,就派人去那台机器上操作。
文章分两步解耦。第一步,Agent 循环跑在无状态的云容器里,会话状态存数据库,容器重启或替换都不影响任务连续。第二步,执行环境留在原地,每个端点只装一个轻量 daemon(常驻后台的小程序),它不保存会话状态,只负责执行命令和返回结果。
这一设计还支持 BYOM(Bring Your Own Machine,把自己的电脑接到云端 Agent)。这样不必把未提交改动和本地凭据全部同步到云上,设备重新上线后,云端 Agent 还能继续完成需要在那台设备上跑的任务。Anthropic 的 “Decoupling the brain from the hands” 也采用了类似的解耦思路,可以对照阅读。
模块五:DeepSeek 超级智能体的 Watchdog 外部巡检
类比: 值班主管不参与具体工作,定时巡查谁停工了、谁跑偏了。
很多 Agent 异常并不是崩溃,而是进程还在,模型却卡在无产出的循环里,传统存活探针发现不了。Watchdog 是跑在主系统之外的独立会话,由定时消息驱动。它既处理 API 错误、状态恢复失败等基础设施故障,也用模型判断每个 Worker 是否在实质推进。维护人员可以用自然语言问它“为什么失败”,也可以让它在系统运行时调整 prompt 和触发规则。
DeepSeek 超级智能体原型现在能试到什么程度
配套仓库是 github.com/deepseek-ai/dsh-superagent-prototype,采用 MIT 协议,2026-11-02 抓取时有 8,636 stars、863 forks。它是研究原型,不是 DeepSeek 官方产品,也不等同于团队内部版本或文章描述的完整实现,文中部分设计属于未来方向,原型并未实现。
原型是一个面向单个 GitHub 仓库的主动式编程 Agent,打包成 DeepSeek Harness 的 bundle。它监听 GitHub,也可选接飞书;有人派活时就开工作项,在自己的会话和目录中完成,最后回到原对话回复,比如提交 PR。另有网页面板显示需要人处理的事项。
DeepSeek 超级智能体的两组实验数据说明了什么
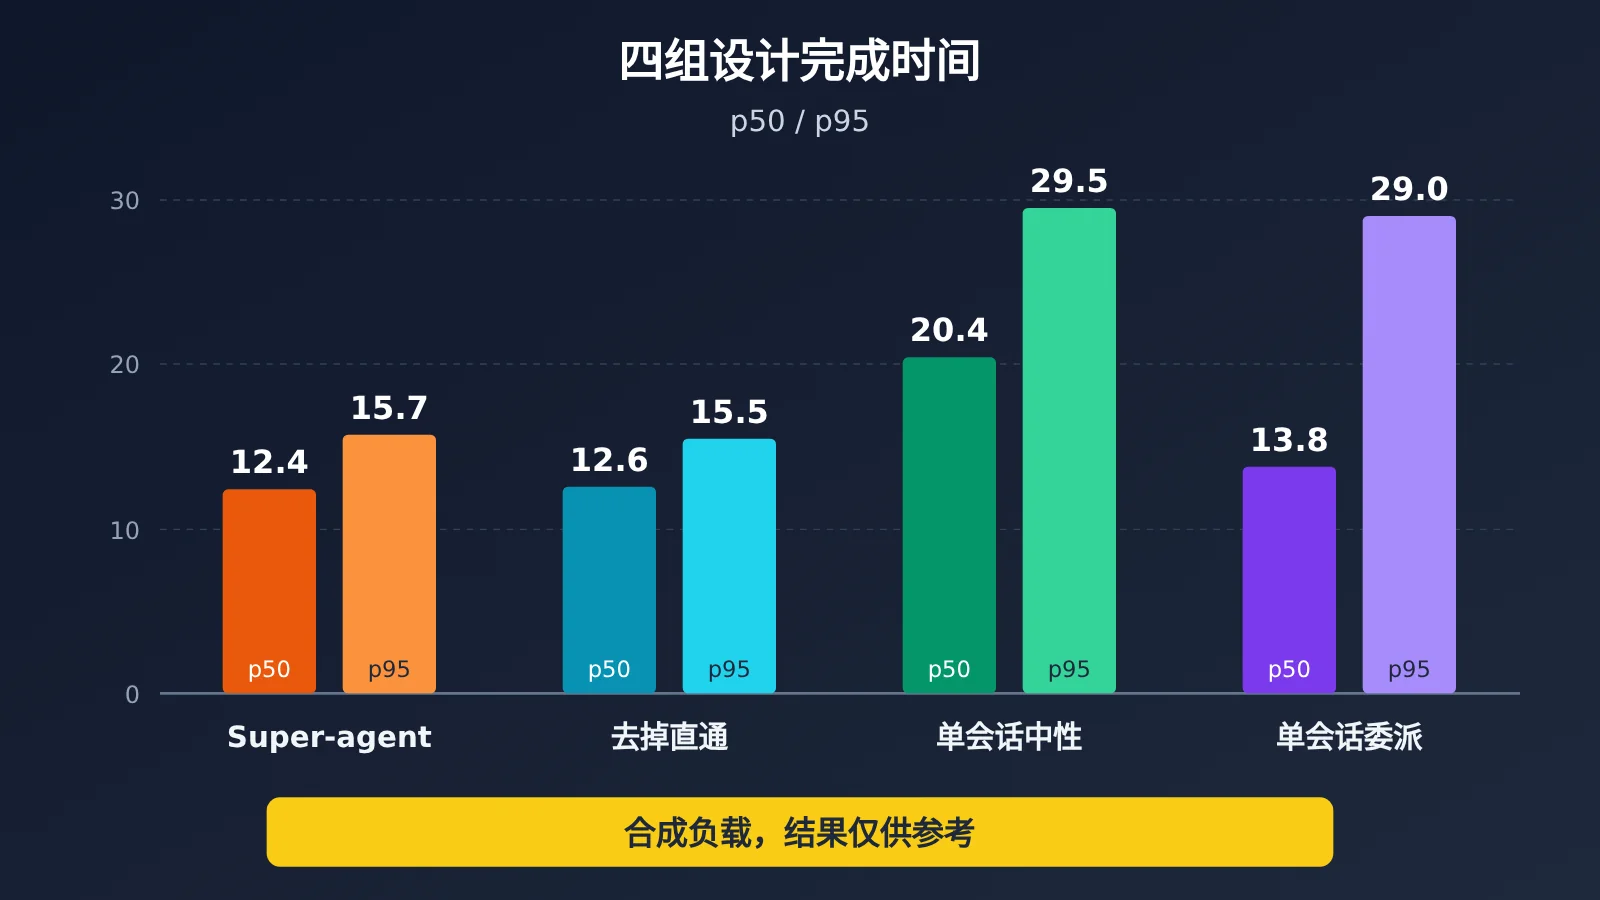
以下数据均为官方文章自报,实验采用合成负载、简化环境,作者说结果仅供参考。第一组实验的每次运行约 300 条消息,其中约 20 个工作请求,每种设计重复 5 次。编码工作用只消耗时间的工具模拟,所以它测的是调度和协调,不是任务执行质量。
表中的 p50 指一半任务在该时间内完成,p95 指 95% 的任务在该时间内完成。cache-read tokens 是缓存读(直接复用已缓存上下文,不重新处理)的 token 数,这里是所有会话的合计。
| 设计 | p50(分钟) | p95(分钟) | cache-read tokens / 次 |
|---|---|---|---|
| Super-agent | 12.4 | 15.7 | 23.2M |
| 去掉 Pass-through(订阅直通) | 12.6 | 15.5 | 31.8M |
| 单会话 + 子 Agent(中性提示) | 20.4 | 29.5 | 6.1M |
| 单会话 + 子 Agent(委派优先提示) | 13.8 | 29.0 | 10.8M |
中性提示下,模型 5 次运行都没有调用子 Agent。委派优先提示下,5 次中有 4 次委派,另一次模型认为活小而自己做了。这说明在这个负载下,单会话的表现高度依赖 prompt 和模型的临场判断,而双层架构把委派固化到了系统层。代价也很清楚:Super-agent 的缓存读消耗明显更高,是用 token 换更短、更稳定的完成时间。
去掉直通后,完成时间几乎不变,但 Router 决策数多约 30%,cache-read tokens 多约 37%。所以在这个负载下,直通没有提速,主要作用是降低 Router 的开销。
第二组实验单独压测 Router 层:Router 调真实模型,Worker 用模拟模型,逐步提高需要 Router 决策的 Trigger 到达率。
| 到达率(次/分钟) | 平均批大小 | 单请求时间 | 每决策分摊推理时间 |
|---|---|---|---|
| 约 1 | 1.0 | 2.5 秒 | 6.4 秒 |
| 约 40 | 2.8 | 3.9 秒 | 1.6 秒 |
一个决策可能包含多次 LLM 请求,所以分摊时间可能大于单请求时间。这组数据支持的结论是:事件突发时,自动合并能提高 Router 的有效吞吐。但它不能证明真实生产环境也有同样的结果,也无法说明任务质量和不同代码库下的表现。
DeepSeek 超级智能体的四个开放问题
文章明确承认以下问题尚未解决,评估落地方案时应当把它们算进去:
- 架构如何扩展: 任务更大、耦合更紧时,Router 该不该分片、分多细,Worker 何时该直接通信,都没有定论。分片越细,并发越高,但共享记忆和上下文越少,长期记忆也是主要瓶颈。
- 没有会话后怎么用: 任务如何呈现、人如何在不打断后台工作的前提下干预关键细节,还需要新的交互方式。
- 上下文边界与 A2A: A2A(agent-to-agent)泛指不同 Agent 之间的沟通协作。组织变大后,配置 Super-agent 实际上是在决定哪些上下文共享、哪些隔离,跨权限边界如何安全协作尚无答案。
- 安全与隐私: 这是最需要优先评估的一项。云端循环持续接收外部事件,端点又持有私有代码和本地凭据;服务端被入侵或循环被 prompt injection(藏在输入里的恶意指令)攻破时,连着的端点都可能被接管。文章认为,Agent 需要一种“用得到凭据但看不见凭据”的方式。
DeepSeek 超级智能体小团队最小落地清单
下面的顺序是我们基于原文思路给出的建议,并非官方路线。先在单个仓库、可信范围内试点,暂时不做 Router 分片。
第一步:先拆 Router/Worker
- 代码: 建一个长期在线的 Router 入口,不给它 Bash 工具;每个任务开独立 Worker,配独立上下文和工作目录;Worker 的结果只报给 Router。
- 模型: Router 用轻模型,Worker 用能力更强的模型,两者分开配置,便于单独替换。
- 人: 只和 Router 对话,负责定义任务边界、处理决策请求和最终签核。
第二步:再加 Trigger 过滤
- 代码: 配置来源白名单和三档策略,把 PR、IM 话题映射为 Thread,已订阅的后续事件直接透传给 Worker。
- 模型: 只对候选事件做语义判断,判断是否行动、是否新开 Worker。
- 人: 用 prompt 写清行动条件,定期抽查误触发和漏触发,再调整白名单和策略。
第三步:最后加 Watchdog
- 代码: 把它部署在主系统之外,用定时消息驱动,检查 API 错误、状态恢复失败等基础设施问题。
- 模型: 读取 Worker 的进展记录,判断它是在实质推进、卡住还是偏离目标。
- 人: 设定 Watchdog 的修复权限,审批它对 prompt 和触发规则的修改,并复盘失败原因。
从第一天起就应避免把生产凭据直接放进模型上下文,权限也要按最小范围配置。异步工具调用和算力分离可以等前三步跑稳,并确实遇到阻塞或设备离线问题时再做。
DeepSeek 超级智能体的模型搭配与成本估算
下表是 2026-11-02 查询的 API易 · apiyi.com 型号表,单位为 $/1M tokens。型号与价格以平台型号列表为准,实际扣费以控制台为准。
| 型号 | 输入 | 输出 | 缓存读 |
|---|---|---|---|
| deepseek-v4.1-flash | 0.3 | 1.2 | 0.006 |
| deepseek-v4-flash | 0.44 | 1.32 | 0.01408 |
| deepseek-v4-pro | 1.32 | 3.96 | 0.043996 |
| claude-opus-5-5 | 4 | 20 | 0.2 |
以下均为按公开价计算的估算,不是实测。假设一次调用消耗输入 2 万 tokens、输出 2 千 tokens,暂不计缓存:
deepseek-v4.1-flash约 $0.0084,deepseek-v4-pro约 $0.0343,claude-opus-5-5约 $0.12。- Router 用
deepseek-v4.1-flash、Worker 用deepseek-v4-pro各跑一次,合计约 $0.0427;两边都用claude-opus-5-5约 $0.24,约为前者的 5.6 倍。 - 如果每天按这个用量跑 20 组,混合搭配约 $0.85,全用
claude-opus-5-5约 $4.8。真实 Worker 往往不止一轮调用,应换成自己日志里的 token 数重算。
长跑系统还要单独算缓存读。按实验中的 23.2M cache-read tokens 估算,全部按 deepseek-v4.1-flash 计约 $0.14,按 deepseek-v4-pro 计约 $1.02,按 claude-opus-5-5 计约 $4.64。这只是量级参考,实验并未公开各层 token 分布,也不包含输入和输出费用。
Router 和 Worker 的模型最好做成配置项。通过 API易 · apiyi.com,可以用一个 API Key 切换这些模型,OpenAI 兼容接口的 base_url 为 https://api.apiyi.com/v1,切换时主要改模型名,便于用同一批任务比较质量和成本。价格只是选型的一半,Worker 的默认模型仍要看任务成功率和返工量。
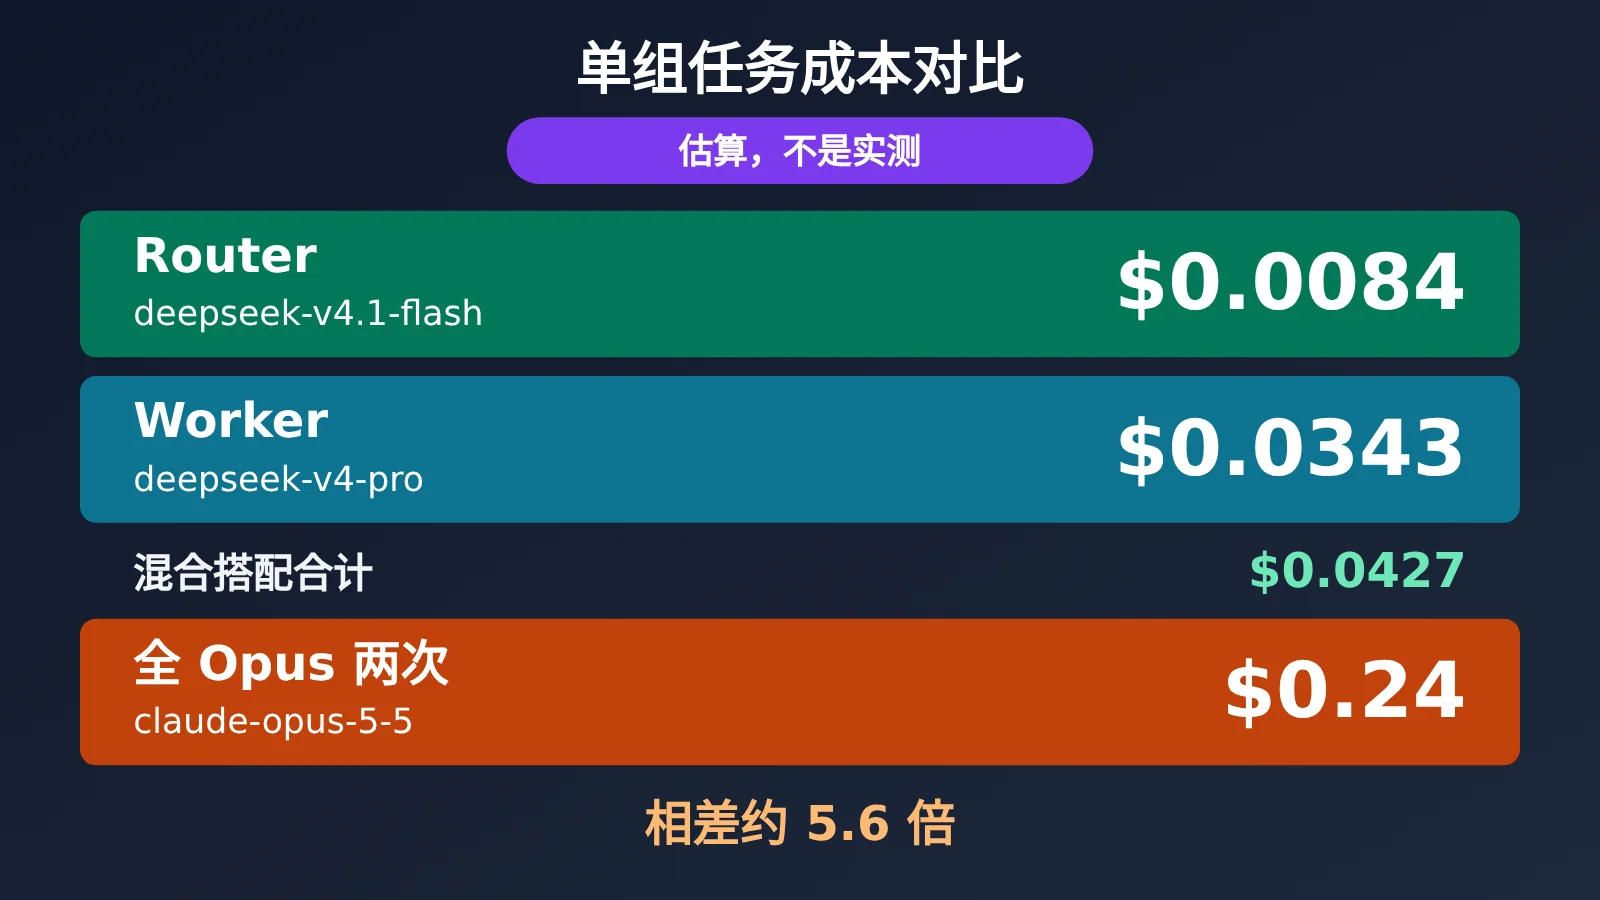
上图按 API易 · apiyi.com 型号表的默认标价估算,请替换为自己的 token 用量后再做预算。
DeepSeek 超级智能体常见问题 FAQ
Q1:这是新模型吗?
不是。这是一篇讨论 Agent 系统架构的文章,重点在外围系统如何组织会话、事件、状态和监控,并未发布新模型。
Q2:普通开发者能直接用吗?
不能把五个模块当作开箱即用的功能。目前可以试研究原型,或按文中思路自建;原文唯一明确提到的现有实现,是 DeepSeek Harness 的异步任务机制,且默认未开启。
Q3:dsh-superagent-prototype 是官方产品吗?
不是。它的 README 写明仅供研究参考,不是 DeepSeek 官方产品,也不等同于内部版本或文章描述的完整实现。
Q4:多 Agent 会更贵吗?
在这组实验里,缓存读 token 确实更多:Super-agent 是 23.2M,单会话方案是 6.1M 到 10.8M,换来的是更短、更稳定的完成时间。实际总成本还取决于模型搭配和任务规模,Router 用轻模型、开启 Thread 直通都有助于控制开销。
Q5:国内怎么接这些模型?
可以通过 API易 · apiyi.com 注册并获取 API Key,新用户有免费测试额度。然后把客户端的 base_url 改成上文地址,并在模型参数中填写表内型号。这些 DeepSeek 和 Claude 型号都支持 chat、messages 端点,上线前建议先用小流量验证。
总结
DeepSeek 超级智能体这篇文章的价值,在于把经典系统工程思路用到了 Agent 上。读完可以带走这几点:
- 问题定位: 在单任务上,模型需要的人越来越少,多任务的瓶颈正在转向人的注意力。
- 五个模块: 双层架构、事件驱动、全双工多通道、算力状态环境分离和 Watchdog,分别对应连续、高效、主动和持久四个特征。
- 证据边界: 两组实验都是作者自报的合成负载结果,只能作为设计参考。
- 落地顺序: 先拆 Router/Worker,再加 Trigger 过滤,最后加 Watchdog,全程把安全边界放在前面。
模型搭配不必一次定死,可以通过 API易 · apiyi.com 用同一批任务先跑小规模对比,再根据成功率和账单确定配置。
先把自己从“人肉 Router”的位置上换下来,再考虑加更多 Agent。
作者:API易 技术团队
技术交流:欢迎在 API易 网站首页联系我们,更多资料可访问 docs.apiyi.com 文档中心