В последнее время многие разработчики отмечают «парадоксальную» вещь: claude-opus-5-5 совсем не кажется медленным, а во многих задачах заканчивает работу даже раньше claude-sonnet-5-5. Если флагманская модель одновременно быстрая и мощная, остаётся ли у Sonnet лишь одно преимущество — цена вдвое ниже? Не всё так однозначно. В этой статье разберём на 6 наборах открытых данных реальные различия между claude-sonnet-5-5 и claude-opus-5-5 и ответим на более практичный вопрос: как распределить роли между этими моделями в корпоративных Agent-сценариях с длинным входным и выходным контентом.
Главная ценность: после прочтения вы поймёте настоящую причину «скорости» Opus, какие весомые преимущества Sonnet даёт помимо цены, а также получите готовую к внедрению двухмодельную Agent-архитектуру Opus + Sonnet.
Краткий обзор ключевых параметров claude-sonnet-5-5 и claude-opus-5-5
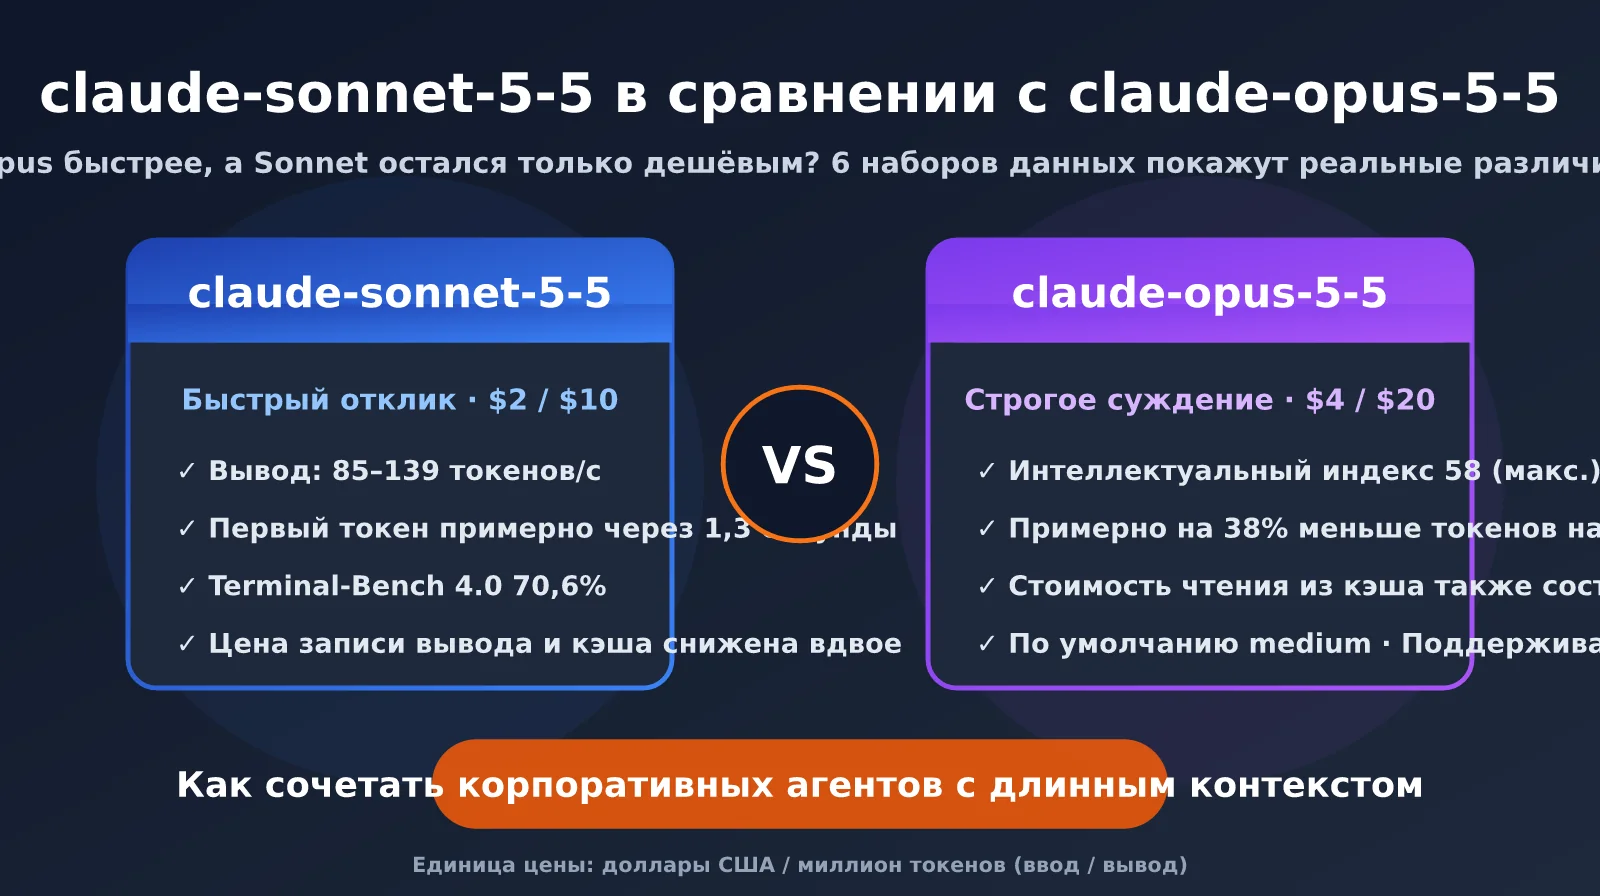
claude-opus-5-5 вышла 22 сентября 2026 года, а claude-sonnet-5-5 — 28 сентября 2026 года; обе входят в семейство Claude 5.5. Главное изменение этого поколения, на которое стоит обратить внимание: Opus стала дешевле. Базовая цена снизилась на 20% — с $5/$25 для Opus 5 до $4/$20, а чтение из кеша подешевело с $0,50 до $0,20, то есть теперь стоит столько же, сколько у Sonnet. Sonnet 5.5 сохранила цену $2/$10; по заявлению разработчика, стоимость одной задачи снизилась относительно предыдущего поколения максимум примерно на 30%.
| Параметр | claude-sonnet-5-5 | claude-opus-5-5 |
|---|---|---|
| Дата выхода | 2026-09-28 | 2026-09-22 |
| Цена ввода / вывода | $2 / $10 | $4 / $20 |
| Чтение из кеша | $0,20 | $0,20 (5% от базовой цены ввода) |
| Запись в кеш на 5 минут | $2,50 | $5 |
| Цена Batch | $1 / $5 | $2 / $10 |
| Контекстное окно | 1 млн токенов, без доплаты за длинный контекст | 1 млн токенов, без доплаты за длинный контекст |
| Максимальный вывод | 128K (300K в бета-версии Batch) | 128K (300K в бета-версии Batch) |
| Уровень рассуждений API по умолчанию | high | medium |
| Режим Fast | Не поддерживается | Поддерживается: примерно в 2,5 раза выше скорость вывода, $8 / $40 |
| Доступные платформы | APIYI apiyi.com, официальный API Anthropic | APIYI apiyi.com, официальный API Anthropic |
В таблице есть две детали, которые напрямую влияют на пользовательский опыт. Во-первых, уровни рассуждений по умолчанию различаются: у Opus по умолчанию установлен medium, а API Sonnet использует high. Именно это — главная причина, по которой многим Opus кажется быстрее. Во-вторых, стоимость чтения из кеша у них одинаковая. Поэтому в Agent-сценариях с активным повторным использованием длинного контекста разница во входных расходах сильно сокращается.
🎯 Совет по тестированию: при сравнении двух моделей обязательно явно задавайте одинаковый уровень рассуждений, иначе выводы будут серьёзно искажены. Рекомендуем через APIYI apiyi.com вызывать claude-sonnet-5-5 и claude-opus-5-5 одним и тем же ключом, меняя только параметры
modelиreasoning_effort— этого достаточно для корректного сравнительного теста.
Почему claude-opus-5-5 ощущается быстрее, чем claude-sonnet-5-5
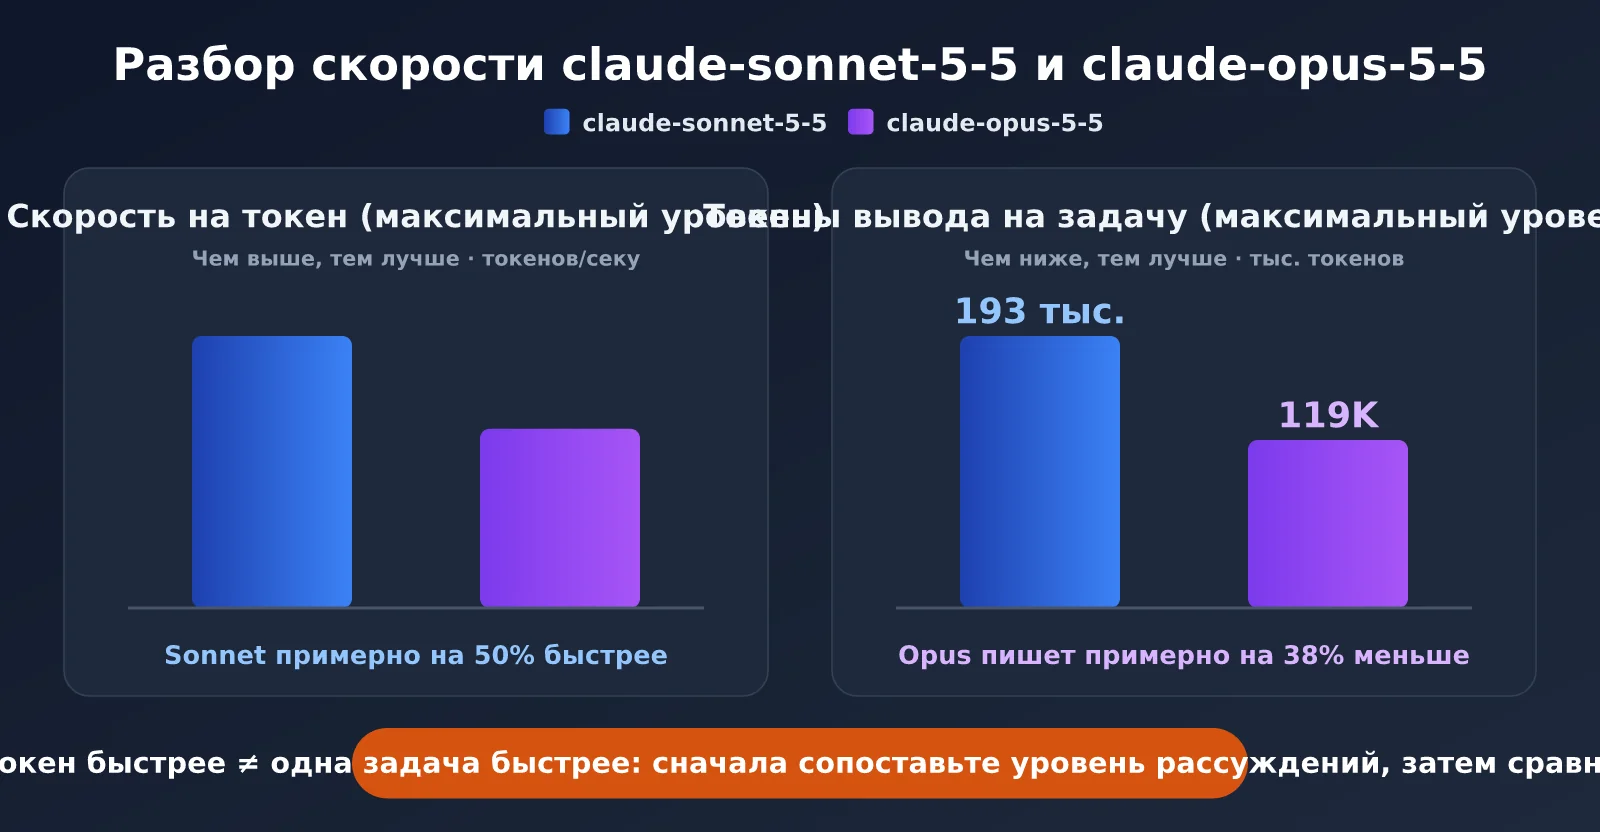
Если говорить именно о скорости генерации, claude-sonnet-5-5 заметно быстрее. По замерам Artificial Analysis, Sonnet 5.5 выдаёт 85–139 токенов в секунду в зависимости от уровня рассуждений, а Opus 5.5 — 74–93 токена в секунду. Anthropic тоже оценивает задержку Sonnet как «быструю», а Opus — как «среднюю». Откуда же берётся ощущение, что Opus быстрее? На это есть три основные причины.
Причина 1: разные настройки по умолчанию — Sonnet по умолчанию «думает» на уровень больше
У Opus 5.5 стандартный уровень для API был снижен с high у прошлого поколения до medium. По словам компании, режим medium уже соответствует или превосходит уровень high у Opus 5. У Sonnet 5.5 в API по умолчанию остаётся high, при этом режим рассуждений нельзя отключить.
Независимые тесты показывают, что на уровне high Sonnet генерирует примерно вдвое больше токенов, чем на medium, но без заметного прироста качества. Если просто вызывать модели с параметрами по умолчанию, Sonnet фактически «думает» на один уровень глубже — поэтому и тратит больше времени.
Причина 2: Opus эффективнее расходует токены
В тесте Artificial Analysis Intelligence Index Sonnet 5.5 на уровне max в среднем выводил около 193 тыс. токенов на одну задачу — это максимальный показатель среди измеренных моделей. У Opus 5.5 на том же уровне — около 119 тыс. токенов.
Более высокая скорость на один токен не означает, что задача будет выполнена быстрее. Sonnet может генерировать примерно на 50% больше токенов в секунду, но если при этом ему нужно написать на 60% больше текста, по времени от начала до конца Opus его догонит или даже обгонит.
Причина 3: только у Opus есть режим Fast
Opus 5.5 поддерживает режим Fast (исследовательский превью-режим): та же модель работает на более быстрой конфигурации инференса и может выдавать ответы до 2,5 раза быстрее. Цена составляет $8/$40. Если в инструменте для программирования включить Fast для Opus, впечатление, что «Opus очень быстрый», становится ещё сильнее.
Важно: Fast повышает только число выходных токенов в секунду, но не уменьшает задержку до первого токена. Кроме того, кэш промптов между стандартным и быстрым режимами не общий.
| Метрика скорости | claude-sonnet-5-5 | claude-opus-5-5 | Пояснение |
|---|---|---|---|
| Скорость вывода (токенов/с) | 85–139 | 74–93 | Sonnet быстрее на уровне отдельного токена |
Выходных токенов на задачу (max) |
около 193 тыс. | около 119 тыс. | Opus расходует меньше токенов |
| Задержка до первого токена (низкий уровень) | около 1,3 с (medium) |
около 14,3 с (low) |
Sonnet начинает отвечать заметно быстрее |
| Официальная оценка задержки | Быстрая | Средняя | По странице моделей Anthropic |
| Время выполнения реальной задачи по программированию (сторонний тест) | 29 мин 27 с | 44 мин 50 с | Sonnet примерно в 1,5 раза быстрее |
Вывод: с параметрами по умолчанию Opus может завершить задачу быстрее, но при сопоставимых и подходящих настройках Sonnet всё ещё заметно выигрывает по скорости отклика. Особенно это касается задержки до первого токена: на уровне medium Sonnet начинает вывод примерно через 1,3 секунды. Для интерактивных Agent-систем, работающих с пользователем, это критично.
У claude-sonnet-5-5 есть только ценовое преимущество? Сравниваем возможности по данным
Начнём с неожиданного факта: на уровне max Sonnet вовсе не дешевле Opus. Полный прогон Intelligence Index от Artificial Analysis обошёлся примерно в $8 977 для Sonnet 5.5 (max) и в $8 708 для Opus 5.5 (max). Opus оказался даже немного дешевле и при этом набрал больше баллов — 58 против 56. Причина та же: эффективность использования токенов. Поэтому если использовать Sonnet только на уровне max, его ценовое преимущество может исчезнуть.
Так в чём ценность Sonnet? В таблице ниже — баллы обеих моделей в Intelligence Index по уровням рассуждений. Она хорошо показывает, как их лучше применять:
| Уровень рассуждений | Индекс интеллекта claude-sonnet-5-5 | Индекс интеллекта claude-opus-5-5 |
|---|---|---|
| max | 56 | 58 |
| xhigh | 52 | 56 |
| high | 47 | 54 |
| medium | 41 | 51 |
| low | — | 42 |
По совокупному интеллекту Opus уверенно лидирует на всех одинаковых уровнях. Особенно заметно его преимущество в фактической точности (AA-Omniscience: 66% против 54%), а также в праве, финансах, стратегии и других профессиональных областях. Но у Sonnet есть несколько сильных сторон, которые Opus не может полноценно заменить:
- Агентное программирование в терминале: в Terminal-Bench 4.0 Sonnet (
max) набирает 70,6% — выше, чем Opus (xhigh) с 66,4%. Однако на одинаковом уровнеxhighOpus всё равно впереди: 66,4% против 61,5%. Sonnet нужно выкручивать на максимум, чтобы его обойти. - Задержка ответа: и время до первого токена, и скорость генерации в токенах в секунду у Sonnet заметно лучше. Это хороший выбор для интерфейсов с потоковым выводом и сценариев реального времени.
- Входные данные без попадания в кэш и запись в кэш: стоимость каждого из этих типов операций вдвое ниже, чем у Opus. Sonnet выгоднее для одноразовых задач с новыми длинными документами.
- Длинные ответы и пакетная обработка: цена вывода составляет $10 против $20, а в Batch — $5 против $10. При массовой генерации длинных отчётов и документов преимущество по стоимости сразу становится двукратным.
- Высокий параллелизм: Anthropic позиционирует Sonnet как более быстрого и дешёвого напарника Opus. Он хорошо подходит для множества параллельных субагентов, выполняющих чётко определённые подзадачи.
В других публичных бенчмарках Opus опережает Sonnet примерно на 2 процентных пункта: CursorBench 4.0 — 57,8% против 55,5%, FrontierCode 1.1 — 54,4% против 52,1%, OSWorld 2.1 — 81,8% против 80,1%. А в ProgramBench — стороннем сводном тесте реконструкции программ в длинном контексте — разрыв уже существенно больше: 91,2% у Opus против 79,7% у Sonnet. Это показывает, что чем важнее точные выводы в сверхдлинном контексте, тем сильнее преимущество Opus.
💡 Совет по выбору модели: Sonnet лучше использовать на уровнях от
mediumдоxhighкак «исполнителя», а Opus — отmediumи выше как «того, кто принимает решения». Чтобы проверить разницу на собственных задачах, запустите одинаковую задачу с длинным документом для обеих моделей в APIYI apiyi.com и сравните качество результата с фактическими расходами.
Реальная стоимость корпоративных Agent-сценариев с длинным контекстом
Типичная нагрузка корпоративного Agent выглядит так: на вход поступают контракты, репозитории кода или базы знаний объёмом в сотни тысяч токенов, а на выходе нужны подробные отчёты, массовая переработка текстов или код в нескольких файлах. Обе модели поддерживают контекст до 1 млн токенов и не берут дополнительную плату за длинный контекст, поэтому реальную стоимость определяют доля попаданий в кэш и длина вывода. Ниже — оценка для нескольких типичных сценариев по официальным тарифам (для Sonnet предполагается в 1,6 раза больше выходных токенов, чем у Opus; это соответствует разнице в Token-эффективности моделей на уровне max):
| Сценарий | Состав нагрузки | claude-sonnet-5-5 | claude-opus-5-5 | Соотношение стоимости |
|---|---|---|---|---|
| Многораундовые уточнения с длинным контекстом | 500 тыс. токенов контекста, 95% попадает в кэш, 25 тыс. новых токенов записывается | около $0.28 (вывод 12 тыс.) | около $0.37 (вывод 7,5 тыс.) | 1 : 1.3 |
| Первичная загрузка длинного документа | 500 тыс. токенов в 5-минутный кэш + 10 тыс. токенов вывода | около $1.35 | около $2.70 | 1 : 2 |
| Генерация большого отчёта | 50 тыс. токенов ввода + 50 тыс. токенов вывода (одинаковый объём вывода) | около $0.60 | около $1.20 | 1 : 2 |
| Офлайн-пакетная генерация | Режим Batch, по 100 тыс. токенов на ввод и вывод | около $0.60 | около $1.20 | 1 : 2 |
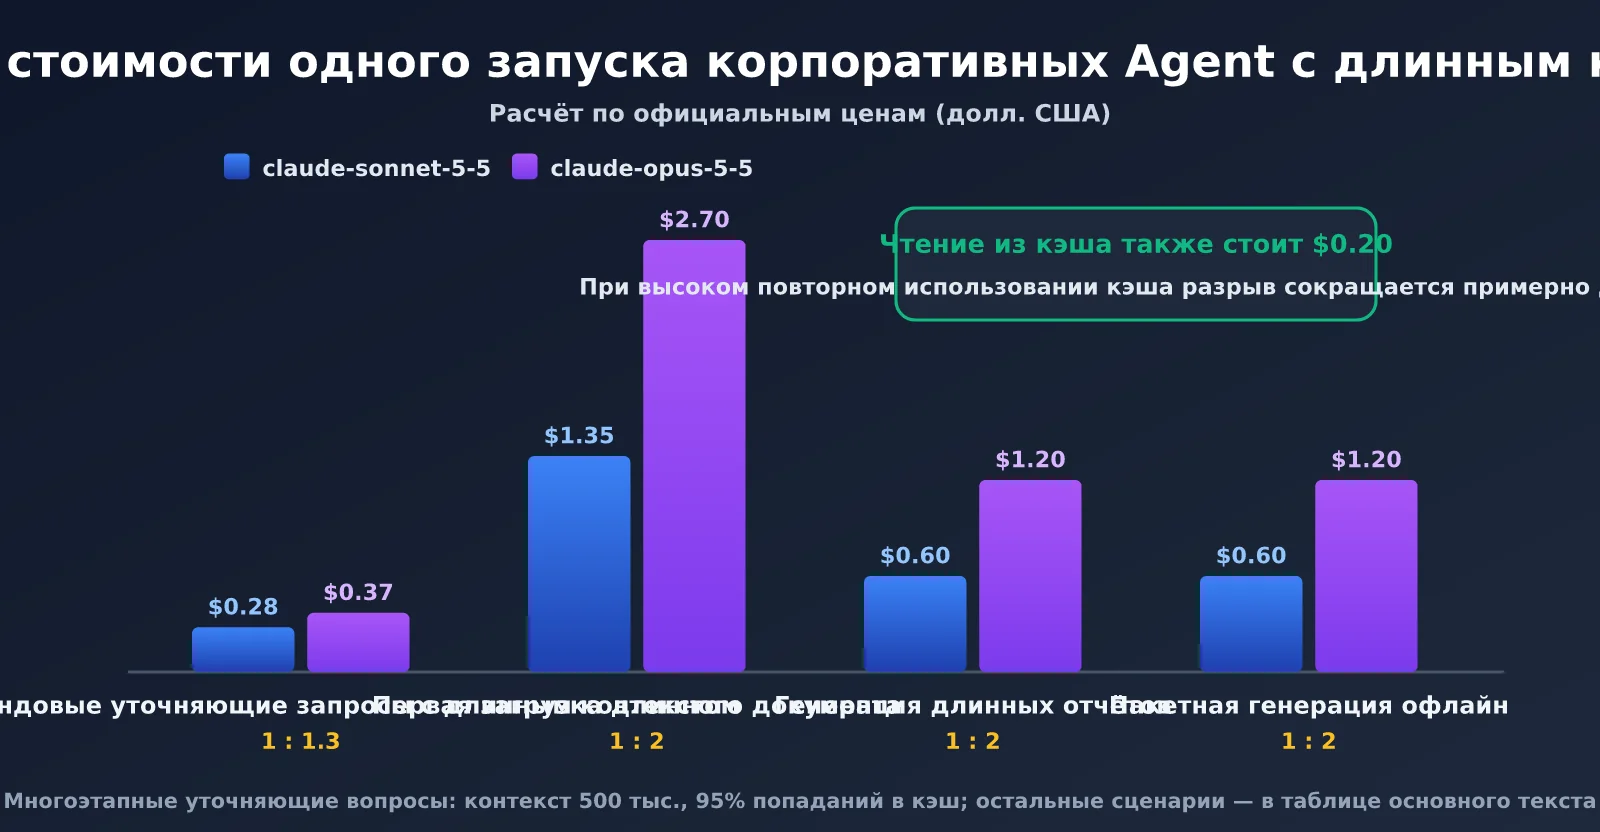
Эта таблица показывает важную закономерность: в многораундовых уточнениях с длинным вводом, высокой долей попаданий в кэш и коротким выводом Opus дороже Sonnet всего примерно на 30%. Причина в том, что основную часть затрат составляет чтение из кэша, а его цена у моделей одинакова; кроме того, Opus расходует меньше токенов на вывод. Но при первой загрузке нового документа и генерации длинного ответа преимущество Sonnet по стоимости возвращается к полным 50%.
Иными словами, Opus лучше подходит для сценариев, где нужно «много раз перечитывать один и тот же длинный материал и принимать решения», а Sonnet — когда требуется «за один раз обработать новые материалы» или «сгенерировать большой объём контента».
Есть ещё один нюанс, на котором легко ошибиться: кэш промптов нельзя использовать между разными моделями. Если один и тот же документ на 500 тыс. токенов сначала прочитал Opus, а затем Sonnet, за запись в кэш придётся заплатить дважды. Поэтому в двухмодельной архитектуре важно, чтобы длинный контекст по возможности «жил» только у одной модели, а вторая получала лишь сжатую сводку задачи.
Оптимальная схема совместного использования claude-sonnet-5-5 и claude-opus-5-5
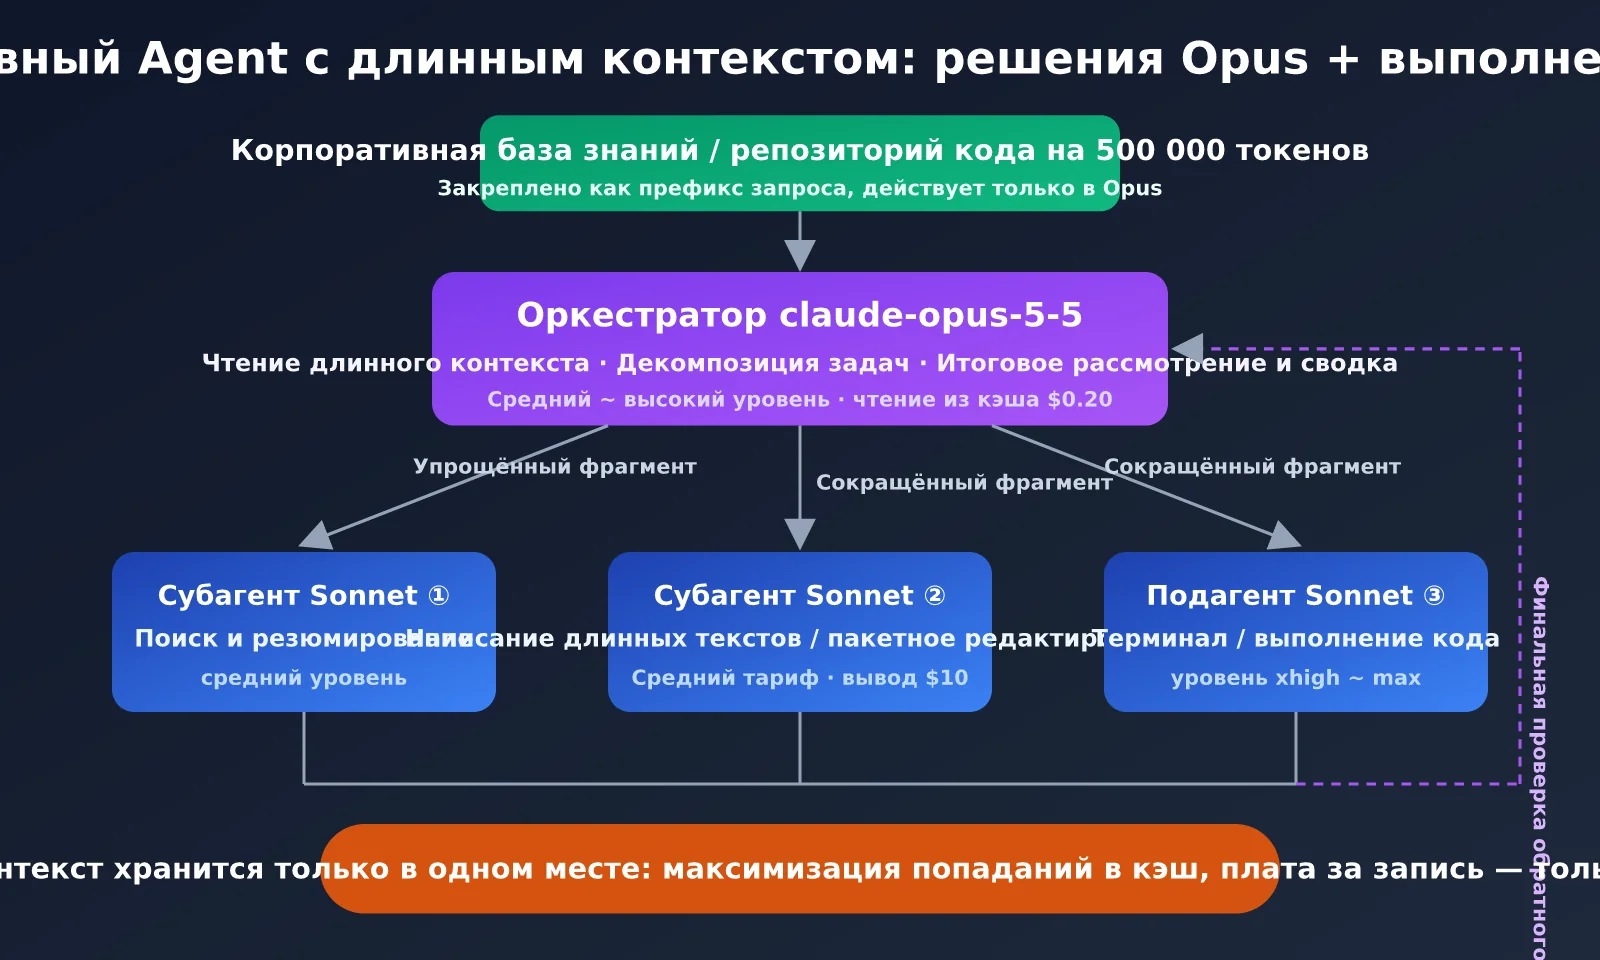
На основе этих данных для корпоративных Agent, работающих с длинным контентом, рекомендуем многоуровневую архитектуру «Opus принимает решения, Sonnet исполняет». В зависимости от того, какая модель хранит длинный контекст, возможны два варианта.
Вариант 1: Opus координирует, Sonnet запускает параллельных субагентов
Подходит для задач, требующих сложных выводов на основе больших объёмов материалов: проверки контрактов, миграции кода между репозиториями, комплексной проверки компании. Opus хранит полный длинный контекст — и может долго работать с попаданиями в кэш. Он отвечает за понимание общей картины, декомпозицию задачи и распределение работы между несколькими субагентами Sonnet.
Каждый субагент Sonnet получает только нужный фрагмент материала и чёткие инструкции, быстро выполняя задачу параллельно на уровне medium. Затем Opus объединяет результаты и проводит финальную проверку. В этой схеме дорогое кэширование длинного контекста оплачивается только один раз, а Sonnet генерирует большие объёмы текста по вдвое более низкой цене за выходные токены.
Вариант 2: Sonnet на первом уровне, Opus подключается для сложных случаев
Подходит для интерактивных сценариев с высоким трафиком: вопросов к корпоративной базе знаний, Agent службы поддержки или внутренних IT-помощников. Sonnet хранит длинный контекст и на уровне medium выдаёт первый токен примерно за 1 секунду.
Если модель не уверена в ответе, запрос затрагивает вопросы соответствия требованиям или пользователь явно недоволен результатом, в Opus передаётся сокращённая формулировка задачи вместе с ключевыми фрагментами. Основной поток запросов Sonnet обрабатывает недорого, а Opus используется только для небольшого числа сложных случаев.
| Роль Agent | Рекомендуемая модель | Рекомендуемый уровень | Причина |
|---|---|---|---|
| Оркестратор / планировщик | claude-opus-5-5 | medium ~ high | Более высокий общий интеллект и точность по фактам, хорошая Token-эффективность |
| Анализ длинного контекста и финальная проверка | claude-opus-5-5 | high ~ xhigh | Заметное преимущество в точных выводах по длинному контексту |
| Подготовка длинных текстов / массовая переработка | claude-sonnet-5-5 | medium | Цена выходных токенов вдвое ниже, скорость генерации выше |
| Субагент для терминала / выполнения кода | claude-sonnet-5-5 | xhigh ~ max | Лучший результат Terminal-Bench на максимальном уровне |
| Фронтенд для диалогов в реальном времени | claude-sonnet-5-5 | medium | Задержка первого токена около 1,3 секунды |
| Офлайн-пакетная обработка | claude-sonnet-5-5 | medium | Batch $1/$5, поддерживает длинный вывод до 300 тыс. токенов |
Реализация схемы «Opus координирует + Sonnet исполняет» через единый интерфейс
Ниже — минимальный пример первого варианта. Вызовы выполняются через совместимый с OpenAI интерфейс, а для обеих моделей используется один ключ:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口
)

def ask(model, prompt, effort="medium"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        messages=[{"role": "user", "content": prompt}])
    return r.choices[0].message.content

plan = ask("claude-opus-5-5", "阅读以下合同全文,拆成 3 个独立审查子任务,每行一个:\n" + contract_text)
drafts = [ask("claude-sonnet-5-5", f"完成子任务并输出审查意见:{t}") for t in plan.splitlines() if t.strip()]
report = ask("claude-opus-5-5", "汇总并终审以下意见,输出最终报告:\n" + "\n".join(drafts), effort="high")
Разверните, чтобы посмотреть полный пример: параллельные субагенты и фиксированный префикс длинного контекста
import asyncio
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口
)

ORCHESTRATOR = "claude-opus-5-5"
WORKER = "claude-sonnet-5-5"

async def call(model, messages, effort="medium"):
    r = await client.chat.completions.create(
        model=model, reasoning_effort=effort, messages=messages)
    return r.choices[0].message.content, r.usage

async def run(long_doc: str, goal: str):
    # 1. 长文档固定放在 system 前缀,只驻留在 Opus 上,便于多轮命中缓存
    base = [{"role": "system", "content": "你是企业文档分析编排者。以下是完整材料:\n" + long_doc}]
    plan, _ = await call(ORCHESTRATOR, base + [
        {"role": "user", "content": f"目标:{goal}\n请拆成最多 5 个子任务,每个子任务附上所需的原文片段,用 --- 分隔。"}])

    # 2. Sonnet 子 Agent 只接收精简片段,并行执行
    tasks = [t.strip() for t in plan.split("---") if t.strip()]
    results = await asyncio.gather(*[
        call(WORKER, [{"role": "user", "content": f"独立完成以下子任务,输出结构化结论:\n{t}"}])
        for t in tasks])

    # 3. 回到 Opus 终审,复用同一长上下文前缀
    merged = "\n\n".join(r[0] for r in results)
    final, usage = await call(ORCHESTRATOR, base + [
        {"role": "user", "content": f"核对以下子任务结论与原文是否一致,修正错误后输出最终报告:\n{merged}"}],
        effort="high")
    print("终审 Token 用量:", usage)
    return final

# asyncio.run(run(open("contract.md").read(), "识别合同中的付款、违约与知识产权风险"))
🚀 Быстрый старт: официальный аккаунт Claude предъявляет довольно строгие требования к региону регистрации и способу оплаты, поэтому корпоративные команды нередко сталкиваются со сложностями уже на этапе подключения. Можно зарегистрироваться в APIYI на apiyi.com и получить тестовый лимит: один Key позволит вызывать и claude-opus-5-5, и claude-sonnet-5-5. Сначала запустите описанную выше двухмодельную архитектуру, а затем оцените стоимость её масштабирования.
Рекомендации по выбору между claude-sonnet-5-5 и claude-opus-5-5
Сведём предыдущий анализ к четырём практическим правилам:
- Сначала выбирайте уровень, затем сравнивайте модели: для Sonnet используйте medium~xhigh, для Opus — medium~high. Так вы избежите лишнего расхода токенов из-за режима high по умолчанию у Sonnet.
- Длинный контекст с высокой повторной загрузкой кэша поручайте Opus: чтение из кэша стоит одинаково, а Opus дороже всего примерно на 30%, зато обеспечивает более высокую точность и требует меньше доработок.
- Загрузку новых материалов и длинные ответы поручайте Sonnet: стоимость записи в кэш и выходных токенов у него вдвое ниже, чем у Opus. Для офлайн-задач дополнительно можно использовать Batch со скидкой 50%.
- Храните длинный контекст только в одном месте: кэш нельзя использовать между разными моделями. Передавайте субагентам только сжатые фрагменты, чтобы не платить повторно за запись в кэш.
Что касается режима Fast у Opus: он подходит для сценариев, где критична скорость одного ответа и бюджет не ограничен. Но цена при этом удваивается, а кэш не используется совместно. Для большинства корпоративных Agent-систем выгоднее отдать интерактивные задачи Sonnet в режиме medium, чем включать Fast у Opus.
Частые вопросы
Q1: claude-opus-5-5 и так быстрый. Есть ли смысл использовать claude-sonnet-5-5?
Да, есть. Высокая скорость Opus в основном связана с более низким уровнем по умолчанию и лучшей эффективностью токенов. Однако Sonnet всё ещё заметно опережает его по скорости генерации токенов в секунду и задержке до первого токена, а стоимость выходных токенов у него вдвое ниже. Для написания длинных текстов, диалогов в реальном времени и параллельных субагентов Sonnet остаётся более подходящим исполнителем.
Q2: Может ли claude-sonnet-5-5 в режиме max заменить Opus?
В отдельных задачах — например, в программировании через терминал — может. Результат Sonnet (max) в Terminal-Bench 4.0 даже выше, чем у Opus. Но по совокупному индексу интеллекта он всё равно уступает на 2 балла, а в режиме max Sonnet расходует больше токенов. В итоге общая стоимость становится сопоставимой с Opus или даже немного выше. Если вам нужен максимальный уровень качества, обычно выгоднее сразу выбрать Opus.
Q3: Как корпоративному Agent для работы с длинными документами контролировать расходы на две модели?
Главное — повысить процент попаданий в кэш. Держите длинные документы в фиксированном префиксе запроса, пусть полный контекст хранит только одна модель, а субагенты получают лишь сжатые фрагменты. Рекомендуется выполнять вызовы через APIYI apiyi.com и отслеживать в ответах объём токенов кэша. Постепенно оптимизируйте структуру префикса: процент попаданий в кэш обычно становится самым эффективным рычагом снижения затрат.
Q4: Что учесть при миграции с Sonnet 5 или Opus 5 на версии 5.5?
Обе модели 5.5 содержат изменения, нарушающие обратную совместимость: режим рассуждений нельзя отключить, принудительный вызов инструментов (tool_choice со значением any или tool) будет возвращать ошибку 400, а старый инструмент управления компьютером необходимо обновить. Перед миграцией стоит сначала прогнать регрессионные тесты в тестовой среде, параллельно сравнить ответы старых и новых моделей, а уже затем переключать production-трафик.
Итоги
Сравнение claude-sonnet-5-5 и claude-opus-5-5 не сводится к простой формуле «дороже — лучше, дешевле — хуже». После снижения цены Opus 5.5 стоимость чтения из кэша стала такой же, как у Sonnet, а стандартный уровень medium достаточно эффективен. В задачах, где нужны точные выводы на длинном контексте и комплексное интеллектуальное рассуждение, он уверенно лидирует. Sonnet 5.5, в свою очередь, сохраняет незаменимые преимущества в скорости ответа, стоимости вывода, программировании в терминале и выполнении задач при высокой параллельной нагрузке. Поэтому преимущество Sonnet — не только в цене: оно раскрывается при правильном уровне производительности и правильно выбранной роли.
Для корпоративных Agent-систем с большими объёмами входного и выходного контента оптимальна связка «Opus принимает решения, Sonnet исполняет». Opus хранит длинный контекст, отвечает за планирование и финальную проверку, а Sonnet на уровне medium параллельно выполняет написание материалов и прикладные задачи. Офлайн-часть можно передать Batch. На практике стоит сначала запустить сравнительные тесты с фиксированными уровнями, затем разделить Agent по ролям согласно таблице из статьи и после этого постоянно оптимизировать расходы по двум показателям: доле попаданий в кэш и числу выходных токенов.
Если хотите быстро проверить эту двухмодельную схему, рекомендуем через APIYI apiyi.com единообразно вызывать claude-opus-5-5 и claude-sonnet-5-5. Интерфейс платформы совместим с форматом OpenAI: достаточно одного API-ключа, чтобы свободно переключаться между обеими моделями. Это удобно и для тестирования при выборе модели, и для оркестрации нескольких моделей в production-среде.
Источники:
— Документация Anthropic по ценам: platform.claude.com/docs/en/about-claude/pricing
— Документация Anthropic по режиму Fast: platform.claude.com/docs/en/build-with-claude/fast-mode
— Сравнение Sonnet 5.5 и Opus 5.5 от Artificial Analysis: artificialanalysis.ai
— Разбор релиза Opus 5.5 от Digital Applied: digitalapplied.com
— Сравнения Sonnet 5.5 и Opus 5.5 от Kingy AI и Emergent: kingy.ai, emergent.sh
Об авторе: техническая команда APIYI, специализирующаяся на интеграции API больших языковых моделей и инженерной практике. Будем рады обсудить через APIYI apiyi.com опыт оркестрации Agent-систем на claude-opus-5-5 и claude-sonnet-5-5, а также оптимизацию затрат.