Claude Fable 5.2 wurde am 9. November 2026 veröffentlicht. Der Standardpreis pro API-Aufruf liegt 20 % unter dem von Version 5.1.
Viele Teams fragen sich deshalb sofort: Wenn das Modell günstiger geworden ist, können wir dann einfach auf „max“ umschalten?
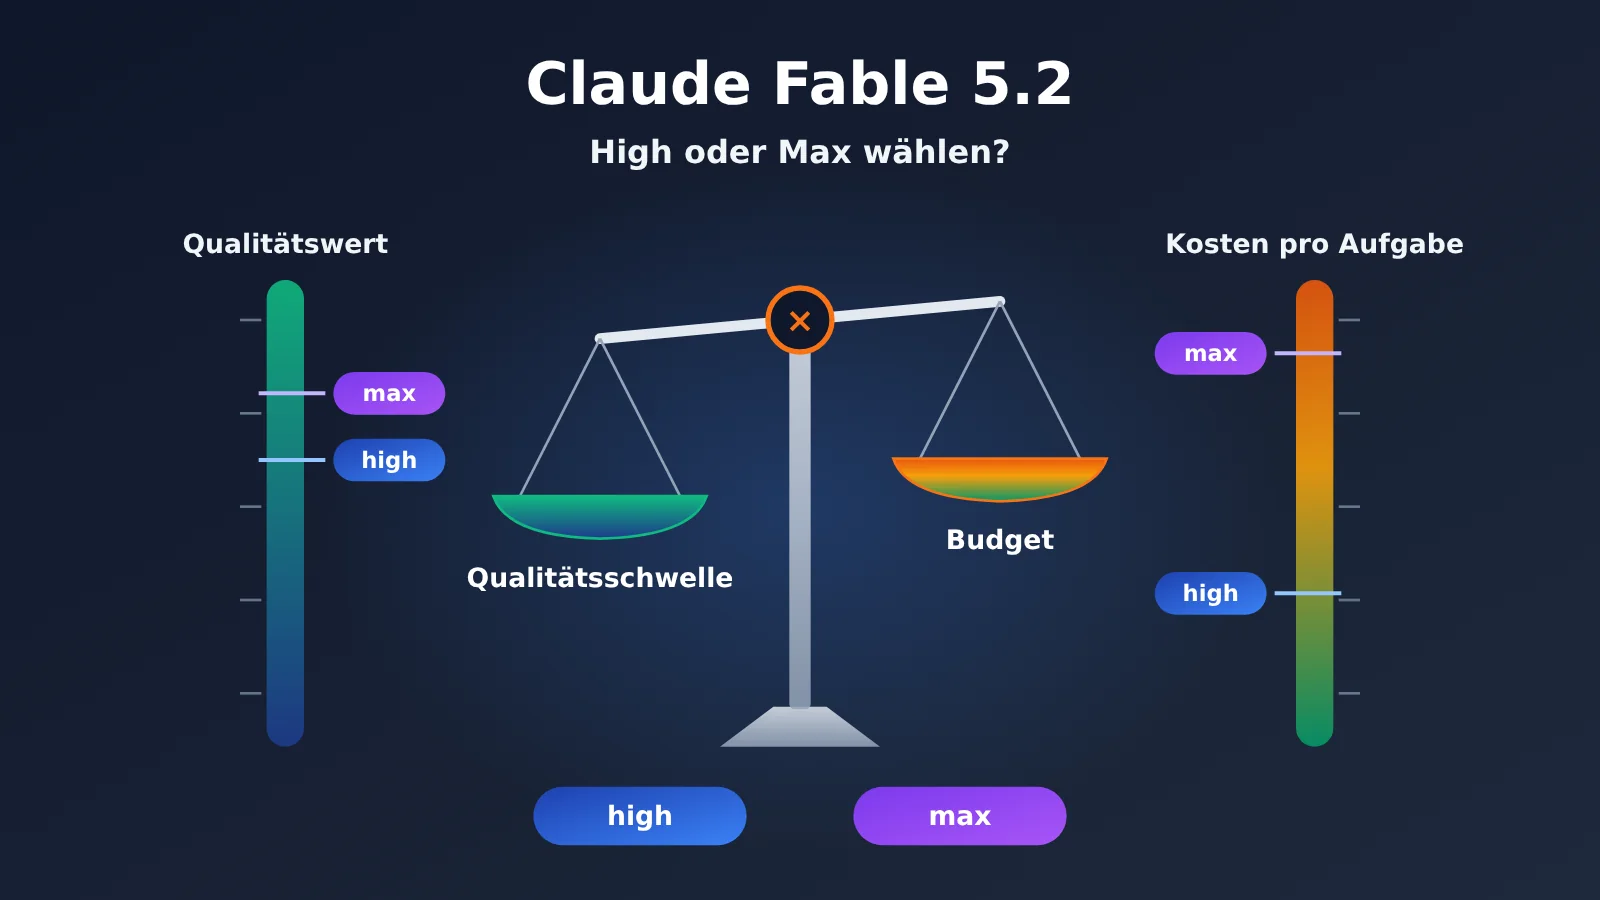
In diesem Artikel vergleichen wir Fable 5.2 high und Fable 5.2 max nach denselben Kriterien und betrachten sowohl die Qualität als auch die Kosten pro Aufgabe.
Der Mehrwert: Nach der Lektüre wissen Sie, für welche Bedingungen sich „high“ oder „max“ bei Fable 5.2 eignet. Außerdem erhalten Sie eine Checkliste, mit der Sie ein Upgrade direkt abnehmen können.
Inhaltsverzeichnis
- Vorab: Begriffe zur Auswahl der Fable-5.2-Stufe
- 1 Was sich bei Fable 5.2 high und max unterscheidet – und warum nicht derselbe Einzelpreis
- 2 Qualität und Kosten von Fable 5.2 im direkten Vergleich
- 3 Trends bei den Fable-5.2-Stufen anhand unabhängiger Daten prüfen
- 4 Die passende Fable-5.2-Stufe je nach Einsatzzweck auswählen
- 5 Mit eigenen Abnahmetests entscheiden, ob sich das Upgrade von Fable 5.2 auf max lohnt
- Häufige Fragen (FAQ) / Wichtigste Erkenntnisse / Fazit
Wissenswertes
| Begriff | Bedeutung | Darauf sollten Sie beim Lesen achten |
|---|---|---|
| Effort | Einstellung, die steuert, wie viel Denkaufwand das Modell investiert | Der API-Standardwert für Fable 5.2 ist high |
| Adaptive thinking | Mechanismus, mit dem das Modell den Denkaufwand automatisch festlegt | Bei Fable 5.2 immer aktiviert |
| Harness | Laufzeitumgebung, die dem Modell Tools, Sitzungen und Ausführungsregeln bereitstellt | Die Harness-Umgebungen von Cursor und AA unterscheiden sich |
| Intelligence Index | Von AA gewichteter Gesamtindex aus mehreren Benchmarks | Ein Index, keine Trefferquote |
| Prozentpunkte | Absolute Differenz, die sich aus der Subtraktion zweier Prozentwerte ergibt | Von 56,9 % auf 60,0 % sind es 3,1 Prozentpunkte |
| Kosten pro Aufgabe | Modellkosten, die unter bestimmten Testbedingungen auf eine einzelne Aufgabe entfallen | Entspricht nicht Ihrer API-Rechnung |
| Abnahmeschwelle | Qualitätsanforderung, die eine Aufgabe erfüllen muss | Erst die Schwelle erreichen, dann das Budget vergleichen |
| Aufgabenstaffelung | Gruppierung von Aufgaben nach Schwierigkeitsgrad und Fehlerkosten | Für unterschiedliche Stufen eignen sich unterschiedliche Effort-Stufen |
1 Bei Fable 5.2 verändern high und max nicht denselben Stückpreis
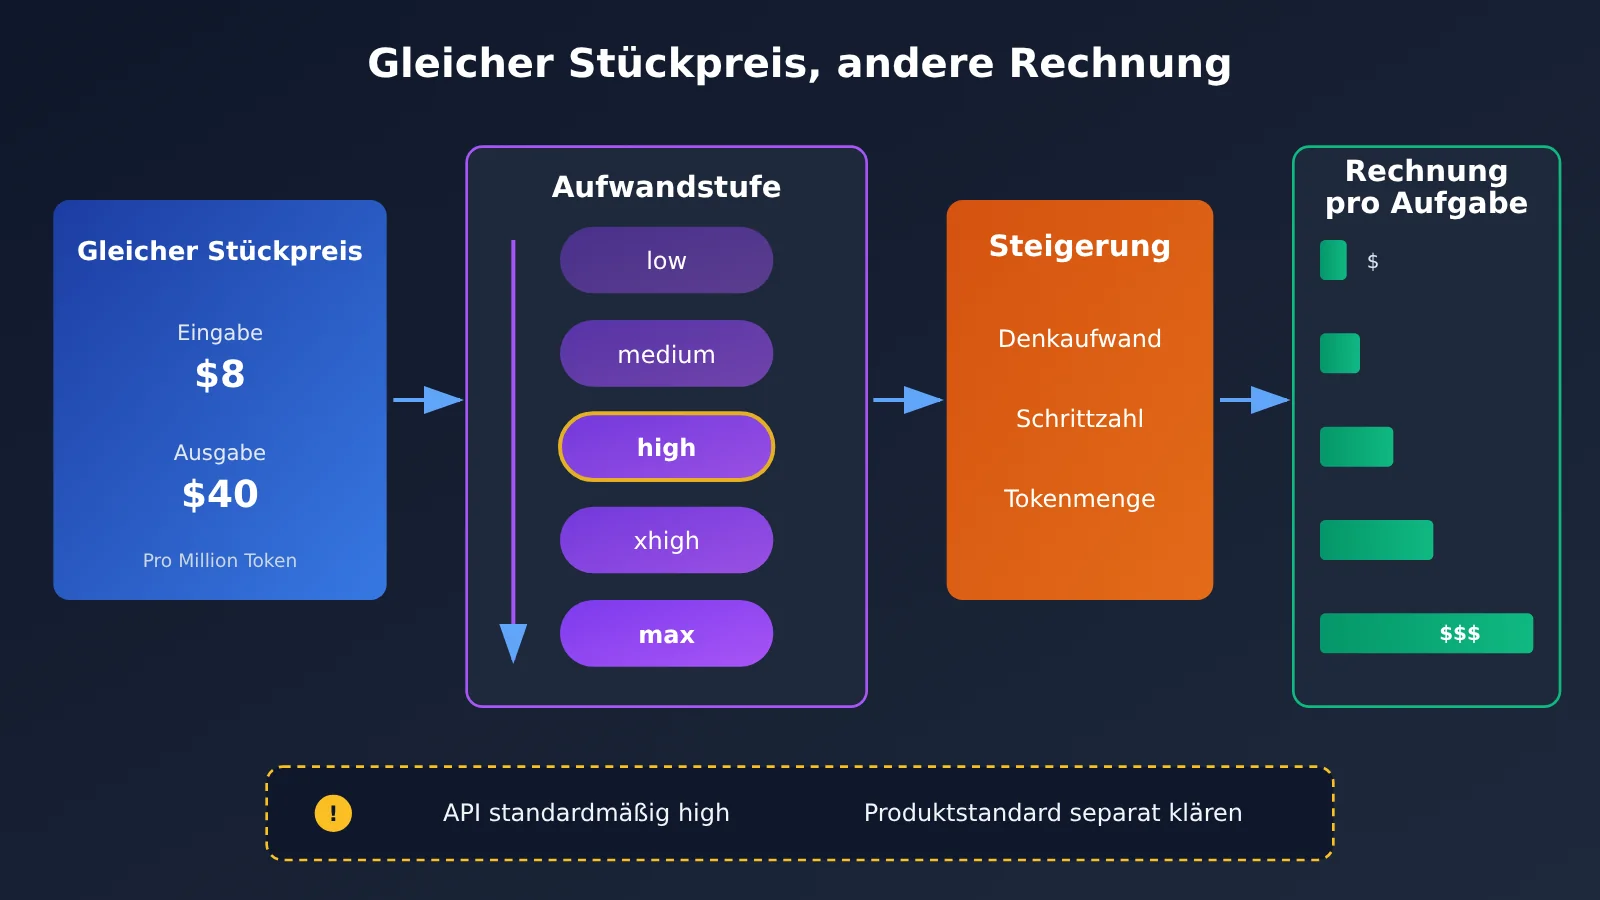
Viele gehen davon aus, dass ein höheres Effort-Level auch einen höheren Stückpreis bedeutet. Bei den offiziellen Standardtarifen von Anthropic kostet Fable 5.2 tatsächlich 8 US-Dollar pro Million Eingabe-Token und 40 US-Dollar pro Million Ausgabe-Token – unabhängig vom Effort-Level.
Effort beeinflusst, wie viel Denkaufwand das Modell in eine Aufgabe investiert, wie viele Schritte es ausführt, wie lange es braucht und wie viele Token es verbraucht. Der Stückpreis bleibt gleich, aber die Kosten pro Aufgabe können sich um ein Mehrfaches unterscheiden.
Wie sich die Effort-Stufen bei Fable 5.2 auf die Kosten auswirken
Bei Fable 5.2 ist Adaptive Thinking immer aktiviert. Effort bestimmt, wie viel Denkaufwand das Modell maximal investieren kann und wozu es tendiert. Bei höheren Stufen führt das Modell in der Regel mehr Schlussfolgerungen und Tool-Aufrufe aus, wodurch auch die abgerechnete Tokenmenge steigt.
Bei 100.000 Eingabe-Token steigen die Kosten im Standardmodus von Version 5.2 beispielsweise von 1,60 auf 2,40 US-Dollar, wenn die Ausgabe von 20.000 auf 40.000 Token wächst. Das ist sogar mehr als die 2 US-Dollar, die Version 5.1 bei der ursprünglichen Tokenmenge kostet.
Außerdem sollten Sie zwei Arten von „Standardwerten“ auseinanderhalten. In der offiziellen Modelldokumentation steht, dass der API-Standardwert für Effort high ist. Produkte wie Cursor haben eine eigene Konfigurationsebene. So beträgt der Standard-Kontext bei Cursor 300K – das ist nicht mit der 1M-Angabe in der API-Dokumentation gleichzusetzen.
Noch ein Hinweis: Laut den offiziellen Prompting-Richtlinien kann der Denkaufwand bei gleichnamigen Effort-Stufen je nach Version unterschiedlich ausfallen. Erfahrungen mit den Stufen aus der Zeit von Version 5.1 lassen sich daher nicht unverändert auf Version 5.2 übertragen.
2 Qualität und Kosten von Fable 5.2 in einer Tabelle
CursorBench 4.0 ist ein Benchmark, den Cursor mit eigenen Aufgaben und in der eigenen Tool-Umgebung durchführt. Es handelt sich nicht um eine unabhängige, allgemeine Nachprüfung. Da der Benchmark jedoch alle fünf Stufen im selben Harness vergleicht, eignet er sich gut, um die relativen Unterschiede zwischen den Stufen zu betrachten. Die folgenden Daten stammen vom 10. November 2026.
| Fable 5.2-Stufe | Punktzahl | Kosten pro Aufgabe (US-Dollar) | Tokens (aggregiertes Feld) | Schritte |
|---|---|---|---|---|
| Low | 53,2 % | 3,94 | 36.616 | 30 |
| Medium | 54,8 % | 4,66 | 44.103 | 35 |
| High | 56,9 % | 9,70 | 99.259 | 69 |
| Extra High | 56,3 % | 15,48 | 161.251 | 108 |
| Max | 60,0 % | 32,79 | 352.794 | 218 |
Hinweis: Die Spalte „Tokens“ ist ein aggregiertes Feld der Benchmark-Seite und darf nicht so verstanden werden, als enthielte sie nur die Ausgabemenge. Quelle: CursorBench 4.0.
Fable 5.2 von High zu Max: 3,1 Prozentpunkte bei etwa 3,38-fachen Kosten
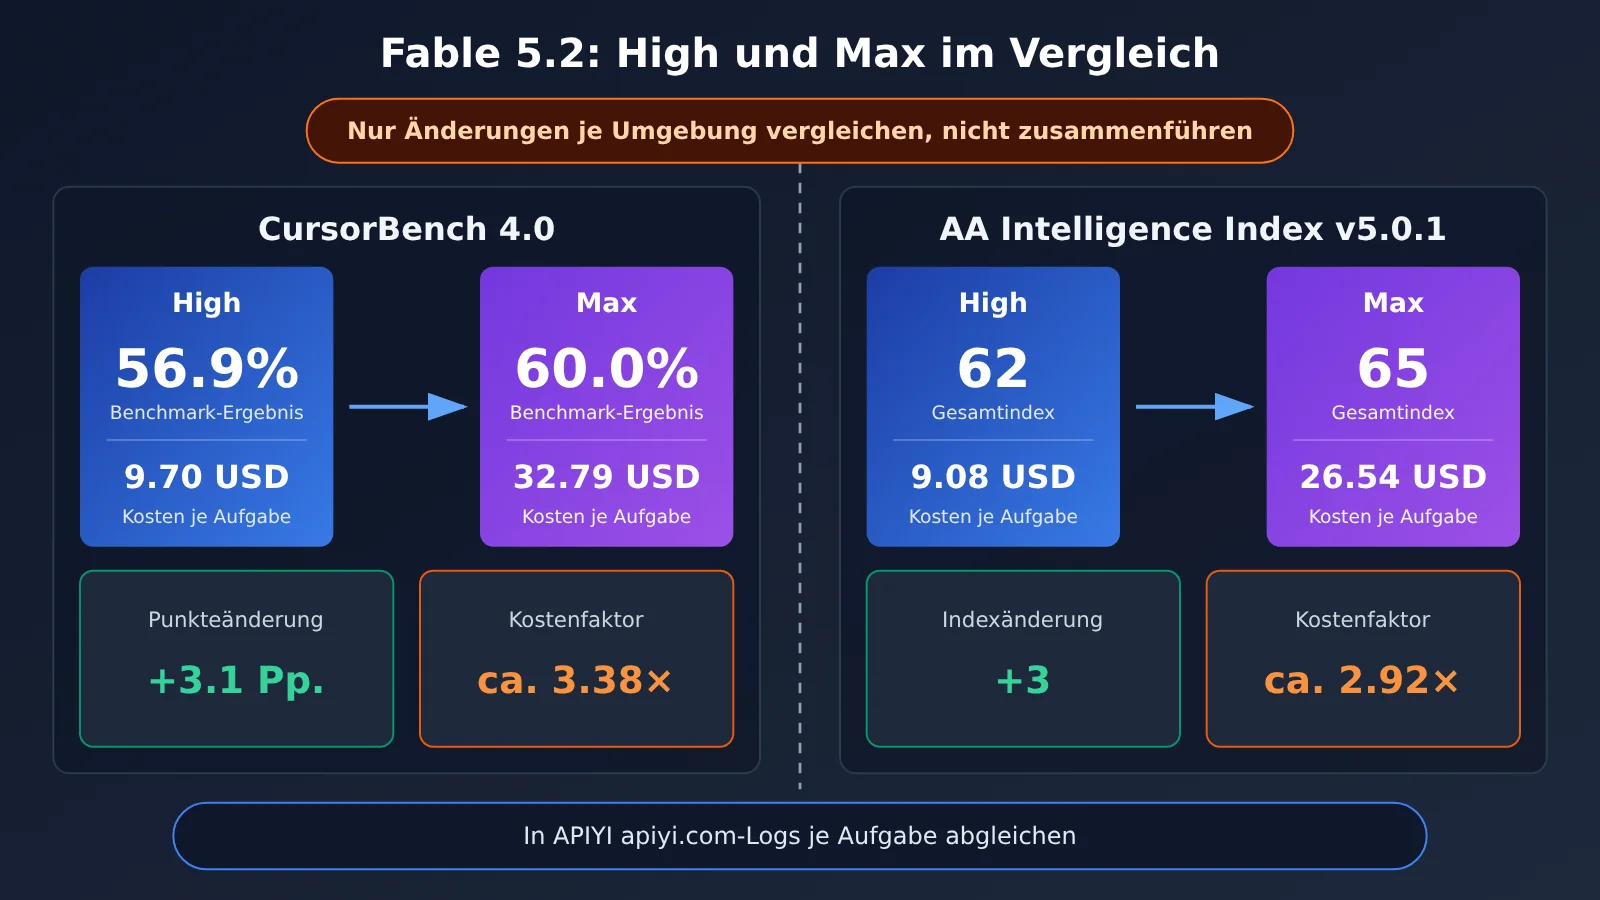
In dieser Tabelle steigt die Punktzahl von High zu Max von 56,9 % auf 60,0 % – ein Plus von 3,1 Prozentpunkten. Die Kosten pro Aufgabe steigen von 9,70 auf 32,79 US-Dollar und liegen damit bei etwa dem 3,38-Fachen. Das entspricht einem Anstieg um rund 238 %.
Nach unserer Berechnung erhöht sich das Tokens-Feld auf etwa das 3,55-Fache. Die Zahl der Schritte steigt von 69 auf 218, also auf etwa das 3,16-Fache. Der Kostenanstieg ist vor allem auf mehr Denk- und Ausführungsschritte zurückzuführen, nicht auf den Preis pro Einheit.
Diese Daten zeigen lediglich, dass in dieser Umgebung eine höhere Punktzahl mit deutlich höheren Kosten einhergeht.
Wie ist das unerwartete Ergebnis von Extra High einzuordnen?
Ein weiterer bemerkenswerter Punkt in der Tabelle: Extra High ist rund 60 % teurer als High, erzielt aber eine um 0,6 Prozentpunkte niedrigere Punktzahl.
💡 Empfehlung zur Auswahl: Vergleichen lassen sich nur die Unterschiede zwischen den Stufen innerhalb derselben Tabelle. Zahlen aus unterschiedlichen Benchmarks sollte man nicht direkt miteinander vermischen. Wenn Sie einen ähnlichen Vergleich mit Ihren eigenen Aufgaben nachstellen möchten, können Sie über die einheitliche Schnittstelle von APIYI (apiyi.com) und die Aufrufprotokolle einen Abgleich vornehmen. Prüfen Sie zuvor, welche Modell-IDs und Stufen die Plattform am jeweiligen Tag unterstützt.
3 Trends bei den Fable-5.2-Leistungsstufen anhand unabhängiger Benchmark-Daten prüfen
Wer nur eine Benchmark-Umgebung betrachtet, läuft Gefahr, dass die Ergebnisse von den Besonderheiten dieser Umgebung beeinflusst werden. AA ist eine unabhängige Benchmark-Organisation. Ihre Rangliste lässt sich heranziehen, um zu prüfen, ob sich der in Cursor beobachtete Trend auch in einer anderen Umgebung zeigt. Die folgende Momentaufnahme stammt vom 10. November 2026; verwendet wurde die Methodenversion Intelligence Index v5.0.1.
| Konfiguration | Intelligence Index | Kosten pro Aufgabe (US-Dollar) |
|---|---|---|
| Fable 5.2 medium | 56 | 3.80 |
| Fable 5.2 high | 62 | 9.08 |
| Fable 5.2 xhigh | 62 | 14.83 |
| Fable 5.2 max | 65 | 26.54 |
| Opus 5.5 max | 59 | 10.04 |
65 bedeutet nicht 65 % Genauigkeit
Laut der Methodenseite von AA setzt sich der Index in Version 5.0.1 aus neun Benchmarks zusammen, wobei vier Kompetenzbereiche jeweils mit 25 % gewichtet werden. Der Wert 65 ist also ein zusammengesetzter Indexwert und keine Genauigkeit von 65 %. In der AA-Umgebung steigt der Index von high zu max um 3 Punkte; die Kosten pro Aufgabe sind dabei etwa 2,92-mal so hoch. Dass high und xhigh beide den Wert 62 erreichen, bedeutet nur, dass ihre Gesamtpunktzahl gleich ist – nicht, dass sie sich bei jeder einzelnen Aufgabe identisch verhalten.
Die beiden Umgebungen nur jeweils intern vergleichen
In beiden Umgebungen zeigt sich dieselbe Richtung: max erzielt eine höhere Punktzahl und kostet ungefähr dreimal so viel wie high. Das bestätigt den Trend auf gewisse Weise. Allerdings unterscheiden sich AA und Cursor bei den Aufgaben, der Bewertung und der Kostenberechnung. Der Wert 65 von AA und die 60,0 % von Cursor lassen sich daher nicht zu einer gemeinsamen Genauigkeitsangabe zusammenführen.
4 Den passenden Fable-5.2-Modus je nach Aufgabe wählen
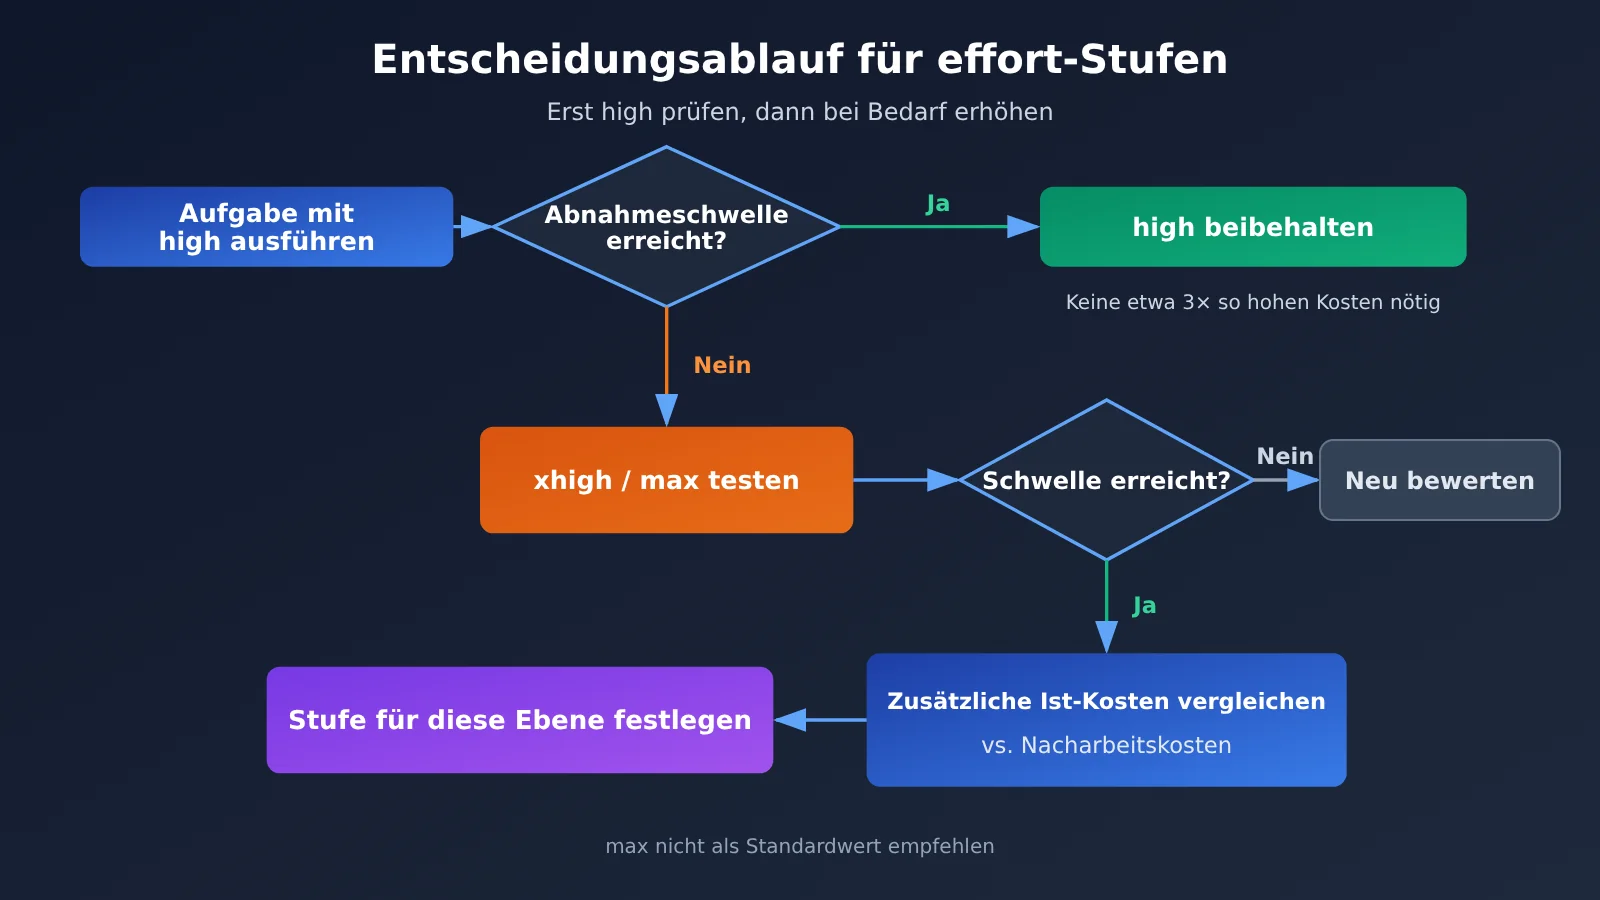
Der offizielle Leitfaden für Eingabeaufforderungen empfiehlt folgende Vorgehensweise: Beginnen Sie bei der API mit der Standardeinstellung high und passen Sie sie anhand Ihrer eigenen Evaluierung nach oben oder unten an. medium eignet sich eher für interaktive Szenarien. xhigh ist für schwierige, umfangreiche Aufgaben gedacht, bei denen ein zusätzlicher Nutzen nachgewiesen wurde. max dient dazu, die Leistungsgrenzen auszuloten, oder kommt bei wenigen Aufgaben zum Einsatz, bei denen weder Zeit noch Token eine Rolle spielen. Bei niedrigeren Stufen sollten Sie außerdem das Risiko berücksichtigen, dass eine Aufgabe vorzeitig beendet wird.
Empfehlungen für typische Fable-5.2-Szenarien
Die drei folgenden Szenarien sind hypothetische Beispiele, die die Auswahl veranschaulichen sollen.
| Hypothetisches Szenario | Empfohlener Einstieg | Wann eine höhere Stufe sinnvoll ist | Nicht empfehlenswert |
|---|---|---|---|
| Anforderungsänderungen (Felder ändern, Schnittstellen anpassen, Tests ergänzen) | Mit medium evaluieren, bei Bedarf high |
Wenn medium Aufgaben vorzeitig beendet oder Änderungen auslässt |
Für kleine Änderungen standardmäßig max verwenden |
| Komplexe Fehlerbehebung (modulübergreifende Bugs, Nebenläufigkeitsprobleme) | high |
Wenn die Erfolgsquote von high die Abnahmeschwelle nicht erreicht |
Ohne vorherige Evaluierung direkt zu xhigh wechseln |
| Langwierige Recherche (offene Fragen, Lösungsansätze erkunden) | Mit high beginnen |
Wenn die Frage wichtig ist, die Kosten eines Fehlschlags hoch sind und Evaluierungen bereits einen Vorteil von max belegt haben |
max als Standardeinstellung für alle Anfragen festlegen |
Wann Fable 5.2 high wählen?
- Für die meisten API-Aufgaben, die anspruchsvolles Schlussfolgern erfordern und klare Abnahmekriterien haben;
- wenn das Team noch kein Evaluierungssystem für die verschiedenen Stufen eingerichtet hat und einen offiziell empfohlenen Ausgangspunkt braucht;
- für Produktionsabläufe mit hohem Anfragevolumen und strengen Kostenanforderungen pro Aufgabe.
Wann Fable 5.2 max wählen?
- Um die Leistungsgrenzen des Modells bei einer bestimmten Art von Problem zu ermitteln;
- bei wenigen offenen Fragen, bei denen die Kosten eines Fehlschlags deutlich höher sind als die Modellkosten;
- wenn eigene Tests bereits belegt haben, dass
maxdie Erfolgsquote über die erforderliche Schwelle hebt,highdies aber nicht schafft.
🎯 Technische Empfehlung: Legen Sie die Stufe für Aufgabengruppen fest, statt sie für jede Anfrage einzeln zu bestimmen. Als bewährte Vorgehensweise empfiehlt der offizielle Leitfaden, zunächst eine Reihe repräsentativer Aufgaben mit
highauszuführen. Wenn Sie den einheitlichen Zugang über APIYI apiyi.com nutzen möchten, sollten Sie vor dem produktiven Start auf der Plattform die aktuelle Modell-ID, die Gruppe, den Endpunkt und die Unterstützung füreffortprüfen.
5 Mit eigenen Abnahmekriterien entscheiden, ob sich ein Upgrade von Fable 5.2 auf max lohnt
Öffentliche Benchmarks zeigen nur Trends. Ob sich ein Upgrade lohnt, sollten deine eigenen Abnahmeergebnisse entscheiden. Die folgende Checkliste kannst du direkt verwenden. Das wichtigste Prinzip: Ändere pro Durchlauf nur die Modellstufe.
| Erfassungspunkt | Anforderung |
|---|---|
| Aufgabe und Eingabe | Dieselben Aufgaben, dieselben Eingaben und dieselbe System-Eingabeaufforderung |
| Tool-Berechtigungen | Identische Tools und Berechtigungen |
| Modell und Stufe | Modell-ID und Effort festhalten; pro Durchlauf nur die Modellstufe ändern |
| Abnahmekriterien | Schwellenwerte vorab festlegen und nicht erst nach Sichtung der Ergebnisse anpassen |
| Usage | Eingabe, Cache-Schreibvorgänge und Cache-Lesevorgänge sowie Ausgabe getrennt erfassen |
| Dauer und Wiederholungen | Gesamtdauer, Anzahl der Wiederholungen und vorzeitigen Abbrüche festhalten |
| Tatsächliche Abrechnung | Maßgeblich sind die tatsächlich abgebuchten Beträge im Plattformprotokoll, nicht Schätzungen anhand offizieller Preise |
| Fehlgeschlagene Fälle | Originalausgaben aufbewahren und analysieren, welche Probleme max behoben hat |
Fable 5.2 schnell ausprobieren: zuerst die Usage erfassen
Das folgende Minimalbeispiel zeigt nur, wie Sie einen Aufruf starten und die Usage erfassen. Dieser Artikel enthält keine Anleitung zur Weitergabe des Parameters effort: Ob Fable 5.2 bereits auf der Plattform verfügbar ist und ob effort weitergegeben werden kann, entnehmen Sie bitte der aktuellen Plattformdokumentation.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # Hier die aktuell von der Plattform bestätigte Modell-ID eintragen
    messages=[{"role": "user", "content": "按验收标准修复以下函数……"}]
)
print(resp.usage)  # Usage für den späteren Kostenabgleich erfassen
Vollständigen Code zur Erfassung und zum Kostenabgleich anzeigen
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Offizielle Anthropic-Standardpreise (USD pro Million Token), nur zur Schätzung; sie entsprechen nicht den tatsächlich abgebuchten Kosten
RATE_IN, RATE_OUT = 8.0, 40.0

def run_task(task_id: str, prompt: str, model: str, effort_label: str, passed_fn):
    """Führt eine Aufgabe aus und gibt einen Abnahmenachweis zurück. effort_label dient nur als Kennzeichnung."""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}]
    )
    text = resp.choices[0].message.content
    u = resp.usage
    est_usd = u.prompt_tokens / 1e6 * RATE_IN + u.completion_tokens / 1e6 * RATE_OUT
    return {
        "task_id": task_id,
        "model": model,
        "effort": effort_label,
        "passed": passed_fn(text),          # Zuvor definierte Abnahmefunktion
        "prompt_tokens": u.prompt_tokens,
        "completion_tokens": u.completion_tokens,
        "est_usd": round(est_usd, 4),       # Geschätzter Wert
        "seconds": round(time.time() - start, 1),
        "output": text,                     # Originaltext fehlgeschlagener Fälle beibehalten
    }

def quota_to_usd(quota: int) -> float:
    """Laut Plattformprotokoll entspricht quota ÷ 500000 dem tatsächlich abgebuchten Betrag in USD."""
    return quota / 500000
Die Protokolldokumentation von APIYI führt unter anderem die Felder model_name, prompt_tokens, completion_tokens, quota, duration_for_view und request_id auf. quota ÷ 500000 entspricht dem tatsächlich abgebuchten Betrag in USD; das Feld other enthält zusätzliche Angaben, etwa zu Gruppenmultiplikatoren. Verknüpfen Sie die Abnahmenachweise über request_id mit den Protokollen, können Sie die tatsächlichen Kosten für „erfolgreiche Aufgaben“ berechnen, statt nur die Kosten einzelner Anfragen zu betrachten.
🚀 Schnellstart: Wenn Sie den Ablauf zunächst mit einer kleinen Stichprobe überprüfen möchten, registrieren Sie sich bei APIYI unter apiyi.com und nutzen Sie das kostenlose Testguthaben für neue Nutzer. Führen Sie damit die Erfassung nach dem Prinzip „gleiche Aufgabe, eine Variable, tatsächlich abgebuchte Kosten“ durch und entscheiden Sie anschließend, ob Sie die Stichprobe vergrößern möchten.
Die wichtigste Entscheidungsregel lautet: Prüfen Sie zuerst, ob high die Qualitätsanforderungen erfüllt. Wenn ja, müssen Sie für die wenigen Prozentpunkte Unterschied nicht etwa das Dreifache bezahlen. Nur wenn high die Anforderungen verfehlt und max sie erfüllt, sollten Sie abwägen, ob die zusätzlichen Kosten für max geringer sind als die Kosten eines Fehlschlags oder einer Nachbesserung. Es empfiehlt sich nicht, max standardmäßig für alle Anfragen zu verwenden.
Häufige Fragen (FAQ)
F1: Welche effort-Stufen gibt es bei Claude Fable 5.2?
Mit effort wird festgelegt, wie viel Denkaufwand das Modell betreibt. Zur Auswahl stehen Stufen von low bis max. Die Einstellung ändert nicht den Preis pro Token, sondern den Denkaufwand, die Anzahl der Schritte, die Laufzeit und den Tokenverbrauch. Deshalb können die Kosten für dieselbe Aufgabe je nach Stufe um ein Vielfaches variieren. Die API verwendet standardmäßig die Stufe high.
F2: Wie groß ist der Unterschied zwischen Fable 5.2 high und max?
In CursorBench 4.0 erreichte high 56,9 % bei Kosten von 9,70 US-Dollar, max dagegen 60,0 % bei 32,79 US-Dollar. Das sind 3,1 Prozentpunkte Unterschied; die Kosten liegen etwa beim 3,38-Fachen. In AA kam high auf 62 Punkte bei 9,08 US-Dollar, max auf 65 Punkte bei 26,54 US-Dollar. Die Kosten betragen also etwa das 2,92-Fache. Die beiden Datensätze lassen sich nur jeweils innerhalb ihrer eigenen Umgebung vergleichen.
F3: Von wann stammen diese Daten? Können sie sich ändern?
Fable 5.2 wurde am 9. November 2026 veröffentlicht. Die Daten in diesem Artikel sind eine Momentaufnahme vom 10. November. Die Seiten von AA und Cursor werden laufend aktualisiert. Zahlen können sich durch spätere Versionen, veränderte Aufgabensätze oder angepasste Kostenberechnungen ändern. Bei Zitaten sollte daher das Abrufdatum angegeben werden.
F4: Extra High erzielt einen niedrigeren Wert als High. Sollte man die Stufe also nicht verwenden?
Das ist lediglich das Ergebnis eines einzelnen Durchlaufs von CursorBench 4.0. Daraus lässt sich nicht schließen, dass xhigh bei allen Aufgaben schlechter abschneidet. Offiziell wird empfohlen, xhigh für schwierige, umfangreiche Aufgaben aufzuheben, bei denen eigene Tests bereits einen Vorteil gezeigt haben. Solange kein solcher Vorteil nachgewiesen ist, muss die Stufe nicht standardmäßig aktiviert werden.
F5: Wie kann ich die Kosten verschiedener Fable-5.2-Stufen über die API vergleichen?
Am besten verwendest du für alle Stufen dieselben Aufgaben und änderst nur die Stufe. Halte dabei den usage-Wert und die tatsächlich vom Plattformkonto abgebuchten Kosten fest. Bei Aufrufen über die einheitliche Schnittstelle von APIYI (apiyi.com) kannst du die tatsächliche Abbuchung in US-Dollar anhand von quota÷500000 aus den Protokollen berechnen. Prüfe vor dem Start, welche Modell-ID, Gruppenzuordnung und effort-Stufen die Plattform an diesem Tag unterstützt. Dieser Artikel empfiehlt keine ungeprüfte Methode zur Weitergabe von Parametern.
F6: Welche Einschränkungen haben öffentlich zugängliche Evaluationsergebnisse?
CursorBench ist eine Evaluation eines Tool-Anbieters in dessen eigener Umgebung. Der AA-Index ist ein gewichteter Gesamtwert. Keiner der beiden Werte entspricht der Erfolgsquote in deinem Geschäftsfeld. Auch lässt sich anhand eines Unterschieds von etwa 3 Prozentpunkten nicht beurteilen, ob das Ergebnis statistisch signifikant ist. Erste Einschätzungen auf sozialen Plattformen können als Anhaltspunkt dienen; die endgültige Bewertung sollte jedoch auf deinen eigenen Abnahmetests beruhen.
F7: Lohnt sich max nach einer Preissenkung der API um 20 %?
Nicht unbedingt. Eine Preissenkung spart bei unverändertem Verbrauch entsprechend Geld. Der Tokenverbrauch und die Anzahl der Schritte bei max können jedoch mehr als das Dreifache von high betragen. Der niedrigere Preis pro Token kann durch den höheren Verbrauch leicht wieder aufgezehrt werden. Vergleiche deshalb die tatsächlichen Kosten pro erfolgreich erledigter Aufgabe, statt nur auf den Einzelpreis zu schauen.
Fable 5.2 high und max: Kernaussagen
- Der Stückpreis bleibt gleich, die Rechnung ändert sich:
effortbeeinflusst den Denkaufwand und die Anzahl der Schritte. Bei gleichem Stückpreis können die Kosten pro Aufgabe um ein Mehrfaches variieren. - Die API verwendet standardmäßig high: Der Anbieter empfiehlt, mit high zu beginnen und die Einstellung anschließend anhand eigener Evaluationen nach oben oder unten anzupassen.
- Vergleich in Cursor: Von high zu max steigt der Wert um 3,1 Prozentpunkte, die Kosten liegen etwa beim 3,38-Fachen.
- Vergleich mit AA: Der Index steigt von 62 auf 65, die Kosten liegen etwa beim 2,92-Fachen. Der Wert 65 ist keine Genauigkeit.
- Die Umgebungen dürfen nicht zusammengeführt werden: Beide Evaluationen lassen sich nur jeweils innerhalb ihrer eigenen Umgebung vergleichen. Sie ergeben keinen gemeinsamen Wert für das Preis-Leistungs-Verhältnis.
- max ist für wenige Aufgaben gedacht: Geeignet zur Bewertung der Leistungsgrenze und für offene Fragestellungen mit hohem Mehrwert.
- Anhand der tatsächlich abgerechneten Nutzung prüfen: Verwenden Sie dieselbe Aufgabe, ändern Sie jeweils nur eine Variable und protokollieren Sie die
usage-Werte. Für den Abgleich der Logs können Sie den API-Proxy-Dienst APIYI unter apiyi.com nutzen.
Zusammenfassung
Die Wahl zwischen Fable 5.2 high und max lässt sich auf drei Punkte bringen:
- Stückpreis und Aufgabenrechnung unterscheiden: Die Stufe verändert nicht den Stückpreis, sondern den Ressourceneinsatz.
- Daten nur innerhalb derselben Umgebung auswerten: Sowohl Cursor als auch AA zeigen, dass max etwas höhere Werte erzielt und etwa dreimal so viel kostet wie high. Die Ergebnisse der beiden Umgebungen lassen sich jedoch nicht zusammenführen.
- Die Abnahmekriterien sind entscheidend: Wenn high die Anforderungen erfüllt, sollten Sie dabei bleiben. Erst wenn high nicht ausreicht und max die Anforderungen erfüllt, lohnt es sich, Mehrkosten und Aufwand für Nachbesserungen gegeneinander abzuwägen.
Für die meisten Teams ist es sinnvoll, zunächst mit high Aufgabenklassen und Abnahmekriterien festzulegen und anschließend nur wenige Aufgaben mit hohem Mehrwert gezielt mit max zu bewerten. Über die einheitliche Schnittstelle von APIYI unter apiyi.com und anhand der Aufrufprotokolle können Sie die Einstellungen schnell mit eigenen Beispieldaten überprüfen. Vergewissern Sie sich, dass das Modell und die jeweilige Stufe unterstützt werden, bevor Sie den Einsatz ausweiten.
📚 Quellen
- Veröffentlichungsankündigung von Anthropic: Umfang der Veröffentlichung von Fable und Mythos 5.2 sowie Einschätzung des Anbieters
- Link:
anthropic.com/claude-fable-and-mythos-5-2 -
Hinweis: Das Veröffentlichungsdatum ist der 09.11.2026. Die Seite enthält Angaben zur Geschwindigkeit und eine Benchmark-Tabelle.
-
Claude-API-Preise: Offizielle Standardtarife
- Link:
platform.claude.com/docs/en/about-claude/pricing -
Hinweis: Für Fable 5.2 kosten Ein- und Ausgabe 8 bzw. 40 US-Dollar pro Million Token.
-
Fable 5.2 – Modellspezifikationen: Kontext, Ausgabelimit und standardmäßiger Effort
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview -
Hinweis: Adaptives Denken ist immer aktiviert; der Standardwert der API ist „high“.
-
Fable 5.2 – Leitfaden für Eingabeaufforderungen: Offizielle Empfehlungen zur Auswahl der Stufe
- Link:
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
Hinweis: Anwendungsbereiche der Stufen „medium“, „high“, „xhigh“ und „max“.
-
CursorBench 4.0: Fünfstufige Bewertung in der eigenen Umgebung von Cursor
- Link:
prod.cursor.com/evals -
Hinweis: Eine eigene Bewertung des Tool-Anbieters, keine allgemeine unabhängige Nachprüfung.
-
Modell-Rangliste von Artificial Analysis: Laufend aktualisierte Rangliste einer unabhängigen Organisation
- Link:
artificialanalysis.ai/leaderboards/models -
Hinweis: Intelligence Index und Kosten pro Aufgabe.
-
Evaluierungsmethodik von Artificial Analysis: Aufbau des Intelligence Index v5.0.1
- Link:
artificialanalysis.ai/methodology/intelligence-benchmarking -
Hinweis: 9 Benchmarks; jede der vier Fähigkeitskategorien zählt 25 %.
-
Wie Cursor die Modellqualität vergleicht: Methoden-Blogbeitrag zu einer älteren Benchmark-Version
- Link:
prod.cursor.com/blog/cursorbench -
Hinweis: Nur zum Verständnis der Designidee geeignet, nicht für statistische Schlussfolgerungen zu Version 4.0.
-
APIYI-API zur Protokollabfrage: Protokollfelder und Umrechnung des tatsächlich abgebuchten Betrags
- Link:
docs.apiyi.com/api-capabilities/log-query - Hinweis:
quota÷500000entspricht dem tatsächlich abgebuchten Betrag in US-Dollar.
Autor: Technisches Team von APIYI
Technischer Austausch: Besuchen Sie die Startseite von APIYI unter apiyi.com, um uns zu kontaktieren. Weitere Informationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.