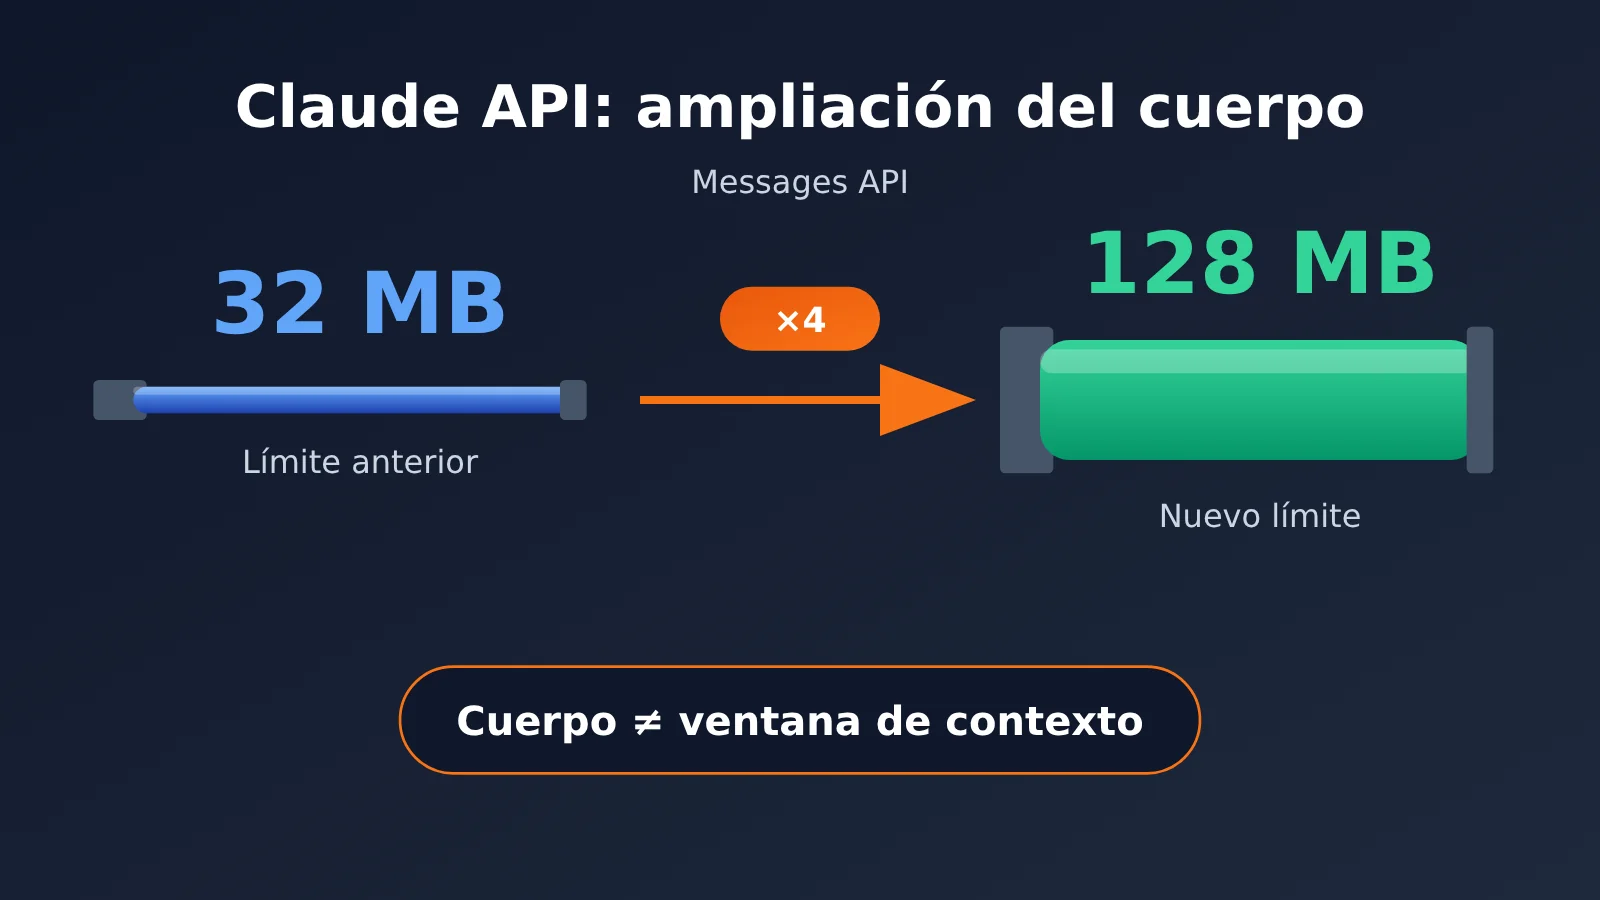
El 28 de octubre de 2026, Anthropic anunció una actualización en su registro oficial de versiones: el tamaño máximo del cuerpo de las solicitudes de Messages API y Token Counting API de la API oficial de Claude pasó de 32 MB a 128 MB, cuatro veces el límite anterior. Tras el anuncio, muchos responsables técnicos de empresas empezaron a plantearse una pregunta práctica: ¿conviene rediseñar los procesos de división, carga y preprocesamiento de archivos grandes que se crearon para sortear el límite de 32 MB?
Esta actualización no significa que «el modelo sea más potente». Lo que cambia es el límite de tamaño del cuerpo de la solicitud en la capa HTTP; no tiene relación con la ventana de contexto del modelo ni con la longitud de la respuesta. Muchas interpretaciones erróneas surgen precisamente de confundir 128 MB con 128K o 1M de tokens.
Valor principal: en este artículo aclaramos primero qué límite ha cambiado con la ampliación del cuerpo de las solicitudes de Claude API. Después, presentamos tres categorías de decisión —A, B y C— según el caso de uso y, por último, ofrecemos un plan de validación de bajo costo y una lista de comprobación. Las recomendaciones de arquitectura son un análisis técnico basado en información oficial, no instrucciones oficiales de migración publicadas por Anthropic.
Datos clave sobre la ampliación del tamaño de solicitud de Claude API
Esta tabla resume los hechos de la actualización de Claude API que servirán de base para el análisis posterior.
| Información | Detalles | Fuente |
|---|---|---|
| Fecha de publicación | 28 de octubre de 2026 | Registro oficial de versiones (S1) |
| Publicado por | Anthropic | Registro oficial de versiones (S1) |
| Endpoints afectados | Messages API y Token Counting API de Claude API | S1, S2 |
| Cambio principal | El tamaño máximo del cuerpo de la solicitud pasa de 32 MB a 128 MB | S1, S2 |
| Qué no cambia | La ventana de contexto del modelo y la longitud de salida no aumentan | S2, S5 |
| Al superar el límite | Se devuelve el error HTTP 413 request_too_large |
S2 |
| Facturación | Se sigue cobrando según el uso de tokens; un cuerpo de solicitud más grande no significa que el procesamiento de archivos sea gratuito | S6 |
Los límites del cuerpo de solicitud varían según el endpoint de Claude API
Es importante tener en cuenta que los endpoints de Claude API no comparten un límite de tamaño de solicitud. Esta actualización solo afecta a Messages y Token Counting; los demás endpoints mantienen sus propios límites. Al tomar decisiones de arquitectura, las empresas no pueden basarse en una sola cifra.
| Endpoint | Límite actual de tamaño de solicitud | Detalles |
|---|---|---|
| Messages API | 128 MB | Aumenta de 32 MB con esta actualización |
| Token Counting API | 128 MB | Aumenta de 32 MB y se iguala al límite de Messages |
| Batch API | 256 MB | Para procesamiento asíncrono por lotes |
| Files API | 500 MB | Límite de almacenamiento de 500 MB por archivo |
| Sessions / Agents / Environments | 32 MB | Mantienen el límite anterior |
Los datos proceden de la documentación oficial de descripción general de la API (S2). Si tu aplicación utiliza tanto Messages como endpoints de Agents, tendrás que planificar los límites de tamaño por separado: no puedes aplicar el límite de 128 MB a ambos.
¿Qué límite cambia realmente con la ampliación del cuerpo de solicitud de Claude API?
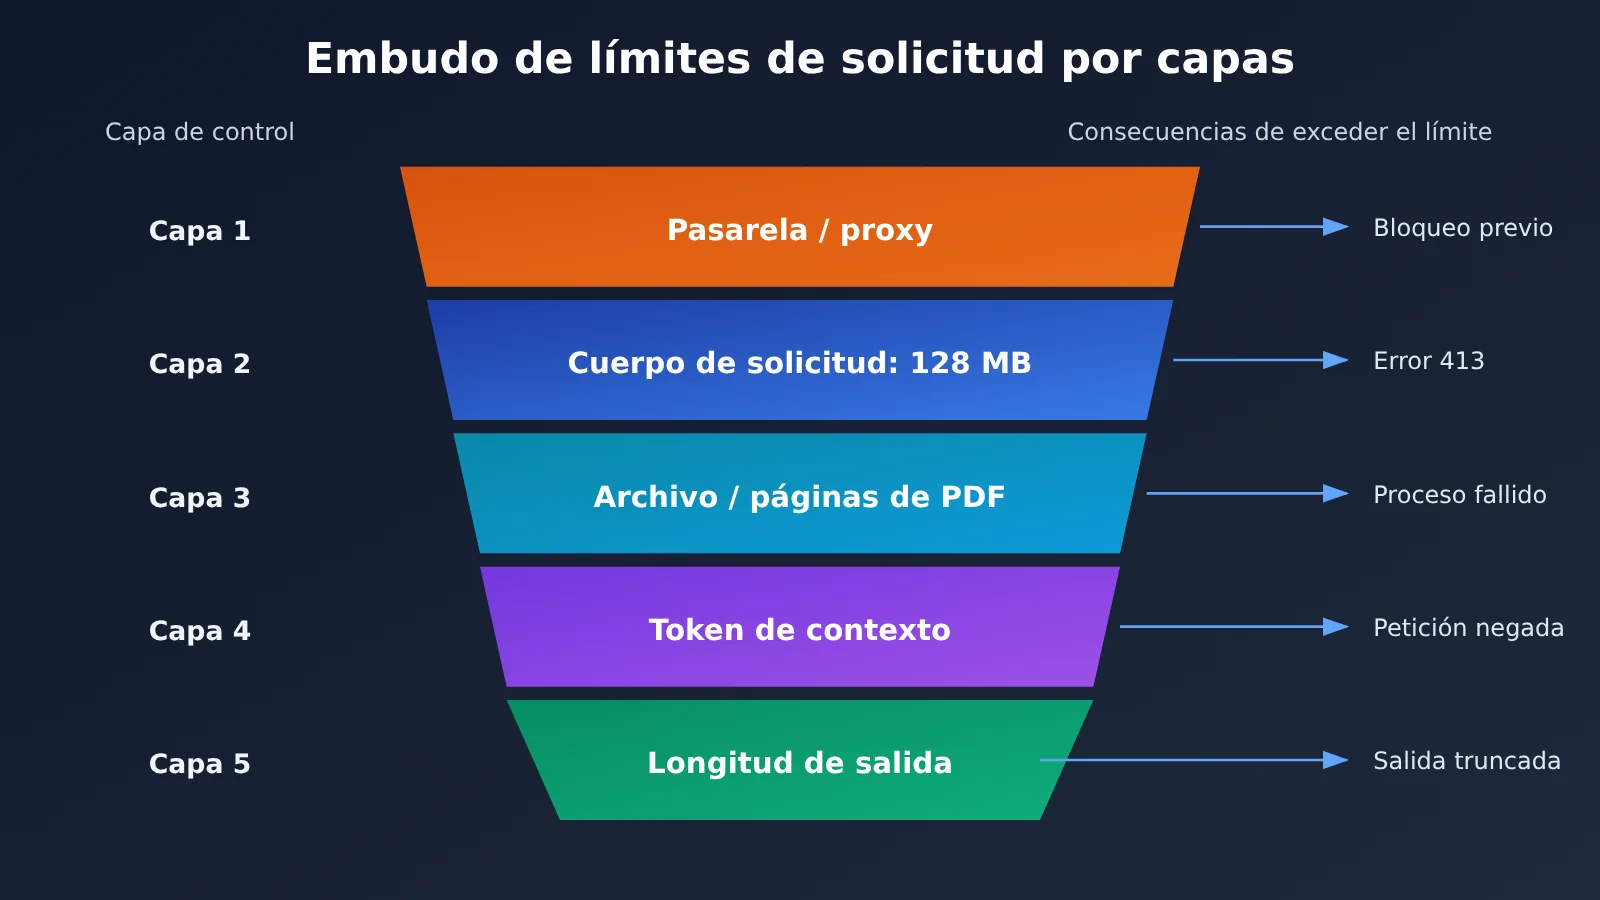
Una llamada a Claude API debe pasar por varias «barreras», y el tamaño del cuerpo de la solicitud es solo la primera. Distinguirlas es clave para decidir si hace falta modificar la arquitectura.
| Tipo de límite | Unidad de medida | ¿Ha cambiado? | Consecuencia de superarlo |
|---|---|---|---|
| Tamaño del cuerpo de la solicitud HTTP | Bytes (MB) | Sí, Messages y Token Counting aumentan a 128 MB | HTTP 413 request_too_large |
| Ventana de contexto del modelo | Tokens | No | La solicitud se rechaza o debe truncarse |
| Límites de archivos y PDF | Tamaño del archivo, número de páginas | El límite del cuerpo de solicitud para PDF es de 128 MB; el número de páginas tiene un límite independiente | El archivo no se puede procesar por completo |
| Longitud de la salida | Tokens | No | La salida se trunca |
Un cuerpo de solicitud de 128 MB no significa que el modelo pueda «entender» 128 MB
El tamaño del cuerpo de la solicitud mide los bytes que se transmiten por la red; la ventana de contexto mide cuántos tokens puede procesar el modelo de una sola vez. Una imagen de alta resolución puede ocupar varios MB y, aun así, no representar necesariamente muchos tokens. En cambio, un texto sin formato puede ocupar solo unos cientos de KB y acercarse al límite de la ventana de contexto. Por eso, «poder enviar más bytes» y «que el modelo pueda comprender más contenido» son cosas distintas.
Además, los contenidos binarios, como imágenes y archivos PDF, suelen codificarse en base64 dentro de las solicitudes JSON. Esa codificación aumenta su tamaño aproximadamente a 4/3 del original. Esto significa que un cuerpo de solicitud de 128 MB puede contener una cantidad considerablemente menor de datos binarios originales. Conviene tener en cuenta esa sobrecarga al calcular el espacio disponible.
Relación entre el cuerpo de solicitud de Claude API y el límite de páginas de PDF
La documentación oficial sobre PDF (S3) indica que, al procesar PDF mediante la API oficial, el cuerpo de la solicitud tiene un límite de 128 MB, pero el número de páginas tiene un límite independiente que depende de la ventana de contexto del modelo utilizado. Es decir, aunque un contrato escaneado de 100 MB pase sin problemas por la capa HTTP, es posible que no se pueda procesar por completo si su número de páginas o de tokens supera los límites aplicables.
Qué aplicaciones empresariales podrían beneficiarse de la ampliación del cuerpo de las solicitudes a la API de Claude
El siguiente análisis es una estimación y parte de que el límite de 32 MB del cuerpo de la solicitud realmente estaba frenando la actividad. Incluso si se cumple esa condición, no significa que estos casos ya no necesiten dividir los datos en partes.
- Análisis de PDF y contratos de gran tamaño: los equipos jurídicos y de auditoría suelen tener que enviar contratos escaneados o informes con varios archivos adjuntos. Los documentos escaneados ocupan mucho espacio, pero contienen relativamente poco texto. Si el principal obstáculo era que el archivo superaba los 32 MB, la ampliación podría permitir enviarlo de una sola vez; si el problema era el número de páginas o los tokens de contexto, la mejora será limitada.
- Envío de varias imágenes o documentos de varias páginas: en casos como las reclamaciones de seguros o las inspecciones de calidad, se suelen adjuntar muchas fotos de campo en una misma solicitud. Al combinar varias imágenes es fácil superar el límite anterior. La ampliación podría reducir la probabilidad de encontrar un error 413, aunque la cantidad de imágenes sigue estando sujeta a las restricciones del modelo y del contexto.
- Aplicaciones de IA con grandes volúmenes de datos estructurados: algunos sistemas incluyen directamente en la solicitud grandes bloques de JSON, registros o tablas. Aunque ahora hay más margen en bytes, estos datos suelen tener una alta densidad de tokens, por lo que es más probable alcanzar primero el límite de la ventana de contexto que el de 128 MB.
- Procesos que antes dividían los datos de entrada solo por el límite de 32 MB: son los beneficiarios más directos. Si la única razón para dividirlos era evitar el límite del cuerpo de la solicitud, ahora vale la pena volver a evaluar si esa división es necesaria.
🎯 Consejo técnico: al evaluar estos casos, conviene medir primero tanto el «tamaño en bytes» como la «cantidad de tokens» con muestras reales, y después identificar dónde está el cuello de botella. A través de APIYI apiyi.com puedes usar una misma clave API para probar y comparar Claude con otros modelos principales. Sin embargo, el límite del cuerpo de la solicitud de una plataforma externa puede ser distinto al de la API oficial, así que confirma el límite que admite la plataforma antes de pasar a producción.
¿Hay que cambiar la arquitectura tras el aumento del límite del cuerpo de solicitud de Claude API? Tres casos: A, B y C
Este es el criterio central del artículo. La necesidad de ajustar la arquitectura no depende de que «haya aumentado el límite oficial», sino del problema que el diseño original intentaba resolver.
| Caso | Características típicas | Acción recomendada | Prioridad |
|---|---|---|---|
| A. Nunca se acerca a los 32 MB | El cuerpo de solicitud suele ocupar unos pocos MB y no hay errores 413 en los registros | Mantener la arquitectura actual y documentar el cambio | Baja |
| B. Errores 413 frecuentes por el tamaño de la solicitud | Los errores 413 request_too_large representan una proporción significativa en el monitoreo |
Probar y optimizar la ruta de carga; evaluar si se puede reducir la división en fragmentos | Alta |
| C. Fragmentación por contexto, precisión, rendimiento o costo | La división busca mejorar la precisión de la recuperación, controlar costos o reducir la latencia | Mantener el diseño de fragmentación, recuperación y caché | Sin cambios |
Caso A: sistemas que nunca se acercan a los 32 MB
En la mayoría de las aplicaciones de conversación solo con texto, atención al cliente y asistencia con código, el cuerpo de cada solicitud está muy por debajo de los 32 MB. Estos sistemas no suelen tener motivos para hacer cambios directos, y una modificación innecesaria solo introduciría nuevos riesgos. Basta con actualizar la información sobre el límite del endpoint en la documentación técnica para facilitar la resolución de problemas en el futuro.
Caso B: sistemas con errores 413 frecuentes por el límite del cuerpo de solicitud
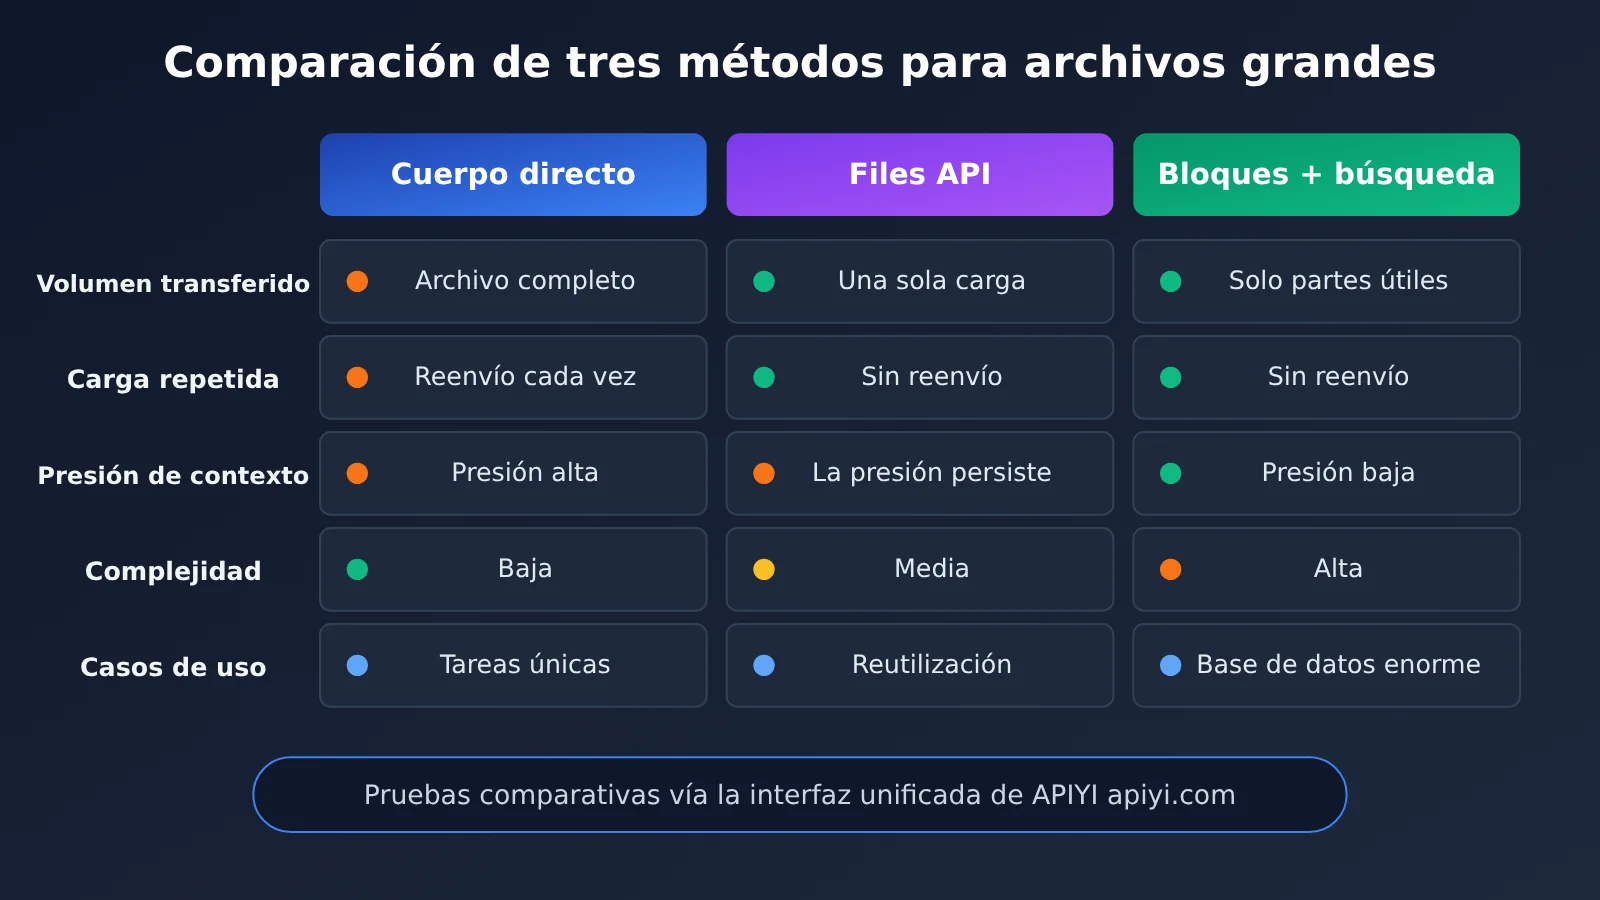
Si el monitoreo muestra errores 413 recurrentes y se confirma que se deben a que el cuerpo de solicitud supera el límite del endpoint Messages, sí vale la pena probar esta actualización. Se puede evaluar si parte de la lógica de división puede sustituirse por un único envío o, directamente, usar referencias file_id de Files API para reducir las transferencias repetidas.
Caso C: fragmentación por calidad, costo o rendimiento
Muchos sistemas RAG dividen el contenido en fragmentos no porque la solicitud sea demasiado grande para enviarse, sino para mejorar la precisión de la recuperación, usar menos tokens en cada invocación y obtener respuestas más rápidas. El aumento del límite del cuerpo de solicitud no cambia estas razones. En estos casos, eliminar la fragmentación podría aumentar los costos y reducir la calidad de las respuestas. Estos sistemas deben conservar los mecanismos necesarios de fragmentación, recuperación y caché.
5 comprobaciones de arquitectura antes de ampliar el cuerpo de las solicitudes a la API de Claude
Incluso si estás en el caso B, conviene revisar cada capa en el siguiente orden. Muchos equipos siguen encontrando errores después de que se amplíe el límite oficial, y la causa suele estar en algún punto intermedio de la cadena.
- Confirma el límite oficial del endpoint de Anthropic que vas a usar: Messages admite 128 MB, pero Sessions / Agents / Environments siguen limitados a 32 MB, Batch a 256 MB y Files a 500 MB (S2).
- Revisa los límites de solicitudes del gateway de API y del proxy inverso: los gateways propios de las empresas, Nginx, los balanceadores de carga y los WAF suelen tener sus propios límites predeterminados, que pueden ser mucho menores de 128 MB. Hay que verificarlos uno por uno.
- Revisa el cliente, el SDK y el método de transferencia: los tiempos de espera, el almacenamiento en memoria y el método de carga del cliente HTTP afectan al envío de solicitudes grandes. También hay que tener en cuenta el aumento de tamaño que provoca la codificación base64.
- Comprueba las restricciones independientes de tokens, contexto y archivos: usa la Token Counting API para estimar el número de tokens y confirma que se respeten el límite de páginas de PDF y la capacidad de la ventana de contexto (S3, S5).
- Evalúa la latencia, los tiempos de espera, los costos y el manejo de errores: las solicitudes grandes tardan más en cargarse y reintentarlas tras un fallo cuesta más. El cobro sigue basándose en tokens (S6), por lo que tendrás que revisar la estrategia de tiempos de espera y reintentos.
Alternativas al envío de archivos en el cuerpo de la solicitud a la API de Claude
Además de incluir archivos grandes directamente en el cuerpo de la solicitud, vale la pena evaluar estas alternativas:
- Files API y referencias mediante
file_id: primero subes el archivo y después lo referencias en los mensajes mediantefile_id, evitando transmitirlo de nuevo en cada solicitud (S4). El límite de almacenamiento por archivo es de 500 MB, pero su procesamiento por el modelo sigue sujeto a restricciones como la capacidad de contexto. - Caché de indicaciones: activar la caché para el prefijo de un documento largo que se reutiliza varias veces puede ayudar a controlar el costo de las entradas repetidas. Consulta las reglas de facturación en la página oficial de precios (S6).
- Mantener la fragmentación + recuperación: para repositorios de información muy extensos, recuperar y enviar solo los fragmentos relevantes suele seguir siendo una opción que equilibra calidad y costo.
Tampoco hay que pasar por alto el riesgo de aislamiento de archivos en entornos multiinquilino. Al usar Files API, los archivos se almacenan a nivel de cuenta de API. Si varios clientes comparten una misma cuenta, es necesario aislar estrictamente los permisos de acceso a file_id en la capa de aplicación, para evitar que una solicitud del inquilino A haga referencia a un archivo del inquilino B.
Cómo verificar a bajo costo los beneficios reales de ampliar el tamaño de las solicitudes a la API de Claude
Por ahora, no hay datos de pruebas que puedan citarse públicamente y que demuestren que la ampliación mejora la velocidad de procesamiento o reduce los costos. Por eso, lo más fiable es hacer una prueba con muestras de tu propio negocio. Lo que sigue es un plan de pruebas, no un conjunto de resultados.
| Nivel de prueba | Tamaño del cuerpo de la solicitud | Qué observar |
|---|---|---|
| Nivel 1 | Muy por debajo de 32 MB | Usarlo como referencia y registrar el tiempo habitual y los tokens |
| Nivel 2 | Cerca de 32 MB | Observar si la conexión es estable cerca del límite anterior |
| Nivel 3 | Más de 32 MB | Comprobar si la puerta de enlace y el SDK permiten la solicitud y si aparece un error 413 |
| Nivel 4 | Cerca de 128 MB | Comprobar los tiempos de espera, el uso de memoria y el costo de los reintentos tras fallos |
Cada nivel debe prepararse dentro de los límites permitidos para el modelo y los archivos. Además, hay que registrar seis métricas: tamaño de la solicitud HTTP, cantidad de tokens, código de estado, tiempo transcurrido, costo y calidad del resultado. Después, procesa el mismo conjunto de muestras con tres métodos: «envío directo», «referencia mediante Files API» y «procesamiento por bloques». Por último, usa los datos para decidir si conviene ajustar el flujo de trabajo actual.
Ejemplo mínimo para medir el cuerpo de una solicitud a la API de Claude
El siguiente código mide los bytes del cuerpo de la solicitud antes de enviarla y captura el error 413 para facilitar el registro de datos durante las pruebas:
import json, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

messages = [{"role": "user", "content": "请总结这份长文档的要点:" + open("doc.txt").read()}]
body_mb = len(json.dumps({"messages": messages}).encode("utf-8")) / 1024 / 1024
print(f"请求体约 {body_mb:.2f} MB")

resp = client.chat.completions.create(model="YOUR_CLAUDE_MODEL", messages=messages)
print(resp.usage)  # 记录 Token 用量
Ver el script completo para registrar las pruebas
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 通过 APIYI 统一接口调用
)

MODEL = "YOUR_CLAUDE_MODEL"  # 替换为平台模型列表中的 Claude 模型名

def run_case(case_name: str, messages: list) -> dict:
    """记录单次请求的体积、Token、状态、耗时,用于方案对比"""
    body = json.dumps({"model": MODEL, "messages": messages}).encode("utf-8")
    record = {
        "case": case_name,
        "body_mb": round(len(body) / 1024 / 1024, 2),
        "status": None,
        "latency_s": None,
        "prompt_tokens": None,
        "completion_tokens": None,
    }
    start = time.time()
    try:
        resp = client.chat.completions.create(model=MODEL, messages=messages)
        record["status"] = 200
        record["prompt_tokens"] = resp.usage.prompt_tokens
        record["completion_tokens"] = resp.usage.completion_tokens
    except openai.APIStatusError as e:
        record["status"] = e.status_code  # 413 即请求体超限
    except Exception as e:
        record["status"] = f"error: {e}"
    record["latency_s"] = round(time.time() - start, 2)
    return record

if __name__ == "__main__":
    text = open("doc.txt", encoding="utf-8").read()
    cases = {
        "baseline": [{"role": "user", "content": "总结要点:" + text[:20000]}],
        "full_direct": [{"role": "user", "content": "总结要点:" + text}],
    }
    results = [run_case(name, msgs) for name, msgs in cases.items()]
    for r in results:
        print(r)
🚀 Inicio rápido: Si tu equipo quiere poner en marcha las pruebas, puede registrarse en APIYI apiyi.com para obtener crédito de prueba y usar el script anterior para registrar los datos de cada tamaño. Ten en cuenta que, al enviar solicitudes a través de una plataforma de terceros, el límite del cuerpo de la solicitud en su gateway podría ser inferior al límite oficial de 128 MB. Consulta la documentación de la plataforma antes de probar solicitudes de gran tamaño.
Preguntas frecuentes (FAQ)
Q1: ¿Qué significa exactamente que el cuerpo de las solicitudes de Claude API admita hasta 128 MB?
Significa que el tamaño máximo de una solicitud HTTP individual a Messages API y Token Counting API de Claude aumentó de 32 MB a 128 MB (S1, S2). No se refiere a la ventana de contexto ni a la longitud de la respuesta.
Q2: ¿Qué diferencia hay entre un cuerpo de solicitud de 128 MB y una ventana de contexto de 128K o 1M de tokens?
El primero mide en bytes la cantidad de datos transmitidos por la red; la segunda mide en tokens la capacidad de procesamiento del modelo. Son unidades completamente distintas. Que puedas enviar una solicitud no significa que todo su contenido quepa en la ventana de contexto; el presupuesto de tokens debe estimarse por separado con Token Counting API.
Q3: ¿El aumento del límite hará que el procesamiento sea más rápido o más económico?
No hay datos oficiales ni pruebas públicas que lo demuestren. El costo sigue calculándose según el uso de tokens (S6), y un cuerpo de solicitud más grande también puede tardar más en subirse. Para saber si ofrece alguna ventaja, hay que probarlo con muestras de tu propio caso de uso.
Q4: ¿Cómo puedo comprobar rápidamente mediante la API el impacto de este cambio en mi caso de uso?
Puedes seguir el plan de pruebas de cuatro niveles de este artículo. Tras registrarte en APIYI apiyi.com y obtener una clave API, configura base_url como `https://api.apiyi.com/v1` y usa el script de prueba para registrar el tamaño, los tokens, el código de estado y el tiempo de respuesta. Como los límites de la plataforma pueden diferir de los oficiales, confirma primero el máximo admitido antes de probar los niveles de mayor tamaño.
Q5: ¿Hay que eliminar el sistema de fragmentación de RAG que ya tengo?
Normalmente no. Si fragmentas los documentos para mejorar la precisión de la recuperación, controlar el costo de tokens o reducir la latencia, esas razones siguen siendo válidas. Solo vale la pena reconsiderarlo si el único motivo para fragmentar era evitar el límite de 32 MB.
Q6: ¿Cuáles son las limitaciones conocidas del nuevo límite del cuerpo de solicitud de Claude API?
Hay tres principales: los endpoints de Sessions / Agents / Environments siguen limitados a 32 MB; el número de páginas de los PDF y la ventana de contexto tienen sus propias restricciones; y las pasarelas empresariales, los proxies y las plataformas de terceros pueden tener límites más bajos. Si quieres comparar el rendimiento de varios modelos con documentos grandes, puedes usar la interfaz unificada de APIYI apiyi.com, teniendo en cuenta el límite que admita realmente la plataforma.
Ampliación del cuerpo de solicitud de Claude API: puntos clave
- Qué cambió: el límite del cuerpo de las solicitudes de Messages y Token Counting pasó de 32 MB a 128 MB. Es un ajuste en la capa HTTP.
- Qué no cambió: la ventana de contexto, la longitud de salida y el método de facturación por tokens siguen igual.
- Diferencias entre endpoints: Batch admite 256 MB y Files, 500 MB; los endpoints de tipo Agents siguen limitados a 32 MB.
- Criterio de decisión: determina si la división original se hizo para evitar el límite de tamaño o por motivos de calidad, coste y rendimiento.
- Revisión de la cadena: los límites de gateways, proxies y SDK suelen activarse antes que el límite oficial.
- Cómo verificarlo: compara el envío directo, las referencias a archivos y la división en bloques en cuatro rangos de tamaño. Puedes usar la interfaz unificada de APIYI apiyi.com para ejecutar las pruebas.
Conclusión: un cuerpo de solicitud más grande en Claude API no obliga a desmontar el sistema existente
La ampliación del cuerpo de solicitud de Claude API se resume en tres puntos:
- Se amplió la entrada: la API oficial de Messages permite enviar más bytes en una sola solicitud, lo que da más margen a los procesos que antes se encontraban con errores 413.
- Los demás límites no cambiaron: la ventana de contexto, el número de páginas de los PDF, la facturación por tokens y los límites de otros endpoints deben evaluarse por separado.
- Los cambios dependen del cuello de botella: las decisiones de arquitectura deben basarse en los problemas reales del negocio, la calidad de los resultados, los costes y los requisitos de seguridad, no solo en la noticia.
Para la mayoría de las empresas, lo más prudente es revisar primero los registros, probar después con muestras y, por último, decidir el alcance de los cambios. Esta lista de comprobación está lista para ponerla en práctica:
- [ ] Medir la frecuencia de los errores 413
request_too_largerecientes e identificar los endpoints de origen - [ ] Confirmar qué endpoints usa la aplicación y sus límites oficiales (Messages / Batch / Files / Agents)
- [ ] Comprobar los límites del cuerpo de solicitud en gateways propios, proxies inversos, WAF y balanceadores de carga
- [ ] Revisar los tiempos de espera y la configuración de búfer del SDK y del cliente HTTP, teniendo en cuenta el aumento de tamaño por base64
- [ ] Usar la API de Token Counting para estimar el número de tokens de las solicitudes grandes y el margen disponible en la ventana de contexto
- [ ] Comparar el envío directo, las referencias mediante Files API y la división en bloques en cuatro rangos de tamaño
- [ ] Evaluar el aislamiento de
file_identre inquilinos y las políticas de seguridad de datos - [ ] Decidir si se necesitan ajustes según los datos y actualizar la documentación técnica interna
Puedes usar APIYI apiyi.com para montar rápidamente un entorno de pruebas comparativas. Con una sola clave API puedes invocar varios de los principales modelos y validar las distintas opciones con muestras reales.
📚 Referencias
- Registro oficial de novedades de Anthropic: anuncio del ajuste del límite del cuerpo de la solicitud del 28 de octubre de 2026
- Enlace:
platform.claude.com/docs/en/release-notes/overview -
Descripción: fuente original del aumento de 32 MB a 128 MB (S1)
-
Descripción general de la API de Claude y límites de los endpoints: límites de tamaño de solicitud y explicación del error 413
- Enlace:
platform.claude.com/docs/en/api/overview -
Descripción: comparación de los límites de los endpoints Messages, Batch, Files y Agents, entre otros (S2)
-
Documentación de soporte para PDF: límites del cuerpo de la solicitud y del número de páginas de los PDF
- Enlace:
platform.claude.com/docs/en/build-with-claude/pdf-support -
Descripción: lectura imprescindible antes de procesar archivos PDF grandes (S3)
-
Documentación de Files API: carga de archivos, referencias mediante
file_id, almacenamiento y permisos - Enlace:
platform.claude.com/docs/en/build-with-claude/files -
Descripción: recursos para evaluar el uso de referencias a archivos y el aislamiento entre inquilinos (S4)
-
Documentación de la ventana de contexto: capacidad de tokens del modelo
- Enlace:
platform.claude.com/docs/en/build-with-claude/context-windows -
Descripción: ayuda a distinguir entre el límite de bytes y el límite de tokens (S5)
-
Información oficial sobre precios y caché: facturación por tokens y almacenamiento en caché de indicaciones
- Enlace:
platform.claude.com/docs/en/about-claude/pricing - Descripción: referencia para evaluar el impacto en los costos (S6)
Autor: Equipo técnico de APIYI
Consultas técnicas: Puedes contactarnos desde la página principal de APIYI en apiyi.com. Para acceder a más recursos de integración, visita el centro de documentación en docs.apiyi.com.