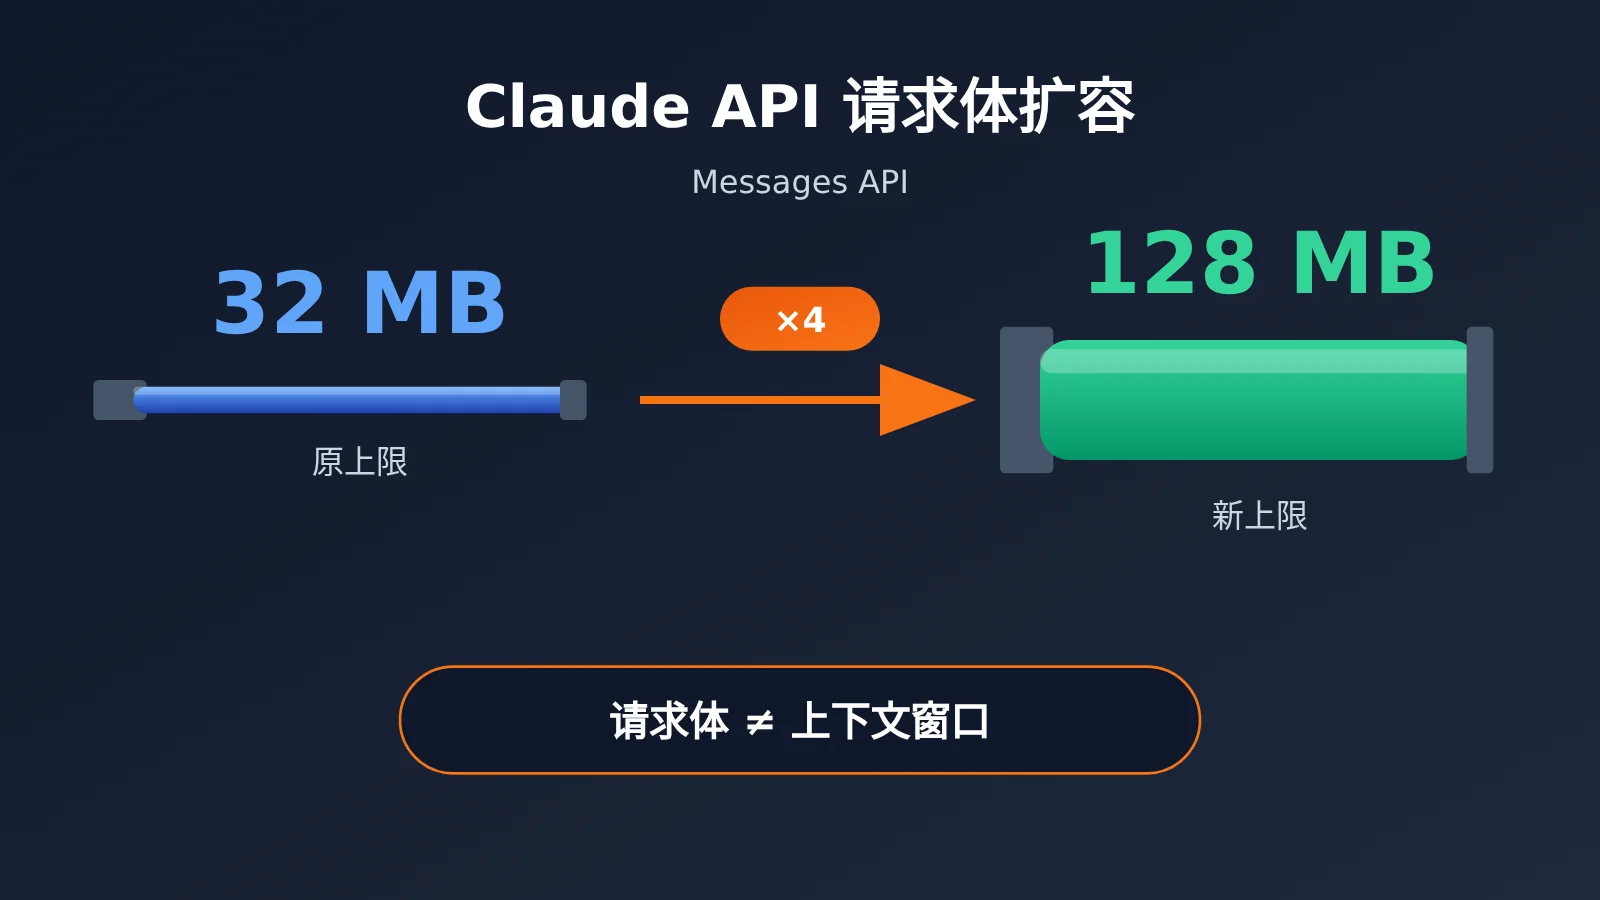
2026 年 10 月 28 日,Anthropic 在官方发布日志中公布了一项更新:第一方 Claude API 的 Messages API 和 Token Counting API 最大请求体从 32 MB 提高至 128 MB,上限变为原来的四倍。消息发出后,不少企业技术负责人开始考虑一个实际问题:原先为了绕开 32 MB 限制而设计的大文件拆分、上传和预处理流程,现在是否应该重做?
这不是一次“模型变强了”的更新,它调整的是 HTTP 层面的请求体积上限,与模型上下文窗口、输出长度无关。很多误判正是源于把 128 MB 和 128K Token、1M Token 混为一谈。
核心价值:本文先厘清 Claude API 请求体扩容到底改了哪一道限制,再按业务场景给出 A/B/C 三类判断,最后提供一份可执行的低成本验证计划和检查清单。文中架构建议属于基于官方信息的技术分析,并非 Anthropic 发布的官方迁移指令。
Claude API 请求体扩容核心信息速览
先用一张表把这次 Claude API 请求体更新的事实部分固定下来,后续分析都以此为基础。
| 信息项 | 详情 | 来源 |
|---|---|---|
| 发布时间 | 2026 年 10 月 28 日 | 官方发布日志(S1) |
| 发布方 | Anthropic | 官方发布日志(S1) |
| 涉及端点 | 第一方 Claude API 的 Messages API、Token Counting API | S1、S2 |
| 核心变化 | 最大请求体由 32 MB 提高至 128 MB | S1、S2 |
| 未变化的部分 | 模型上下文窗口、输出长度不随之扩大 | S2、S5 |
| 超限表现 | 返回 HTTP 413 request_too_large 错误 |
S2 |
| 计费方式 | 仍按 Token 用量计费,请求体变大不代表文件处理免费 | S6 |
Claude API 各端点请求体上限并不统一
需要特别注意,第一方 Claude API 的各个端点并没有统一的请求大小上限。这次只调整了 Messages 和 Token Counting 两个端点,其他端点维持各自的限制,企业在做架构判断时不能只看一个数字。
| 端点 | 当前请求大小上限 | 说明 |
|---|---|---|
| Messages API | 128 MB | 本次从 32 MB 提升 |
| Token Counting API | 128 MB | 本次从 32 MB 提升,与 Messages 保持一致 |
| Batch API | 256 MB | 批量异步处理场景 |
| Files API | 500 MB | 单文件存储上限 500 MB |
| Sessions / Agents / Environments | 32 MB | 维持原限制 |
数据来源为官方 API 概览文档(S2)。如果你的业务同时使用 Messages 和 Agents 类端点,两者的体积预算仍然需要分开设计,不能按 128 MB 统一处理。
Claude API 请求体扩容真正改变的是哪一道限制
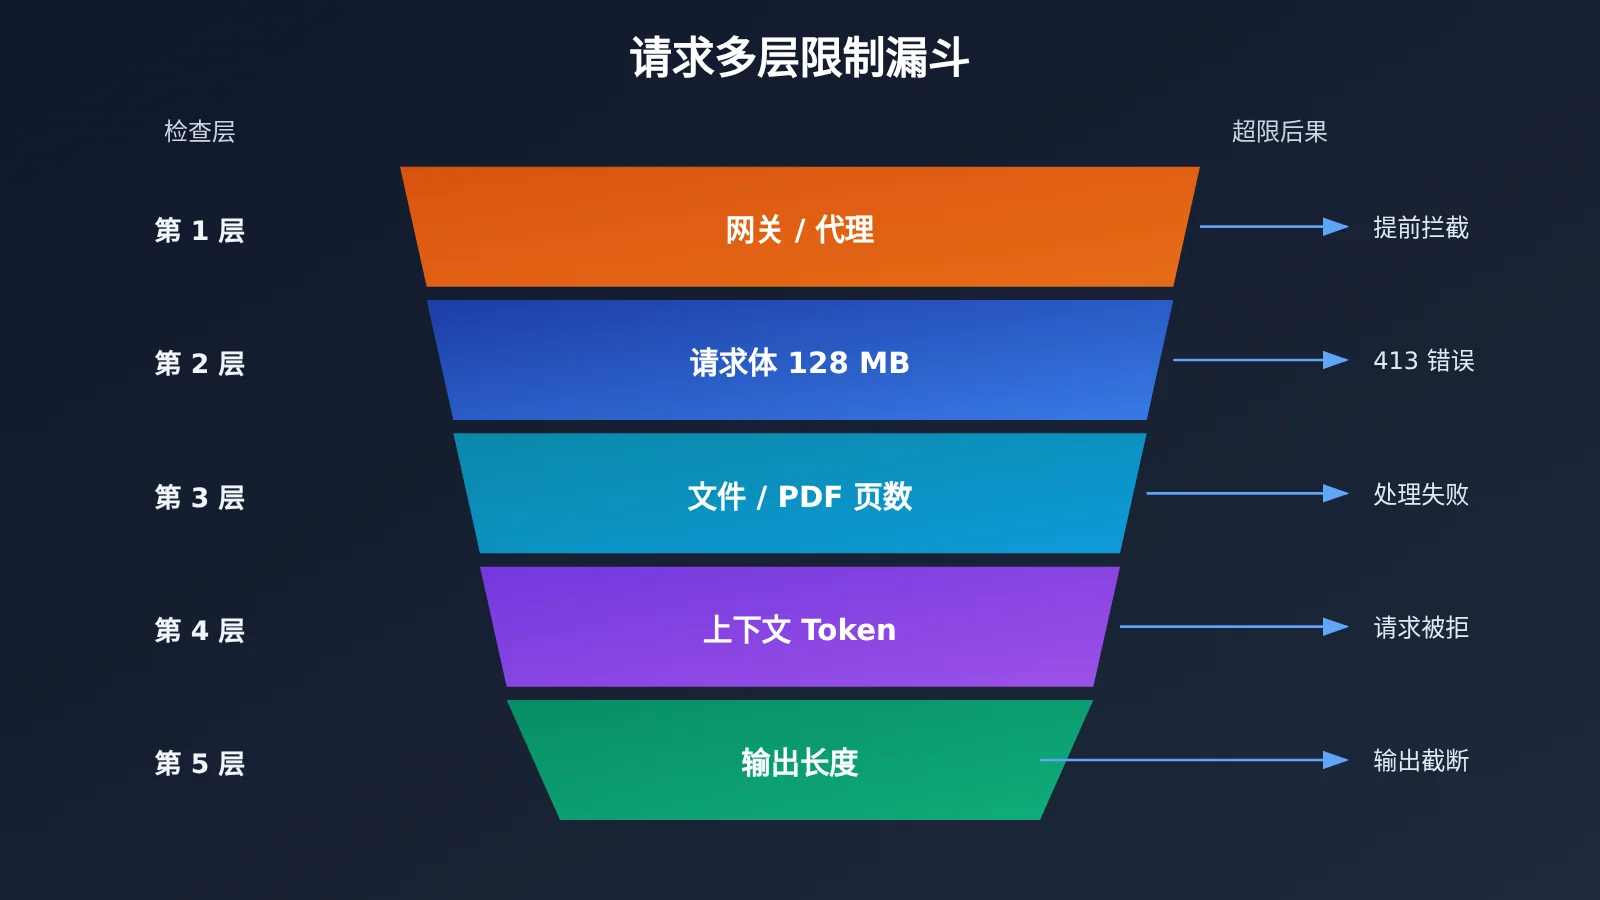
一次 Claude API 调用实际要通过好几道“闸门”,请求体大小只是最外层的一道。把这几道闸门分清楚,是判断要不要改架构的前提。
| 限制类型 | 衡量单位 | 本次是否变化 | 超限后果 |
|---|---|---|---|
| HTTP 请求体大小 | 字节(MB) | 是,Messages / Token Counting 升至 128 MB | HTTP 413 request_too_large |
| 模型上下文窗口 | Token | 否 | 请求被拒绝或需要截断 |
| 文件与 PDF 限制 | 文件大小、页数 | PDF 请求体限制为 128 MB,页数另有限制 | 文件无法被完整处理 |
| 输出长度 | Token | 否 | 输出被截断 |
请求体 128 MB 不等于模型能“读懂”128 MB
请求体大小衡量的是网络传输的字节数,上下文窗口衡量的是模型一次能处理的 Token 数。一张高分辨率图片可能占好几 MB 字节,换算成 Token 却未必很多;一段纯文本只占几百 KB,Token 数量却可能直接逼近上下文上限。所以“能发送更多字节”和“模型能理解更多内容”是两回事。
另外,图片、PDF 等二进制内容在 JSON 请求中通常需要 base64 编码,编码后体积大约膨胀为原始大小的 4/3。这意味着 128 MB 的请求体实际能承载的原始二进制文件,要明显小于 128 MB,估算预算时应当把这部分开销算进去。
Claude API 请求体与 PDF 页数限制的关系
官方 PDF 文档(S3)说明,第一方接口处理 PDF 时请求体限制为 128 MB,但页面数量另有限制,具体取决于所用模型的上下文窗口。也就是说,一份 100 MB 的扫描合同即使能顺利通过 HTTP 层,仍可能因为页数或 Token 超出上下文而无法完整处理。
Claude API 请求体扩容后哪些企业应用可能受益
以下分析属于推断,前提是业务原本确实被 32 MB 的请求体限制卡住。即便满足前提,也不代表这些场景从此不再需要分块。
- 大型 PDF 与合同分析:法务、审计类业务常需要提交扫描版合同或多附件报告,扫描件体积大但文字密度低。若此前的主要障碍是文件体积超过 32 MB,扩容后有机会改为单次提交;若障碍是页数或上下文 Token,则改善有限。
- 多图或多页材料提交:保险理赔、质检巡检等场景会在一次请求中附带大量现场照片。多图叠加后容易超出旧上限,扩容可能降低遇到 413 的概率,但图片数量本身仍受模型和上下文约束。
- 携带较长结构化数据的 AI 应用:部分系统会把大段 JSON、日志或表格直接放进请求。字节层面的余量变大了,但这类数据往往 Token 密度很高,更容易先撞上上下文窗口,而不是 128 MB。
- 原先仅因 32 MB 而拆分输入的业务:这是最直接的受益者。如果拆分的唯一理由就是绕开请求体限制,那么现在值得重新评估拆分的必要性。
🎯 技术建议:在评估这些场景时,建议先用真实样本测出“字节体积”和“Token 数量”两组数据,再判断瓶颈在哪一层。通过 API易 apiyi.com 可以用同一个 API Key 调用 Claude 及其他主流模型做对照测试,但第三方平台自身的请求体上限可能与官方第一方接口不同,正式上线前请先确认平台当前支持的上限。
Claude API 请求体扩容后现有架构要不要改:A/B/C 三类判断
这是本文最核心的判断框架。是否需要调整架构,不取决于“官方上限变大了”,而取决于“你原来的设计是为了解决什么问题”。
| 情况 | 典型特征 | 建议动作 | 优先级 |
|---|---|---|---|
| A. 从未接近 32 MB | 请求体通常只有几 MB,日志中没有 413 | 维持现状,记录本次变化即可 | 低 |
| B. 频繁因请求体报 413 | 监控里 413 request_too_large 占比明显 |
测试并优化上传路径,评估减少拆分 | 高 |
| C. 分块源于上下文、准确率、性能或费用 | 拆分是为了检索精度、控成本或降延迟 | 保留分块、检索与缓存设计 | 不变 |
情况 A:从未接近 32 MB 的系统
大多数纯文本对话、客服问答、代码辅助类应用,单次请求体远低于 32 MB。这类系统通常没有直接的调整动力,强行改造只会引入新风险。只需在技术文档中更新端点上限信息,方便以后排查问题即可。
情况 B:因请求体限制频繁报 413 的系统
如果监控显示 413 错误集中出现,而且确认是 Messages 端点的请求体超限,那么这次更新确实值得投入测试。可以评估把部分拆分逻辑改成单次提交,或者干脆改用 Files API 的 file_id 引用方式,减少重复传输。
情况 C:分块是为了质量、成本或性能
很多 RAG 系统做分块,并不是因为请求太大发不出去,而是为了让检索更准、让每次调用的 Token 更少、让响应更快。请求体扩容并不会改变这些动机,此时取消分块反而可能导致成本上升、答案质量下降。这一类系统应保留必要的分块、检索和缓存设计。
Claude API 请求体扩容前的 5 步架构检查
即使属于情况 B,也建议按以下顺序逐层检查。很多团队在官方上限放开后仍然报错,原因往往出在中间链路上。
- 确认 Anthropic 目标端点的官方上限:Messages 为 128 MB,但 Sessions / Agents / Environments 仍是 32 MB,Batch 为 256 MB,Files 为 500 MB(S2)。
- 检查 API 网关和反向代理的请求限制:企业自建网关、Nginx、负载均衡、WAF 往往有自己的默认上限,可能远低于 128 MB,需要逐一核对。
- 检查客户端、SDK 与传输方式:HTTP 客户端的超时、内存缓冲、上传方式都会影响大请求能否发出,base64 编码带来的体积膨胀也要计入。
- 核对 Token、上下文与文件的独立约束:用 Token Counting API 预估 Token 数,确认 PDF 页数与上下文窗口是否允许(S3、S5)。
- 评估延迟、超时、成本和错误处理:大请求的上传耗时更长,失败重试代价更高;费用仍按 Token 计算(S6),需要重新设计超时与重试策略。
Claude API 请求体之外的可选策略
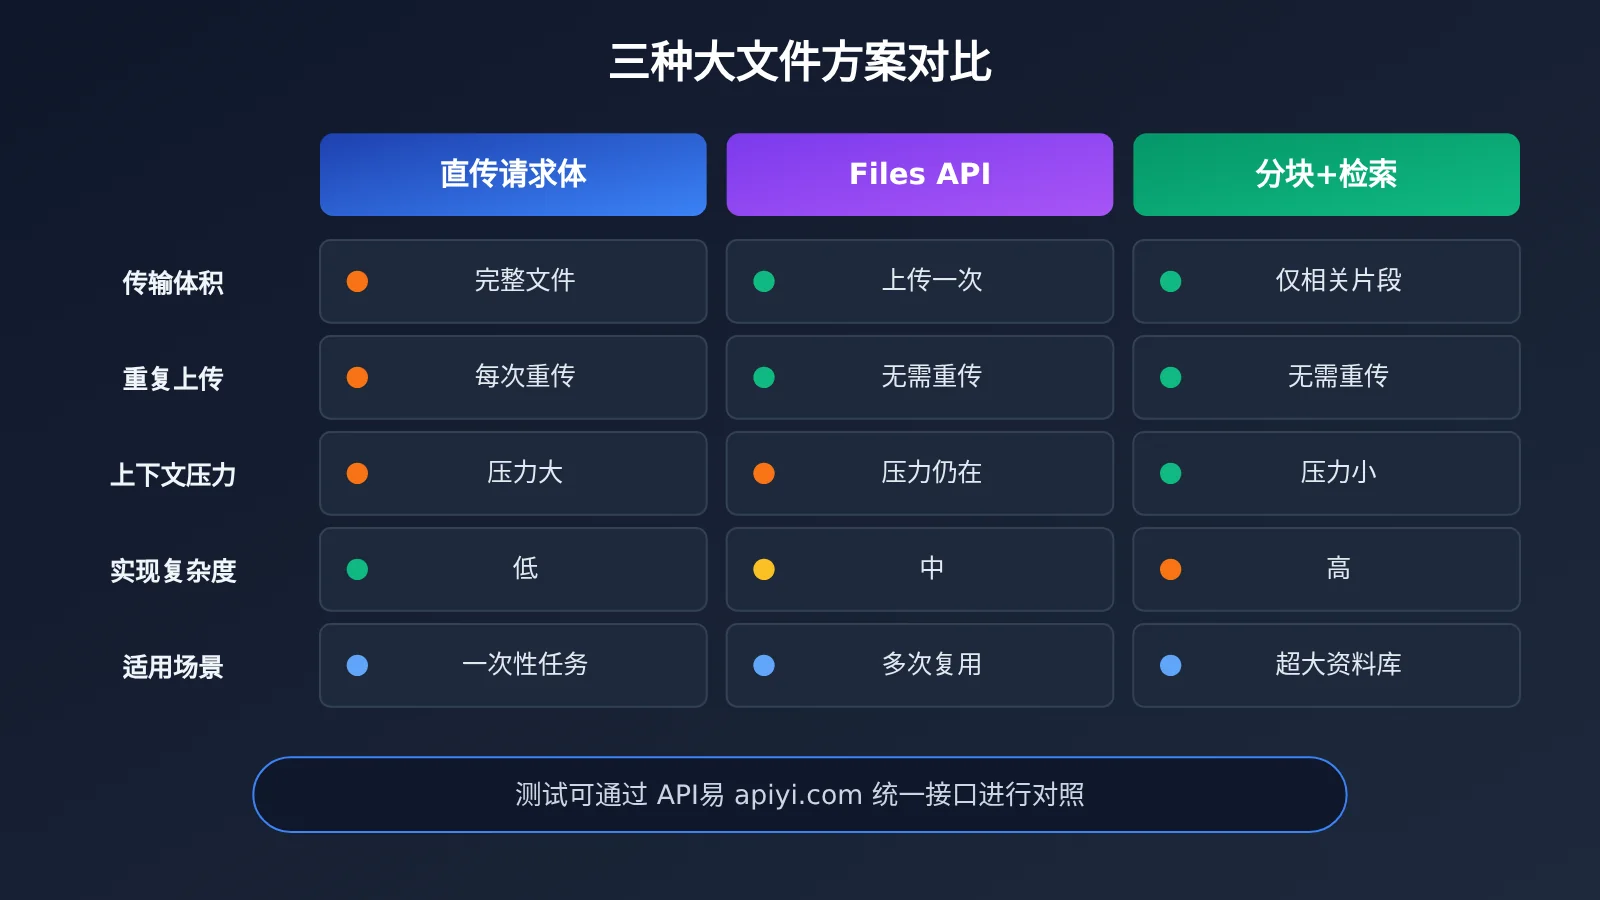
除了直接把大文件塞进请求体,还有几种可选方案值得一起评估:
- Files API 与
file_id引用:先上传文件,再在消息中通过file_id引用,避免同一份文件在多次请求中重复传输(S4)。单文件存储上限为 500 MB,但模型处理时仍受上下文容量等限制。 - 提示缓存:对多次复用的长文档前缀启用缓存,可能有助于控制重复输入的成本,具体计费规则以官方价格页(S6)为准。
- 保留分块 + 检索:对超长资料库,检索后只送相关片段,通常仍是兼顾质量与成本的方案。
多租户文件隔离风险同样不能忽视。使用 Files API 时,文件存放在 API 账户维度下,如果多个客户共用同一账户,需要在应用层严格隔离 file_id 的访问权限,防止 A 租户的请求引用到 B 租户的文件。
如何低成本验证 Claude API 请求体扩容的实际收益
目前没有可公开引用的实测数据可以证明扩容后处理速度提高或成本下降,所以最可靠的做法是用自己的业务样本测一次。下面是一份测试计划,并非测试结果。
| 测试档位 | 请求体规模 | 观察重点 |
|---|---|---|
| 档位 1 | 明显低于 32 MB | 作为基线,记录正常耗时与 Token |
| 档位 2 | 接近 32 MB | 观察旧上限附近链路是否稳定 |
| 档位 3 | 超过 32 MB | 验证网关、SDK 是否放行,是否出现 413 |
| 档位 4 | 接近 128 MB | 验证超时、内存占用与失败重试代价 |
每个档位都应在合法的模型与文件限制范围内构造,并同时记录 HTTP 请求体积、Token 数量、状态码、耗时、费用和结果质量六项指标。然后对同一批样本分别跑“直传”“Files API 引用”“分块处理”三种方案,最后再根据数据判断是否需要调整现有流程。
Claude API 请求体测量极简示例
下面的代码在发送前先测量请求体字节数,并捕获 413 错误,便于在测试中记录数据:
import json, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

messages = [{"role": "user", "content": "请总结这份长文档的要点:" + open("doc.txt").read()}]
body_mb = len(json.dumps({"messages": messages}).encode("utf-8")) / 1024 / 1024
print(f"请求体约 {body_mb:.2f} MB")

resp = client.chat.completions.create(model="YOUR_CLAUDE_MODEL", messages=messages)
print(resp.usage)  # 记录 Token 用量
查看完整测试记录脚本
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 通过 API易 统一接口调用
)

MODEL = "YOUR_CLAUDE_MODEL"  # 替换为平台模型列表中的 Claude 模型名

def run_case(case_name: str, messages: list) -> dict:
    """记录单次请求的体积、Token、状态、耗时,用于方案对比"""
    body = json.dumps({"model": MODEL, "messages": messages}).encode("utf-8")
    record = {
        "case": case_name,
        "body_mb": round(len(body) / 1024 / 1024, 2),
        "status": None,
        "latency_s": None,
        "prompt_tokens": None,
        "completion_tokens": None,
    }
    start = time.time()
    try:
        resp = client.chat.completions.create(model=MODEL, messages=messages)
        record["status"] = 200
        record["prompt_tokens"] = resp.usage.prompt_tokens
        record["completion_tokens"] = resp.usage.completion_tokens
    except openai.APIStatusError as e:
        record["status"] = e.status_code  # 413 即请求体超限
    except Exception as e:
        record["status"] = f"error: {e}"
    record["latency_s"] = round(time.time() - start, 2)
    return record

if __name__ == "__main__":
    text = open("doc.txt", encoding="utf-8").read()
    cases = {
        "baseline": [{"role": "user", "content": "总结要点:" + text[:20000]}],
        "full_direct": [{"role": "user", "content": "总结要点:" + text}],
    }
    results = [run_case(name, msgs) for name, msgs in cases.items()]
    for r in results:
        print(r)
🚀 快速开始:如果团队希望先跑通测试流程,可以在 API易 apiyi.com 注册后获取测试额度,用上面的脚本记录各档位数据。需要注意,经由第三方平台转发时,平台网关的请求体上限可能低于官方第一方的 128 MB,测试大体积档位前请先查阅平台文档确认。
常见问题 FAQ
Q1: Claude API 请求体扩容到 128 MB 具体指什么?
指第一方 Claude API 的 Messages API 和 Token Counting API 单次 HTTP 请求的最大字节数,从 32 MB 提高到 128 MB(S1、S2)。它不是上下文窗口,也不是输出长度。
Q2: 128 MB 请求体和 128K Token、1M Token 上下文有什么区别?
前者按字节衡量网络传输量,后者按 Token 衡量模型的处理容量,两者单位完全不同。请求体能发出去,不代表内容都能放进上下文窗口;Token 预算仍需单独用 Token Counting API 估算。
Q3: 扩容后处理速度会变快、成本会变低吗?
没有官方数据或公开实测能证明这一点。费用仍按 Token 用量计算(S6),更大的请求体还可能带来更长的上传耗时。是否有收益需要用自己的业务样本测试后才能判断。
Q4: 如何通过 API 快速验证 Claude API 请求体变化对业务的影响?
可以按本文的四档测试计划执行。在 API易 apiyi.com 注册获取 API Key 后,将 base_url 设为 `https://api.apiyi.com/v1`,用测试脚本记录体积、Token、状态码与耗时。由于平台限制可能与官方不同,大体积档位请先确认平台支持的上限。
Q5: 已经做好的 RAG 分块系统需要拆掉吗?
通常不需要。如果分块是为了检索准确度、控制 Token 成本或降低延迟,这些动机并未因请求体扩容而改变。只有当分块的唯一理由是绕开 32 MB 限制时,才值得重新评估。
Q6: Claude API 请求体扩容有哪些已知限制?
主要有三点:Sessions / Agents / Environments 端点仍为 32 MB;PDF 页数和上下文窗口另有约束;企业网关、代理及第三方平台可能存在更低的上限。如果想同时对比多个模型在大文档场景的表现,可以借助 API易 apiyi.com 的统一接口做对照,但请以平台实际支持的上限为准。
Claude API 请求体扩容核心要点 Key Takeaways
- 变化本质:Messages 与 Token Counting 请求体从 32 MB 升至 128 MB,属于 HTTP 层调整。
- 未变部分:上下文窗口、输出长度、Token 计费方式都没有变化。
- 端点差异:Batch 256 MB、Files 500 MB,Agents 类端点仍是 32 MB。
- 判断依据:看原有拆分是为了绕开体积限制,还是为了质量、成本与性能。
- 链路排查:网关、代理、SDK 的限制往往比官方上限更早触发。
- 验证方式:按四个体积档位对比直传、文件引用、分块三种方案,可借助 API易 apiyi.com 统一接口执行测试。
总结:Claude API 请求体变大,不等于必须拆掉原有系统
这次 Claude API 请求体扩容的核心意义可以归纳为三点:
- 入口变大了:第一方 Messages 接口单次能发送的字节更多,原先受困于 413 的业务获得了新的余量。
- 其他闸门没变:上下文窗口、PDF 页数、Token 计费和其他端点的限制都需要单独评估。
- 改不改看瓶颈:架构调整应当由实际业务瓶颈、结果质量、成本和安全要求决定,而不是由新闻本身决定。
对于大多数企业,比较稳妥的做法是先查日志、再测样本、最后决定改动范围。以下是一份可直接执行的检查清单:
- [ ] 统计近期 413
request_too_large错误的频率与来源端点 - [ ] 确认业务使用的端点及其官方上限(Messages / Batch / Files / Agents)
- [ ] 核对自建网关、反向代理、WAF、负载均衡的请求体上限
- [ ] 核对 SDK 与 HTTP 客户端的超时、缓冲配置,计入 base64 膨胀
- [ ] 用 Token Counting API 预估大请求的 Token 数与上下文余量
- [ ] 按四档体积对比直传、Files API 引用、分块三种方案
- [ ] 评估多租户
file_id隔离与数据安全策略 - [ ] 根据数据决定是否调整,并同步更新内部技术文档
推荐通过 API易 apiyi.com 快速搭建对照测试环境,一个 API Key 即可调用多种主流模型,便于在真实样本上验证方案取舍。
📚 参考资料
- Anthropic 官方发布日志:2026 年 10 月 28 日请求体上限调整公告
- 链接:
platform.claude.com/docs/en/release-notes/overview -
说明:本次 32 MB 提升至 128 MB 的原始出处(S1)
-
Claude API 概览与端点限制:各端点请求大小上限与 413 错误说明
- 链接:
platform.claude.com/docs/en/api/overview -
说明:Messages、Batch、Files、Agents 等端点上限对照(S2)
-
PDF 支持文档:PDF 请求体与页数限制
- 链接:
platform.claude.com/docs/en/build-with-claude/pdf-support -
说明:处理大型 PDF 前必读(S3)
-
Files API 文档:文件上传、
file_id引用、存储与权限 - 链接:
platform.claude.com/docs/en/build-with-claude/files -
说明:评估文件引用方案与多租户隔离(S4)
-
上下文窗口文档:模型 Token 容量说明
- 链接:
platform.claude.com/docs/en/build-with-claude/context-windows -
说明:区分字节限制与 Token 限制(S5)
-
官方价格与缓存说明:Token 计费与提示缓存
- 链接:
platform.claude.com/docs/en/about-claude/pricing - 说明:评估成本影响的依据(S6)
作者:APIYI 技术团队
技术交流:欢迎在 API易 apiyi.com 网站首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心