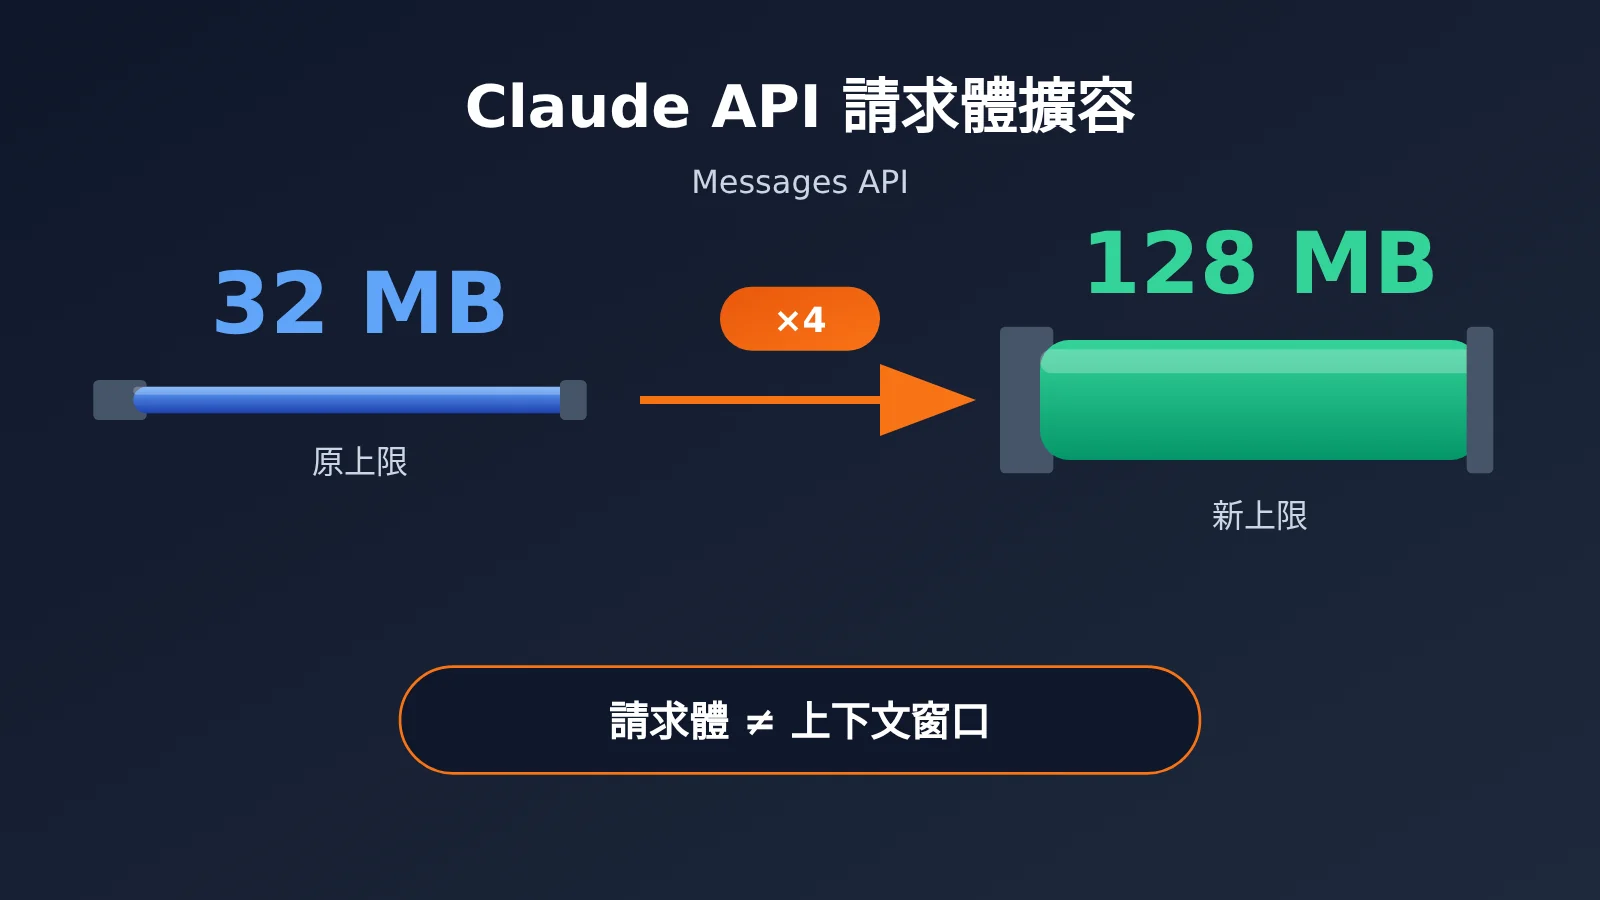
2026 年 10 月 28 日,Anthropic 在官方發佈日誌中公佈了一項更新:第一方 Claude API 的 Messages API 和 Token Counting API 最大請求體從 32 MB 提高至 128 MB,上限變爲原來的四倍。消息發出後,不少企業技術負責人開始考慮一個實際問題:原先爲了繞開 32 MB 限制而設計的大文件拆分、上傳和預處理流程,現在是否應該重做?
這不是一次“模型變強了”的更新,它調整的是 HTTP 層面的請求體積上限,與模型上下文窗口、輸出長度無關。很多誤判正是源於把 128 MB 和 128K Token、1M Token 混爲一談。
核心價值:本文先釐清 Claude API 請求體擴容到底改了哪一道限制,再按業務場景給出 A/B/C 三類判斷,最後提供一份可執行的低成本驗證計劃和檢查清單。文中架構建議屬於基於官方信息的技術分析,並非 Anthropic 發佈的官方遷移指令。
Claude API 請求體擴容核心信息速覽
先用一張表把這次 Claude API 請求體更新的事實部分固定下來,後續分析都以此爲基礎。
| 信息項 | 詳情 | 來源 |
|---|---|---|
| 發佈時間 | 2026 年 10 月 28 日 | 官方發佈日誌(S1) |
| 發佈方 | Anthropic | 官方發佈日誌(S1) |
| 涉及端點 | 第一方 Claude API 的 Messages API、Token Counting API | S1、S2 |
| 核心變化 | 最大請求體由 32 MB 提高至 128 MB | S1、S2 |
| 未變化的部分 | 模型上下文窗口、輸出長度不隨之擴大 | S2、S5 |
| 超限表現 | 返回 HTTP 413 request_too_large 錯誤 |
S2 |
| 計費方式 | 仍按 Token 用量計費,請求體變大不代表文件處理免費 | S6 |
Claude API 各端點請求體上限並不統一
需要特別注意,第一方 Claude API 的各個端點並沒有統一的請求大小上限。這次只調整了 Messages 和 Token Counting 兩個端點,其他端點維持各自的限制,企業在做架構判斷時不能只看一個數字。
| 端點 | 當前請求大小上限 | 說明 |
|---|---|---|
| Messages API | 128 MB | 本次從 32 MB 提升 |
| Token Counting API | 128 MB | 本次從 32 MB 提升,與 Messages 保持一致 |
| Batch API | 256 MB | 批量異步處理場景 |
| Files API | 500 MB | 單文件存儲上限 500 MB |
| Sessions / Agents / Environments | 32 MB | 維持原限制 |
數據來源爲官方 API 概覽文檔(S2)。如果你的業務同時使用 Messages 和 Agents 類端點,兩者的體積預算仍然需要分開設計,不能按 128 MB 統一處理。
Claude API 請求體擴容真正改變的是哪一道限制
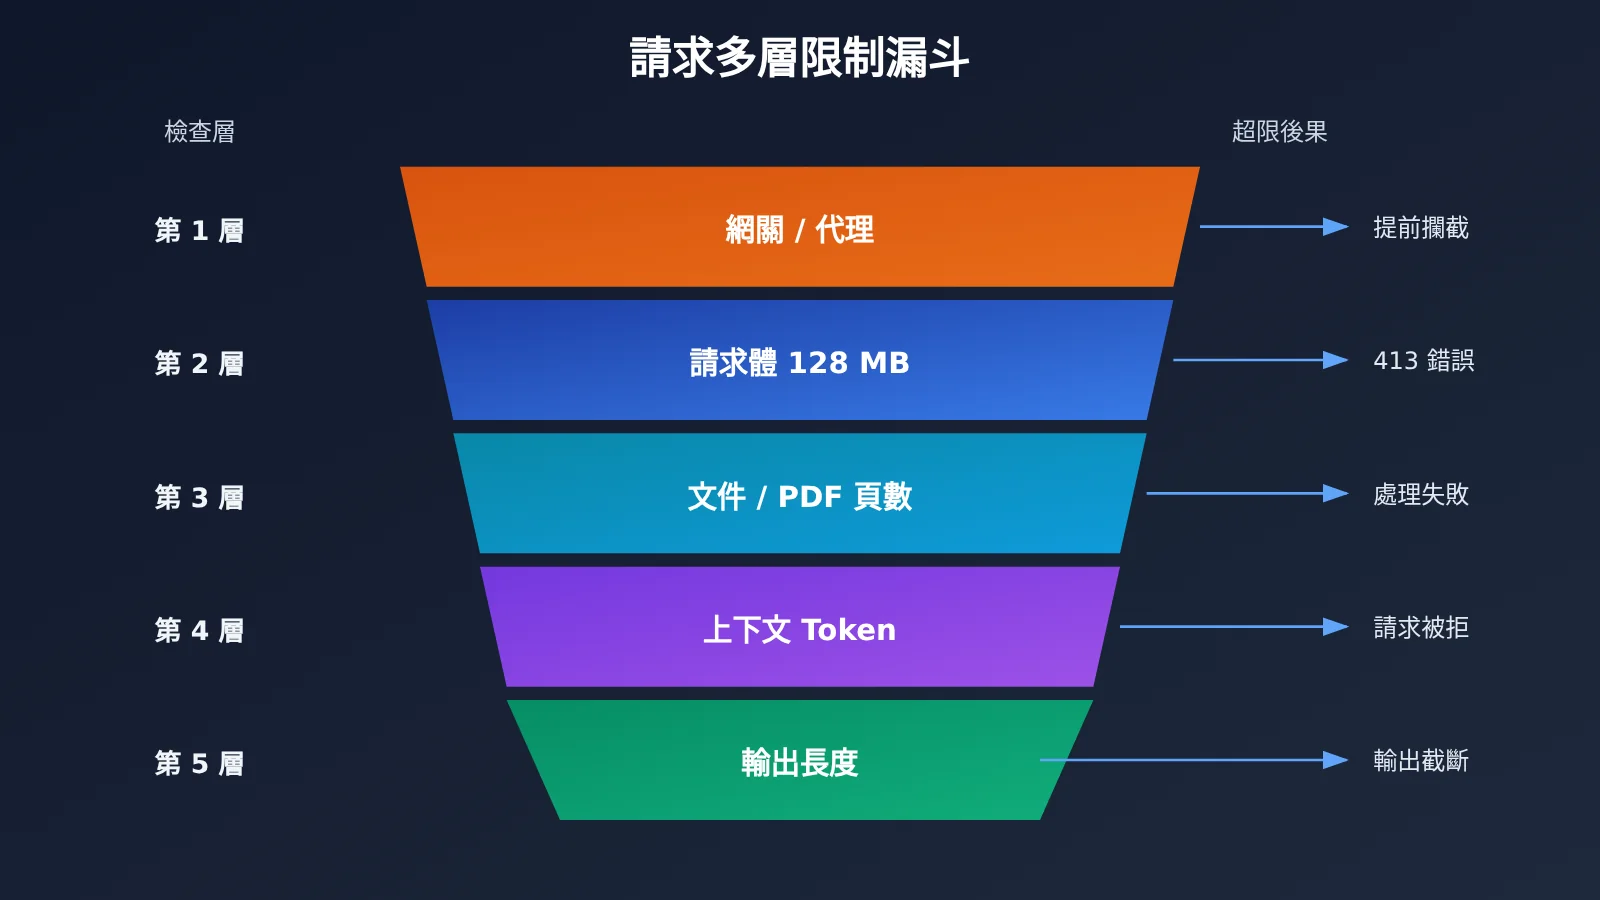
一次 Claude API 調用實際要通過好幾道“閘門”,請求體大小隻是最外層的一道。把這幾道閘門分清楚,是判斷要不要改架構的前提。
| 限制類型 | 衡量單位 | 本次是否變化 | 超限後果 |
|---|---|---|---|
| HTTP 請求體大小 | 字節(MB) | 是,Messages / Token Counting 升至 128 MB | HTTP 413 request_too_large |
| 模型上下文窗口 | Token | 否 | 請求被拒絕或需要截斷 |
| 文件與 PDF 限制 | 文件大小、頁數 | PDF 請求體限制爲 128 MB,頁數另有限制 | 文件無法被完整處理 |
| 輸出長度 | Token | 否 | 輸出被截斷 |
請求體 128 MB 不等於模型能“讀懂”128 MB
請求體大小衡量的是網絡傳輸的字節數,上下文窗口衡量的是模型一次能處理的 Token 數。一張高分辨率圖片可能佔好幾 MB 字節,換算成 Token 卻未必很多;一段純文本只佔幾百 KB,Token 數量卻可能直接逼近上下文上限。所以“能發送更多字節”和“模型能理解更多內容”是兩回事。
另外,圖片、PDF 等二進制內容在 JSON 請求中通常需要 base64 編碼,編碼後體積大約膨脹爲原始大小的 4/3。這意味着 128 MB 的請求體實際能承載的原始二進制文件,要明顯小於 128 MB,估算預算時應當把這部分開銷算進去。
Claude API 請求體與 PDF 頁數限制的關係
官方 PDF 文檔(S3)說明,第一方接口處理 PDF 時請求體限制爲 128 MB,但頁面數量另有限制,具體取決於所用模型的上下文窗口。也就是說,一份 100 MB 的掃描合同即使能順利通過 HTTP 層,仍可能因爲頁數或 Token 超出上下文而無法完整處理。
Claude API 請求體擴容後哪些企業應用可能受益
以下分析屬於推斷,前提是業務原本確實被 32 MB 的請求體限制卡住。即便滿足前提,也不代表這些場景從此不再需要分塊。
- 大型 PDF 與合同分析:法務、審計類業務常需要提交掃描版合同或多附件報告,掃描件體積大但文字密度低。若此前的主要障礙是文件體積超過 32 MB,擴容後有機會改爲單次提交;若障礙是頁數或上下文 Token,則改善有限。
- 多圖或多頁材料提交:保險理賠、質檢巡檢等場景會在一次請求中附帶大量現場照片。多圖疊加後容易超出舊上限,擴容可能降低遇到 413 的概率,但圖片數量本身仍受模型和上下文約束。
- 攜帶較長結構化數據的 AI 應用:部分系統會把大段 JSON、日誌或表格直接放進請求。字節層面的餘量變大了,但這類數據往往 Token 密度很高,更容易先撞上上下文窗口,而不是 128 MB。
- 原先僅因 32 MB 而拆分輸入的業務:這是最直接的受益者。如果拆分的唯一理由就是繞開請求體限制,那麼現在值得重新評估拆分的必要性。
🎯 技術建議:在評估這些場景時,建議先用真實樣本測出“字節體積”和“Token 數量”兩組數據,再判斷瓶頸在哪一層。通過 API易 apiyi.com 可以用同一個 API Key 調用 Claude 及其他主流模型做對照測試,但第三方平臺自身的請求體上限可能與官方第一方接口不同,正式上線前請先確認平臺當前支持的上限。
Claude API 請求體擴容後現有架構要不要改:A/B/C 三類判斷
這是本文最核心的判斷框架。是否需要調整架構,不取決於“官方上限變大了”,而取決於“你原來的設計是爲了解決什麼問題”。
| 情況 | 典型特徵 | 建議動作 | 優先級 |
|---|---|---|---|
| A. 從未接近 32 MB | 請求體通常只有幾 MB,日誌中沒有 413 | 維持現狀,記錄本次變化即可 | 低 |
| B. 頻繁因請求體報 413 | 監控裏 413 request_too_large 佔比明顯 |
測試並優化上傳路徑,評估減少拆分 | 高 |
| C. 分塊源於上下文、準確率、性能或費用 | 拆分是爲了檢索精度、控成本或降延遲 | 保留分塊、檢索與緩存設計 | 不變 |
情況 A:從未接近 32 MB 的系統
大多數純文本對話、客服問答、代碼輔助類應用,單次請求體遠低於 32 MB。這類系統通常沒有直接的調整動力,強行改造只會引入新風險。只需在技術文檔中更新端點上限信息,方便以後排查問題即可。
情況 B:因請求體限制頻繁報 413 的系統
如果監控顯示 413 錯誤集中出現,而且確認是 Messages 端點的請求體超限,那麼這次更新確實值得投入測試。可以評估把部分拆分邏輯改成單次提交,或者乾脆改用 Files API 的 file_id 引用方式,減少重複傳輸。
情況 C:分塊是爲了質量、成本或性能
很多 RAG 系統做分塊,並不是因爲請求太大發不出去,而是爲了讓檢索更準、讓每次調用的 Token 更少、讓響應更快。請求體擴容並不會改變這些動機,此時取消分塊反而可能導致成本上升、答案質量下降。這一類系統應保留必要的分塊、檢索和緩存設計。
Claude API 請求體擴容前的 5 步架構檢查
即使屬於情況 B,也建議按以下順序逐層檢查。很多團隊在官方上限放開後仍然報錯,原因往往出在中間鏈路上。
- 確認 Anthropic 目標端點的官方上限:Messages 爲 128 MB,但 Sessions / Agents / Environments 仍是 32 MB,Batch 爲 256 MB,Files 爲 500 MB(S2)。
- 檢查 API 網關和反向代理的請求限制:企業自建網關、Nginx、負載均衡、WAF 往往有自己的默認上限,可能遠低於 128 MB,需要逐一覈對。
- 檢查客戶端、SDK 與傳輸方式:HTTP 客戶端的超時、內存緩衝、上傳方式都會影響大請求能否發出,base64 編碼帶來的體積膨脹也要計入。
- 覈對 Token、上下文與文件的獨立約束:用 Token Counting API 預估 Token 數,確認 PDF 頁數與上下文窗口是否允許(S3、S5)。
- 評估延遲、超時、成本和錯誤處理:大請求的上傳耗時更長,失敗重試代價更高;費用仍按 Token 計算(S6),需要重新設計超時與重試策略。
Claude API 請求體之外的可選策略
除了直接把大文件塞進請求體,還有幾種可選方案值得一起評估:
- Files API 與
file_id引用:先上傳文件,再在消息中通過file_id引用,避免同一份文件在多次請求中重複傳輸(S4)。單文件存儲上限爲 500 MB,但模型處理時仍受上下文容量等限制。 - 提示緩存:對多次複用的長文檔前綴啓用緩存,可能有助於控制重複輸入的成本,具體計費規則以官方價格頁(S6)爲準。
- 保留分塊 + 檢索:對超長資料庫,檢索後只送相關片段,通常仍是兼顧質量與成本的方案。
多租戶文件隔離風險同樣不能忽視。使用 Files API 時,文件存放在 API 賬戶維度下,如果多個客戶共用同一賬戶,需要在應用層嚴格隔離 file_id 的訪問權限,防止 A 租戶的請求引用到 B 租戶的文件。
如何低成本驗證 Claude API 請求體擴容的實際收益
目前沒有可公開引用的實測數據可以證明擴容後處理速度提高或成本下降,所以最可靠的做法是用自己的業務樣本測一次。下面是一份測試計劃,並非測試結果。
| 測試檔位 | 請求體規模 | 觀察重點 |
|---|---|---|
| 檔位 1 | 明顯低於 32 MB | 作爲基線,記錄正常耗時與 Token |
| 檔位 2 | 接近 32 MB | 觀察舊上限附近鏈路是否穩定 |
| 檔位 3 | 超過 32 MB | 驗證網關、SDK 是否放行,是否出現 413 |
| 檔位 4 | 接近 128 MB | 驗證超時、內存佔用與失敗重試代價 |
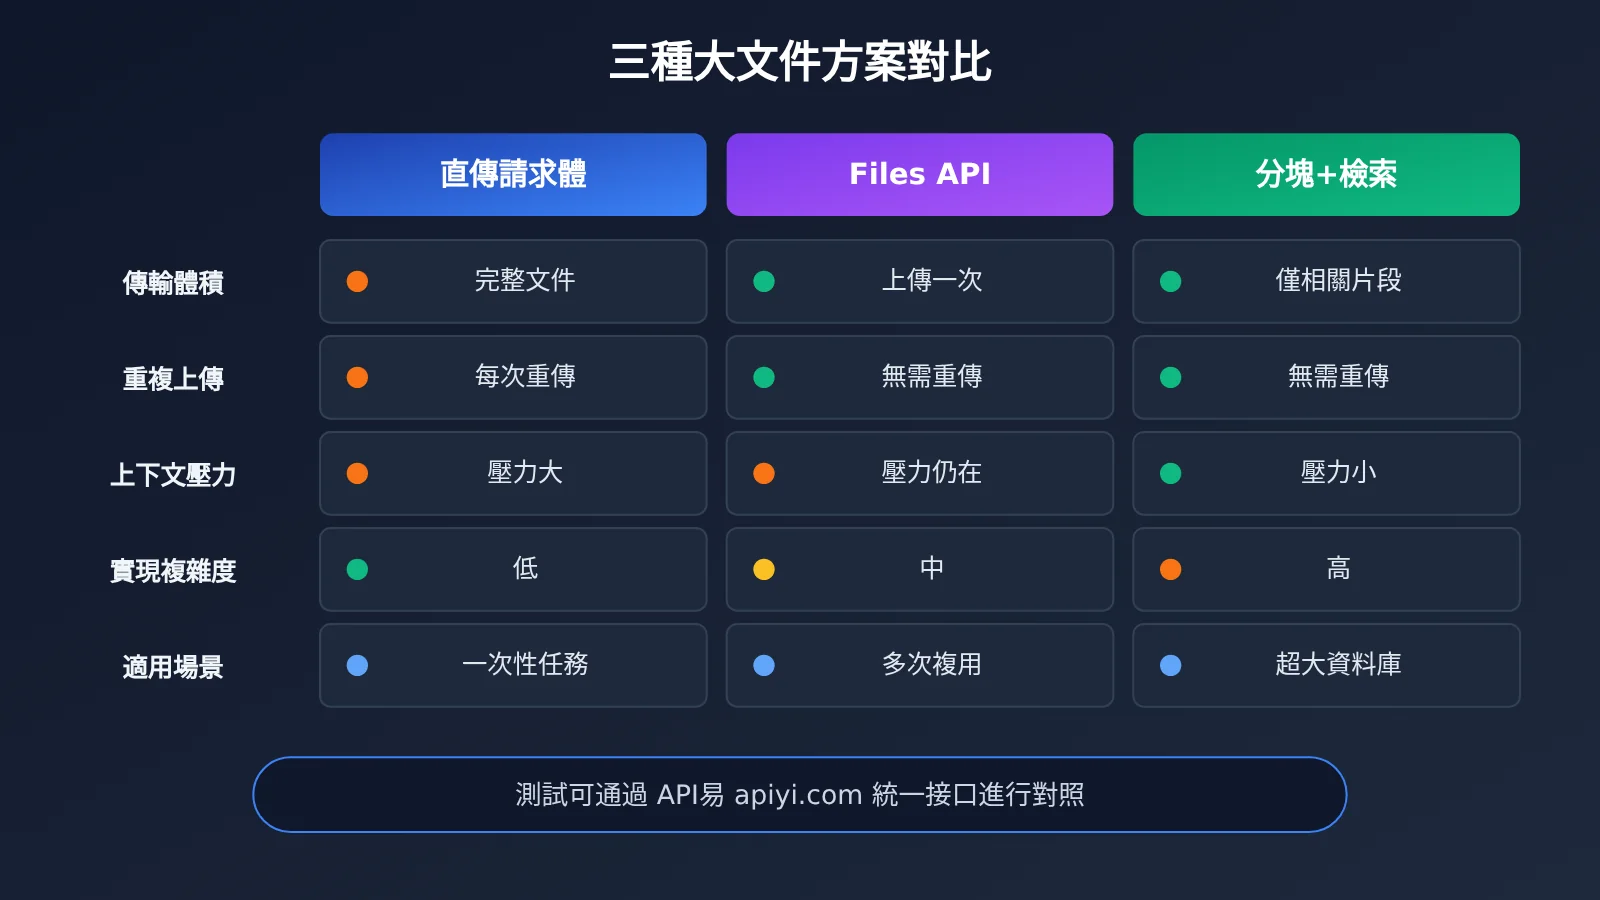
每個檔位都應在合法的模型與文件限制範圍內構造,並同時記錄 HTTP 請求體積、Token 數量、狀態碼、耗時、費用和結果質量六項指標。然後對同一批樣本分別跑“直傳”“Files API 引用”“分塊處理”三種方案,最後再根據數據判斷是否需要調整現有流程。
Claude API 請求體測量極簡示例
下面的代碼在發送前先測量請求體字節數,並捕獲 413 錯誤,便於在測試中記錄數據:
import json, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

messages = [{"role": "user", "content": "請總結這份長文檔的要點:" + open("doc.txt").read()}]
body_mb = len(json.dumps({"messages": messages}).encode("utf-8")) / 1024 / 1024
print(f"請求體約 {body_mb:.2f} MB")

resp = client.chat.completions.create(model="YOUR_CLAUDE_MODEL", messages=messages)
print(resp.usage)  # 記錄 Token 用量
查看完整測試記錄腳本
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 通過 API易 統一接口調用
)

MODEL = "YOUR_CLAUDE_MODEL"  # 替換爲平臺模型列表中的 Claude 模型名

def run_case(case_name: str, messages: list) -> dict:
    """記錄單次請求的體積、Token、狀態、耗時,用於方案對比"""
    body = json.dumps({"model": MODEL, "messages": messages}).encode("utf-8")
    record = {
        "case": case_name,
        "body_mb": round(len(body) / 1024 / 1024, 2),
        "status": None,
        "latency_s": None,
        "prompt_tokens": None,
        "completion_tokens": None,
    }
    start = time.time()
    try:
        resp = client.chat.completions.create(model=MODEL, messages=messages)
        record["status"] = 200
        record["prompt_tokens"] = resp.usage.prompt_tokens
        record["completion_tokens"] = resp.usage.completion_tokens
    except openai.APIStatusError as e:
        record["status"] = e.status_code  # 413 即請求體超限
    except Exception as e:
        record["status"] = f"error: {e}"
    record["latency_s"] = round(time.time() - start, 2)
    return record

if __name__ == "__main__":
    text = open("doc.txt", encoding="utf-8").read()
    cases = {
        "baseline": [{"role": "user", "content": "總結要點:" + text[:20000]}],
        "full_direct": [{"role": "user", "content": "總結要點:" + text}],
    }
    results = [run_case(name, msgs) for name, msgs in cases.items()]
    for r in results:
        print(r)
🚀 快速開始:如果團隊希望先跑通測試流程,可以在 API易 apiyi.com 註冊後獲取測試額度,用上面的腳本記錄各檔位數據。需要注意,經由第三方平臺轉發時,平臺網關的請求體上限可能低於官方第一方的 128 MB,測試大體積檔位前請先查閱平臺文檔確認。
常見問題 FAQ
Q1: Claude API 請求體擴容到 128 MB 具體指什麼?
指第一方 Claude API 的 Messages API 和 Token Counting API 單次 HTTP 請求的最大字節數,從 32 MB 提高到 128 MB(S1、S2)。它不是上下文窗口,也不是輸出長度。
Q2: 128 MB 請求體和 128K Token、1M Token 上下文有什麼區別?
前者按字節衡量網絡傳輸量,後者按 Token 衡量模型的處理容量,兩者單位完全不同。請求體能發出去,不代表內容都能放進上下文窗口;Token 預算仍需單獨用 Token Counting API 估算。
Q3: 擴容後處理速度會變快、成本會變低嗎?
沒有官方數據或公開實測能證明這一點。費用仍按 Token 用量計算(S6),更大的請求體還可能帶來更長的上傳耗時。是否有收益需要用自己的業務樣本測試後才能判斷。
Q4: 如何通過 API 快速驗證 Claude API 請求體變化對業務的影響?
可以按本文的四檔測試計劃執行。在 API易 apiyi.com 註冊獲取 API Key 後,將 base_url 設爲 `https://api.apiyi.com/v1`,用測試腳本記錄體積、Token、狀態碼與耗時。由於平臺限制可能與官方不同,大體積檔位請先確認平臺支持的上限。
Q5: 已經做好的 RAG 分塊系統需要拆掉嗎?
通常不需要。如果分塊是爲了檢索準確度、控制 Token 成本或降低延遲,這些動機並未因請求體擴容而改變。只有當分塊的唯一理由是繞開 32 MB 限制時,才值得重新評估。
Q6: Claude API 請求體擴容有哪些已知限制?
主要有三點:Sessions / Agents / Environments 端點仍爲 32 MB;PDF 頁數和上下文窗口另有約束;企業網關、代理及第三方平臺可能存在更低的上限。如果想同時對比多個模型在大文檔場景的表現,可以藉助 API易 apiyi.com 的統一接口做對照,但請以平臺實際支持的上限爲準。
Claude API 請求體擴容核心要點 Key Takeaways
- 變化本質:Messages 與 Token Counting 請求體從 32 MB 升至 128 MB,屬於 HTTP 層調整。
- 未變部分:上下文窗口、輸出長度、Token 計費方式都沒有變化。
- 端點差異:Batch 256 MB、Files 500 MB,Agents 類端點仍是 32 MB。
- 判斷依據:看原有拆分是爲了繞開體積限制,還是爲了質量、成本與性能。
- 鏈路排查:網關、代理、SDK 的限制往往比官方上限更早觸發。
- 驗證方式:按四個體積檔位對比直傳、文件引用、分塊三種方案,可藉助 API易 apiyi.com 統一接口執行測試。
總結:Claude API 請求體變大,不等於必須拆掉原有系統
這次 Claude API 請求體擴容的核心意義可以歸納爲三點:
- 入口變大了:第一方 Messages 接口單次能發送的字節更多,原先受困於 413 的業務獲得了新的餘量。
- 其他閘門沒變:上下文窗口、PDF 頁數、Token 計費和其他端點的限制都需要單獨評估。
- 改不改看瓶頸:架構調整應當由實際業務瓶頸、結果質量、成本和安全要求決定,而不是由新聞本身決定。
對於大多數企業,比較穩妥的做法是先查日誌、再測樣本、最後決定改動範圍。以下是一份可直接執行的檢查清單:
- [ ] 統計近期 413
request_too_large錯誤的頻率與來源端點 - [ ] 確認業務使用的端點及其官方上限(Messages / Batch / Files / Agents)
- [ ] 覈對自建網關、反向代理、WAF、負載均衡的請求體上限
- [ ] 覈對 SDK 與 HTTP 客戶端的超時、緩衝配置,計入 base64 膨脹
- [ ] 用 Token Counting API 預估大請求的 Token 數與上下文餘量
- [ ] 按四檔體積對比直傳、Files API 引用、分塊三種方案
- [ ] 評估多租戶
file_id隔離與數據安全策略 - [ ] 根據數據決定是否調整,並同步更新內部技術文檔
推薦通過 API易 apiyi.com 快速搭建對照測試環境,一個 API Key 即可調用多種主流模型,便於在真實樣本上驗證方案取捨。
📚 參考資料
- Anthropic 官方發佈日誌:2026 年 10 月 28 日請求體上限調整公告
- 鏈接:
platform.claude.com/docs/en/release-notes/overview -
說明:本次 32 MB 提升至 128 MB 的原始出處(S1)
-
Claude API 概覽與端點限制:各端點請求大小上限與 413 錯誤說明
- 鏈接:
platform.claude.com/docs/en/api/overview -
說明:Messages、Batch、Files、Agents 等端點上限對照(S2)
-
PDF 支持文檔:PDF 請求體與頁數限制
- 鏈接:
platform.claude.com/docs/en/build-with-claude/pdf-support -
說明:處理大型 PDF 前必讀(S3)
-
Files API 文檔:文件上傳、
file_id引用、存儲與權限 - 鏈接:
platform.claude.com/docs/en/build-with-claude/files -
說明:評估文件引用方案與多租戶隔離(S4)
-
上下文窗口文檔:模型 Token 容量說明
- 鏈接:
platform.claude.com/docs/en/build-with-claude/context-windows -
說明:區分字節限制與 Token 限制(S5)
-
官方價格與緩存說明:Token 計費與提示緩存
- 鏈接:
platform.claude.com/docs/en/about-claude/pricing - 說明:評估成本影響的依據(S6)
作者:APIYI 技術團隊
技術交流:歡迎在 API易 apiyi.com 網站首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心