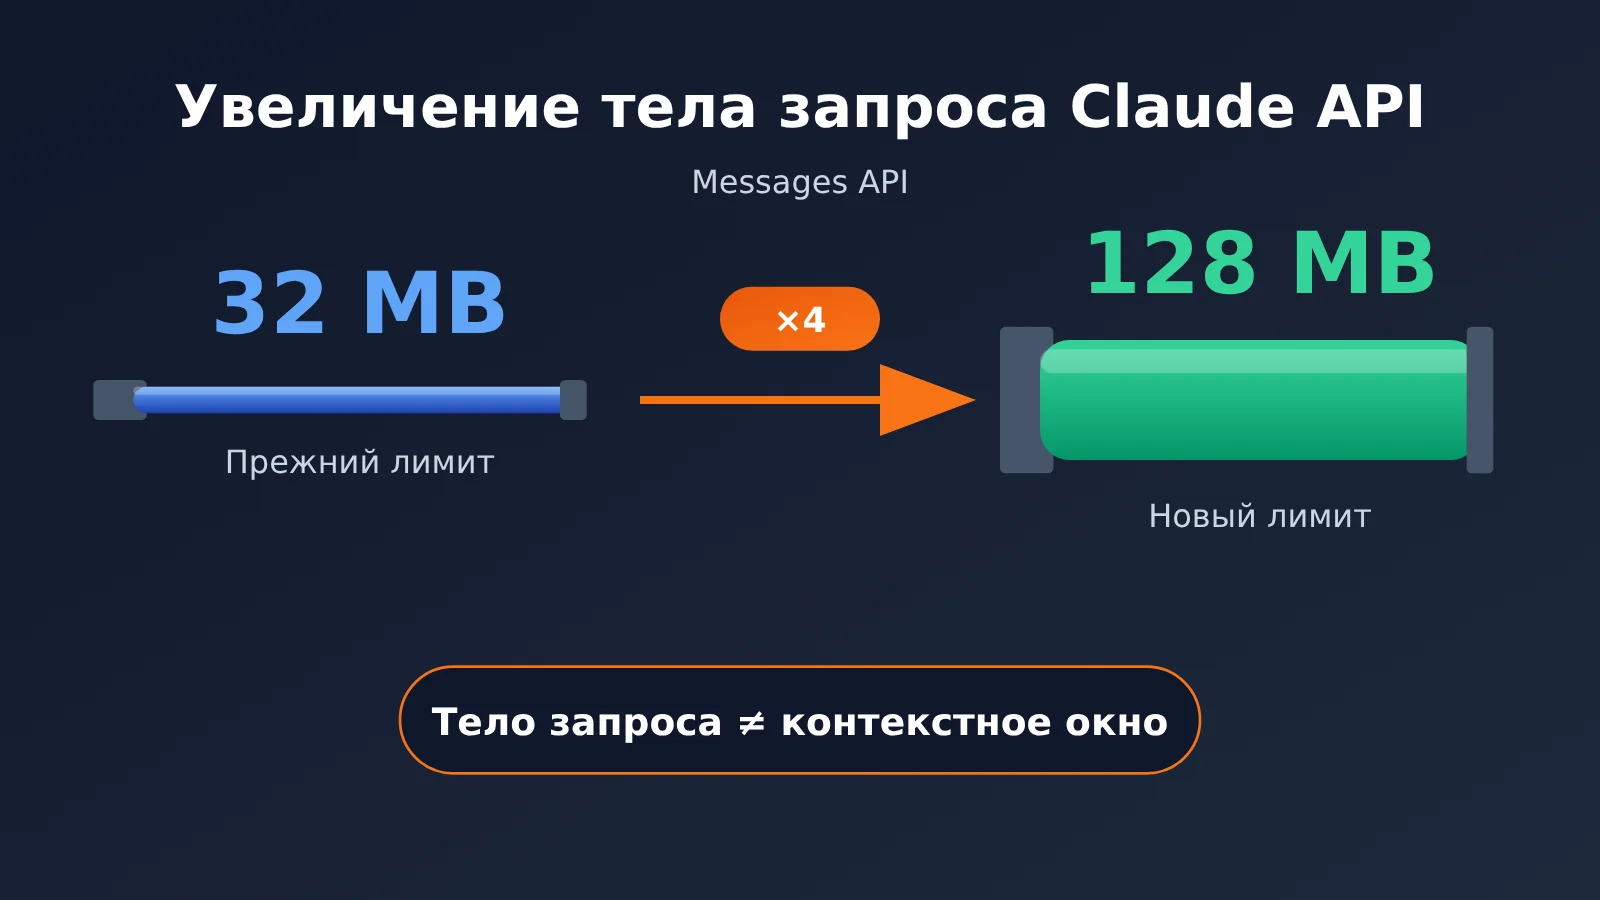
28 октября 2026 года Anthropic сообщила в официальном журнале обновлений, что максимальный размер тела запроса для Messages API и Token Counting API в собственном Claude API увеличен с 32 до 128 МБ — в четыре раза. После этого многие технические руководители задумались: стоит ли теперь переделывать процессы разделения, загрузки и предварительной обработки больших файлов, которые создавались в обход ограничения в 32 МБ?
Это обновление не сделало модель «мощнее»: оно меняет ограничение на размер тела HTTP-запроса и не связано ни с контекстным окном модели, ни с длиной ответа. Путаница часто возникает, когда 128 МБ смешивают со 128 тысячами или миллионом токенов.
Главное в статье: сначала разберёмся, какое именно ограничение изменилось в Claude API. Затем рассмотрим три варианта — A, B и C — для разных бизнес-сценариев и предложим недорогой план проверки и чек-лист. Рекомендации по архитектуре основаны на техническом анализе официальной информации, но не являются официальной инструкцией Anthropic по миграции.
Увеличение лимита тела запроса Claude API: главное
Для начала соберём основные факты об обновлении Claude API в одной таблице. На них будет опираться дальнейший разбор.
| Параметр | Подробности | Источник |
|---|---|---|
| Дата публикации | 28 октября 2026 года | Официальный журнал обновлений (S1) |
| Разработчик | Anthropic | Официальный журнал обновлений (S1) |
| Затронутые эндпоинты | Messages API и Token Counting API в Claude API от Anthropic | S1, S2 |
| Главное изменение | Максимальный размер тела запроса увеличен с 32 до 128 МБ | S1, S2 |
| Что не изменилось | Контекстное окно модели и максимальная длина ответа не увеличились | S2, S5 |
| При превышении лимита | Возвращается ошибка HTTP 413 request_too_large |
S2 |
| Оплата | По-прежнему зависит от количества токенов; увеличение размера запроса не означает, что обработка файлов стала бесплатной | S6 |
Лимиты тела запроса различаются для разных эндпоинтов Claude API
Важно учитывать, что в Claude API от Anthropic нет единого ограничения на размер запроса для всех эндпоинтов. На этот раз лимит изменился только для Messages и Token Counting. У остальных эндпоинтов действуют свои ограничения, поэтому при проектировании архитектуры нельзя ориентироваться только на одно число.
| Эндпоинт | Текущий лимит размера запроса | Примечание |
|---|---|---|
| Messages API | 128 МБ | Лимит увеличен с 32 МБ |
| Token Counting API | 128 МБ | Лимит увеличен с 32 МБ и совпадает с лимитом Messages |
| Batch API | 256 МБ | Для пакетной асинхронной обработки |
| Files API | 500 МБ | Максимальный размер одного файла для хранения — 500 МБ |
| Sessions / Agents / Environments | 32 МБ | Прежний лимит |
Источник данных — официальный обзор API (S2). Если ваше приложение использует и Messages, и эндпоинты категории Agents, лимиты размера для них по-прежнему нужно учитывать отдельно: применять ограничение в 128 МБ ко всем запросам нельзя.
Какое именно ограничение изменилось после увеличения размера запроса Claude API
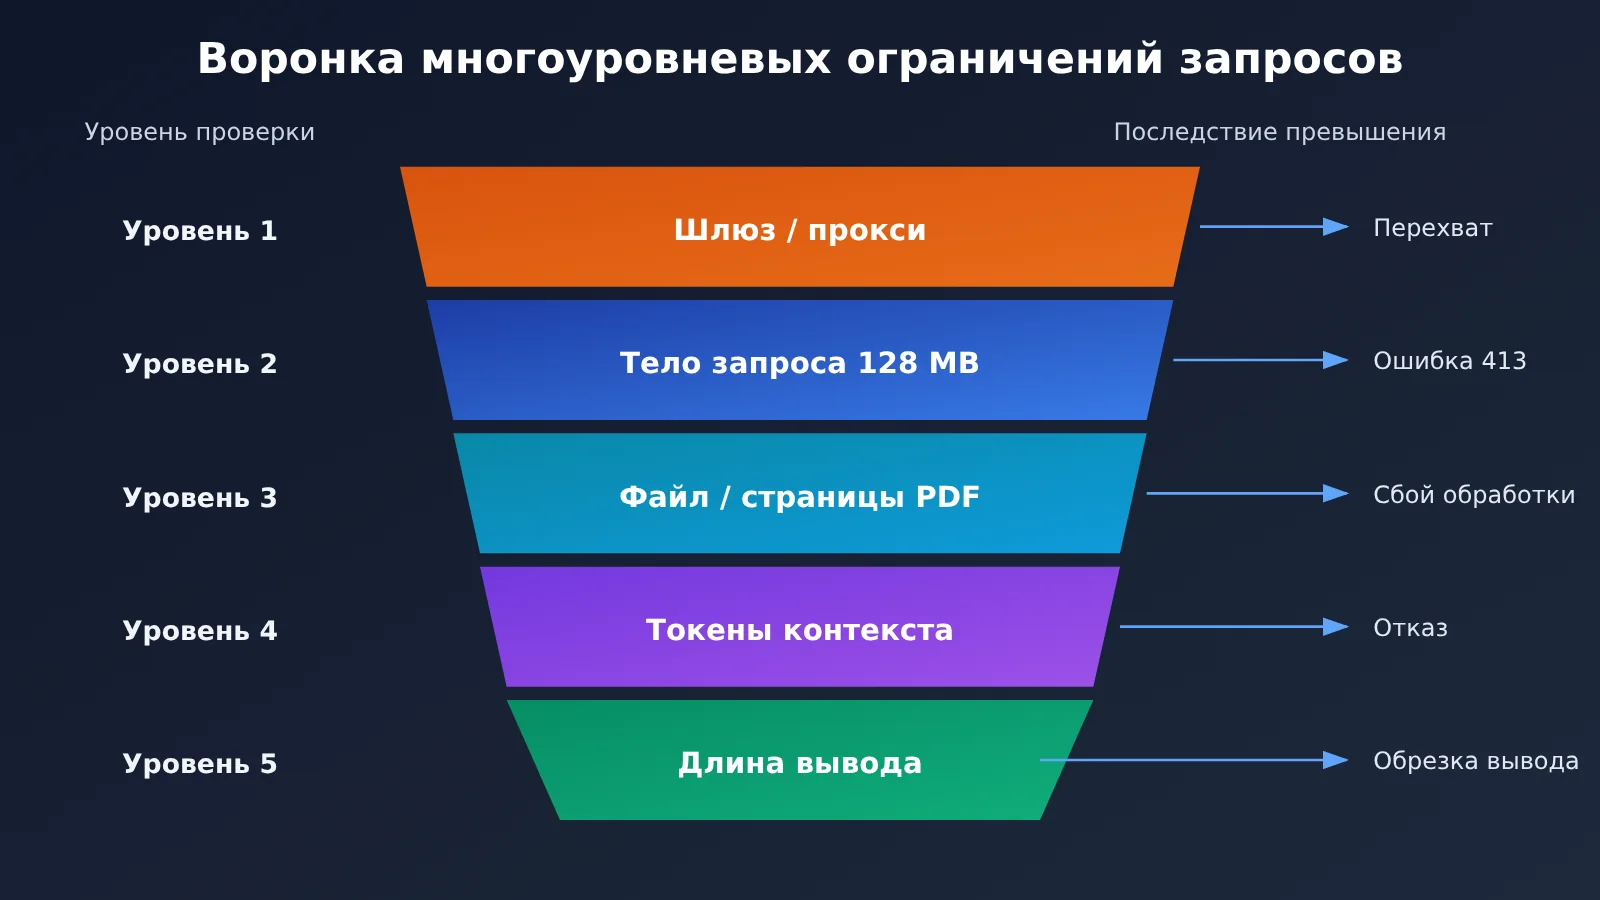
Каждый вызов Claude API проходит через несколько «фильтров», и размер тела запроса — лишь первый из них. Чтобы понять, нужно ли менять архитектуру, важно разобраться, чем эти ограничения отличаются.
| Тип ограничения | Единица измерения | Изменилось ли | Последствия превышения |
|---|---|---|---|
| Размер тела HTTP-запроса | Байты (МБ) | Да, для Messages и Token Counting увеличен до 128 МБ | HTTP 413 request_too_large |
| Контекстное окно модели | Токены | Нет | Запрос отклоняется или требует сокращения |
| Ограничения для файлов и PDF | Размер файла, количество страниц | Для тела запроса с PDF — 128 МБ, количество страниц ограничено отдельно | Файл не удаётся обработать целиком |
| Длина ответа | Токены | Нет | Ответ обрезается |
Тело запроса в 128 МБ не означает, что модель сможет «понять» 128 МБ данных
Размер тела запроса измеряется в байтах, передаваемых по сети, а контекстное окно — в токенах, которые модель может обработать за один раз. Изображение высокого разрешения может занимать несколько мегабайт, но при этом не обязательно содержать много токенов. А обычный текст размером всего в несколько сотен килобайт по количеству токенов может вплотную приблизиться к пределу контекстного окна. Так что «отправить больше байтов» и «дать модели понять больше информации» — не одно и то же.
Кроме того, двоичные данные — например, изображения и PDF — в JSON-запросе обычно кодируются в base64. После этого их размер увеличивается примерно до 4/3 от исходного. Поэтому в тело запроса на 128 МБ поместится заметно меньше 128 МБ исходных двоичных файлов. При расчётах стоит учитывать эти дополнительные затраты.
Как связаны ограничения на размер запроса Claude API и количество страниц в PDF
В официальной документации по PDF (S3) указано, что при обработке PDF через собственный API размер тела запроса ограничен 128 МБ. Но для количества страниц действует отдельное ограничение, которое зависит от контекстного окна используемой модели. Иными словами, даже если отсканированный договор на 100 МБ успешно пройдёт через HTTP-уровень, его всё равно может не получиться обработать целиком из-за количества страниц или превышения лимита токенов в контекстном окне.
Какие корпоративные приложения могут выиграть от увеличения размера тела запроса Claude API
Следующие выводы носят предположительный характер: они актуальны, только если ограничение тела запроса в 32 МБ действительно мешало работе. И даже в этом случае не факт, что данные больше не придётся разбивать на части.
- Анализ больших PDF и договоров: юристам и аудиторам часто нужно отправлять сканированные договоры или отчёты с множеством приложений. Сканированные файлы занимают много места, хотя текста в них может быть немного. Если раньше главной проблемой был размер файла свыше 32 МБ, теперь его, возможно, удастся отправить одним запросом. Если же дело в количестве страниц или токенов контекста, улучшения будут ограниченными.
- Отправка большого количества изображений или многостраничных материалов: при обработке страховых случаев и контроле качества к одному запросу могут прикладывать множество фотографий с места событий. Вместе они легко превышают прежний лимит. Его увеличение может снизить вероятность ошибки 413, но количество изображений по-прежнему ограничено возможностями модели и размером контекста.
- ИИ-приложения с большими объёмами структурированных данных: некоторые системы отправляют в запросе большие фрагменты JSON, журналы или таблицы. Допустимый объём в байтах вырос, но такие данные обычно содержат много токенов, поэтому приложение скорее упрётся в ограничение контекстного окна, чем достигнет 128 МБ.
- Сценарии, где входные данные разбивали только из-за лимита в 32 МБ: они выиграют от изменений в первую очередь. Если разбиение было нужно исключительно для обхода ограничения тела запроса, теперь стоит пересмотреть его необходимость.
🎯 Техническая рекомендация: сначала измерьте на реальных примерах размер данных в байтах и количество токенов, а затем определите, где именно возникает ограничение. Через APIYI apiyi.com можно с одним API-ключом вызывать Claude и другие популярные модели для сравнительного тестирования. Однако лимит тела запроса на сторонней платформе может отличаться от лимита официального API, поэтому перед запуском в продакшен уточните, какой предел поддерживается в данный момент.
Нужно ли менять архитектуру после увеличения лимита тела запроса Claude API: три сценария A/B/C
Это главный критерий для принятия решения. Нужно ли менять архитектуру, зависит не от того, что «официальный лимит вырос», а от того, какую проблему решали ваши прежние решения.
| Ситуация | Типичные признаки | Рекомендуемые действия | Приоритет |
|---|---|---|---|
| A. Размер запросов никогда не приближался к 32 МБ | Тело запроса обычно занимает несколько МБ, в логах нет ошибок 413 | Ничего не менять, просто зафиксировать изменение | Низкий |
| B. Частые ошибки 413 из-за размера тела запроса | В мониторинге заметна высокая доля ошибок 413 request_too_large |
Протестировать и оптимизировать процесс загрузки, оценить возможность сократить разбиение на части | Высокий |
| C. Разбиение связано с контекстом, точностью, производительностью или расходами | Данные разбиваются для повышения точности поиска, контроля затрат или снижения задержки | Сохранить разбиение, поиск и кеширование | Без изменений |
Ситуация A: системы, в которых запросы никогда не приближались к 32 МБ
В большинстве приложений для текстовых диалогов, поддержки клиентов и помощи с кодом тело отдельного запроса значительно меньше 32 МБ. Для таких систем менять что-либо обычно нет причин: переделка только создаст новые риски. Достаточно обновить информацию о лимите эндпоинта в технической документации — это поможет при поиске проблем в будущем.
Ситуация B: системы с частыми ошибками 413 из-за ограничения тела запроса
Если мониторинг показывает много ошибок 413 и вы убедились, что причина — превышение лимита тела запроса к эндпоинту Messages, обновление действительно стоит протестировать. Можно оценить, получится ли вместо разбиения некоторых данных отправлять их одним запросом, или перейти на ссылки file_id через Files API, чтобы сократить повторную передачу данных.
Ситуация C: разбиение на части нужно для качества, снижения затрат или производительности
Во многих RAG-системах данные разбивают на части не потому, что запрос слишком велик, а чтобы повысить точность поиска, сократить количество токенов при каждом вызове и ускорить ответ. Увеличение лимита тела запроса этих причин не устраняет. Если отказаться от разбиения, затраты могут вырасти, а качество ответов — снизиться. Таким системам стоит сохранить необходимое разбиение, поиск и кеширование.
5 шагов для проверки архитектуры перед увеличением размера запроса к Claude API
Даже в случае B стоит последовательно проверить все уровни системы. Многие команды продолжают получать ошибки после увеличения официального лимита — зачастую причина кроется в промежуточных звеньях.
- Уточните официальный лимит для нужного эндпоинта Anthropic: для Messages он составляет 128 МБ, для Sessions / Agents / Environments — по-прежнему 32 МБ, для Batch — 256 МБ, для Files — 500 МБ (S2).
- Проверьте ограничения запросов на API-шлюзе и обратном прокси: у корпоративного шлюза, Nginx, балансировщика нагрузки и WAF часто есть собственные лимиты по умолчанию. Они могут быть гораздо ниже 128 МБ, поэтому проверьте каждый компонент.
- Проверьте клиент, SDK и способ передачи данных: тайм-ауты HTTP-клиента, буферизация в памяти и способ загрузки влияют на возможность отправить большой запрос. Учитывайте и увеличение размера при кодировании в base64.
- Проверьте отдельные ограничения на токены, контекст и файлы: оцените количество токенов с помощью Token Counting API, проверьте допустимое число страниц PDF и размер контекстного окна (S3, S5).
- Оцените задержки, тайм-ауты, стоимость и обработку ошибок: большие запросы загружаются дольше, а повторные попытки обходятся дороже. Стоимость по-прежнему рассчитывается по количеству токенов (S6), поэтому стратегию тайм-аутов и повторных попыток нужно пересмотреть.
Альтернативы передаче файлов в теле запроса к Claude API
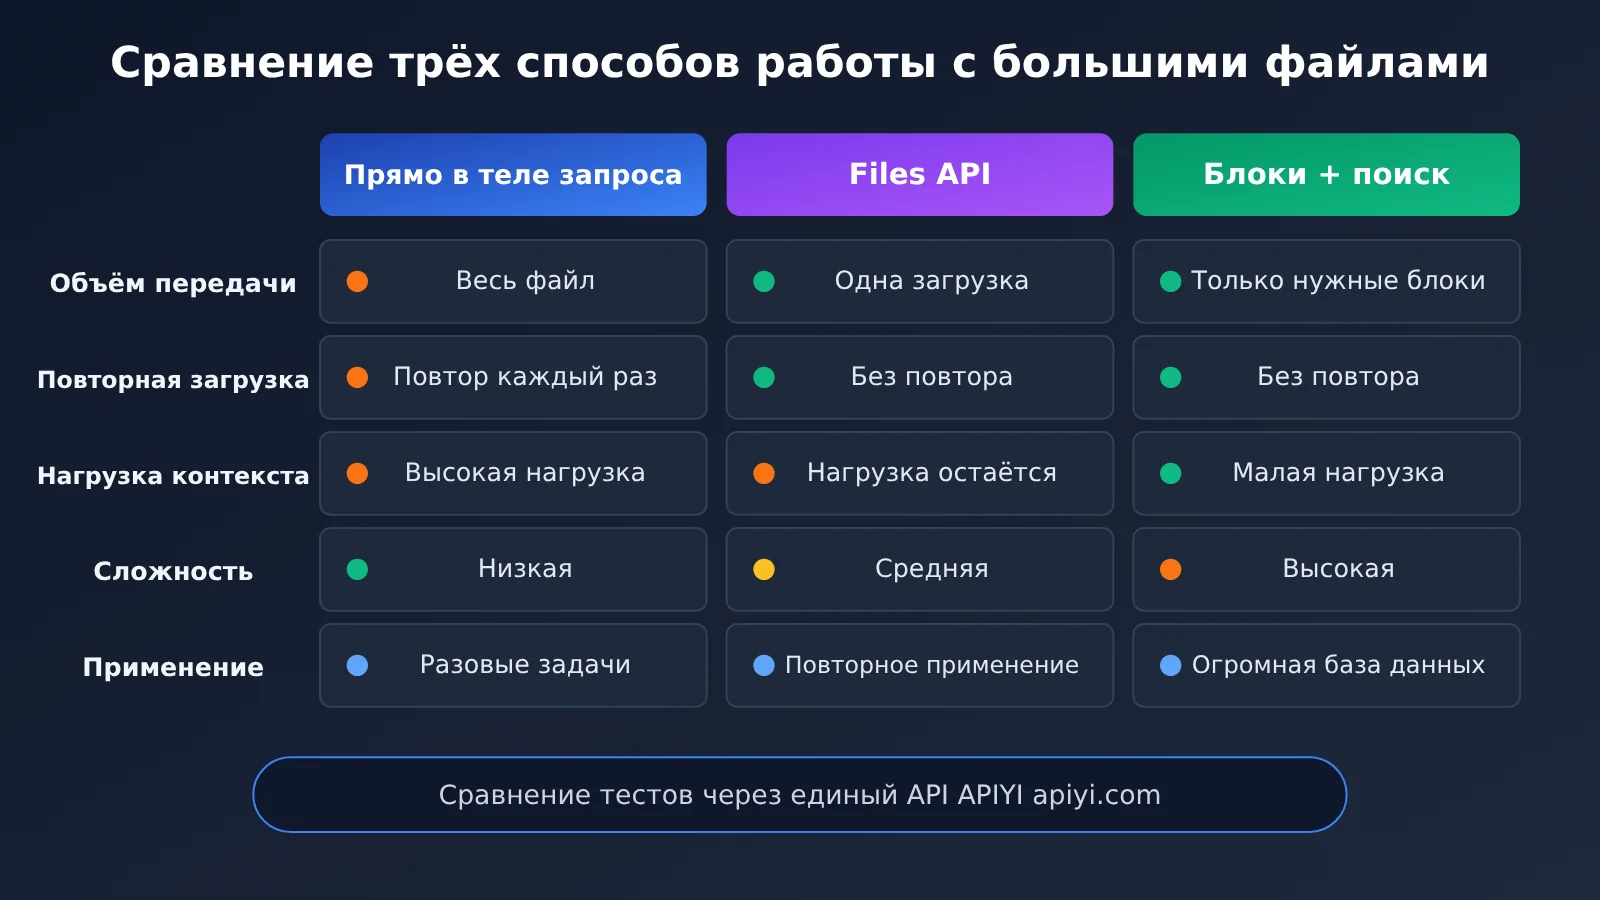
Помимо прямой передачи больших файлов в теле запроса, стоит рассмотреть несколько других вариантов:
- Files API и ссылки через
file_id: сначала загрузите файл, а затем ссылайтесь на него в сообщениях черезfile_id. Так не придётся передавать один и тот же файл при каждом запросе (S4). Лимит хранения одного файла — 500 МБ, но при обработке моделью по-прежнему действуют ограничения, в том числе на размер контекста. - Кэширование промптов: кэширование префикса с длинным документом, который используется многократно, может снизить стоимость повторного ввода. Точные правила тарификации приведены на официальной странице с ценами (S6).
- Разбиение на фрагменты и поиск: для очень больших баз материалов по-прежнему имеет смысл находить и отправлять только релевантные фрагменты — это обычно помогает найти баланс между качеством и стоимостью.
Риск нарушения изоляции файлов между арендаторами тоже нельзя игнорировать. При использовании Files API файлы хранятся на уровне аккаунта API. Если несколько клиентов используют один аккаунт, на уровне приложения необходимо строго разграничить доступ к file_id, чтобы запросы арендатора A не могли ссылаться на файлы арендатора B.
Как с минимальными затратами проверить пользу от увеличения лимита тела запроса Claude API
Сейчас нет общедоступных результатов тестов, на которые можно было бы сослаться и которые подтверждали бы рост скорости обработки или снижение затрат после увеличения лимита. Поэтому надёжнее всего провести тест на собственных рабочих данных. Ниже приведён план тестирования, а не его результаты.
| Уровень теста | Размер тела запроса | На что обратить внимание |
|---|---|---|
| Уровень 1 | Значительно меньше 32 МБ | Использовать как базовый уровень: записать обычное время обработки и количество токенов |
| Уровень 2 | Близко к 32 МБ | Проверить стабильность работы системы вблизи прежнего лимита |
| Уровень 3 | Более 32 МБ | Проверить, пропускают ли запрос шлюз и SDK, возникает ли ошибка 413 |
| Уровень 4 | Близко к 128 МБ | Проверить тайм-ауты, потребление памяти и затраты на повторные попытки после сбоев |
Для каждого уровня подготовьте запросы в пределах допустимых ограничений модели и файлов. При этом записывайте шесть показателей: размер HTTP-запроса, количество токенов, код состояния, время обработки, стоимость и качество результата. Затем обработайте один и тот же набор данных тремя способами: прямая передача, ссылка через Files API и обработка по частям. На основе полученных данных решите, нужно ли менять текущий процесс.
Минимальный пример измерения тела запроса к Claude API
Этот код измеряет размер тела запроса в байтах перед отправкой и перехватывает ошибку 413, чтобы данные можно было записать во время тестирования:
import json, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

messages = [{"role": "user", "content": "请总结这份长文档的要点:" + open("doc.txt").read()}]
body_mb = len(json.dumps({"messages": messages}).encode("utf-8")) / 1024 / 1024
print(f"请求体约 {body_mb:.2f} MB")

resp = client.chat.completions.create(model="YOUR_CLAUDE_MODEL", messages=messages)
print(resp.usage)  # 记录 Token 用量
Посмотреть полный скрипт для записи результатов тестирования
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 通过 APIYI 统一接口调用
)

MODEL = "YOUR_CLAUDE_MODEL"  # 替换为平台模型列表中的 Claude 模型名

def run_case(case_name: str, messages: list) -> dict:
    """记录单次请求的体积、Token、状态、耗时,用于方案对比"""
    body = json.dumps({"model": MODEL, "messages": messages}).encode("utf-8")
    record = {
        "case": case_name,
        "body_mb": round(len(body) / 1024 / 1024, 2),
        "status": None,
        "latency_s": None,
        "prompt_tokens": None,
        "completion_tokens": None,
    }
    start = time.time()
    try:
        resp = client.chat.completions.create(model=MODEL, messages=messages)
        record["status"] = 200
        record["prompt_tokens"] = resp.usage.prompt_tokens
        record["completion_tokens"] = resp.usage.completion_tokens
    except openai.APIStatusError as e:
        record["status"] = e.status_code  # 413 即请求体超限
    except Exception as e:
        record["status"] = f"error: {e}"
    record["latency_s"] = round(time.time() - start, 2)
    return record

if __name__ == "__main__":
    text = open("doc.txt", encoding="utf-8").read()
    cases = {
        "baseline": [{"role": "user", "content": "总结要点:" + text[:20000]}],
        "full_direct": [{"role": "user", "content": "总结要点:" + text}],
    }
    results = [run_case(name, msgs) for name, msgs in cases.items()]
    for r in results:
        print(r)
🚀 Быстрый старт: чтобы опробовать процесс тестирования, зарегистрируйтесь на APIYI apiyi.com, получите тестовую квоту и запустите скрипт выше для записи результатов при разных размерах запросов. Учтите, что при передаче через стороннюю платформу лимит тела запроса на её шлюзе может быть ниже официального лимита в 128 МБ. Прежде чем тестировать большие запросы, проверьте лимиты в документации платформы.
Частые вопросы FAQ
Q1: Что именно означает увеличение размера тела запроса Claude API до 128 МБ?
Максимальный размер одного HTTP-запроса к Messages API и Token Counting API напрямую через Claude API увеличен с 32 до 128 МБ (S1, S2). Это ограничение не относится к контекстному окну или длине ответа.
Q2: Чем тело запроса на 128 МБ отличается от контекстного окна на 128 тыс. или 1 млн токенов?
Первое измеряет объём передаваемых данных в байтах, второе — объём данных, который модель может обработать, в токенах. Это совершенно разные единицы. Возможность отправить запрос не означает, что всё его содержимое поместится в контекстное окно. Бюджет токенов по-прежнему нужно отдельно оценивать с помощью Token Counting API.
Q3: После увеличения лимита обработка станет быстрее, а расходы — ниже?
Официальных данных или опубликованных результатов тестов, которые это подтверждают, нет. Стоимость по-прежнему рассчитывается по количеству использованных токенов (S6), а загрузка более крупного тела запроса может занять больше времени. Чтобы понять, есть ли выгода, нужно провести тесты на собственных данных.
Q4: Как быстро проверить через API, повлияло ли изменение лимита тела запроса Claude API на работу приложения?
Можно воспользоваться планом тестирования с четырьмя уровнями размера запроса, приведённым в статье. Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ, затем задайте для base_url значение `https://api.apiyi.com/v1` и используйте тестовый скрипт, чтобы записать размер запроса, количество токенов, код ответа и затраченное время. Ограничения платформы могут отличаться от официальных, поэтому перед тестированием крупных запросов уточните поддерживаемый лимит.
Q5: Нужно ли отказываться от уже настроенной системы разбиения на фрагменты для RAG?
Обычно нет. Если вы разбиваете данные на фрагменты для повышения точности поиска, контроля расходов на токены или снижения задержки, увеличение лимита тела запроса ничего не меняет. Пересмотреть подход стоит только в том случае, если единственной причиной разбиения был обход ограничения в 32 МБ.
Q6: Какие ограничения действуют после увеличения размера тела запроса Claude API?
Основных ограничений три: для эндпоинтов Sessions / Agents / Environments лимит по-прежнему составляет 32 МБ; для количества страниц PDF и размера контекстного окна действуют отдельные ограничения; корпоративные шлюзы, прокси и сторонние платформы могут устанавливать более низкие лимиты. Если вы хотите сравнить работу нескольких моделей с большими документами, можно воспользоваться единым интерфейсом APIYI apiyi.com, но учитывайте фактические ограничения платформы.
Увеличение размера запросов Claude API: главное
- Что изменилось: максимальный размер тела запроса для Messages и Token Counting вырос с 32 до 128 МБ. Это изменение на уровне HTTP.
- Что осталось прежним: контекстное окно, длина ответа и принцип тарификации токенов не изменились.
- Различия между эндпоинтами: для Batch лимит составляет 256 МБ, для Files — 500 МБ, а для эндпоинтов Agents по-прежнему действует ограничение в 32 МБ.
- Как принять решение: выясните, зачем раньше разбивали запросы — чтобы обойти ограничение размера или ради качества, стоимости и производительности.
- Проверка всей цепочки: ограничения шлюзов, прокси и SDK часто срабатывают раньше официального лимита.
- Как проверить: сравните прямую передачу, ссылки на файлы и разбиение на части для запросов четырёх размеров. Провести тесты через единый интерфейс можно с помощью APIYI apiyi.com.
Итог: увеличение размера запросов Claude API не повод перестраивать всю систему
Значение этого изменения можно свести к трём пунктам:
- Лимит на входе вырос: в один запрос к официальному интерфейсу Messages теперь помещается больше байтов. У сценариев, которые упирались в ошибку 413, появился дополнительный запас.
- Остальные ограничения остались прежними: контекстное окно, число страниц PDF, тарификацию токенов и лимиты других эндпоинтов по-прежнему нужно оценивать отдельно.
- Решение зависит от узких мест: менять архитектуру стоит исходя из реальных ограничений бизнеса, качества результата, стоимости и требований безопасности, а не просто потому, что вышла новость.
Для большинства компаний разумный подход — сначала изучить логи, затем провести тесты на реальных данных и только после этого определить масштаб изменений. Вот готовый чек-лист:
- [ ] Подсчитать частоту ошибок 413
request_too_largeза последнее время и выяснить, какие эндпоинты их возвращают - [ ] Определить, какие эндпоинты использует система, и проверить их официальные лимиты (Messages / Batch / Files / Agents)
- [ ] Проверить ограничения на размер тела запроса в собственных шлюзах, обратных прокси, WAF и балансировщиках нагрузки
- [ ] Проверить тайм-ауты и настройки буферизации SDK и HTTP-клиентов, учитывая увеличение размера при кодировании в base64
- [ ] С помощью Token Counting API оценить число токенов в крупных запросах и запас контекстного окна
- [ ] Сравнить прямую передачу, ссылки через Files API и разбиение на части для запросов четырёх размеров
- [ ] Оценить изоляцию
file_idмежду арендаторами и политику безопасности данных - [ ] На основании полученных данных решить, нужны ли изменения, и обновить внутреннюю техническую документацию
Для быстрого создания тестовой среды можно воспользоваться APIYI apiyi.com: один API-ключ позволяет вызывать несколько популярных моделей и сравнивать варианты на реальных данных.
📚 Источники
- Официальный журнал обновлений Anthropic: объявление об изменении лимита тела запроса от 28 октября 2026 года
- Ссылка:
platform.claude.com/docs/en/release-notes/overview -
Описание: первоисточник информации об увеличении лимита с 32 до 128 МБ (S1)
-
Обзор Claude API и ограничения эндпоинтов: лимиты размера запроса для каждого эндпоинта и описание ошибки 413
- Ссылка:
platform.claude.com/docs/en/api/overview -
Описание: сравнение лимитов эндпоинтов Messages, Batch, Files, Agents и других (S2)
-
Документация по поддержке PDF: ограничения на размер тела запроса и количество страниц PDF
- Ссылка:
platform.claude.com/docs/en/build-with-claude/pdf-support -
Описание: рекомендуем ознакомиться перед обработкой больших PDF-файлов (S3)
-
Документация Files API: загрузка файлов, ссылки через
file_id, хранение и права доступа - Ссылка:
platform.claude.com/docs/en/build-with-claude/files -
Описание: материал для оценки работы со ссылками на файлы и изоляции данных разных клиентов (S4)
-
Документация по контекстному окну: информация о вместимости модели в токенах
- Ссылка:
platform.claude.com/docs/en/build-with-claude/context-windows -
Описание: поможет разобраться в разнице между ограничениями в байтах и токенах (S5)
-
Официальная информация о ценах и кэшировании: тарификация токенов и кэширование промптов
- Ссылка:
platform.claude.com/docs/en/about-claude/pricing - Описание: основа для оценки влияния на расходы (S6)
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через главную страницу сайта APIYI apiyi.com. Дополнительные материалы по подключению доступны в центре документации docs.apiyi.com